Przykład: sieć magazynów i pytanie „czy nasz test działa?”
Fikcyjna sieć sześciu magazynów logistycznych zatrudnia magazynierów. Każdy kandydat rozwiązuje dwa testy: test praktyczny (kompletacja zamówień na stanowisku próbnym, 0–100 pkt) i test uwagi (wyszukiwanie niezgodnych etykiet, 0–40 pkt). Przyjmowane są tylko osoby z wynikiem testu praktycznego co najmniej 68 pkt. Po 6 miesiącach kierownik zmiany ocenia pracę nowej osoby (średnia sześciu pozycji, skala 1–7).
W 2025 r. testy napisało 1200 kandydatów, zatrudniono 315 (26.2%). Dział kadr policzył korelację testu z oceną pracy i wyszło r = .27. Zarząd pyta: czy test jest słaby i czy w ogóle warto go dalej robić?
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie: w całej puli kandydatów test praktyczny koreluje z prawdziwą jakością pracy na poziomie .645, test uwagi – .45, testy ze sobą – .30, a rzetelność jednej oceny kierownika wynosi .60. Dlatego w puli korelacja testu praktycznego z oceną wynosi około .50. Ocenę „gdyby zatrudniono wszystkich” znamy tylko dzięki symulacji – w firmie odrzuceni nie mają oceny. Dla 80 losowych zatrudnionych zebraliśmy drugą, niezależną ocenę (kierownik magazynu). Ziarno danych to 717; parametrów danych ani ziaren po pierwszym uruchomieniu nie zmienialiśmy. Dane pobierzesz jako trafnosc-testu-magazyny-kandydaci.csv (kolumna ocena_symulacja istnieje tylko w symulacji).
Sam mechanizm pokazuje wpis ograniczony zakres zmiennej – wizualizacja. Tu liczymy decyzje jednej firmy.
Rysunek 1: pula kandydatów, próg i zatrudnieni
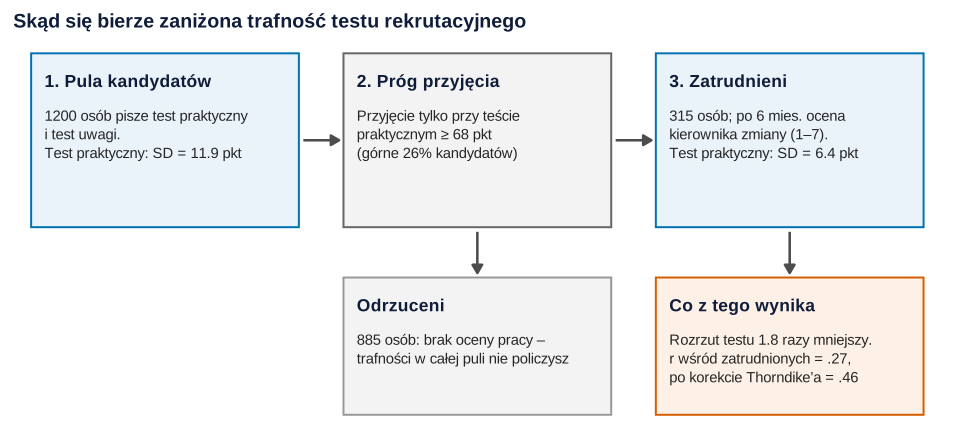
set.seed(717)).Co widać. Korelację testu z oceną pracy da się policzyć tylko na zatrudnionych, a ich wybrano właśnie testem. Wśród nich odchylenie standardowe testu praktycznego wynosi 6.4 pkt zamiast 11.9 pkt. To ograniczenie zakresu – szczególny przypadek błędu selekcji.
Jak może zmylić. Schemat zakłada ostry próg. Jeśli o przyjęciu decydował też wywiad albo część osób odrzuciła ofertę, selekcja jest pośrednia (pułapki niżej).
Podpis do pracy:
Rysunek 2: cała pula a zatrudnieni
Trafność prognostyczna to zdolność testu do przewidywania kryterium zmierzonego później – tu oceny pracy po 6 miesiącach. Jej miarą jest współczynnik trafności, czyli korelacja Pearsona wyniku testu z kryterium (więcej o rodzinie dowodów w haśle trafność kryterialna). Z praktycznego punktu widzenia to najważniejsza własność metody oceny kandydatów (Schmidt i Hunter, 1998).
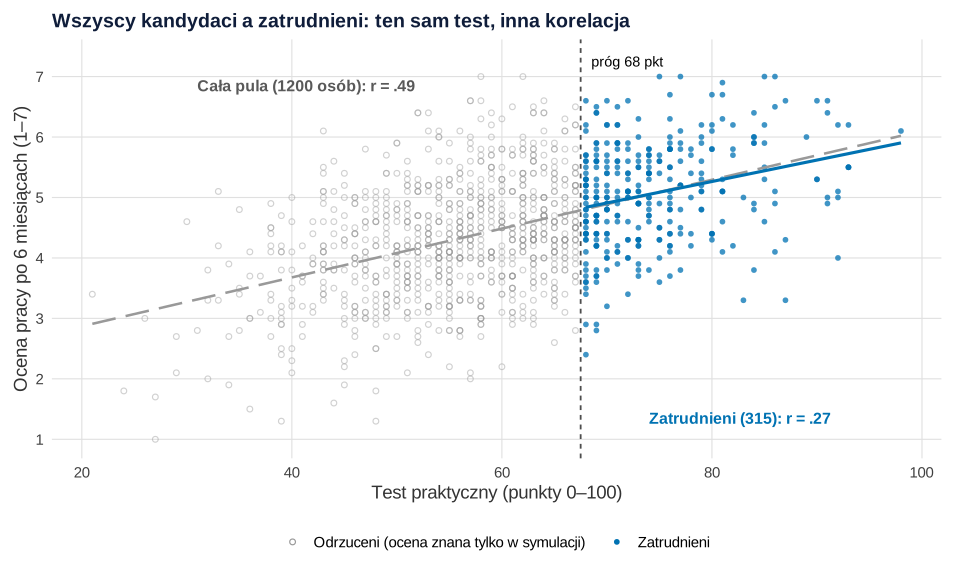
set.seed(717)).Co widać. Wśród zatrudnionych r = .27, 95% CI [.16, .37], t(313) = 4.93, p < .001. Gdyby zatrudniono wszystkich, wyszłoby r = .49. Prosta prawie się nie zmienia: 0.40 pkt oceny na 10 pkt testu w puli i 0.36 wśród zatrudnionych. Spada korelacja, bo spadł rozrzut testu.
Jak może zmylić. W firmie nie zobaczysz szarych kółek – tylko niebieską chmurę, która wygląda na „słaby związek”.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: korekta Thorndike’a z przedziałem bootstrap
Firma ma przewagę nad wieloma badaczami: test napisali wszyscy kandydaci, więc znamy jego odchylenie standardowe bez ograniczenia. Przy selekcji bezpośrednio po teście stosuje się korektę Thorndike’a, przypadek II. Słowami: pomnóż obserwowaną korelację przez u – iloraz SD testu w puli do SD wśród zatrudnionych – i podziel przez pierwiastek z wyrażenia „1 minus r² plus r² razy u²”:
Na liczbach: .268 × 1.847 / √(1 − .072 + .072 × 3.41) = .46. Sackett i Yang (2000) klasyfikują sytuacje ograniczenia zakresu według zmiennej, po której nastąpiła selekcja, i według tego, czy znasz wariancję bez ograniczenia – nasz przypadek (selekcja po teście, znane SD puli) jest najprostszy.
Wzór daje jedną liczbę, a z 315 osób potrzebujesz też przedziału. Dlatego stosujemy bootstrap: 5000 razy losujemy zatrudnionych ze zwracaniem i za każdym razem liczymy r, u i korektę. Chan i Chan (2004) pokazali w symulacjach, że dla skorygowanej korelacji przedział bootstrapowy BCa najtrafniej pokrywa wartość w populacji.
Ocena kierownika też ma błąd. Zgodność dwóch kierowników u 80 osób to ryy = .48 [.30, .61] – blisko średniej .52 dla ocen przełożonych z metaanalizy Viswesvarana i in. (1996), którzy przypominają, że do korekty trzeba użyć rzetelności międzyoceniającej. Dzieląc r przez √ryy, a dopiero potem korygując zakres, szacujesz trafność wobec jakości pracy bez błędu oceny. Logikę i ograniczenia tej korekty na atenuację opisuje wpis o błędzie pomiaru w regresji.
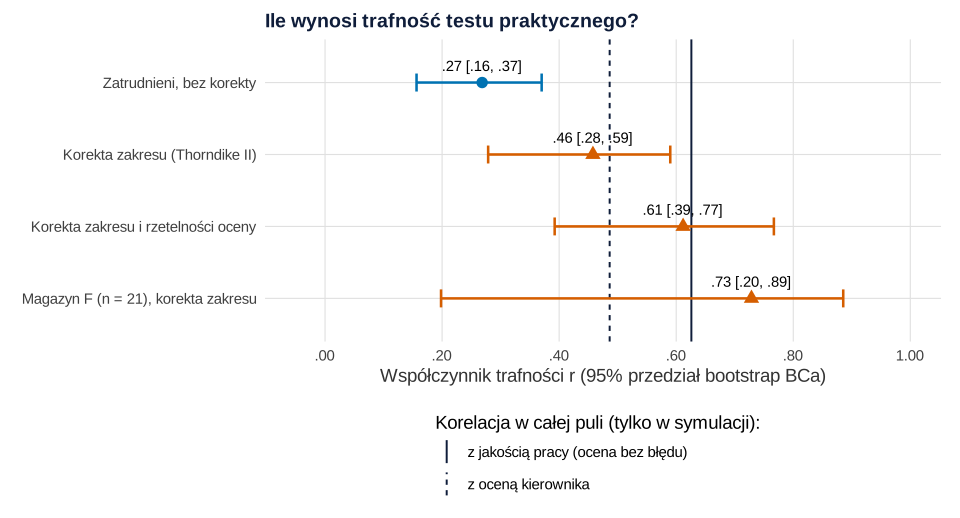
set.seed(717), set.seed(7173), set.seed(7174)).Co widać. Korekta podnosi trafność z .27 do .46, 95% CI [.28, .59] – blisko prawdziwego .49 w puli. Po dodatkowej korekcie na rzetelność oceny wychodzi .61 [.39, .77] wobec prawdziwego .63. Przedział po korekcie jest jednak szerszy: korekta mnoży także niepewność.
Jak może zmylić. Ostatni wiersz to jeden magazyn z 21 zatrudnionymi: r = .49, po korekcie .73, a przedział od .20 do .89. Z tak małej grupy nie wyciągaj wniosków o teście w tym magazynie. Druga sprawa: w metaanalizach trafności metod selekcji korekty na ograniczenie zakresu bywały nadmierne – po ich poprawieniu średnie współczynniki trafności spadły o .10–.20 (Sackett i in., 2022). Koryguj tylko wtedy, gdy wiesz, po czym była selekcja i jakie jest SD puli.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: co dokłada test uwagi?
Test uwagi wydłuża rekrutację. Czy przewiduje ocenę pracy ponad test praktyczny? To pytanie o trafność przyrostową. Sprawdzamy ją w regresji hierarchicznej: w kroku 1 test praktyczny, w kroku 2 test uwagi, i patrzymy na przyrost ΔR².
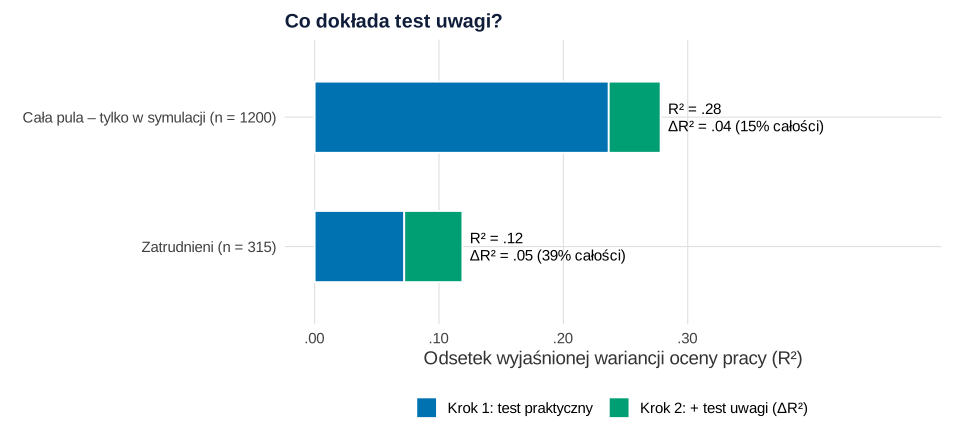
set.seed(717)).Co widać. Wśród zatrudnionych test uwagi podnosi R² z .072 do .119: ΔR² = .047, F(1, 312) = 16.55, p < .001; 5 pkt w teście uwagi to 0.17 pkt oceny więcej. W całej puli ΔR² jest podobne (.042), a współczynnik prawie ten sam (0.18).
Jak może zmylić. Wśród zatrudnionych test uwagi wygląda na prawie równorzędny – daje 39% wyjaśnionej wariancji, w puli tylko 15%. To efekt selekcji: zawęziliśmy test praktyczny, a test uwagi tylko trochę (jego korelacja z testem praktycznym spadła z .29 do .14). Ocena przyrostu zależy od kryterium, miar porównawczych i próby (Haynes i Lench, 2003). Więcej o tej analizie: wpis trafność przyrostowa nowej skali.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: ilu dobrych pracowników daje próg?
Korelacja niewiele mówi kierownikowi. Lepiej przełożyć ją na odsetek „dobrych” magazynierów (ocena co najmniej 5.0) wśród przyjętych przy różnych progach. Firma może to policzyć z modelu: rozkładu normalnego dwóch zmiennych z korelacją r (tablice Taylora–Russella). Średnią i SD oceny w puli odtwarzamy z prostej regresji oceny na test wśród zatrudnionych – przy selekcji po teście ta prosta się nie zmienia. Model daje 31.5% dobrych w puli (w symulacji 32.4%).
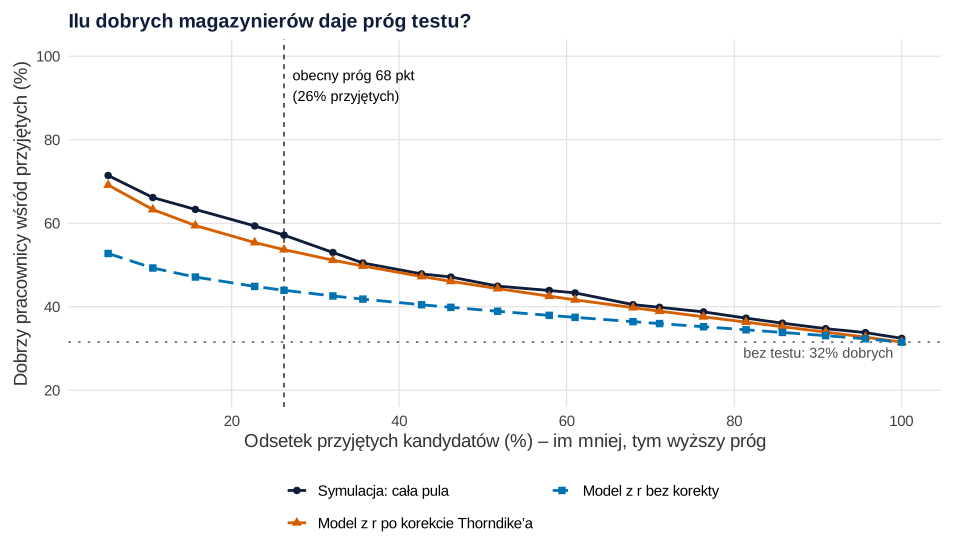
set.seed(717)).Co widać. Bez testu dobrych byłoby ok. 32%. Przy obecnym progu (26.2% przyjętych) jest ich 57.1%. Model z korelacją po korekcie przewiduje 53.7%, a model z r = .27 bez korekty – tylko 43.9%. Przy ostrzejszym progu 75 pkt (10.6% przyjętych) symulacja daje 66.1%, model po korekcie 63.3%, bez korekty 49.3%.
Jak może zmylić. Model bez korekty zaniża użyteczność testu. Ostrzejszy próg to więcej dobrych, ale mniej przyjętych – przy brakach kadrowych odsetek przyjętych ustala rynek. Model zakłada liniowość i normalność.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: kierownik, który zna wynik, i mała próba
(A) Kierownik zmiany zna wynik testu nowej osoby i ocenia ją przez ten pryzmat. To kontaminacja kryterium: ocena zawiera kawałek testu. W symulacji dodajemy do oceny w odchyleń standardowych oceny razy wynik testu w jednostkach z. (B) Firma sprawdza trafność na pierwszych zatrudnionych – w podzbiorach 25, 50, 100 i 200 osób z losowej kolejności.
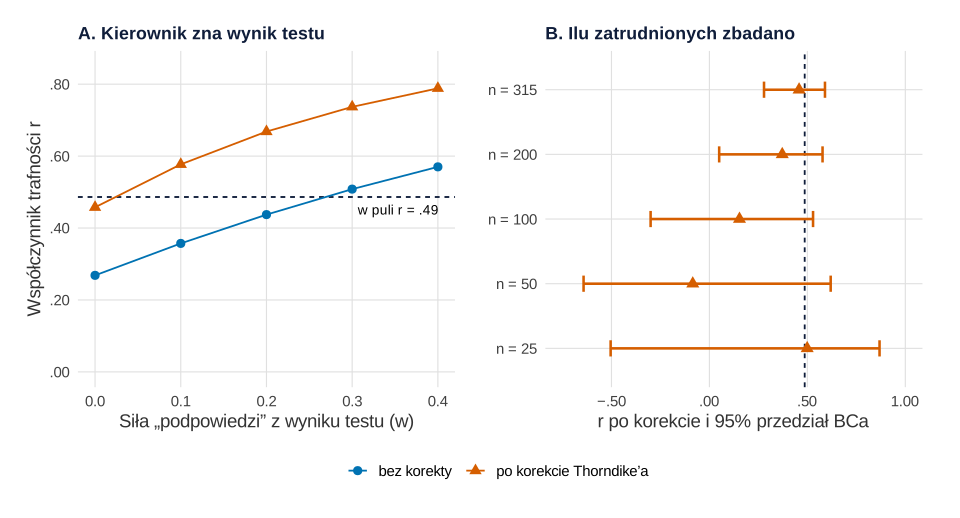
set.seed(7176)).Co widać. Panel A: już w = 0.2 podnosi r do .44, a po korekcie do .67 – wyżej niż prawdziwe .49. Korekta Thorndike’a powiększa każdy błąd w kryterium. Panel B: przy 50 osobach wyszło −.09 z przedziałem od −.64 do .62; pilotaż na takiej grupie mógłby „pokazać”, że test nie działa. Dopiero 200–315 osób daje przedział, który wyklucza zero.
Jak może zmylić. Kontaminacji nie widać w danych – trzeba jej zapobiec. Podzbiory w panelu B to jedno losowanie, więc przedziały nie maleją idealnie z n.
Podpis do pracy:
Co z tym zrobić w firmie
- Nie wyrzucaj testu za r = .27. Po korekcie trafność wynosi .46 [.28, .59], a próg 68 pkt podnosi odsetek dobrych magazynierów z ok. 32% do ok. 57%.
- Zapisuj wyniki wszystkich kandydatów. Bez SD puli nie policzysz korekty. Normy wydawcy testu (hasło normy testowe) zastąpią je tylko wtedy, gdy dotyczą podobnych kandydatów.
- Ukryj wynik testu przed oceniającymi. Ocena „na ślepo” to jedyna ochrona przed kontaminacją kryterium.
- Zbieraj dwie oceny. Drugi oceniający dla części osób daje rzetelność kryterium; jak mierzyć zgodność oceniających, pokazuje wpis ocena 360 stopni.
- Test uwagi zostaw, jeśli koszt jest mały. Przyrost ΔR² = .04–.05 jest realny, ale skromniejszy, niż sugeruje udział 39% wśród zatrudnionych.
- Sprawdź też równość szans. Ten sam próg może przyjmować różne grupy kandydatów w różnym odsetku – zob. wpis o zasadzie czterech piątych. Płace nowych pracowników analizuje wpis o siatce płac.
Jak opisać w pracy
Podaj, kto miał kryterium, po czym była selekcja, skąd SD bez ograniczenia, jaką korektę zastosowano i jak liczono przedział. Ogólne wskazówki: wpis statystyka w pracy z zarządzania i ekonomii.
W Wynikach podaj tabelę obok siebie: wartość obserwowaną i skorygowaną.
| Oszacowanie | r | 95% CI (BCa) |
|---|---|---|
| Zatrudnieni, bez korekty | .27 | [.16, .37] |
| Korekta na ograniczenie zakresu | .46 | [.28, .59] |
| Korekta na zakres i rzetelność oceny | .61 | [.39, .77] |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje pomocnicze, z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Ziarna: set.seed(717) (dane), set.seed(7173) i set.seed(7174) (bootstrap w przepisie 3), set.seed(7176) (przepis 6); ustalono je raz i nie zmieniano. Ręcznie ustalono: 1200 kandydatów, korelacje ukryte (.645, .45, .30), rzetelność jednej oceny .60, skale testów (średnie 60 i 28 pkt, SD 12 i 6 pkt) i oceny (średnia 4.5, SD 1), próg 68 pkt, udziały magazynów, 80 osób z drugą oceną, granicę „dobrego pracownika” 5.0 i wagi kontaminacji 0–0.4. Po pierwszym uruchomieniu zmieniono raz sposób losowania podzbiorów w przepisie 6: zamiast niezależnych prób każdej wielkości – podzbiory zagnieżdżone (pierwsze 25, 50, 100, 200 osób z jednej losowej kolejności), a dla wszystkich 315 osób – przedział z przepisu 3, by ta sama liczba nie miała na stronie dwóch przedziałów. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: 1200 kandydatów, próg i ocena pracy
R
# Przepis 1. Fikcyjna sieć magazynów: 1200 kandydatów na magazynierów, test praktyczny, test uwagi,
# próg przyjęcia i ocena pracy po 6 miesiącach
library(MASS)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Pula" = "grey60", "Zatrudnieni" = "#0072B2", "Korekta" = "#D55E00", "Prawda" = "#0f1d3a",
         "Uwaga" = "#009E73", "Bez korekty" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków
r_txt <- function(r) minus(sub("^(-?)0\\.", "\\1.", sprintf("%.2f", r)))   # r = .43 (bez zera)

# Parametry ustalone ręcznie (korelacje zmiennych ukrytych w całej puli kandydatów):
# test praktyczny – prawdziwa jakość pracy .645, test uwagi – jakość pracy .45, test praktyczny – test uwagi .30.
# Ocena kierownika = jakość pracy + błąd; rzetelność jednej oceny .60, więc korelacja testu praktycznego
# z oceną w puli wynosi ok. .645 × √.60 = .50, a testu uwagi ok. .35.
n_pula <- 1200
R_ukryte <- matrix(c(1, .30, .645,
                     .30, 1, .45,
                     .645, .45, 1), 3, 3)
rzetelnosc_oceny <- 0.60
prog <- 68                                        # próg przyjęcia: test praktyczny ≥ 68 pkt

set.seed(717)
z <- mvrnorm(n_pula, mu = c(0, 0, 0), Sigma = R_ukryte)
ocena_z <- function(T) sqrt(rzetelnosc_oceny) * T + sqrt(1 - rzetelnosc_oceny) * rnorm(length(T))
pula <- data.frame(
  id = 1:n_pula,
  magazyn = paste("Magazyn", sample(LETTERS[1:6], n_pula, replace = TRUE, prob = c(.25, .22, .18, .15, .12, .08))),
  test_praktyczny = pmin(100, pmax(0, round(60 + 12 * z[, 1]))),     # punkty 0–100
  test_uwagi = pmin(40, pmax(0, round(28 + 6 * z[, 2]))),            # punkty 0–40
  # ocena pracy po 6 mies. (średnia 6 pozycji 1–7) – w symulacji znana dla wszystkich, w firmie tylko dla zatrudnionych
  ocena_symulacja = pmin(7, pmax(1, round(4.5 + 1.0 * ocena_z(z[, 3]), 1))),
  ocena_drugi_symulacja = pmin(7, pmax(1, round(4.5 + 1.0 * ocena_z(z[, 3]), 1))))
pula$zatrudniony <- pula$test_praktyczny >= prog
# Drugą, niezależną ocenę (kierownik magazynu) zebrano dla losowych 80 zatrudnionych
drugi <- sample(pula$id[pula$zatrudniony], 80)
pula$ocena <- ifelse(pula$zatrudniony, pula$ocena_symulacja, NA)
pula$ocena_drugi <- ifelse(pula$id %in% drugi, pula$ocena_drugi_symulacja, NA)
zatr <- pula[pula$zatrudniony, ]
write.csv(pula[, c("id", "magazyn", "test_praktyczny", "test_uwagi", "zatrudniony", "ocena", "ocena_drugi",
                   "ocena_symulacja")], "trafnosc-testu-magazyny-kandydaci.csv", row.names = FALSE)

c(kandydaci = nrow(pula), zatrudnieni = nrow(zatr), z_dwiema_ocenami = sum(!is.na(pula$ocena_drugi)))
round(100 * mean(pula$zatrudniony), 1)                 # odsetek zatrudnionych (%)
table(zatr$magazyn)
round(sapply(pula[, c("test_praktyczny", "test_uwagi", "ocena_symulacja")], function(x) c(M = mean(x), SD = sd(x))), 2)
round(sapply(zatr[, c("test_praktyczny", "test_uwagi", "ocena")], function(x) c(M = mean(x), SD = sd(x))), 2)
Wynik w R
       kandydaci      zatrudnieni z_dwiema_ocenami
            1200              315               80
[1] 26.2

Magazyn A Magazyn B Magazyn C Magazyn D Magazyn E Magazyn F
       77        63        46        60        48        21
   test_praktyczny test_uwagi ocena_symulacja
M            60.05      28.03            4.49
SD           11.88       5.85            0.99
   test_praktyczny test_uwagi ocena
M            74.70      30.11  5.08
SD            6.43       5.44  0.85
2. Cała pula a zatrudnieni: Rysunek 2
R
# Przepis 2. Cała pula a zatrudnieni: korelacja testu praktycznego z oceną pracy (Rysunek 2)
# (korzysta z pula, zatr, prog, kol, motyw i r_txt() z przepisu 1)
library(ggplot2)

# W firmie znasz tylko wiersz „zatrudnieni”; wiersz „cała pula” istnieje, bo dane są symulowane
r_pula <- cor(pula$test_praktyczny, pula$ocena_symulacja)
test_zatr <- cor.test(zatr$test_praktyczny, zatr$ocena)
r_zatr <- unname(test_zatr$estimate)
sd_pula <- sd(pula$test_praktyczny); sd_zatr <- sd(zatr$test_praktyczny)
u <- sd_pula / sd_zatr                            # ile razy rozrzut testu w puli jest większy niż wśród zatrudnionych
round(c(r_pula = r_pula, r_zatrudnieni = r_zatr, SD_pula = sd_pula, SD_zatrudnieni = sd_zatr, u = u), 3)
sprintf("t(%d) = %.2f, p = %.2g", test_zatr$parameter, test_zatr$statistic, test_zatr$p.value)
round(test_zatr$conf.int, 3)
# Nachylenie prostej (punkty oceny na 10 pkt testu) – przy selekcji po teście prawie się nie zmienia
round(10 * c(pula = unname(coef(lm(ocena_symulacja ~ test_praktyczny, pula))[2]),
             zatrudnieni = unname(coef(lm(ocena ~ test_praktyczny, zatr))[2])), 3)

pula$grupa <- ifelse(pula$zatrudniony, "Zatrudnieni", "Pula")
p2 <- ggplot(pula, aes(test_praktyczny, ocena_symulacja)) +
  geom_vline(xintercept = prog - 0.5, linetype = "22", colour = "grey30") +
  geom_point(aes(colour = grupa, shape = grupa, alpha = grupa), size = 1.6) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["Pula"]], linetype = "longdash", linewidth = 0.9) +
  geom_smooth(data = zatr, aes(test_praktyczny, ocena), method = "lm", formula = y ~ x, se = FALSE,
              colour = kol[["Zatrudnieni"]], linewidth = 1.1) +
  annotate("text", x = 31, y = 6.85, hjust = 0, size = 4.2, fontface = "bold", colour = "grey35",
           label = paste0("Cała pula (", nrow(pula), " osób): r = ", r_txt(r_pula))) +
  annotate("text", x = 74, y = 1.35, hjust = 0, size = 4.2, fontface = "bold", colour = kol[["Zatrudnieni"]],
           label = paste0("Zatrudnieni (", nrow(zatr), "): r = ", r_txt(r_zatr))) +
  annotate("text", x = prog + 0.5, y = 7.25, hjust = 0, size = 3.8, label = paste("próg", prog, "pkt")) +
  scale_colour_manual(values = kol[c("Pula", "Zatrudnieni")], name = NULL,
                      labels = c("Odrzuceni (ocena znana tylko w symulacji)", "Zatrudnieni")) +
  scale_shape_manual(values = c(Pula = 1, Zatrudnieni = 16), name = NULL,
                     labels = c("Odrzuceni (ocena znana tylko w symulacji)", "Zatrudnieni")) +
  scale_alpha_manual(values = c(Pula = 0.45, Zatrudnieni = 0.75), guide = "none") +
  scale_y_continuous(breaks = 1:7, limits = c(1, 7.3)) +
  labs(x = "Test praktyczny (punkty 0–100)", y = "Ocena pracy po 6 miesiącach (1–7)",
       title = "Wszyscy kandydaci a zatrudnieni: ten sam test, inna korelacja") + motyw
p2   # zapis: ggsave("trafnosc-testu-pula-a-zatrudnieni.svg", p2, width = 10, height = 6)
Wynik w R
        r_pula  r_zatrudnieni        SD_pula SD_zatrudnieni              u
         0.486          0.268         11.882          6.432          1.847
[1] "t(313) = 4.93, p = 1.3e-06"
[1] 0.163 0.368
attr(,"conf.level")
[1] 0.95
       pula zatrudnieni
      0.404       0.355
3. Korekta Thorndike’a, rzetelność oceny i bootstrap BCa: Rysunek 3
R
# Przepis 3. Korekta Thorndike’a (przypadek II), korekta na rzetelność oceny i przedziały bootstrap (Rysunek 3)
# (korzysta z pula, zatr, sd_pula, r_pula, kol, motyw i r_txt() z przepisu 1–2)
library(boot)
library(ggplot2)

# Thorndike, przypadek II (selekcja bezpośrednio po teście): r_c = r·u / √(1 − r² + r²·u²), u = SD puli / SD zatrudnionych
thorndike2 <- function(r, u) r * u / sqrt(1 - r^2 + r^2 * u^2)

statystyki <- function(d, i) {
  d <- d[i, ]
  r <- cor(d$test_praktyczny, d$ocena)
  u <- sd_pula / sd(d$test_praktyczny)            # SD puli jest znane: test pisali wszyscy kandydaci
  dwie <- !is.na(d$ocena_drugi)
  r_yy <- cor(d$ocena[dwie], d$ocena_drugi[dwie]) # zgodność dwóch kierowników = rzetelność jednej oceny
  c(r = r, r_thorndike = thorndike2(r, u),
    r_yy = r_yy, r_oba = thorndike2(r / sqrt(r_yy), u))   # najpierw rzetelność oceny (u zatrudnionych), potem zakres
}
oszac <- statystyki(zatr, seq_len(nrow(zatr)))
round(oszac, 3)

set.seed(7173)
bs <- boot(zatr, statystyki, R = 5000)
przedzial <- function(k) boot.ci(bs, type = "bca", index = k)$bca[4:5]
ci <- t(sapply(c(r = 1, r_thorndike = 2, r_yy = 3, r_oba = 4), przedzial))
round(cbind(oszacowanie = oszac, dolna_95 = ci[, 1], gorna_95 = ci[, 2]), 3)

# Jeden mały magazyn – ta sama korekta, ale z kilkudziesięciu osób
maly <- zatr[zatr$magazyn == "Magazyn F", ]
stat_maly <- function(d, i) { d <- d[i, ]; thorndike2(cor(d$test_praktyczny, d$ocena), sd_pula / sd(d$test_praktyczny)) }
set.seed(7174)
bs_maly <- boot(maly, stat_maly, R = 5000)
ci_maly <- boot.ci(bs_maly, type = "bca")$bca[4:5]
round(c(n = nrow(maly), r = cor(maly$test_praktyczny, maly$ocena), r_thorndike = bs_maly$t0,
        dolna_95 = ci_maly[1], gorna_95 = ci_maly[2]), 3)

# Wartości docelowe – znane tylko w symulacji: korelacja z oceną w całej puli i z „prawdziwą” jakością pracy
r_cel_ocena <- r_pula
r_cel_jakosc <- r_pula / sqrt(cor(pula$ocena_symulacja, pula$ocena_drugi_symulacja))
round(c(cel_ocena_w_puli = r_cel_ocena, rzetelnosc_oceny_w_puli = cor(pula$ocena_symulacja, pula$ocena_drugi_symulacja),
        cel_bez_bledu_oceny = r_cel_jakosc), 3)

wyk <- data.frame(
  co = c("Zatrudnieni, bez korekty", "Korekta zakresu (Thorndike II)", "Korekta zakresu i rzetelności oceny",
         paste0("Magazyn F (n = ", nrow(maly), "), korekta zakresu")),
  r = c(oszac[["r"]], oszac[["r_thorndike"]], oszac[["r_oba"]], bs_maly$t0),
  dolna = c(ci["r", 1], ci["r_thorndike", 1], ci["r_oba", 1], ci_maly[1]),
  gorna = c(ci["r", 2], ci["r_thorndike", 2], ci["r_oba", 2], ci_maly[2]),
  typ = c("Bez korekty", "Korekta", "Korekta", "Korekta"))
wyk$co <- factor(wyk$co, rev(wyk$co))
cele <- data.frame(x = c(r_cel_ocena, r_cel_jakosc),
                   co = c("z oceną kierownika", "z jakością pracy (ocena bez błędu)"))
p3 <- ggplot(wyk, aes(r, co)) +
  geom_vline(data = cele, aes(xintercept = x, linetype = co), colour = kol[["Prawda"]], linewidth = 0.7) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna, colour = typ), width = 0.25, orientation = "y", linewidth = 0.9) +
  geom_point(aes(colour = typ, shape = typ), size = 3.6) +
  geom_text(aes(label = paste0(r_txt(r), "  [", r_txt(dolna), ", ", r_txt(gorna), "]")), vjust = -1.1, size = 3.9) +
  scale_colour_manual(values = kol[c("Bez korekty", "Korekta")], guide = "none") +
  scale_shape_manual(values = c("Bez korekty" = 16, "Korekta" = 17), guide = "none") +
  scale_linetype_manual(values = c("z oceną kierownika" = "22", "z jakością pracy (ocena bez błędu)" = "solid"),
                        name = "Korelacja w całej puli (tylko w symulacji):") +
  guides(linetype = guide_legend(nrow = 2, title.position = "top")) +
  scale_x_continuous(limits = c(-0.05, 1), breaks = seq(0, 1, 0.2), labels = r_txt) +
  labs(x = "Współczynnik trafności r (95% przedział bootstrap BCa)", y = NULL,
       title = "Ile wynosi trafność testu praktycznego?") + motyw
p3   # zapis: ggsave("trafnosc-testu-korekta-thorndike.svg", p3, width = 10, height = 5.4)
Wynik w R
          r r_thorndike        r_yy       r_oba
      0.268       0.458       0.483       0.612
            oszacowanie dolna_95 gorna_95
r                 0.268    0.156    0.370
r_thorndike       0.458    0.279    0.590
r_yy              0.483    0.300    0.612
r_oba             0.612    0.392    0.767
          n           r r_thorndike    dolna_95    gorna_95
     21.000       0.494       0.729       0.198       0.885
       cel_ocena_w_puli rzetelnosc_oceny_w_puli     cel_bez_bledu_oceny
                  0.486                   0.604                   0.626
4. Trafność przyrostowa testu uwagi: Rysunek 4
R
# Przepis 4. Trafność przyrostowa testu uwagi ponad test praktyczny (Rysunek 4)
# (korzysta z pula, zatr, kol, motyw i r_txt() z przepisu 1)
library(ggplot2)

przyrost <- function(d, y) {
  m1 <- lm(reformulate("test_praktyczny", y), d)
  m2 <- lm(reformulate(c("test_praktyczny", "test_uwagi"), y), d)
  a <- anova(m1, m2)
  c(n = nrow(d), R2_krok1 = summary(m1)$r.squared, R2_krok2 = summary(m2)$r.squared,
    dR2 = summary(m2)$r.squared - summary(m1)$r.squared, F = a$F[2], df2 = a$Res.Df[2], p = a$`Pr(>F)`[2],
    b_uwagi_na_5_pkt = 5 * unname(coef(m2)["test_uwagi"]))
}
tab <- rbind(zatrudnieni = przyrost(zatr, "ocena"),
             cala_pula_symulacja = przyrost(pula, "ocena_symulacja"))
print(round(tab[, colnames(tab) != "p"], 4))
signif(tab[, "p"], 3)                    # wartości p testu F dla ΔR²
round(c(r_uwagi_zatrudnieni = cor(zatr$test_uwagi, zatr$ocena),
        r_uwagi_pula = cor(pula$test_uwagi, pula$ocena_symulacja),
        r_testow_zatrudnieni = cor(zatr$test_uwagi, zatr$test_praktyczny),
        r_testow_pula = cor(pula$test_uwagi, pula$test_praktyczny)), 3)

wyk <- data.frame(grupa = rep(c(paste0("Zatrudnieni (n = ", nrow(zatr), ")"),
                                paste0("Cała pula – tylko w symulacji (n = ", nrow(pula), ")")), 2),
                  krok = rep(c("Krok 1: test praktyczny", "Krok 2: + test uwagi (ΔR²)"), each = 2),
                  R2 = c(tab[, "R2_krok1"], tab[, "dR2"]))
wyk$grupa <- factor(wyk$grupa, unique(wyk$grupa))
wyk$krok <- factor(wyk$krok, rev(unique(wyk$krok)))
etyk <- data.frame(grupa = levels(wyk$grupa), R2 = tab[, "R2_krok2"],
                   tekst = paste0("R² = ", r_txt(tab[, "R2_krok2"]), "\nΔR² = ", r_txt(tab[, "dR2"]),
                                  " (", sprintf("%.0f", 100 * tab[, "dR2"] / tab[, "R2_krok2"]), "% całości)"))
p4 <- ggplot(wyk, aes(R2, grupa)) +
  geom_col(aes(fill = krok), width = 0.55, colour = "white") +
  geom_text(data = etyk, aes(x = R2 + 0.006, label = tekst), hjust = 0, size = 4, lineheight = 0.95) +
  scale_fill_manual(values = c("Krok 1: test praktyczny" = kol[["Zatrudnieni"]], "Krok 2: + test uwagi (ΔR²)" = kol[["Uwaga"]]),
                    breaks = c("Krok 1: test praktyczny", "Krok 2: + test uwagi (ΔR²)"), name = NULL) +
  scale_x_continuous(limits = c(0, 0.48), breaks = seq(0, 0.3, 0.1), labels = r_txt) +
  labs(x = "Odsetek wyjaśnionej wariancji oceny pracy (R²)", y = NULL,
       title = "Co dokłada test uwagi?") + motyw
p4   # zapis: ggsave("trafnosc-testu-przyrost-testu-uwagi.svg", p4, width = 10, height = 4.6)
Wynik w R
                       n R2_krok1 R2_krok2    dR2       F  df2 b_uwagi_na_5_pkt
zatrudnieni          315   0.0721   0.1188 0.0467 16.5501  312           0.1706
cala_pula_symulacja 1200   0.2365   0.2782 0.0417 69.1677 1197           0.1799
        zatrudnieni cala_pula_symulacja
           6.01e-05            2.43e-16
 r_uwagi_zatrudnieni         r_uwagi_pula r_testow_zatrudnieni
               0.250                0.335                0.135
       r_testow_pula
               0.286
5. Odsetek dobrych pracowników przy różnych progach: Rysunek 5
R
# Przepis 5. Użyteczność testu: odsetek dobrych pracowników przy różnych progach (Rysunek 5)
# (korzysta z pula, zatr, sd_pula, prog, oszac z przepisu 3, kol, motyw i minus() z przepisu 1)
library(ggplot2)

dobra <- 5.0                                       # „dobry pracownik”: ocena po 6 mies. co najmniej 5.0
# Prawda w symulacji: wśród kandydatów powyżej progu – jaki odsetek miałby ocenę ≥ 5.0?
odsetki <- c(seq(0.05, 0.95, by = 0.05), 1)
progi <- quantile(pula$test_praktyczny, 1 - odsetki, type = 1)
prawda <- sapply(progi, function(x0) mean(pula$ocena_symulacja[pula$test_praktyczny >= x0] >= dobra))
przyjeci <- sapply(progi, function(x0) mean(pula$test_praktyczny >= x0))

# Model (to, co firma może policzyć): rozkład dwuwymiarowy normalny testu i oceny w puli.
# Średnią i SD oceny w puli odtwarzamy z regresji oceny na test wśród zatrudnionych (selekcja po teście
# nie zmienia tej prostej); korelację bierzemy bez korekty albo po korekcie Thorndike’a.
m <- lm(ocena ~ test_praktyczny, zatr)
sr_oceny <- unname(coef(m)[1] + coef(m)[2] * mean(pula$test_praktyczny))
sd_oceny <- sqrt(coef(m)[[2]]^2 * sd_pula^2 + sigma(m)^2)
odsetek_dobrych <- function(s, rho, p0) {          # P(ocena ≥ próg | test w górnych s·100%), wzór Taylora–Russella
  a <- qnorm(1 - s); b <- qnorm(1 - p0)
  if (s >= 1) return(p0)
  integrate(function(x) dnorm(x) * pnorm((rho * x - b) / sqrt(1 - rho^2)), a, Inf)$value / s
}
p0 <- 1 - pnorm((dobra - sr_oceny) / sd_oceny)     # odsetek dobrych w puli według modelu
round(c(srednia_oceny_model = sr_oceny, SD_oceny_model = sd_oceny, dobrzy_w_puli_model = p0,
        dobrzy_w_puli_symulacja = mean(pula$ocena_symulacja >= dobra), dobrzy_wsrod_zatrudnionych = mean(zatr$ocena >= dobra)), 3)
model_kor <- sapply(przyjeci, odsetek_dobrych, rho = oszac[["r_thorndike"]], p0 = p0)
model_bez <- sapply(przyjeci, odsetek_dobrych, rho = oszac[["r"]], p0 = p0)
tab_u <- data.frame(przyjeci_proc = round(100 * przyjeci, 1), prog_pkt = unname(progi),
                    symulacja = round(100 * prawda, 1), model_thorndike = round(100 * model_kor, 1),
                    model_bez_korekty = round(100 * model_bez, 1))
print(tab_u[c(1, 2, 4, 5, 6, 10, 14, 20), ], row.names = FALSE)

dl <- rbind(data.frame(x = 100 * przyjeci, y = 100 * prawda, co = "Symulacja: cała pula"),
            data.frame(x = 100 * przyjeci, y = 100 * model_kor, co = "Model z r po korekcie Thorndike’a"),
            data.frame(x = 100 * przyjeci, y = 100 * model_bez, co = "Model z r bez korekty"))
dl$co <- factor(dl$co, unique(dl$co))
obecny <- 100 * mean(pula$zatrudniony)
p5 <- ggplot(dl, aes(x, y, colour = co, shape = co, linetype = co)) +
  geom_hline(yintercept = 100 * p0, colour = "grey45", linetype = "13") +
  annotate("text", x = 99, y = 100 * p0 - 2.5, hjust = 1, size = 3.8, colour = "grey30",
           label = sprintf("bez testu: %.0f%% dobrych", 100 * p0)) +
  geom_vline(xintercept = obecny, colour = "grey30", linetype = "22") +
  annotate("text", x = obecny + 1, y = 93, hjust = 0, size = 3.8, label = sprintf("obecny próg %d pkt\n(%.0f%% przyjętych)", prog, obecny)) +
  geom_line(linewidth = 1) + geom_point(size = 2.2) +
  scale_colour_manual(values = unname(kol[c("Prawda", "Korekta", "Bez korekty")]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "42"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 100, 20)) + scale_y_continuous(limits = c(20, 100), breaks = seq(20, 100, 20)) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "Odsetek przyjętych kandydatów (%) – im mniej, tym wyższy próg", y = "Dobrzy pracownicy wśród przyjętych (%)",
       title = "Ilu dobrych magazynierów daje próg testu?") + motyw
p5   # zapis: ggsave("trafnosc-testu-odsetek-dobrych-progi.svg", p5, width = 10, height = 5.8)
Wynik w R
       srednia_oceny_model             SD_oceny_model
                     4.556                      0.922
       dobrzy_w_puli_model    dobrzy_w_puli_symulacja
                     0.315                      0.324
dobrzy_wsrod_zatrudnionych
                     0.571
 przyjeci_proc prog_pkt symulacja model_thorndike model_bez_korekty
           5.2       80      71.4            69.1              52.7
          10.6       75      66.1            63.3              49.3
          22.8       69      59.3            55.4              44.9
          26.2       68      57.1            53.7              43.9
          32.1       66      53.0            51.1              42.6
          51.7       60      44.9            44.3              38.9
          71.1       54      39.9            38.9              36.0
         100.0       21      32.4            31.5              31.5
6. Kontaminacja kryterium i mała próba: Rysunek 6
R
# Przepis 6. Pułapki: kierownik zna wynik testu (kontaminacja kryterium) i mała próba zatrudnionych (Rysunek 6)
# (korzysta z zatr, sd_pula, r_pula z przepisu 2, thorndike2(), oszac i ci z przepisu 3, kol, motyw, r_txt() z przepisu 1)
library(boot)
library(ggplot2)
library(patchwork)

# A. Kontaminacja: kierownik, który zna wynik testu, dodaje do oceny w × SD oceny × (wynik testu w jednostkach z)
z_testu <- as.numeric(scale(zatr$test_praktyczny))
wagi <- c(0, 0.1, 0.2, 0.3, 0.4)
kont <- t(sapply(wagi, function(w) {
  ocena_k <- zatr$ocena + w * sd(zatr$ocena) * z_testu
  r <- cor(zatr$test_praktyczny, ocena_k)
  c(w = w, r = r, r_thorndike = thorndike2(r, sd_pula / sd(zatr$test_praktyczny)))
}))
round(kont, 3)

# B. Mała próba: pierwsze 25, 50, 100 i 200 osób z losowej kolejności zatrudnionych (podzbiory zagnieżdżone),
# 95% przedział BCa po korekcie; wiersz dla wszystkich 315 osób – z przepisu 3
set.seed(7176)
kolejnosc <- sample(nrow(zatr))
wielkosci <- c(25, 50, 100, 200)
male <- t(sapply(wielkosci, function(n) {
  d <- zatr[kolejnosc[1:n], ]
  b <- boot(d, function(d, i) { d <- d[i, ]; thorndike2(cor(d$test_praktyczny, d$ocena), sd_pula / sd(d$test_praktyczny)) },
            R = 2000)
  ci <- boot.ci(b, type = "bca")$bca[4:5]
  c(n = n, r_thorndike = b$t0, dolna = ci[1], gorna = ci[2], szerokosc = ci[2] - ci[1])
}))
male <- rbind(male, c(nrow(zatr), oszac[["r_thorndike"]], ci["r_thorndike", ], diff(ci["r_thorndike", ])))
round(male, 3)

ka <- data.frame(kont)
pa <- ggplot(ka, aes(w)) +
  geom_hline(yintercept = r_pula, colour = kol[["Prawda"]], linetype = "22") +
  annotate("text", x = 0.4, y = r_pula - 0.035, hjust = 1, size = 3.6, label = paste("w puli r =", r_txt(r_pula))) +
  geom_line(aes(y = r, colour = "Bez korekty")) + geom_point(aes(y = r, colour = "Bez korekty", shape = "Bez korekty"), size = 2.8) +
  geom_line(aes(y = r_thorndike, colour = "Korekta")) +
  geom_point(aes(y = r_thorndike, colour = "Korekta", shape = "Korekta"), size = 2.8) +
  scale_colour_manual(values = kol[c("Bez korekty", "Korekta")], labels = c("bez korekty", "po korekcie Thorndike’a"), name = NULL) +
  scale_shape_manual(values = c("Bez korekty" = 16, "Korekta" = 17), labels = c("bez korekty", "po korekcie Thorndike’a"), name = NULL) +
  scale_y_continuous(limits = c(0, 0.85), labels = r_txt) +
  labs(x = "Siła „podpowiedzi” z wyniku testu (w)", y = "Współczynnik trafności r",
       title = "A. Kierownik zna wynik testu") + motyw
mb <- data.frame(male)
mb$n_txt <- factor(paste0("n = ", mb$n), paste0("n = ", mb$n))
pb <- ggplot(mb, aes(r_thorndike, n_txt)) +
  geom_vline(xintercept = r_pula, colour = kol[["Prawda"]], linetype = "22") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y", colour = kol[["Korekta"]], linewidth = 0.9) +
  geom_point(colour = kol[["Korekta"]], shape = 17, size = 3) +
  scale_x_continuous(limits = c(-0.75, 1), breaks = seq(-0.5, 1, 0.5), labels = r_txt) +
  labs(x = "r po korekcie i 95% przedział BCa", y = NULL, title = "B. Ilu zatrudnionych zbadano") + motyw
p6 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p6   # zapis: ggsave("trafnosc-testu-pulapki.svg", p6, width = 10, height = 5.4)
Wynik w R
       w     r r_thorndike
[1,] 0.0 0.268       0.458
[2,] 0.1 0.357       0.577
[3,] 0.2 0.437       0.668
[4,] 0.3 0.508       0.737
[5,] 0.4 0.570       0.788
       n r_thorndike  dolna gorna szerokosc
[1,]  25       0.499 -0.504 0.868     1.373
[2,]  50      -0.085 -0.642 0.619     1.261
[3,] 100       0.153 -0.300 0.529     0.829
[4,] 200       0.372  0.050 0.577     0.528
[5,] 315       0.458  0.279 0.590     0.311
7. Grafika: pula → próg → zatrudnieni (Rysunek 1)
R
# Przepis 7. Grafika: schemat „pula kandydatów → próg → zatrudnieni” (Rysunek 1)
# (korzysta z pula, zatr, prog z przepisu 1, r_zatr, u, sd_pula, sd_zatr z przepisu 2, oszac z przepisu 3, motyw i r_txt())
library(ggplot2)

n_odrz <- sum(!pula$zatrudniony)
bloki <- data.frame(
  x = c(0.2, 3.7, 7.2, 3.7), y = c(2.2, 2.2, 2.2, 0.15), w = c(3, 3, 3, 3), h = c(1.9, 1.9, 1.9, 1.5),
  rodzaj = c("a", "b", "a", "c"),
  tytul = c("1. Pula kandydatów", "2. Próg przyjęcia", "3. Zatrudnieni", "Odrzuceni"),
  tekst = c(sprintf("%d osób pisze test praktyczny\ni test uwagi.\nTest praktyczny: SD = %.1f pkt", nrow(pula), sd_pula),
            sprintf("Przyjęcie tylko przy teście\npraktycznym ≥ %d pkt\n(górne %.0f%% kandydatów)", prog, 100 * mean(pula$zatrudniony)),
            sprintf("%d osób; po 6 mies. ocena\nkierownika zmiany (1–7).\nTest praktyczny: SD = %.1f pkt", nrow(zatr), sd_zatr),
            sprintf("%d osób: brak oceny pracy –\ntrafności w całej puli nie policzysz", n_odrz)))
strzalki <- data.frame(x = c(3.25, 6.75, 5.2), xend = c(3.65, 7.15, 5.2), y = c(3.15, 3.15, 2.15), yend = c(3.15, 3.15, 1.7))
p1 <- ggplot() +
  geom_rect(data = bloki, aes(xmin = x, xmax = x + w, ymin = y, ymax = y + h, fill = rodzaj, colour = rodzaj), linewidth = 0.7) +
  geom_text(data = bloki, aes(x + 0.15, y + h - 0.3, label = tytul), hjust = 0, fontface = "bold", size = 4.6, colour = "#0f1d3a") +
  geom_text(data = bloki, aes(x + 0.15, y + h - 0.62, label = tekst), hjust = 0, vjust = 1, size = 3.9, lineheight = 1.05, colour = "grey15") +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = yend), linewidth = 0.9, colour = "grey30",
               arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("rect", xmin = 7.2, xmax = 10.2, ymin = 0.15, ymax = 1.65, fill = "#fdf0e6", colour = "#D55E00", linewidth = 0.7) +
  annotate("text", x = 7.35, y = 1.35, hjust = 0, fontface = "bold", size = 4.6, colour = "#0f1d3a", label = "Co z tego wynika") +
  annotate("text", x = 7.35, y = 1.03, hjust = 0, vjust = 1, size = 3.9, lineheight = 1.05, colour = "grey15",
           label = sprintf("Rozrzut testu %.1f razy mniejszy.\nr wśród zatrudnionych = %s,\npo korekcie Thorndike’a = %s",
                           u, r_txt(r_zatr), r_txt(oszac[["r_thorndike"]]))) +
  annotate("segment", x = 10.2 - 1.5, xend = 10.2 - 1.5, y = 2.15, yend = 1.7, linewidth = 0.9, colour = "grey30",
           arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  scale_fill_manual(values = c(a = "#eaf2fa", b = "#f3f3f3", c = "#f3f3f3"), guide = "none") +
  scale_colour_manual(values = c(a = "#0072B2", b = "grey40", c = "grey60"), guide = "none") +
  scale_x_continuous(limits = c(0, 10.4), expand = c(0, 0)) + scale_y_continuous(limits = c(0, 4.25), expand = c(0, 0)) +
  labs(x = NULL, y = NULL, title = "Skąd się bierze zaniżona trafność testu rekrutacyjnego") +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("trafnosc-testu-schemat-pula-prog-zatrudnieni.svg", p1, width = 10, height = 4.6)
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("pula – zatrudnieni" = c("grey60", "#0072B2"), "bez korekty – korekta" = c("#0072B2", "#D55E00"),
             "krok 1 – test uwagi" = c("#0072B2", "#009E73"), "prawda – korekta" = c("#0f1d3a", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
pula – zatrudnieni                          44.9         48.9       40.6
bez korekty – korekta                      114.6        108.3       91.9
krok 1 – test uwagi                         70.1         55.4       58.0
prawda – korekta                           101.6         96.6       81.5
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych z rozkładu wielowymiarowego normalnego – pakiet MASS; bootstrap i przedziały BCa – pakiet boot; korelacje, regresja i całkowanie – funkcje podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- boot (wersja 1.3.32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions [R package]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Selekcja pośrednia. Gdy o przyjęciu decyduje też wywiad, korekta dla selekcji bezpośredniej niedoszacowuje trafności; ograniczenie zakresu w większości danych jest pośrednie (Hunter i in., 2006).
- Odejścia przed oceną. Osoby, które odeszły przed 6. miesiącem, nie mają oceny – to druga selekcja (wpis o rotacji pracowników).
- Rzetelność liczona nie tak. Do korekty kryterium użyj zgodności oceniających, nie alfy pozycji jednej oceny. Zauważ też, że wśród zatrudnionych rzetelność oceny jest niższa (.48) niż w puli (.60) – zawężony jest także rozrzut jakości pracy. Ogólnie o rzetelności – w słowniku.
Najczęstsze pytania
Dlaczego korelacja testu rekrutacyjnego z oceną pracy jest niska?
Najczęściej dlatego, że ocenę pracy mają tylko osoby przyjęte, a przyjęto je właśnie na podstawie testu. Wśród nich wyniki testu mało się różnią, więc korelacja spada, choć związek testu z pracą jest ten sam. W przykładzie korelacja wyniosła .27 wśród zatrudnionych i .49 w całej puli kandydatów.
Jak policzyć korektę Thorndike’a na ograniczenie zakresu?
Przy selekcji bezpośrednio po teście (przypadek II) policz u – iloraz odchylenia standardowego testu w puli kandydatów i wśród zatrudnionych. Skorygowana korelacja to r · u / √(1 − r² + r² · u²). Przykład: r = .268 i u = 1.847 dają .46. Przedział ufności wyznacz bootstrapem BCa (Chan i Chan, 2004).
Kiedy nie stosować korekty na ograniczenie zakresu?
Gdy nie znasz odchylenia standardowego testu w całej puli kandydatów albo selekcja nie była bezpośrednio po teście. Przy selekcji pośredniej korekta dla selekcji bezpośredniej niedoszacowuje trafności (Hunter i in., 2006), a w metaanalizach korekty bywały też nadmierne (Sackett i in., 2022). Opisz założenia i podaj obie wartości: obserwowaną i skorygowaną.
Co to jest kontaminacja kryterium w rekrutacji?
To sytuacja, w której ocena pracy zależy od wyniku testu, np. dlatego, że kierownik ten wynik zna. Korelacja testu z oceną rośnie wtedy sztucznie, a korekta na ograniczenie zakresu jeszcze to powiększa. Jedyna ochrona: osoby oceniające pracę nie powinny znać wyników testu.
Jak sprawdzić, czy drugi test rekrutacyjny coś wnosi?
Sprawdź trafność przyrostową w regresji hierarchicznej: w kroku 1 dotychczasowy test, w kroku 2 nowy, i oceń przyrost ΔR² z testem F. Pamiętaj, że wśród zatrudnionych przyrost może wyglądać na względnie większy, bo zawężono pierwszy test – w przykładzie test uwagi dawał 39% wyjaśnionej wariancji wśród zatrudnionych i 15% w całej puli.
Powiązane hasła
Przeczytaj też
Ograniczony zakres zmiennej – wizualizacja
Progi przyjęcia, selekcja po X i po Y, skrajne grupy i 1000 badań z poprawką Thorndike’a – pięć rysunków z kodem R.
Czytaj →PoradnikSiatka płac z regresji
220 płac w biurze projektowym: log(płacy) w procentach, przedział predykcji, płace poza siatką i widełki z regresji kwantylowej – z kodem R.
Czytaj →PoradnikZasada czterech piątych w rekrutacji
Wskaźnik wpływu, reguła 4/5, test z i Fishera, przedział i moc – na fikcyjnej rekrutacji w firmie ochrony mienia, z kodem R.
Czytaj →Sprawdzasz trafność testu rekrutacyjnego albo piszesz o tym pracę?
Pomożemy policzyć współczynnik trafności z korektą na ograniczenie zakresu i rzetelność kryterium, ocenić przyrost drugiego testu i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Chan, W., & Chan, D. W.-L. (2004). Bootstrap standard error and confidence intervals for the correlation corrected for range restriction: A simulation study. Psychological Methods, 9(3), 369–385. https://doi.org/10.1037/1082-989x.9.3.369
- Haynes, S. N., & Lench, H. C. (2003). Incremental validity of new clinical assessment measures. Psychological Assessment, 15(4), 456–466. https://doi.org/10.1037/1040-3590.15.4.456
- Hunter, J. E., Schmidt, F. L., & Le, H. (2006). Implications of direct and indirect range restriction for meta-analysis methods and findings. Journal of Applied Psychology, 91(3), 594–612. https://doi.org/10.1037/0021-9010.91.3.594
- Sackett, P. R., & Yang, H. (2000). Correction for range restriction: An expanded typology. Journal of Applied Psychology, 85(1), 112–118. https://doi.org/10.1037/0021-9010.85.1.112
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology, 107(11), 2040–2068. https://doi.org/10.1037/apl0000994
- Schmidt, F. L., & Hunter, J. E. (1998). The validity and utility of selection methods in personnel psychology: Practical and theoretical implications of 85 years of research findings. Psychological Bulletin, 124(2), 262–274. https://doi.org/10.1037/0033-2909.124.2.262
- Viswesvaran, C., Ones, D. S., & Schmidt, F. L. (1996). Comparative analysis of the reliability of job performance ratings. Journal of Applied Psychology, 81(5), 557–574. https://doi.org/10.1037/0021-9010.81.5.557
Cytowania BibTeX
@article{chan2004bootstrap, author={Chan, Wai and Chan, Daniel W.-L.}, title={{Bootstrap standard error and confidence intervals for the correlation corrected for range restriction: A simulation study}}, journal={Psychological Methods}, year={2004}, volume={9}, number={3}, pages={369--385}, doi={10.1037/1082-989x.9.3.369}}@article{haynes2003incremental, author={Haynes, Stephen N. and Lench, Heather C.}, title={{Incremental validity of new clinical assessment measures}}, journal={Psychological Assessment}, year={2003}, volume={15}, number={4}, pages={456--466}, doi={10.1037/1040-3590.15.4.456}}@article{hunter2006implications, author={Hunter, John E. and Schmidt, Frank L. and Le, Huy}, title={{Implications of direct and indirect range restriction for meta-analysis methods and findings}}, journal={Journal of Applied Psychology}, year={2006}, volume={91}, number={3}, pages={594--612}, doi={10.1037/0021-9010.91.3.594}}@article{sackett2000correction, author={Sackett, Paul R. and Yang, Hyuckseung}, title={{Correction for range restriction: An expanded typology}}, journal={Journal of Applied Psychology}, year={2000}, volume={85}, number={1}, pages={112--118}, doi={10.1037/0021-9010.85.1.112}}@article{sackett2022revisiting, author={Sackett, Paul R. and Zhang, Charlene and Berry, Christopher M. and Lievens, Filip}, title={{Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range}}, journal={Journal of Applied Psychology}, year={2022}, volume={107}, number={11}, pages={2040--2068}, doi={10.1037/apl0000994}}@article{schmidt1998validity, author={Schmidt, Frank L. and Hunter, John E.}, title={{The validity and utility of selection methods in personnel psychology: Practical and theoretical implications of 85 years of research findings}}, journal={Psychological Bulletin}, year={1998}, volume={124}, number={2}, pages={262--274}, doi={10.1037/0033-2909.124.2.262}}@article{viswesvaran1996comparative, author={Viswesvaran, Chockalingam and Ones, Deniz S. and Schmidt, Frank L.}, title={{Comparative analysis of the reliability of job performance ratings}}, journal={Journal of Applied Psychology}, year={1996}, volume={81}, number={5}, pages={557--574}, doi={10.1037/0021-9010.81.5.557}}