Przykład: firma ochrony mienia i pytanie „czy rekrutacja kogoś pomija?”
Fikcyjna firma ochrony mienia w 2025 r. przyjmowała kandydatów na dwa stanowiska: pracownik ochrony obiektu i operator centrum monitoringu. Rekrutacja ma cztery etapy: wymagania formalne, test sprawności fizycznej (u operatorów – test spostrzegawczości przy monitorach), rozmowę z kierownikiem i ofertę z podpisaniem umowy. Dział kadr zapisuje płeć i wiek kandydatów w czterech grupach: 18–29, 30–44, 45–59 i 60+.
Na stanowisko ochrony obiektu zgłosiło się 1140 osób (950 mężczyzn i 190 kobiet), przyjęto 301, czyli 26.4%. Zarząd pyta: czy któraś grupa kandydatów przechodzi rekrutację wyraźnie rzadziej – i na którym etapie?
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie (lista przy kodzie). Różnicę wbudowaliśmy tylko w test sprawności: osoby 60+ zdają go z szansą 0.40 zamiast 0.72 (grupa 30–44), a kobiety z szansą o jedną czwartą mniejszą niż mężczyźni w tym samym wieku. Na innych etapach różnią się tylko najmłodsi (nieco słabsza rozmowa i oferta), a u operatorów szanse płci są równe. Po pierwszym uruchomieniu zmieniliśmy dwa parametry: szansę zdania testu sprawności w grupie 60+ z 0.46 na 0.40 i mnożnik dla kobiet z 0.82 na 0.75. Przy pierwotnych wartościach przypadek zatarł różnice – wylosowane wskaźniki wpływu wynosiły 0.95–1.00. Ziarna 718 nie zmienialiśmy. Dane (1380 kandydatów) pobierzesz jako zasada-czterech-piatych-kandydaci-ochrona.csv.
Uwaga o prawie. Reguła czterech piątych pochodzi z praktyki amerykańskiej: stosuje ją Komisja ds. Równych Szans Zatrudnienia (EEOC) w USA (Roth i in., 2006). Traktuj ją jako regułę orientacyjną. Ten wpis opisuje statystykę, nie ocenę prawną – o tym, jak polskie przepisy oceniają różnice w rekrutacji, nie rozstrzyga.
Rysunek 1: odsetki przyjęć i wskaźnik wpływu
Najpierw liczysz odsetek przyjęć w każdej grupie: przyjęci / kandydaci. Potem dzielisz go przez odsetek grupy, która wypadła najlepiej. Wynik to wskaźnik wpływu (impact ratio, iloraz odsetków – to samo co ryzyko względne):
Reguła 4/5 daje sygnał, gdy wskaźnik jest mniejszy niż 0.80 – czyli gdy grupa przechodzi rekrutację rzadziej niż w czterech przypadkach na pięć w porównaniu z grupą najlepszą (Roth i in., 2006).
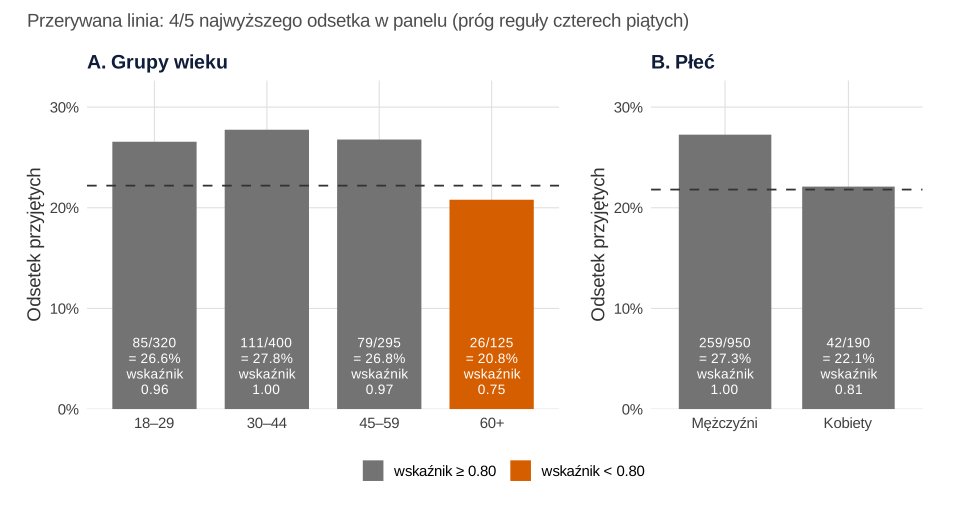
set.seed(718)).Co widać. Najwyższy odsetek ma grupa 30–44 (27.8%). Grupa 60+ ma 20.8%, więc wskaźnik 20.8 / 27.8 = 0.75 – reguła daje sygnał. Kobiety mają 22.1% wobec 27.3% u mężczyzn: wskaźnik 0.81, tuż nad progiem.
Jak może zmylić. Reguła jest progiem „tak/nie”: 0.81 to „w porządku”, 0.79 – „sygnał”, choć różnica jest kosmetyczna. Wykres nie pokazuje też niepewności.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: test różnicy proporcji, test Fishera i przedział dla wskaźnika
Reguła 4/5 mówi, czy różnica jest duża. Nie mówi, czy da się ją odróżnić od przypadku. Do tego służy test dla dwóch proporcji (test z, równoważny chi-kwadrat bez poprawki), a przy małych liczbach – test dokładny Fishera. Obie metody często dają rozbieżne odpowiedzi, bo jedna mierzy istotność praktyczną, a druga statystyczną (Morris i Lobsenz, 2000).
Najwięcej mówi przedział ufności dla samego wskaźnika (Morris i Lobsenz, 2000). Najprostszy liczy się na logarytmie ilorazu (Katz i in., 1978):
x to przyjęci, n – kandydaci, 1 – grupa porównywana, 2 – grupa odniesienia. Ten przedział działa dobrze dopiero w dużych próbach; lepsze metody dla małych prób porównują Fagerland i in. (2015), a dla różnicy odsetków – hasło o przedziale Newcombe’a.
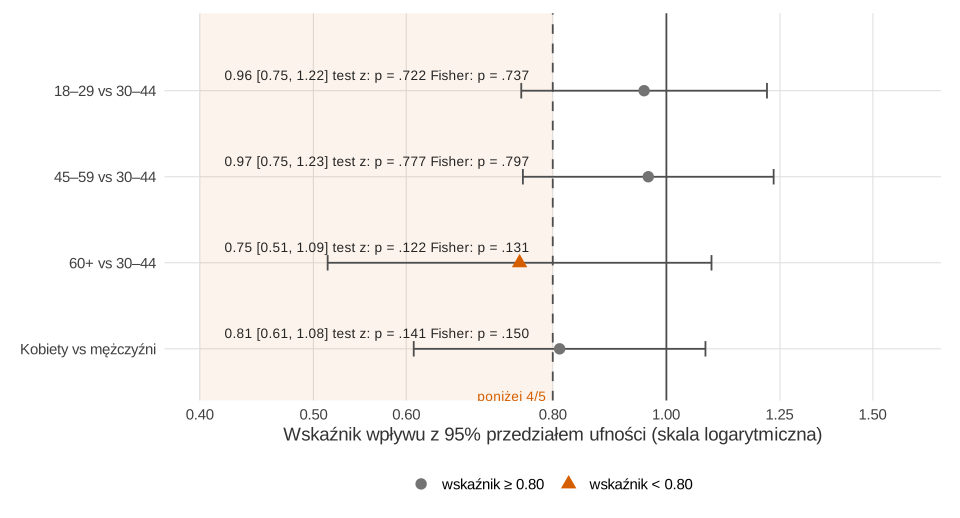
set.seed(718)).Co widać. Grupa 60+ ma 6.95 punktu procentowego mniej przyjęć niż grupa 30–44, z = −1.54, p = .122 (Fisher: p = .131). Przedział dla wskaźnika [0.51, 1.09] obejmuje zarówno wartości poniżej 0.80, jak i 1 (brak różnicy). U kobiet podobnie: 0.81 [0.61, 1.08], p = .141. Reguła mówi „sygnał” dla 60+, test – „nie wiadomo”, a przedział pokazuje dlaczego: danych jest za mało, by rozstrzygnąć w którąkolwiek stronę.
Jak może zmylić. „Nieistotne” nie znaczy „brak różnicy”. Wiemy, że różnicę wbudowaliśmy, a test jej nie potwierdził – to błąd II rodzaju. Test Fishera ma tu nieco wyższe p; przy małych próbach jest zachowawczy (o wyborze testu: chi-kwadrat czy test Fishera).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: kiedy reguła i test się nie zgadzają? Symulacja
Żeby zobaczyć, jak obie metody zachowują się „średnio”, symulujemy 10 000 rekrutacji dla każdej liczebności: mniejsza grupa od 10 do 1000 kandydatów, większa – 4 razy liczniejsza. W scenariuszu A obie grupy mają naprawdę 30% przyjęć, w scenariuszu B mniejsza ma 27% (wskaźnik 0.90). Sygnał liczymy tylko wtedy, gdy mniejsza grupa wypada gorzej. Błąd Monte Carlo każdego odsetka nie przekracza 0.5 punktu procentowego.
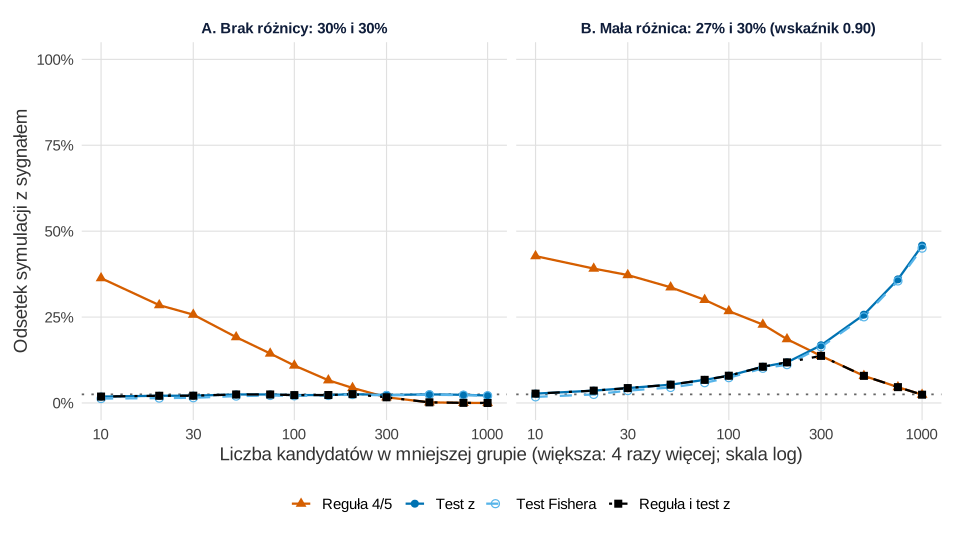
set.seed(7181)).Co widać. Gdy różnicy nie ma (A), reguła przy 10 kandydatach w mniejszej grupie daje fałszywy alarm w 36.3% rekrutacji, przy 100 – w 10.9%, a dopiero od ok. 300 rzadziej niż test. Test z trzyma się poziomu 1.9–2.6% (oczekiwane 2.5%, bo liczymy tylko różnice na niekorzyść mniejszej grupy). Gdy różnica jest mała (B), role się odwracają: przy 1000 kandydatach test wskazuje ją w 45.8% rekrutacji, a reguła – w 2.4%. To samo pokazali Roth i in. (2006): reguła często daje fałszywe sygnały, a dodanie testu usuwa wiele z nich.
Jak może zmylić. Wyniki zależą od odsetka przyjęć (tu 30%) i proporcji grup (1 : 4); przy niższym odsetku przyjęć reguła myli się częściej.
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: moc wykrycia realnej różnicy
Teraz różnica jest realna: 21% wobec 30% przyjęć (wskaźnik 0.70). Ile kandydatów trzeba, żeby ją wykryć? To pytanie o moc testu.
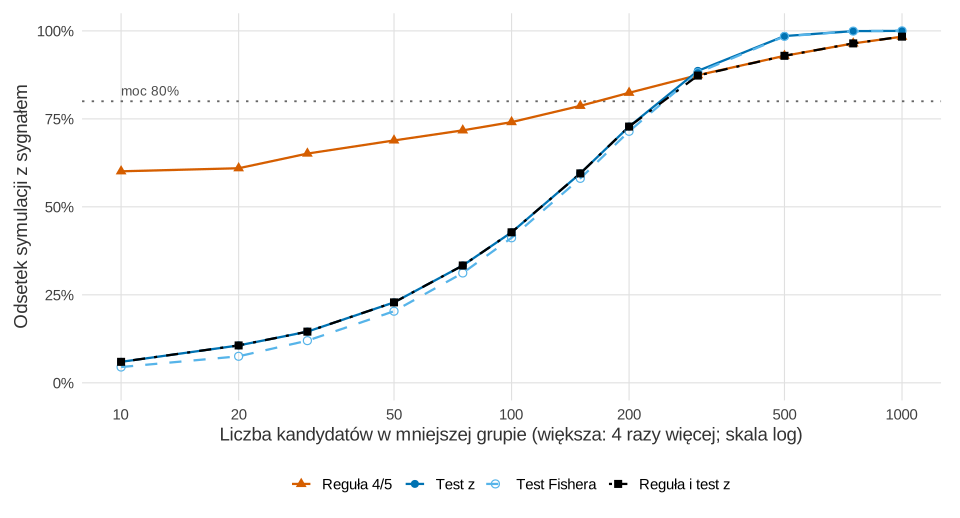
set.seed(7182)).Co widać. Test z osiąga moc 80% dopiero przy ok. 300 kandydatach w mniejszej grupie (88.6%; przy 200 – 72.8%). Przy 100 kandydatach wykrywa różnicę w 42.8% rekrutacji, Fisher – w 41.2%. Mała moc w typowych rekrutacjach to główny wniosek wcześniejszych badań (Morris i Lobsenz, 2000; Collins i Morris, 2008). Kobiet było u nas 190, osób 60+ – 125: nawet duża różnica miała szansę zostać przeoczona.
Jak może zmylić. Wysoka „moc” reguły przy 10 kandydatach (60.1%) to nie zaleta – w scenariuszu A ta sama reguła alarmowała w 36.3% bez żadnej różnicy. Reguła reaguje na szum. Collins i Morris (2008) nie zalecają testu Fishera ani poprawki Yatesa: są zbyt zachowawcze i tracą moc.
Podpis do pracy:
Zdanie do Metody:
Rysunek 5: który etap rekrutacji odpowiada za różnicę?
Wynik końcowy to iloczyn etapów, jak w lejku konwersji. Na każdym etapie liczymy odsetek przechodzących wśród tych, którzy do niego doszli, i wskaźnik wpływu. W symulacjach wieloetapowej selekcji niektóre układy etapów znacznie lepiej od innych godziły jakość przyjętych z odsetkiem przyjęć grup mniejszościowych (Finch i in., 2009).
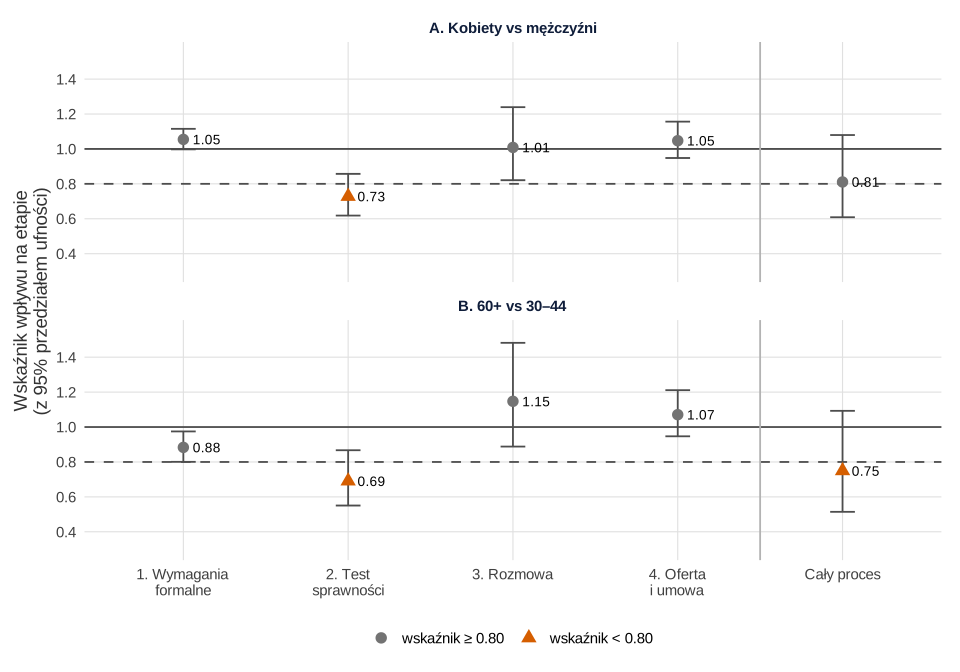
set.seed(718)).Co widać. Różnica powstaje w teście sprawności. Zdało go 48.2% kobiet (82 ze 170) wobec 66.3% mężczyzn: wskaźnik 0.73, 95% CI [0.62, 0.86], p < .001. W grupie 60+ – 45.9% wobec 66.5%: 0.69 [0.55, 0.87], p < .001. Różnica na etapie jest większa niż w całym procesie, więc test ją wykrywa.
Jak może zmylić. Grupa 60+ ma też niższy odsetek na etapie formalnym: 78.4% (98 ze 125) wobec 88.8% (355 z 400), p = .003. Tu różnicy nie wbudowaliśmy – to przypadek. Przy dziesięciu testach (5 etapów × 2 porównania) taki wynik nie dziwi; to problem wielokrotnych porównań. Sygnał na etapie to powód, by sprawdzić etap, a nie dowód.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: jak policzyć wskaźnik wpływu – karta
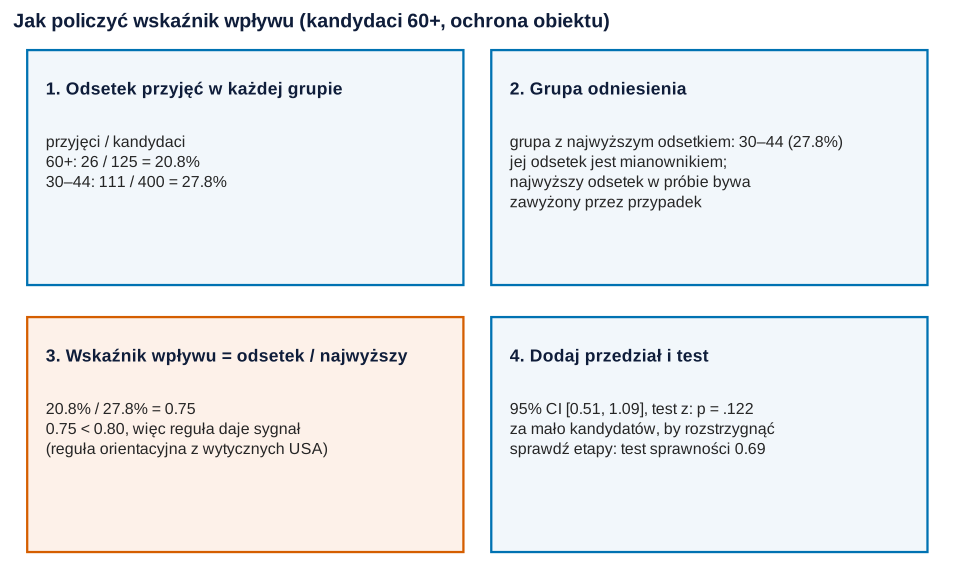
Co widać. Krok 4 decyduje, czy sygnał z kroku 3 jest czymś więcej niż szumem.
Jak może zmylić. Grupa „najlepsza” jest wybrana po fakcie, więc jej odsetek jest zawyżony – to klątwa zwycięzcy (zob. pułapki).
Podpis do pracy:
Co z tym zrobić w firmie
- Licz wskaźnik, przedział i test razem. Sam wskaźnik 0.75 nic nie rozstrzyga przy 125 kandydatach; przedział [0.51, 1.09] mówi uczciwie: „za mało danych”.
- Szukaj etapu, nie winnego. W przykładzie różnicę tworzy test sprawności. Sprawdź, czy jego normy odpowiadają zadaniom na stanowisku ochrony obiektu i czy test przewiduje pracę – metodę opisuje wpis o trafności testu rekrutacyjnego.
- Zbieraj dane dłużej. Przy mocy 42.8% dla 100 kandydatów jeden rok to za mało. Łącz lata lub oddziały – ale osobno dla każdego stanowiska.
- Ustal plan analizy z góry. Zapisz grupy, porównania, grupę odniesienia i poprawkę na wiele porównań, zanim zobaczysz wyniki.
- Nie traktuj wyniku jako opinii prawnej. Statystyka wskazuje, gdzie patrzeć; ocenę prawną zostaw specjalistom.
Jak opisać w pracy
Podaj liczebności, odsetki, wskaźnik z przedziałem, test i jego moc. Ogólne wskazówki: statystyka w pracy z zarządzania i ekonomii, a o porównaniu dwóch odsetków krok po kroku – jak porównać odsetki w dwóch grupach.
| Porównanie | Odsetki przyjęć (%) | Wskaźnik wpływu [95% CI] | p (test z) | p (Fisher) |
|---|---|---|---|---|
| 18–29 vs 30–44 | 26.6 vs 27.8 | 0.96 [0.75, 1.22] | .722 | .737 |
| 45–59 vs 30–44 | 26.8 vs 27.8 | 0.97 [0.75, 1.23] | .777 | .797 |
| 60+ vs 30–44 | 20.8 vs 27.8 | 0.75 [0.51, 1.09] | .122 | .131 |
| Kobiety vs mężczyźni | 22.1 vs 27.3 | 0.81 [0.61, 1.08] | .141 | .150 |
Kod R: wskaźnik wpływu, testy, symulacje i lejek etapów
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję minus(), z których korzystają następne. Przepisy 2–8 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(718)), 4 (set.seed(7181)), 5 (set.seed(7182)) i 7 (set.seed(7183)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: liczbę kandydatów w grupach (mężczyźni 260, 330, 250, 110; kobiety 60, 70, 45, 15 w grupach 18–29, 30–44, 45–59, 60+), szanse przejścia etapów (wymagania formalne 0.85; test sprawności 0.74, 0.72, 0.64 i 0.40, u kobiet × 0.75; rozmowa 0.55 u najmłodszych i 0.62 u pozostałych; oferta 0.85 i 0.90), stanowisko operatora (90 mężczyzn, 150 kobiet; etapy 0.85, 0.30, 0.50, 0.90 bez różnic), odsetki w symulacjach (30%, 27% i 21%), proporcję grup 1 : 4 i 10 000 powtórzeń. Po pierwszym uruchomieniu zmieniono dwa parametry: szansę zdania testu sprawności w grupie 60+ z 0.46 na 0.40 i mnożnik dla kobiet z 0.82 na 0.75 (przy pierwotnych wartościach wylosowane wskaźniki wynosiły 0.95–1.00). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: 1380 kandydatów, dwa stanowiska, cztery etapy
R
# Przepis 1. Fikcyjna firma ochrony mienia: kandydaci na dwa stanowiska i cztery etapy rekrutacji w 2025 r.
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Bez sygnału" = "grey45", "Sygnał" = "#D55E00", "Reguła 4/5" = "#D55E00", "Test z" = "#0072B2",
         "Test Fishera" = "#56B4E9", "Reguła i test z" = "#000000")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie. Stanowisko 1: pracownik ochrony obiektu.
wiek <- c("18–29", "30–44", "45–59", "60+")
n_m <- c(260, 330, 250, 110)                         # liczba kandydatów: mężczyźni wg wieku
n_k <- c(60, 70, 45, 15)                             # liczba kandydatek: kobiety wg wieku
p_formalny <- 0.85                                   # etap 1: wymagania formalne (dla wszystkich tak samo)
p_sprawnosc <- c(0.74, 0.72, 0.64, 0.40)             # etap 2: test sprawności fizycznej (mężczyźni)
mnoznik_k <- 0.75                                    # kobiety: szansa zdania testu sprawności × 0.75
p_rozmowa <- c(0.55, 0.62, 0.62, 0.62)               # etap 3: rozmowa z kierownikiem obiektu
p_oferta <- c(0.85, 0.90, 0.90, 0.90)                # etap 4: oferta przyjęta i umowa podpisana

set.seed(718)
ochrona <- data.frame(stanowisko = "Ochrona obiektu",
                      plec = rep(c("Mężczyźni", "Kobiety"), c(sum(n_m), sum(n_k))),
                      wiek = factor(c(rep(wiek, n_m), rep(wiek, n_k)), levels = wiek))
g <- as.integer(ochrona$wiek); k <- ochrona$plec == "Kobiety"
ochrona$etap1 <- rbinom(nrow(ochrona), 1, p_formalny)
ochrona$etap2 <- ochrona$etap1 * rbinom(nrow(ochrona), 1, p_sprawnosc[g] * ifelse(k, mnoznik_k, 1))
ochrona$etap3 <- ochrona$etap2 * rbinom(nrow(ochrona), 1, p_rozmowa[g])
ochrona$etap4 <- ochrona$etap3 * rbinom(nrow(ochrona), 1, p_oferta[g])

# Stanowisko 2: operator centrum monitoringu (do pułapki z paradoksem Simpsona) – szanse równe dla płci
n_op <- c("Mężczyźni" = 90, "Kobiety" = 150)
operator <- data.frame(stanowisko = "Operator monitoringu",
                       plec = rep(names(n_op), n_op),
                       wiek = factor(sample(wiek, sum(n_op), replace = TRUE, prob = c(.35, .35, .2, .1)), levels = wiek))
operator$etap1 <- rbinom(nrow(operator), 1, 0.85)
operator$etap2 <- operator$etap1 * rbinom(nrow(operator), 1, 0.30)   # test spostrzegawczości przy monitorach
operator$etap3 <- operator$etap2 * rbinom(nrow(operator), 1, 0.50)
operator$etap4 <- operator$etap3 * rbinom(nrow(operator), 1, 0.90)

kandydaci <- rbind(ochrona, operator)
kandydaci$id <- seq_len(nrow(kandydaci))
kandydaci$przyjety <- kandydaci$etap4
kandydaci <- kandydaci[, c("id", "stanowisko", "plec", "wiek", "etap1", "etap2", "etap3", "etap4", "przyjety")]
write.csv(kandydaci, "zasada-czterech-piatych-kandydaci-ochrona.csv", row.names = FALSE, fileEncoding = "UTF-8")

ochrona <- subset(kandydaci, stanowisko == "Ochrona obiektu")
c(kandydaci = nrow(kandydaci), ochrona_obiektu = nrow(ochrona), operator = nrow(operator),
  przyjeci_ochrona = sum(ochrona$przyjety), przyjeci_operator = sum(operator$etap4))
round(100 * mean(ochrona$przyjety), 1)               # odsetek przyjęć na stanowisku ochrony obiektu (%)
Wynik w R
        kandydaci   ochrona_obiektu          operator  przyjeci_ochrona przyjeci_operator
             1380              1140               240               301                28
[1] 26.4
2. Odsetki przyjęć i wskaźnik wpływu: Rysunek 1
R
# Przepis 2. Odsetki przyjęć w grupach i wskaźnik wpływu (impact ratio): Rysunek 1
library(patchwork)

odsetki <- function(dane, grupa) {
  t <- aggregate(przyjety ~ g, data = data.frame(g = dane[[grupa]], przyjety = dane$przyjety),
                 FUN = function(x) c(n = length(x), x = sum(x)))
  t <- data.frame(grupa = t$g, n = t$przyjety[, "n"], przyjeci = t$przyjety[, "x"])
  t$odsetek <- t$przyjeci / t$n
  t$wskaznik <- t$odsetek / max(t$odsetek)           # wskaźnik wpływu: odsetek grupy / najwyższy odsetek
  t
}
tab_wiek <- odsetki(ochrona, "wiek")
tab_plec <- odsetki(ochrona, "plec")
tab_plec$grupa <- factor(tab_plec$grupa, levels = c("Mężczyźni", "Kobiety"))
tab_plec <- tab_plec[order(tab_plec$grupa), ]
print(transform(rbind(tab_wiek, tab_plec), odsetek = round(100 * odsetek, 1), wskaznik = round(wskaznik, 3)),
      row.names = FALSE)

rys1 <- function(t, tytul) {
  t$sygnal <- factor(ifelse(t$wskaznik < 0.8, "Sygnał", "Bez sygnału"), levels = c("Bez sygnału", "Sygnał"))
  t$etykieta <- sprintf("%d/%d\n= %.1f%%\nwskaźnik\n%.2f", t$przyjeci, t$n, 100 * t$odsetek, t$wskaznik)
  ggplot(t, aes(grupa, odsetek)) +
    geom_col(aes(fill = sygnal), width = 0.75) +
    geom_hline(yintercept = 0.8 * max(t$odsetek), linetype = "dashed", colour = "grey20") +
    geom_text(aes(y = 0.015, label = etykieta), vjust = 0, size = 3.6, lineheight = 0.95, colour = "white") +
    scale_fill_manual(values = kol, name = NULL, limits = c("Bez sygnału", "Sygnał"),
                      labels = c("Bez sygnału" = "wskaźnik ≥ 0.80", "Sygnał" = "wskaźnik < 0.80")) +
    scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.32),
                       expand = expansion(mult = c(0, 0.02))) +
    labs(title = tytul, x = NULL, y = "Odsetek przyjętych") + motyw
}
p1 <- (rys1(tab_wiek, "A. Grupy wieku") | rys1(tab_plec, "B. Płeć") + guides(fill = "none")) +
  plot_layout(widths = c(4, 2.3), guides = "collect") +
  plot_annotation(subtitle = "Przerywana linia: 4/5 najwyższego odsetka w panelu (próg reguły czterech piątych)") &
  theme(legend.position = "bottom")
p1   # zapis: ggsave("zasada-czterech-piatych-odsetki.svg", p1, width = 10, height = 5.4)
Wynik w R
     grupa   n przyjeci odsetek wskaznik
     18–29 320       85    26.6    0.957
     30–44 400      111    27.8    1.000
     45–59 295       79    26.8    0.965
       60+ 125       26    20.8    0.750
 Mężczyźni 950      259    27.3    1.000
   Kobiety 190       42    22.1    0.811
3. Test z, test Fishera i przedział dla wskaźnika: Rysunek 2
R
# Przepis 3. Test różnicy proporcji, test dokładny Fishera i przedział dla wskaźnika wpływu: Rysunek 2
porownaj <- function(x1, n1, x2, n2) {     # grupa 1 – porównywana, grupa 2 – odniesienia (najwyższy odsetek)
  p1 <- x1 / n1; p2 <- x2 / n2
  ir <- p1 / p2
  se_log <- sqrt(1 / x1 - 1 / n1 + 1 / x2 - 1 / n2) # błąd standardowy log(ilorazu) – metoda Katza
  z <- suppressWarnings(prop.test(c(x1, x2), c(n1, n2), correct = FALSE))  # test z (= chi-kwadrat bez poprawki)
  f <- fisher.test(matrix(c(x1, n1 - x1, x2, n2 - x2), 2))         # test dokładny Fishera
  data.frame(odsetek = 100 * p1, odsetek_odn = 100 * p2, roznica_pp = 100 * (p1 - p2),
             wskaznik = ir, ci_dol = exp(log(ir) - 1.96 * se_log), ci_gora = exp(log(ir) + 1.96 * se_log),
             z = sign(p1 - p2) * sqrt(unname(z$statistic)), p_z = z$p.value, p_fisher = f$p.value)
}
odn <- tab_wiek[which.max(tab_wiek$odsetek), ]       # grupa wieku z najwyższym odsetkiem: 30–44
porownania <- rbind(
  cbind(porownanie = paste(tab_wiek$grupa[-2], "vs 30–44"),
        do.call(rbind, lapply(c(1, 3, 4), function(i) porownaj(tab_wiek$przyjeci[i], tab_wiek$n[i],
                                                            odn$przyjeci, odn$n)))),
  cbind(porownanie = "Kobiety vs mężczyźni",
        porownaj(tab_plec$przyjeci[2], tab_plec$n[2], tab_plec$przyjeci[1], tab_plec$n[1])))
porownania$regula_4_5 <- porownania$wskaznik < 0.8
pokaz <- porownania
num <- sapply(pokaz, is.numeric)
pokaz[num] <- lapply(pokaz[num], round, 3)
pokaz

porownania$porownanie <- factor(porownania$porownanie, levels = rev(porownania$porownanie))
porownania$sygnal <- factor(ifelse(porownania$regula_4_5, "Sygnał", "Bez sygnału"), levels = c("Bez sygnału", "Sygnał"))
porownania$etykieta <- minus(sprintf("%.2f [%.2f, %.2f]   test z: p = %s   Fisher: p = %s",
  porownania$wskaznik, porownania$ci_dol, porownania$ci_gora,
  sub("^0", "", sprintf("%.3f", porownania$p_z)), sub("^0", "", sprintf("%.3f", porownania$p_fisher))))
p2 <- ggplot(porownania, aes(wskaznik, porownanie)) +
  annotate("rect", xmin = 0.4, xmax = 0.8, ymin = -Inf, ymax = Inf, fill = "#D55E00", alpha = 0.08) +
  geom_vline(xintercept = 0.8, linetype = "dashed", colour = "grey30") +
  geom_vline(xintercept = 1, colour = "grey30") +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0.18, orientation = "y", colour = "grey30") +
  geom_point(aes(colour = sygnal, shape = sygnal), size = 3.6) +
  geom_text(aes(x = 0.42, label = etykieta), vjust = -1.1, size = 3.6, colour = "grey15", hjust = 0) +
  annotate("text", x = 0.79, y = 0.45, label = "poniżej 4/5", hjust = 1, size = 3.6, colour = "#D55E00") +
  scale_x_log10(breaks = c(0.4, 0.5, 0.6, 0.8, 1, 1.25, 1.5), limits = c(0.4, 1.6)) +
  scale_colour_manual(values = kol, name = NULL, labels = c("Bez sygnału" = "wskaźnik ≥ 0.80", "Sygnał" = "wskaźnik < 0.80")) +
  scale_shape_manual(values = c("Bez sygnału" = 16, "Sygnał" = 17), name = NULL,
                     labels = c("Bez sygnału" = "wskaźnik ≥ 0.80", "Sygnał" = "wskaźnik < 0.80")) +
  scale_y_discrete(expand = expansion(add = c(0.6, 0.9))) +
  labs(x = "Wskaźnik wpływu z 95% przedziałem ufności (skala logarytmiczna)", y = NULL) + motyw
p2   # zapis: ggsave("zasada-czterech-piatych-test-i-przedzial.svg", p2, width = 10, height = 5.4)
Wynik w R
            porownanie odsetek odsetek_odn roznica_pp wskaznik ci_dol ci_gora      z   p_z p_fisher regula_4_5
1       18–29 vs 30–44  26.562      27.750     -1.188    0.957  0.752   1.218 -0.356 0.722    0.737      FALSE
2       45–59 vs 30–44  26.780      27.750     -0.970    0.965  0.754   1.234 -0.284 0.777    0.797      FALSE
3         60+ vs 30–44  20.800      27.750     -6.950    0.750  0.514   1.093 -1.544 0.122    0.131       TRUE
4 Kobiety vs mężczyźni  22.105      27.263     -5.158    0.811  0.609   1.080 -1.472 0.141    0.150      FALSE
4. Reguła 4/5 a test – symulacja: Rysunek 3
R
# Przepis 4. Reguła 4/5 a test istotności przy różnej liczbie kandydatów (symulacja): Rysunek 3
# Funkcje sygnałów (z nich korzysta też przepis 5)
p_test_z <- function(x1, n1, x2, n2) {               # test z dla dwóch proporcji (wektorowo)
  p <- (x1 + x2) / (n1 + n2)
  z <- (x1 / n1 - x2 / n2) / sqrt(p * (1 - p) * (1 / n1 + 1 / n2))
  ifelse(p %in% c(0, 1), 1, 2 * pnorm(-abs(z)))
}
p_fisher <- function(x1, n1, x2, n2) {               # test dokładny Fishera, liczony raz dla każdej tabeli
  klucz <- paste(x1, x2)
  u <- !duplicated(klucz)
  pu <- mapply(function(a, b) {
    m <- a + b; k <- max(0, m - n2):min(n1, m)
    d <- dhyper(k, n1, n2, m)
    sum(d[d <= dhyper(a, n1, n2, m) * (1 + 1e-7)])
  }, x1[u], x2[u])
  pu[match(klucz, klucz[u])]
}
sygnaly <- function(n_mn, p_mn, p_wk, R = 10000) {   # mniejsza grupa n_mn, większa 4 × n_mn
  n_wk <- 4 * n_mn
  x1 <- rbinom(R, n_mn, p_mn); x2 <- rbinom(R, n_wk, p_wk)
  nizej <- x1 / n_mn < x2 / n_wk                     # sygnał liczymy tylko, gdy mniejsza grupa wypada gorzej
  regula <- x2 > 0 & (x1 / n_mn) / (x2 / n_wk) < 0.8
  test_z <- nizej & p_test_z(x1, n_mn, x2, n_wk) < 0.05
  fisher <- nizej & p_fisher(x1, n_mn, x2, n_wk) < 0.05
  c("Reguła 4/5" = mean(regula), "Test z" = mean(test_z), "Test Fishera" = mean(fisher),
    "Reguła i test z" = mean(regula & test_z))
}
liczebnosci <- c(10, 20, 30, 50, 75, 100, 150, 200, 300, 500, 750, 1000)
scenariusze <- c("A. Brak różnicy: 30% i 30%" = 0.30, "B. Mała różnica: 27% i 30% (wskaźnik 0.90)" = 0.27)

set.seed(7181)
zgodnosc <- do.call(rbind, lapply(names(scenariusze), function(s) do.call(rbind, lapply(liczebnosci, function(n)
  data.frame(scenariusz = s, n = n, metoda = c("Reguła 4/5", "Test z", "Test Fishera", "Reguła i test z"),
             odsetek = sygnaly(n, scenariusze[[s]], 0.30))))))
szer <- reshape(zgodnosc, idvar = c("scenariusz", "n"), timevar = "metoda", direction = "wide")
names(szer) <- sub("odsetek\\.", "", names(szer))
szer[, -(1:2)] <- round(100 * szer[, -(1:2)], 1)
print(szer, row.names = FALSE)
# Błąd Monte Carlo odsetka 50% przy 10 000 powtórzeniach (największy możliwy), w punktach procentowych:
round(100 * sqrt(0.5 * 0.5 / 10000), 2)

zgodnosc$metoda <- factor(zgodnosc$metoda, levels = c("Reguła 4/5", "Test z", "Test Fishera", "Reguła i test z"))
p3 <- ggplot(zgodnosc, aes(n, odsetek, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_hline(yintercept = 0.025, colour = "grey40", linetype = "dotted") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.4) +
  facet_wrap(~scenariusz, ncol = 2) +
  scale_x_log10(breaks = c(10, 30, 100, 300, 1000)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(17, 16, 1, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "dashed", "dotdash"), name = NULL) +
  labs(x = "Liczba kandydatów w mniejszej grupie (większa: 4 razy więcej; skala log)",
       y = "Odsetek symulacji z sygnałem") +
  guides(colour = guide_legend(nrow = 1)) + motyw
p3   # zapis: ggsave("zasada-czterech-piatych-regula-a-test.svg", p3, width = 10, height = 5.6)
Wynik w R
                                 scenariusz    n Reguła 4/5 Test z Test Fishera Reguła i test z
                 A. Brak różnicy: 30% i 30%   10       36.3    1.9          1.3             1.9
                 A. Brak różnicy: 30% i 30%   20       28.5    2.1          1.4             2.1
                 A. Brak różnicy: 30% i 30%   30       25.7    2.1          1.5             2.1
                 A. Brak różnicy: 30% i 30%   50       19.1    2.5          2.0             2.5
                 A. Brak różnicy: 30% i 30%   75       14.4    2.5          2.2             2.5
                 A. Brak różnicy: 30% i 30%  100       10.9    2.3          2.1             2.3
                 A. Brak różnicy: 30% i 30%  150        6.6    2.3          2.2             2.3
                 A. Brak różnicy: 30% i 30%  200        4.4    2.6          2.4             2.6
                 A. Brak różnicy: 30% i 30%  300        1.7    2.3          2.2             1.7
                 A. Brak różnicy: 30% i 30%  500        0.2    2.5          2.4             0.2
                 A. Brak różnicy: 30% i 30%  750        0.0    2.4          2.3             0.0
                 A. Brak różnicy: 30% i 30% 1000        0.0    2.2          2.1             0.0
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)   10       42.7    2.7          1.8             2.7
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)   20       39.1    3.6          2.5             3.6
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)   30       37.2    4.3          3.6             4.3
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)   50       33.7    5.3          4.5             5.3
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)   75       30.0    6.7          5.9             6.7
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)  100       26.7    7.9          7.3             7.9
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)  150       22.8   10.5         10.1            10.5
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)  200       18.6   11.8         11.1            11.8
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)  300       13.7   16.8         16.3            13.7
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)  500        7.9   25.7         25.1             7.9
 B. Mała różnica: 27% i 30% (wskaźnik 0.90)  750        4.6   36.0         35.5             4.6
 B. Mała różnica: 27% i 30% (wskaźnik 0.90) 1000        2.4   45.8         45.1             2.4
[1] 0.5
5. Moc przy wskaźniku 0.70: Rysunek 4
R
# Przepis 5. Moc wykrycia realnej różnicy: 21% i 30% (wskaźnik 0.70): Rysunek 4
# Korzysta z funkcji sygnaly() i wektora liczebnosci z przepisu 4.
set.seed(7182)
moc <- do.call(rbind, lapply(liczebnosci, function(n)
  data.frame(n = n, metoda = c("Reguła 4/5", "Test z", "Test Fishera", "Reguła i test z"),
             odsetek = sygnaly(n, 0.21, 0.30))))
szer_moc <- reshape(moc, idvar = "n", timevar = "metoda", direction = "wide")
names(szer_moc) <- sub("odsetek\\.", "", names(szer_moc))
szer_moc[, -1] <- round(100 * szer_moc[, -1], 1)
print(szer_moc, row.names = FALSE)
# Najmniejsza liczba kandydatów w mniejszej grupie (z siatki), przy której moc testu z ≥ 80%:
min(szer_moc$n[szer_moc$`Test z` >= 80])

moc$metoda <- factor(moc$metoda, levels = c("Reguła 4/5", "Test z", "Test Fishera", "Reguła i test z"))
p4 <- ggplot(moc, aes(n, odsetek, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_hline(yintercept = 0.8, colour = "grey40", linetype = "dotted") +
  annotate("text", x = 10, y = 0.83, label = "moc 80%", hjust = 0, size = 3.6, colour = "grey30") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.4) +
  scale_x_log10(breaks = c(10, 20, 50, 100, 200, 500, 1000)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(17, 16, 1, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "dashed", "dotdash"), name = NULL) +
  labs(x = "Liczba kandydatów w mniejszej grupie (większa: 4 razy więcej; skala log)",
       y = "Odsetek symulacji z sygnałem") +
  guides(colour = guide_legend(nrow = 1)) + motyw
p4   # zapis: ggsave("zasada-czterech-piatych-moc.svg", p4, width = 10, height = 5.4)
Wynik w R
    n Reguła 4/5 Test z Test Fishera Reguła i test z
   10       60.1    6.0          4.5             6.0
   20       61.0   10.6          7.5            10.6
   30       65.1   14.5         12.0            14.5
   50       68.9   22.9         20.3            22.9
   75       71.7   33.3         31.2            33.3
  100       74.1   42.8         41.2            42.8
  150       78.7   59.5         58.1            59.5
  200       82.4   72.8         71.5            72.8
  300       87.4   88.6         88.1            87.3
  500       92.9   98.5         98.4            92.9
  750       96.4   99.9         99.9            96.4
 1000       98.4  100.0        100.0            98.4
[1] 300
6. Wskaźnik wpływu na etapach rekrutacji: Rysunek 5
R
# Przepis 6. Który etap rekrutacji odpowiada za różnicę? Wskaźnik wpływu w lejku etapów: Rysunek 5
# Korzysta z danych ochrona (przepis 1) i funkcji porownaj() (przepis 3).
etapy <- c(etap1 = "1. Wymagania\nformalne", etap2 = "2. Test\nsprawności", etap3 = "3. Rozmowa",
           etap4 = "4. Oferta\ni umowa", calosc = "Cały proces")
lejek <- function(grupa, odniesienie, nazwa) {
  do.call(rbind, lapply(names(etapy), function(e) {
    if (e == "calosc") { wejscie <- rep(TRUE, nrow(ochrona)); wyjscie <- ochrona$etap4 == 1 } else {
      i <- match(e, names(etapy))
      wejscie <- if (i == 1) rep(TRUE, nrow(ochrona)) else ochrona[[paste0("etap", i - 1)]] == 1
      wyjscie <- ochrona[[e]] == 1
    }
    x1 <- sum(wyjscie & wejscie & grupa); n1 <- sum(wejscie & grupa)
    x2 <- sum(wyjscie & wejscie & odniesienie); n2 <- sum(wejscie & odniesienie)
    cbind(porownanie = nazwa, etap = etapy[[e]], x1 = x1, n1 = n1, x2 = x2, n2 = n2, porownaj(x1, n1, x2, n2))
  }))
}
etapy_wynik <- rbind(
  lejek(ochrona$plec == "Kobiety", ochrona$plec == "Mężczyźni", "A. Kobiety vs mężczyźni"),
  lejek(ochrona$wiek == "60+", ochrona$wiek == "30–44", "B. 60+ vs 30–44"))
pokaz <- etapy_wynik[, c("porownanie", "etap", "x1", "n1", "x2", "n2", "odsetek", "odsetek_odn",
                         "wskaznik", "ci_dol", "ci_gora", "p_z")]
pokaz$etap <- gsub("\n", " ", pokaz$etap)
num <- sapply(pokaz, is.numeric)
pokaz[num] <- lapply(pokaz[num], round, 3)
print(pokaz, row.names = FALSE)

etapy_wynik$etap <- factor(etapy_wynik$etap, levels = etapy)
etapy_wynik$sygnal <- factor(ifelse(etapy_wynik$wskaznik < 0.8, "Sygnał", "Bez sygnału"),
                             levels = c("Bez sygnału", "Sygnał"))
p5 <- ggplot(etapy_wynik, aes(etap, wskaznik)) +
  geom_hline(yintercept = 0.8, linetype = "dashed", colour = "grey30") +
  geom_hline(yintercept = 1, colour = "grey30") +
  geom_vline(xintercept = 4.5, colour = "grey70") +
  geom_errorbar(aes(ymin = ci_dol, ymax = ci_gora), width = 0.15, colour = "grey30") +
  geom_point(aes(colour = sygnal, shape = sygnal), size = 3.6) +
  geom_text(aes(label = sprintf("%.2f", wskaznik)), hjust = -0.35, size = 3.6) +
  facet_wrap(~porownanie, ncol = 1) +
  scale_y_continuous(limits = c(0.3, 1.55), breaks = c(0.4, 0.6, 0.8, 1, 1.2, 1.4)) +
  scale_colour_manual(values = kol, name = NULL, labels = c("Bez sygnału" = "wskaźnik ≥ 0.80", "Sygnał" = "wskaźnik < 0.80")) +
  scale_shape_manual(values = c("Bez sygnału" = 16, "Sygnał" = 17), name = NULL,
                     labels = c("Bez sygnału" = "wskaźnik ≥ 0.80", "Sygnał" = "wskaźnik < 0.80")) +
  labs(x = NULL, y = "Wskaźnik wpływu na etapie\n(z 95% przedziałem ufności)") + motyw
p5   # zapis: ggsave("zasada-czterech-piatych-lejek-etapow.svg", p5, width = 10, height = 7)
Wynik w R
              porownanie                  etap  x1  n1  x2  n2 odsetek odsetek_odn wskaznik ci_dol ci_gora   p_z
 A. Kobiety vs mężczyźni 1. Wymagania formalne 170 190 806 950  89.474      84.842    1.055  0.997   1.115 0.097
 A. Kobiety vs mężczyźni    2. Test sprawności  82 170 534 806  48.235      66.253    0.728  0.618   0.857 0.000
 A. Kobiety vs mężczyźni            3. Rozmowa  46  82 297 534  56.098      55.618    1.009  0.821   1.239 0.935
 A. Kobiety vs mężczyźni     4. Oferta i umowa  42  46 259 297  91.304      87.205    1.047  0.948   1.156 0.430
 A. Kobiety vs mężczyźni           Cały proces  42 190 259 950  22.105      27.263    0.811  0.609   1.080 0.141
         B. 60+ vs 30–44 1. Wymagania formalne  98 125 355 400  78.400      88.750    0.883  0.801   0.975 0.003
         B. 60+ vs 30–44    2. Test sprawności  45  98 236 355  45.918      66.479    0.691  0.550   0.867 0.000
         B. 60+ vs 30–44            3. Rozmowa  28  45 128 236  62.222      54.237    1.147  0.888   1.482 0.323
         B. 60+ vs 30–44     4. Oferta i umowa  26  28 111 128  92.857      86.719    1.071  0.947   1.211 0.368
         B. 60+ vs 30–44           Cały proces  26 125 111 400  20.800      27.750    0.750  0.514   1.093 0.122
7. Pułapki: łączenie stanowisk i wiele porównań
R
# Przepis 7. Pułapki: łączenie stanowisk (paradoks Simpsona) i wiele porównań z „najlepszą” grupą
# Korzysta z danych kandydaci (przepis 1), porownaj() (przepis 3) i p_test_z() (przepis 4).
simpson <- do.call(rbind, lapply(list("Ochrona obiektu", "Operator monitoringu",
                                      c("Ochrona obiektu", "Operator monitoringu")), function(s) {
  d <- kandydaci[kandydaci$stanowisko %in% s, ]
  xk <- sum(d$przyjety[d$plec == "Kobiety"]); nk <- sum(d$plec == "Kobiety")
  xm <- sum(d$przyjety[d$plec == "Mężczyźni"]); nm <- sum(d$plec == "Mężczyźni")
  cbind(stanowisko = if (length(s) > 1) "Oba stanowiska razem" else s,
        kobiety = paste0(xk, "/", nk), mezczyzni = paste0(xm, "/", nm), porownaj(xk, nk, xm, nm))
}))
pok <- simpson[, c("stanowisko", "kobiety", "mezczyzni", "odsetek", "odsetek_odn", "wskaznik", "ci_dol", "ci_gora", "p_z")]
num <- sapply(pok, is.numeric)
pok[num] <- lapply(pok[num], round, 3)
print(pok, row.names = FALSE)

# Wiele porównań: 4 grupy wieku o tej samej prawdziwej szansie 26.4%, liczebności jak w danych (320, 400, 295, 125).
# Każdą grupę porównujemy z grupą, która w danej próbie wypadła najlepiej.
set.seed(7183)
n_wiek <- c(320, 400, 295, 125)
R <- 10000
x <- sapply(n_wiek, function(n) rbinom(R, n, 0.264))
p_obs <- sweep(x, 2, n_wiek, "/")
najlepsza <- max.col(p_obs, ties.method = "first")
ir <- p_obs / p_obs[cbind(1:R, najlepsza)]
pz <- sapply(1:4, function(j) p_test_z(x[, j], n_wiek[j], x[cbind(1:R, najlepsza)], n_wiek[najlepsza]))
pz[cbind(1:R, najlepsza)] <- 1                       # grupy nie porównujemy z nią samą
holm <- t(apply(pz, 1, p.adjust, method = "holm"))
round(100 * c(regula_60plus = mean(ir[, 4] < 0.8),
              regula_ktorakolwiek = mean(rowSums(ir < 0.8) > 0),
              test_z_ktorykolwiek = mean(rowSums(pz < 0.05) > 0),
              test_z_holm_ktorykolwiek = mean(rowSums(holm < 0.05) > 0),
              najwyzszy_odsetek_sredni = mean(p_obs[cbind(1:R, najlepsza)])), 1)
Wynik w R
           stanowisko kobiety mezczyzni odsetek odsetek_odn wskaznik ci_dol ci_gora   p_z
      Ochrona obiektu  42/190   259/950  22.105      27.263    0.811  0.609   1.080 0.141
 Operator monitoringu  15/150     13/90  10.000      14.444    0.692  0.345   1.387 0.299
 Oba stanowiska razem  57/340  272/1040  16.765      26.154    0.641  0.495   0.830 0.000
           regula_60plus      regula_ktorakolwiek      test_z_ktorykolwiek test_z_holm_ktorykolwiek
                    19.2                     46.3                     19.8                      5.8
najwyzszy_odsetek_sredni
                    29.4
8. Grafika: karta „jak policzyć wskaźnik wpływu”: Rysunek 6
R
# Przepis 8. Grafika: karta „jak policzyć wskaźnik wpływu” z liczbami z przykładu: Rysunek 6
# Korzysta z tab_wiek (przepis 2), porownania (przepis 3) i etapy_wynik (przepis 6).
g60 <- tab_wiek[tab_wiek$grupa == "60+", ]; g30 <- tab_wiek[tab_wiek$grupa == "30–44", ]
w60 <- porownania[porownania$porownanie == "60+ vs 30–44", ]
e60 <- etapy_wynik[etapy_wynik$porownanie == "B. 60+ vs 30–44" & grepl("sprawności", etapy_wynik$etap), ]
f1 <- function(x) sprintf("%.1f%%", 100 * x)
karty <- data.frame(
  x = c(0, 1, 0, 1), y = c(1, 1, 0, 0),
  naglowek = c("1. Odsetek przyjęć w każdej grupie", "2. Grupa odniesienia",
               "3. Wskaźnik wpływu = odsetek / najwyższy", "4. Dodaj przedział i test"),
  tresc = c(
    sprintf("przyjęci / kandydaci\n60+: %d / %d = %s\n30–44: %d / %d = %s", g60$przyjeci, g60$n, f1(g60$odsetek),
            g30$przyjeci, g30$n, f1(g30$odsetek)),
    sprintf("grupa z najwyższym odsetkiem: 30–44 (%s)\njej odsetek jest mianownikiem;\nnajwyższy odsetek w próbie bywa\nzawyżony przez przypadek",
            f1(g30$odsetek)),
    sprintf("%s / %s = %.2f\n%.2f < 0.80, więc reguła daje sygnał\n(reguła orientacyjna z wytycznych USA)",
            f1(g60$odsetek), f1(g30$odsetek), w60$wskaznik, w60$wskaznik),
    minus(sprintf("95%% CI [%.2f, %.2f], test z: p = %s\nza mało kandydatów, by rozstrzygnąć\nsprawdź etapy: test sprawności %.2f",
            w60$ci_dol, w60$ci_gora, sub("^0", "", sprintf("%.3f", w60$p_z)), e60$wskaznik))))
p6 <- ggplot(karty) +
  geom_rect(aes(xmin = x - 0.47, xmax = x + 0.47, ymin = y - 0.44, ymax = y + 0.44),
            fill = c("#F2F7FB", "#F2F7FB", "#FDF1E9", "#F2F7FB"), colour = c("#0072B2", "#0072B2", "#D55E00", "#0072B2"),
            linewidth = 0.8) +
  geom_text(aes(x = x - 0.43, y = y + 0.32, label = naglowek), hjust = 0, vjust = 1, fontface = "bold",
            size = 4.6, colour = "#0f1d3a") +
  geom_text(aes(x = x - 0.43, y = y + 0.12, label = tresc), hjust = 0, vjust = 1, size = 4.2,
            lineheight = 1.05, colour = "grey15") +
  coord_cartesian(xlim = c(-0.5, 1.5), ylim = c(-0.48, 1.48), expand = FALSE) +
  labs(title = "Jak policzyć wskaźnik wpływu (kandydaci 60+, ochrona obiektu)", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p6   # zapis: ggsave("zasada-czterech-piatych-karta.svg", p6, width = 10, height = 6)
9. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 9. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("bez sygnału – sygnał" = c("grey45", "#D55E00"),
             "reguła 4/5 – test z" = c("#D55E00", "#0072B2"), "test z – test Fishera" = c("#0072B2", "#56B4E9"),
             "reguła 4/5 – reguła i test z" = c("#D55E00", "#000000"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
bez sygnału – sygnał                        76.9         63.4       53.8
reguła 4/5 – test z                        114.6        108.3       91.9
test z – test Fishera                       26.4         24.7       24.6
reguła 4/5 – reguła i test z                93.9         85.4       71.8
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, test z (prop.test), test dokładny Fishera (fisher.test), rozkład hipergeometryczny i poprawka Holma – pakiet stats i funkcje podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Łączenie stanowisk (paradoks Simpsona). Na ochronę obiektu wskaźnik dla kobiet to 0.81 (p = .141), na operatora monitoringu 0.69 [0.35, 1.39] (p = .299; tu różnicy nie wbudowaliśmy). Po złączeniu stanowisk: 57 z 340 kobiet (16.8%) wobec 272 z 1040 mężczyzn (26.2%), wskaźnik 0.64 [0.50, 0.83], p < .001. Kobiety częściej aplikowały na operatora, gdzie przyjmuje się mało osób – łączny wynik miesza płeć ze stanowiskiem. To paradoks Simpsona, znany też z porównań sklepów; zawsze sprawdzaj, czy obraz nie odwraca się w podgrupach (Kievit i in., 2013). Analizuj stanowiska osobno albo warstwowo (test Cochrana–Mantela–Haenszela).
- Wiele porównań z „najlepszą” grupą. Symulacja 10 000 rekrutacji, w których cztery grupy wieku mają tę samą szansę 26.4%: reguła dawała sygnał dla grupy 60+ w 19.2% rekrutacji, a dla którejkolwiek grupy – w 46.3%. Test z wskazywał którąś grupę w 19.8%, z poprawką Holma – w 5.8%. Najwyższy odsetek w próbie wynosił średnio 29.4%, choć prawdziwy to 26.4%.
- Niejasna definicja kandydata. Wszyscy, którzy wysłali CV, czy tylko spełniający wymagania? Wynik zależy od mianownika.
- Grupy o kilku osobach. 15 kandydatek 60+ to za mało na jakąkolwiek regułę; łącz grupy według planu ustalonego przed analizą.
Najczęstsze pytania
Co to jest zasada czterech piątych w rekrutacji?
To reguła orientacyjna z praktyki amerykańskiej (EEOC): jeśli odsetek przyjętych w jakiejś grupie kandydatów jest mniejszy niż 4/5 (80%) odsetka w grupie, która wypadła najlepiej, traktuje się to jako sygnał możliwego niekorzystnego wpływu procesu rekrutacji. Nie jest to test statystyczny ani ocena prawna.
Jak policzyć wskaźnik wpływu (impact ratio)?
Policz odsetek przyjętych w każdej grupie (przyjęci / kandydaci), wybierz grupę z najwyższym odsetkiem i podziel przez niego odsetek każdej grupy. W przykładzie: 20.8% / 27.8% = 0.75 dla grupy 60+. Wynik poniżej 0.80 to sygnał według reguły 4/5; podaj do niego 95% przedział ufności.
Czy reguła 4/5 i test istotności dają ten sam wynik?
Często nie. W symulacji bez prawdziwej różnicy reguła dawała fałszywy sygnał w 36.3% rekrutacji przy 10 kandydatach w mniejszej grupie, a test z – w ok. 2%. Przy 1000 kandydatach i wskaźniku 0.90 test wskazywał różnicę w 45.8% rekrutacji, a reguła w 2.4%. Dlatego warto podawać oba wyniki i przedział.
Test z czy test dokładny Fishera przy małej liczbie kandydatów?
Test Fishera jest zachowawczy i ma mniejszą moc; w badaniach symulacyjnych test z dla dwóch proporcji działał rozsądnie poza bardzo małymi próbami (Collins i Morris, 2008). W przykładzie oba dały zbliżone wyniki (p = .122 i .131). Przy bardzo małych liczbach ważniejszy od wyboru testu jest szeroki przedział ufności.
Ilu kandydatów potrzeba, żeby wykryć różnicę w odsetkach przyjęć?
Dużo. Przy odsetkach 21% i 30% (wskaźnik 0.70) i grupach w proporcji 1 : 4 test z osiągał moc 80% przy ok. 300 kandydatach w mniejszej grupie; przy 100 kandydatach moc wynosiła 42.8%. Przy mniejszej liczbie łącz dane z kilku lat, ale osobno dla każdego stanowiska.
Powiązane hasła
Przeczytaj też
Jak porównać odsetki w dwóch grupach?
Tabela 2 × 2, test chi-kwadrat lub Fishera i różnica w punktach procentowych z 95% CI Newcombe’a – z przykładem w R i wzorem opisu.
Czytaj →PoradnikTrafność testu rekrutacyjnego i korekta Thorndike’a
Test koreluje z oceną pracy tylko na r = .27, bo zatrudniono najlepszych. Korekta Thorndike’a z przedziałem bootstrap, test uwagi i próg – z kodem R.
Czytaj →PoradnikLike-for-like i paradoks Simpsona
Sklepy przy stacjach paliw: sprzedaż porównywalna, indeksy Laspeyresa i Paaschego, efekt mieszanki i średnia ze średnich – pięć rysunków z kodem R.
Czytaj →Analizujesz rekrutację albo piszesz o niej pracę?
Pomożemy policzyć wskaźniki wpływu z przedziałami, dobrać test i liczebność, rozbić wynik na etapy rekrutacji i opisać wszystko tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Collins, M. W., & Morris, S. B. (2008). Testing for adverse impact when sample size is small. Journal of Applied Psychology, 93(2), 463–471. https://doi.org/10.1037/0021-9010.93.2.463
- Fagerland, M. W., Lydersen, S., & Laake, P. (2015). Recommended confidence intervals for two independent binomial proportions. Statistical Methods in Medical Research, 24(2), 224–254. https://doi.org/10.1177/0962280211415469
- Finch, D. M., Edwards, B. D., & Wallace, J. C. (2009). Multistage selection strategies: Simulating the effects on adverse impact and expected performance for various predictor combinations. Journal of Applied Psychology, 94(2), 318–340. https://doi.org/10.1037/a0013775
- Katz, D., Baptista, J., Azen, S. P., & Pike, M. C. (1978). Obtaining confidence intervals for the risk ratio in cohort studies. Biometrics, 34(3), 469–474. https://doi.org/10.2307/2530610
- Kievit, R. A., Frankenhuis, W. E., Waldorp, L. J., & Borsboom, D. (2013). Simpson's paradox in psychological science: A practical guide. Frontiers in Psychology, 4, Article 513. https://doi.org/10.3389/fpsyg.2013.00513 ● Otwarty dostęp
- Morris, S. B., & Lobsenz, R. E. (2000). Significance tests and confidence intervals for the adverse impact ratio. Personnel Psychology, 53(1), 89–111. https://doi.org/10.1111/j.1744-6570.2000.tb00195.x
- Roth, P. L., Bobko, P., & Switzer, F. S. (2006). Modeling the behavior of the 4/5ths rule for determining adverse impact: Reasons for caution. Journal of Applied Psychology, 91(3), 507–522. https://doi.org/10.1037/0021-9010.91.3.507
Cytowania BibTeX
@article{collins2008testing, author={Collins, Michael W. and Morris, Scott B.}, title={{Testing for adverse impact when sample size is small}}, journal={Journal of Applied Psychology}, year={2008}, volume={93}, number={2}, pages={463--471}, doi={10.1037/0021-9010.93.2.463}}@article{fagerland2015recommended, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{Recommended confidence intervals for two independent binomial proportions}}, journal={Statistical Methods in Medical Research}, year={2015}, volume={24}, number={2}, pages={224--254}, doi={10.1177/0962280211415469}}@article{finch2009multistage, author={Finch, David M. and Edwards, Bryan D. and Wallace, J. Craig}, title={{Multistage selection strategies: Simulating the effects on adverse impact and expected performance for various predictor combinations}}, journal={Journal of Applied Psychology}, year={2009}, volume={94}, number={2}, pages={318--340}, doi={10.1037/a0013775}}@article{katz1978obtaining, author={Katz, D. and Baptista, J. and Azen, S. P. and Pike, M. C.}, title={{Obtaining confidence intervals for the risk ratio in cohort studies}}, journal={Biometrics}, year={1978}, volume={34}, number={3}, pages={469--474}, doi={10.2307/2530610}}@article{kievit2013simpson, author={Kievit, Rogier A. and Frankenhuis, Willem E. and Waldorp, Lourens J. and Borsboom, Denny}, title={{Simpson's paradox in psychological science: A practical guide}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={513}, doi={10.3389/fpsyg.2013.00513}}@article{morris2000significance, author={Morris, Scott B. and Lobsenz, Russell E.}, title={{Significance tests and confidence intervals for the adverse impact ratio}}, journal={Personnel Psychology}, year={2000}, volume={53}, number={1}, pages={89--111}, doi={10.1111/j.1744-6570.2000.tb00195.x}}@article{roth2006modeling, author={Roth, Philip L. and Bobko, Philip and Switzer, Fred S.}, title={{Modeling the behavior of the 4/5ths rule for determining adverse impact: Reasons for caution}}, journal={Journal of Applied Psychology}, year={2006}, volume={91}, number={3}, pages={507--522}, doi={10.1037/0021-9010.91.3.507}}