Co robi analiza skupień i czym nie jest
Analiza skupień dzieli osoby na grupy o podobnym wzorcu wyników. To odróżnia ją od analizy czynnikowej i PCA, które grupują zmienne, oraz od analizy dyskryminacyjnej, która zaczyna od znanych grup. W analizie skupień grup nie znasz – metoda sama je proponuje.
I to jest największa pułapka: algorytm zawsze zwróci jakiś podział, także gdy w danych nie ma żadnych grup. Dlatego obok liczenia pokazuję kontrolę: wybór liczby skupień, stabilność, dane bez struktury i walidację na innych zmiennych. Segmentację k-średnich i analizę profili latentnych szerzej omawia wpis segmentacja respondentów, a te same kroki w programie SPSS – analiza skupień w SPSS.
Przykład: jak studenci radzą sobie ze stresem
Przykład (dane symulowane): 240 studentów wypełniło kwestionariusz strategii radzenia sobie ze stresem. Grupujemy na czterech skalach (średnie z pozycji, 1–5): koncentracji na zadaniu, szukaniu wsparcia, koncentracji na emocjach i unikaniu. Płeć i tryb studiów przydadzą się w kroku 2, a odczuwany stres (0–40) i zadowolenie z życia (5–35) – do walidacji. Dane wygenerowano z trzech profili, więc możemy sprawdzić, czy metody odtworzą prawdę. Ziarno danych (set.seed(11)) wybraliśmy spośród 13 sprawdzonych tak, by kryteria liczby skupień się różniły – jak często w prawdziwych badaniach. Plik: analiza-skupien-dane.csv.
Krok 1. Wybierz zmienne, ustandaryzuj je i sprawdź odstające
Zmienne. Wynik zależy przede wszystkim od tego, co włożysz do analizy. Wybierz zmienne z teorii, która mówi, czym mają się różnić typy osób. Nie dorzucaj „na wszelki wypadek” wieku czy stażu – każda zmienna bez struktury grupowej rozmywa skupienia. Zmiennych do walidacji (stres, zadowolenie) nie włączaj.
Standaryzacja. Odległość sumuje różnice na wszystkich zmiennych, więc zmienna o większym rozrzucie waży więcej. Przelicz zmienne na wyniki z (standaryzacja zmiennej, w R scale()). U nas SD wynoszą od 0.90 do 0.97, ale skala 0–40 obok skal 1–5 zdominowałaby podział.
Korelacje. Koncentracja na zadaniu i szukanie wsparcia korelują na poziomie r = .51, a obie z unikaniem ujemnie (−.51 i −.54). Dwie skale mierzące prawie to samo liczą się w odległości podwójnie.
Odstające. Braków nie było. Odległość Mahalanobisa nikogo nie wskazała: próg χ²(4) dla p = .001 to 18.47, a największa wartość – 13.32. Ta miara zakłada jednak jeden środek danych, więc członek małego skupienia może wyglądać na odstającego. Usuwaj błędy i nieuważne odpowiedzi według reguły ustalonej z góry, a nie osoby „nietypowe” (wartości odstające).
Krok 2. Wybierz miarę odległości
Przy zmiennych ilościowych standardem jest odległość euklidesowa na wynikach z. Gdy łączysz skale, kategorie i zmienne 0/1, użyj odległości Gowera – współczynnika, który łączy zmienne różnych typów w jednej mierze (Gower, 1971). W R: daisy(metric = "gower") i grupowanie metodą PAM. Uważaj na wagi: dla zmiennej binarnej różnica wynosi 0 albo 1, dla skali – ułamek zakresu. Gdy dołożyliśmy płeć i tryb studiów, PAM podzieliła osoby głównie według nich: 108 kobiet ze studiów stacjonarnych, 77 mężczyzn i 55 osób ze studiów niestacjonarnych. Zgodność z podziałem według strategii radzenia sobie była zerowa (ARI = .012). Dwie zmienne binarne przejęły analizę.
Krok 3. Metoda hierarchiczna: Ward i dendrogram
Hierarchiczna analiza aglomeracyjna zaczyna od 240 jednoosobowych skupień i w każdym kroku łączy dwa. Ward (1963) zaproponował, by wybierać połączenie najmniej pogarszające funkcję celu – w praktyce najmniej zwiększające sumę kwadratów wewnątrz skupień. W R użyj hclust(d, method = "ward.D2"). Programy różnie implementują algorytm Warda (Murtagh i Legendre, 2014); według dokumentacji R kryterium Warda realizuje opcja "ward.D2", a starsza "ward.D" podana na zwykłych odległościach – nie.
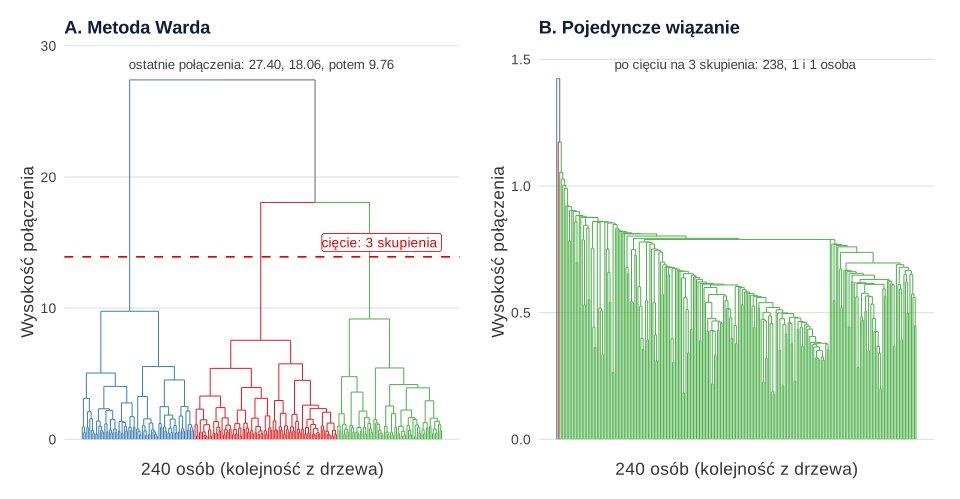
Jak czytać dendrogram. Pionowa oś to wysokość połączenia: im wyżej łączą się gałęzie, tym bardziej różne grupy połączono. Szukaj dużego skoku wysokości. Trzy ostatnie połączenia zaszły na wysokościach 27.40, 18.06 i 9.76 – przejście z trzech skupień do dwóch kosztuje prawie dwa razy więcej niż z czterech do trzech. Cięcie dało skupienia liczące 95, 75 i 70 osób.
Sposób łączenia ma znaczenie. Pojedyncze wiązanie utworzyło „łańcuch”: po cięciu na trzy skupienia – 238, 1 i 1 osoba. Wiązanie pełne dało 118, 71 i 51 osób, średnie – 115, 73 i 52. Korelacja kofenetyczna (zgodność odległości „z drzewa” z rzeczywistymi) wyniosła .705 dla Warda, .707 dla pełnego, .724 dla średniego i .466 dla pojedynczego wiązania – mówi, jak wiernie drzewo oddaje odległości, a nie który podział jest najlepszy. Metodę łączenia wybierz z góry, zamiast sprawdzać wszystkie i brać „najładniejszą” (ogród rozwidlających się ścieżek).
Krok 4. Dopracuj podział metodą k-średnich
Metoda hierarchiczna nie poprawia raz połączonych grup. Dlatego często łączy się dwa etapy: Ward wskazuje liczbę skupień i punkty startowe, a k-średnich przypisuje osoby na nowo do najbliższego środka. Alternatywa to k-średnich z wieloma losowymi startami (nstart = 50), bo pojedynczy start może utknąć w minimum lokalnym. U nas oba warianty dały tę samą sumę kwadratów wewnątrz skupień (WSS = 391.283).
Do odpowiadających sobie skupień Warda i k-średnich trafiło 225 z 240 osób (93.8%). Zgodność podziałów mierzy skorygowany indeks Randa (ARI) – indeks Randa skorygowany na zgodność przypadkową (Hubert i Arabie, 1985): 1 oznacza identyczne podziały, 0 – zgodność na poziomie przypadku. Tu ARI = .832.
Krok 5. Ile skupień? Łokieć, sylwetka i statystyka luki
Żadne kryterium nie rozstrzyga liczby skupień samo, więc z góry zapisz, które porównasz i co zrobisz przy niezgodności (plan analizy statystycznej).
- Łokieć: WSS maleje z każdym skupieniem; szukasz miejsca, po którym spadek słabnie.
- Średnia sylwetka (Rousseeuw, 1987): porównuje bliskość osoby do własnego skupienia i do najbliższego innego; wybierasz najwyższą średnią.
- Statystyka luki (Tibshirani i in., 2001): porównuje spadek rozproszenia wewnątrz skupień z oczekiwanym w danych odniesienia bez skupień. W
clusGap()ustawd.power = 2(tak liczyli autorzy; domyślnie jest 1) i regułę"Tibs2001SEmax": najmniejsze k, dla którego Gap(k) ≥ Gap(k + 1) − SE(k + 1). Tylko luka może wskazać k = 1, czyli brak skupień.
| k | WSS | Średnia sylwetka | Gap(k) | SE |
|---|---|---|---|---|
| 1 | 956.0 | — | 0.509 | 0.033 |
| 2 | 570.5 | .375 | 0.671 | 0.032 |
| 3 | 391.3 | .368 | 0.797 | 0.029 |
| 4 | 345.5 | .321 | 0.733 | 0.029 |
| 5 | 307.1 | .243 | 0.733 | 0.029 |
| 6 | 278.0 | .238 | 0.729 | 0.029 |
Kryteria się nie zgadzają – to normalne. Sylwetka była najwyższa przy dwóch skupieniach (.375), minimalnie przed trzema (.368). Luka wskazała trzy: Gap(3) = 0.797 przekracza Gap(4) − SE = 0.704, a Gap(2) = 0.671 nie osiąga Gap(3) − SE = 0.768. Łokieć też wypada przy trzech: WSS spada z 570.5 do 391.3, a potem tylko do 345.5. Dwa skupienia połączyłyby wszystkich 100 „zadaniowych” z 58 z 65 „emocjonalnych”, choć w rozwiązaniu z trzema skupieniami ich średnie koncentracji na emocjach dzieli 1.73 odchylenia standardowego. Rozstrzygnęły zgoda większości kryteriów, stabilność i interpretowalność – i tak opisz tę decyzję w pracy.
Moc analizy skupień zależy przede wszystkim od separacji grup: Dalmaijer i in. (2022) zalecają ją przy oczekiwanej wyraźnej separacji i 20–30 osobach na podgrupę.
Krok 6. Sprawdź stabilność w podpróbach
Losuj 80% osób, powtórz k-średnich i porównaj nowy podział z podziałem z pełnej próby (na tych samych osobach) za pomocą ARI; powtórz 200 razy. Logika przypomina walidację krzyżową: czy wynik nie jest dopasowany do jednej próby?
| Liczba skupień | Mediana ARI | 5. percentyl ARI |
|---|---|---|
| 2 | 1.000 | .958 |
| 3 | .985 | .956 |
| 4 | .971 | .625 |
| 5 | .902 | .735 |
| 3 – dane bez skupień | .736 | .461 |
Dwa i trzy skupienia odtwarzały się prawie identycznie. Przy czterech w co dwudziestej podpróbie zgodność spadała do .625 lub niżej. Stabilność to jednak warunek konieczny, a nie dowód istnienia grup. Stabilność każdego skupienia osobno (współczynnik Jaccarda) pokazujemy we wpisie o segmentacji.
Kontrola: „ładne” skupienia w danych bez skupień
Najlepszy test procedury to dane, w których na pewno nie ma grup. Wylosowaliśmy 240 osób z jednego wielowymiarowego rozkładu normalnego o tych samych korelacjach i powtórzyliśmy kroki 4–6.
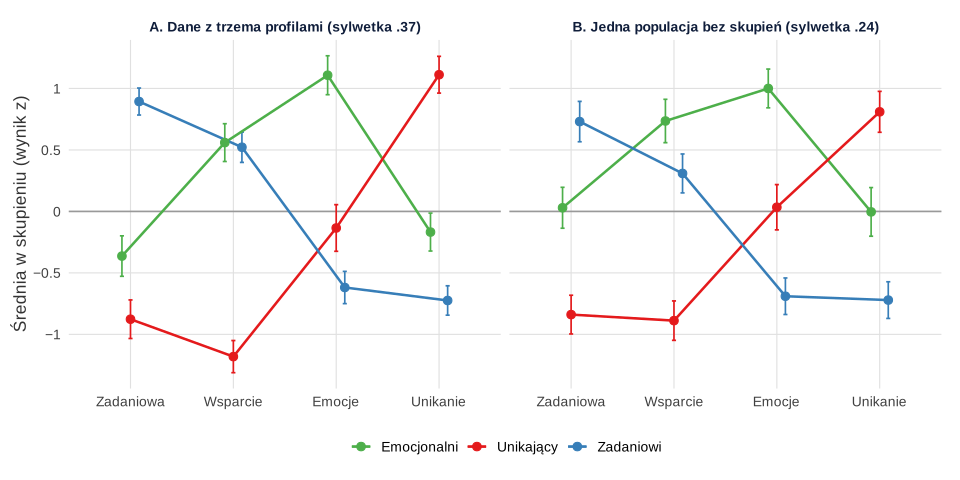
K-średnich podzieliło jednolitą populację na skupienia liczące 84, 62 i 94 osoby, a ich profile wyglądają prawie jak prawdziwe: średnie sięgają od −0.89 do 1.00 odchylenia standardowego. Algorytm tnie wydłużoną przez korelacje chmurę punktów. Ładny wykres profili niczego nie dowodzi.
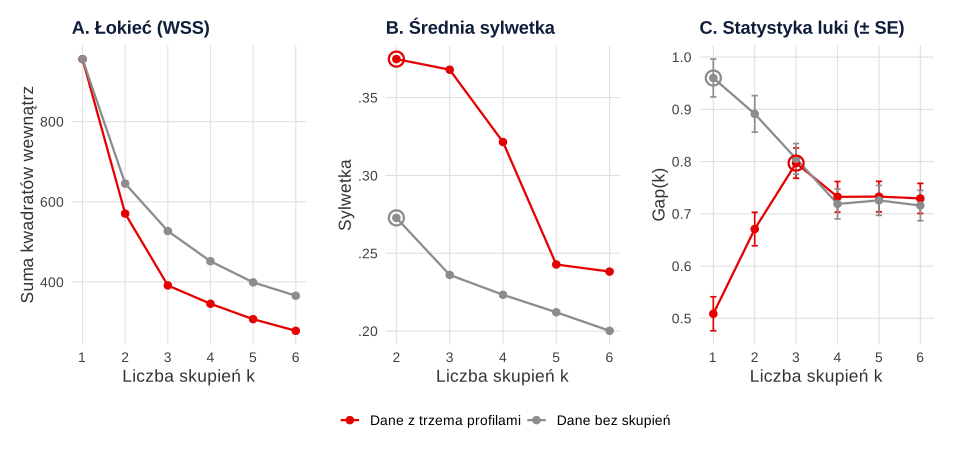
Co zdradziło brak grup? Niska sylwetka (.273 przy dwóch i .236 przy trzech skupieniach), statystyka luki wskazująca k = 1 i słabsza stabilność (mediana ARI .736). Sama sylwetka nie powie „grup nie ma” – w obu zbiorach wskazała dwa skupienia.
Błąd koła. W danych bez skupień ANOVA dla każdej zmiennej grupującej dała F(2, 237) od 91.26 do 100.00, p < .001. Algorytm maksymalizuje różnice na tych zmiennych, więc test na nich zawsze „wyjdzie” i nie dowodzi, że skupienia są prawdziwe. To samo dotyczy MANOVA i analizy dyskryminacyjnej na tych samych zmiennych.
Krok 7. Opisz profile i zweryfikuj je na innych zmiennych
Nazwy nadaj po obejrzeniu profilu (Rysunek 2A). Zadaniowi (n = 100) mają najwyższą koncentrację na zadaniu (0.89 SD powyżej średniej) i niskie unikanie (−0.72). Emocjonalni (n = 65) wyróżniają się koncentracją na emocjach (1.11) i dość częstym szukaniem wsparcia (0.56). Unikający (n = 75) mają wysokie unikanie (1.11) i najrzadziej szukają wsparcia (−1.18). W tabeli podaj średnie w jednostkach skali – wyniki z zależą od próby. Średnia sylwetka w skupieniach wynosiła od .332 do .385, a zgodność z prawdziwymi profilami (znanymi tylko w symulacji) – ARI = .870.
Walidacja zewnętrzna to właściwy test trafności: różnice na zmiennych nieużytych do grupowania, w kierunku przewidzianym przed analizą. Oczekiwaliśmy najniższego stresu i najwyższego zadowolenia u zadaniowych. ANOVA Welcha wykazała różnice w stresie, F(2, 150.05) = 34.33, p < .001, η² = .228, i w zadowoleniu z życia, F(2, 143.81) = 30.06, p < .001, η² = .203; zadaniowi mieli najniższy stres (M = 15.33) i najwyższe zadowolenie (M = 24.01).
Modele mieszanin. W pakiecie mclust liczbę skupień wybiera kryterium BIC, a osoby dostają prawdopodobieństwa przynależności. U nas BIC wybrał model EII z trzema skupieniami, zgodny z k-średnich (ARI = .950). Więcej w haśle analiza profili latentnych.
Jak opisać analizę skupień w pracy
Clatworthy i in. (2005) stwierdzili, że tylko 27% z 59 przejrzanych artykułów z psychologii zdrowia spełniało wszystkie pięć kryteriów rzetelnego raportowania analizy skupień. W rozdziale metodologicznym podaj: zmienne, standaryzację, miarę odległości, metodę łączenia, liczbę startów, kryteria liczby skupień, stabilność i zmienne walidacyjne.
Tabela 1
Średnie (odchylenia standardowe) strategii radzenia sobie ze stresem i zmiennych walidacyjnych w trzech skupieniach
| Zmienna | Zadaniowi (n = 100) | Emocjonalni (n = 65) | Unikający (n = 75) |
|---|---|---|---|
| Zmienne użyte do grupowania (1–5) | |||
| Koncentracja na zadaniu | 4.23 (0.53) | 3.02 (0.64) | 2.53 (0.65) |
| Szukanie wsparcia | 3.87 (0.61) | 3.91 (0.61) | 2.22 (0.55) |
| Koncentracja na emocjach | 2.40 (0.59) | 3.96 (0.57) | 2.84 (0.74) |
| Unikanie | 1.97 (0.59) | 2.51 (0.61) | 3.76 (0.63) |
| Zmienne walidacyjne | |||
| Odczuwany stres (0–40) | 15.33 (6.52) | 22.82 (5.89) | 21.44 (6.15) |
| Zadowolenie z życia (5–35) | 24.01 (4.72) | 20.35 (5.05) | 18.17 (5.37) |
Uwaga. N = 240 (dane symulowane). Skupienia wyodrębniono metodą Warda i k-średnich na standaryzowanych wynikach czterech skal; średnia szerokość sylwetki = .37. Zmiennych walidacyjnych nie użyto do grupowania. ANOVA Welcha: stres F(2, 150.05) = 34.33, p < .001, η2 = .23; zadowolenie F(2, 143.81) = 30.06, p < .001, η2 = .20.
Analiza skupień w R – pełny kod
Kod odtwarza wszystkie liczby z tekstu i tabel. Pobierz plik analiza-skupien-dane.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – kolejne przepisy korzystają z obiektów utworzonych wcześniej. Ziarna losowania w przepisach (2026 dla algorytmów, 7 dla danych bez skupień) ustalono raz, bez dobierania pod wynik; ziarno danych symulowanych (11) wybrano tak, by kryteria liczby skupień się różniły.
1. Dane, standaryzacja i obserwacje odstające
R
# Analiza skupień: strategie radzenia sobie ze stresem u studentów (dane symulowane)
options(width = 100)
library(cluster)
dane <- read.csv("analiza-skupien-dane.csv")
zm   <- c("zadaniowa", "wsparcie", "emocje", "unikanie")   # zmienne do grupowania
nrow(dane); sum(!complete.cases(dane[, zm]))                # liczba osób i osób z brakami
round(rbind(M = colMeans(dane[, zm]), SD = apply(dane[, zm], 2, sd)), 2)
round(cor(dane[, zm]), 2)

# standaryzacja: każda zmienna ma średnią 0 i SD 1, więc waży w odległości tyle samo
z <- scale(dane[, zm])

# obserwacje odstające: odległość Mahalanobisa od środka danych, próg χ²(4) dla p = .001
D2 <- mahalanobis(z, colMeans(z), cov(z))
c(prog = round(qchisq(.999, df = 4), 2), powyzej_progu = sum(D2 > qchisq(.999, df = 4)),
  max_D2 = round(max(D2), 2))
Wynik w R
[1] 240
[1] 0
   zadaniowa wsparcie emocje unikanie
M       3.37     3.37   2.96     2.67
SD      0.96     0.97   0.90     0.98
          zadaniowa wsparcie emocje unikanie
zadaniowa      1.00     0.51  -0.20    -0.51
wsparcie       0.51     1.00   0.15    -0.54
emocje        -0.20     0.15   1.00     0.21
unikanie      -0.51    -0.54   0.21     1.00
         prog powyzej_progu        max_D2
        18.47          0.00         13.32
2. Metoda Warda i inne sposoby łączenia
R
# Hierarchiczna analiza skupień: macierz odległości euklidesowych i cztery sposoby łączenia (kontynuacja: z)
d <- dist(z, method = "euclidean")
metody <- c(Warda = "ward.D2", pelne = "complete", srednie = "average", pojedyncze = "single")
drzewa <- lapply(metody, function(m) hclust(d, method = m))

# korelacja kofenetyczna: jak dobrze drzewo odtwarza odległości między osobami
round(sapply(drzewa, function(h) cor(d, cophenetic(h))), 3)
# liczebności skupień po przecięciu każdego drzewa na trzy skupienia
sapply(drzewa, function(h) sort(as.vector(table(cutree(h, k = 3))), decreasing = TRUE))

# metoda Warda: wysokości ośmiu ostatnich połączeń (duży skok = połączono różne skupienia)
ward <- drzewa$Warda
round(rev(tail(ward$height, 8)), 2)
ward3 <- cutree(ward, k = 3)
table(ward3)
Wynik w R
     Warda      pelne    srednie pojedyncze
     0.705      0.707      0.724      0.466
     Warda pelne srednie pojedyncze
[1,]    95   118     115        238
[2,]    75    71      73          1
[3,]    70    51      52          1
[1] 27.40 18.06  9.76  9.17  7.54  5.75  5.54  5.44
ward3
 1  2  3
75 70 95
3. k-średnich i zgodność z metodą Warda
R
# k-średnich: start ze środków skupień Warda i 50 losowych startów (kontynuacja: z, ward3)
library(mclust)                                      # adjustedRandIndex()
srodki_ward <- apply(z, 2, function(x) tapply(x, ward3, mean))
km_ward <- kmeans(z, centers = srodki_ward)
set.seed(2026)
km3 <- kmeans(z, centers = 3, nstart = 50)
c(WSS_start_Ward = km_ward$tot.withinss, WSS_50_startow = km3$tot.withinss)
table(Ward = ward3, k_srednich = km3$cluster)
round(adjustedRandIndex(ward3, km3$cluster), 3)      # zgodność podziałów (1 = identyczne)
Wynik w R
WSS_start_Ward WSS_50_startow
       391.283        391.283
    k_srednich
Ward  1  2  3
   1 71  0  4
   2  4  6 60
   3  0 94  1
[1] 0.832
4. Łokieć, sylwetka i statystyka luki
R
# Ile skupień? Łokieć (WSS), średnia sylwetka i statystyka luki dla k = 1–6 (kontynuacja: z, d)
set.seed(2026)
rozw <- lapply(1:6, function(k) kmeans(z, centers = k, nstart = 50))
sylw <- sapply(rozw[-1], function(r) mean(silhouette(r$cluster, d)[, "sil_width"]))
set.seed(2026)
luka <- clusGap(z, FUNcluster = kmeans, K.max = 6, B = 200, d.power = 2, nstart = 20, verbose = FALSE)
tab <- data.frame(k = 1:6, WSS = sapply(rozw, `[[`, "tot.withinss"),
                  sylwetka = c(NA, sylw), luka = luka$Tab[, "gap"], SE = luka$Tab[, "SE.sim"])
print(round(tab, 3), row.names = FALSE)
c(sylwetka = which.max(sylw) + 1,
  luka = maxSE(luka$Tab[, "gap"], luka$Tab[, "SE.sim"], method = "Tibs2001SEmax"))
table(k2 = rozw[[2]]$cluster, k3 = km3$cluster)   # co łączy rozwiązanie z dwoma skupieniami
Wynik w R
 k     WSS sylwetka  luka    SE
 1 956.000       NA 0.509 0.033
 2 570.544    0.375 0.671 0.032
 3 391.283    0.368 0.797 0.029
 4 345.521    0.321 0.733 0.029
 5 307.107    0.243 0.733 0.029
 6 278.014    0.238 0.729 0.029
sylwetka     luka
       2        3
   k3
k2    1   2   3
  1   0 100  58
  2  75   0   7
5. Stabilność w podpróbach
R
# Stabilność: 200 podprób po 80% osób, k-średnich od nowa, ARI z podziałem z pełnej próby (kontynuacja: z, rozw)
stabilnosc <- function(k, R = 200, frac = .8) {
  pelny <- rozw[[k]]$cluster
  sapply(seq_len(R), function(r) {
    i <- sample(nrow(z), round(frac * nrow(z)))
    adjustedRandIndex(pelny[i], kmeans(z[i, ], centers = k, nstart = 20)$cluster)
  })
}
set.seed(2026)
ari <- sapply(2:5, stabilnosc)
colnames(ari) <- paste0("k=", 2:5)
round(apply(ari, 2, quantile, probs = c(.05, .50)), 3)   # 5. percentyl i mediana ARI
Wynik w R
      k=2   k=3   k=4   k=5
5%  0.958 0.956 0.625 0.735
50% 1.000 0.985 0.971 0.902
6. Kontrola: dane bez skupień
R
# Kontrola: jedna populacja bez skupień o tych samych korelacjach (kontynuacja: z)
library(MASS)
set.seed(7)
z0 <- scale(mvrnorm(240, mu = rep(0, 4), Sigma = cor(z)))
colnames(z0) <- colnames(z)
d0 <- dist(z0)
set.seed(2026)
rozw0 <- lapply(1:6, function(k) kmeans(z0, centers = k, nstart = 50))
km0 <- rozw0[[3]]
table(km0$cluster)
round(km0$centers, 2)                                  # „profile” w danych bez skupień
sylw0 <- sapply(rozw0[-1], function(r) mean(silhouette(r$cluster, d0)[, "sil_width"]))
round(sylw0, 3)
set.seed(2026)
luka0 <- clusGap(z0, FUNcluster = kmeans, K.max = 6, B = 200, d.power = 2, nstart = 20, verbose = FALSE)
c(sylwetka = which.max(sylw0) + 1,
  luka = maxSE(luka0$Tab[, "gap"], luka0$Tab[, "SE.sim"], method = "Tibs2001SEmax"))
# błąd koła: ANOVA na zmiennych, z których powstały skupienia, „potwierdza” różnice
t(sapply(colnames(z0), function(v) {
  a <- summary(aov(z0[, v] ~ factor(km0$cluster)))[[1]]
  c(F = round(a[1, "F value"], 2), df2 = a[2, "Df"], p = signif(a[1, "Pr(>F)"], 3)) }))
# stabilność trzech „skupień” w podpróbach
set.seed(2026)
ari0 <- sapply(1:200, function(r) { i <- sample(240, 192)
  adjustedRandIndex(km0$cluster[i], kmeans(z0[i, ], centers = 3, nstart = 20)$cluster) })
round(quantile(ari0, c(.05, .50)), 3)
Wynik w R
 1  2  3
84 62 94
  zadaniowa wsparcie emocje unikanie
1     -0.84    -0.89   0.03     0.81
2      0.03     0.74   1.00     0.00
3      0.73     0.31  -0.69    -0.72
[1] 0.273 0.236 0.223 0.212 0.200
sylwetka     luka
       2        1
               F df2        p
zadaniowa 100.00 237 3.24e-32
wsparcie   98.98 237 5.65e-32
emocje     95.79 237 3.25e-31
unikanie   91.26 237 4.08e-30
   5%   50%
0.461 0.736
7. Profil skupień i walidacja zewnętrzna
R
# Profil skupień i walidacja zewnętrzna (kontynuacja: dane, z, d, km3)
dane$skupienie <- km3$cluster
table(dane$skupienie)
round(km3$centers, 2)                                  # średnie wyników z w skupieniach
round(aggregate(dane[, zm], list(skupienie = dane$skupienie), mean), 2)   # średnie w jednostkach skali 1–5
round(aggregate(dane[, zm], list(skupienie = dane$skupienie), sd), 2)     # odchylenia standardowe
round(summary(silhouette(km3$cluster, d))$clus.avg.widths, 3)             # średnia sylwetka w skupieniach
round(adjustedRandIndex(km3$cluster, dane$profil_prawdziwy), 3)          # zgodność z prawdą (tylko w symulacji)

# walidacja zewnętrzna: zmienne, których NIE użyto do grupowania (ANOVA Welcha i η²)
for (v in c("stres", "satysfakcja")) {
  cat("\n==", v, "\n")
  print(round(aggregate(dane[[v]], list(skupienie = dane$skupienie), function(x) c(M = mean(x), SD = sd(x))), 2))
  print(oneway.test(dane[[v]] ~ factor(dane$skupienie)))
  a <- anova(lm(dane[[v]] ~ factor(dane$skupienie)))
  cat("eta2 =", round(a[1, 2] / sum(a[, 2]), 3), "\n")
}
Wynik w R
  1   2   3
 75 100  65
  zadaniowa wsparcie emocje unikanie
1     -0.88    -1.18  -0.13     1.11
2      0.89     0.52  -0.62    -0.72
3     -0.36     0.56   1.11    -0.17
  skupienie zadaniowa wsparcie emocje unikanie
1         1      2.53     2.22   2.84     3.76
2         2      4.23     3.87   2.40     1.97
3         3      3.02     3.91   3.96     2.51
  skupienie zadaniowa wsparcie emocje unikanie
1         1      0.65     0.55   0.74     0.63
2         2      0.53     0.61   0.59     0.59
3         3      0.64     0.61   0.57     0.61
    1     2     3
0.376 0.385 0.332
[1] 0.87

== stres
  skupienie   x.M  x.SD
1         1 21.44  6.15
2         2 15.33  6.52
3         3 22.82  5.89

	One-way analysis of means (not assuming equal variances)

data:  dane[[v]] and factor(dane$skupienie)
F = 34.333, num df = 2.00, denom df = 150.05, p-value = 5.28e-13

eta2 = 0.228

== satysfakcja
  skupienie   x.M  x.SD
1         1 18.17  5.37
2         2 24.01  4.72
3         3 20.35  5.05

	One-way analysis of means (not assuming equal variances)

data:  dane[[v]] and factor(dane$skupienie)
F = 30.057, num df = 2.00, denom df = 143.81, p-value = 1.24e-11

eta2 = 0.203
8. Odległość Gowera i model mieszanin
R
# Dwa warianty: odległość Gowera dla danych mieszanych i model mieszanin (kontynuacja: dane, z, km3)
# 1. Gower: cztery skale + płeć i tryb studiów (zmienne 0/1 jako czynniki), metoda PAM
mieszane <- data.frame(dane[, zm], kobieta = factor(dane$kobieta), niestac = factor(dane$niestacjonarne))
dg <- daisy(mieszane, metric = "gower")
pam3 <- pam(dg, k = 3, diss = TRUE)
table(PAM = pam3$clustering, kobieta = dane$kobieta, niestac = dane$niestacjonarne)
round(adjustedRandIndex(pam3$clustering, km3$cluster), 3)

# 2. Model mieszanin rozkładów normalnych: BIC dla 1–6 skupień
mm <- Mclust(z, G = 1:6, verbose = FALSE)
summary(mm)
round(adjustedRandIndex(mm$classification, km3$cluster), 3)
Wynik w R
, , niestac = 0

   kobieta
PAM   0   1
  1   0   0
  2   0 108
  3  64   0

, , niestac = 1

   kobieta
PAM   0   1
  1  16  39
  2   0   0
  3  13   0

[1] 0.012
----------------------------------------------------
Gaussian finite mixture model fitted by EM algorithm
----------------------------------------------------

Mclust EII (spherical, equal volume) model with 3 components:

 log-likelihood   n df       BIC       ICL
      -1178.644 240 15 -2439.497 -2464.428

Clustering table:
  1   2   3
 75  61 104
[1] 0.95
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakietach ggplot2, patchwork i dendextend i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- cluster (wersja 2.1.8.2): Maechler, M., Rousseeuw, P., Struyf, A., Hubert, M., & Hornik, K. (2026). cluster: Cluster analysis basics and extensions (R package version 2.1.8.2) [Computer software]. https://CRAN.R-project.org/package=cluster
- mclust (wersja 6.1.2): Scrucca, L., Fraley, C., Murphy, T. B., & Raftery, A. E. (2023). Model-based clustering, classification, and density estimation using mclust in R. Chapman and Hall/CRC. https://doi.org/10.1201/9781003277965
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- dendextend (wersja 1.19.1): Galili, T. (2015). dendextend: An R package for visualizing, adjusting and comparing trees of hierarchical clustering. Bioinformatics, 31(22), 3718–3720. https://doi.org/10.1093/bioinformatics/btv428
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Testowanie skupień na zmiennych, z których powstały – ANOVA „potwierdzi” różnice nawet w danych bez grup.
- Brak standaryzacji zmiennych w różnych jednostkach.
- Zmienne binarne w odległości Gowera „z rozpędu” – mogą przejąć cały podział.
- Metoda łączenia wybrana po obejrzeniu wyników albo pojedyncze wiązanie bez uzasadnienia.
- Jeden start k-średnich i brak ziarna losowania.
- Liczba skupień z jednego kryterium albo „bo tak przewiduje hipoteza” – pokaż kilka kryteriów i ich niezgodność.
- Skupienia jako naturalne typy ludzi. Pisz „wyodrębniono trzy profile”, a nie „istnieją trzy typy studentów”.
Najczęstsze pytania
Jak zrobić analizę skupień w R krok po kroku?
Ustandaryzuj zmienne (scale()), policz odległości (dist()), zbuduj dendrogram metodą Warda (hclust(d, "ward.D2")), a podział dopracuj funkcją kmeans() z wieloma startami (nstart = 50). Liczbę skupień wybierz, porównując łokieć, sylwetkę (cluster::silhouette) i statystykę luki (cluster::clusGap), a na koniec sprawdź stabilność w podpróbach i różnice na zmiennych spoza analizy.
Którą metodę łączenia wybrać w hierarchicznej analizie skupień?
W badaniach psychologicznych najczęściej wybiera się metodę Warda, bo tworzy zwarte skupienia o zbliżonej wielkości; w R odpowiada jej method = "ward.D2". Pojedyncze wiązanie łatwo tworzy „łańcuch” i skupienia złożone z jednej osoby. Metodę łączenia wybierz i uzasadnij przed analizą, zamiast sprawdzać kilka i zostawiać tę z najładniejszym wynikiem.
Co zrobić, gdy łokieć, sylwetka i statystyka luki wskazują różną liczbę skupień?
To częsta sytuacja – sylwetka zwykle premiuje zgrubny podział na dwie grupy. Rozstrzygnij na podstawie zgody większości kryteriów, dendrogramu, stabilności w podpróbach i interpretowalności profili, a w pracy napisz wprost, które kryterium wskazało inną liczbę i dlaczego wybrałeś dane rozwiązanie.
Jak sprawdzić, czy skupienia są stabilne?
Losuj wielokrotnie podpróbę (np. 80% osób), powtórz analizę i porównaj nowy podział z podziałem z pełnej próby skorygowanym indeksem Randa (ARI; w R mclust::adjustedRandIndex). Mediana bliska 1 i wysoki 5. percentyl świadczą o stabilności, ale stabilność nie dowodzi istnienia grup – algorytm potrafi stabilnie dzielić także jednolitą chmurę punktów.
Czy różnice między skupieniami w ANOVA potwierdzają, że skupienia są prawdziwe?
Nie, jeśli testujesz zmienne, z których skupienia powstały. Algorytm maksymalizuje różnice na tych zmiennych, więc ANOVA będzie istotna nawet w danych bez żadnych grup. Trafność skupień sprawdzaj na innych zmiennych, przewidzianych przed analizą.
Powiązane hasła
Przeczytaj też
Analiza skupień w marketingu – segmentacja klientów
Księgarnia internetowa, 1500 klientów i RFM: przekształcenia, liczba segmentów, mapa PCA, karty segmentów z działaniami i stabilność – sześć rysunków z kodem R.
Czytaj →PoradnikAnaliza skupień w SPSS krok po kroku
Hierarchical Cluster, K-Means i TwoStep od pliku .sav po opis APA: standaryzacja, metoda Warda, przegląd aglomeracji, Final Cluster Centers i opisowe testy F.
Czytaj →PoradnikSegmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →PoradnikAnaliza dyskryminacyjna w SPSS krok po kroku
Discriminant od pliku .sav po opis APA: test M Boxa, Eigenvalues, lambda Wilksa, macierz struktury, centroidy, a priori i trafność z walidacji krzyżowej.
Czytaj →Robisz analizę skupień do pracy dyplomowej?
Pomożemy dobrać zmienne, metodę i liczbę skupień, sprawdzimy stabilność i walidację oraz opiszemy wyniki tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Clatworthy, J., Buick, D., Hankins, M., Weinman, J., & Horne, R. (2005). The use and reporting of cluster analysis in health psychology: A review. British Journal of Health Psychology, 10(3), 329–358. https://doi.org/10.1348/135910705X25697
- Dalmaijer, E. S., Nord, C. L., & Astle, D. E. (2022). Statistical power for cluster analysis. BMC Bioinformatics, 23(1), Article 205. https://doi.org/10.1186/s12859-022-04675-1 ● Otwarty dostęp
- Gower, J. C. (1971). A general coefficient of similarity and some of its properties. Biometrics, 27(4), 857–871. https://doi.org/10.2307/2528823
- Hubert, L., & Arabie, P. (1985). Comparing partitions. Journal of Classification, 2(1), 193–218. https://doi.org/10.1007/bf01908075
- Murtagh, F., & Legendre, P. (2014). Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion? Journal of Classification, 31(3), 274–295. https://doi.org/10.1007/s00357-014-9161-z ● Otwarty dostęp: pełny tekst
- Rousseeuw, P. J. (1987). Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65. https://doi.org/10.1016/0377-0427(87)90125-7 ● Otwarty dostęp
- Tibshirani, R., Walther, G., & Hastie, T. (2001). Estimating the number of clusters in a data set via the gap statistic. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 63(2), 411–423. https://doi.org/10.1111/1467-9868.00293
- Ward, J. H. (1963). Hierarchical grouping to optimize an objective function. Journal of the American Statistical Association, 58(301), 236–244. https://doi.org/10.1080/01621459.1963.10500845
Cytowania BibTeX
@article{clatworthy2005use, author={Clatworthy, Jane and Buick, Deanna and Hankins, Matthew and Weinman, John and Horne, Robert}, title={{The use and reporting of cluster analysis in health psychology: A review}}, journal={British Journal of Health Psychology}, year={2005}, volume={10}, number={3}, pages={329--358}, doi={10.1348/135910705x25697}}@article{dalmaijer2022statistical, author={Dalmaijer, Edwin S. and Nord, Camilla L. and Astle, Duncan E.}, title={{Statistical power for cluster analysis}}, journal={BMC Bioinformatics}, year={2022}, volume={23}, number={1}, eid={205}, doi={10.1186/s12859-022-04675-1}}@article{gower1971general, author={Gower, John C.}, title={{A general coefficient of similarity and some of its properties}}, journal={Biometrics}, year={1971}, volume={27}, number={4}, pages={857--871}, doi={10.2307/2528823}}@article{hubert1985comparing, author={Hubert, Lawrence and Arabie, Phipps}, title={{Comparing partitions}}, journal={Journal of Classification}, year={1985}, volume={2}, number={1}, pages={193--218}, doi={10.1007/bf01908075}}@article{murtagh2014ward, author={Murtagh, Fionn and Legendre, Pierre}, title={{Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion?}}, journal={Journal of Classification}, year={2014}, volume={31}, number={3}, pages={274--295}, doi={10.1007/s00357-014-9161-z}}@article{rousseeuw1987silhouettes, author={Rousseeuw, Peter J.}, title={{Silhouettes: A graphical aid to the interpretation and validation of cluster analysis}}, journal={Journal of Computational and Applied Mathematics}, year={1987}, volume={20}, pages={53--65}, doi={10.1016/0377-0427(87)90125-7}}@article{tibshirani2001estimating, author={Tibshirani, Robert and Walther, Guenther and Hastie, Trevor}, title={{Estimating the number of clusters in a data set via the gap statistic}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2001}, volume={63}, number={2}, pages={411--423}, doi={10.1111/1467-9868.00293}}@article{ward1963hierarchical, author={Ward, Joe H.}, title={{Hierarchical grouping to optimize an objective function}}, journal={Journal of the American Statistical Association}, year={1963}, volume={58}, number={301}, pages={236--244}, doi={10.1080/01621459.1963.10500845}}