Co to jest wykres grzbietowy?
Wykres grzbietowy (ang. ridgeline plot, dawniej joyplot) pokazuje rozkład tej samej zmiennej w wielu grupach lub punktach czasu. Każda grupa dostaje własną krzywą gęstości, oszacowaną estymatorem jądrowym, a krzywe leżą jedna pod drugą na wspólnej osi wartości i lekko na siebie zachodzą – jak kolejne grzbiety gór. Wilke (2019) poleca ten wykres zwłaszcza do pokazywania, jak rozkład zmienia się w czasie, i zauważa, że dobrze znosi nawet bardzo wiele rozkładów naraz.
Jak czytać
- Położenie grzbietu na osi poziomej mówi, gdzie leżą wyniki grupy; przesuwanie się grzbietów z wiersza na wiersz to zmiana typowego poziomu.
- Kształt pokazuje rozrzut, skośność i liczbę szczytów. Pionowa wysokość krzywej to gęstość, a nie liczba osób.
- Linia wewnątrz grzbietu, jeśli ją dodasz, oznacza zwykle medianę lub kwartyle.
W porównaniu z wykresem skrzypcowym grzbiety zajmują mniej miejsca, bo krzywa nie jest odbita lustrzanie. Do ilu grup ma sens? Od kilku do kilkunastu; przy dwóch–trzech czytelniejsze są nałożone gęstości albo ECDF.
Przykład
Symulowaliśmy stres (0–40) w ośmiu niezależnych próbach po 120 studentów, od października do maja. Mediana rośnie z 15 w październiku do 18 w grudniu i 20 w styczniu, spada do 16 w marcu i wraca do 19 w maju. W styczniu (sesja) dane mają dwie podgrupy: spokojną i bardzo zestresowaną – SD wynosi wtedy 7.7 wobec 4.4–5.8 w innych miesiącach. Średnie i stycznową mieszaninę ustawiono ręcznie, żeby zmiana kształtu była wyraźna; ziarna (733) nie zmieniano.
Na rysunku
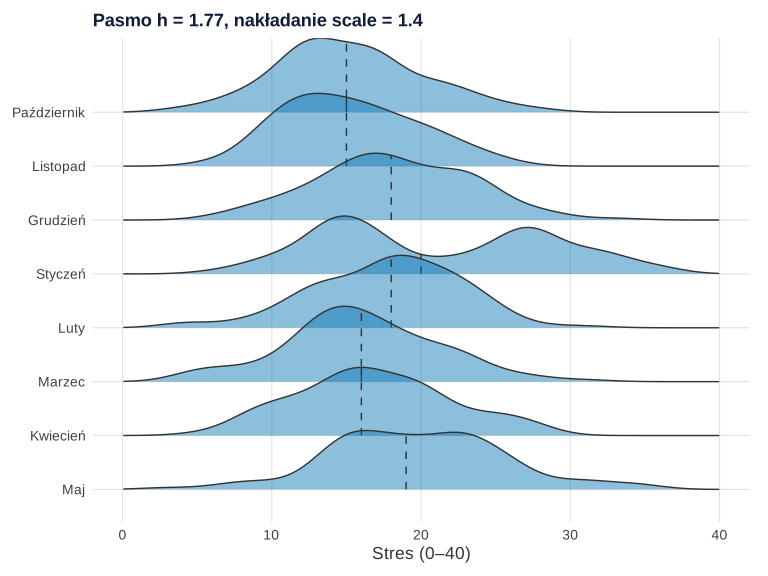
set.seed(733)).Co widać. Grzbiety przesuwają się w prawo od listopada do stycznia i wracają w lutym i marcu. Styczeń wyróżnia się kształtem: dwa szczyty i mediana 20 w dolinie między nimi, czyli w miejscu, gdzie wyników jest mało. Sama mediana albo pudełko pokazałyby tylko lekki wzrost.
Na co uważać. Krzywe zachodzą na siebie, więc górna część grzbietu zasłania fragment krzywej powyżej. Wykres nie pokazuje liczebności grup – przy nierównych grupach podaj je w podpisie. Gęstość rozciąga się ponad zakres danych, np. poniżej najniższego wyniku.
Podpis do pracy:
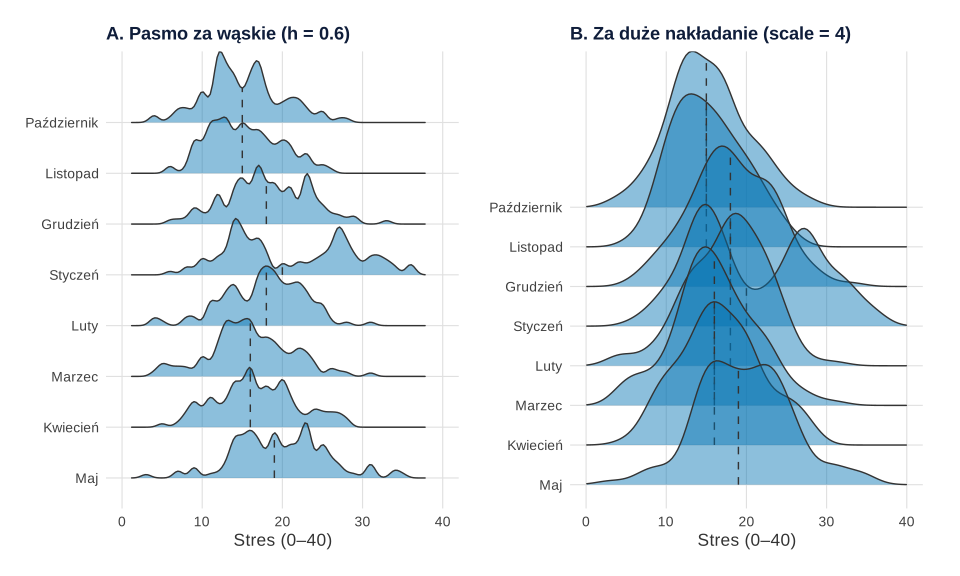
set.seed(733)).Co widać. Przy paśmie 0.6 każdy miesiąc ma kilka ostrych szczytów – to szum próby, a nie budowa rozkładu. Od szerokości pasma zależy, ile szczytów zobaczysz; Silverman (1981) opisał, jak za pomocą estymatorów jądrowych badać liczbę szczytów rozkładu. Przy nakładaniu 4 grzbiety są wysokie, ale zasłaniają się nawzajem.
Na co uważać. Używaj jednego pasma dla wszystkich grup, żeby różnice kształtu nie wynikały z ustawień. Zamiast reguły kciuka możesz wybrać pasmo metodą Sheathera i Jonesa (1991), dobraną z danych (bw = "SJ"). Nakładanie (scale) ustaw w okolicach 1–2: najwyższy grzbiet sięga wtedy jednego–dwóch wierszy wyżej.
Podpis do pracy:
Jak opisać w pracy
Wykres grzbietowy zwykle trafia do opisu danych. Wybór między histogramem, gęstością a ECDF dla jednej zmiennej omawia wpis rozkład zmiennej na wykresie.
Na co uważać
- Histogramy zamiast gęstości. W układzie grzbietowym słupki z różnych wierszy zlewają się, dlatego wykres opiera się zwykle na krzywych gęstości (Wilke, 2019). Przy danych o kilku możliwych wartościach (np. jedna pozycja Likerta) gęstość jest jednak złym wyborem – lepsze są słupki.
- Małe grupy. Przy kilkunastu osobach krzywa jest niestabilna. Dodaj punkty pod grzbietem albo wybierz wykres pszczelego roju.
- Kolejność wierszy. Przy czasie zachowaj kolejność chronologiczną; przy kategoriach nominalnych sortuj według mediany.
Wykres grzbietowy w R
Kod symuluje dane, liczy statystyki opisowe dla miesięcy i wspólną szerokość pasma (średnią reguły bw.nrd0 w miesiącach), a potem rysuje oba rysunki funkcją stat_density_ridges() z pakietu ggridges. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu; dane, geometrie i skale są identyczne.
Rozkład stresu w ośmiu miesiącach
Kod R rysunków 1 i 2
# Wykres grzbietowy (ridgeline): rozkład stresu w ośmiu miesiącach roku akademickiego
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(ggridges)})
oi <- c(niebieski = "#0072B2", pomarancz = "#E69F00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())

set.seed(733)
miesiace <- c("Październik", "Listopad", "Grudzień", "Styczeń", "Luty", "Marzec", "Kwiecień", "Maj")
srednia  <- c(15, 16, 18, 21, 17, 16, 17, 19)            # stres 0–40, osobne próby po 120 osób
d <- do.call(rbind, lapply(seq_along(miesiace), function(i) {
  y <- if (miesiace[i] == "Styczeń") c(rnorm(60, 14, 3.5), rnorm(60, 28, 3.5))   # sesja: dwie grupy
       else rnorm(120, srednia[i], 5)
  data.frame(miesiac = miesiace[i], stres = pmin(pmax(round(y), 0), 40))
}))
d$miesiac <- factor(d$miesiac, levels = rev(miesiace))   # październik na górze
opis <- t(sapply(split(d$stres, d$miesiac), function(x) c(n = length(x), Mdn = median(x), M = mean(x), SD = sd(x))))
print(round(opis[rev(rownames(opis)), ], 1))
h <- mean(sapply(split(d$stres, d$miesiac), bw.nrd0))    # wspólna szerokość pasma dla wszystkich miesięcy
cat("Szerokość pasma h =", round(h, 2), "\n")

grzbiet <- function(pasmo, nakladanie, tytul) {
  ggplot(d, aes(x = stres, y = miesiac)) +
    stat_density_ridges(geom = "density_ridges", bandwidth = pasmo, scale = nakladanie, n = 128,
                        fill = oi[["niebieski"]], alpha = 0.45, colour = "grey20",
                        quantile_lines = TRUE, quantiles = 2, vline_linetype = "dashed") +
    scale_x_continuous(limits = c(0, 40)) +
    labs(title = tytul, x = "Stres (0–40)", y = NULL)
}
p1 <- grzbiet(h, 1.4, sprintf("Pasmo h = %.2f, nakładanie scale = 1.4", h)) + motyw
p2 <- (grzbiet(0.6, 1.4, "A. Pasmo za wąskie (h = 0.6)") +
       grzbiet(h, 4, "B. Za duże nakładanie (scale = 4)")) & motyw
p1
p2
Wynik w R
              n Mdn    M  SD
Październik 120  15 15.2 4.8
Listopad    120  15 15.2 4.4
Grudzień    120  18 18.1 5.2
Styczeń     120  20 21.0 7.7
Luty        120  18 17.7 4.9
Marzec      120  16 16.0 5.2
Kwiecień    120  16 16.8 5.1
Maj         120  19 19.8 5.8
Szerokość pasma h = 1.77
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane i pasmo – funkcje bazowe rnorm(), bw.nrd0(); rysunki – pakiety ggplot2, ggridges i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggridges (wersja 0.5.7): Wilke, C. O. (2025). ggridges: Ridgeline plots in ggplot2 [R package]. https://doi.org/10.32614/CRAN.package.ggridges
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym różni się wykres grzbietowy od wykresu skrzypcowego?
Skrzypce odbijają krzywą gęstości symetrycznie i stawiają grupy obok siebie, a wykres grzbietowy rysuje jedną połowę krzywej i układa grupy jedna pod drugą. Przy wielu grupach lub punktach czasu grzbiety zajmują mniej miejsca i łatwiej śledzić przesuwanie się rozkładu.
Ile grup można pokazać na wykresie grzbietowym?
Zwykle od kilku do kilkunastu, ale wykres dobrze znosi też kilkadziesiąt grup, bo każda zajmuje tylko wąski pas. Przy dwóch–trzech grupach prostsze będą nałożone gęstości lub wykres pudełkowy z punktami.
Dlaczego wykres grzbietowy nazywa się też joyplot?
Nazwa nawiązuje do okładki płyty zespołu Joy Division z podobnym rysunkiem przesuniętych krzywych. W publikacjach lepiej używać nazwy ridgeline plot, a po polsku – wykres grzbietowy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Rozkład zmiennej na wykresie
Histogram przy czterech szerokościach przedziału, gęstość za gładka i za szorstka, ECDF, dwie grupy i skala Likerta – sześć rysunków z kodem R.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikPorównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Sheather, S. J., & Jones, M. C. (1991). A reliable data-based bandwidth selection method for kernel density estimation. Journal of the Royal Statistical Society: Series B (Methodological), 53(3), 683–690. https://doi.org/10.1111/j.2517-6161.1991.tb01857.x
- Silverman, B. W. (1981). Using kernel density estimates to investigate multimodality. Journal of the Royal Statistical Society: Series B (Methodological), 43(1), 97–99. https://doi.org/10.1111/j.2517-6161.1981.tb01155.x
- Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media. https://clauswilke.com/dataviz/ ● Otwarty dostęp
Cytowania BibTeX
@article{sheather1991reliable, author={Sheather, S. J. and Jones, M. C.}, title={{A reliable data-based bandwidth selection method for kernel density estimation}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1991}, volume={53}, number={3}, pages={683--690}, doi={10.1111/j.2517-6161.1991.tb01857.x}}@article{silverman1981using, author={Silverman, Bernard W.}, title={{Using kernel density estimates to investigate multimodality}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1981}, volume={43}, number={1}, pages={97--99}, doi={10.1111/j.2517-6161.1981.tb01155.x}}@book{wilke2019fundamentals, author={Wilke, Claus O.}, title={{Fundamentals of data visualization: A primer on making informative and compelling figures}}, year={2019}, publisher={O’Reilly Media}, url={https://clauswilke.com/dataviz/}}