Przykład: serwis z planami treningowymi i byli abonenci
Fikcyjny serwis internetowy sprzedaje w abonamencie plany treningowe: ćwiczenia na każdy dzień, filmy instruktażowe i dziennik postępów, za 49 zł miesięcznie. Co miesiąc część abonentów rezygnuje. Dział marketingu pyta: czy opłaca się próbować odzyskać byłych abonentów – i czym: rabatem czy samym e-mailem? Takie działania nazywa się po angielsku win-back. Thomas i in. (2004) postulowali, żeby odzyskiwanie było osobną częścią zarządzania relacjami z klientami, obok utrzymywania obecnych.
Serwis zrobił test A/B z trzema grupami. Spośród byłych abonentów, którzy odeszli 1–24 miesiące wcześniej i zgodzili się na kontakt marketingowy, wylosowano 9000 osób. 3600 dostało e-mail z ofertą: trzy miesiące za 24.50 zł (−50%), ważną 30 dni. 3600 dostało e-mail bez rabatu, z informacją o nowych planach. 1800 osób nie dostało nic – to grupa kontrolna. Obserwujemy 365 dni od wysyłki: czy i kiedy ktoś wrócił, a jeśli wrócił – jak długo płacił.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Parametry ustaliliśmy ręcznie (pełna lista przy kodzie): bez kontaktu w ciągu roku wraca 15% osób, które odeszły 1–3 miesiące temu, 8% z odejściem 4–12 miesięcy temu i 4% z odejściem dawniej. E-mail zwiększa liczbę powrotów 1.35 raza, rabat 2.1 raza. Osoby, które wracają dopiero po kontakcie, odchodzą potem szybciej (13% miesięcznie wobec 5%). Przy końcu rabatu rezygnuje 30% tych, którzy jeszcze płacą. Ziarna 747 i parametrów po pierwszym uruchomieniu nie zmienialiśmy. Dane pobierzesz jako odzyskiwanie-klientow-serwis-treningowy.csv (kolumna typ istnieje tylko w symulacji).
W ciągu roku wróciło 1265 osób, 527 z nich skorzystało z rabatu, a 685 odeszło ponownie przed końcem obserwacji. Pierwsze odejście abonentów opisuje wpis churn jako analiza przeżycia, a wybór, do kogo dzwonić przed odejściem – model odejść klientów. Tu zaczynamy po odejściu. Inne tematy prac zebraliśmy we wpisie statystyka w pracy z marketingu.
Rysunek 1: oś czasu klienta i cztery typy byłych abonentów
Zanim policzymy cokolwiek, zobaczmy historię jednego klienta: odejście, wysyłka, powrót, ponowne odejście. Byli abonenci różnią się tym, jak zareagowaliby na każdą z trzech wersji wysyłki.
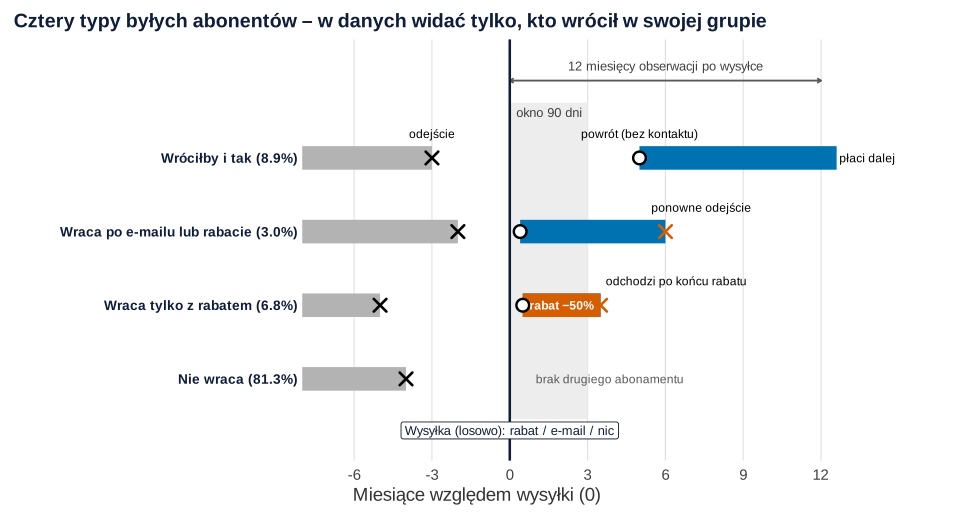
set.seed(747)).Co widać. Szare paski to pierwszy abonament, niebieskie – drugi. Pierwszy typ (8.9% byłych abonentów) wróciłby i bez kontaktu. Drugi (3.0%) wraca po e-mailu albo rabacie, trzeci (6.8%) – tylko z rabatem. Większość, 81.3%, nie wraca w ogóle. Te typy to warstwy główne: Frangakis i Rubin (2002) opisali je jako podział osób według reakcji na każdą wersję interwencji. Warstwa nie zależy od losowania, więc porównanie w jej obrębie daje efekt przyczynowy.
Jak może zmylić. W danych nikt nie ma etykiety typu. Widzimy tylko, kto wrócił w swojej grupie. Powracający po rabacie to mieszanina trzech typów, a powracający bez kontaktu – jednego. To będzie kluczowe przy rysunku 5.
Rysunek 2: ilu wróciło i ilu dzięki kontaktowi
Pierwsza miara to odsetek powrotów w ustalonym oknie, z przedziałem Wilsona. Ważniejsza jest druga: przyrost względem grupy bez kontaktu, czyli powroty, których bez wysyłki by nie było. To ta sama logika co w teście wyłączenia reklamy.
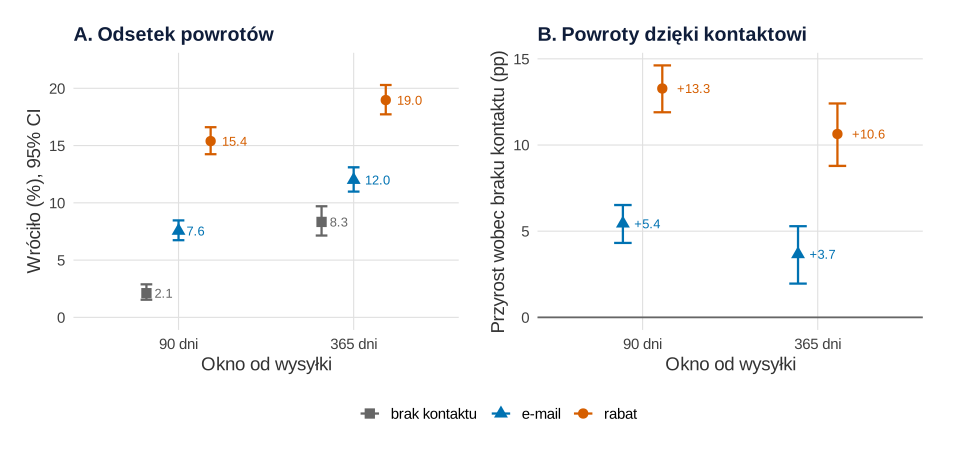
Co widać. W 365 dni wróciło 8.33% osób bez kontaktu (95% CI [7.14, 9.70]), 12.00% po e-mailu [10.98, 13.10] i 18.97% po rabacie [17.72, 20.29]; χ²(2) = 133.42, p < .001. Przyrost wobec braku kontaktu wynosi +3.67 pp dla e-maila [1.96, 5.29] i +10.64 pp dla rabatu [8.79, 12.41], z przedziałem Newcombe’a. Rabat daje o 6.97 pp więcej powrotów niż sam e-mail [5.31, 8.64].
Jak może zmylić. Bez grupy kontrolnej przypisalibyśmy rabatowi wszystkie 683 powroty. Tymczasem 43.9% z nich zdarzyłoby się i tak. W oknie 90 dni przyrost jest większy (+13.28 pp dla rabatu, +5.44 pp dla e-maila), bo część osób tylko wróciła wcześniej.
Rysunek 3: czas do powrotu – Kaplan–Meier i Cox
Kto nie wrócił w 365 dni, ma obserwację cenzurowaną. Skumulowany odsetek powrotów rysujemy jako 1 minus estymator Kaplana–Meiera; Kaplan i Meier (1958) zaproponowali go dla obserwacji niepełnych. Procedurę krok po kroku opisuje wpis Kaplan–Meier i model Coxa.
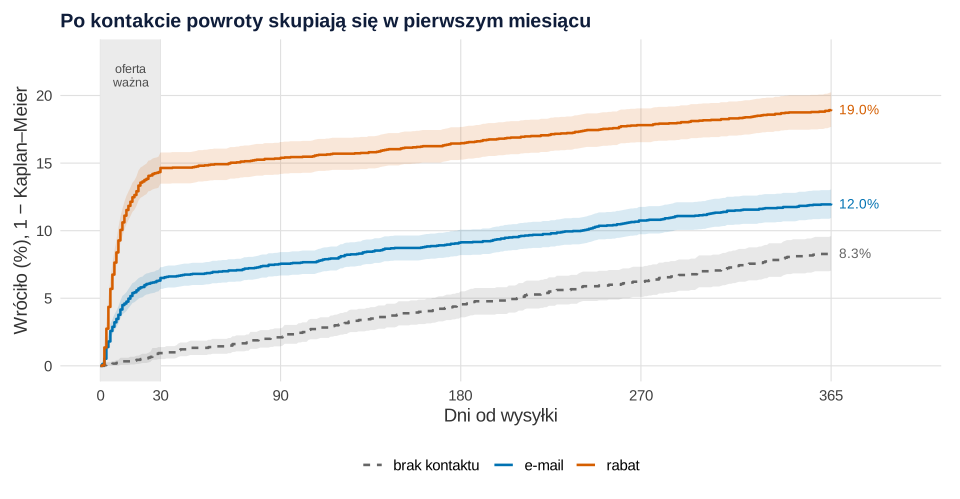
Co widać. Po 30 dniach wróciło 0.9% osób bez kontaktu, 6.5% po e-mailu i 14.6% po rabacie. Potem krzywe kontaktowanych grup rosną wolniej niż krzywa kontrolna. Krzywe różnią się (log-rank: χ²(2) = 146, p < .001). Model Coxa (Cox, 1972) z segmentem daje HR = 1.53 [1.27, 1.84] dla e-maila i 2.56 [2.14, 3.05] dla rabatu.
Jak może zmylić. Jeden HR uśrednia dwa okresy. Test oparty na resztach Schoenfelda odrzuca proporcjonalność dla grupy (χ²(2) = 173.67, p < .001). W dniach 0–30 HR wynosi 7.23 [4.42, 11.83] dla e-maila i 16.92 [10.44, 27.43] dla rabatu, a w dniach 31–365 – 0.80 [0.64, 1.00] i 0.69 [0.55, 0.87]. Po pierwszym miesiącu kontaktowani wracają rzadziej, bo część „wróciłaby i tak” wróciła już wcześniej. Hernán (2010) zwraca uwagę, że HR może zmieniać się w czasie i ma wbudowane obciążenie selekcją.
Rysunek 4: segmenty według czasu od odejścia
Kumar i in. (2015) pokazali, że to, jak klient zachowywał się w pierwszym okresie, wiąże się z szansą odzyskania, długością drugiego okresu i jego rentownością. Najprostsza cecha tego typu to czas od odejścia.
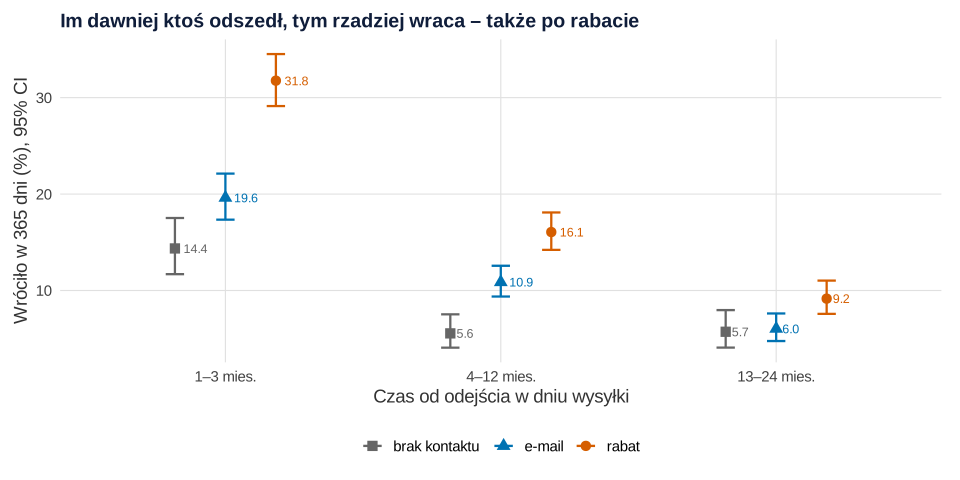
Co widać. Wśród osób, które odeszły 1–3 miesiące temu, rabat dał +17.40 pp powrotów [13.28, 21.23], a e-mail +5.26 pp [1.37, 8.92]. Przy odejściu 4–12 miesięcy temu: +10.51 pp i +5.31 pp. Przy odejściu 13–24 miesiące temu rabat dał już tylko +3.43 pp [0.69, 5.92], a e-mail +0.31 pp [−2.27, 2.59].
Jak może zmylić. Przyrost w punktach procentowych maleje, ale na skali logitu interakcja grupy z segmentem nie jest rozstrzygnięta (χ²(4) = 8.36, p = .079). W danych ukryliśmy ten sam mnożnik w każdym segmencie – mniej osób wraca, więc i przyrost w pp jest mniejszy. W grupie kontrolnej odsetki 5.56% i 5.72% w dwóch starszych segmentach to szum przy 559–684 osobach w komórce (prawda: 8% i 4%).
Rysunek 5: trwałość odzyskanych – pułapka selekcji
Naturalne pytanie: czy klienci odzyskani rabatem zostają na dłużej? Kusi, by wziąć tylko powracających i porównać czas do ponownego odejścia. To porównanie jest jednak warunkowe na zdarzeniu, na które wpływa sama interwencja – klasyczny błąd selekcji, czyli warunkowanie na zmiennej zderzeniowej.
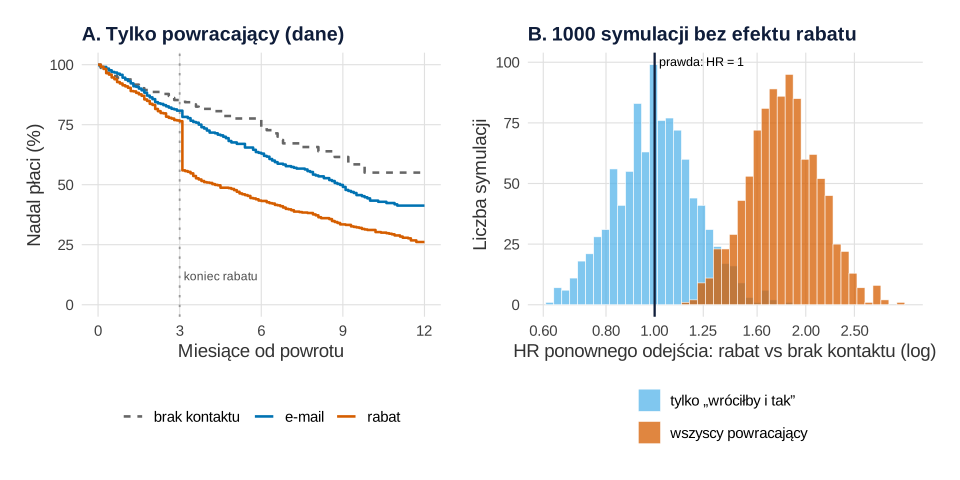
Co widać – panel A. Po 6 miesiącach od powrotu płaci jeszcze 74.0% powracających bez kontaktu [66.3, 82.6], 63.0% po e-mailu i 43.2% po rabacie. Po rabacie widać schodek w 3. miesiącu: z 76.5% do 50.9%. HR ponownego odejścia wynosi 1.45 [1.04, 2.03] dla e-maila i 2.35 [1.71, 3.24] dla rabatu. Wniosek „rabat ściąga klientów, którzy szybko uciekają” jest tylko częściowo prawdziwy.
Co widać – panel B. Symulujemy 1000 eksperymentów, w których rabat nikomu nie skraca drugiego abonamentu. Porównanie wszystkich powracających daje średnio HR = 1.83, a w 95.9% eksperymentów „istotnie” szybsze odejścia po rabacie (błąd Monte Carlo 0.6 pp). Porównanie w jednej warstwie („wróciłby i tak”) daje średnio HR = 1.03 i 1.7% fałszywych alarmów. Powód widać w składzie: wśród powracających po rabacie tylko 48.9% to osoby, które wróciłyby i tak, w grupie kontrolnej – 100%.
Jak może zmylić. W naszych danych w warstwie „wróciłby i tak” HR dla rabatu wynosi 1.26 [0.89, 1.79] – to ślad prawdziwego efektu końca rabatu. Ale tej warstwy w praktyce nie widać. Dlatego trwałość mierz wynikiem na osobę wylosowaną (rysunek 6).
Rysunek 6: wynik na osobę wylosowaną – miesiące i wartość netto
Rozwiązanie jest proste: licz wynik na każdą wylosowaną osobę, także na tych, którzy nie wrócili (mają 0). Tak działa analiza ITT. Tu wynik to liczba opłaconych miesięcy w roku po wysyłce i wartość netto: przychód (z rabatem tam, gdzie był) minus koszt wysyłki 0.10 zł. Przedziały dają 2000 replikacji bootstrapu w obrębie grup.
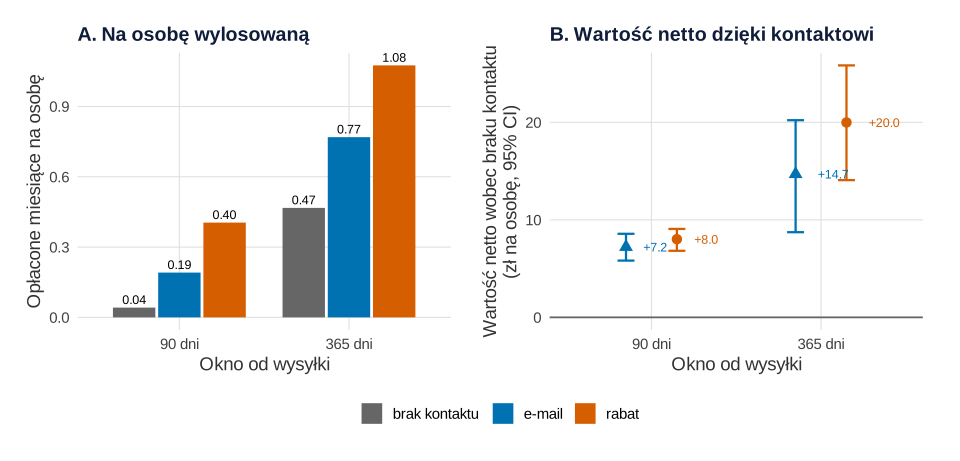
Co widać. W roku po wysyłce osoba bez kontaktu opłaciła średnio 0.47 miesiąca, po e-mailu 0.77, po rabacie 1.08. Wartość netto na osobę wzrosła o 14.70 zł po e-mailu [8.73, 20.22] i o 19.99 zł po rabacie [14.08, 25.84]. Rabat wobec samego e-maila: +0.31 opłaconego miesiąca [0.19, 0.44], ale tylko +5.30 zł [−0.15, 10.98] – przedział obejmuje zero.
Jak może zmylić. Po 90 dniach rabat i e-mail wyglądają prawie tak samo (+8.02 zł i +7.22 zł), bo rabat obniża cenę pierwszych miesięcy. Rabat kosztował 34 986 zł utraconego przychodu, a 36.3% tej kwoty trafiło do osób, które wróciłyby i tak. Wartość po roku nie obejmuje też miesięcy po 365. dniu – podaj horyzont. Rachunek wartości klienta w dłuższym czasie opisuje wpis wartość klienta (CLV).
Co z tym zrobić w marketingu
- Zawsze zostaw losową grupę bez kontaktu. Bez niej nie oddzielisz powrotów dzięki kampanii od tych, które zdarzyłyby się i tak.
- Decyzję podejmuj na wyniku na osobę wylosowaną w ustalonym horyzoncie (np. 12 miesięcy), nie na odsetku powrotów po miesiącu.
- Nie oceniaj jakości odzyskanych na samych powracających. Jeśli chcesz wiedzieć, czy rabat skraca drugi abonament, zaplanuj osobny test wśród powracających (np. losowo rabat na 3 albo 6 miesięcy).
- Rabat kieruj do świeżo odeszłych, a dawno odeszłym wysyłaj najwyżej tańszy e-mail. Ascarza (2018) pokazała, że lepiej wybierać klientów według reakcji na interwencję zmierzonej w eksperymencie niż według samego ryzyka; ten sam pomysł rozwija modelowanie uplift.
- Zaplanuj, co po rabacie. Thomas i in. (2004) w swoim zastosowaniu doszli do strategii z niską ceną na powrót i wyższą po odzyskaniu – ale schodek w 3. miesiącu pokazuje, że koniec rabatu też kosztuje. Podobny problem u nowych klientów opisuje wpis rabat na pierwszy miesiąc.
Jak opisać w pracy
W Metodzie opisz populację (byli abonenci ze zgodą na kontakt), losowanie, wynik i horyzont; w Wynikach najpierw przyrost, potem czas, na końcu wartość na osobę.
Kod R: dane, powroty, czas do powrotu, selekcja i wartość na osobę
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Krzywe Kaplana–Meiera, test log-rank i model Coxa to pakiet survival; odsetki, przedziały Wilsona i Newcombe’a, regresja logistyczna i bootstrap – bazowy R. Każdy przepis z rysunkiem kończy się nazwą wykresu (p2–p8), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepis 1 (set.seed(747)), przepis 6 (set.seed(7476), 1000 symulowanych eksperymentów) i przepis 7 (set.seed(7477), 2000 replikacji bootstrapu); ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: 9000 byłych abonentów ze zgodą na kontakt, przydział 1800 / 3600 / 3600 (brak kontaktu, e-mail, rabat), udziały segmentów czasu od odejścia (30% 1–3 mies., 40% 4–12 mies., 30% 13–24 mies.), odsetek powrotów w 365 dni bez kontaktu (15%, 8%, 4%), mnożniki powrotów (e-mail 1.35, rabat 2.1), część osób „wróciłby i tak”, które po kontakcie wracają od razu (e-mail 30%, rabat 50%), czas powrotu dzięki kontaktowi (1 dzień + rozkład wykładniczy ze średnią 8 dni, najwyżej 30 dni), miesięczne ryzyko ponownego odejścia (5% u osób, które wróciłyby i tak, 13% u pozostałych powracających), cenę 49 zł i rabat 50% przez 3 miesiące przy powrocie w ciągu 30 dni, odejście 30% wciąż płacących po końcu rabatu i koszt wysyłki 0.10 zł. Po pierwszym uruchomieniu nie zmieniano żadnego parametru danych; poprawiono tylko sposób liczenia HR w dwóch okresach i wygląd rysunków. Całość liczy się w kilkanaście sekund.
1. Paleta, motyw i dane
R
# Przepis 1. Fikcyjny serwis z planami treningowymi online: eksperyment win-back wśród byłych
# abonentów – oferta rabatowa, e-mail bez rabatu, brak kontaktu (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta oparta na Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol_grupa <- c("brak kontaktu" = "grey40", "e-mail" = "#0072B2", "rabat" = "#D55E00")
ksz_grupa <- c("brak kontaktu" = 15, "e-mail" = 17, "rabat" = 16)
kol <- c(granat = "#0f1d3a", prawda = "#CC79A7", zielony = "#009E73", szary = "grey55", jasny = "grey85")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie ------------------------------------------------------------------
n        <- 9000                                   # byli abonenci ze zgodą na kontakt
grupy    <- c("brak kontaktu", "e-mail", "rabat")
liczby   <- c(1800, 3600, 3600)                    # przydział losowy 20% / 40% / 40%
segmenty <- c("1–3 mies.", "4–12 mies.", "13–24 mies.")   # czas od odejścia w dniu wysyłki
udz_seg  <- c(0.30, 0.40, 0.30)
p_sam    <- c(0.15, 0.08, 0.04)    # powrót w 365 dni BEZ kontaktu, wg segmentu
mnoznik  <- c("brak kontaktu" = 1, "e-mail" = 1.35, "rabat" = 2.1)  # ile razy więcej powrotów
przysp   <- c("brak kontaktu" = 0, "e-mail" = 0.30, "rabat" = 0.50) # część „wróciłby i tak”, która wraca od razu
h_mies   <- c(lojalny = 0.05, nowy = 0.13)         # miesięczne ryzyko ponownego odejścia
cena     <- 49; cena_rabat <- 24.5                 # zł za miesiąc; rabat −50% przez 3 miesiące
waznosc  <- 30                                     # oferta ważna 30 dni
koniec_rabatu <- 0.30                              # tyle odchodzi przy końcu rabatu (jeśli jeszcze płaci)
koszt_wysylki <- 0.10                              # zł za wysłany e-mail
mies <- 30.4                                       # dni w miesiącu rozliczeniowym

set.seed(747)
ab <- data.frame(id = seq_len(n), grupa = factor(sample(rep(grupy, liczby)), levels = grupy),
                 segment = factor(sample(segmenty, n, replace = TRUE, prob = udz_seg), levels = segmenty))
g <- as.character(ab$grupa); s <- as.integer(ab$segment)
U <- runif(n)                                       # ukryta skłonność do powrotu (mniejsza = chętniej)
# Typ klienta (warstwa główna) – znany tylko w symulacji, nie zależy od przydziału
ab$typ <- factor(ifelse(U < p_sam[s], "wróci i tak", ifelse(U < p_sam[s] * mnoznik["e-mail"], "wróci po kontakcie",
                 ifelse(U < p_sam[s] * mnoznik["rabat"], "wróci tylko z rabatem", "nie wróci"))),
                 levels = c("wróci i tak", "wróci po kontakcie", "wróci tylko z rabatem", "nie wróci"))
wraca <- U < p_sam[s] * mnoznik[g]
# Dzień powrotu: „wróciłby i tak” – w dowolnym dniu roku, część przyspiesza po kontakcie;
# ci, którzy wracają dzięki kontaktowi – w ciągu 30 dni od wysyłki
dzien <- runif(n, 1, 365)
szybko <- (ab$typ != "wróci i tak") | (runif(n) < przysp[g])
dzien[szybko] <- pmin(waznosc, 1 + rexp(sum(szybko), 1 / 8))
dzien[!wraca] <- Inf
ab$rabat_uzyty <- as.integer(g == "rabat" & dzien <= waznosc)
# Drugi okres abonamentu: czas do ponownego odejścia (dni); u „nowych” powracających ryzyko wyższe
h <- ifelse(ab$typ == "wróci i tak", h_mies["lojalny"], h_mies["nowy"])
D <- rexp(n, h / mies)
odchodzi_po_rabacie <- ab$rabat_uzyty == 1 & D > 3 * mies & runif(n) < koniec_rabatu
D[odchodzi_po_rabacie] <- 3 * mies                 # rezygnacja po trzecim (ostatnim tańszym) miesiącu
# Obserwacja trwa 365 dni od wysyłki
ab$wrocil      <- as.integer(dzien <= 365)
ab$dzien_powrotu <- round(pmin(dzien, 365), 1)
ab$dni_drugiego  <- ifelse(ab$wrocil == 1, round(pmin(D, 365 - dzien), 1), NA)
ab$odszedl_znowu <- ifelse(ab$wrocil == 1, as.integer(D <= 365 - dzien), NA)
# Opłacone miesiące i przychód w oknie (płatność na początku każdego miesiąca abonamentu)
miesiace <- function(okno) ifelse(dzien <= okno, ceiling((pmin(dzien + D, okno) - dzien) / mies), 0)
ab$mies_90  <- miesiace(90)
ab$mies_365 <- pmin(12, miesiace(365))
przychod <- function(m) ifelse(ab$rabat_uzyty == 1, cena_rabat * pmin(m, 3) + cena * pmax(m - 3, 0), cena * m)
ab$przychod_90  <- przychod(ab$mies_90)
ab$przychod_365 <- przychod(ab$mies_365)
ab$koszt <- ifelse(g == "brak kontaktu", 0, koszt_wysylki)
write.csv(ab, "odzyskiwanie-klientow-serwis-treningowy.csv", row.names = FALSE)

# Opis danych
table(ab$grupa, ab$segment)
c(powrotow_365 = sum(ab$wrocil), z_rabatem = sum(ab$rabat_uzyty),
  odeszli_znowu = sum(ab$odszedl_znowu, na.rm = TRUE))
# Prawda z symulacji: udział typów klientów (taki sam w każdej grupie, bo przydział jest losowy)
round(100 * prop.table(table(ab$typ)), 1)
Wynik w R
                1–3 mies. 4–12 mies. 13–24 mies.
  brak kontaktu       557        684         559
  e-mail             1060       1463        1077
  rabat              1143       1376        1081
 powrotow_365     z_rabatem odeszli_znowu
         1265           527           685

          wróci i tak    wróci po kontakcie wróci tylko z rabatem
                  8.9                   3.0                   6.8
            nie wróci
                 81.3
2. Odsetek powrotów i przyrost: Rysunek 2
R
# Przepis 2. Odsetek powrotów w 90 i 365 dni z 95% CI i przyrost względem braku kontaktu (Rysunek 2)
# Korzysta z obiektów przepisu 1: ab, kol_grupa, ksz_grupa, motyw. Nie losuje.
wilson <- function(x, n, z = 1.96) {                 # przedział Wilsona dla jednej proporcji
  p <- x / n; m <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  h <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  c(m - h, m + h)
}
newcombe <- function(x1, n1, x0, n0) {               # różnica p1 − p0, przedział Newcombe'a (Wilson)
  p1 <- x1 / n1; p0 <- x0 / n0; w1 <- wilson(x1, n1); w0 <- wilson(x0, n0)
  c(roznica = p1 - p0, dolna = p1 - p0 - sqrt((p1 - w1[1])^2 + (w0[2] - p0)^2),
    gorna = p1 - p0 + sqrt((w1[2] - p1)^2 + (p0 - w0[1])^2))
}
ab$wrocil_90 <- as.integer(ab$wrocil == 1 & ab$dzien_powrotu <= 90)
odsetki <- do.call(rbind, lapply(c(90, 365), function(okno) {
  y <- if (okno == 90) ab$wrocil_90 else ab$wrocil
  do.call(rbind, lapply(levels(ab$grupa), function(gr) {
    x <- sum(y[ab$grupa == gr]); m <- sum(ab$grupa == gr); w <- wilson(x, m)
    data.frame(okno = paste(okno, "dni"), grupa = gr, wrocilo = x, n = m,
               proc = 100 * x / m, dolna = 100 * w[1], gorna = 100 * w[2])
  }))
}))
print(odsetki, digits = 3)
# Przyrost względem braku kontaktu (punkty procentowe) – to są powroty, których bez kontaktu by nie było
przyrost <- do.call(rbind, lapply(c(90, 365), function(okno) {
  y <- if (okno == 90) ab$wrocil_90 else ab$wrocil
  x0 <- sum(y[ab$grupa == "brak kontaktu"]); n0 <- sum(ab$grupa == "brak kontaktu")
  do.call(rbind, lapply(c("e-mail", "rabat"), function(gr) {
    r <- newcombe(sum(y[ab$grupa == gr]), sum(ab$grupa == gr), x0, n0)
    data.frame(okno = paste(okno, "dni"), grupa = gr, pp = 100 * r[1], dolna = 100 * r[2], gorna = 100 * r[3])
  }))
}))
print(przyrost, digits = 3)
# Rabat wobec samego e-maila (365 dni) i test χ² dla trzech grup
round(100 * newcombe(sum(ab$wrocil[ab$grupa == "rabat"]), 3600, sum(ab$wrocil[ab$grupa == "e-mail"]), 3600), 2)
chisq.test(table(ab$grupa, ab$wrocil))
# Ile powrotów w grupie z rabatem przypada na osoby, które wróciłyby i bez kontaktu?
round(100 * mean(odsetki$proc[odsetki$okno == "365 dni" & odsetki$grupa == "brak kontaktu"] /
                   odsetki$proc[odsetki$okno == "365 dni" & odsetki$grupa == "rabat"]), 1)

odsetki$grupa <- factor(odsetki$grupa, levels = levels(ab$grupa))
przyrost$grupa <- factor(przyrost$grupa, levels = levels(ab$grupa))
odsetki$okno <- factor(odsetki$okno, levels = c("90 dni", "365 dni"))
przyrost$okno <- factor(przyrost$okno, levels = c("90 dni", "365 dni"))
pA <- ggplot(odsetki, aes(okno, proc, colour = grupa, shape = grupa)) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.2, linewidth = 0.8, position = position_dodge(0.55)) +
  geom_point(size = 3.2, position = position_dodge(0.55)) +
  geom_text(aes(label = sprintf("%.1f", proc)), position = position_dodge(0.55), hjust = -0.45, size = 3.4,
            show.legend = FALSE) +
  scale_colour_manual(values = kol_grupa, name = NULL) + scale_shape_manual(values = ksz_grupa, name = NULL) +
  coord_cartesian(ylim = c(0, 22)) +
  labs(x = "Okno od wysyłki", y = "Wróciło (%), 95% CI", title = "A. Odsetek powrotów") + motyw
pB <- ggplot(przyrost, aes(okno, pp, colour = grupa, shape = grupa)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.2, linewidth = 0.8, position = position_dodge(0.45)) +
  geom_point(size = 3.2, position = position_dodge(0.45)) +
  geom_text(aes(label = sprintf("%+.1f", pp)), position = position_dodge(0.45), hjust = -0.45, size = 3.4,
            show.legend = FALSE) +
  scale_colour_manual(values = kol_grupa, name = NULL, drop = FALSE) +
  scale_shape_manual(values = ksz_grupa, name = NULL, drop = FALSE) +
  labs(x = "Okno od wysyłki", y = "Przyrost wobec braku kontaktu (pp)", title = "B. Powroty dzięki kontaktowi") +
  motyw + guides(colour = "none", shape = "none")
p2 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("odzyskiwanie-klientow-powroty.svg", p2, width = 10, height = 4.8)
Wynik w R
     okno         grupa wrocilo    n  proc dolna gorna
1  90 dni brak kontaktu      38 1800  2.11  1.54  2.88
2  90 dni        e-mail     272 3600  7.56  6.74  8.46
3  90 dni         rabat     554 3600 15.39 14.25 16.60
4 365 dni brak kontaktu     150 1800  8.33  7.14  9.70
5 365 dni        e-mail     432 3600 12.00 10.98 13.10
6 365 dni         rabat     683 3600 18.97 17.72 20.29
             okno  grupa    pp dolna gorna
roznica    90 dni e-mail  5.44  4.32  6.52
roznica1   90 dni  rabat 13.28 11.90 14.62
roznica2  365 dni e-mail  3.67  1.96  5.29
roznica11 365 dni  rabat 10.64  8.79 12.41
roznica   dolna   gorna
   6.97    5.31    8.64

	Pearson's Chi-squared test

data:  table(ab$grupa, ab$wrocil)
X-squared = 133.42, df = 2, p-value < 2.2e-16

[1] 43.9
3. Czas do powrotu: Kaplan–Meier i Cox – Rysunek 3
R
# Przepis 3. Czas do powrotu: Kaplan–Meier, test log-rank i model Coxa (Rysunek 3)
# Korzysta z obiektów przepisu 1: ab, kol_grupa, motyw. Nie losuje.
library(survival)

# Kto nie wrócił w 365 dni, ma obserwację cenzurowaną w 365. dniu
km <- survfit(Surv(dzien_powrotu, wrocil) ~ grupa, data = ab)
s <- summary(km, times = c(7, 14, 30, 90, 180, 365), extend = TRUE)
km_tab <- data.frame(grupa = sub("grupa=", "", s$strata), dzien = s$time, wrocilo_proc = 100 * (1 - s$surv),
                     dolna = 100 * (1 - s$upper), gorna = 100 * (1 - s$lower))
km_tab[, 3:5] <- round(km_tab[, 3:5], 1)
km_tab
survdiff(Surv(dzien_powrotu, wrocil) ~ grupa, data = ab)          # test log-rank

# Model Coxa: grupa i segment (czas od odejścia); sprawdzenie proporcjonalności hazardów
cox <- coxph(Surv(dzien_powrotu, wrocil) ~ grupa + segment, data = ab)
round(cbind(HR = exp(coef(cox)), exp(confint(cox))), 2)
cox.zph(cox)
# Hazardy nie są proporcjonalne: osobne HR dla dni 0–30 (oferta ważna) i 31–365
ab_s <- survSplit(Surv(dzien_powrotu, wrocil) ~ grupa + segment, data = ab, cut = 30, episode = "okres")
ab_s$okres <- factor(ab_s$okres, labels = c("dni 0–30", "dni 31–365"))
w <- ab_s$okres == "dni 0–30"
ab_s$email_0_30  <- as.integer(ab_s$grupa == "e-mail" & w);  ab_s$email_31_365 <- as.integer(ab_s$grupa == "e-mail" & !w)
ab_s$rabat_0_30  <- as.integer(ab_s$grupa == "rabat" & w);   ab_s$rabat_31_365 <- as.integer(ab_s$grupa == "rabat" & !w)
cox2 <- coxph(Surv(tstart, dzien_powrotu, wrocil) ~ email_0_30 + email_31_365 + rabat_0_30 + rabat_31_365 + segment,
              data = ab_s)
round(cbind(HR = exp(coef(cox2)), exp(confint(cox2)))[1:4, ], 2)   # każdy wobec braku kontaktu w tym samym okresie

sk <- summary(km, times = 0:365, extend = TRUE)
km_df <- data.frame(grupa = factor(sub("grupa=", "", sk$strata), levels = levels(ab$grupa)), dzien = sk$time,
                    proc = 100 * (1 - sk$surv), dolna = 100 * (1 - sk$upper), gorna = 100 * (1 - sk$lower))
konce <- km_df[km_df$dzien == 365, ]
p3 <- ggplot(km_df, aes(dzien, proc, colour = grupa, fill = grupa)) +
  annotate("rect", xmin = 0, xmax = 30, ymin = -Inf, ymax = Inf, fill = "grey92") +
  annotate("text", x = 15, y = 21.5, label = "oferta\nważna", size = 3.3, colour = "grey30", lineheight = 0.9) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), alpha = 0.15, colour = NA) +
  geom_step(aes(linetype = grupa), linewidth = 0.9) +
  geom_text(data = konce, aes(x = 369, y = proc, label = sprintf("%.1f%%", proc)), hjust = 0, size = 3.6,
            show.legend = FALSE) +
  scale_colour_manual(values = kol_grupa, name = NULL) + scale_fill_manual(values = kol_grupa, guide = "none") +
  scale_linetype_manual(values = c("brak kontaktu" = "22", "e-mail" = "solid", "rabat" = "solid"), name = NULL) +
  scale_x_continuous(breaks = c(0, 30, 90, 180, 270, 365), limits = c(0, 400)) +
  coord_cartesian(ylim = c(0, 23)) +
  labs(x = "Dni od wysyłki", y = "Wróciło (%), 1 − Kaplan–Meier",
       title = "Po kontakcie powroty skupiają się w pierwszym miesiącu") + motyw
p3   # zapis: ggsave("odzyskiwanie-klientow-czas-do-powrotu.svg", p3, width = 10, height = 5.2)
Wynik w R
           grupa dzien wrocilo_proc dolna gorna
1  brak kontaktu     7          0.2   0.0   0.4
2  brak kontaktu    14          0.3   0.1   0.6
3  brak kontaktu    30          0.9   0.5   1.4
4  brak kontaktu    90          2.1   1.4   2.8
5  brak kontaktu   180          4.6   3.6   5.5
6  brak kontaktu   365          8.3   7.0   9.6
7         e-mail     7          3.2   2.6   3.8
8         e-mail    14          5.0   4.3   5.7
9         e-mail    30          6.5   5.7   7.3
10        e-mail    90          7.6   6.7   8.4
11        e-mail   180          9.1   8.2  10.1
12        e-mail   365         12.0  10.9  13.1
13         rabat     7          7.6   6.8   8.5
14         rabat    14         11.8  10.8  12.9
15         rabat    30         14.6  13.5  15.8
16         rabat    90         15.4  14.2  16.6
17         rabat   180         16.5  15.3  17.7
18         rabat   365         19.0  17.7  20.2
Call:
survdiff(formula = Surv(dzien_powrotu, wrocil) ~ grupa, data = ab)

                       N Observed Expected (O-E)^2/E (O-E)^2/V
grupa=brak kontaktu 1800      150      267      51.3      65.0
grupa=e-mail        3600      432      514      13.1      22.1
grupa=rabat         3600      683      484      82.0     132.8

 Chisq= 146  on 2 degrees of freedom, p= <2e-16
                     HR 2.5 % 97.5 %
grupae-mail        1.53  1.27   1.84
gruparabat         2.56  2.14   3.05
segment4–12 mies.  0.47  0.41   0.53
segment13–24 mies. 0.27  0.23   0.32
         chisq df      p
grupa   173.67  2 <2e-16
segment   2.51  2   0.28
GLOBAL  176.41  4 <2e-16
                HR 2.5 % 97.5 %
email_0_30    7.23  4.42  11.83
email_31_365  0.80  0.64   1.00
rabat_0_30   16.92 10.44  27.43
rabat_31_365  0.69  0.55   0.87
4. Segmenty według czasu od odejścia: Rysunek 4
R
# Przepis 4. Segmenty według czasu od odejścia: powroty i przyrost w każdym segmencie (Rysunek 4)
# Korzysta z obiektów przepisów 1 i 2: ab, wilson(), newcombe(), kol_grupa, ksz_grupa, motyw. Nie losuje.
seg <- do.call(rbind, lapply(levels(ab$segment), function(sg) {
  d <- ab[ab$segment == sg, ]
  x0 <- sum(d$wrocil[d$grupa == "brak kontaktu"]); n0 <- sum(d$grupa == "brak kontaktu")
  do.call(rbind, lapply(levels(ab$grupa), function(gr) {
    x <- sum(d$wrocil[d$grupa == gr]); m <- sum(d$grupa == gr); w <- wilson(x, m)
    r <- if (gr == "brak kontaktu") c(NA, NA, NA) else newcombe(x, m, x0, n0)
    data.frame(segment = sg, grupa = gr, n = m, proc = 100 * x / m, dolna = 100 * w[1], gorna = 100 * w[2],
               przyrost_pp = 100 * r[1], p_dolna = 100 * r[2], p_gorna = 100 * r[3])
  }))
}))
print(seg, digits = 3)
# Czy przyrost od rabatu zależy od segmentu? Interakcja w regresji logistycznej (test ilorazu wiarygodności)
m0 <- glm(wrocil ~ grupa + segment, family = binomial, data = ab)
m1 <- glm(wrocil ~ grupa * segment, family = binomial, data = ab)
anova(m0, m1, test = "LRT")

seg$segment <- factor(seg$segment, levels = levels(ab$segment))
seg$grupa <- factor(seg$grupa, levels = levels(ab$grupa))
p4 <- ggplot(seg, aes(segment, proc, colour = grupa, shape = grupa)) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.2, linewidth = 0.8, position = position_dodge(0.55)) +
  geom_point(size = 3.2, position = position_dodge(0.55)) +
  geom_text(aes(label = sprintf("%.1f", proc)), position = position_dodge(0.55), hjust = -0.35, size = 3.3,
            show.legend = FALSE) +
  scale_colour_manual(values = kol_grupa, name = NULL) + scale_shape_manual(values = ksz_grupa, name = NULL) +
  labs(x = "Czas od odejścia w dniu wysyłki", y = "Wróciło w 365 dni (%), 95% CI",
       title = "Im dawniej ktoś odszedł, tym rzadziej wraca – także po rabacie") + motyw
p4   # zapis: ggsave("odzyskiwanie-klientow-segmenty.svg", p4, width = 10, height = 5)
Wynik w R
              segment         grupa    n  proc dolna gorna przyrost_pp p_dolna
1           1–3 mies. brak kontaktu  557 14.36 11.69 17.52          NA      NA
roznica     1–3 mies.        e-mail 1060 19.62 17.34 22.12       5.260    1.37
roznica1    1–3 mies.         rabat 1143 31.76 29.12 34.51      17.396   13.28
11         4–12 mies. brak kontaktu  684  5.56  4.07  7.53          NA      NA
roznica2   4–12 mies.        e-mail 1463 10.87  9.37 12.57       5.313    2.83
roznica11  4–12 mies.         rabat 1376 16.06 14.22 18.10      10.505    7.80
12        13–24 mies. brak kontaktu  559  5.72  4.08  7.97          NA      NA
roznica3  13–24 mies.        e-mail 1077  6.04  4.76  7.62       0.311   -2.27
roznica12 13–24 mies.         rabat 1081  9.16  7.58 11.03       3.434    0.69
          p_gorna
1              NA
roznica      8.92
roznica1    21.23
11             NA
roznica2     7.57
roznica11   13.02
12             NA
roznica3     2.59
roznica12    5.92
Analysis of Deviance Table

Model 1: wrocil ~ grupa + segment
Model 2: wrocil ~ grupa * segment
  Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1      8995     6855.5
2      8991     6847.1  4   8.3595  0.07926 .
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
5. Trwałość wśród powracających
R
# Przepis 5. Trwałość odzyskanych: czas od powrotu do ponownego odejścia wśród powracających
# Korzysta z obiektów przepisu 1: ab. Nie losuje. Rysunek 5 powstaje w przepisie 6.
library(survival)

wr <- ab[ab$wrocil == 1, ]                            # tylko ci, którzy wrócili – porównanie warunkowe!
wr$mies_drugiego <- wr$dni_drugiego / 30.4
table(wr$grupa)
km2 <- survfit(Surv(mies_drugiego, odszedl_znowu) ~ grupa, data = wr)
s2 <- summary(km2, times = c(3, 4, 6), extend = TRUE)
round(data.frame(miesiac = s2$time, nadal_placi_proc = 100 * s2$surv, dolna = 100 * s2$lower,
                 gorna = 100 * s2$upper, row.names = paste(sub("grupa=", "", s2$strata), s2$time)), 1)
cox_wr <- coxph(Surv(mies_drugiego, odszedl_znowu) ~ grupa, data = wr)
round(cbind(HR = exp(coef(cox_wr)), exp(confint(cox_wr))), 2)
# Dlaczego? Skład powracających: udział osób, które wróciłyby i bez kontaktu (znany tylko w symulacji)
round(100 * prop.table(table(wr$grupa, wr$typ), 1), 1)
# Porównanie w jednej warstwie głównej („wróci i tak”) – też tylko w symulacji
cox_wit <- coxph(Surv(mies_drugiego, odszedl_znowu) ~ grupa, data = wr[wr$typ == "wróci i tak", ])
round(cbind(HR = exp(coef(cox_wit)), exp(confint(cox_wit))), 2)

sk2 <- summary(km2, times = seq(0, 12, by = 0.1), extend = TRUE)
km2_df <- data.frame(grupa = factor(sub("grupa=", "", sk2$strata), levels = levels(ab$grupa)),
                     miesiac = sk2$time, proc = 100 * sk2$surv)
Wynik w R
brak kontaktu        e-mail         rabat
          150           432           683
                miesiac nadal_placi_proc dolna gorna
brak kontaktu 3       3             85.3  79.5  91.5
brak kontaktu 4       4             81.6  75.1  88.6
brak kontaktu 6       6             74.0  66.3  82.6
e-mail 3              3             80.8  77.1  84.7
e-mail 4              4             72.6  68.3  77.1
e-mail 6              6             63.0  58.2  68.1
rabat 3               3             76.5  73.3  79.8
rabat 4               4             50.9  47.2  54.9
rabat 6               6             43.2  39.5  47.3
              HR 2.5 % 97.5 %
grupae-mail 1.45  1.04   2.03
gruparabat  2.35  1.71   3.24

                wróci i tak wróci po kontakcie wróci tylko z rabatem nie wróci
  brak kontaktu       100.0                0.0                   0.0       0.0
  e-mail               72.9               27.1                   0.0       0.0
  rabat                48.9               16.4                  34.7       0.0
              HR 2.5 % 97.5 %
grupae-mail 0.96  0.67   1.38
gruparabat  1.26  0.89   1.79
6. Symulacja 1000 eksperymentów: Rysunek 5
R
# Przepis 6. Symulacja 1000 eksperymentów: rabat NIE skraca drugiego abonamentu nikomu,
# a porównanie samych powracających i tak pokazuje „szybsze odejścia” (Rysunek 5)
# Korzysta z obiektów przepisów 1 i 5: parametry z przepisu 1, km2_df, kol_grupa, kol, motyw.
library(survival)

symuluj <- function(koniec = 0) {      # koniec = odsetek odchodzących po końcu rabatu (tu 0: brak efektu)
  gr <- factor(sample(rep(grupy, liczby)), levels = grupy); g <- as.character(gr)
  s <- sample(1:3, n, replace = TRUE, prob = udz_seg); U <- runif(n)
  i_tak <- U < p_sam[s]; wraca <- U < p_sam[s] * mnoznik[g]
  dzien <- runif(n, 1, 365); szybko <- !i_tak | runif(n) < przysp[g]
  dzien[szybko] <- pmin(waznosc, 1 + rexp(sum(szybko), 1 / 8))
  D <- rexp(n, ifelse(i_tak, h_mies["lojalny"], h_mies["nowy"]) / mies)
  k <- g == "rabat" & dzien <= waznosc & D > 3 * mies & runif(n) < koniec; D[k] <- 3 * mies
  d <- data.frame(grupa = gr, i_tak, t = pmin(D, 365 - dzien) / mies, e = as.integer(D <= 365 - dzien))[wraca, ]
  hr <- function(dd) summary(coxph(Surv(t, e) ~ grupa, data = dd))$coefficients["gruparabat", c(2, 5)]
  c(naiwny = hr(d), warstwa = hr(d[d$i_tak, ]))
}
set.seed(7476)
sym <- t(replicate(1000, symuluj(koniec = 0)))
colnames(sym) <- c("HR_naiwny", "p_naiwny", "HR_warstwa", "p_warstwa")
# Średni HR (rabat vs brak kontaktu) i odsetek badań z p < .05 i HR > 1, z błędem Monte Carlo
istotnie <- function(hr, p) mean(p < .05 & hr > 1)
round(c(HR_naiwny_srednio = mean(sym[, "HR_naiwny"]), HR_warstwa_srednio = mean(sym[, "HR_warstwa"]),
        naiwny_istotny_proc = 100 * istotnie(sym[, 1], sym[, 2]),
        blad_MC_pp = 100 * sqrt(istotnie(sym[, 1], sym[, 2]) * (1 - istotnie(sym[, 1], sym[, 2])) / 1000),
        warstwa_istotny_proc = 100 * istotnie(sym[, 3], sym[, 4])), 3)

pA <- ggplot(km2_df, aes(miesiac, proc, colour = grupa, linetype = grupa)) +
  geom_vline(xintercept = 3, colour = "grey60", linetype = "dotted") +
  annotate("text", x = 3.15, y = 12, label = "koniec rabatu", hjust = 0, size = 3.2, colour = "grey30") +
  geom_step(linewidth = 0.9) +
  scale_colour_manual(values = kol_grupa, name = NULL) +
  scale_linetype_manual(values = c("brak kontaktu" = "22", "e-mail" = "solid", "rabat" = "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 12, 3)) + coord_cartesian(ylim = c(0, 100)) +
  labs(x = "Miesiące od powrotu", y = "Nadal płaci (%)", title = "A. Tylko powracający (dane)") + motyw
dl <- rbind(data.frame(HR = sym[, "HR_naiwny"], porownanie = "wszyscy powracający"),
            data.frame(HR = sym[, "HR_warstwa"], porownanie = "tylko „wróciłby i tak”"))
pB <- ggplot(dl, aes(HR, fill = porownanie)) +
  geom_histogram(bins = 45, alpha = 0.75, position = "identity", colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = 1, colour = kol[["granat"]], linewidth = 0.8) +
  annotate("text", x = 1.02, y = Inf, label = "prawda: HR = 1", hjust = 0, vjust = 1.5, size = 3.3) +
  scale_fill_manual(values = c("wszyscy powracający" = "#D55E00", "tylko „wróciłby i tak”" = "#56B4E9"), name = NULL) +
  scale_x_log10(breaks = c(0.6, 0.8, 1, 1.25, 1.6, 2, 2.5)) +
  labs(x = "HR ponownego odejścia: rabat vs brak kontaktu (log)", y = "Liczba symulacji",
       title = "B. 1000 symulacji bez efektu rabatu") + motyw + guides(fill = guide_legend(nrow = 2))
p5 <- pA + pB + plot_layout(widths = c(1, 1.1))
p5   # zapis: ggsave("odzyskiwanie-klientow-selekcja.svg", p5, width = 10, height = 5)
Wynik w R
   HR_naiwny_srednio   HR_warstwa_srednio  naiwny_istotny_proc
               1.830                1.025               95.900
          blad_MC_pp warstwa_istotny_proc
               0.627                1.700
7. Wynik na osobę wylosowaną: Rysunek 6
R
# Przepis 7. Wynik na osobę wylosowaną: opłacone miesiące i wartość netto w 90 i 365 dni,
# różnice względem braku kontaktu z 95% CI z bootstrapu (Rysunek 6)
# Korzysta z obiektów przepisu 1: ab, cena, cena_rabat, kol_grupa, ksz_grupa, motyw.
ab$netto_90  <- ab$przychod_90 - ab$koszt
ab$netto_365 <- ab$przychod_365 - ab$koszt
# Średnio na osobę wylosowaną do grupy (także na tych, którzy nie wrócili – mają 0)
sr_os <- aggregate(cbind(mies_90, mies_365, netto_90, netto_365) ~ grupa, data = ab, FUN = mean)
sr_os[, -1] <- round(sr_os[, -1], 2); sr_os

roznice <- function(d) {                  # średnia w grupie minus średnia bez kontaktu
  m <- sapply(split(d[, c("mies_365", "netto_90", "netto_365")], d$grupa), colMeans)
  c(m[, "e-mail"] - m[, "brak kontaktu"], m[, "rabat"] - m[, "brak kontaktu"], m[, "rabat"] - m[, "e-mail"])
}
est <- roznice(ab)
set.seed(7477)
idx <- split(seq_len(nrow(ab)), ab$grupa)
boot <- replicate(2000, roznice(ab[unlist(lapply(idx, function(i) sample(i, replace = TRUE))), ]))
wyn <- data.frame(porownanie = rep(c("e-mail − brak", "rabat − brak", "rabat − e-mail"), each = 3),
                  miara = rep(c("mies_365", "netto_90", "netto_365"), 3), roznica = est,
                  dolna = apply(boot, 1, quantile, .025), gorna = apply(boot, 1, quantile, .975), row.names = NULL)
print(wyn, digits = 3)
# Koszt rabatu (utracony przychód: 24.50 zł × do 3 miesięcy) – ile trafiło do osób, które wróciłyby i tak
ab$koszt_rabatu <- ifelse(ab$rabat_uzyty == 1, (cena - cena_rabat) * pmin(ab$mies_365, 3), 0)
round(c(koszt_rabatu_zl = sum(ab$koszt_rabatu),
        do_wroci_i_tak_proc = 100 * sum(ab$koszt_rabatu[ab$typ == "wróci i tak"]) / sum(ab$koszt_rabatu)), 1)

w6 <- wyn[wyn$porownanie != "rabat − e-mail" & wyn$miara != "mies_365", ]
w6$grupa <- factor(sub(" − brak", "", w6$porownanie), levels = levels(ab$grupa))
w6$okno <- factor(ifelse(w6$miara == "netto_90", "90 dni", "365 dni"), levels = c("90 dni", "365 dni"))
sr <- aggregate(cbind(mies_90, mies_365) ~ grupa, data = ab, FUN = mean)
sr <- data.frame(grupa = rep(sr$grupa, 2), okno = factor(rep(c("90 dni", "365 dni"), each = 3), levels = c("90 dni", "365 dni")),
                 mies = c(sr$mies_90, sr$mies_365))
pA <- ggplot(sr, aes(okno, mies, fill = grupa)) +
  geom_col(position = position_dodge(0.8), width = 0.75) +
  geom_text(aes(label = sprintf("%.2f", mies)), position = position_dodge(0.8), vjust = -0.4, size = 3.3) +
  scale_fill_manual(values = kol_grupa, name = NULL) +
  labs(x = "Okno od wysyłki", y = "Opłacone miesiące na osobę", title = "A. Na osobę wylosowaną") + motyw
pB <- ggplot(w6, aes(okno, roznica, colour = grupa, shape = grupa)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.2, linewidth = 0.8, position = position_dodge(0.6)) +
  geom_point(size = 3.2, position = position_dodge(0.6)) +
  geom_text(aes(label = sprintf("%+.1f", roznica)), position = position_dodge(0.6), hjust = -0.7, size = 3.3,
            show.legend = FALSE) +
  scale_colour_manual(values = kol_grupa, name = NULL, drop = FALSE) +
  scale_shape_manual(values = ksz_grupa, name = NULL, drop = FALSE) +
  labs(x = "Okno od wysyłki", y = "Wartość netto wobec braku kontaktu\n(zł na osobę, 95% CI)",
       title = "B. Wartość netto dzięki kontaktowi") + motyw + guides(colour = "none", shape = "none")
p6 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p6   # zapis: ggsave("odzyskiwanie-klientow-wartosc.svg", p6, width = 10, height = 4.8)
Wynik w R
          grupa mies_90 mies_365 netto_90 netto_365
1 brak kontaktu    0.04     0.47     2.04     22.89
2        e-mail    0.19     0.77     9.26     37.59
3         rabat    0.40     1.08    10.06     42.88
      porownanie     miara roznica  dolna  gorna
1  e-mail − brak  mies_365   0.302  0.180  0.415
2  e-mail − brak  netto_90   7.223  5.821  8.570
3  e-mail − brak netto_365  14.695  8.733 20.223
4   rabat − brak  mies_365   0.608  0.479  0.732
5   rabat − brak  netto_90   8.019  6.828  9.067
6   rabat − brak netto_365  19.990 14.076 25.843
7 rabat − e-mail  mies_365   0.306  0.188  0.435
8 rabat − e-mail  netto_90   0.796 -0.585  2.232
9 rabat − e-mail netto_365   5.295 -0.150 10.978
    koszt_rabatu_zl do_wroci_i_tak_proc
            34986.0                36.3
8. Grafika: oś czasu klienta – Rysunek 1
R
# Przepis 8. Grafika: oś czasu klienta „odejście – oferta – powrót – ponowne odejście” (Rysunek 1)
# Korzysta z obiektów przepisu 1: ab, kol, motyw. Nie losuje. Udziały typów – z danych symulowanych.
udz <- round(100 * prop.table(table(ab$typ)), 1)
udz
wiersze <- data.frame(y = 4:1, etykieta = c(
  sprintf("Wróciłby i tak (%.1f%%)", udz[["wróci i tak"]]),
  sprintf("Wraca po e-mailu lub rabacie (%.1f%%)", udz[["wróci po kontakcie"]]),
  sprintf("Wraca tylko z rabatem (%.1f%%)", udz[["wróci tylko z rabatem"]]),
  sprintf("Nie wraca (%.1f%%)", udz[["nie wróci"]])))
pierwszy <- data.frame(y = 4:1, od = -8, do = c(-3, -2, -5, -4))              # pierwszy abonament
drugi    <- data.frame(y = c(4, 3, 2), od = c(5, 0.4, 0.5), do = c(12.6, 6, 3.5)) # drugi abonament
p8 <- ggplot() +
  annotate("rect", xmin = 0, xmax = 3, ymin = 0.45, ymax = 4.75, fill = "grey93") +
  annotate("text", x = 1.5, y = 4.62, label = "okno 90 dni", size = 3.4, colour = "grey25") +
  annotate("segment", x = 0, xend = 12, y = 5.05, yend = 5.05, colour = "grey35",
           arrow = arrow(ends = "both", length = unit(0.12, "cm"))) +
  annotate("text", x = 6, y = 5.25, label = "12 miesięcy obserwacji po wysyłce", size = 3.4, colour = "grey25") +
  geom_vline(xintercept = 0, colour = kol[["granat"]], linewidth = 0.9) +
  annotate("label", x = 0, y = 0.3, label = "Wysyłka (losowo): rabat / e-mail / nic", size = 3.4,
           colour = kol[["granat"]], fill = "white") +
  geom_rect(data = pierwszy, aes(xmin = od, xmax = do, ymin = y - 0.16, ymax = y + 0.16), fill = "grey70") +
  geom_rect(data = drugi, aes(xmin = od, xmax = do, ymin = y - 0.16, ymax = y + 0.16), fill = "#0072B2") +
  annotate("rect", xmin = 0.5, xmax = 3.5, ymin = 1.84, ymax = 2.16, fill = "#D55E00") +
  annotate("text", x = 2, y = 2, label = "rabat −50%", size = 3.2, colour = "white", fontface = "bold") +
  geom_point(data = pierwszy, aes(do, y), shape = 4, size = 3.5, stroke = 1.4) +              # odejście
  geom_point(data = drugi, aes(od, y), shape = 21, size = 3.6, fill = "white", stroke = 1.3) + # powrót
  annotate("point", x = c(6, 3.5), y = c(3, 2), shape = 4, size = 3.5, stroke = 1.4, colour = "#D55E00") +
  annotate("text", x = -3, y = 4.33, label = "odejście", size = 3.2) +
  annotate("text", x = 5, y = 4.33, label = "powrót (bez kontaktu)", size = 3.2) +
  annotate("text", x = 6.2, y = 3.33, label = "ponowne odejście", size = 3.2, hjust = 0.2) +
  annotate("text", x = 3.7, y = 2.33, label = "odchodzi po końcu rabatu", size = 3.2, hjust = 0) +
  annotate("text", x = 12.7, y = 4, label = "płaci dalej", size = 3.2, hjust = 0) +
  annotate("text", x = 1, y = 1, label = "brak drugiego abonamentu", size = 3.2, hjust = 0, colour = "grey35") +
  geom_text(data = wiersze, aes(x = -8.2, y = y, label = etykieta), hjust = 1, size = 3.6, fontface = "bold",
            colour = kol[["granat"]]) +
  scale_x_continuous(breaks = c(-6, -3, 0, 3, 6, 9, 12), limits = c(-17.5, 15)) +
  scale_y_continuous(limits = c(0.15, 5.35)) +
  labs(x = "Miesiące względem wysyłki (0)", y = NULL,
       title = "Cztery typy byłych abonentów – w danych widać tylko, kto wrócił w swojej grupie") +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
p8   # zapis: ggsave("odzyskiwanie-klientow-os-czasu.svg", p8, width = 10, height = 5.4)
Wynik w R
          wróci i tak    wróci po kontakcie wróci tylko z rabatem
                  8.9                   3.0                   6.8
            nie wróci
                 81.3
9. Czy paleta przetrwa zaburzenia widzenia barw?
R
# Przepis 9. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("rabat – e-mail" = c("#D55E00", "#0072B2"), "rabat – brak kontaktu" = c("#D55E00", "#666666"),
             "e-mail – brak kontaktu" = c("#0072B2", "#666666"), "histogram: wszyscy – warstwa" = c("#D55E00", "#56B4E9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
rabat – e-mail                             114.6        108.3       91.9
rabat – brak kontaktu                       77.4         64.4       54.0
e-mail – brak kontaktu                      41.6         44.9       38.7
histogram: wszyscy – warstwa               113.6        101.1       89.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, odsetki, przedziały, test χ², regresja logistyczna i bootstrap – pakiety base i stats; Kaplan–Meier, log-rank i model Coxa – pakiet survival). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Brak grupy kontrolnej. 43.9% powrotów po rabacie zdarzyłoby się i bez niego.
- Porównanie samych powracających. Nawet bez żadnego efektu rabatu daje „szybsze odejścia” w 95.9% symulowanych eksperymentów.
- Krótkie okno pomiaru. Po 90 dniach przyrost powrotów jest zawyżony (+13.28 pp zamiast +10.64 pp), a wartość rabatu zaniżona; ponowne odejścia po końcu rabatu pojawiają się dopiero po 3 miesiącach.
- Jeden HR dla całego roku przy efekcie skupionym w pierwszym miesiącu.
- Zgoda na kontakt. Losowaliśmy tylko wśród osób, które ją wyraziły. Wnioski dotyczą tej grupy, nie wszystkich byłych abonentów – osoby bez zgody mogą wracać rzadziej.
- Nieodebrane e-maile. Porównuj grupy z losowania, nie „otworzył e-mail” z „nie otworzył” – otwierają zwykle osoby bardziej zainteresowane powrotem.
Najczęstsze pytania
Jak zmierzyć skuteczność kampanii odzyskiwania klientów?
Wylosuj byłych klientów do grup z kontaktem i do grupy bez kontaktu, a potem porównaj odsetek powrotów w ustalonym oknie. Różnica to przyrost – powroty, których bez kampanii by nie było. W przykładzie rabat dał +10.64 pp powrotów w roku (95% CI [8.79, 12.41]), choć wróciło 18.97% osób, bo 8.33% wróciłoby i bez kontaktu.
Dlaczego nie porównywać trwałości samych powracających klientów?
Bo grupy powracających różnią się składem: oferta ściąga osoby, które bez niej by nie wróciły, a te zwykle szybciej odchodzą. To błąd selekcji – warunkowanie na zdarzeniu, na które wpływa interwencja. W 1000 symulacjach, w których rabat nikomu nie skracał abonamentu, porównanie powracających dawało średnio HR = 1.83 i „istotny” wynik w 95.9% przypadków.
Co zamiast porównania powracających?
Licz wynik na każdą wylosowaną osobę, także na tych, którzy nie wrócili (wynik 0): liczbę opłaconych miesięcy albo wartość netto w roku. To analiza ITT, która zachowuje zalety losowania. W przykładzie rabat dał +0.61 opłaconego miesiąca na osobę (95% CI [0.48, 0.73]).
Czy model Coxa nadaje się do czasu do powrotu klienta?
Tak, ale sprawdź proporcjonalność hazardów. Efekt e-maila czy rabatu zwykle skupia się w pierwszych tygodniach: w przykładzie HR dla rabatu wynosił 16.92 w dniach 0–30 i 0.69 w dniach 31–365. Jeden HR = 2.56 uśrednia te okresy – podaj HR w przedziałach czasu albo odsetki w ustalonych dniach.
Jak długo mierzyć efekt kampanii win-back?
Dłużej niż czas działania oferty. Po 90 dniach przyrost powrotów był zawyżony (+13.28 pp zamiast +10.64 pp po roku), bo część osób tylko wróciła wcześniej, a wartość rabatu – zaniżona. Ponowne odejścia po końcu rabatu pojawiły się dopiero po 3 miesiącach, więc okno co najmniej pół roku do roku jest bezpieczniejsze.
Powiązane hasła
Przeczytaj też
Churn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →PoradnikTest wyłączenia reklamy (holdout)
Sklep z odzieżą: przyrost sprzedaży z holdoutu, ITT i CACE, iCPA wobec CPA z panelu, duże zamówienia i wielkość holdoutu – kod R.
Czytaj →PoradnikRabat na pierwszy miesiąc a rezygnacje
Konwersja rośnie, a co z retencją? Test A/B rabatu, Kaplan–Meier, Cox z resztami Schoenfelda i marża na odwiedzającego z bootstrapu – z kodem R.
Czytaj →Analizujesz kampanię odzyskiwania klientów albo piszesz o niej pracę?
Pomożemy zaplanować eksperyment z grupą kontrolną, policzyć przyrost powrotów, czas do powrotu i wartość na osobę wylosowaną oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ascarza, E. (2018). Retention futility: Targeting high-risk customers might be ineffective. Journal of Marketing Research, 55(1), 80–98. https://doi.org/10.1509/jmr.16.0163 ● Otwarty dostęp: pełny tekst
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Frangakis, C. E., & Rubin, D. B. (2002). Principal stratification in causal inference. Biometrics, 58(1), 21–29. https://doi.org/10.1111/j.0006-341x.2002.00021.x ● Otwarty dostęp: pełny tekst
- Hernán, M. A. (2010). The hazards of hazard ratios. Epidemiology, 21(1), 13–15. https://doi.org/10.1097/ede.0b013e3181c1ea43 ● Otwarty dostęp: pełny tekst
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Kumar, V., Bhagwat, Y., & Zhang, X. (2015). Regaining “lost” customers: The predictive power of first-lifetime behavior, the reason for defection, and the nature of the win-back offer. Journal of Marketing, 79(4), 34–55. https://doi.org/10.1509/jm.14.0107
- Thomas, J. S., Blattberg, R. C., & Fox, E. J. (2004). Recapturing lost customers. Journal of Marketing Research, 41(1), 31–45. https://doi.org/10.1509/jmkr.41.1.31.25086
Cytowania BibTeX
@article{ascarza2018retention, author={Ascarza, Eva}, title={{Retention futility: Targeting high-risk customers might be ineffective}}, journal={Journal of Marketing Research}, year={2018}, volume={55}, number={1}, pages={80--98}, doi={10.1509/jmr.16.0163}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{frangakis2002principal, author={Frangakis, Constantine E. and Rubin, Donald B.}, title={{Principal stratification in causal inference}}, journal={Biometrics}, year={2002}, volume={58}, number={1}, pages={21--29}, doi={10.1111/j.0006-341x.2002.00021.x}}@article{hernan2010hazards, author={Hernán, Miguel A.}, title={{The hazards of hazard ratios}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={13--15}, doi={10.1097/ede.0b013e3181c1ea43}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{kumar2015regaining, author={Kumar, V. and Bhagwat, Yashoda and Zhang, Xi (Alan)}, title={{Regaining “lost” customers: The predictive power of first-lifetime behavior, the reason for defection, and the nature of the win-back offer}}, journal={Journal of Marketing}, year={2015}, volume={79}, number={4}, pages={34--55}, doi={10.1509/jm.14.0107}}@article{thomas2004recapturing, author={Thomas, Jacquelyn S. and Blattberg, Robert C. and Fox, Edward J.}, title={{Recapturing lost customers}}, journal={Journal of Marketing Research}, year={2004}, volume={41}, number={1}, pages={31--45}, doi={10.1509/jmkr.41.1.31.25086}}