Co to jest DML?
Podwójne uczenie maszynowe (double/debiased machine learning, DML) szacuje jeden parametr przyczynowy, np. efekt ekspozycji D na wynik Y, gdy trzeba kontrolować wiele zmiennych zakłócających X o nieznanym, nieliniowym wpływie. W modelu częściowo liniowym Y = θD + g(X) + ε oraz D = m(X) + v. Funkcje pomocnicze g i m szacuje dowolny algorytm: las losowy (zob. drzewa decyzyjne i lasy losowe), LASSO czy boosting.
Dlaczego nie wstawić prognoz wprost?
Chernozhukov i in. (2018) pokazali, że regularyzacja i przeuczenie modeli pomocniczych mocno obciążają θ, jeśli prognozy wstawia się naiwnie do równań estymacyjnych. Obciążenie usuwają dwa składniki. Pierwszy to momenty ortogonalne w sensie Neymana, mało czułe na błędy w g i m. Drugi to cross-fitting, czyli wydajny podział danych. Estymator jest wtedy w przybliżeniu nieobciążony i ma rozkład normalny, więc przedziały ufności są poprawne.
Ortogonalizacja i cross-fitting
Pomysł sięga Robinsona (1988). Oczyść Y i D z wpływu X regresją nieparametryczną, a potem regresuj resztę Y na resztę D. Taki estymator jest zgodny w tempie √N i asymptotycznie normalny. DML robi to samo z uczeniem maszynowym, ale prognozę dla każdej osoby bierze z modelu uczonego na pozostałych foldach, jak w walidacji krzyżowej. Foldy zamieniają się rolami. Dla binarnego leczenia ten schemat daje estymator podwójnie odporny (AIPW).
Przykład
W symulowanej próbie 2000 osób z 10 zmiennymi X prawdziwe θ = 0.5, a x2 działa przez |x2|. Regresja OLS z liniową kontrolą X daje 0.889 (SE = 0.024). DML z lasem losowym (DoubleML, 5 foldów) daje 0.539, 95% CI [0.494, 0.583], a ręczny cross-fitting 0.541. DML z LASSO daje 0.890, bo model liniowy nie wychwycił |x2|. DML jest tak dobre, jak modele pomocnicze.
Na rysunku
Przykład wyżej to jedno badanie. Rysunek powtarza je 50 razy na mniejszych próbach (n = 500), żeby pokazać, gdzie średnio lądują oszacowania θ z trzech podejść.
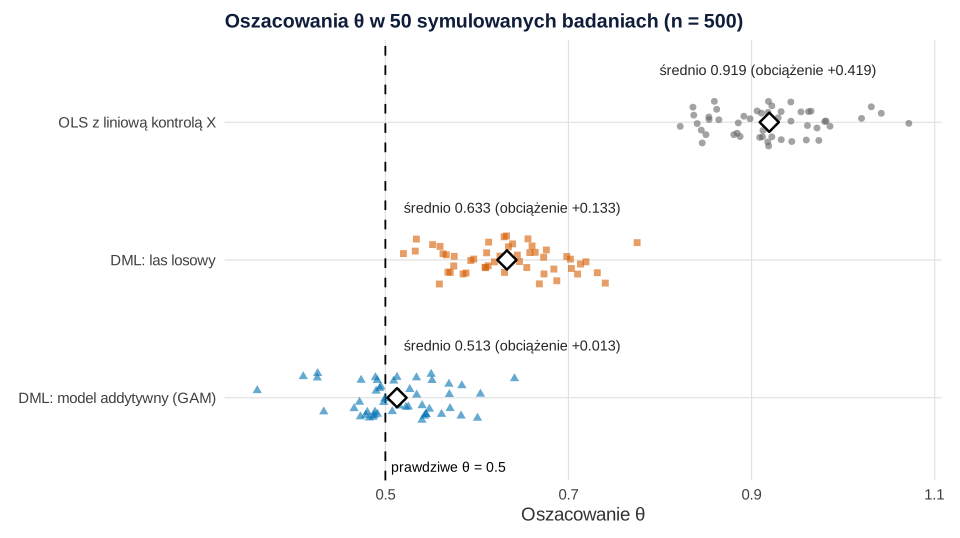
set.seed(7141)).Co widać. Regresja z liniową kontrolą X myli się systematycznie: średnio 0.919 zamiast 0.5, bo nie usuwa nieliniowego wpływu |x2|. DML z lasem losowym zbliża się do prawdy, ale przy 500 osobach i 100 drzewach wciąż daje średnio 0.633 (obciążenie 0.133). Las nie odtworzył dość dokładnie funkcji m i g, a to, czego nie odtworzył, zostaje w resztach jako zakłócenie. DML z modelem addytywnym (GAM ze sklejkami dla każdej zmiennej) daje średnio 0.513. Błąd Monte Carlo każdej średniej wynosi około 0.008, więc różnice między metodami są dużo większe niż szum symulacji. W przykładzie z 2000 osobami DML z lasem było bliżej prawdy (0.539) – obciążenie maleje, gdy modele pomocnicze uczą się na większej próbie.
Na co uważać. GAM wygrywa tu dlatego, że prawdziwe m i g są sumami funkcji pojedynczych zmiennych, czyli mają dokładnie taką postać, jaką zakłada ten model. W prawdziwych danych tej postaci nie znamy, więc wybór modeli pomocniczych opieraj na ich błędzie prognozy poza próbą. Wielkość próby, liczbę drzew i 50 powtórzeń ustawiono ręcznie, żeby symulacja trwała około 50 s; ziarna nie zmieniano. Ogólną logikę zakłócania na rysunkach pokazuje wpis zmienna zakłócająca i collider – wizualizacja.
Podpis do pracy:
Kod jest samowystarczalny: prosty motyw i paletę definiuje sam. Symulację losuje blok zaczynający się od set.seed(7141); punkty rozsunięto w pionie funkcją position_jitter() z własnym ziarnem (seed = 71410). Kod liczy DML ręcznie (cross-fitting i regresja reszt na resztach jak w przykładzie), bez pakietu DoubleML, żeby 50 powtórzeń zmieściło się w minucie. Rysunek na stronie powstał z tego samego obiektu p z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki.
Kod R rysunku
# Rysunek 1. Symulacja 50 badań: OLS z liniową kontrolą X i DML z dwoma rodzajami modeli pomocniczych
library(ggplot2)
library(ranger)
suppressPackageStartupMessages(library(mgcv))

# Paleta Okabe–Ito i prosty motyw
kol <- c("OLS z liniową kontrolą X" = "grey40", "DML: las losowy" = "#D55E00",
         "DML: model addytywny (GAM)" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "none", plot.background = element_rect(fill = "white", colour = NA))

# Model jak w przykładzie hasła (theta = 0.5, nieliniowe zakłócenie przez x1 i |x2|, 10 zmiennych X),
# ale n = 500 osób, 100 drzew i 50 powtórzeń – żeby całość liczyła się w niecałą minutę.
# Oba warianty DML: ręczny 5-krotny cross-fitting i regresja reszt y na resztach d.
jedno_badanie <- function(n = 500, p = 10, theta = 0.5) {
  X <- matrix(rnorm(n * p), n, p, dimnames = list(NULL, paste0("x", 1:p)))
  d <- tanh(X[, 1]) + abs(X[, 2]) + rnorm(n)
  y <- theta * d + sin(X[, 1]) + 1.5 * abs(X[, 2]) + 0.5 * X[, 3] + rnorm(n)
  dane_x <- as.data.frame(X)
  wzor <- as.formula(paste("v ~", paste0("s(x", 1:p, ", k = 5)", collapse = " + ")))
  fold <- sample(rep(1:5, length.out = n))
  r_las <- r_gam <- matrix(0, n, 2, dimnames = list(NULL, c("y", "d")))
  for (k in 1:5) {
    u <- fold != k; te <- fold == k
    for (v in c("y", "d")) {
      cel <- if (v == "y") y else d
      las <- ranger(x = X[u, ], y = cel[u], num.trees = 100, num.threads = 1)
      r_las[te, v] <- cel[te] - predict(las, X[te, ])$predictions
      gam_k <- gam(wzor, data = cbind(dane_x[u, ], v = cel[u]))
      r_gam[te, v] <- cel[te] - predict(gam_k, dane_x[te, ])
    }
  }
  reszty <- function(r) sum(r[, "y"] * r[, "d"]) / sum(r[, "d"]^2)   # regresja reszt na resztach
  c(ols = unname(coef(lm(y ~ d + X))["d"]), las = reszty(r_las), gam = reszty(r_gam))
}

set.seed(7141)
R <- 50
est <- replicate(R, jedno_badanie())         # ok. 50 s
podsum <- data.frame(srednia_theta = rowMeans(est), obciazenie = rowMeans(est) - 0.5,
                     blad_MC_sredniej = apply(est, 1, sd) / sqrt(R), SD_theta = apply(est, 1, sd))
round(podsum, 3)

d <- data.frame(metoda = factor(rep(names(kol), times = R), levels = rev(names(kol))), theta = c(est))
sr <- data.frame(metoda = factor(names(kol), levels = rev(names(kol))), theta = podsum$srednia_theta,
                 tekst = sprintf("średnio %.3f (obciążenie %+.3f)", podsum$srednia_theta, podsum$obciazenie))
p <- ggplot(d, aes(theta, metoda, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = 0.5, linetype = "dashed", colour = "black") +
  geom_point(position = position_jitter(width = 0, height = 0.18, seed = 71410), alpha = 0.6, size = 2) +
  geom_point(data = sr, shape = 23, size = 4.5, fill = "white", colour = "black", stroke = 1.3) +
  geom_text(data = sr, aes(x = pmax(theta - 0.12, 0.52), label = tekst), hjust = 0, nudge_y = 0.38,
            size = 3.8, colour = "grey15") +
  annotate("text", x = 0.5, y = 0.5, label = "prawdziwe θ = 0.5", hjust = -0.05, size = 3.7) +
  scale_colour_manual(values = kol) +
  scale_shape_manual(values = c(17, 15, 16)) +
  labs(title = "Oszacowania θ w 50 symulowanych badaniach (n = 500)", x = "Oszacowanie θ", y = NULL) +
  motyw
p
Wynik w R
    srednia_theta obciazenie blad_MC_sredniej SD_theta
ols         0.919      0.419            0.008    0.057
las         0.633      0.133            0.008    0.060
gam         0.513      0.013            0.007    0.052
Jak opisać w pracy
Na co uważać
- Nieobserwowane zakłócenia zostają. DML lepiej kontroluje zmierzone X, ale nie usuwa wpływu niezmierzonych.
- Losowy podział na foldy. Powtórz cross-fitting kilka razy (
n_rep) i podaj medianę. - Wybór algorytmu. Porównaj kilka modeli pomocniczych i oceniaj ich błąd prognozy poza próbą.
Gdy pytasz, komu efekt służy bardziej, sięgnij po CATE i lasy przyczynowe.
DML w R
Kod symuluje model częściowo liniowy z nieliniowym zakłóceniem, porównuje OLS, DML z lasem losowym i z LASSO (DoubleML), a na końcu powtarza DML ręcznym cross-fittingiem. Liczby w tekście pochodzą z tego kodu.
Model częściowo liniowy: OLS, DoubleML i ręczny cross-fitting
R
set.seed(7140)
library(DoubleML); library(mlr3); library(mlr3learners)
lgr::get_logger("mlr3")$set_threshold("warn")
n <- 2000; p <- 10                                   # dane symulowane: 2000 osób, 10 zmiennych X
X <- matrix(rnorm(n * p), n, p, dimnames = list(NULL, paste0("x", 1:p)))
m <- tanh(X[, 1]) + abs(X[, 2])                      # nieliniowy wpływ X na ekspozycję D
g <- sin(X[, 1]) + 1.5 * abs(X[, 2]) + 0.5 * X[, 3]  # nieliniowy wpływ X na wynik Y
d <- m + rnorm(n)
y <- 0.5 * d + g + rnorm(n)                          # prawdziwy efekt D na Y: theta = 0.5
dane <- data.frame(y = y, d = d, X)
round(coef(summary(lm(y ~ ., data = dane)))["d", 1:2], 3)   # OLS z liniową kontrolą X
dml_dane <- DoubleMLData$new(dane, y_col = "y", d_cols = "d")
las <- lrn("regr.ranger", num.trees = 500, num.threads = 1)
plr_rf <- DoubleMLPLR$new(dml_dane, ml_l = las, ml_m = las$clone(), n_folds = 5)
plr_rf$fit()
round(c(theta = plr_rf$coef, se = plr_rf$se, plr_rf$confint()[1, ]), 3)   # DML z lasem losowym
lasso <- lrn("regr.cv_glmnet", s = "lambda.min")
plr_lasso <- DoubleMLPLR$new(dml_dane, ml_l = lasso, ml_m = lasso$clone(), n_folds = 5)
plr_lasso$fit()
round(c(theta = plr_lasso$coef, se = plr_lasso$se), 3)   # DML z LASSO (model liniowy w X)
# ręczny cross-fitting (ortogonalizacja Robinsona): reszty y i d z prognoz poza foldem
fold <- sample(rep(1:5, length.out = n)); ry <- rd <- numeric(n)
for (k in 1:5) {
  ucz <- fold != k; test <- fold == k
  fy <- ranger::ranger(x = X[ucz, ], y = y[ucz], num.trees = 500, num.threads = 1)
  fd <- ranger::ranger(x = X[ucz, ], y = d[ucz], num.trees = 500, num.threads = 1)
  ry[test] <- y[test] - predict(fy, X[test, ])$predictions
  rd[test] <- d[test] - predict(fd, X[test, ])$predictions
}
fit_r <- lm(ry ~ 0 + rd)                             # regresja reszt na resztach
round(c(theta = unname(coef(fit_r)), se_HC = sqrt(sandwich::vcovHC(fit_r, type = "HC0"))[1]), 3)
Wynik w R
  Estimate Std. Error
     0.889      0.024
theta.d    se.d   2.5 %  97.5 %
  0.539   0.023   0.494   0.583
theta.d    se.d
  0.890   0.024
theta se_HC
0.541 0.023
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety DoubleML, mlr3, mlr3learners, ranger, glmnet, sandwich i lgr). Symulację do Rysunku 1 wykonano pakietami ranger i mgcv, rysunek – w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DoubleML (wersja 1.0.2): Bach, P., Kurz, M. S., Chernozhukov, V., Spindler, M., & Klaassen, S. (2024). DoubleML: An object-oriented implementation of double machine learning in R. Journal of Statistical Software, 108(3), 1–56. https://doi.org/10.18637/jss.v108.i03
- mlr3 (wersja 1.8.0): Lang, M., Binder, M., Richter, J., Schratz, P., Pfisterer, F., Coors, S., Au, Q., Casalicchio, G., Kotthoff, L., & Bischl, B. (2019). mlr3: A modern object-oriented machine learning framework in R. Journal of Open Source Software, 4(44), 1903. https://doi.org/10.21105/joss.01903
- mlr3learners (wersja 0.16.0): Lang, M., Au, Q., Coors, S., Schratz, P., Becker, M., & Zobolas, J. (2026). mlr3learners: Recommended learners for 'mlr3' (R package version 0.16.0) [Computer software]. https://doi.org/10.32614/CRAN.package.mlr3learners
- ranger (wersja 0.18.0): Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01
- glmnet (wersja 5.0): Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- sandwich (wersja 3.1.1): Zeileis, A. (2006). Object-oriented computation of sandwich estimators. Journal of Statistical Software, 16(9), 1–16. https://doi.org/10.18637/jss.v016.i09
- lgr (wersja 0.5.2): Fleck, S. (2026). lgr: A fully featured logging framework (R package version 0.5.2) [Computer software]. https://doi.org/10.32614/CRAN.package.lgr
- mgcv (wersja 1.9-4): Wood, S. N. (2011). Fast stable restricted maximum likelihood and marginal likelihood estimation of semiparametric generalized linear models. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 73(1), 3–36. https://doi.org/10.1111/j.1467-9868.2010.00749.x
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego „podwójne”?
Bo uczenie maszynowe stosuje się dwa razy: do przewidywania wyniku Y z X i ekspozycji D z X. Efekt szacuje się potem z reszt obu modeli.
Po co cross-fitting?
Prognozy dla każdej osoby pochodzą z modelu, który jej nie widział. Dzięki temu przeuczenie modeli pomocniczych nie obciąża oszacowania efektu, a zamiana foldów rolami pozwala wykorzystać wszystkie dane.
Jaki algorytm wybrać do DML?
Taki, który dobrze przewiduje Y i D poza próbą. W przykładzie las losowy dał θ = 0.54 przy prawdziwym 0.5, a LASSO, które nie uchwyciło nieliniowości, 0.89. Warto porównać kilka algorytmów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Chernozhukov, V., Chetverikov, D., Demirer, M., Duflo, E., Hansen, C., Newey, W., & Robins, J. (2018). Double/debiased machine learning for treatment and structural parameters. The Econometrics Journal, 21(1), C1–C68. https://doi.org/10.1111/ectj.12097
- Robinson, P. M. (1988). Root-N-consistent semiparametric regression. Econometrica, 56(4), 931. https://doi.org/10.2307/1912705
Cytowania BibTeX
@article{chernozhukov2018double, author={Chernozhukov, Victor and Chetverikov, Denis and Demirer, Mert and Duflo, Esther and Hansen, Christian and Newey, Whitney and Robins, James}, title={{Double/debiased machine learning for treatment and structural parameters}}, journal={The Econometrics Journal}, year={2018}, volume={21}, number={1}, pages={C1--C68}, doi={10.1111/ectj.12097}}@article{robinson1988root, author={Robinson, P. M.}, title={{Root-N-consistent semiparametric regression}}, journal={Econometrica}, year={1988}, volume={56}, number={4}, pages={931}, doi={10.2307/1912705}}