Co to jest wykres współrzędnych równoległych?
Wykres współrzędnych równoległych (ang. parallel coordinates plot) pokazuje obserwacje opisane kilkoma zmiennymi ilościowymi naraz. Każda zmienna ma własną pionową oś, osie stoją obok siebie, a każda osoba jest łamaną łączącą jej wyniki na kolejnych osiach. Geometrię tej reprezentacji opisuje monografia Inselberga (2009), a Wegman (1990) przedstawił ją jako narzędzie analizy danych wielowymiarowych, omawiając m.in. znaczenie kolejności osi. Zmienne mają zwykle różne jednostki, dlatego każdą oś skaluje się osobno – najczęściej przez standaryzację do wyników z albo do zakresu 0–1.
Jak czytać wykres
- Linie prawie równoległe między dwiema sąsiednimi osiami oznaczają dodatnią korelację tych zmiennych, a linie krzyżujące się w jednym miejscu (kształt litery X) – ujemną.
- Wiązki linii o podobnym przebiegu to grupy osób o podobnym profilu. Kolorem i rodzajem linii zaznacza się zwykle skupienie z analizy skupień albo profil z analizy profili latentnych.
- Gruba linia średnich w grupie to znany wykres profilu. Cienkie linie pokazują, jak bardzo poszczególne osoby od niego odbiegają.
- Pojedyncza linia z dala od wiązek to nietypowy profil, wart sprawdzenia w danych.
Przykład
Symulowano 120 studentów z trzech profili po 40 osób, opisanych sześcioma skalami: motywacja, samoocena, wsparcie, lęk, prokrastynacja i zmęczenie. Średnie profili ustawiono ręcznie tak, by grupy różniły się kształtem profilu; rozrzut wewnątrz profilu to 0.6 odchylenia standardowego, a ziarna (743) nie zmieniano. Po standaryzacji metoda k-średnich z trzema skupieniami odtworzyła profile – tylko 1 osoba ze 120 trafiła do innego skupienia niż jej profil. S1 ma wysokie wyniki motywacji, samooceny i wsparcia (od 0.91 do 0.97) oraz niskie lęku, prokrastynacji i zmęczenia (od −0.85 do −0.99). S2 wyróżnia wysoki lęk (0.98) i niska samoocena (−0.90), a S3 – niska motywacja (−1.15) i wysoka prokrastynacja (0.84).
Na rysunku
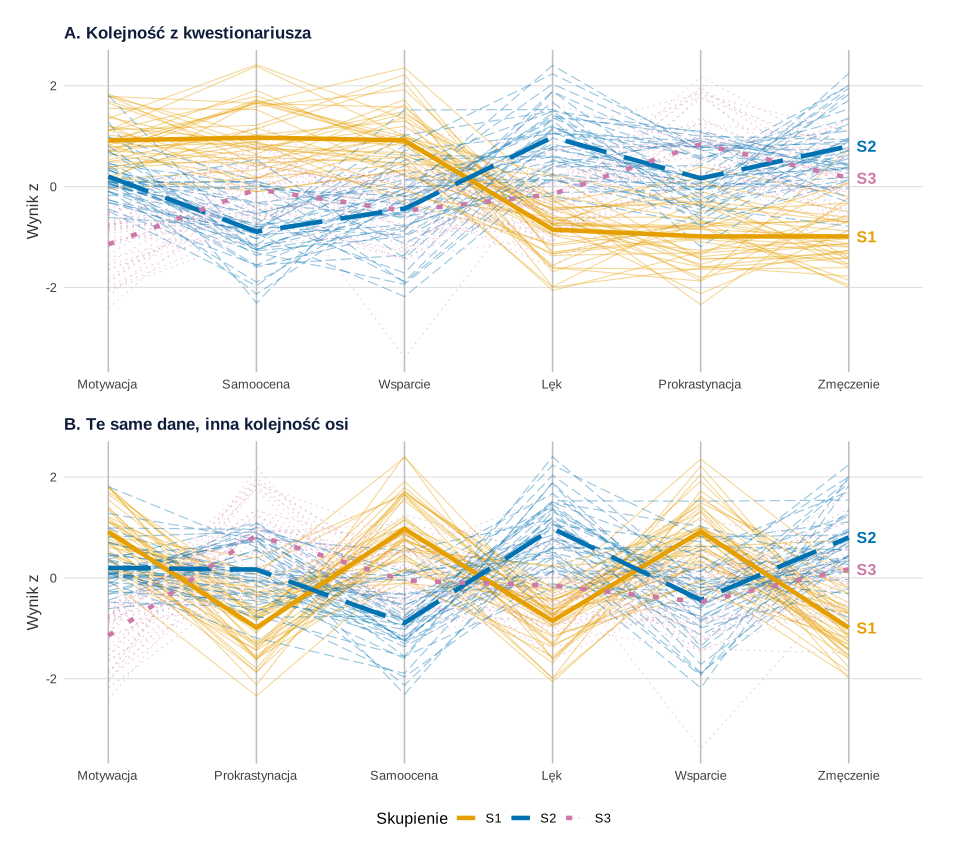
set.seed(743)).Co widać. W panelu A osie stoją w kolejności z kwestionariusza. Profil S1 to wyraźny schodek: wysoko na pierwszych trzech osiach, nisko na ostatnich. Średnia korelacja sąsiednich osi wynosi .22, a krzyżuje się 42.6% par odcinków między sąsiednimi osiami. W panelu B są te same osoby, ale obok siebie stoją zmienne ujemnie skorelowane: średnia korelacja sąsiednich osi spada do −.46, a krzyżuje się 66.2% par odcinków. Każdy profil wygląda teraz jak zygzak i trudniej uchwycić, czym grupy się różnią.
Na co uważać. Kolejność osi zmienia obraz, choć dane są te same. Wykres pokazuje wprost tylko związki sąsiednich osi – pary odległe, np. motywację i zmęczenie, lepiej obejrzeć na macierzy wykresów rozrzutu. Przy setkach osób linie zlewają się, więc pomaga przezroczystość albo pokazanie losowej próbki osób obok średnich. Kolejność, kierunek i skalowanie osi to decyzje autora rysunku – podaj je w podpisie.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Osie w surowych jednostkach. Skala 1–5 obok skali 20–80 daje linie, których kształt zależy od jednostek, a nie od osób. Standaryzuj albo skaluj do 0–1 i napisz, co wybrałeś.
- Kolor jako jedyny nośnik. Grupy rozróżniaj też rodzajem linii albo etykietą przy końcu linii średniej.
- Liczba skupień „z wykresu”. Wykres pokazuje grupy, które już wyznaczyłeś. O ich liczbie decydują kryteria opisane we wpisie Analiza skupień krok po kroku.
- Zakładanie, że czytelnik umie go czytać. Johansson i Forsell (2016) zauważają, że mimo popularności techniki niewiele badań sprawdziło, jak ludzie faktycznie korzystają z takich wykresów. W pracy dodaj zdanie, jak czytać rysunek.
Porównanie k-średnich z analizą profili latentnych na danych ankietowych pokazuje wpis Segmentacja respondentów: k-średnich i LPA.
Wykres współrzędnych równoległych w R
Kod symuluje dane, wyznacza skupienia, liczy dla obu kolejności osi średnią korelację sąsiednich osi i liczbę par osób, których odcinki się krzyżują, a potem rysuje oba panele. Gotową wersję wykresu daje też funkcja ggparcoord() z pakietu GGally (argumenty scale i order). Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Skupienia na osiach równoległych i kolejność osi
R
# Wykres współrzędnych równoległych: 120 osób, 6 skal (wyniki z), linie w kolorze skupienia k-średnich
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("#E69F00", "#0072B2", "#CC79A7")          # Okabe–Ito; skupienia różnią się też rodzajem linii
motyw <- theme_minimal(base_size = 12) + theme(panel.grid.minor = element_blank(),
                                              panel.grid.major.y = element_blank())
set.seed(743)                                      # 3 profile po 40 osób, rozrzut w profilu SD = 0.6
srednie <- rbind(c( 1.0,  0.8,  0.6, -0.8, -0.9, -0.5),
                 c( 0.3, -0.8, -0.3,  1.1,  0.2,  0.7),
                 c(-1.2, -0.1, -0.4, -0.2,  0.9,  0.2))
skale <- c("Motywacja", "Samoocena", "Wsparcie", "Lęk", "Prokrastynacja", "Zmęczenie")
profil <- rep(1:3, each = 40)
x <- srednie[profil, ] + matrix(rnorm(120 * 6, sd = 0.6), 120)
d <- as.data.frame(scale(x)); names(d) <- skale     # każda oś w wynikach z
set.seed(743)
km <- kmeans(d, centers = 3, nstart = 25)
kolejn <- order(-tapply(d$Motywacja, km$cluster, mean))   # skupienia od najwyższej motywacji
d$skupienie <- factor(match(km$cluster, kolejn), labels = c("S1", "S2", "S3"))
table(profil, d$skupienie)                         # zgodność z profilami z symulacji
prof <- aggregate(. ~ skupienie, d, mean); prof[-1] <- round(prof[-1], 2)
prof                                               # profile średnich (wyniki z)
przeciecia <- function(a, b) sum(outer(a, a, "-") * outer(b, b, "-") < 0) / 2   # pary linii, które się krzyżują
ocen <- function(osie) {                          # średnie r sąsiednich osi i liczba skrzyżowań linii
  prz <- sum(sapply(1:5, function(i) przeciecia(d[[osie[i]]], d[[osie[i + 1]]])))
  c(r_sasiednich = round(mean(sapply(1:5, function(i) cor(d[[osie[i]]], d[[osie[i + 1]]]))), 2),
    przeciecia = prz, procent_par = round(100 * prz / (5 * choose(nrow(d), 2)), 1))
}
kolejnosc_A <- c("Motywacja", "Samoocena", "Wsparcie", "Lęk", "Prokrastynacja", "Zmęczenie")
kolejnosc_B <- c("Motywacja", "Prokrastynacja", "Samoocena", "Lęk", "Wsparcie", "Zmęczenie")
rbind(A = ocen(kolejnosc_A), B = ocen(kolejnosc_B))
rysuj <- function(osie, tytul) {
  dl <- data.frame(osoba = rep(seq_len(nrow(d)), 6), skupienie = rep(d$skupienie, 6),
                   os = factor(rep(osie, each = nrow(d)), levels = osie), z = unlist(d[osie]))
  sr <- aggregate(z ~ os + skupienie, dl, mean)
  ggplot(dl, aes(os, z, group = osoba, colour = skupienie, linetype = skupienie)) +
    geom_vline(xintercept = 1:6, colour = "grey75") +
    geom_line(alpha = 0.4, linewidth = 0.4) +
    geom_line(data = sr, aes(group = skupienie), linewidth = 1.6, alpha = 1) +
    geom_text(data = sr[sr$os == osie[6], ], aes(label = skupienie, group = skupienie), hjust = -0.4,
              size = 4.2, fontface = "bold", show.legend = FALSE) +
    scale_colour_manual(values = kol, name = "Skupienie") +
    scale_linetype_manual(values = c("solid", "longdash", "dotted"), name = "Skupienie") +
    scale_x_discrete(expand = expansion(add = c(0.3, 0.5))) +
    labs(title = tytul, x = NULL, y = "Wynik z")
}
p1 <- (rysuj(kolejnosc_A, "A. Kolejność z kwestionariusza") /
       rysuj(kolejnosc_B, "B. Te same dane, inna kolejność osi") +
       plot_layout(guides = "collect")) & motyw & theme(legend.position = "bottom")
p1
Wynik w R
profil S1 S2 S3
     1 40  0  0
     2  0 40  0
     3  0  1 39
  skupienie Motywacja Samoocena Wsparcie   Lęk Prokrastynacja Zmęczenie
1        S1      0.91      0.97     0.92 -0.85          -0.99     -0.99
2        S2      0.20     -0.90    -0.44  0.98           0.16      0.80
3        S3     -1.15     -0.05    -0.48 -0.15           0.84      0.17
  r_sasiednich przeciecia procent_par
A         0.22      15222        42.6
B        -0.46      23620        66.2
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe scale(), kmeans(), cor(); rysunek – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak odczytać korelację na wykresie współrzędnych równoległych?
Patrz na odcinki między dwiema sąsiednimi osiami. Gdy są prawie równoległe, zmienne korelują dodatnio; gdy krzyżują się w jednym miejscu jak litera X, korelacja jest ujemna. Związków osi niesąsiadujących wykres wprost nie pokazuje.
Czy kolejność osi na wykresie współrzędnych równoległych ma znaczenie?
Tak. W przykładzie przy tych samych danych zmiana kolejności obniżyła średnią korelację sąsiednich osi z .22 do −.46, a odsetek krzyżujących się par odcinków wzrósł z 42.6% do 66.2%. Ustaw obok siebie zmienne, których związek chcesz pokazać.
Czym wykres współrzędnych równoległych różni się od wykresu profili?
Wykres profili pokazuje tylko średnie grup na kolejnych zmiennych. Wykres współrzędnych równoległych pokazuje też każdą osobę, więc widać, jak bardzo osoby w skupieniu różnią się od jego średniej i które mają nietypowy profil.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Segmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →PoradnikAnaliza skupień krok po kroku
Ward i dendrogram, k-średnich, sylwetka i statystyka luki, stabilność w podpróbach, kontrola na danych bez skupień i opis APA – na jednym przykładzie w R.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Inselberg, A. (2009). Parallel coordinates: Visual multidimensional geometry and its applications. Springer. https://doi.org/10.1007/978-0-387-68628-8
- Johansson, J., & Forsell, C. (2016). Evaluation of parallel coordinates: Overview, categorization and guidelines for future research. IEEE Transactions on Visualization and Computer Graphics, 22(1), 579–588. https://doi.org/10.1109/tvcg.2015.2466992
- Wegman, E. J. (1990). Hyperdimensional data analysis using parallel coordinates. Journal of the American Statistical Association, 85(411), 664–675. https://doi.org/10.1080/01621459.1990.10474926
Cytowania BibTeX
@book{inselberg2009parallel, author={Inselberg, Alfred}, title={{Parallel coordinates: Visual multidimensional geometry and its applications}}, year={2009}, publisher={Springer}, doi={10.1007/978-0-387-68628-8}}@article{johansson2016evaluation, author={Johansson, Jimmy and Forsell, Camilla}, title={{Evaluation of parallel coordinates: Overview, categorization and guidelines for future research}}, journal={IEEE Transactions on Visualization and Computer Graphics}, year={2016}, volume={22}, number={1}, pages={579--588}, doi={10.1109/tvcg.2015.2466992}}@article{wegman1990hyperdimensional, author={Wegman, Edward J.}, title={{Hyperdimensional data analysis using parallel coordinates}}, journal={Journal of the American Statistical Association}, year={1990}, volume={85}, number={411}, pages={664--675}, doi={10.1080/01621459.1990.10474926}}