Co to jest wykres radarowy?
Wykres radarowy (ang. radar chart, spider chart, star plot) pokazuje kilka zmiennych mierzonych na tej samej skali na osiach wychodzących promieniście ze wspólnego środka. Wartości jednej osoby lub grupy łączy się linią w wielokąt. W psychologii i naukach o zdrowiu najczęściej przedstawia profil wyników w podskalach kwestionariusza – dla jednej grupy albo kilku grup naraz. Saary (2008) proponuje go jako zwarty sposób pokazania podobieństw i różnic grup w wielu zmiennych na jednym rysunku.
Jak czytać wykres
- Każda oś to jedna zmienna; odległość punktu od środka to wartość. Środek odpowiada najniższej wartości skali, nie zawsze zeru.
- Kształt wielokąta pokazuje profil: wyraźne „kolce” oznaczają mocne i słabe strony, wielokąt zbliżony do foremnego – profil płaski.
- Pole wielokąta nie jest miarą wyniku ogólnego. Zależy od kolejności osi i od tego, gdzie jest środek skali.
- Osie muszą mieć tę samą skalę. Przy różnych skalach podskal najpierw przelicz wyniki, np. przez standaryzację.
Przykład
W symulowanych danych po 100 osób pracujących w biurze i zdalnie oceniło sześć aspektów satysfakcji z pracy w skali 1–5. Średnie w populacji ustawiono ręcznie: profil grupy biurowej ma wyraźne wzloty i spadki, a profil grupy zdalnej jest płaski, przy prawie tej samej średniej z sześciu podskal (3.16 i 3.18). Ziarno 773 ustalono z góry.
Na rysunku
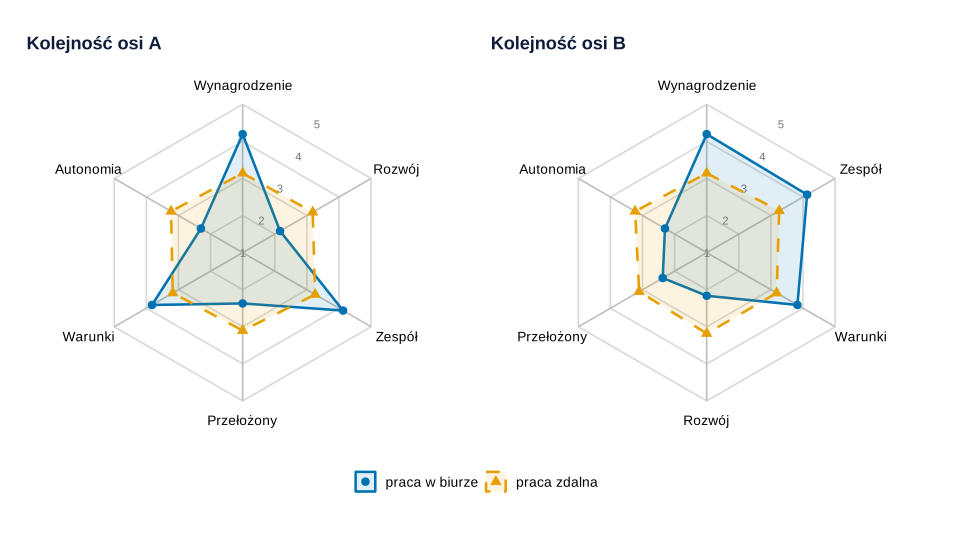
set.seed(773)).Co widać. Dane są identyczne, zmieniła się tylko kolejność osi. Przy kolejności A pole wielokąta grupy biurowej to 0.82 pola grupy zdalnej, przy kolejności B – 1.04: wzrosło z 10.11 do 12.84, a płaski profil grupy zdalnej ma w obu wersjach pole 12.38. Wrażenie, która grupa jest „ogólnie bardziej zadowolona”, zależy więc od decyzji autora wykresu.
Na co uważać. Pole rośnie z iloczynem sąsiednich wartości, więc sąsiadujące wysokie wyniki je powiększają. Odczyt długości na osiach o różnych kierunkach i porównywanie pól to zadania mniej dokładne niż porównanie położenia na wspólnej osi (Cleveland i McGill, 1984). Ustal kolejność osi z góry (np. z budowy kwestionariusza) i podaj ją w podpisie.
Podpis do pracy:
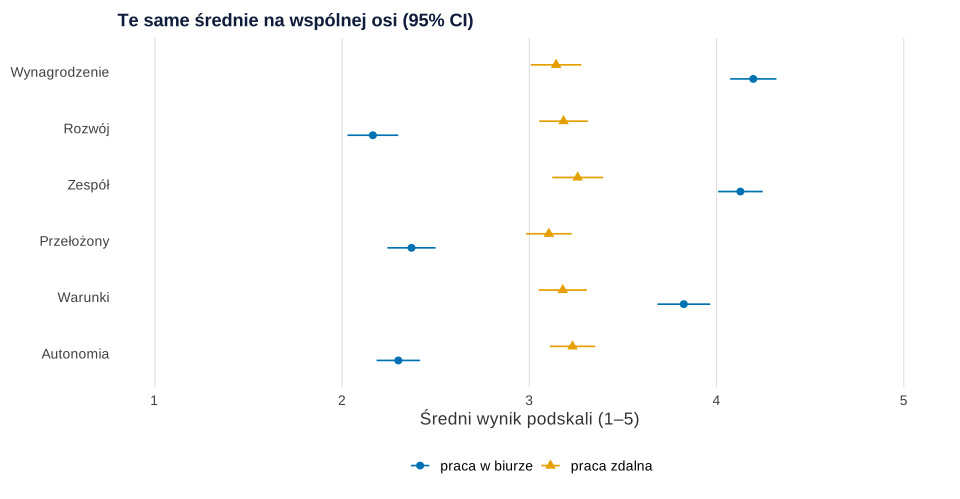
set.seed(773)).Co widać. Grupa biurowa ocenia wyżej wynagrodzenie (4.20 wobec 3.14), zespół i warunki, a niżej rozwój (2.16 wobec 3.18), przełożonego i autonomię. Wszystkie wartości są odczytywane na jednej osi, a przedziały ufności (połowa szerokości najwyżej 0.14) pokazują niepewność, której wykres radarowy zwykle nie ma.
Na co uważać. Wykres profilu nadal pokazuje tylko średnie. Rozkład osób w grupie – czy są w niej podgrupy o różnych profilach – sprawdzisz analizą profili latentnych, a profile pojedynczych osób – na wykresie współrzędnych równoległych.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Nie wnioskuj z pola wielokąta. Wynik ogólny podaj liczbą.
- Nie mieszaj skal. Podskala 0–10 obok podskali 1–5 zniekształci kształt.
- Nie rysuj więcej niż 2–3 grup. Nakładające się wielokąty szybko stają się nieczytelne; wtedy lepszy jest wykres punktowy Clevelanda albo panele.
- Kolor nie może być jedynym rozróżnieniem grup – dodaj kształt punktów i typ linii.
Wykres radarowy w R
Kod symuluje odpowiedzi dwóch grup, rysuje wykres radarowy przy dwóch kolejnościach osi (p1) i wykres profilu z przedziałami ufności (p2) oraz liczy pola wielokątów i średnie z tekstu. Współrzędne radaru są liczone ręcznie (kąt osi i odległość od środka), więc wystarcza sam ggplot2; coord_polar() łączy punkty łukami, a nie odcinkami. Kod sam definiuje paletę Okabe–Ito i motyw. Rysunki na stronie powstały z tych samych obiektów z motywem serwisu – dane, geometrie i skale są identyczne, różni się krój czcionki i siatka.
Wykres radarowy liczony ręcznie i wykres profilu
R
# Wykres radarowy: profil 6 podskal satysfakcji z pracy w dwóch grupach (skala 1–5)
library(ggplot2)
library(patchwork)
kol <- c("praca w biurze" = "#0072B2", "praca zdalna" = "#E69F00")     # Okabe–Ito
ksz <- c("praca w biurze" = 16, "praca zdalna" = 17)                    # kształt = grupa
lin <- c("praca w biurze" = "solid", "praca zdalna" = "dashed")         # typ linii = grupa
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

skale <- c("Wynagrodzenie", "Rozwój", "Zespół", "Przełożony", "Warunki", "Autonomia")
set.seed(773)                                   # 2 × 100 osób, 6 podskal
srednie <- list("praca w biurze" = c(4.2, 2.2, 4.0, 2.4, 3.9, 2.3),    # profil o wyraźnych wzlotach i spadkach
                "praca zdalna"   = c(3.1, 3.2, 3.2, 3.1, 3.2, 3.2))    # profil płaski
os <- do.call(rbind, lapply(names(srednie), function(g)
  data.frame(grupa = g, skala = rep(skale, each = 100),
             wynik = pmin(pmax(rnorm(600, rep(srednie[[g]], each = 100), 0.7), 1), 5))))
prof <- aggregate(wynik ~ grupa + skala, os, function(x) c(m = mean(x), se = sd(x) / sqrt(length(x))))
prof <- data.frame(prof[, 1:2], m = prof$wynik[, "m"], se = prof$wynik[, "se"])

# Współrzędne radaru liczone ręcznie: oś k pod kątem 90° − 360°·(k − 1)/6, promień = wynik − 1
radar <- function(kolejnosc, tytul) {
  kat <- pi / 2 - 2 * pi * (seq_along(kolejnosc) - 1) / length(kolejnosc)
  d <- prof
  d$kat <- kat[match(d$skala, kolejnosc)]
  d$x <- (d$m - 1) * cos(d$kat); d$y <- (d$m - 1) * sin(d$kat)
  d <- d[order(d$grupa, -d$kat), ]
  siatka <- expand.grid(poziom = 1:5, k = c(seq_along(kat), 1))
  siatka$x <- (siatka$poziom - 1) * cos(kat[siatka$k]); siatka$y <- (siatka$poziom - 1) * sin(kat[siatka$k])
  ramiona <- data.frame(x = 4 * cos(kat), y = 4 * sin(kat), skala = kolejnosc)
  ggplot(d, aes(x, y)) +
    geom_path(data = siatka, aes(group = poziom), colour = "grey85") +
    geom_segment(data = ramiona, aes(x = 0, y = 0, xend = x, yend = y), colour = "grey75") +
    annotate("text", x = (0:4) * cos(pi / 3), y = (0:4) * sin(pi / 3), label = 1:5,   # podziałka między osiami
             size = 3, colour = "grey45") +
    geom_text(data = ramiona, aes(x = 1.2 * x, y = 1.13 * y, label = skala), size = 3.6) +
    geom_polygon(aes(colour = grupa, fill = grupa, linetype = grupa), alpha = 0.12, linewidth = 0.9) +
    geom_point(aes(colour = grupa, shape = grupa), size = 2.6) +
    scale_colour_manual(values = kol, name = NULL) + scale_fill_manual(values = kol, name = NULL) +
    scale_shape_manual(values = ksz, name = NULL) + scale_linetype_manual(values = lin, name = NULL) +
    coord_equal(xlim = c(-5.3, 5.3), ylim = c(-4.7, 4.7)) +
    labs(title = tytul, x = NULL, y = NULL) +
    motyw + theme(axis.text = element_blank(), panel.grid = element_blank())
}
kol_a <- skale                                                    # kolejność A: z kwestionariusza
kol_b <- c("Wynagrodzenie", "Zespół", "Warunki", "Rozwój", "Przełożony", "Autonomia")   # kolejność B
# Rysunek 1: te same dwa profile przy dwóch kolejnościach osi
p1 <- radar(kol_a, "Kolejność osi A") + radar(kol_b, "Kolejność osi B") +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")

# Pole wielokąta przy danej kolejności osi (promień liczony od 1, środka skali odpowiedzi)
pole <- function(kolejnosc, g) {
  r <- prof$m[prof$grupa == g][match(kolejnosc, prof$skala[prof$grupa == g])] - 1
  0.5 * sin(2 * pi / length(r)) * sum(r * c(r[-1], r[1]))
}

# Rysunek 2: te same średnie jako wykres profilu (punkty z 95% CI na wspólnej osi)
prof$skala <- factor(prof$skala, rev(skale))
p2 <- ggplot(prof, aes(m, skala, colour = grupa, shape = grupa)) +
  geom_pointrange(aes(xmin = m - 1.96 * se, xmax = m + 1.96 * se),
                  position = position_dodge(width = 0.5), size = 0.5) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
  scale_x_continuous(limits = c(1, 5), breaks = 1:5) +
  labs(title = "Te same średnie na wspólnej osi (95% CI)",
       x = "Średni wynik podskali (1–5)", y = NULL) +
  motyw

# Liczby do tekstu
round(tapply(prof$m, prof$grupa, mean), 2)                       # średnia z 6 podskal
pola <- sapply(list(A = kol_a, B = kol_b), function(k)
  c(biuro = pole(k, "praca w biurze"), zdalna = pole(k, "praca zdalna")))
round(rbind(pola, iloraz_biuro_do_zdalnej = pola[1, ] / pola[2, ]), 2)
tab <- reshape(prof[, c("grupa", "skala", "m")], idvar = "skala", timevar = "grupa", direction = "wide")
tab$roznica <- tab[, 2] - tab[, 3]
tab[, -1] <- round(tab[, -1], 2)
tab[match(skale, tab$skala), ]
round(max(prof$se * 1.96), 2)                                    # największa połowa szerokości 95% CI
p1
p2
Wynik w R
praca w biurze   praca zdalna
          3.16           3.18
                            A     B
biuro                   10.11 12.84
zdalna                  12.38 12.38
iloraz_biuro_do_zdalnej  0.82  1.04
           skala m.praca w biurze m.praca zdalna roznica
9  Wynagrodzenie             4.20           3.14    1.05
5         Rozwój             2.16           3.18   -1.02
11        Zespół             4.13           3.26    0.87
3     Przełożony             2.37           3.10   -0.73
7        Warunki             3.83           3.18    0.65
1      Autonomia             2.30           3.23   -0.93
[1] 0.14
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe i pakiety ggplot2 oraz patchwork). Rysunki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy pole wielokąta na wykresie radarowym oznacza wynik ogólny?
Nie. Pole zależy od kolejności osi i od tego, jaką wartość ma środek wykresu: te same średnie przy innym ułożeniu osi dają inne pole. Wynik ogólny podaj liczbą, np. średnią z podskal.
Czym zastąpić wykres radarowy w pracy dyplomowej?
Wykresem profilu: podskale na jednej osi, średnie grup jako punkty z przedziałami ufności. Wszystkie wartości odczytuje się wtedy na wspólnej skali, a kolejność podskal nie zmienia wrażenia.
Ile osi i grup może mieć czytelny wykres radarowy?
Zwykle 5–10 osi i nie więcej niż 2–3 grupy. Przy większej liczbie grup wielokąty się zasłaniają, a przy trzech osiach wykres traci sens – wystarczy zwykły wykres punktowy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikPorównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Saary, M. J. (2008). Radar plots: A useful way for presenting multivariate health care data. Journal of Clinical Epidemiology, 61(4), 311–317. https://doi.org/10.1016/j.jclinepi.2007.04.021
Cytowania BibTeX
@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{saary2008radar, author={Saary, M. Joan}, title={{Radar plots: A useful way for presenting multivariate health care data}}, journal={Journal of Clinical Epidemiology}, year={2008}, volume={61}, number={4}, pages={311--317}, doi={10.1016/j.jclinepi.2007.04.021}}