Co to jest wykres bąbelkowy?
Wykres bąbelkowy (ang. bubble chart, bubble plot) to wykres rozrzutu, w którym każdy punkt jest kołem, a jego wielkość koduje trzecią zmienną. Najczęściej tą trzecią zmienną jest liczebność albo waga obserwacji: liczba uczniów w szkole, liczba mieszkańców kraju, waga badania w metaregresji. Dzięki temu oko od razu odróżnia jednostki duże od małych, ale dokładny odczyt trzeciej zmiennej z rozmiaru koła jest trudny.
Jak czytać wykres
- Położenie koła odczytujesz jak na zwykłym wykresie rozrzutu: dwie zmienne na osiach.
- Rozmiar koła powinien być proporcjonalny do wartości przez pole, nie przez promień. Koło o dwa razy większym promieniu ma cztery razy większe pole, a oko ocenia właśnie powierzchnię.
- Legenda rozmiaru jest konieczna – bez niej nie da się przełożyć koła na liczbę.
- Kolejność rysowania ma znaczenie: duże koła rysuj najpierw, małe na wierzchu, z przezroczystością i obrysem.
Przykład
W symulowanym zbiorze 40 szkół zestawiono średni status społeczno-ekonomiczny (SES, w jednostkach z) ze średnim wynikiem testu. Szkoły liczyły od 12 do 236 uczniów, a rozrzut średniej wokół linii regresji ustawiono tak, by malał z liczbą uczniów (jak przy losowaniu z populacji). Parametry dobrano ręcznie, żeby efekt był widoczny; ziarno 772 ustalono z góry. Nachylenie regresji wyniosło 22.60 punktu na jedno odchylenie standardowe SES, r = .89.
Na rysunku
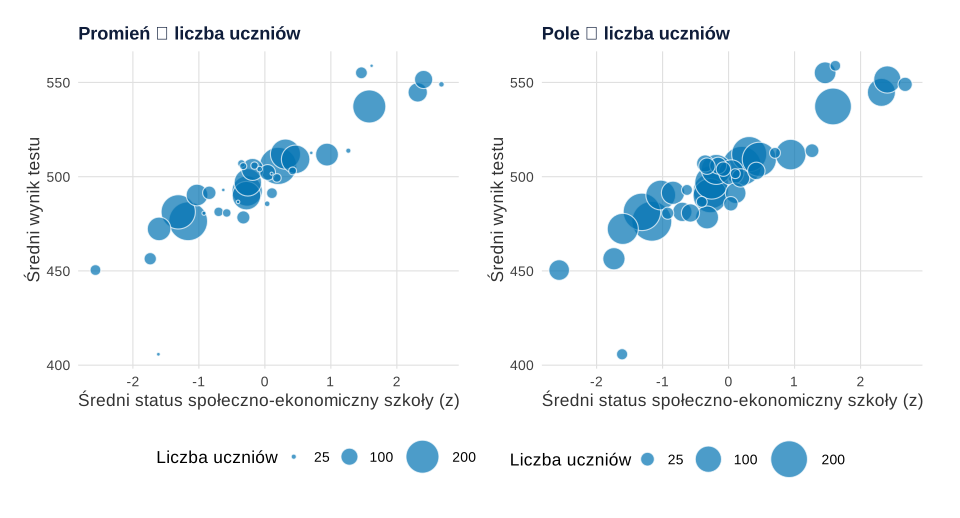
set.seed(772)).Co widać. Największa szkoła ma 19.7 raza więcej uczniów niż najmniejsza. Przy skali promienia jej koło ma pole 386.8 raza większe, więc małe szkoły prawie znikają – także najbardziej odstająca szkoła (16 uczniów, średnia 405.8). Przy skali pola (w ggplot2 scale_size_area()) promień rośnie tylko 4.4 raza, a stosunek pól odpowiada stosunkowi liczebności.
Na co uważać. Nawet przy poprawnej skali ludzie nie doceniają różnic między polami kół (Flannery, 1971), a ocena pola jest mniej dokładna niż ocena położenia na wspólnej osi (Cleveland i McGill, 1984). Rozmiar mówi więc „duży czy mały”, a nie „ile”. Ten sam problem ma wykres kołowy.
Podpis do pracy:
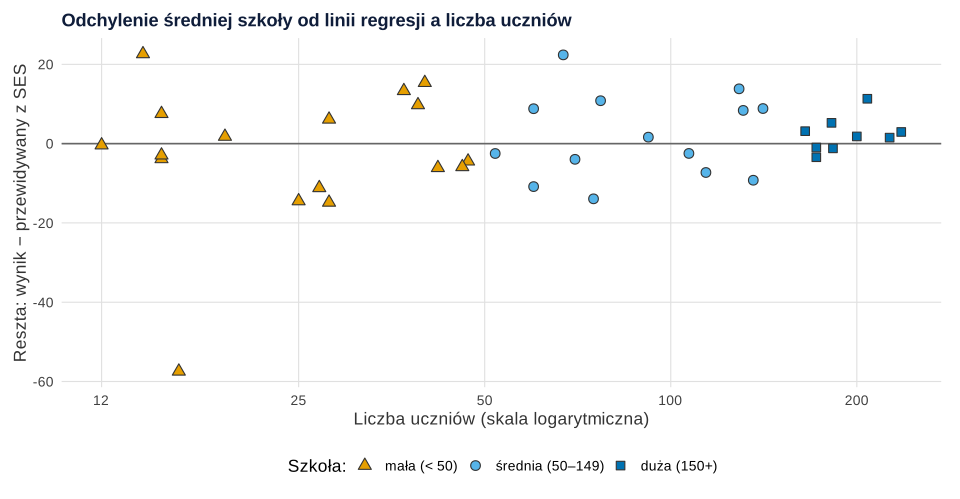
set.seed(772)).Co widać. Średnie małych szkół odchylają się od linii regresji znacznie bardziej (SD reszt 17.6 punktu) niż średnich (10.6) i dużych (4.3). Najbardziej skrajne wyniki to zwykle mała liczebność, a nie wyjątkowa szkoła. Na wykresie bąbelkowym tej zależności nie widać, bo trzecia zmienna nie ma własnej osi.
Na co uważać. Jeśli pytanie dotyczy związku z trzecią zmienną, daj jej oś – w osobnym panelu albo w macierzy wykresów rozrzutu. Porównywanie jednostek o różnej liczebności z granicami losowego rozrzutu pokazuje wykres lejkowy do porównywania instytucji.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Skala promienia zamiast pola – najczęstszy błąd; w ggplot2
scale_radius()robi właśnie to. - Za dużo kół. Przy setkach obserwacji koła się zasłaniają; lepszy jest wykres heksagonalny albo przezroczystość.
- Ujemne wartości nie mają rozmiaru – trzecią zmienną ze znakiem pokaż kolorem lub osią.
- Kolor jako czwarta zmienna szybko przeciąża wykres; zostań przy jednym dodatkowym kodzie.
Wykres bąbelkowy w R
Kod symuluje 40 szkół, rysuje te same dane ze skalą promienia i pola (p1), wykres reszt względem liczby uczniów (p2) i liczy liczby z tekstu. W ggplot2 wykres bąbelkowy to geom_point() z estetyką size; domyślna scale_size() skaluje pole, ale nie od zera, dlatego przy liczebnościach lepsza jest scale_size_area(). Kod sam definiuje paletę Okabe–Ito i motyw. Rysunki na stronie powstały z tych samych obiektów z motywem serwisu – dane, geometrie i skale są identyczne, różni się krój czcionki i siatka.
Skala promienia i pola, trzecia zmienna na osi
R
# Wykres bąbelkowy: średni wynik testu a status społeczno-ekonomiczny w 40 szkołach, rozmiar = liczba uczniów
library(ggplot2)
library(patchwork)
kol <- c("mała (< 50)" = "#E69F00", "średnia (50–149)" = "#56B4E9", "duża (150+)" = "#0072B2")   # Okabe–Ito
ksz <- c("mała (< 50)" = 24, "średnia (50–149)" = 21, "duża (150+)" = 22)                       # kształt = wielkość szkoły
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

set.seed(772)                                   # 40 szkół
k <- 40
sz <- data.frame(szkola = 1:k)
sz$n <- round(exp(runif(k, log(12), log(400))))                 # liczba uczniów: od kilkunastu do kilkuset
sz$ses <- rnorm(k, 0, 1)                                        # średni status społeczno-ekonomiczny (z)
sz$wynik <- 500 + 20 * sz$ses + rnorm(k, 0, 100 / sqrt(sz$n))   # średnia szkoły: im mniej uczniów, tym większy rozrzut
sz$wielkosc <- cut(sz$n, c(0, 49, 149, Inf), labels = names(kol))
sz <- sz[order(-sz$n), ]                                        # duże bąbelki rysowane najpierw, małe na wierzchu

baza <- ggplot(sz, aes(ses, wynik, size = n)) +
  geom_point(shape = 21, fill = "#0072B2", colour = "white", alpha = 0.7, stroke = 0.6) +
  labs(x = "Średni status społeczno-ekonomiczny szkoły (z)", y = "Średni wynik testu") +
  motyw
lamy <- c(25, 100, 200)
# Rysunek 1: ta sama skala danych, rozmiar proporcjonalny do promienia (źle) i do pola (dobrze)
p1 <- (baza + scale_radius(range = c(0, 14), limits = c(0, 250), breaks = lamy, name = "Liczba uczniów") +
         labs(title = "Promień ∝ liczba uczniów")) +
      (baza + scale_size_area(max_size = 14, limits = c(0, 250), breaks = lamy, name = "Liczba uczniów") +
         labs(title = "Pole ∝ liczba uczniów")) +
      plot_layout(guides = "collect") & theme(legend.position = "bottom")

# Rysunek 2: liczba uczniów na osi zamiast w rozmiarze – widać lejek rozrzutu średnich
sz$reszta <- resid(lm(wynik ~ ses, sz))                        # średnia szkoły po uwzględnieniu SES
p2 <- ggplot(sz, aes(n, reszta, fill = wielkosc, shape = wielkosc)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_point(size = 3, colour = "grey20") +
  scale_x_log10(breaks = c(12, 25, 50, 100, 200, 400)) +
  scale_fill_manual(values = kol, name = "Szkoła:") +
  scale_shape_manual(values = ksz, name = "Szkoła:") +
  labs(title = "Odchylenie średniej szkoły od linii regresji a liczba uczniów",
       x = "Liczba uczniów (skala logarytmiczna)", y = "Reszta: wynik − przewidywany z SES") +
  motyw

# Liczby do tekstu
c(n_min = min(sz$n), n_max = max(sz$n), iloraz = round(max(sz$n) / min(sz$n), 1))
round(c(pole_przy_promieniu = (max(sz$n) / min(sz$n))^2, promien_przy_polu = sqrt(max(sz$n) / min(sz$n))), 1)
m <- lm(wynik ~ ses, sz)
round(c(nachylenie = unname(coef(m)[2]), r = cor(sz$ses, sz$wynik)), 2)
round(tapply(sz$reszta, sz$wielkosc, sd), 1)                     # SD reszt według wielkości szkoły
table(sz$wielkosc)
round(sz[which.min(sz$reszta), c("n", "ses", "wynik", "reszta")], 1)   # najbardziej odstająca szkoła
p1
p2
Wynik w R
 n_min  n_max iloraz
  12.0  236.0   19.7
pole_przy_promieniu   promien_przy_polu
              386.8                 4.4
nachylenie          r
     22.60       0.89
     mała (< 50) średnia (50–149)      duża (150+)
            17.6             10.6              4.3

     mała (< 50) średnia (50–149)      duża (150+)
              17               14                9
    n  ses wynik reszta
34 16 -1.6 405.8  -57.4
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe i pakiety ggplot2 oraz patchwork). Rysunki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy na wykresie bąbelkowym rozmiar koła ma odpowiadać promieniowi, czy polu?
Polu. Gdy promień rośnie proporcjonalnie do wartości, pole rośnie z jej kwadratem i duże jednostki optycznie przytłaczają małe. W ggplot2 skalę pola od zera daje scale_size_area(), a skalę promienia – scale_radius().
Kiedy wykres bąbelkowy jest lepszy od zwykłego wykresu rozrzutu?
Gdy obserwacje mają bardzo różną wagę lub liczebność (szkoły, kraje, badania w metaanalizie) i chcesz, by czytelnik od razu odróżnił jednostki duże od małych. Gdy trzecia zmienna jest celem analizy, daj jej osobną oś.
Ile kół zmieści się czytelnie na wykresie bąbelkowym?
Zwykle kilkadziesiąt. Przy setkach obserwacji koła nachodzą na siebie nawet z przezroczystością; wtedy lepiej pokazać gęstość punktów albo podzielić dane na panele.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Korelacje na wykresie
Mapa cieplna w dobrej kolejności, korekta zamiast gwiazdek, ggpairs ujawniający próg i sufit oraz korelacje z przedziałami ufności – pięć rysunków z kodem R.
Czytaj →PoradnikMetaregresja i analiza moderatorów
Moderatory ciągłe i kategoryczne w metafor, Knapp–Hartung, QM i QE, pseudo-R², test permutacyjny, wykres bąbelkowy i opis APA.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Flannery, J. J. (1971). The relative effectiveness of some common graduated point symbols in the presentation of quantitative data. Cartographica, 8(2), 96–109. https://doi.org/10.3138/j647-1776-745h-3667
Cytowania BibTeX
@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{flannery1971relative, author={Flannery, James J.}, title={{The relative effectiveness of some common graduated point symbols in the presentation of quantitative data}}, journal={Cartographica}, year={1971}, volume={8}, number={2}, pages={96--109}, doi={10.3138/j647-1776-745h-3667}}