Co to jest t-SNE i UMAP?
t-SNE i UMAP to nieliniowe metody redukcji wymiaru, które układają obserwacje opisane wieloma zmiennymi na płaszczyźnie (rzadziej w trzech wymiarach). Ich cel to zachowanie lokalnego sąsiedztwa: punkty podobne w danych wyjściowych mają leżeć blisko siebie na mapie. Różni je to od PCA, która liniowo zachowuje jak najwięcej wariancji, i od skalowania wielowymiarowego (MDS), które odtwarza odległości między wszystkimi parami punktów.
t-SNE
Van der Maaten i Hinton (2008) zaproponowali t-SNE jako wariant metody stochastic neighbor embedding, który łatwiej optymalizować i który mniej zagęszcza punkty w środku mapy. Podobieństwa par punktów zamienia się na prawdopodobieństwa sąsiedztwa, a na mapie stosuje rozkład t o grubych ogonach. Najważniejszy parametr, perplexity, odpowiada w przybliżeniu liczbie branych pod uwagę sąsiadów.
UMAP
McInnes i in. (2018) opisują UMAP jako metodę, którą można stosować do wizualizacji podobnie jak t-SNE, ale także do ogólnej nieliniowej redukcji wymiaru. Ich implementacja jest szybsza od większości implementacji t-SNE. Obraz zmieniają głównie parametry n_neighbors (liczba sąsiadów) i min_dist (jak ciasno mogą leżeć punkty).
Punkt odniesienia: PCA i MDS
Zanim użyjesz metody nieliniowej, sprawdź metody liniowe. Na danych iris po standaryzacji dwie pierwsze składowe PCA wyjaśniają 95.8% wariancji, a klasyczne MDS daje te same współrzędne. W tej mapie zachowuje się 73.3% z 10 najbliższych sąsiadów z czterech wymiarów. Ten sam wskaźnik wynosi 79.3% dla t-SNE (perplexity = 30) i 70.8% dla UMAP (n_neighbors = 15), więc metoda nieliniowa nie zawsze zachowuje sąsiedztwo lepiej – warto to sprawdzić. Jeśli celem jest interpretacja wymiarów, a nie sama mapa, zostań przy PCA lub analizie czynnikowej – różnice opisujemy we wpisie PCA czy analiza czynnikowa?
Na rysunku
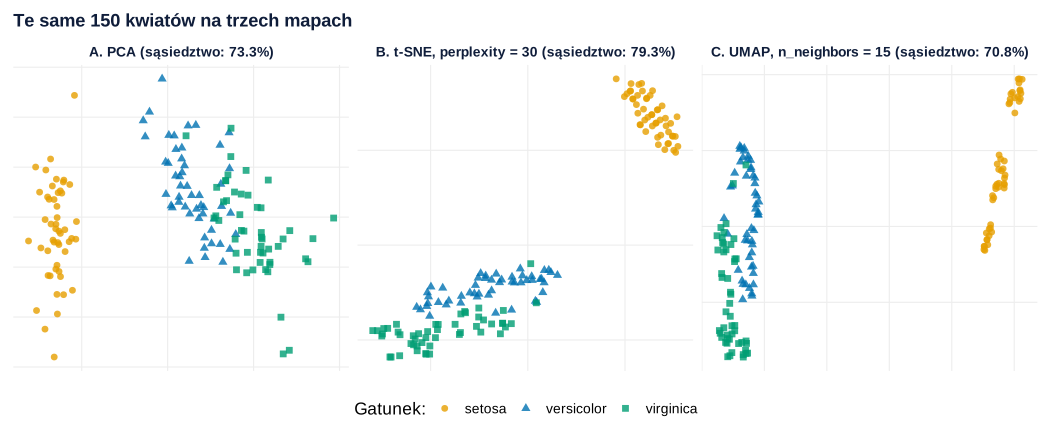
set.seed(621)).Co widać. To mapy z przykładu wyżej. Wszystkie trzy oddzielają setosę od dwóch pozostałych gatunków. t-SNE rysuje gatunki jako zwarte, wyraźniej rozdzielone skupiska i zachowuje najwięcej sąsiadów z czterech wymiarów (79.3%). UMAP ściska versicolor i virginicę w jeden wąski pas, a setosę rozbija na kilka fragmentów, choć w danych to jedna grupa.
Na co uważać. Kształt i wielkość skupisk oraz puste miejsca między nimi nie mają jednostek. Osie map t-SNE i UMAP nic nie znaczą, dlatego są bez opisu.
Podpis do pracy:
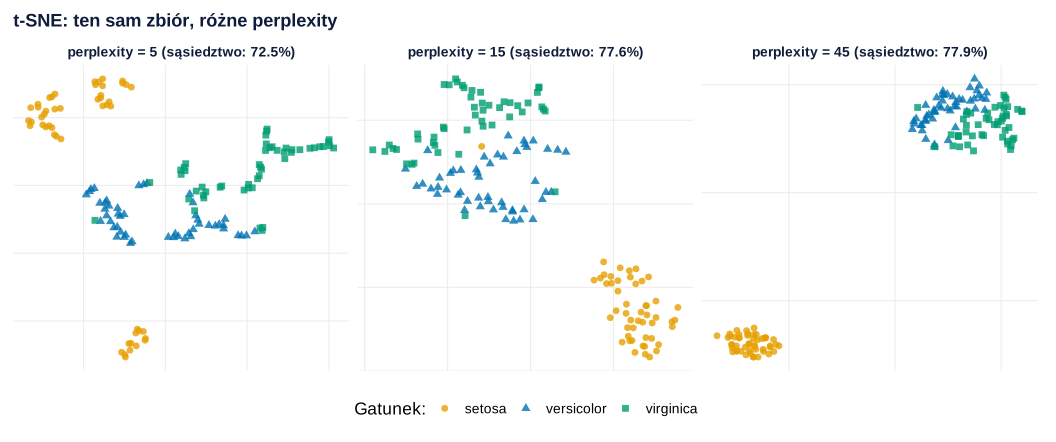
set.seed(621) przed każdą mapą).Co widać. Dane i punkt startowy są te same, zmienia się tylko perplexity. Przy 5 algorytm patrzy na bardzo małe sąsiedztwo: setosa rozpada się na trzy oddalone kawałki, a dwa pozostałe gatunki – na łańcuchy. Przy 45 mapa jest bardziej „globalna”: setosa leży daleko, a versicolor i virginica zlewają się w jedną grupę. Odsetek zachowanych sąsiadów różni się mniej niż obraz (72.5–77.9%).
Na co uważać. Fragmenty przy małym perplexity łatwo wziąć za podgrupy. Zanim je opiszesz, sprawdź, czy przetrwają zmianę parametru i ziarna, i potwierdź je analizą skupień na danych wyjściowych. Panele obok siebie to małe wielokrotności – ułatwiają takie porównanie.
Podpis do pracy:
Rysunek 1 korzysta z tego samego ziarna i tej samej kolejności losowań co przykład. Wartości perplexity (5, 15, 45) dobrano ręcznie: od bardzo małej do bliskiej maksimum dla 150 punktów (49.7). Rysunki na stronie różnią się od wyniku kodu tylko motywem serwisu.
Kod R rysunków 1 i 2
# Rysunek 1. Te same dane iris w PCA, t-SNE i UMAP
# Rysunek 2. t-SNE przy perplexity = 5, 15 i 45 (ta sama inicjalizacja losowa)
library(Rtsne); library(uwot); library(ggplot2)
kol <- c(setosa = "#E69F00", versicolor = "#0072B2", virginica = "#009E73")   # Okabe–Ito
ksz <- c(setosa = 16, versicolor = 17, virginica = 15)                       # kształt = gatunek
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"),
        axis.text = element_blank(), strip.text = element_text(face = "bold"))

# Mapy jak w przykładzie hasła (to samo ziarno i ta sama kolejność losowań)
set.seed(621)
X <- scale(iris[, 1:4])
pca <- prcomp(X)
ts <- Rtsne(X, perplexity = 30, check_duplicates = FALSE)$Y
um <- umap(X, n_neighbors = 15, min_dist = 0.1)

# odsetek 10 najbliższych sąsiadów z 4D zachowanych na mapie 2D
knn <- function(Y, k = 10) t(apply(as.matrix(dist(Y)), 1, function(d) order(d)[2:(k + 1)]))
n4 <- knn(X)
zach <- function(Y) { n2 <- knn(Y); mean(sapply(1:nrow(X), function(i) length(intersect(n4[i, ], n2[i, ])) / 10)) }

mapa <- function(Y, nazwa) data.frame(x = scale(Y[, 1]), y = scale(Y[, 2]), gatunek = iris$Species,
                                      panel = sprintf("%s (sąsiedztwo: %.1f%%)", nazwa, 100 * zach(Y)))
rys <- function(d, tytul) ggplot(d, aes(x, y, colour = gatunek, shape = gatunek)) +
  geom_point(size = 2, alpha = 0.8) + facet_wrap(~ panel, nrow = 1, scales = "free") +
  scale_colour_manual(values = kol, name = "Gatunek:") + scale_shape_manual(values = ksz, name = "Gatunek:") +
  labs(x = NULL, y = NULL, title = tytul) + motyw

d1 <- rbind(mapa(pca$x[, 1:2], "A. PCA"), mapa(ts, "B. t-SNE, perplexity = 30"), mapa(um, "C. UMAP, n_neighbors = 15"))
d1$panel <- factor(d1$panel, levels = unique(d1$panel))
levels(d1$panel)                                       # tytuły paneli z odsetkiem zachowanych sąsiadów
p1 <- rys(d1, "Te same 150 kwiatów na trzech mapach")
p1

# Rysunek 2: każda mapa t-SNE z tym samym ziarnem, zmienia się tylko perplexity
perp <- c(5, 15, 45)                                   # 45 – blisko maksimum (n − 1) / 3 = 49.7
d2 <- do.call(rbind, lapply(perp, function(pp) {
  set.seed(621)
  mapa(Rtsne(X, perplexity = pp, check_duplicates = FALSE)$Y, sprintf("perplexity = %d", pp))
}))
d2$panel <- factor(d2$panel, levels = unique(d2$panel))
levels(d2$panel)                                       # tytuły paneli z odsetkiem zachowanych sąsiadów
p2 <- rys(d2, "t-SNE: ten sam zbiór, różne perplexity")
p2
Wynik w R
[1] "A. PCA (sąsiedztwo: 73.3%)"
[2] "B. t-SNE, perplexity = 30 (sąsiedztwo: 79.3%)"
[3] "C. UMAP, n_neighbors = 15 (sąsiedztwo: 70.8%)"
[1] "perplexity = 5 (sąsiedztwo: 72.5%)"  "perplexity = 15 (sąsiedztwo: 77.6%)"
[3] "perplexity = 45 (sąsiedztwo: 77.9%)"
Na co uważać
- Struktura globalna. Kobak i Berens (2019) pokazują, że t-SNE dobrze oddaje strukturę lokalną, ale przy naiwnym użyciu źle odwzorowuje globalną; zalecają m.in. inicjalizację PCA i wysoki współczynnik uczenia. Funkcja
Rtsne()domyślnie startuje z losowego układu punktów; inicjalizację PCA podasz argumentemY_init. - Odległości i rozmiary. Odległości między skupiskami i ich wielkość na mapie nie mają prostej interpretacji, a osie – jednostek. W przykładzie odległość środków versicolor–virginica (względem setosa–versicolor) wynosi 0.52 w danych i w PCA, ale 0.26 w t-SNE i 0.18 w UMAP.
- Losowość. Wynik zależy od ziarna i parametrów; pokaż kilka ustawień i ustal je przed analizą.
- Grupy. Skupiska z mapy to nie wynik analizy skupień. O wyznaczaniu segmentów piszemy we wpisie o segmentacji respondentów.
t-SNE i UMAP w R na tle PCA i MDS
Kod liczy PCA (prcomp), klasyczne MDS (cmdscale), mapę t-SNE (Rtsne::Rtsne) i mapę UMAP (uwot::umap), a dla każdej mapy odsetek zachowanych 10 najbliższych sąsiadów i względną odległość między środkami gatunków. Zbiór iris ma jeden zduplikowany wiersz, dlatego check_duplicates = FALSE.
PCA, MDS, t-SNE, UMAP i zachowanie sąsiedztwa
R
# t-SNE i UMAP na tle liniowego PCA i klasycznego MDS
library(Rtsne); library(uwot)
set.seed(621)
X <- scale(iris[, 1:4])                              # 150 kwiatów, 4 cechy, standaryzacja
pca <- prcomp(X)
mds <- cmdscale(dist(X), k = 2)                      # klasyczne MDS na odległościach euklidesowych
round(c(wariancja_PC1_PC2 = sum(pca$sdev[1:2]^2) / sum(pca$sdev^2),
        r_PC1_MDS1 = abs(cor(pca$x[, 1], mds[, 1])),
        r_PC2_MDS2 = abs(cor(pca$x[, 2], mds[, 2]))), 3)
ts <- Rtsne(X, perplexity = 30, check_duplicates = FALSE)$Y  # iris ma jeden zduplikowany wiersz
um <- umap(X, n_neighbors = 15, min_dist = 0.1)       # uwot::umap
# Pakiet umap ma funkcję o tej samej nazwie (kod niewykonany): umap::umap(X)
# Zachowanie sąsiedztwa: odsetek 10 najbliższych sąsiadów z 4D zachowanych na mapie 2D
knn <- function(Y, k = 10) t(apply(as.matrix(dist(Y)), 1, function(d) order(d)[2:(k + 1)]))
n4 <- knn(X)
zach <- function(Y) { n2 <- knn(Y); mean(sapply(1:nrow(X), function(i) length(intersect(n4[i, ], n2[i, ])) / 10)) }
round(c(PCA = zach(pca$x[, 1:2]), tSNE = zach(ts), UMAP = zach(um)), 3)
# Odległość środków versicolor–virginica względem setosa–versicolor (= 1)
wzgl <- function(Y) { s <- apply(Y, 2, tapply, iris$Species, mean); d <- as.matrix(dist(s)); d[2, 3] / d[1, 2] }
round(c(dane_4D = wzgl(X), PCA = wzgl(pca$x[, 1:2]), tSNE = wzgl(ts), UMAP = wzgl(um)), 2)
Wynik w R
wariancja_PC1_PC2        r_PC1_MDS1        r_PC2_MDS2
            0.958             1.000             1.000
  PCA  tSNE  UMAP
0.733 0.793 0.708
dane_4D     PCA    tSNE    UMAP
   0.52    0.52    0.26    0.18
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami Rtsne 0.17 i uwot 0.2.5. Rysunki 1 i 2 wykonano w pakiecie ggplot2, a pliki SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- Rtsne (wersja 0.17): Krijthe, J. (2023). Rtsne: T-distributed stochastic neighbor embedding using a Barnes-Hut implementation (R package version 0.17) [Computer software]. https://doi.org/10.32614/CRAN.package.Rtsne
- uwot (wersja 0.2.5): Melville, J. (2026). uwot: The uniform manifold approximation and projection (UMAP) method for dimensionality reduction (R package version 0.2.5) [Computer software]. https://doi.org/10.32614/CRAN.package.uwot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym t-SNE i UMAP różnią się od PCA?
PCA to metoda liniowa, która zachowuje jak najwięcej wariancji, a jej osie są kombinacjami zmiennych. t-SNE i UMAP są nieliniowe i zachowują głównie najbliższe sąsiedztwo, więc ich osie nie mają interpretacji.
Czy skupiska widoczne na mapie t-SNE to gotowe grupy?
Nie. Kształt i liczba skupisk zależą od parametrów i ziarna losowego. Grupy wyznacz analizą skupień na danych wyjściowych, a mapę traktuj jako ilustrację.
Jak opisać t-SNE lub UMAP w pracy?
Podaj pakiet i jego wersję, przygotowanie zmiennych (np. standaryzację), wartości parametrów (perplexity lub n_neighbors i min_dist), ziarno losowe i to, czy sprawdzono stabilność obrazu przy innych ustawieniach.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PCA czy analiza czynnikowa?
Kiedy redukcja danych, a kiedy model konstruktu: tabela „kiedy która” i porównanie PCA z EFA na tych samych danych w R – ładunki, korelacje i wyniki osób.
Czytaj →PoradnikSegmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kobak, D., & Berens, P. (2019). The art of using t-SNE for single-cell transcriptomics. Nature Communications, 10(1), Article 5416. https://doi.org/10.1038/s41467-019-13056-x ● Otwarty dostęp
- McInnes, L., Healy, J., Saul, N., & Großberger, L. (2018). UMAP: Uniform Manifold Approximation and Projection. Journal of Open Source Software, 3(29), Article 861. https://doi.org/10.21105/joss.00861 ● Otwarty dostęp
- van der Maaten, L., & Hinton, G. (2008). Visualizing data using t-SNE. Journal of Machine Learning Research, 9(86), 2579–2605. https://jmlr.org/papers/v9/vandermaaten08a.html ● Otwarty dostęp
Cytowania BibTeX
@article{kobak2019art, author={Kobak, Dmitry and Berens, Philipp}, title={{The art of using t-SNE for single-cell transcriptomics}}, journal={Nature Communications}, year={2019}, volume={10}, number={1}, eid={5416}, doi={10.1038/s41467-019-13056-x}}@article{mcinnes2018umap, author={McInnes, Leland and Healy, John and Saul, Nathaniel and Großberger, Lukas}, title={{UMAP: Uniform Manifold Approximation and Projection}}, journal={Journal of Open Source Software}, year={2018}, volume={3}, number={29}, eid={861}, doi={10.21105/joss.00861}}@article{vandermaaten2008visualizing, author={van der Maaten, Laurens and Hinton, Geoffrey}, title={{Visualizing data using t-SNE}}, journal={Journal of Machine Learning Research}, year={2008}, volume={9}, number={86}, pages={2579--2605}, url={https://jmlr.org/papers/v9/vandermaaten08a.html}}