Kiedy MANOVA, a kiedy osobne ANOVA
MANOVA porównuje grupy jednocześnie pod względem kilku zmiennych zależnych i odpowiada na pytanie, czy różnią się one łącznym profilem wyników. Definicję, cztery statystyki testowe i ich wzory znajdziesz w haśle MANOVA. Ten poradnik prowadzi przez całą analizę na jednym przykładzie: od sprawdzenia danych przez test wielowymiarowy po analizy następcze i opis w pracy. Jeśli masz tylko jedną zmienną zależną, wystarczy ANOVA krok po kroku.
Zanim policzysz MANOVA, odpowiedz sobie na jedno pytanie: czy Twoja hipoteza dotyczy zestawu zmiennych, czy każdej zmiennej osobno? Huberty i Morris (1989) pokazują, że analiza wielowymiarowa ma sens wtedy, gdy zmienne zależne tworzą całość – np. są aspektami jednego konstruktu – i gdy interesuje Cię ich łączny układ. Jeśli każda zmienna to osobne pytanie badawcze, wykonaj serię jednowymiarowych analiz z korektą na wielokrotne porównania. MANOVA nie jest bowiem „bramką”, która zwalnia z tej korekty.
| Sytuacja w pracy | Lepszy wybór |
|---|---|
| Kilka podskal jednego kwestionariusza, hipoteza o „ogólnym” efekcie interwencji | MANOVA, potem analiza dyskryminacyjna lub ANOVA z korektą |
| Kilka różnych wyników, każdy z własną hipotezą (H1, H2, H3) | Osobne ANOVA (najlepiej Welcha) z korektą Holma |
| Zmienne zależne prawie niezwiązane (r bliskie 0) | Osobne ANOVA – MANOVA niewiele zyska |
| Wynik ogólny skali razem z jej podskalami | Nie łącz ich w jednej MANOVA – to współliniowość |
Przykład: trzy formy informacji zwrotnej po kolokwium
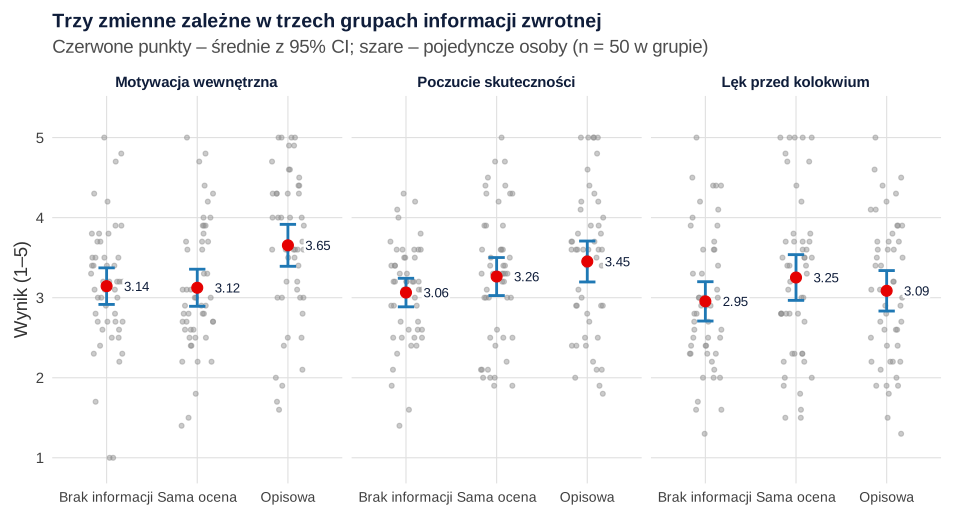
W przykładzie (dane symulowane) 150 studentów losowo przydzielono do trzech warunków po 50 osób. Po kolokwium jedni nie dostali żadnej informacji poza tym, że wyniki są w systemie, drudzy dostali samą ocenę, a trzeci – opisową informację zwrotną z omówieniem błędów. Tydzień później wypełnili trzy skale (średnie z pozycji, 1–5): motywację wewnętrzną do nauki przedmiotu, poczucie własnej skuteczności i lęk przed kolejnym kolokwium. Hipoteza dotyczyła łącznego profilu motywacyjnego, więc MANOVA odpowiada na postawione pytanie. Dzięki randomizacji różnice między grupami można przypisać formie informacji zwrotnej.
Plik do pobrania: manova-dane-przyklad.csv – 150 wierszy, kolumny id, grupa (brak, ocena, opisowa), motywacja, skutecznosc, lek. Wszystkie liczby w tekście pochodzą z kodu w sekcji MANOVA w R.
Krok 1. Statystyki opisowe i korelacje zmiennych zależnych
Zacznij od średnich i odchyleń standardowych w grupach (będą w tabeli końcowej) oraz od korelacji między zmiennymi zależnymi. W MANOVA liczą się korelacje wewnątrzgrupowe, czyli policzone na resztach – po usunięciu różnic między grupami. W przykładzie wyniosły .45 (motywacja–skuteczność), −.20 (motywacja–lęk) i −.40 (skuteczność–lęk). To dobry układ: zmienne są powiązane, ale żadna nie powiela innej. Te korelacje MANOVA wykorzystuje, a seria osobnych ANOVA je pomija.
Na rysunku 1 widać, że grupa z opisową informacją zwrotną ma najwyższą średnią motywację (3.65 wobec 3.14 i 3.12) i najwyższe poczucie skuteczności (3.45 wobec 3.06 i 3.26), a lęk jest najwyższy w grupie z samą oceną (3.25 wobec 2.95 i 3.09). Rozrzut wyników w grupach jest jednak duży, więc to test wielowymiarowy rozstrzygnie, czy profil różni się bardziej, niż wynikałoby z przypadku.
Krok 2. Założenia MANOVA i jak je sprawdzić
Lista założeń jest dłuższa niż przy ANOVA, ale większość sprawdzisz w kilka minut:
- Niezależność obserwacji. Każda osoba jest w jednej grupie i występuje raz. To kwestia planu badania – żaden test jej nie naprawi.
- Liczebność. W każdej grupie musi być wyraźnie więcej osób niż zmiennych zależnych; tu 50 osób na 3 zmienne. Moc planuj z góry – zob. dobór liczebności próby.
- Wielowymiarowa normalność i brak wielowymiarowych obserwacji odstających. Osoba może mieć przeciętne wyniki na każdej skali osobno, a zarazem nietypowe ich połączenie (np. wysoka motywacja przy bardzo niskim poczuciu skuteczności). Takie przypadki wykrywa odległość Mahalanobisa od średnich własnej grupy.
- Jednorodność macierzy kowariancji – wielowymiarowy odpowiednik homogeniczności wariancji, sprawdzany testem M Boxa.
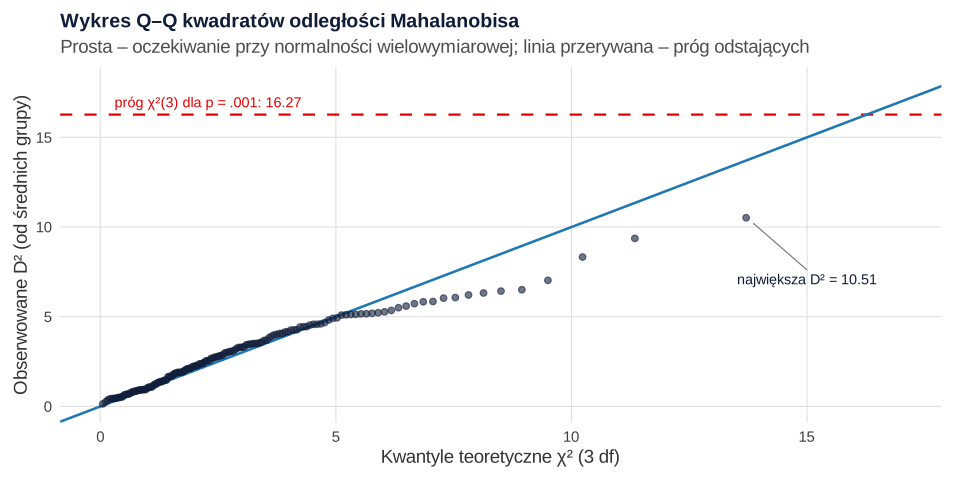
W przykładzie największy kwadrat odległości Mahalanobisa wyniósł 10.51, a próg χ²(3) dla p = .001 to 16.27 – żadna osoba go nie przekroczyła. Leys i in. (2019) zalecają ten próg, ale przestrzegają, że klasyczna odległość Mahalanobisa sama jest wrażliwa na obserwacje odstające; przy wyraźnie nietypowych danych sięgnij po jej odporną wersję. Rysunek 2 pokazuje te same odległości na wykresie Q–Q: punkty idą wzdłuż prostej, a w górnej części leżą nieco poniżej niej. To typowe dla skal o ograniczonym zakresie (1–5) – skrajnych kombinacji jest mniej, niż przewiduje rozkład normalny, co dla MANOVA nie jest problemem. Skośność reszt mieściła się między −0.19 a 0.18. Jednowymiarowe sposoby oceny rozkładu opisujemy we wpisie jak sprawdzić normalność rozkładu.
Test M Boxa nie wskazał na różnice macierzy kowariancji, χ²(12) = 10.52, p = .571. Nie przeceniaj go jednak w żadną stronę: test jest bardzo czuły na nienormalność i na dużą liczebność. Olson (1974) w symulacjach pokazał, że przy naruszeniu założeń najodporniejszy jest ślad Pillaia, a test największego pierwiastka Roya należy wtedy odrzucić. Przy równych liczebnościach grup i śladzie Pillaia umiarkowanie istotny wynik testu Boxa nie przekreśla analizy.
Krok 3. Test wielowymiarowy: ślad Pillaia
Program poda cztery statystyki: ślad Pillaia, lambdę Wilksa, ślad Hotellinga–Lawleya i największy pierwiastek Roya. Aranowska i Rytel (2010) podkreślają, że w MANOVA nie ma jednego ustalonego sprawdzianu, dlatego wybierz statystykę przed analizą i raportuj ją konsekwentnie – domyślnie ślad Pillaia. W przykładzie forma informacji zwrotnej różnicowała łączny profil trzech zmiennych: V = 0.13, F(6, 292) = 3.44, p = .003. Lambda Wilksa prowadzi do tego samego wniosku: Λ = .87, F(6, 290) = 3.43, p = .003.
Wielowymiarową wielkość efektu dla śladu Pillaia liczy się ze wzoru:
Tu s = 2, a więc η²p = .07 (0.13 / 2), 95% CI [.01, .11]. To efekt umiarkowany: forma informacji zwrotnej wiąże się z około 7% zmienności łącznego profilu, ale przedział jest szeroki. Jak interpretować takie wartości, wyjaśniają hasło eta kwadrat i wpis wielkość efektu – interpretacja.
Krok 4. Analizy następcze: co dokładnie się różni?
Istotna MANOVA mówi tylko, że centroidy grup się różnią. Dalej masz dwie drogi i obie są poprawne, jeśli opiszesz je uczciwie.
Droga A: ANOVA dla każdej zmiennej z korektą Holma
Gdy promotor lub hipotezy pytają o konkretne zmienne, wykonaj dla każdej ANOVA Welcha – Delacre i in. (2019) rekomendują ją jako domyślną, bo nie zakłada równych wariancji – i skoryguj p metodą Holma (1979). Korekta jest potrzebna, bo Huberty i Morris (1989) pokazali, że istotna MANOVA nie chroni przed błędem I rodzaju w testach jednowymiarowych. Wyniki:
- motywacja: F(2, 97.67) = 5.71, p = .005, po korekcie Holma p = .014, η² = .08;
- poczucie skuteczności: F(2, 95.36) = 3.25, p = .043, po korekcie p = .087, η² = .04;
- lęk: F(2, 97.62) = 1.26, p = .289, po korekcie p = .289, η² = .02.
Zwróć uwagę na poczucie skuteczności: bez korekty wynik byłby „istotny”, po korekcie już nie. Tak właśnie wygląda sytuacja, w której MANOVA użyta jako bramka prowadzi do nadmiernie optymistycznych wniosków. Więcej o wyborze korekty piszemy we wpisie poprawki na wielokrotne porównania.
Dla motywacji sprawdź, które grupy się różnią. Przy nierównych wariancjach dobrym wyborem jest test Gamesa–Howella – Sauder i DeMars (2019) wykazali, że dobrze kontroluje błąd I rodzaju przy naruszonych założeniach. Grupa z opisową informacją zwrotną miała wyższą motywację niż grupa bez informacji (różnica 0.51, 95% CI [0.10, 0.92], p = .011) i niż grupa z samą oceną (0.53, 95% CI [0.12, 0.94], p = .008). Sama ocena nie różniła się od braku informacji (−0.02, 95% CI [−0.41, 0.37], p = .992).
Droga B: opisowa analiza dyskryminacyjna
Warne (2014) wskazuje, że analizą następczą najlepiej oddającą logikę MANOVA jest opisowa analiza dyskryminacyjna. Szuka ona kombinacji zmiennych zależnych, które najlepiej różnicują grupy. W przykładzie pierwsza funkcja odpowiadała za 68.7% różnic międzygrupowych. Jej współczynniki strukturalne (korelacje zmiennych z funkcją) wyniosły .87 dla motywacji, .63 dla skuteczności i .11 dla lęku, więc jest to wymiar „motywacyjnego zaangażowania”. Centroidy (−0.33, −0.09 i 0.41) pokazują, że odróżnia on grupę z opisową informacją zwrotną od pozostałych. Druga funkcja (31.3%) też była istotna, χ²(2) = 6.37, p = .041. Łączy wyższy lęk (−.61) z niższą motywacją (.49) i najmocniej wyróżnia grupę z samą oceną (centroid −0.29). Ten wzorzec nie wyszedł w żadnej pojedynczej ANOVA – to właśnie informacja, którą daje podejście wielowymiarowe.
Krok 5. Jak opisać MANOVA w pracy (APA)
W rozdziale wyników podaj: uzasadnienie wyboru MANOVA, sprawdzenie założeń, nazwę statystyki testowej z przybliżonym F, stopniami swobody, p i η²p, a potem analizy następcze z informacją o korekcie. Haase i Ellis (1987) zalecają raportowanie zarówno testu wielowymiarowego, jak i testów następczych oraz miar siły związku. Średnie zbierz w tabeli; ogólne zasady znajdziesz w poradniku tabele APA – wzory i przykłady.
Tabela 1
Motywacja, poczucie skuteczności i lęk w trzech warunkach informacji zwrotnej oraz jednowymiarowe analizy następcze
| Zmienna | Brak informacji | Sama ocena | Opisowa | F Welcha | pHolm | η2 |
|---|---|---|---|---|---|---|
| M (SD) | M (SD) | M (SD) | ||||
| Motywacja wewnętrzna | 3.14 (0.80) | 3.12 (0.82) | 3.65 (0.92) | 5.71 | .014 | .08 |
| Poczucie skuteczności | 3.06 (0.63) | 3.26 (0.84) | 3.45 (0.90) | 3.25 | .087 | .04 |
| Lęk przed kolokwium | 2.95 (0.86) | 3.25 (1.01) | 3.09 (0.89) | 1.26 | .289 | .02 |
Uwaga. N = 150, n = 50 w każdej grupie (dane symulowane); skale 1–5. MANOVA: ślad Pillaia V = 0.13, F(6, 292) = 3.44, p = .003, η2p = .07. F Welcha z 2 i 95.36–97.67 stopniami swobody; pHolm – wartość p skorygowana metodą Holma dla trzech testów.
Gotowe zdania do innych analiz znajdziesz w poradniku jak opisać wyniki w stylu APA. Jeśli masz MANOVA z kilkoma czynnikami albo z kowariantem (MANCOVA, wielowymiarowy odpowiednik ANCOVA) i nie wiesz, którą drogę analiz następczych wybrać, zajrzyj do oferty analiz statystycznych dla studentów – sprawdzimy model i wyjaśnimy wyniki tak, abyś umiał(a) ich samodzielnie bronić.
MANOVA w R
Kod odtwarza wszystkie liczby z tekstu i tabeli. Pobierz plik manova-dane-przyklad.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – przepisy 2 i 3 korzystają z obiektów dane, zm i model z przepisu 1. Potrzebne pakiety: heplots, effectsize, rstatix i MASS.
1. Statystyki opisowe i założenia
R
# Krok 1–2: statystyki opisowe, korelacje zmiennych zależnych i założenia MANOVA (dane symulowane)
options(width = 110)
suppressPackageStartupMessages(library(heplots))   # boxM()
dane <- read.csv("manova-dane-przyklad.csv")
dane$grupa <- factor(dane$grupa, levels = c("brak", "ocena", "opisowa"))
zm <- c("motywacja", "skutecznosc", "lek")
Y <- as.matrix(dane[, zm])

# Liczebności oraz M i SD w grupach
table(dane$grupa)
round(do.call(cbind, lapply(zm, function(v) do.call(rbind, tapply(dane[[v]], dane$grupa,
  function(x) setNames(c(mean(x), sd(x)), paste0(v, c("_M", "_SD"))))))), 2)

# Korelacje wewnątrzgrupowe (z reszt modelu) – czy zmienne zależne tworzą sensowny zestaw?
model <- manova(Y ~ grupa, data = dane)
E <- crossprod(residuals(model)); dfe <- nrow(dane) - nlevels(dane$grupa)
round(cov2cor(E / dfe), 2)

# Wielowymiarowe obserwacje odstające: kwadrat odległości Mahalanobisa od średnich własnej grupy
D2 <- mahalanobis(residuals(model), center = rep(0, 3), cov = E / dfe)
c(max_D2 = round(max(D2), 2), krytyczna_chi2_3_001 = round(qchisq(.999, df = 3), 2), ponad_prog = sum(D2 > qchisq(.999, 3)))

# Rozkłady jednowymiarowe: skośność reszt w grupach (wartości bliskie 0 – brak silnej asymetrii)
skosnosc <- function(x) mean((x - mean(x))^3) / sd(x)^3
round(apply(residuals(model), 2, skosnosc), 2)

# Jednorodność macierzy kowariancji: test M Boxa
boxM(Y, dane$grupa)
Wynik w R
   brak   ocena opisowa
     50      50      50
        motywacja_M motywacja_SD skutecznosc_M skutecznosc_SD lek_M lek_SD
brak           3.14         0.80          3.06           0.63  2.95   0.86
ocena          3.12         0.82          3.26           0.84  3.25   1.01
opisowa        3.65         0.92          3.45           0.90  3.09   0.89
            motywacja skutecznosc  lek
motywacja        1.00        0.45 -0.2
skutecznosc      0.45        1.00 -0.4
lek             -0.20       -0.40  1.0
              max_D2 krytyczna_chi2_3_001           ponad_prog
               10.51                16.27                 0.00
  motywacja skutecznosc         lek
      -0.19       -0.04        0.18

 Box's M-test for Homogeneity of Covariance Matrices

data:  Y by dane$grupa
Chi-Sq (approx.) = 10.5154, df = 12, p-value = 0.5708
2. MANOVA: ślad Pillaia, lambda Wilksa i wielkość efektu
R
# Krok 3: MANOVA – ślad Pillaia (domyślnie), lambda Wilksa i wielowymiarowa wielkość efektu (kontynuacja: dane, model)
options(width = 110)
suppressPackageStartupMessages(library(effectsize))
summary(model, test = "Pillai")
summary(model, test = "Wilks")

# Cząstkowe eta kwadrat dla śladu Pillaia: V / s, gdzie s = min(liczba zmiennych zależnych, liczba grup − 1)
V <- summary(model, test = "Pillai")$stats[1, "Pillai"]
s <- min(3, nlevels(dane$grupa) - 1)
round(c(V = V, s = s, eta2p = V / s), 3)
# To samo z przybliżonego F, z 95% CI
st <- summary(model, test = "Pillai")$stats[1, ]
F_to_eta2(f = st[["approx F"]], df = st[["num Df"]], df_error = st[["den Df"]], ci = .95, alternative = "two.sided")
Wynik w R
           Df  Pillai approx F num Df den Df   Pr(>F)
grupa       2 0.13191   3.4364      6    292 0.002704 **
Residuals 147
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
           Df  Wilks approx F num Df den Df   Pr(>F)
grupa       2 0.8719    3.429      6    290 0.002755 **
Residuals 147
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
    V     s eta2p
0.132 2.000 0.066
Eta2 (partial) |       95% CI
-----------------------------
0.07           | [0.01, 0.11]
3. Analizy następcze: ANOVA Welcha z korektą Holma, Games–Howell i analiza dyskryminacyjna
R
# Krok 4: analizy następcze – ANOVA Welcha dla każdej zmiennej z korektą Holma, Games–Howell i analiza dyskryminacyjna
options(width = 110)
suppressPackageStartupMessages({ library(rstatix); library(MASS) })

# 4a. ANOVA Welcha dla każdej zmiennej zależnej, p skorygowane metodą Holma (3 testy)
welch <- t(sapply(zm, function(v) {
  w <- oneway.test(as.formula(paste(v, "~ grupa")), data = dane)
  a <- anova(lm(as.formula(paste(v, "~ grupa")), data = dane))
  c(F = unname(w$statistic), df1 = unname(w$parameter[1]), df2 = unname(w$parameter[2]), p = w$p.value,
    eta2 = a$`Sum Sq`[1] / sum(a$`Sum Sq`))
}))
welch <- cbind(welch, p_Holm = p.adjust(welch[, "p"], method = "holm"))
round(welch, 3)

# 4b. Porównania parami Gamesa–Howella dla motywacji (istotnej po korekcie)
games_howell_test(dane, motywacja ~ grupa)

# 4c. Opisowa analiza dyskryminacyjna: współczynniki strukturalne i centroidy grup
l <- lda(grupa ~ motywacja + skutecznosc + lek, data = dane)
wyn <- predict(l)$x
round(l$svd^2 / sum(l$svd^2), 3)                       # udział funkcji w różnicach międzygrupowych
# Czy druga funkcja jest istotna sama w sobie? (aproksymacja Bartletta dla wartości własnych z MANOVA)
ev <- summary(model)$Eigenvalues[1, 1:2]; N <- nrow(dane)
chi2 <- -(N - 1 - (3 + 3) / 2) * log(1 / (1 + ev[2]))
round(c(chi2_funkcja2 = chi2, df = 2, p = pchisq(chi2, 2, lower.tail = FALSE)), 3)
struktura <- sapply(1:2, function(f) sapply(zm, function(v)
  cor(resid(lm(dane[[v]] ~ dane$grupa)), resid(lm(wyn[, f] ~ dane$grupa)))))
colnames(struktura) <- c("LD1", "LD2"); round(struktura, 2)
round(aggregate(as.data.frame(wyn), list(grupa = dane$grupa), mean)[, -1], 2)
Wynik w R
                F df1    df2     p  eta2 p_Holm
motywacja   5.710   2 97.665 0.005 0.079  0.014
skutecznosc 3.246   2 95.362 0.043 0.039  0.087
lek         1.256   2 97.615 0.289 0.018  0.289
# A tibble: 3 × 8
  .y.       group1 group2  estimate conf.low conf.high p.adj p.adj.signif
* <chr>     <chr>  <chr>      <dbl>    <dbl>     <dbl> <dbl> <chr>
1 motywacja brak   ocena    -0.0200  -0.405      0.365 0.992 ns
2 motywacja brak   opisowa   0.51     0.0984     0.922 0.011 *
3 motywacja ocena  opisowa   0.53     0.116      0.944 0.008 **
[1] 0.687 0.313
chi2_funkcja2            df             p
        6.369         2.000         0.041
             LD1   LD2
motywacja   0.87  0.49
skutecznosc 0.63 -0.20
lek         0.11 -0.61
    LD1   LD2
1 -0.33  0.19
2 -0.09 -0.29
3  0.41  0.10
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- heplots (wersja 1.8.1): Friendly, M., Fox, J., & Monette, G. (2025). heplots: Visualizing tests in multivariate linear models [R package]. https://CRAN.R-project.org/package=heplots
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w MANOVA
- MANOVA jako bramka do ANOVA bez korekty. Istotny test wielowymiarowy nie chroni testów jednowymiarowych przed błędem I rodzaju (Huberty i Morris, 1989).
- Wrzucenie do modelu wszystkich zmiennych z ankiety. Zestaw zmiennych zależnych powinien wynikać z teorii, a każda dodatkowa zmienna obniża moc testu, jeśli nie wnosi różnic.
- Łączenie wyniku ogólnego skali z jej podskalami. Wynik ogólny jest sumą podskal, więc macierz kowariancji staje się osobliwa.
- Raportowanie czterech statystyk naraz albo wybór tej, która „wyszła”. Wybierz statystykę przed analizą – domyślnie ślad Pillaia.
- Pominięcie wielowymiarowych obserwacji odstających. Sprawdzenie każdej skali osobno ich nie wykryje.
- Brak wielkości efektu. Podaj η²p dla testu wielowymiarowego i η² lub różnice średnich z 95% CI w analizach następczych.
- Interpretacja przyczynowa przy grupach naturalnych. W przykładzie grupy losowano; przy porównaniu np. kierunków studiów różnice mogą mieć inne źródła.
Jeśli nie masz pewności, czy MANOVA to właściwa analiza dla Twoich hipotez, skorzystaj z przewodnika testy statystyczne – przewodnik po wyborze.
Najczęstsze pytania
Czy po MANOVA trzeba korygować p w jednowymiarowych ANOVA?
Tak. Istotny test wielowymiarowy nie chroni testów jednowymiarowych przed błędem I rodzaju – Huberty i Morris (1989) zakwestionowali tę praktykę. Wystarczy, że grupy różnią się jedną zmienną, a MANOVA „otworzy bramkę” także dla pozostałych. Skoryguj p metodą Holma albo zamiast serii ANOVA wykonaj opisową analizę dyskryminacyjną.
Jak policzyć wielkość efektu w MANOVA?
Dla śladu Pillaia cząstkowe eta kwadrat to η²p = V / s, gdzie s to mniejsza z liczb: liczba zmiennych zależnych albo liczba grup minus jeden. Przy trzech grupach i V = 0.13 daje to η²p = .07. W R przedział ufności uzyskasz funkcją F_to_eta2() z pakietu effectsize, podając przybliżone F i stopnie swobody.
Jak wykryć wielowymiarowe obserwacje odstające przed MANOVA?
Policz kwadrat odległości Mahalanobisa każdej osoby od średnich jej grupy i porównaj go z wartością krytyczną rozkładu χ² o liczbie stopni swobody równej liczbie zmiennych zależnych, zwykle dla p = .001 (dla trzech zmiennych 16.27). Osoby powyżej progu sprawdź w danych, zamiast usuwać je automatycznie. Pomaga też wykres Q–Q tych odległości.
Czy MANOVA działa przy różnej liczebności grup?
Działa, ale nierówne liczebności zwiększają wrażliwość testu na różne macierze kowariancji w grupach. Wtedy szczególnie raportuj ślad Pillaia, porównaj odchylenia standardowe i korelacje w grupach i nie opieraj się wyłącznie na teście M Boxa. Najbezpieczniej zaplanować badanie z równymi grupami.
Ile zmiennych zależnych można włączyć do MANOVA?
Tyle, ile uzasadnia teoria – zwykle 2–5 powiązanych zmiennych, np. podskal jednego kwestionariusza. Każda zmienna bez różnic międzygrupowych obniża moc testu, a liczba osób w każdej grupie musi wyraźnie przekraczać liczbę zmiennych. Nie łącz wyniku ogólnego skali z jej podskalami.
Powiązane hasła
Przeczytaj też
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikPoprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Masz w pracy kilka zmiennych zależnych i nie wiesz, czy liczyć MANOVA?
Pomożemy dobrać analizę do hipotez, sprawdzimy założenia i analizy następcze oraz wyjaśnimy wyniki tak, abyś umiał(a) samodzielnie obronić je przed promotorem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aranowska, E., & Rytel, J. (2010). Wielowymiarowa analiza wariancji – MANOVA. Psychologia Społeczna, 5(2–3), 117–141. https://www.ceeol.com/search/article-detail?id=229288 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Haase, R. F., & Ellis, M. V. (1987). Multivariate analysis of variance. Journal of Counseling Psychology, 34(4), 404–413. https://doi.org/10.1037/0022-0167.34.4.404
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Huberty, C. J., & Morris, J. D. (1989). Multivariate analysis versus multiple univariate analyses. Psychological Bulletin, 105(2), 302–308. https://doi.org/10.1037/0033-2909.105.2.302
- Leys, C., Delacre, M., Mora, Y. L., Lakens, D., & Ley, C. (2019). How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration. International Review of Social Psychology, 32(1), Article 5. https://doi.org/10.5334/irsp.289 ● Otwarty dostęp
- Olson, C. L. (1974). Comparative robustness of six tests in multivariate analysis of variance. Journal of the American Statistical Association, 69(348), 894–908. https://doi.org/10.1080/01621459.1974.10480224
- Sauder, D. C., & DeMars, C. E. (2019). An updated recommendation for multiple comparisons. Advances in Methods and Practices in Psychological Science, 2(1), 26–44. https://doi.org/10.1177/2515245918808784 ● Otwarty dostęp
- Warne, R. T. (2014). A primer on multivariate analysis of variance (MANOVA) for behavioral scientists. Practical Assessment, Research, and Evaluation, 19, Article 17. https://doi.org/10.7275/sm63-7h70 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{aranowska2010wielowymiarowa, author={Aranowska, Elżbieta and Rytel, Jolanta}, title={{Wielowymiarowa analiza wariancji – MANOVA}}, journal={Psychologia Społeczna}, year={2010}, volume={5}, number={2–3}, pages={117--141}, url={https://www.ceeol.com/search/article-detail?id=229288}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{haase1987multivariate, author={Haase, Richard F. and Ellis, Michael V.}, title={{Multivariate analysis of variance}}, journal={Journal of Counseling Psychology}, year={1987}, volume={34}, number={4}, pages={404--413}, doi={10.1037/0022-0167.34.4.404}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{huberty1989multivariate, author={Huberty, Carl J. and Morris, John D.}, title={{Multivariate analysis versus multiple univariate analyses}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={2}, pages={302--308}, doi={10.1037/0033-2909.105.2.302}}@article{leys2019how, author={Leys, Christophe and Delacre, Marie and Mora, Youri L. and Lakens, Daniël and Ley, Christophe}, title={{How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={5}, doi={10.5334/irsp.289}}@article{olson1974comparative, author={Olson, Chester L.}, title={{Comparative robustness of six tests in multivariate analysis of variance}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={348}, pages={894--908}, doi={10.1080/01621459.1974.10480224}}@article{sauder2019updated, author={Sauder, Derek C. and DeMars, Christine E.}, title={{An updated recommendation for multiple comparisons}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={1}, pages={26--44}, doi={10.1177/2515245918808784}}@article{warne2014primer, author={Warne, Russell T.}, title={{A primer on multivariate analysis of variance (MANOVA) for behavioral scientists}}, journal={Practical Assessment, Research, and Evaluation}, year={2014}, volume={19}, eid={17}, doi={10.7275/sm63-7h70}}