Kiedy korelacja kanoniczna
Masz dwa zestawy zmiennych i pytanie dotyczy związku między zestawami, a nie pojedynczych par. Na przykład: jak cechy pracy (autonomia, wsparcie przełożonego, obciążenie) wiążą się z samopoczuciem pracowników (zaangażowanie, satysfakcja, wyczerpanie, sen)? Macierz korelacji między zestawami daje tu 3 × 4 = 12 liczb. Testowanie każdej osobno zwiększa ryzyko błędu I rodzaju i rozmywa obraz całości.
Korelacja kanoniczna (ang. canonical correlation analysis, CCA) streszcza te 12 liczb w kilku parach kombinacji liniowych. Metodę zaproponował Hotelling (1936). Krótką definicję znajdziesz w haśle korelacja kanoniczna. Tutaj przechodzimy przez całą analizę na jednym przykładzie.
CCA ma sens, gdy oba zestawy są ciągłe, a żaden nie jest wyraźnie „przyczyną”. Jeśli jeden zestaw to grupy, wybierz MANOVA. Jeśli w drugim zestawie jest jedna zmienna, wystarczy regresja wieloraka. Gdy chcesz odtworzyć strukturę jednego zestawu, a nie związek dwóch, potrzebujesz PCA albo analizy czynnikowej.
Pary zmiennych kanonicznych
Zestaw X ma p zmiennych, zestaw Y – q. Analiza szuka takich wag, by kombinacja U1 zmiennych X i kombinacja V1 zmiennych Y były skorelowane najsilniej, jak się da. Ta korelacja to pierwsza korelacja kanoniczna rc1. Potem szuka drugiej pary (U2, V2) o największej korelacji, ale nieskorelowanej z pierwszą parą. I tak dalej, aż do s = min(p, q) par.
- Każda korelacja kanoniczna jest zwykłą korelacją Pearsona dwóch nowych zmiennych, U i V.
- Kolejne korelacje są coraz mniejsze: rc1 ≥ rc2 ≥ … ≥ rcs.
- rc² to wspólna wariancja zmiennych kanonicznych, a nie zmiennych obserwowanych. To częsty błąd interpretacji. Ile wariancji zmiennych odtwarzasz, mówi dopiero redundancja.
- Pierwsza korelacja kanoniczna jest co najmniej tak duża jak największa pojedyncza korelacja między zestawami. Maksymalizacja dopasowuje wagi do próby, więc rc1 jest w małych próbach przeszacowana.
Przykład: praca a samopoczucie
W danych symulowanych (set.seed(321)) 300 pracowników wypełniło siedem skal (średnie z pozycji, 1–5). Zestaw X to cechy pracy: autonomia, wsparcie przełożonego i obciążenie pracą. Zestaw Y to samopoczucie: zaangażowanie, satysfakcja z pracy, wyczerpanie emocjonalne i problemy ze snem. Mamy więc p = 3, q = 4 i s = 3 pary.
Plik do pobrania: korelacja-kanoniczna-dane-przyklad.csv – 300 wierszy, kolumny id, autonomia, wsparcie, obciazenie, zaangazowanie, satysfakcja, wyczerpanie, sen. Wszystkie liczby w tekście pochodzą z kodu w sekcji Przykład w R.
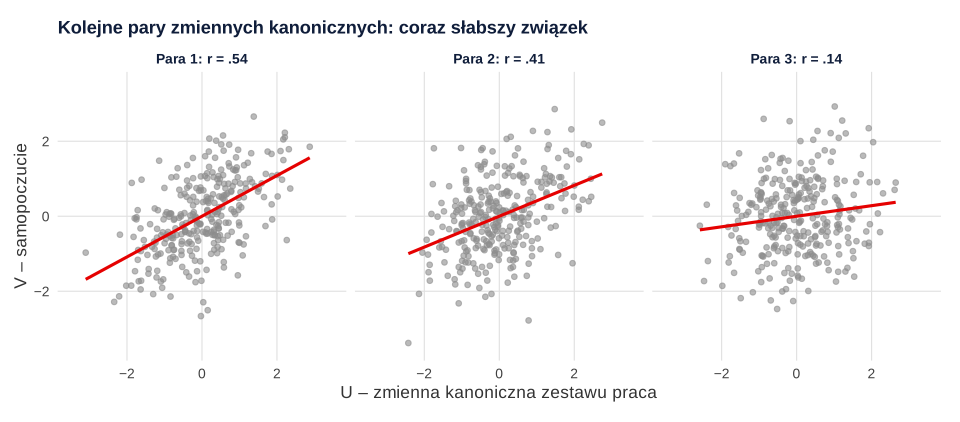
Korelacje między zestawami układają się w dwa bloki. Autonomia i wsparcie korelują z zaangażowaniem i satysfakcją (r od .36 do .48). Obciążenie koreluje z wyczerpaniem (r = .39) i problemami ze snem (r = .27). Pozostałe korelacje są bliskie zera albo słabe, od −.18 do −.04. Funkcja cancor() z bazowego R daje trzy korelacje kanoniczne: rc = .543, .411 i .141 (rc² = .294, .169 i .020).
Testy kolejnych korelacji
Nie testuje się każdej korelacji kanonicznej osobno. Stosuje się testy redukcji wymiaru: pierwszy test sprawdza, czy wszystkie s korelacji jest zerowych, drugi – czy zerowe są korelacje od drugiej do ostatniej, i tak dalej. Statystyką jest lambda Wilksa dla par od k do s:
Bartlett (1941) podał przybliżenie rozkładem chi-kwadrat:
Programy statystyczne częściej podają dokładniejsze przybliżenie F Rao. Oznacz a = p − k + 1 i b = q − k + 1. Wtedy:
F = (1 − Λk1/t) / Λk1/t × df2 / df1, df1 = ab, df2 = wt − ab / 2 + 1
Gdy a² + b² − 5 ≤ 0, przyjmuje się t = 1. Wzory w tej postaci podają podręczniki analizy wielowymiarowej (np. Rencher i Christensen, 2012). Pakietów CCA i CCP nie potrzebujesz: obie statystyki liczy kilka linijek kodu. Sprawdziliśmy też, że pierwszy test daje dokładnie tę samą lambdę i to samo F co summary(manova(Y ~ X), test = "Wilks").
| Testowane pary | Λ | χ² (df) | F Rao (df1, df2) | p |
|---|---|---|---|---|
| 1–3 | .574 | 163.51 (12) | 15.06 (12, 775.5) | < .001 |
| 2–3 | .814 | 60.63 (6) | 10.61 (6, 588) | < .001 |
| 3 | .980 | 5.91 (2) | 2.99 (2, 295) | .052 |
Pierwszy wiersz mówi tylko, że zestawy są związane, a nie że istotna jest akurat pierwsza para. Drugi wiersz pokazuje, że po usunięciu pierwszej pary zostaje jeszcze związek. Trzecia para nie osiąga progu .05, a jej rc² = .020 jest i tak zbyt małe, by ją interpretować. Interpretujemy dwie pary. Testy zakładają wielowymiarową normalność, więc sprawdź rozkłady i obserwacje odstające, np. odległością Mahalanobisa. Liczbę interpretowanych par wpisz do planu analizy albo uzasadnij regułą ustaloną z góry.
Wagi standaryzowane a ładunki
Każdą parę opisują dwa rodzaje współczynników, łatwe do pomylenia.
- Wagi standaryzowane (współczynniki kanoniczne) to współczynniki, z którymi zmienne wchodzą do U albo V. Działają jak współczynniki β w regresji: pokazują wkład zmiennej przy kontroli pozostałych z tego samego zestawu. Przy współliniowości są niestabilne i mogą zmieniać znak.
- Ładunki (współczynniki struktury, rs) to korelacje zmiennej z własną zmienną kanoniczną. Pokazują, do czego zmienna kanoniczna jest podobna, tak jak macierz struktury w analizie czynnikowej.
- Ładunki krzyżowe to korelacje zmiennej ze zmienną kanoniczną z drugiego zestawu. Mówią, jak dobrze druga strona „przewiduje” daną zmienną.
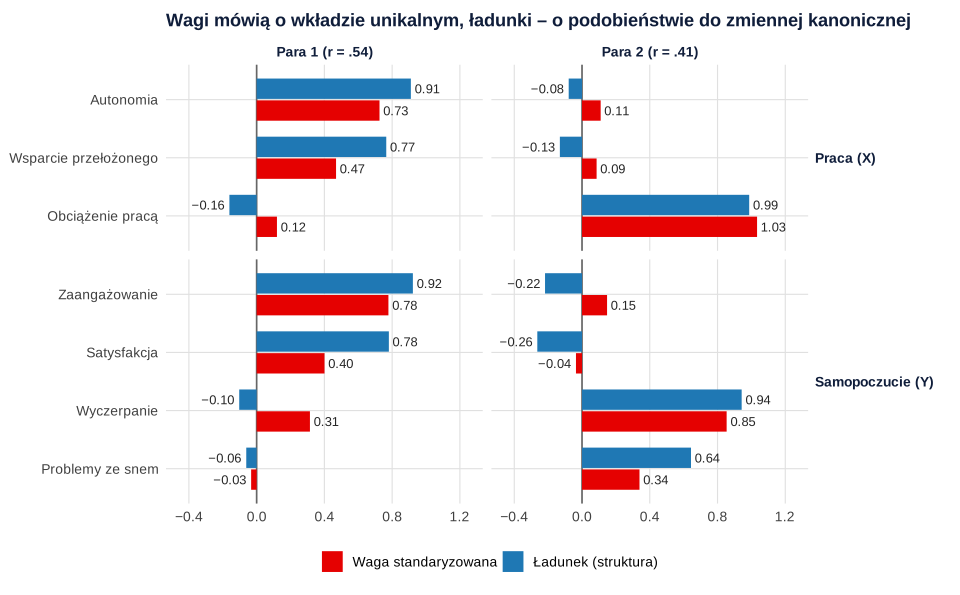
Pierwszą parę opisują ładunki: autonomia .91, wsparcie .77, zaangażowanie .92 i satysfakcja .78. To wymiar „zasoby w pracy – dobrostan motywacyjny”. Wyczerpanie ma tu ładunek −.10, ale dodatnią wagę 0.31. Po kontroli zaangażowania i satysfakcji, z którymi wyczerpanie koreluje ujemnie, jego reszta poprawia dopasowanie V1. To klasyczna supresja. Z samych wag wyciągnąłbyś błędny wniosek. Drugą parę tworzą obciążenie pracą (ładunek .99) oraz wyczerpanie (.94) i problemy ze snem (.64): to wymiar „wymagania – przeciążenie”.
Co raportować? Sherry i Henson (2005) pokazują pełną analizę krok po kroku i podają obie grupy współczynników. Rencher (1988) zwraca uwagę, że ładunki odtwarzają tylko związki jednowymiarowe i nie mówią, ile zmienna wnosi przy pozostałych. Wagi z kolei są wrażliwe na korelacje wewnątrz zestawu. Praktyczna rada: podawaj oba rodzaje współczynników, nazwę wymiaru opieraj na ładunkach, a rozbieżność znaków między wagą a ładunkiem opisz jako supresję, a nie jako wynik merytoryczny.
Redundancja
Stewart i Love (1968) zaproponowali wskaźnik redundancji. Mówi on, ile wariancji zmiennych jednego zestawu odtwarza druga strona przez daną parę:
Pierwszy czynnik to wariancja zestawu Y wyodrębniona przez Vk. W przykładzie V1 wyodrębnia 36.9% wariancji zmiennych samopoczucia, a V2 35.5%. Po przemnożeniu przez rc² dostajemy redundancję .109 i .060. Łącznie cechy pracy odtwarzają 17.1% wariancji samopoczucia. To dokładnie średnie R² z czterech regresji każdej zmiennej Y na trzech zmiennych X (.171).
Redundancja jest asymetryczna. W drugą stronę samopoczucie odtwarza 20.1% wariancji cech pracy (.141 i .056 dla dwóch par). Cramer i Nicewander (1979) odróżniają redundancję od symetrycznych miar wielowymiarowego związku zestawów, które są funkcjami korelacji kanonicznych. Uwaga na nazwę: w PLS-SEM analiza redundancji oznacza coś innego – sprawdzenie trafności zbieżnej konstruktu formatywnego.
Związek z regresją wieloraką i MANOVA
Knapp (1978) opisał korelację kanoniczną jako ogólny system testów parametrycznych. Typowe testy są jej szczególnymi przypadkami. Trzy zależności warto znać:
- Jedna zmienna w zestawie Y: jest tylko jedna para, a rc = R z regresji wielorakiej. Dla zaangażowania obie wartości wynoszą .510, a wagi kanoniczne są proporcjonalne do β.
- Zestaw X złożony ze zmiennych zero-jedynkowych kodujących grupy: lambda Wilksa z CCA jest lambdą z MANOVA, a zmienne kanoniczne zestawu Y to funkcje analizy dyskryminacyjnej. Przy dwóch grupach test sprowadza się do T² Hotellinga.
- Wielowymiarowa regresja Y na X: pierwszy test redukcji wymiaru to test całego modelu. W przykładzie
manova(Y ~ X)daje Λ = .574 i F(12, 775.5) = 15.06, tak samo jak wzór Rao.
Regresja wielowymiarowa odpowiada na pytanie, jak X przewiduje każdą zmienną Y. CCA pyta, ile niezależnych wymiarów łączy zestawy i jak je nazwać. W przykładzie odpowiedź brzmi: dwa wymiary, zasoby i wymagania.
Liczebność i stabilność wyników
Same korelacje kanoniczne są dość stabilne. Wagi i ładunki – już nie. W symulacji Barcikowskiego i Stevensa (1975) rzetelne wskazanie najważniejszych zmiennych wymagało od 42 do 68 osób na zmienną. Przy siedmiu zmiennych to około 300–480 osób. Nasze N = 300 leży na dolnej granicy.
Podzieliliśmy próbę losowo na dwie połowy po 150 osób, czyli około 21 osób na zmienną. Pierwsza korelacja kanoniczna wyniosła .59 i .51. Ładunki zaangażowania (.89 i .95) i satysfakcji (.76 i .85) powtórzyły się dobrze. Waga wyczerpania spadła jednak z 0.44 do 0.06, a jego ładunek zmienił się z −.04 na −.33. Taki podział (albo walidacja krzyżowa i bootstrap współczynników) warto pokazać w aneksie.
Lambert i Durand (1975) ostrzegają, że pominięcie ograniczeń analizy kanonicznej prowadzi do błędnych interpretacji. Dlatego zachowaj ostrożność:
- nazwę wymiaru opieraj na kilku wysokich ładunkach, a nie na jednej wadze;
- nie interpretuj par o małym rc², nawet istotnych w dużej próbie;
- nie dobieraj zmiennych do zestawów po obejrzeniu wyników – CCA jest wtedy analizą eksploracyjną i tak ją opisz;
- pamiętaj, że zmienne kanoniczne to kompozyty bez błędu pomiaru, a nie zmienne latentne.
Jak opisać korelację kanoniczną (APA)
W metodzie podaj skład zestawów, N, sprawdzenie założeń i regułę wyboru liczby par. W wynikach podaj testy redukcji wymiaru, rc i rc² interpretowanych par, tabelę wag i ładunków oraz redundancję w wybranym kierunku. Ogólne zasady tabel opisujemy we wpisie o tabelach i rysunkach do artykułu.
Tabela 1
Wagi standaryzowane i ładunki dwóch pierwszych par zmiennych kanonicznych
| Para 1 | Para 2 | ||||
|---|---|---|---|---|---|
| Zmienna | Waga | rs | Waga | rs | h² |
| Zestaw X: cechy pracy | |||||
| Autonomia | 0.73 | .91 | 0.11 | −.08 | .84 |
| Wsparcie przełożonego | 0.47 | .77 | 0.09 | −.13 | .60 |
| Obciążenie pracą | 0.12 | −.16 | 1.03 | .99 | 1.00 |
| Zestaw Y: samopoczucie | |||||
| Zaangażowanie | 0.78 | .92 | 0.15 | −.22 | .90 |
| Satysfakcja | 0.40 | .78 | −0.04 | −.26 | .68 |
| Wyczerpanie emocjonalne | 0.31 | −.10 | 0.85 | .94 | .90 |
| Problemy ze snem | −0.03 | −.06 | 0.34 | .64 | .42 |
| rc (rc²) | .54 (.29) | .41 (.17) | |||
| Redundancja Y | X | .11 | .06 | |||
Uwaga. N = 300. Waga = standaryzowany współczynnik kanoniczny; rs = ładunek (korelacja zmiennej z własną zmienną kanoniczną); h² = suma kwadratów ładunków w dwóch parach. Redundancja Y | X = część wariancji zmiennych samopoczucia odtworzona przez cechy pracy w danej parze. Trzecia para: rc = .14, p = .052. Dane symulowane.
Jeśli przygotowujesz artykuł z analizą wielowymiarową i chcesz, żeby ktoś sprawdził wybór metody i interpretację, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Trzy przepisy uruchamiane po kolei w jednej sesji, w folderze z plikiem danych. Wystarczy bazowy R (cancor(), manova(), lm()) i pakiet MASS do symulacji. Testy Bartletta i Rao, ładunki oraz redundancję liczymy ręcznie ze wzorów, więc pakiety CCA i CCP nie są potrzebne.
0. Symulacja danych
R
# B321 – symulacja danych: zasoby i wymagania w pracy (zestaw X) a samopoczucie pracowników (zestaw Y)
# Uruchom z folderu strony (nad kod/):  Rscript kod/b321-0-symulacja-danych.R
set.seed(321)
n <- 300
zm <- c("autonomia", "wsparcie", "obciazenie", "zaangazowanie", "satysfakcja", "wyczerpanie", "sen")
# populacyjna macierz korelacji (kolejność jak w zm)
R <- matrix(c(
  1.00,  .45, -.10,  .40,  .35, -.15, -.05,
   .45, 1.00, -.20,  .30,  .38, -.25, -.12,
  -.10, -.20, 1.00, -.05, -.15,  .40,  .30,
   .40,  .30, -.05, 1.00,  .60, -.35, -.15,
   .35,  .38, -.15,  .60, 1.00, -.40, -.20,
  -.15, -.25,  .40, -.35, -.40, 1.00,  .45,
  -.05, -.12,  .30, -.15, -.20,  .45, 1.00), 7, dimnames = list(zm, zm))
z <- MASS::mvrnorm(n, mu = rep(0, 7), Sigma = R)
# wyniki skal jako średnie z pozycji 1–5 (średnia 3, SD 0.7), zaokrąglone do 0.01
dane <- as.data.frame(round(pmin(pmax(3 + 0.7 * z, 1), 5), 2))
names(dane) <- zm
dane <- data.frame(id = seq_len(n), dane)
write.csv(dane, "korelacja-kanoniczna-dane-przyklad.csv", row.names = FALSE)
cat("Zapisano", nrow(dane), "wierszy\n")
1. Korelacje kanoniczne, testy, wagi, ładunki i redundancja
R
# Krok 1–4: korelacje kanoniczne, testy kolejnych par, wagi standaryzowane, ładunki i redundancja
# Dane: korelacja-kanoniczna-dane-przyklad.csv (symulowane, set.seed(321)); uruchom z folderu strony (nad kod/)
options(width = 110)
dane <- read.csv("korelacja-kanoniczna-dane-przyklad.csv")
X <- scale(dane[, c("autonomia", "wsparcie", "obciazenie")])                  # zestaw 1: praca
Y <- scale(dane[, c("zaangazowanie", "satysfakcja", "wyczerpanie", "sen")])   # zestaw 2: samopoczucie
N <- nrow(X); p <- ncol(X); q <- ncol(Y); s <- min(p, q)

# Korelacje między zestawami (12 liczb, które CCA ma streścić)
round(cor(X, Y), 2)

# 1. Korelacje kanoniczne (stats::cancor)
cc <- cancor(X, Y)
r <- cc$cor
round(rbind(r = r, r2 = r^2), 3)

# 2. Testy kolejnych par: lambda Wilksa, przybliżenie Bartletta (chi-kwadrat) i F Rao
testy_kanoniczne <- function(r, N, p, q) {
  do.call(rbind, lapply(seq_along(r), function(k) {
    L <- prod(1 - r[k:length(r)]^2)                       # lambda Wilksa dla par k, k+1, ..., s
    pk <- p - k + 1; qk <- q - k + 1; df1 <- pk * qk
    chi2 <- -(N - 1 - (p + q + 1) / 2) * log(L)           # Bartlett
    w <- N - 1.5 - (p + q) / 2                            # F Rao
    t <- if (pk^2 + qk^2 - 5 > 0) sqrt((pk^2 * qk^2 - 4) / (pk^2 + qk^2 - 5)) else 1
    df2 <- w * t - df1 / 2 + 1
    Fr <- (1 - L^(1 / t)) / L^(1 / t) * df2 / df1
    data.frame(pary = paste0(k, "-", length(r)), lambda = L, chi2 = chi2, df = df1,
               p_chi2 = pchisq(chi2, df1, lower.tail = FALSE),
               F = Fr, df1 = df1, df2 = df2, p_F = pf(Fr, df1, df2, lower.tail = FALSE))
  }))
}
tst <- testy_kanoniczne(r, N, p, q)
print(transform(tst, lambda = round(lambda, 3), chi2 = round(chi2, 2), F = round(F, 2), df2 = round(df2, 1),
                p_chi2 = signif(p_chi2, 3), p_F = signif(p_F, 3)), row.names = FALSE)

# Kontrola: pierwszy test to to samo co wielowymiarowa regresja Y na X (lambda Wilksa w manova)
summary(manova(Y ~ X), test = "Wilks")

# 3. Wagi standaryzowane i ładunki (współczynniki struktury)
U <- X %*% cc$xcoef[, 1:s]; V <- Y %*% cc$ycoef[, 1:s]
lY <- cor(Y, V)
znak <- sign(lY[cbind(apply(abs(lY), 2, which.max), 1:s)])   # największy ładunek w zestawie Y dodatni
U <- sweep(U, 2, znak * apply(U, 2, sd), "/"); V <- sweep(V, 2, znak * apply(V, 2, sd), "/")
colnames(U) <- paste0("U", 1:s); colnames(V) <- paste0("V", 1:s)
wagi_X <- solve(cor(X), cor(X, U))           # wagi standaryzowane = współczynniki regresji U na X
wagi_Y <- solve(cor(Y), cor(Y, V))
lad_X <- cor(X, U); lad_Y <- cor(Y, V)       # ładunki kanoniczne (struktura)
krz_X <- cor(X, V); krz_Y <- cor(Y, U)       # ładunki krzyżowe
round(cbind(wagi = wagi_X, ladunki = lad_X), 2)
round(cbind(wagi = wagi_Y, ladunki = lad_Y), 2)
round(krz_X, 2); round(krz_Y, 2)
round(diag(cor(U, V)), 3)                    # kontrola: to są korelacje kanoniczne

# 4. Redundancja (Stewart i Love, 1968): średni kwadrat ładunku × r^2
wyjasn_Y <- colMeans(lad_Y^2); wyjasn_X <- colMeans(lad_X^2)
red <- rbind(r2 = r^2, wariancja_Y_wyjasniona_przez_V = wyjasn_Y, redundancja_Y_przez_X = wyjasn_Y * r^2,
             wariancja_X_wyjasniona_przez_U = wyjasn_X, redundancja_X_przez_Y = wyjasn_X * r^2)
round(cbind(red, razem = c(NA, rowSums(red[-1, ]))), 3)
# kontrola: łączna redundancja Y przez X = średnie R^2 z regresji każdej zmiennej Y na wszystkich X
round(mean(sapply(colnames(Y), function(v) summary(lm(Y[, v] ~ X))$r.squared)), 3)

# 5. Wspólność h2: część wariancji zmiennej odtworzona przez dwie interpretowane pary (suma kwadratów ładunków)
round(c(rowSums(lad_X[, 1:2]^2), rowSums(lad_Y[, 1:2]^2)), 2)
Wynik w R
           zaangazowanie satysfakcja wyczerpanie   sen
autonomia           0.48        0.36       -0.08 -0.06
wsparcie            0.37        0.39       -0.09 -0.04
obciazenie         -0.17       -0.18        0.39  0.27
    [,1]  [,2]  [,3]
r  0.543 0.411 0.141
r2 0.294 0.169 0.020
 pary lambda   chi2 df   p_chi2     F df1   df2      p_F
  1-3  0.574 163.51 12 1.01e-28 15.06  12 775.5 1.02e-28
  2-3  0.814  60.63  6 3.35e-11 10.61   6 588.0 3.35e-11
  3-3  0.980   5.91  2 5.20e-02  2.99   2 295.0 5.20e-02
           Df   Wilks approx F num Df den Df    Pr(>F)
X           3 0.57449   15.061     12  775.5 < 2.2e-16 ***
Residuals 296
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
             U1   U2    U3    U1    U2    U3
autonomia  0.73 0.11 -0.86  0.91 -0.08 -0.41
wsparcie   0.47 0.09  1.04  0.77 -0.13  0.63
obciazenie 0.12 1.03  0.07 -0.16  0.99 -0.01
                 V1    V2    V3    V1    V2    V3
zaangazowanie  0.78  0.15 -1.00  0.92 -0.22 -0.28
satysfakcja    0.40 -0.04  1.19  0.78 -0.26  0.57
wyczerpanie    0.31  0.85 -0.04 -0.10  0.94 -0.02
sen           -0.03  0.34  0.21 -0.06  0.64  0.22
              V1    V2    V3
autonomia   0.49 -0.03 -0.06
wsparcie    0.42 -0.05  0.09
obciazenie -0.09  0.41  0.00
                 U1    U2    U3
zaangazowanie  0.50 -0.09 -0.04
satysfakcja    0.42 -0.11  0.08
wyczerpanie   -0.06  0.39  0.00
sen           -0.03  0.26  0.03
[1] 0.543 0.411 0.141
                                  V1    V2    V3 razem
r2                             0.294 0.169 0.020    NA
wariancja_Y_wyjasniona_przez_V 0.369 0.355 0.112 0.835
redundancja_Y_przez_X          0.109 0.060 0.002 0.171
wariancja_X_wyjasniona_przez_U 0.480 0.332 0.187 1.000
redundancja_X_przez_Y          0.141 0.056 0.004 0.201
[1] 0.171
    autonomia      wsparcie    obciazenie zaangazowanie   satysfakcja   wyczerpanie           sen
         0.84          0.60          1.00          0.90          0.68          0.90          0.42
2. Regresja wieloraka i stabilność w połowach próby
R
# Krok 5: związek z regresją wieloraką i stabilność wag oraz ładunków (kontynuacja przepisu 1)
# Jedna zmienna w drugim zestawie: korelacja kanoniczna = R z regresji wielorakiej
c(r_kanoniczna = cancor(X, Y[, "zaangazowanie"])$cor,
  R_regresja = sqrt(summary(lm(Y[, "zaangazowanie"] ~ X))$r.squared))

# Podział próby na dwie losowe połowy: czy wagi i ładunki pierwszej pary się powtarzają?
set.seed(3211)
polowa <- sample(rep(1:2, length.out = N))
para1 <- function(idx) {
  Xh <- scale(X[idx, ]); Yh <- scale(Y[idx, ]); ch <- cancor(Xh, Yh)
  u <- Xh %*% ch$xcoef[, 1]; v <- Yh %*% ch$ycoef[, 1]
  zn <- sign(cor(Yh[, "zaangazowanie"], v)[1]); u <- zn * u / sd(u); v <- zn * v / sd(v)
  c(r1 = ch$cor[1], wagaY = solve(cor(Yh), cor(Yh, v))[, 1], ladY = cor(Yh, v)[, 1])
}
round(cbind(polowa_1 = para1(polowa == 1), polowa_2 = para1(polowa == 2), cala = para1(rep(TRUE, N))), 2)
Wynik w R
r_kanoniczna   R_regresja
   0.5099858    0.5099858
                    polowa_1 polowa_2  cala
r1                      0.59     0.51  0.54
wagaY.zaangazowanie     0.80     0.69  0.78
wagaY.satysfakcja       0.40     0.42  0.40
wagaY.wyczerpanie       0.44     0.06  0.31
wagaY.sen              -0.09    -0.05 -0.03
ladY.zaangazowanie      0.89     0.95  0.92
ladY.satysfakcja        0.76     0.85  0.78
ladY.wyczerpanie       -0.04    -0.33 -0.10
ladY.sen               -0.06    -0.17 -0.06
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje cancor(), manova(), lm()) i pakietu MASS (mvrnorm()); rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Czytanie rc² jako wyjaśnionej wariancji zmiennych. W przykładzie rc1² = .294, a redundancja pierwszej pary to tylko .109.
- Nazywanie wymiaru na podstawie samych wag. Waga wyczerpania w pierwszej parze ma inny znak niż jego ładunek.
- Interpretowanie wszystkich par, bo „program je wypisał”. Liczbę par ustala sekwencja testów i wielkość rc².
- Traktowanie pierwszego testu jako testu pierwszej pary. Λ1 dotyczy wszystkich par łącznie.
- Za mała próba. Przy kilkunastu osobach na zmienną wagi i ładunki zmieniają się między połowami próby.
- Brak kierunku przy redundancji. RdY|X i RdX|Y to różne liczby; podaj, którą raportujesz.
- Mylenie CCA z PCA. PCA streszcza jeden zestaw, CCA – związek dwóch zestawów.
Najczęstsze pytania
Kiedy przestać interpretować kolejne korelacje kanoniczne?
Gdy pierwszy raz w sekwencji testów redukcji wymiaru wynik jest nieistotny albo gdy rc² kolejnej pary jest zbyt małe, by miało znaczenie praktyczne. Test 1–s sprawdza wszystkie pary razem, test 2–s pary od drugiej i tak dalej. Regułę zapisz przed analizą.
Dlaczego waga kanoniczna ma inny znak niż ładunek?
Waga standaryzowana pokazuje wkład zmiennej przy kontroli pozostałych zmiennych zestawu, jak β w regresji, a ładunek to zwykła korelacja zmiennej ze zmienną kanoniczną. Gdy zmienne w zestawie są skorelowane, zmienna o ładunku bliskim zera może dostać wyraźną wagę – to supresja. Nazwę wymiaru opieraj wtedy na ładunkach.
Co to jest indeks redundancji w korelacji kanonicznej?
To część wariancji zmiennych jednego zestawu odtworzona przez drugi zestaw w danej parze: średni kwadrat ładunku pomnożony przez rc². Suma po parach równa się średniemu R² z regresji każdej zmiennej jednego zestawu na wszystkich zmiennych drugiego. Redundancja jest asymetryczna, więc podaj kierunek.
Jaka liczebność próby jest potrzebna do korelacji kanonicznej?
Same korelacje kanoniczne są stabilne już w umiarkowanych próbach, ale wagi i ładunki wymagają dużo więcej danych. W symulacji Barcikowskiego i Stevensa (1975) potrzebne było od 42 do 68 osób na zmienną. Przy mniejszej próbie sprawdź stabilność w podziale próby albo bootstrapem i opisz wyniki ostrożnie.
Jak policzyć korelację kanoniczną w R bez dodatkowych pakietów?
Funkcja cancor() z bazowego R zwraca korelacje kanoniczne i współczynniki. Lambdę Wilksa liczysz jako iloczyn (1 − rc²), a test Bartletta i F Rao – ze wzorów w kilku linijkach. Ładunki to korelacje zmiennych z wynikami zmiennych kanonicznych. Pierwszy test możesz sprawdzić funkcją manova().
Powiązane hasła
Przeczytaj też
MANOVA krok po kroku
Założenia, odległość Mahalanobisa i test M Boxa, ślad Pillaia z η²p, analizy następcze z korektą Holma i opis APA – na danych do pobrania z kodem R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikPCA czy analiza czynnikowa?
Kiedy redukcja danych, a kiedy model konstruktu: tabela „kiedy która” i porównanie PCA z EFA na tych samych danych w R – ładunki, korelacje i wyniki osób.
Czytaj →Analizujesz związek dwóch zestawów zmiennych i nie wiesz, ile wymiarów interpretować?
Pomożemy dobrać metodę, przetestować kolejne korelacje kanoniczne, sprawdzić stabilność ładunków i opisać wyniki w tabeli APA tak, żebyś mógł(a) je samodzielnie obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Barcikowski, R. S., & Stevens, J. P. (1975). A Monte Carlo study of the stability of canonical correlations, canonical weights and canonical variate-variable correlations. Multivariate Behavioral Research, 10(3), 353–364. https://doi.org/10.1207/s15327906mbr1003_8
- Bartlett, M. S. (1941). The statistical significance of canonical correlations. Biometrika, 32(1), 29–37. https://doi.org/10.1093/biomet/32.1.29
- Cramer, E. M., & Nicewander, W. A. (1979). Some symmetric, invariant measures of multivariate association. Psychometrika, 44(1), 43–54. https://doi.org/10.1007/bf02293783
- Hotelling, H. (1936). Relations between two sets of variates. Biometrika, 28(3–4), 321–377. https://doi.org/10.1093/biomet/28.3-4.321
- Knapp, T. R. (1978). Canonical correlation analysis: A general parametric significance-testing system. Psychological Bulletin, 85(2), 410–416. https://doi.org/10.1037/0033-2909.85.2.410
- Lambert, Z. V., & Durand, R. M. (1975). Some precautions in using canonical analysis. Journal of Marketing Research, 12(4), 468–475. https://doi.org/10.1177/002224377501200411
- Rencher, A. C. (1988). On the use of correlations to interpret canonical functions. Biometrika, 75(2), 363–365. https://doi.org/10.1093/biomet/75.2.363
- Rencher, A. C., & Christensen, W. F. (2012). Methods of multivariate analysis (3rd ed.). Wiley. https://doi.org/10.1002/9781118391686
- Sherry, A., & Henson, R. K. (2005). Conducting and interpreting canonical correlation analysis in personality research: A user-friendly primer. Journal of Personality Assessment, 84(1), 37–48. https://doi.org/10.1207/s15327752jpa8401_09 ● Otwarty dostęp
- Stewart, D., & Love, W. (1968). A general canonical correlation index. Psychological Bulletin, 70(3, Pt. 1), 160–163. https://doi.org/10.1037/h0026143
Cytowania BibTeX
@article{barcikowski1975monte, author={Barcikowski, Robert S. and Stevens, James P.}, title={{A Monte Carlo study of the stability of canonical correlations, canonical weights and canonical variate-variable correlations}}, journal={Multivariate Behavioral Research}, year={1975}, volume={10}, number={3}, pages={353--364}, doi={10.1207/s15327906mbr1003_8}}@article{bartlett1941statistical, author={Bartlett, M. S.}, title={{The statistical significance of canonical correlations}}, journal={Biometrika}, year={1941}, volume={32}, number={1}, pages={29--37}, doi={10.1093/biomet/32.1.29}}@article{cramer1979some, author={Cramer, Elliot M. and Nicewander, W. Alan}, title={{Some symmetric, invariant measures of multivariate association}}, journal={Psychometrika}, year={1979}, volume={44}, number={1}, pages={43--54}, doi={10.1007/bf02293783}}@article{hotelling1936relations, author={Hotelling, Harold}, title={{Relations between two sets of variates}}, journal={Biometrika}, year={1936}, volume={28}, number={3–4}, pages={321--377}, doi={10.1093/biomet/28.3-4.321}}@article{knapp1978canonical, author={Knapp, Thomas R.}, title={{Canonical correlation analysis: A general parametric significance-testing system}}, journal={Psychological Bulletin}, year={1978}, volume={85}, number={2}, pages={410--416}, doi={10.1037/0033-2909.85.2.410}}@article{lambert1975some, author={Lambert, Zarrel V. and Durand, Richard M.}, title={{Some precautions in using canonical analysis}}, journal={Journal of Marketing Research}, year={1975}, volume={12}, number={4}, pages={468--475}, doi={10.1177/002224377501200411}}@article{rencher1988use, author={Rencher, Alvin C.}, title={{On the use of correlations to interpret canonical functions}}, journal={Biometrika}, year={1988}, volume={75}, number={2}, pages={363--365}, doi={10.1093/biomet/75.2.363}}@book{rencher2012methods, author={Rencher, Alvin C. and Christensen, William F.}, title={{Methods of multivariate analysis (3rd ed.)}}, year={2012}, publisher={Wiley}, doi={10.1002/9781118391686}}@article{sherry2005conducting, author={Sherry, Alissa and Henson, Robin K.}, title={{Conducting and interpreting canonical correlation analysis in personality research: A user-friendly primer}}, journal={Journal of Personality Assessment}, year={2005}, volume={84}, number={1}, pages={37--48}, doi={10.1207/s15327752jpa8401_09}}@article{stewart1968general, author={Stewart, Douglas and Love, William}, title={{A general canonical correlation index}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={3, Pt. 1}, pages={160--163}, doi={10.1037/h0026143}}