Kiedy MANOVA w SPSS ma sens
MANOVA porównuje grupy jednocześnie pod względem kilku zmiennych zależnych. Teorię, założenia i analizy następcze omawia wpis MANOVA krok po kroku. Tutaj zajmujemy się tylko SPSS: oknem procedury, tabelami wydruku i tym, co z nich przepisać do pracy. Ogólne zasady czytania wydruku są we wpisie jak czytać wyniki z SPSS.
Zanim klikniesz, odpowiedz na jedno pytanie: czy hipoteza dotyczy łącznego profilu zmiennych, czy każdej zmiennej osobno? Huberty i Morris (1989) wskazują, że analiza wielowymiarowa ma sens przy pytaniach o układ zmiennych zależnych, na przykład o konstrukt, który tworzą razem. Huang (2020) zauważa, że większość opublikowanych badań z MANOVA stawia w istocie pytania jednowymiarowe. Sam fakt, że masz kilka zmiennych zależnych, nie jest więc powodem do MANOVA. Dokumentacja SPSS dodaje praktyczną uwagę: gdy zmienne zależne są nieskorelowane, testy jednowymiarowe mają większą moc (IBM Corp., b.d.-d). Jeśli każda zmienna to osobna hipoteza (H1, H2, H3), wykonaj osobne ANOVA, opisane we wpisie ANOVA w SPSS krok po kroku, z korektą na wielokrotne porównania. Pomoże też kreator doboru testu.
W SPSS MANOVA to procedura GLM Multivariate. Ścieżki menu, nazwy okien, opcji i tabel sprawdziliśmy w dokumentacji IBM SPSS Statistics 31 (IBM Corp., b.d.-a, b.d.-b, b.d.-c, b.d.-d) i podajemy je po angielsku. Polska dokumentacja nazywa procedurę „Analiza OML wielu zmiennych” i podaje ścieżkę Analizuj → Ogólny model liniowy → Wielowymiarowy (IBM Corp., b.d.-a). Etykiety w polskim interfejsie programu mogą brzmieć inaczej. Według dokumentacji procedura wymaga wydania SPSS Statistics Standard Edition albo opcji Advanced Statistics (IBM Corp., b.d.-a).
Przykład i pliki do pobrania
Wszystkie liczby pochodzą z jednego zbioru symulowanego. 120 osób na pierwszym roku studiów przydzielono losowo do trzech warunków po 40 osób: bez programu wsparcia, z mentoringiem starszego studenta albo z cyklem warsztatów. Po semestrze wypełniły trzy skale (średnie z pozycji, 1–5): adaptację do studiów, poczucie przynależności i samotność. Hipoteza dotyczyła ogólnego przystosowania do studiów, które te trzy skale opisują razem, więc pytanie jest wielowymiarowe.
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV (format opisuje hasło plik .sav). Jeden wiersz to jedna osoba; grupa ma kody 1–3 z etykietami. Zmienne zależne muszą być ilościowe, a czynnik jakościowy (IBM Corp., b.d.-a). Etykiety i braki danych ustawisz według wpisu przygotowanie danych w SPSS.
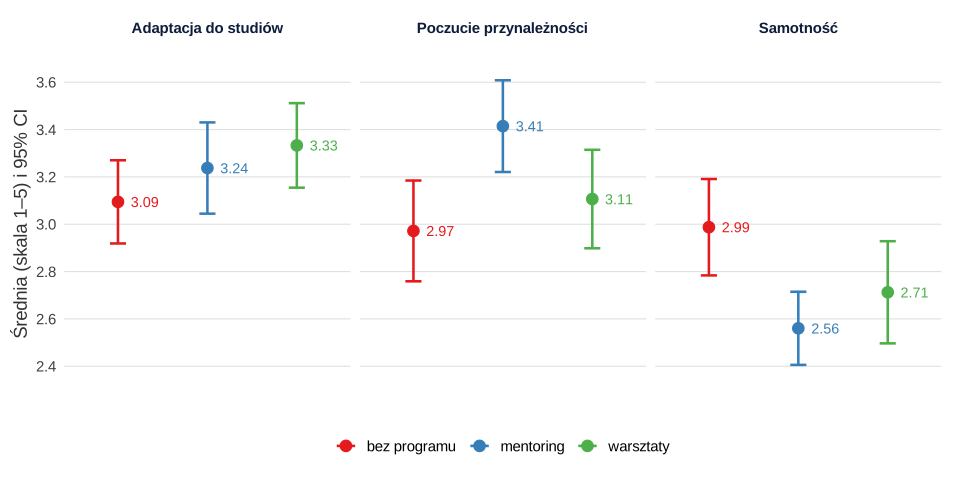
Okna procedury krok po kroku
- Analyze → General Linear Model → Multivariate (IBM Corp., b.d.-a).
- Okno główne. Przenieś
adaptacja,przynaleznoscisamotnoscna listę zmiennych zależnych – SPSS wymaga co najmniej dwóch (IBM Corp., b.d.-a). Zmiennągrupaprzenieś do pola Fixed Factor(s). Pole Covariate(s) zostaw puste; kowarianty dodaje się tak jak w ANCOVA w SPSS. - Options. Zaznacz Descriptive statistics, Estimates of effect size i Homogeneity tests. Ta ostatnia opcja daje test Levene’a dla każdej zmiennej zależnej i test M Boxa (IBM Corp., b.d.-b).
- Post Hoc. Przenieś
grupai zaznacz Tukey (równe grupy, równe wariancje) albo Games-Howell (nierówne wariancje). Testy te SPSS liczy osobno dla każdej zmiennej zależnej (IBM Corp., b.d.-a). - Kliknij OK albo Paste, żeby zapisać składnię GLM.
Domyślny model zawiera wszystkie efekty główne i interakcje czynników, a sumy kwadratów są typu III (IBM Corp., b.d.-a). Przy jednym czynniku nic nie zmieniasz. Przy dwóch czynnikach dochodzi wiersz interakcji, czytany tak jak w dwuczynnikowej ANOVA.
Wyniki pokazujemy w tabelach o układzie tabel wynikowych SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Dokumentacja IBM pokazuje tabele wydruku jako obrazy, więc nagłówki kolumn odtworzyliśmy z typowego wydruku SPSS. Pogrubiono liczby, które trafią do pracy.
Krok 1: test M Boxa i testy Levene’a
MANOVA zakłada, że macierze wariancji–kowariancji zmiennych zależnych są w grupach jednakowe (IBM Corp., b.d.-a). Sprawdza to test M Boxa, przekształcony do statystyki F z df1 i df2 (IBM Corp., b.d.-c).
| Box’s M | 10.259 |
|---|---|
| F | .823 |
| df1 | 12 |
| df2 | 66339.000 |
| Sig. | .627 |
p = .627, więc test nie wskazuje na różnice macierzy kowariancji. Bardzo duże df2 jest typowe dla przybliżenia F tego testu i nie oznacza błędu. Dokumentacja IBM ostrzega, że test Boxa jest czuły na dużą liczebność i na odejścia od normalności. Radzi też obejrzeć testy Levene’a i wykres spread vs. level (IBM Corp., b.d.-c).
| Zmienna zależna | Levene Statistic | df1 | df2 | Sig. |
|---|---|---|---|---|
| adaptacja | .166 | 2 | 117 | .847 |
| przynaleznosc | .302 | 2 | 117 | .740 |
| samotnosc | 2.195 | 2 | 117 | .116 |
Żaden test Levene’a nie jest istotny. Gdyby test Boxa wyszedł istotny, nie przekreślaj od razu analizy. Sprawdź liczebności grup i testy Levene’a, a w pracy raportuj ślad Pillaia. Olson (1974) w symulacjach pokazał, że przy naruszonych założeniach jest on najodporniejszy, a największego pierwiastka Roya należy wtedy unikać.
Krok 2: tabela Multivariate Tests
Ta tabela odpowiada na pytanie główne: czy grupy różnią się łącznym profilem trzech skal. Dla każdego efektu SPSS podaje cztery statystyki: ślad Pillaia, lambdę Wilksa, ślad Hotellinga i największy pierwiastek Roya (IBM Corp., b.d.-a). Obok są F, stopnie swobody hipotezy i błędu, istotność i – po zaznaczeniu Estimates of effect size – η² cząstkowe (IBM Corp., b.d.-c). Pierwszy blok tabeli, Intercept, pomijasz.
| Effect | Value | F | Hypothesis df | Error df | Sig. | Partial Eta Squared | |
|---|---|---|---|---|---|---|---|
| grupa | Pillai’s Trace | .151 | 3.168 | 6.000 | 232.000 | .005 | .076 |
| Wilks’ Lambda | .853 | 3.167 | 6.000 | 230.000 | .005 | .076 | |
| Hotelling’s Trace | .167 | 3.166 | 6.000 | 228.000 | .005 | .077 | |
| Roy’s Largest Root | .122 | 4.727 | 3.000 | 116.000 | .004 | .109 |
Jak czytać kolumnę Value? Ślad Pillaia jest dodatni i rośnie wraz z efektem. Lambda Wilksa mieści się między 0 a 1 i maleje, gdy efekt rośnie. Ślad Hotellinga to suma wartości własnych, a pierwiastek Roya – największa z nich (IBM Corp., b.d.-c). Szczegóły opisuje hasło lambda Wilksa i ślad Pillaia.
Co raportować: jedną statystykę wybraną przed analizą, zwykle ślad Pillaia: V = 0.15, F(6, 232) = 3.17, p = .005, η²p = .08. Trzy pierwsze statystyki dają tu niemal to samo F. Roy ma inne stopnie swobody i mniejsze p, bo jego F jest górną granicą. Wybieranie statystyki „z najmniejszym p” to błąd. η² cząstkowe dla śladu Pillaia to V/s, gdzie s = min(liczba zmiennych zależnych, liczba grup − 1) = 2. Wartości dla pozostałych wierszy policzyliśmy wzorami podanymi w kodzie. Dokumentacja HTML nie opisuje wzorów SPSS, więc w pracy przepisz liczbę ze swojego wydruku. Jak interpretować tę miarę, wyjaśnia hasło eta kwadrat.
Krok 3: Tests of Between-Subjects Effects i korekta
Bez dodatkowych ustawień GLM Multivariate podaje obok testów wielowymiarowych testy jednowymiarowe dla każdego efektu (IBM Corp., b.d.-d). Trafiają one do tabeli Tests of Between-Subjects Effects, nazwanej tak samo jak w GLM Univariate (IBM Corp., b.d.-c). W wydruku wielowymiarowym kolejne wiersze to pary efekt × zmienna zależna (układ odtworzony z typowego wydruku). Poniżej tylko wiersze grupy i błędu. Wiersze Corrected Model, Intercept, Total i Corrected Total zwykle pomijasz.
| Source | Dependent Variable | Type III Sum of Squares | df | Mean Square | F | Sig. | Partial Eta Squared |
|---|---|---|---|---|---|---|---|
| grupa | adaptacja | 1.153 | 2 | .576 | 1.770 | .175 | .029 |
| przynaleznosc | 4.121 | 2 | 2.060 | 5.012 | .008 | .079 | |
| samotnosc | 3.751 | 2 | 1.876 | 5.143 | .007 | .081 | |
| Error | adaptacja | 38.092 | 117 | .326 | |||
| przynaleznosc | 48.099 | 117 | .411 | ||||
| samotnosc | 42.670 | 117 | .365 |
To trzy zwykłe ANOVA, po jednej na zmienną. Ich p nie są korygowane. Przy trzech zmiennych zastosuj korektę Holma: posortuj p rosnąco i pomnóż najmniejsze przez 3, drugie przez 2, trzecie przez 1, pilnując, żeby kolejne wartości nie malały. Wychodzi: samotność .0072 × 3 = .022, przynależność .0082 × 2 = .016, czyli również .022 (nie może być mniejsze od poprzedniego), adaptacja .175. Dokumentacja opisuje testy post hoc tylko w obrębie jednej zmiennej zależnej (IBM Corp., b.d.-a), więc korektę między zmiennymi policz ręcznie.
Po korekcie istotne są poczucie przynależności i samotność. Test Tukeya (tabela Multiple Comparisons) pokazuje, że różnice wynikają z mentoringu. Osoby z mentoringiem miały wyższe poczucie przynależności niż osoby bez programu: różnica 0.44, 95% CI [0.10, 0.78], p = .007. Miały też niższą samotność: −0.43, 95% CI [−0.75, −0.11], p = .006. Warsztaty nie różniły się istotnie od żadnej grupy (wszystkie p ≥ .085). Gdy wariancje są nierówne, zamiast Tukeya wybierz test Gamesa–Howella. Drugą drogą analiz następczych jest analiza dyskryminacyjna – omawia ją wpis o MANOVA w ogóle.
Dlaczego MANOVA nie „chroni” testów jednowymiarowych
Często spotykany przepis brzmi: „najpierw MANOVA; jeśli wyjdzie istotna, wolno robić ANOVA bez korekty”. Huberty i Morris (1989) kwestionują tę praktykę. Mechanizm pokazuje symulacja w R z rysunku 2. Trzy grupy po 40 osób i trzy skorelowane zmienne zależne sprawdziliśmy w 4000 powtórzeniach. Liczyliśmy, jak często choć jedna zmienna bez prawdziwej różnicy wyszła istotna.
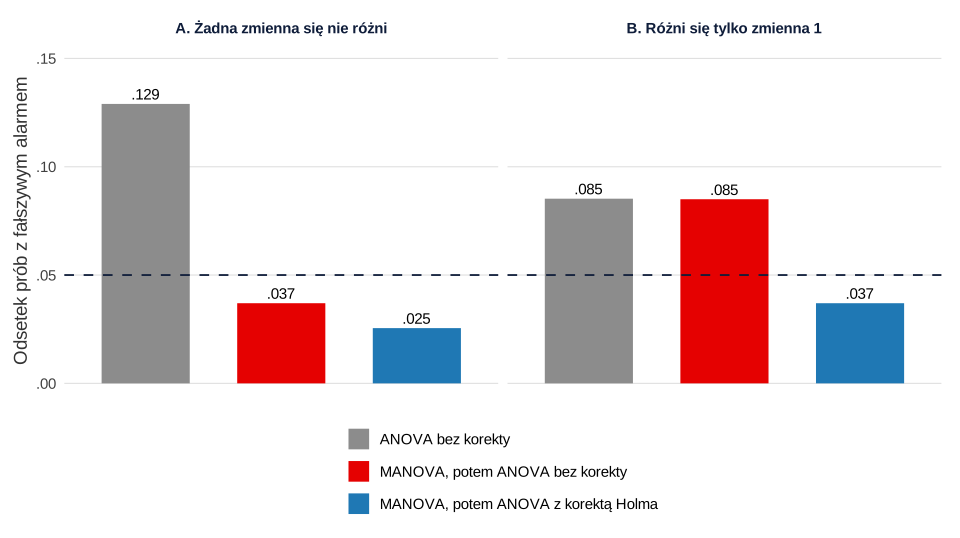
Gdy żadna zmienna się nie różni (scenariusz A), MANOVA rzeczywiście działa jak bramka: rzadko jest istotna, więc fałszywe alarmy w ANOVA zdarzają się w 3.7% prób. Ale gdy różni się jedna zmienna (scenariusz B), MANOVA jest istotna prawie zawsze (97.9% prób). Wtedy pozostałe dwie zmienne testujesz praktycznie bez ochrony: fałszywy alarm w 8.5% prób, tyle samo co bez MANOVA. Korekta Holma utrzymuje ten odsetek poniżej 5%. Wniosek: jeśli interpretujesz zmienne osobno, korekta jest potrzebna niezależnie od wyniku MANOVA.
Zapis wyników w stylu APA
Podaj sprawdzenie założeń, wybraną statystykę wielowymiarową z η² cząstkowym, testy jednowymiarowe z informacją o korekcie i porównania par. Wzór do dostosowania:
Średnie i odchylenia standardowe w grupach pokaż w tabeli. Zdania do innych analiz przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według wykresu składni GLM: Multivariate i podkomend PRINT oraz POSTHOC w Command Syntax Reference (IBM Corp., b.d.-d), ale nie uruchamialiśmy jej w SPSS. Przepis 2 w R tworzy pliki do pobrania i liczy liczby z tabel: test M Boxa z przybliżeniem F, testy Levene’a od średniej, cztery statystyki wielowymiarowe (funkcja manova() i summary(test = …)), ANOVA typu III, korektę Holma i test Tukeya. Przepis 3 to symulacja z rysunku 2; parametry ustawiono ręcznie.
1. Składnia SPSS: GLM z kilkoma zmiennymi zależnymi
SPSS
* Składnia zgodna z opisem GLM: Multivariate w Command Syntax Reference; nie była uruchamiana w SPSS.
GLM adaptacja przynaleznosc samotnosc BY grupa
  /METHOD=SSTYPE(3)
  /INTERCEPT=INCLUDE
  /POSTHOC=grupa(TUKEY GH)
  /PRINT=DESCRIPTIVE ETASQ HOMOGENEITY
  /CRITERIA=ALPHA(.05)
  /DESIGN=grupa.
2. Te same liczby w R i pliki .sav oraz CSV
R
# MANOVA w SPSS: liczby do tabel GLM Multivariate (dane symulowane)
# 120 studentów pierwszego roku: grupa 1 = bez programu, 2 = mentoring, 3 = warsztaty (po 40 osób).
# Zmienne zależne (średnie z pozycji, 1–5): adaptacja, przynależność, samotność.
suppressPackageStartupMessages({ library(haven); library(car); library(heplots) })
set.seed(537)
n <- 40
grupa <- rep(1:3, each = n)
R <- matrix(c(1, .50, -.40,
              .50, 1, -.50,
              -.40, -.50, 1), 3)                 # korelacje wewnątrzgrupowe
L <- chol(R * 0.6^2)                            # SD = 0.6 w każdej grupie
srednie <- rbind(c(3.10, 3.00, 2.90),            # bez programu
                 c(3.25, 3.40, 2.60),            # mentoring
                 c(3.35, 3.10, 2.85))            # warsztaty
Y <- srednie[grupa, ] + matrix(rnorm(3 * n * 3), ncol = 3) %*% L
Y[] <- round(pmin(5, pmax(1, Y)), 2)
dane <- data.frame(id = 1:(3 * n), grupa = grupa,
                   adaptacja = Y[, 1], przynaleznosc = Y[, 2], samotnosc = Y[, 3])

# Plik .sav z etykietami zmiennych i wartości oraz ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$grupa <- labelled(sav$grupa, labels = c("bez programu" = 1, "mentoring" = 2, "warsztaty" = 3),
                      label = "Program wsparcia")
sav$adaptacja <- labelled(sav$adaptacja, label = "Adaptacja do studiów (1–5)")
sav$przynaleznosc <- labelled(sav$przynaleznosc, label = "Poczucie przynależności (1–5)")
sav$samotnosc <- labelled(sav$samotnosc, label = "Samotność (1–5)")
write_sav(sav, "manova-spss-dane.sav")
write.csv(dane, "manova-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

d <- dane
d$gr <- factor(d$grupa, levels = 1:3, labels = c("bez programu", "mentoring", "warsztaty"))
dv <- c("adaptacja", "przynaleznosc", "samotnosc")
Ym <- as.matrix(d[, dv])

# 1. Descriptive Statistics: średnia, SD i N w grupach
for (v in dv) {
  cat("\n", v, "\n")
  print(data.frame(M = c(tapply(d[[v]], d$gr, mean), Total = mean(d[[v]])),
                   SD = c(tapply(d[[v]], d$gr, sd), Total = sd(d[[v]])),
                   N = c(table(d$gr), Total = nrow(d))), digits = 4)
}

# 2. Korelacje wewnątrzgrupowe (na resztach modelu)
m <- lm(Ym ~ gr, data = d, contrasts = list(gr = "contr.sum"))
cat("\nKorelacje reszt:\n"); print(round(cor(resid(m)), 2))

# 3. Box's Test of Equality of Covariance Matrices: M, przybliżenie F i chi-kwadrat
box_m <- function(Y, g) {
  p <- ncol(Y); k <- nlevels(g); ni <- as.vector(table(g)); N <- sum(ni)
  S <- lapply(split(as.data.frame(Y), g), cov)
  Sp <- Reduce(`+`, Map(function(s, n) (n - 1) * s, S, ni)) / (N - k)
  M <- (N - k) * log(det(Sp)) - sum((ni - 1) * sapply(S, function(s) log(det(s))))
  c1 <- (sum(1 / (ni - 1)) - 1 / (N - k)) * (2 * p^2 + 3 * p - 1) / (6 * (p + 1) * (k - 1))
  c2 <- (sum(1 / (ni - 1)^2) - 1 / (N - k)^2) * (p - 1) * (p + 2) / (6 * (k - 1))
  df1 <- (k - 1) * p * (p + 1) / 2
  df2 <- (df1 + 2) / (c2 - c1^2)
  F <- M / (df1 / (1 - c1 - df1 / df2))
  c(M = M, F = F, df1 = df1, df2 = df2, Sig = pf(F, df1, df2, lower.tail = FALSE))
}
cat("\nBox's M:\n"); print(round(box_m(Ym, d$gr), 4))
print(boxM(Ym, d$gr))                             # kontrolnie: wersja chi-kwadrat

# 4. Levene's Test of Equality of Error Variances (od średniej) dla każdej zmiennej
for (v in dv) { cat("\nLevene:", v, "\n"); print(leveneTest(d[[v]] ~ d$gr, center = mean)) }

# 5. Multivariate Tests: cztery statystyki dla efektu grupa i η² cząstkowe
p <- length(dv); q <- nlevels(d$gr) - 1; s <- min(p, q)
eta_wielow <- c(Pillai = function(x) x / s, Wilks = function(x) 1 - x^(1 / s),
                "Hotelling-Lawley" = function(x) (x / s) / (x / s + 1), Roy = function(x) x / (1 + x))
mv <- manova(Ym ~ gr, data = d)
for (t in names(eta_wielow)) {
  st <- summary(mv, test = t)$stats["gr", ]
  cat(sprintf("%-17s Value = %.3f  F = %.3f  df = %g, %g  Sig = %.4f  eta2p = %.3f\n",
              t, st[2], st[3], st[4], st[5], st[6], eta_wielow[[t]](st[2])))
}

# 6. Tests of Between-Subjects Effects: osobna ANOVA (typ III) dla każdej zmiennej zależnej
for (v in dv) {
  a <- Anova(lm(d[[v]] ~ gr, data = d, contrasts = list(gr = "contr.sum")), type = 3)
  SSg <- a["gr", "Sum Sq"]; SSe <- a["Residuals", "Sum Sq"]
  cat(sprintf("%-14s grupa: SS = %.3f  df = 2  MS = %.3f  F = %.3f  Sig = %.4f  eta2p = %.3f | Error: SS = %.3f df = %d MS = %.3f\n",
              v, SSg, SSg / 2, a["gr", "F value"], a["gr", "Pr(>F)"], SSg / (SSg + SSe), SSe,
              a["Residuals", "Df"], SSe / a["Residuals", "Df"]))
}

# 7. Korekta Holma dla trzech testów jednowymiarowych (liczona poza SPSS)
p_jedn <- sapply(dv, function(v) anova(lm(d[[v]] ~ gr, data = d))[1, "Pr(>F)"])
print(round(cbind(p = p_jedn, p_Holm = p.adjust(p_jedn, "holm")), 4))

# 8. Post hoc Tukey HSD (równe liczebności) dla zmiennych istotnych po korekcie
for (v in dv[p.adjust(p_jedn, "holm") < .05]) { cat("\nTukey:", v, "\n"); print(TukeyHSD(aov(d[[v]] ~ gr, data = d)), digits = 3) }
Wynik:
 adaptacja
                 M     SD   N
bez programu 3.095 0.5495  40
mentoring    3.237 0.6028  40
warsztaty    3.333 0.5581  40
Total        3.222 0.5743 120

 przynaleznosc
                 M     SD   N
bez programu 2.972 0.6657  40
mentoring    3.414 0.6058  40
warsztaty    3.107 0.6505  40
Total        3.164 0.6624 120

 samotnosc
                 M     SD   N
bez programu 2.987 0.6367  40
mentoring    2.560 0.4827  40
warsztaty    2.712 0.6750  40
Total        2.753 0.6246 120

Korelacje reszt:
              adaptacja przynaleznosc samotnosc
adaptacja          1.00          0.53     -0.44
przynaleznosc      0.53          1.00     -0.55
samotnosc         -0.44         -0.55      1.00

Box's M:
         M          F        df1        df2        Sig
   10.2590     0.8231    12.0000 66339.0000     0.6267

 Box's M-test for Homogeneity of Covariance Matrices

data:  Ym by d$gr
Chi-Sq (approx.) = 9.879, df = 12, p-value = 0.6266


Levene: adaptacja
Levene's Test for Homogeneity of Variance (center = mean)
       Df F value Pr(>F)
group   2  0.1662 0.8471
      117

Levene: przynaleznosc
Levene's Test for Homogeneity of Variance (center = mean)
       Df F value Pr(>F)
group   2  0.3023 0.7397
      117

Levene: samotnosc
Levene's Test for Homogeneity of Variance (center = mean)
       Df F value Pr(>F)
group   2  2.1951 0.1159
      117
Pillai            Value = 0.151  F = 3.168  df = 6, 232  Sig = 0.0053  eta2p = 0.076
Wilks             Value = 0.853  F = 3.167  df = 6, 230  Sig = 0.0053  eta2p = 0.076
Hotelling-Lawley  Value = 0.167  F = 3.166  df = 6, 228  Sig = 0.0053  eta2p = 0.077
Roy               Value = 0.122  F = 4.727  df = 3, 116  Sig = 0.0038  eta2p = 0.109
adaptacja      grupa: SS = 1.153  df = 2  MS = 0.576  F = 1.770  Sig = 0.1748  eta2p = 0.029 | Error: SS = 38.092 df = 117 MS = 0.326
przynaleznosc  grupa: SS = 4.121  df = 2  MS = 2.060  F = 5.012  Sig = 0.0082  eta2p = 0.079 | Error: SS = 48.099 df = 117 MS = 0.411
samotnosc      grupa: SS = 3.751  df = 2  MS = 1.876  F = 5.143  Sig = 0.0072  eta2p = 0.081 | Error: SS = 42.670 df = 117 MS = 0.365
                   p p_Holm
adaptacja     0.1748 0.1748
przynaleznosc 0.0082 0.0217
samotnosc     0.0072 0.0217

Tukey: przynaleznosc
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = d[[v]] ~ gr, data = d)

$gr
                         diff    lwr    upr p adj
mentoring-bez programu  0.443  0.102 0.7831 0.007
warsztaty-bez programu  0.135 -0.206 0.4751 0.616
warsztaty-mentoring    -0.308 -0.648 0.0323 0.085


Tukey: samotnosc
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = d[[v]] ~ gr, data = d)

$gr
                         diff    lwr     upr p adj
mentoring-bez programu -0.427 -0.748 -0.1067 0.006
warsztaty-bez programu -0.275 -0.596  0.0456 0.108
warsztaty-mentoring     0.152 -0.168  0.4728 0.499
3. Symulacja: czy MANOVA chroni testy jednowymiarowe
R
# Czy istotna MANOVA „chroni” testy jednowymiarowe? Symulacja (parametry ustawione ręcznie)
# 3 grupy po 40 osób, 3 zmienne zależne skorelowane r = .50, SD = 1.
# Scenariusz A: brak różnic w żadnej zmiennej (pełna hipoteza zerowa).
# Scenariusz B: różnica tylko w zmiennej 1 (średnie 0, 0.8, 0.8); zmienne 2 i 3 bez różnic.
# Błąd I rodzaju = co najmniej jedna z „pustych” zmiennych wychodzi istotna (p < .05).
set.seed(5370)
n <- 40; g <- factor(rep(1:3, each = n)); L <- chol(matrix(.5, 3, 3) + diag(.5, 3))
jedna_proba <- function(efekt) {
  Y <- matrix(rnorm(3 * n * 3), ncol = 3) %*% L
  Y[, 1] <- Y[, 1] + c(0, efekt, efekt)[g]
  p_manova <- summary(manova(Y ~ g), test = "Pillai")$stats["g", "Pr(>F)"]
  p_jedn <- apply(Y, 2, function(y) anova(lm(y ~ g))[1, "Pr(>F)"])
  puste <- if (efekt == 0) 1:3 else 2:3
  c(bez_bramki = any(p_jedn[puste] < .05),
    bramka_manova = p_manova < .05 && any(p_jedn[puste] < .05),
    bramka_holm = p_manova < .05 && any(p.adjust(p_jedn, "holm")[puste] < .05),
    holm_bez_manova = any(p.adjust(p_jedn, "holm")[puste] < .05),
    manova_istotna = p_manova < .05)
}
R <- 4000
wyniki <- rbind(A_pelna_H0 = rowMeans(replicate(R, jedna_proba(0))),
                B_efekt_w_zmiennej_1 = rowMeans(replicate(R, jedna_proba(0.8))))
print(round(wyniki, 3))
Wynik:
                     bez_bramki bramka_manova bramka_holm holm_bez_manova manova_istotna
A_pelna_H0                0.129         0.037       0.025           0.044          0.049
B_efekt_w_zmiennej_1      0.085         0.085       0.037           0.037          0.979
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- heplots (wersja 1.8.1): Friendly, M., Fox, J., & Monette, G. (2025). heplots: Visualizing tests in multivariate linear models [R package]. https://CRAN.R-project.org/package=heplots
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy i lista kontrolna
- MANOVA, bo „mam kilka zmiennych zależnych”, choć każda ma osobną hipotezę (Huang, 2020).
- Istotna MANOVA jako przepustka do ANOVA bez korekty.
- Raportowanie statystyki, która dała najmniejsze p, zwykle pierwiastka Roya.
- Pomylenie kierunku lambdy Wilksa: mała Λ oznacza duży efekt.
- Wynik ogólny skali razem z jej podskalami w jednej MANOVA – suma jest kombinacją podskal, a macierz kowariancji może być osobliwa.
- Odrzucenie analizy z powodu istotnego testu Boxa bez sprawdzenia liczebności grup i testów Levene’a.
- „Sig. = .000” przepisane dosłownie. Pisz p < .001.
Lista kontrolna przed oddaniem rozdziału: (1) pytanie dotyczy profilu zmiennych, a nie każdej osobno; (2) statystyka wielowymiarowa wybrana przed analizą i nazwana w tekście; (3) test Boxa i testy Levene’a opisane jednym zdaniem; (4) η² cząstkowe przy teście wielowymiarowym; (5) testy jednowymiarowe z korektą i jej nazwą; (6) porównania par z przedziałami ufności; (7) średnie i SD w tabeli; (8) wersja SPSS w Metodzie.
Gdy te same osoby mierzono kilka razy, potrzebujesz innej procedury – zob. model mieszany w SPSS. Braki danych przed analizą opisuje wpis braki danych i wielokrotna imputacja w SPSS.
Najczęstsze pytania
Gdzie w SPSS jest MANOVA, skoro w menu nie ma takiej nazwy?
MANOVA uruchamiasz przez Analyze → General Linear Model → Multivariate (w polskiej dokumentacji: Analizuj → Ogólny model liniowy → Wielowymiarowy). Procedura wymaga co najmniej dwóch zmiennych zależnych. Dokumentacja IBM podaje, że wymaga wydania Standard Edition albo opcji Advanced Statistics, więc w niektórych instalacjach jej nie znajdziesz.
Którą statystykę z tabeli Multivariate Tests podać w pracy?
Jedną, wybraną przed analizą – zwykle ślad Pillaia (Pillai’s Trace), bo w badaniach symulacyjnych okazał się najodporniejszy na naruszenia założeń (Olson, 1974). Przepisz wartość V, F, df hipotezy, df błędu, p i η² cząstkowe, np. V = 0.15, F(6, 232) = 3.17, p = .005, η²p = .08. Nie wybieraj statystyki, która „wyszła najlepiej”.
Co zrobić, gdy test M Boxa w SPSS jest istotny?
Sprawdź testy Levene’a dla każdej zmiennej zależnej i liczebności grup. Test Boxa jest czuły na duże próby i na brak normalności (IBM Corp., b.d.-c), więc istotny wynik nie musi przekreślać analizy, zwłaszcza przy równych grupach. Raportuj wtedy ślad Pillaia, a przy dużej różnicy liczebności i wyraźnie różnych wariancjach rozważ osobne ANOVA Welcha z korektą.
Czy po istotnej MANOVA w SPSS trzeba korygować testy jednowymiarowe?
Tak, jeśli wnioskujesz o każdej zmiennej osobno. Istotna MANOVA nie chroni przed fałszywymi alarmami w zmiennych, w których różnic nie ma, gdy różni się choć jedna inna (Huberty i Morris, 1989). SPSS liczy testy post hoc osobno dla każdej zmiennej zależnej, więc korektę między zmiennymi, np. Holma, policz ręcznie.
Dlaczego w SPSS Pillai, Wilks i Hotelling dają prawie to samo F?
Wszystkie trzy opierają się na tych samych wartościach własnych macierzy hipotezy względem macierzy błędu. Dokumentacja IBM zauważa, że przy małych wartościach własnych ślad Hotellinga i ślad Pillaia są prawie równe (IBM Corp., b.d.-c). Przy dwóch grupach jest tylko jedna wartość własna i cztery testy dają to samo F. Największy pierwiastek Roya ma inne stopnie swobody, a jego F jest górną granicą, więc p bywa zaniżone.
Powiązane hasła
Przeczytaj też
Analiza dyskryminacyjna w SPSS krok po kroku
Discriminant od pliku .sav po opis APA: test M Boxa, Eigenvalues, lambda Wilksa, macierz struktury, centroidy, a priori i trafność z walidacji krzyżowej.
Czytaj →PoradnikMANOVA krok po kroku
Założenia, odległość Mahalanobisa i test M Boxa, ślad Pillaia z η²p, analizy następcze z korektą Holma i opis APA – na danych do pobrania z kodem R.
Czytaj →PoradnikANOVA w SPSS krok po kroku
One-Way ANOVA w SPSS od przygotowania pliku po opis APA: opcje Welch i Brown-Forsythe, Tukey a Games–Howell, η² ręcznie i składnia ONEWAY – z plikiem .sav do pobrania.
Czytaj →PoradnikPoprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →Masz kilka zmiennych zależnych i wydruk MANOVA z SPSS?
Sprawdzimy, czy MANOVA odpowiada na Twoje pytanie, wybierzemy statystykę i korektę testów jednowymiarowych oraz opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Huang, F. L. (2020). MANOVA: A procedure whose time has passed? Gifted Child Quarterly, 64(1), 56–60. https://doi.org/10.1177/0016986219887200
- Huberty, C. J., & Morris, J. D. (1989). Multivariate analysis versus multiple univariate analyses. Psychological Bulletin, 105(2), 302–308. https://doi.org/10.1037/0033-2909.105.2.302
- IBM Corp. (b.d.-a). GLM Multivariate Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_glm_multivariate.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). GLM Multivariate Options. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_glmm_opt.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). Multivariate Analysis of Variance (MANOVA) Using the GLM Multivariate Procedure. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/glmm_patlos_intro_01.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). GLM: Multivariate (Command Syntax Reference). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_glm_multivariate.html ● Otwarty dostęp
- Olson, C. L. (1974). Comparative robustness of six tests in multivariate analysis of variance. Journal of the American Statistical Association, 69(348), 894–908. https://doi.org/10.1080/01621459.1974.10480224
Cytowania BibTeX
@article{huang2020manova, author={Huang, Francis L.}, title={{MANOVA: A procedure whose time has passed?}}, journal={Gifted Child Quarterly}, year={2020}, volume={64}, number={1}, pages={56--60}, doi={10.1177/0016986219887200}}@article{huberty1989multivariate, author={Huberty, Carl J. and Morris, John D.}, title={{Multivariate analysis versus multiple univariate analyses}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={2}, pages={302--308}, doi={10.1037/0033-2909.105.2.302}}@misc{ibmnd31glmmultivariate, author={{IBM Corp.}}, title={{GLM Multivariate Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_glm_multivariate.html}}@misc{ibmnd31glmmultivariateopcje, author={{IBM Corp.}}, title={{GLM Multivariate Options}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/advanced/idh_glmm_opt.html}}@misc{ibmnd31glmmultivariatestudium, author={{IBM Corp.}}, title={{Multivariate Analysis of Variance (MANOVA) Using the GLM Multivariate Procedure}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/glmm_patlos_intro_01.html}}@misc{ibmnd31glmmultivariateskladnia, author={{IBM Corp.}}, title={{GLM: Multivariate (Command Syntax Reference)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_glm_multivariate.html}}@article{olson1974comparative, author={Olson, Chester L.}, title={{Comparative robustness of six tests in multivariate analysis of variance}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={348}, pages={894--908}, doi={10.1080/01621459.1974.10480224}}