Co to są lambda Wilksa i ślad Pillaia?
To dwie z czterech statystyk testowych MANOVA (zestawienie wszystkich podaje hasło o MANOVA). Obie porównują macierz międzygrupową H z wewnątrzgrupową E:
- Lambda Wilksa: Λ = det(E) / det(E + H) – iloraz wariancji uogólnionych, czyli część zmienności niewyjaśniona przez grupy (0–1; im mniejsza, tym silniejszy efekt). To statystyka ilorazu wiarygodności.
- Ślad Pillaia: V = tr[H(H + E)−1] – suma udziałów wyjaśnionej zmienności na kolejnych wymiarach różnic, od 0 do s (mniejsza z liczb: zmiennych zależnych lub grup minus 1).
Wielowymiarowe η²p to 1 − Λ1/s dla Wilksa i V/s dla Pillaia – wartości zbliżone, lecz nie identyczne. Przy dwóch grupach obie dają ten sam test co T² Hotellinga.
Przykład
Dla 90 osób w trzech grupach i trzech zmiennych zależnych (dane symulowane) rachunek ręczny daje Λ = .751 i V = 0.253 – jak summary.manova(). Λ: F(6, 170) = 4.36, p < .001, η²p = .13; V: F(6, 172) = 4.15, p < .001, η²p = .13.
Kiedy ślad Pillaia jest odporniejszy
Olson (1974) w symulacjach pokazał, że przy nienormalności i różnych macierzach kowariancji ślad Pillaia jest najodporniejszy, a testu największego pierwiastka Roya należy unikać. Przewaga nad lambdą Wilksa bywa jednak niewielka. W symulacji (2000 powtórzeń, brak różnic średnich, grupa A ma dwa razy większe SD) przy grupach 30/30/30 odsetek fałszywych odrzuceń to 6.3% dla Pillaia i 6.4% dla Wilksa. Przy 10/30/50 (mniejsza grupa bardziej rozproszona) – 29.7% i 30.1%, a przy 50/30/10 – po 0.4%. Podobnie wypadły symulacje, które opisali Anderson i Walsh (2013): ślad Pillaia jest mało wrażliwy na różne rozproszenie tylko w układach zrównoważonych.
Na rysunku
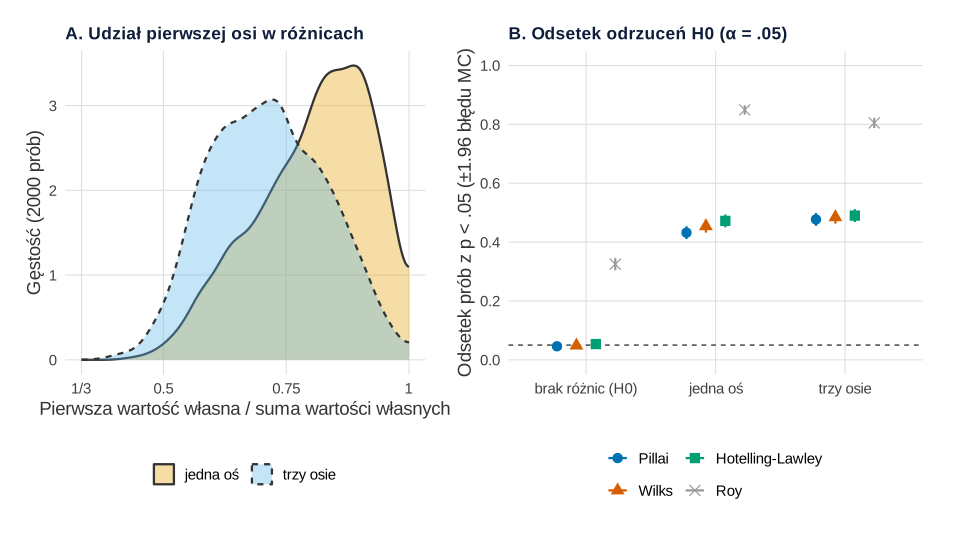
set.seed(652)).Co widać. Cztery grupy po 15 osób, trzy zmienne zależne. W obu układach z różnicami suma kwadratów odchyleń średnich grup jest ta sama (0.6), zmienia się tylko jej kierunek: średnie leżą na jednej prostej albo w wierzchołkach czworościanu. Panel A pokazuje, że układ widać w wartościach własnych: przy jednej osi pierwsza z nich niesie zwykle większość różnic (mediana udziału 0.82), przy trzech mniej (0.71). Panel B: lambda Wilksa i ślad Pillaia dają niemal to samo. Przy jednej osi Pillai odrzuca H0 w 43.2% prób, Wilks w 45.4%, Hotelling–Lawley w 47.2%. Przy trzech osiach różnice prawie znikają (47.7%, 48.4%, 49.0%). Największy błąd Monte Carlo odsetka to 1.1 punktu procentowego.
Na co uważać. Wysokie odsetki Roya to nie moc: bez żadnych różnic odrzuca H0 w 32.5% prób, bo F Roya w R jest górnym ograniczeniem. Przewaga mocy Hotellinga–Lawleya przy jednej osi częściowo wynika z nieco wyższego odsetka fałszywych odrzuceń (5.4% wobec 4.6% dla Pillaia). Symulacja dotyczy rozkładów normalnych i równych macierzy kowariancji; przy ich naruszeniu ważniejsza jest odporność opisana wyżej. Moc testów na wykresach ogólnie omawia wpis Moc testu w obrazkach.
Podpis do pracy:
Liczebności, liczbę zmiennych, średnie grup i sumę kwadratów 0.6 ustawiono ręcznie, tak by moc była pośrednia. Ziarno set.seed(652) ustalono raz i nie zmieniano; każdy układ zaczyna od tego samego ziarna. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu; symulacja trwa kilka sekund.
Kod R rysunku 1
# Rysunek 1. Te same różnice średnich skupione na jednej osi albo rozłożone na trzy osie:
# udział pierwszej osi w sumie wartości własnych (A) i odsetek odrzuceń H0 dla czterech statystyk (B)
library(ggplot2)
library(patchwork)

kol <- c(Pillai = "#0072B2", Wilks = "#D55E00", `Hotelling-Lawley` = "#009E73", Roy = "#999999")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# 4 grupy po 15 osób, 3 niezależne zmienne zależne (SD = 1). Średnie grup ustawione ręcznie tak,
# by suma kwadratów odchyleń średnich od środka była w obu układach równa 0.6:
# „jedna oś” – średnie na jednej prostej; „trzy osie” – wierzchołki czworościanu foremnego
n <- 15; g <- factor(rep(c("A", "B", "C", "D"), each = n))
uklady <- list(
  `brak różnic (H0)` = matrix(0, 4, 3),
  `jedna oś` = cbind(c(-3, -1, 1, 3) * sqrt(0.6 / 20), 0, 0),
  `trzy osie` = rbind(c(1, 1, 1), c(1, -1, -1), c(-1, 1, -1), c(-1, -1, 1)) * sqrt(0.6 / 12))
sapply(uklady, function(M) sum(scale(M, scale = FALSE)^2))   # kontrola: 0, 0.6, 0.6

testy <- c("Pillai", "Wilks", "Hotelling-Lawley", "Roy")
R <- 2000
wyniki <- lapply(names(uklady), function(u) {
  set.seed(652)                                            # to samo ziarno w każdym układzie
  w <- replicate(R, {
    Y <- matrix(rnorm(4 * n * 3), ncol = 3) + uklady[[u]][as.integer(g), ]
    fit <- manova(Y ~ g)
    p <- sapply(testy, function(t) summary(fit, test = t)$stats[1, 6])
    ev <- summary(fit)$Eigenvalues[1, ]
    c(p < .05, udzial = ev[1] / sum(ev))
  })
  list(odrzucenia = rowMeans(w[testy, ]), udzial = w["udzial", ])
})
names(wyniki) <- names(uklady)

tabB <- do.call(rbind, lapply(names(uklady), function(u) data.frame(
  uklad = u, statystyka = testy, odsetek = wyniki[[u]]$odrzucenia)))
tabB$se_mc <- sqrt(tabB$odsetek * (1 - tabB$odsetek) / R)   # błąd Monte Carlo odsetka
tabB$uklad <- factor(tabB$uklad, levels = names(uklady))
tabB$statystyka <- factor(tabB$statystyka, levels = testy)
print(round(xtabs(odsetek ~ uklad + statystyka, tabB), 3))
cat("Największy błąd MC odsetka:", round(max(tabB$se_mc), 3), "\n")
tabA <- do.call(rbind, lapply(names(uklady)[2:3], function(u) data.frame(uklad = u, udzial = wyniki[[u]]$udzial)))
print(round(tapply(tabA$udzial, tabA$uklad, median), 2))

pA <- ggplot(tabA, aes(udzial, fill = uklad, linetype = uklad)) +
  geom_density(alpha = 0.35, colour = "grey20", linewidth = 0.8, bounds = c(1 / 3, 1), n = 128) +
  scale_fill_manual(values = c(`jedna oś` = "#E69F00", `trzy osie` = "#56B4E9"), name = NULL) +
  scale_linetype_manual(values = c(`jedna oś` = "solid", `trzy osie` = "22"), name = NULL) +
  scale_x_continuous(limits = c(1 / 3, 1), breaks = c(1 / 3, 0.5, 0.75, 1), labels = c("1/3", "0.5", "0.75", "1")) +
  labs(title = "A. Udział pierwszej osi w różnicach", x = "Pierwsza wartość własna / suma wartości własnych",
       y = "Gęstość (2000 prób)") + motyw

pB <- ggplot(tabB, aes(uklad, odsetek, colour = statystyka, shape = statystyka)) +
  geom_hline(yintercept = 0.05, linetype = "22", colour = "grey40") +
  geom_errorbar(aes(ymin = odsetek - 1.96 * se_mc, ymax = odsetek + 1.96 * se_mc),
                width = 0, linewidth = 0.8, position = position_dodge(width = 0.6)) +
  geom_point(size = 3.2, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17, 15, 4), name = NULL) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  labs(title = "B. Odsetek odrzuceń H0 (α = .05)", x = NULL, y = "Odsetek prób z p < .05 (±1.96 błędu MC)") +
  motyw + guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
p1 <- pA + pB + plot_layout(widths = c(1, 1.15))
p1
Wynik w R
brak różnic (H0)         jedna oś        trzy osie
             0.0              0.6              0.6
                  statystyka
uklad              Pillai Wilks Hotelling-Lawley   Roy
  brak różnic (H0)  0.046 0.048            0.054 0.325
  jedna oś          0.432 0.454            0.472 0.849
  trzy osie         0.477 0.484            0.490 0.805
Największy błąd MC odsetka: 0.011
 jedna oś trzy osie
     0.82      0.71
Jak opisać w pracy
Na co uważać
- Pillai nie naprawia złego układu. Przy nierównych grupach i istotnym teście M Boxa sprawdź, która grupa ma większy rozrzut.
- Roy w R jest liberalny. Według dokumentacji
summary.manovaF dla Roya to górne ograniczenie; w symulacji test odrzucał prawdziwą H0 w 19.4% prób nawet przy równych grupach. - Wybierz statystykę przed analizą (zob. MANOVA krok po kroku). Przy silnej skośności rozważ PERMANOVA.
Lambda Wilksa i ślad Pillaia w R
Kod liczy Λ i V ręcznie z macierzy E i H, porównuje je z summary.manova(), a potem w symulacji sprawdza odsetek fałszywych odrzuceń czterech statystyk przy różnym rozproszeniu grup. Liczby w tekście pochodzą z tego kodu; symulacja trwa kilkanaście sekund.
Wyznacznik, ślad i odporność przy nierównych grupach
R
library(MASS)                                      # mvrnorm()
set.seed(652)
S <- matrix(.3, 3, 3); diag(S) <- 1                # 3 zmienne zależne, korelacja .30
g <- factor(rep(c("A", "B", "C"), each = 30))
M <- rbind(A = c(0, 0, 0), B = c(.6, 0, 0), C = c(0, .6, 0))
Y <- mvrnorm(90, rep(0, 3), S) + M[as.integer(g), ]   # dane symulowane
fit <- manova(Y ~ g)
E <- crossprod(resid(fit))                         # macierz wewnątrzgrupowa (błędu)
H <- crossprod(scale(Y, scale = FALSE)) - E        # macierz międzygrupowa (hipotezy)
s <- min(ncol(Y), nlevels(g) - 1)
L <- det(E) / det(E + H)                           # lambda Wilksa
V <- sum(diag(H %*% solve(H + E)))                 # ślad Pillaia
round(c(Wilks = L, Pillai = V, eta2p_Wilks = 1 - L^(1 / s), eta2p_Pillai = V / s), 4)
round(summary(fit, test = "Wilks")$stats[1, ], 4)
round(summary(fit, test = "Pillai")$stats[1, ], 4)
# Odporność: H0 prawdziwa, grupa A ma 2 razy większe SD; 2000 powtórzeń na układ
testy <- c("Pillai", "Wilks", "Hotelling-Lawley", "Roy")
odsetek <- function(n) {
  gs <- factor(rep(c("A", "B", "C"), n)); set.seed(6520)
  rowMeans(replicate(2000, {
    Y0 <- mvrnorm(sum(n), rep(0, 3), S) * ifelse(gs == "A", 2, 1)
    sapply(testy, function(t) summary(manova(Y0 ~ gs), test = t)$stats[1, 6]) < .05 })) }
round(rbind(`30/30/30` = odsetek(c(30, 30, 30)),
            `10/30/50` = odsetek(c(10, 30, 50)),          # mniejsza grupa bardziej rozproszona
            `50/30/10` = odsetek(c(50, 30, 10))), 3)      # większa grupa bardziej rozproszona
Wynik w R
       Wilks       Pillai  eta2p_Wilks eta2p_Pillai
      0.7509       0.2529       0.1335       0.1265
      Df    Wilks approx F   num Df   den Df   Pr(>F)
  2.0000   0.7509   4.3639   6.0000 170.0000   0.0004
      Df   Pillai approx F   num Df   den Df   Pr(>F)
  2.0000   0.2529   4.1497   6.0000 172.0000   0.0006
         Pillai Wilks Hotelling-Lawley   Roy
30/30/30  0.063 0.064            0.068 0.194
10/30/50  0.297 0.301            0.306 0.489
50/30/10  0.004 0.004            0.004 0.036
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem MASS 7.3-65 (funkcja mvrnorm()); MANOVA – funkcja manova() z pakietu stats. Rysunek – pakiety ggplot2 4.0.2 i patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego lambda Wilksa maleje, gdy różnice między grupami rosną?
Lambda Wilksa to część łącznej zmienności, której nie wyjaśniają grupy: wyznacznik macierzy wewnątrzgrupowej dzielony przez wyznacznik macierzy całkowitej. Im większe różnice centroidów, tym większa macierz międzygrupowa i tym mniejszy iloraz. Ślad Pillaia działa odwrotnie – rośnie razem z efektem.
Co zrobić, gdy ślad Pillaia i lambda Wilksa dają różne wnioski?
Raportuj statystykę wybraną przed analizą, zwykle ślad Pillaia, i nie zmieniaj jej po fakcie. Rozbieżność zdarza się głównie przy wynikach bliskich progu istotności i przy kilku wymiarach różnic; warto wtedy sprawdzić wartości własne i opisać wymiary różnic analizą dyskryminacyjną.
Czy ślad Pillaia chroni przed niejednorodnością kowariancji przy nierównych grupach?
Tylko częściowo. W symulacjach ślad Pillaia w przybliżeniu trzyma poziom błędu I rodzaju przy równych grupach, ale gdy mniejsza grupa ma większy rozrzut, odrzuca prawdziwą hipotezę zerową znacznie częściej niż w 5% prób, a gdy rozrzut ma większa grupa – staje się zbyt konserwatywny. Lepiej planować zbliżone liczebności grup.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, M. J., & Walsh, D. C. I. (2013). PERMANOVA, ANOSIM, and the Mantel test in the face of heterogeneous dispersions: What null hypothesis are you testing? Ecological Monographs, 83(4), 557–574. https://doi.org/10.1890/12-2010.1
- Olson, C. L. (1974). Comparative robustness of six tests in multivariate analysis of variance. Journal of the American Statistical Association, 69(348), 894–908. https://doi.org/10.1080/01621459.1974.10480224
Cytowania BibTeX
@article{anderson2013permanova, author={Anderson, Marti J. and Walsh, Daniel C. I.}, title={{PERMANOVA, ANOSIM, and the Mantel test in the face of heterogeneous dispersions: What null hypothesis are you testing?}}, journal={Ecological Monographs}, year={2013}, volume={83}, number={4}, pages={557--574}, doi={10.1890/12-2010.1}}@article{olson1974comparative, author={Olson, Chester L.}, title={{Comparative robustness of six tests in multivariate analysis of variance}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={348}, pages={894--908}, doi={10.1080/01621459.1974.10480224}}