Kim był Jan Czekanowski?
Jan Czekanowski (1882–1965) to polski antropolog i statystyk, przez lata kierujący lwowską szkołą antropologiczną. Jego najtrwalszy wkład w statystykę to diagram Czekanowskiego – porządkowanie macierzy odległości tak, by podobne obiekty leżały obok siebie. Wszystkie dane biograficzne poniżej podajemy za Fernández-Lizaną (2026).
Urodził się 8 października 1882 r. w Głuchowie. Od 1902 r. studiował w Zurychu – antropologię u Rudolfa Martina, a także anatomię i matematykę. Od 1906 r. pracował w Museum für Völkerkunde w Berlinie i w latach 1907–1909 uczestniczył w wyprawie do Afryki Środkowej prowadzonej przez księcia Adolfa Fryderyka meklemburskiego. W latach 1910–1913 pracował w muzeum antropologii i etnografii w Petersburgu, potem w Katedrze Antropologii i Etnologii Uniwersytetu Jana Kazimierza we Lwowie, której był rektorem w latach 1934–1936. Po wkroczeniu Niemców do Lwowa w 1941 r. stracił stanowisko. Po wojnie uczył w Katolickim Uniwersytecie Lubelskim (1944–1949), a od 1946 r. był profesorem antropologii w Poznaniu, do emerytury w 1960 r. Zmarł 20 lipca 1965 r. w Szczecinie.
Najważniejsze pomysły
- „Przeciętna różnica” (1909). W pracy o diagnostyce różnicowej grupy neandertalskiej, opartej na pomiarach czaszek, Czekanowski zaproponował miarę odległości między dwoma obiektami: średnią z bezwzględnych różnic na wszystkich cechach (niem. durchschnittliche Differenz). To odległość miejska (manhattańska) podzielona przez liczbę cech, a nie odległość Mahalanobisa czy euklidesowa.
- Diagram (1909). W tej samej pracy pokazał trzy kroki: policz odległości między wszystkimi parami, przestaw wiersze i kolumny macierzy tak, by małe odległości znalazły się obok siebie, i wstaw w każde pole symbol – im ciemniejszy, tym obiekty bardziej podobne. Skupienia widać jako ciemne bloki przy przekątnej, a ich liczby nie trzeba ustalać z góry. Fernández-Lizana (2026) przytacza opinię, że to pierwsze użycie porządkowania macierzy, czyli zapowiedź dzisiejszej analizy skupień i map cieplnych z kolejnością z grupowania.
- Podręcznik (1913). Zarys metod statystycznych w zastosowaniu do antropologii, wydany przez Towarzystwo Naukowe Warszawskie, Fernández-Lizana (2026) opisuje jako pierwszą polską książkę o nowoczesnych metodach statystycznych: od statystyk opisowych przez współczynnik korelacji i regresję wieloraką po własne metody autora.
- Wskaźnik podobieństwa. Nazwisko Czekanowskiego nosi też wskaźnik podobieństwa dwóch profili liczebności, używany w ekologii. Yoshioka (2008) zwrócił uwagę, że część programów nazywa go indeksem Braya–Curtisa, choć trafniej przypisać go Czekanowskiemu, a oba wskaźniki mogą dać wyraźnie różne wyniki.
Czekanowski był bliski poglądom Karla Pearsona: statystyka miała służyć badaniom empirycznym, a nie stawać się czystą matematyką.
Przykład: diagram Czekanowskiego w R
Nie korzystamy z danych samego Czekanowskiego. Bierzemy wbudowany w R zbiór mtcars: według pliku pomocy to dane z amerykańskiego magazynu Motor Trend z 1974 r. – zużycie paliwa i 10 cech konstrukcji i osiągów 32 samochodów z modeli 1973–1974. Wszystkie 11 zmiennych zestandaryzowano, a odległość policzono jak u Czekanowskiego – jako średnią bezwzględną różnicę wyników z. Wyniosła od 0.05 (Merc 280 i Merc 280C) do 2.34, mediana 1.07.
Kolejność wierszy wyznaczyła seriacja metodą OLO (optymalne uporządkowanie liści drzewa) z pakietu seriation, jedną z dwóch metod, na których opierają się autorzy pakietu RMaCzek do rysowania takich diagramów (Bartoszek i Västerlund, 2020). Suma odległości między sąsiadami w kolejności spadła z 21.62 (kolejność z tabeli) do 9.33. Pary podzielono na klasy: 15% najbliższych (odległość do 0.51), 15–30% (do 0.73) i 30–45% (do 1.02); dalszych par nie rysujemy. Progi wybraliśmy ręcznie, żeby rysunek był czytelny.
Na rysunku
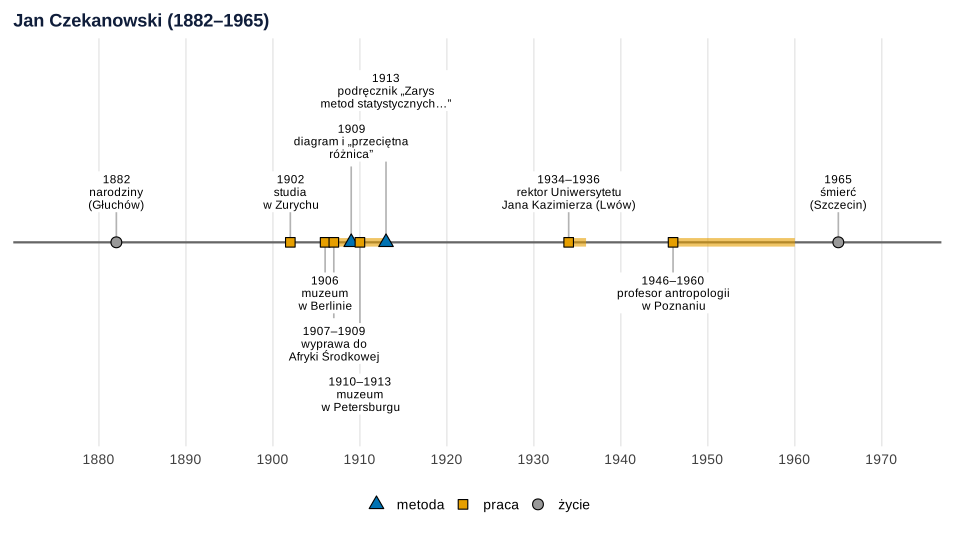
Co widać. Metoda powstała wcześnie – w 1909 r., w czasie pracy muzealnej i tuż po wyprawie afrykańskiej – a podręcznik cztery lata później. Pasy na osi pokazują okresy: wyprawę, pracę w Petersburgu, rektorat we Lwowie i profesurę w Poznaniu.
Na co uważać. Na osi brak roku objęcia stanowiska we Lwowie: źródło mówi tylko, że nastąpiło to po pobycie w Petersburgu. Nie zgadujemy dat, których źródło nie podaje.
Podpis do pracy:
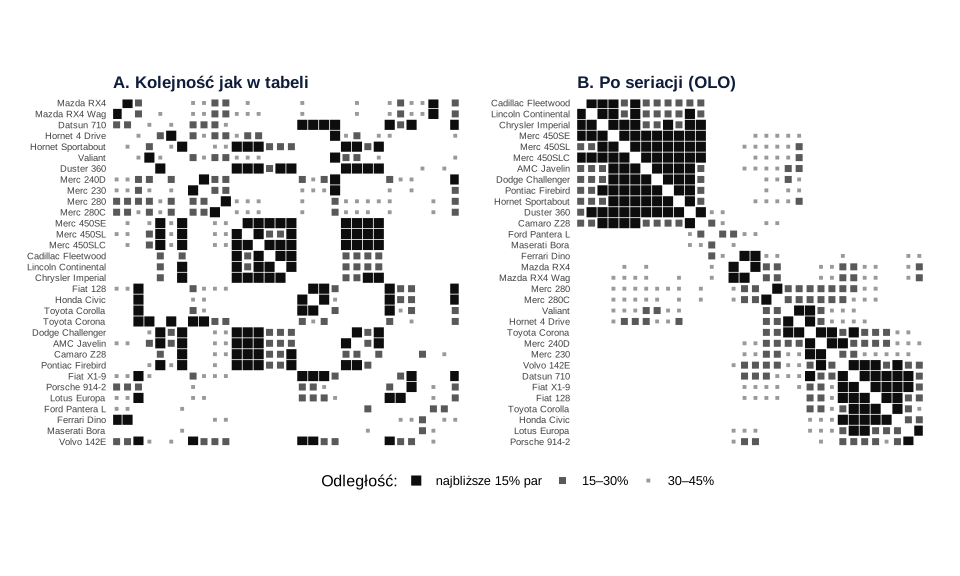
Co widać. Obie macierze zawierają te same odległości – zmieniła się tylko kolejność wierszy i kolumn. W panelu A podobne auta są rozrzucone, w panelu B tworzą bloki. Pierwsze 12 aut to ośmiocylindrowe samochody z automatyczną skrzynią (od Cadillaca Fleetwood do Camaro Z28). Ford Pantera L i Maserati Bora mają niewielu bliskich sąsiadów, dalej idą auta sześciocylindrowe, a na końcu – czterocylindrowe, z najlżejszymi (Fiat, Toyota Corolla, Honda Civic, Lotus Europa) w ciasnym bloku. Kolejność sama „odkryła” liczbę cylindrów, choć była to tylko jedna z 11 cech.
Na co uważać. Inna metoda seriacji albo inne progi klas dadzą trochę inny obraz. Diagram nie mówi też, ile jest skupień ani czy są one istotne – to ocena wzrokowa. Granice skupień sprawdź np. wskaźnikiem sylwetki albo dendrogramem. Bez standaryzacji zmienne w dużych jednostkach (np. pojemność silnika) zdominowałyby odległość.
Podpis do pracy:
Gdzie spotkasz Czekanowskiego w swojej pracy
- Mapy cieplne z uporządkowaną kolejnością – gdy program sam ustawia zmienne lub osoby według grupowania, korzysta z tej samej idei co diagram z 1909 r.
- Analiza skupień – diagram to szybki sposób, by przed formalną analizą zobaczyć, czy w danych w ogóle są grupy (zob. wpis analiza skupień krok po kroku).
- Ekologia i dane o składzie – wskaźnik Czekanowskiego, często pod nazwą Braya–Curtisa. Napisz w pracy wzór, którego użyłeś.
- Antropologia i nauki społeczne w Polsce – Bartoszek i Västerlund (2020) pokazują zastosowania na danych antropologicznych i społeczno-ekonomicznych.
Inną polską metodę grupowania, metodę k-średnich, opisujemy w haśle Hugo Steinhaus.
Spory, mity i trudne strony
- Kontekst antropologii rasowej. Czekanowski stworzył metodę na potrzeby antropologii fizycznej swoich czasów, która dzieliła populacje na „typy antropologiczne”; Fernández-Lizana (2026) pokazuje, jak ten kontekst ukształtował narzędzie, które dziś służy do zupełnie innych celów.
- Wojna. Według tego samego źródła po zajęciu Lwowa przez Niemców jego nazwisko usunięto z listy lwowskich profesorów rozstrzelanych 4 lipca 1941 r.; kilku członków lwowskiej szkoły antropologicznej zginęło w czasie wojny.
- Indeks czy indeksy? „Indeks Czekanowskiego” i „indeks Braya–Curtisa” bywają w programach mylone. Przed porównaniem wyników z różnych prac sprawdź wzory (Yoshioka, 2008).
- Diagram to nie dendrogram. Diagram pokazuje całą macierz odległości, a dendrogram – tylko kolejność łączenia skupień.
Diagram Czekanowskiego w R
Kod tworzy oś czasu (rysunek 1), liczy „przeciętną różnicę” Czekanowskiego dla 32 samochodów, porządkuje macierz metodą OLO i rysuje diagram przed seriacją i po niej (rysunek 2). Rysunki na stronie powstały z tych samych obiektów p_os i p_diagram z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Odległości, seriacja OLO i symbole w klasach
Kod R rysunków 1 i 2
# Jan Czekanowski: oś czasu i diagram Czekanowskiego dla 32 samochodów z mtcars
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(seriation)})
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")

# 1. Oś czasu (lata z cytowanych źródeł)
zdarzenia <- data.frame(
  rok = c(1882, 1902, 1906, 1907, 1909, 1910, 1913, 1934, 1946, 1965),
  koniec = c(NA, NA, NA, 1909, NA, 1913, NA, 1936, 1960, NA),
  opis = c("narodziny\n(Głuchów)", "studia\nw Zurychu", "muzeum\nw Berlinie", "wyprawa do\nAfryki Środkowej",
           "diagram i „przeciętna\nróżnica”", "muzeum\nw Petersburgu", "podręcznik „Zarys\nmetod statystycznych…”",
           "rektor Uniwersytetu\nJana Kazimierza (Lwów)", "profesor antropologii\nw Poznaniu", "śmierć\n(Szczecin)"),
  rodzaj = c("życie", "praca", "praca", "praca", "metoda", "praca", "metoda", "praca", "praca", "życie"),
  poziom = c(0.9, 0.9, -0.9, -1.8, 1.8, -2.7, 2.7, 0.9, -0.9, 0.9))
zdarzenia$etykieta <- paste0(ifelse(is.na(zdarzenia$koniec), zdarzenia$rok,
                                    paste0(zdarzenia$rok, "–", zdarzenia$koniec)), "\n", zdarzenia$opis)
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.8) +
  geom_segment(data = subset(zdarzenia, !is.na(koniec)), aes(x = rok, xend = koniec, y = 0, yend = 0),
               colour = "#E69F00", linewidth = 3, alpha = 0.6) +
  geom_segment(aes(xend = rok, yend = poziom * 0.75), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.4) +
  geom_label(aes(y = poziom, label = etykieta), size = 3.1, lineheight = 0.9, linewidth = 0, fill = "white") +
  scale_shape_manual(values = c(życie = 21, praca = 22, metoda = 24), name = NULL) +
  scale_fill_manual(values = c(życie = "grey60", praca = "#E69F00", metoda = "#0072B2"), name = NULL) +
  scale_x_continuous(breaks = seq(1880, 1970, 10), limits = c(1875, 1972)) +
  scale_y_continuous(limits = c(-3.3, 3.3)) +
  labs(x = NULL, y = NULL, title = "Jan Czekanowski (1882–1965)") + motyw +
  theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# 2. „Przeciętna różnica” Czekanowskiego: średnia bezwzględna różnica wyników z na 11 zmiennych
z <- scale(mtcars)                                   # 32 samochody, 11 zmiennych standaryzowanych
d <- dist(z, method = "manhattan") / ncol(z)         # odległość miejska podzielona przez liczbę zmiennych
round(summary(as.vector(d)), 2)

# 3. Kolejność: tabela z czasopisma vs seriacja (optymalne uporządkowanie liści, OLO)
kol_oryg <- 1:32
kol_olo <- get_order(seriate(d, method = "OLO"))
round(c(sciezka_tabela = unname(criterion(d, kol_oryg, "Path_length")),
        sciezka_seriacja = unname(criterion(d, kol_olo, "Path_length"))), 2)
rownames(mtcars)[kol_olo]

# 4. Klasy odległości jak u Czekanowskiego: im bliżej, tym większy i ciemniejszy symbol; najdalsze 55% par – puste pole
progi <- quantile(as.vector(d), c(0.15, 0.30, 0.45))
round(progi, 2)
diagram <- function(kolejnosc, tytul) {
  m <- as.matrix(d)[kolejnosc, kolejnosc]
  g <- expand.grid(wiersz = seq_along(kolejnosc), kolumna = seq_along(kolejnosc))
  g$odl <- m[cbind(g$wiersz, g$kolumna)]
  g$klasa <- cut(g$odl, c(-Inf, progi, Inf), labels = c("najbliższe 15% par", "15–30%", "30–45%", "dalej"))
  g <- droplevels(subset(g, klasa != "dalej" & wiersz != kolumna))
  ggplot(g, aes(kolumna, wiersz, size = klasa, colour = klasa)) +
    geom_point(shape = 15) +
    scale_size_manual(values = c(3.2, 2.1, 1), name = "Odległość:") +
    scale_colour_manual(values = c("grey5", "grey35", "grey60"), name = "Odległość:") +
    scale_y_reverse(breaks = seq_along(kolejnosc), labels = rownames(mtcars)[kolejnosc], expand = c(0.01, 0.01)) +
    scale_x_continuous(breaks = NULL, expand = c(0.01, 0.01)) +
    coord_fixed() + labs(x = NULL, y = NULL, title = tytul) + motyw +
    theme(axis.text.y = element_text(size = 7), panel.grid = element_blank())
}
p_diagram <- (diagram(kol_oryg, "A. Kolejność jak w tabeli") + diagram(kol_olo, "B. Po seriacji (OLO)")) +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
p_os
p_diagram
Wynik w R
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   0.05    0.63    1.07    1.09    1.47    2.34
  sciezka_tabela sciezka_seriacja
           21.62             9.33
 [1] "Cadillac Fleetwood"  "Lincoln Continental" "Chrysler Imperial"
 [4] "Merc 450SE"          "Merc 450SL"          "Merc 450SLC"
 [7] "AMC Javelin"         "Dodge Challenger"    "Pontiac Firebird"
[10] "Hornet Sportabout"   "Duster 360"          "Camaro Z28"
[13] "Ford Pantera L"      "Maserati Bora"       "Ferrari Dino"
[16] "Mazda RX4"           "Mazda RX4 Wag"       "Merc 280"
[19] "Merc 280C"           "Valiant"             "Hornet 4 Drive"
[22] "Toyota Corona"       "Merc 240D"           "Merc 230"
[25] "Volvo 142E"          "Datsun 710"          "Fiat X1-9"
[28] "Fiat 128"            "Toyota Corolla"      "Honda Civic"
[31] "Lotus Europa"        "Porsche 914-2"
 15%  30%  45%
0.51 0.73 1.02
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (odległości – dist(); seriacja – pakiet seriation; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seriation (wersja 1.5.8): Hahsler, M., Hornik, K., & Buchta, C. (2008). Getting things in order: An introduction to the R package seriation. Journal of Statistical Software, 25(3), 1–34. https://doi.org/10.18637/jss.v025.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Jan Czekanowski?
Polskim antropologiem i statystykiem (1882–1965). Studiował w Zurychu, pracował w muzeach w Berlinie i Petersburgu, uczestniczył w wyprawie do Afryki Środkowej, kierował antropologią na Uniwersytecie Jana Kazimierza we Lwowie (rektor w latach 1934–1936), a od 1946 r. był profesorem w Poznaniu.
Co to jest diagram Czekanowskiego?
To macierz odległości między obiektami, w której wiersze i kolumny przestawiono tak, by obiekty podobne leżały obok siebie, a w każdym polu wstawiono symbol – tym ciemniejszy, im obiekty bardziej podobne. Skupienia widać jako ciemne bloki przy przekątnej, bez ustalania z góry ich liczby.
Czy indeks Czekanowskiego to to samo co indeks Braya–Curtisa?
Nie zawsze. Yoshioka (2008) pokazał, że część programów pod nazwą Braya–Curtisa liczy w rzeczywistości wskaźnik Czekanowskiego, a na tych samych danych oba wskaźniki mogą się wyraźnie różnić. W pracy podaj wzór, którego użyłeś.
Jak zrobić diagram Czekanowskiego w R?
Policz macierz odległości (np. dist() na zestandaryzowanych danych), ustal kolejność obiektów seriacją, np. seriate(d, method = "OLO") z pakietu seriation, i narysuj uporządkowaną macierz w ggplot2 z symbolami według klas odległości. Gotowe diagramy rysuje też pakiet RMaCzek.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bartoszek, K., & Västerlund, A. (2020). “Old techniques for new times”: The RMaCzek package for producing Czekanowski’s diagrams. Biometrical Letters, 57(2), 89–118. https://doi.org/10.2478/bile-2020-0008 ● Otwarty dostęp
- Fernández-Lizana, M. I. (2026). Jan Czekanowski y la instrumentalización de la estadística matemática en la Escuela de Antropología de Lwów (Polonia) durante la primera mitad del siglo XX. Revista Latinoamericana de Metodología de las Ciencias Sociales, 16(1), Article e168. https://doi.org/10.24215/18537863e168 ● Otwarty dostęp
- Yoshioka, P. M. (2008). Misidentification of the Bray-Curtis similarity index. Marine Ecology Progress Series, 368, 309–310. https://doi.org/10.3354/meps07728 ● Otwarty dostęp
Cytowania BibTeX
@article{bartoszek2020old, author={Bartoszek, Krzysztof and Västerlund, Albin}, title={{“Old techniques for new times”: The RMaCzek package for producing Czekanowski’s diagrams}}, journal={Biometrical Letters}, year={2020}, volume={57}, number={2}, pages={89--118}, doi={10.2478/bile-2020-0008}}@article{fernandezlizana2026czekanowski, author={Fernández-Lizana, Miguel Ignacio}, title={{Jan Czekanowski y la instrumentalización de la estadística matemática en la Escuela de Antropología de Lwów (Polonia) durante la primera mitad del siglo XX}}, journal={Revista Latinoamericana de Metodología de las Ciencias Sociales}, year={2026}, volume={16}, number={1}, eid={e168}, doi={10.24215/18537863e168}}@article{yoshioka2008misidentification, author={Yoshioka, P. M.}, title={{Misidentification of the Bray-Curtis similarity index}}, journal={Marine Ecology Progress Series}, year={2008}, volume={368}, pages={309--310}, doi={10.3354/meps07728}}