Sondaż przekrojowy w jednym akapicie
Sondaż przekrojowy to badanie, w którym jeden raz pytasz określoną grupę osób o ich stan i zachowania. Służy zwykle do oszacowania, jak często coś występuje, do opisu populacji i do szukania uwarunkowań zdrowia (Wang i Cheng, 2020). Ponieważ ekspozycję i wynik mierzysz w tym samym czasie, wnioskowanie przyczynowe jest trudne (Setia, 2016). W rozdziale o metodzie częsty problem jest jednak inny: opis skupia się na narzędziach, a pomija to, kogo naprawdę zbadano i ile osób po drodze odpadło.
Ten wpis to gotowy wzór podrozdziału „Metoda” dla takiego badania. Ogólny układ rozdziału opisuje poradnik o rozdziale metodologicznym, ankietę w jednym szpitalu ze znaną kadrą – wpis o ankiecie wśród personelu, a opis wyników przy wielu pytaniach – wpis o ankiecie z 30 pytaniami. Tu chodzi o sondaż, w którym listy populacji zwykle nie masz i musisz opisać, skąd wzięli się respondenci.
Przykład przewodni (fikcyjny, dane symulowane). Studentka zdrowia publicznego pyta dorosłych pacjentów czterech przychodni podstawowej opieki zdrowotnej (POZ), jak często występują objawy depresyjne (PHQ-9) i czy wiążą się z małą aktywnością fizyczną. Rekrutacja trwa sześć tygodni. Liczby w tekście pochodzą z kodu R na końcu wpisu. Przykład nie mówi nic o prawdziwych pacjentach.
Układ według STROBE: co gdzie opisać
Dla badań obserwacyjnych, w tym przekrojowych, standardem raportowania jest lista STROBE (von Elm i in., 2007). Którą listę wybrać i jak ją wypełnić, wyjaśnia wpis o wytycznych raportowania. Jeśli dane pochodzą z dokumentacji, a nie od respondentów, zobacz badanie retrospektywne. Poniżej punkty szczególnie ważne w pracach ankietowych, przypisane do podrozdziałów. Treść punktów jest streszczona.
| Punkt STROBE | Podrozdział | Co napisać w przykładzie |
|---|---|---|
| 4–5: schemat, miejsce, daty | Schemat i miejsce badania | Sondaż przekrojowy, cztery przychodnie POZ, daty rekrutacji |
| 6a: kryteria i sposób doboru | Uczestnicy | Kryteria włączenia, kolejne osoby w rejestracji |
| 7–8: zmienne i pomiar | Narzędzia | Definicja wyniku i ekspozycji, źródło każdego narzędzia |
| 9: źródła obciążenia | Procedura | Co zrobiono, by ograniczyć błąd doboru i pomiaru |
| 10: liczebność | Uczestnicy | Skąd wzięła się liczba osób |
| 12: metody, w tym 12c (braki) i 12d (schemat doboru) | Plan analizy | Modele, braki, uwzględnienie przychodni |
| 13: liczby na etapach, powody, diagram | Wyniki, początek | Rysunek 1 |
| 14a–b: charakterystyka, braki dla każdej zmiennej | Wyniki | Tabela 1 i liczba braków |
| 16: wyniki surowe i skorygowane z CI | Wyniki | Oba oszacowania, lista zmiennych korygujących |
| 19–21: ograniczenia, interpretacja, uogólnianie | Dyskusja | Kierunek obciążenia, czasowość, do kogo odnoszą się wyniki |
Populacja i rekrutacja: kogo naprawdę zbadano
Rozdziel trzy rzeczy, które w pracach zlewają się w jedno: populację, o której chcesz mówić (dorośli pacjenci POZ), miejsca, w których ją spotykasz (cztery przychodnie), i sposób doboru. Zapraszanie kolejnych osób przez ustalony czas to nadal dobór nieprobabilistyczny, ale ma nad ankietą w mediach społecznościowych tę przewagę, że znasz liczbę zaproszonych, więc możesz policzyć odsetek odpowiedzi. Przychodnie to dodatkowe źródło podobieństwa: pacjenci jednej placówki bywają do siebie podobni. Przy czterech placówkach wprowadź przychodnię do modelu jako zmienną, zamiast liczyć błędy klastrowe.
| Jak bywa napisane | Co jest nie tak | Lepiej |
|---|---|---|
| „W badaniu wzięło udział 472 pacjentów.” | Nie wiadomo, kim są, skąd pochodzą i ilu odmówiło. | „Zaproszono 730 kolejnych dorosłych pacjentów czterech przychodni POZ; 700 spełniało kryteria.” |
| „Próba była reprezentatywna dla pacjentów POZ.” | Reprezentatywności nie daje liczebność ani rozkład płci. Bez doboru losowego nie można jej stwierdzić. | „Próba obejmuje pacjentów czterech przychodni z jednego powiatu; wyniki odnoszą się do podobnych placówek.” |
| „Ankietę rozdano w przychodniach.” | Brak kryteriów, dat i osoby rekrutującej; nie da się powtórzyć procedury. | „Od 2 marca do 10 kwietnia osoba rekrutująca zapraszała każdego dorosłego pacjenta oczekującego na wizytę.” |
| „Badanie miało charakter ankietowy.” | To technika zbierania danych, a nie schemat. | „Przeprowadzono sondaż przekrojowy z użyciem kwestionariusza do samodzielnego wypełnienia.” |
Liczebność uzasadnij precyzją oszacowania, a nie zwyczajem. Dla spodziewanego odsetka 25% i marginesu ±4 punkty procentowe potrzeba 451 osób. Przy spodziewanym udziale 65% oznacza to około 694 uprawnionych do zaproszenia. Rachunek ze spodziewanym udziałem opisuje wpis ile zaproszeń wysłać.
Odsetek odpowiedzi i diagram przepływu
STROBE prosi o liczby na każdym etapie, powody odpadania i rozważenie diagramu (von Elm i in., 2007). Mianownik wskaźnika odpowiedzi podaj wprost: tu 482 z 700 uprawnionych, czyli 68.9%. Reguły liczenia etapów są we wpisie o diagramie przepływu, a rysunek przygotujesz w generatorze online.
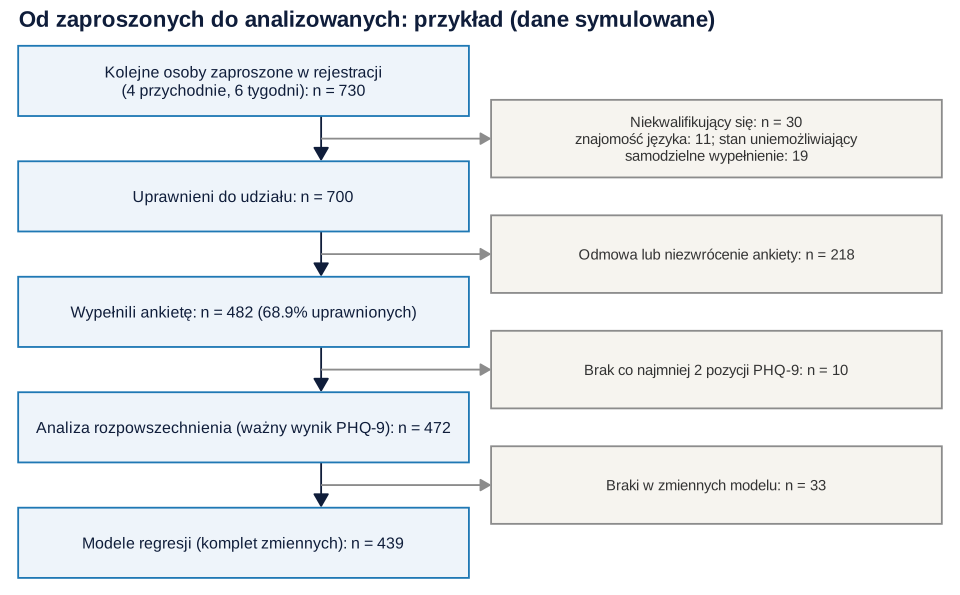
Sam odsetek nie rozstrzyga, czy wyniki są obciążone: brak odpowiedzi może, ale nie musi prowadzić do obciążenia (Groves, 2006). Sprawdź to na tym, co masz o osobach, które odmówiły. Osoba rekrutująca może notować wiek i płeć bez danych identyfikujących, jeśli zgodzi się na to komisja bioetyczna. W przykładzie osoby odmawiające były nieco młodsze (M = 49.7 wobec 52.8 lat), a odsetek kobiet był podobny (61.0% i 63.7%). Taki wynik pomaga, ale nie wystarcza. Dzięki symulacji znamy to, czego w prawdziwym badaniu nie zobaczysz: osoby z objawami brały udział rzadziej (58.9% wobec 72.0%), więc wśród wszystkich uprawnionych wynik PHQ-9 ≥ 10 miało 24.0% osób, a w analizie 20.8%. Porównanie wieku i płci tej różnicy nie ujawnia. Dlatego w dyskusji napisz, w którą stronę mógł działać brak odpowiedzi.
Narzędzia: co zmierzono i co z tego wynika
Dla każdej zmiennej podaj: definicję, źródło, sposób liczenia wyniku i próg. Szczegóły PHQ-9 opisuje wpis o liczeniu wyniku GAD-7 i PHQ-9. W badaniu walidacyjnym wynik co najmniej 10 miał czułość i swoistość po 88% dla dużej depresji (Kroenke i in., 2001). To narzędzie przesiewowe, więc pisz „wynik PHQ-9 ≥ 10” albo „nasilone objawy depresyjne”, a nie „depresja”. Pozycja 9 pyta o myśli samobójcze. Przed rekrutacją ustal z promotorem i komisją, jak zareagujesz na niepokojącą odpowiedź w badaniu anonimowym, i dołącz informację o miejscach pomocy.
Własne pytanie opisz równie dokładnie jak skalę: dosłowne brzmienie w załączniku, próg z uzasadnieniem, otwarte przyznanie, że to pojedyncza pozycja samoopisowa. W przykładzie aktywność mierzy pytanie o liczbę dni z co najmniej 30 minutami umiarkowanego wysiłku. Podanie rzetelności z własnej próby (tu α = .88) nie zastępuje informacji o walidacji.
Braki danych: osobno dla każdej zmiennej
STROBE wymaga podania liczby osób z brakami dla każdej zmiennej (punkt 14b) i opisu postępowania z nimi (12c; von Elm i in., 2007). W przykładzie 42 osoby pominęły jedną pozycję PHQ-9 i dostały wynik proporcjonalny, a 10 osób pominęło dwie lub więcej i nie ma wyniku. Dalsze braki to wykształcenie (17), aktywność (13) i choroba przewlekła (4). Model obejmuje więc 439 z 472 osób. Pisz wprost, że analiza dotyczy osób z kompletem zmiennych, a modele surowy i skorygowany licz na tych samych osobach. Kiedy to za mało i jakie są inne podejścia, wyjaśnia wpis o brakach danych w ankiecie.
Gotowy podrozdział „Metoda”
Przepisz układ, a treść zastąp własnymi danymi. Daty i liczby są fikcyjne. Wymagania uczelni i promotora mają pierwszeństwo przed tym wzorem.
Schemat i uczestnicy
Komentarz. Oddziel populację docelową od placówek. Ostatnie zdanie zapobiega zarzutowi nadmiernego uogólniania.
Narzędzia
Komentarz. Podaj okres, którego dotyczy pytanie. W sondażu przekrojowym to jedyna informacja o czasie.
Procedura
Komentarz. Zdanie o tym, czemu służył dany krok, odpowiada punktowi 9 STROBE (źródła obciążenia).
Plan analizy
Komentarz. Przy częstym wyniku iloraz szans nie przybliża ilorazu chorobowości: gdy PR > 1, OR jest zawsze większy (Thompson i in., 1998). Zamiast tego można oszacować PR bezpośrednio, np. regresją Poissona z odpornym estymatorem wariancji (Barros i Hirakata, 2003). Różnice między miarami omawia wpis o RR, OR i NNT. Przedział Wilsona opisuje tylko niepewność losową i nie obejmuje błędu wynikającego z braku odpowiedzi.
Tabela i pierwszy akapit wyników
Tabelę opisową pokaż bez testów istotności: STROBE odradza je w tym miejscu (Vandenbroucke i in., 2007). Reguły układu i formatowania opisuje wpis o tabeli 1.
| Cecha | Wszyscy (n = 472) | PHQ-9 < 10 (n = 374) | PHQ-9 ≥ 10 (n = 98) |
|---|---|---|---|
| Wiek, M (SD) | 52.7 (15.3) | 52.0 (15.3) | 55.6 (15.2) |
| Kobiety, n (%) | 301 (63.8) | 231 (61.8) | 70 (71.4) |
| Wykształcenie podstawowe/zawodowe, n (%) | 95 (20.9) | 72 (20.1) | 23 (24.0) |
| Wykształcenie średnie, n (%) | 161 (35.4) | 128 (35.7) | 33 (34.4) |
| Wykształcenie wyższe, n (%) | 199 (43.7) | 159 (44.3) | 40 (41.7) |
| Choroba przewlekła, n (%) | 200 (42.7) | 135 (36.5) | 65 (66.3) |
| Mała aktywność, n (%) | 173 (37.7) | 118 (32.4) | 55 (57.9) |
Odsetki liczono wśród osób z danymi dla danej zmiennej; dane symulowane.
Zwróć uwagę na różnicę: PR = 1.96 oznacza prawie dwukrotnie wyższy odsetek, a OR = 2.52 łatwo błędnie przeczytać jako „dwa i pół razy częściej”.
Przekrojowość a czasowość
Ta sama tabela może powstać z zupełnie różnych procesów. Symulacja na rysunku 2 tworzy trzy światy: w jednym mała aktywność zwiększa objawy, w drugim objawy ograniczają aktywność, a w trzecim oba zjawiska mają wspólną przyczynę. Sondaż w każdym z nich pokazuje niemal to samo: około 30% wobec 16% i OR około 2.25. Inny jest tylko skutek hipotetycznej zmiany: gdyby wszyscy stali się aktywni, odsetek spadłby z 22.6% do 16.0% tylko w świecie A.
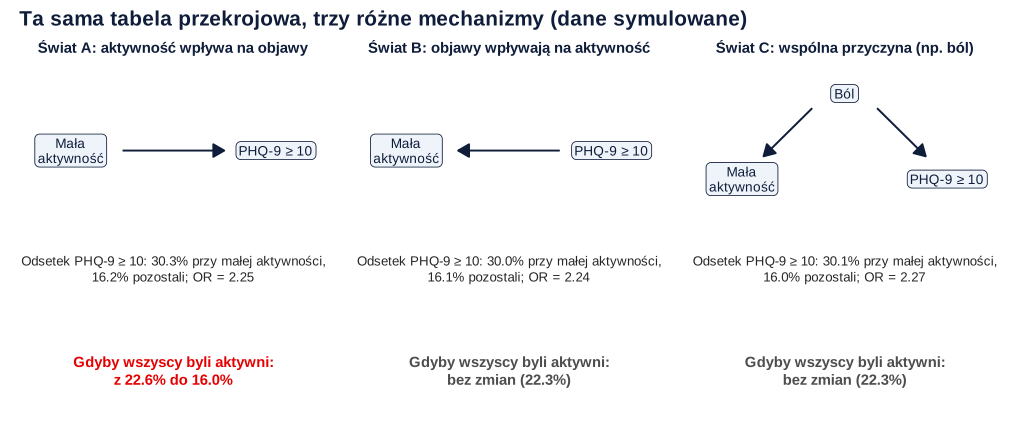
Nie znaczy to, że sondaż niczego nie mówi o przyczynach. Savitz i Wellenius (2023) przekonują, że odwrócona przyczynowość, ograniczenie do rozpowszechnienia czy pomiar tylko bieżącej ekspozycji nie dotyczą każdego badania przekrojowego i trzeba je oceniać w konkretnym przypadku. Sprawdź więc w swojej pracy trzy rzeczy:
- Czy ekspozycja mogła zależeć od wyniku? Wiek czy wzrost nie zależą od objawów, ale aktywność, sen i dieta mogą.
- Czy masz informację o kolejności? Pytanie, od kiedy trwa stan, pomaga, ale wnosi błąd pamięci. Opisz to jako dane retrospektywne.
- Czy badasz rozpowszechnienie, a nie nowe przypadki? W sondażu nadreprezentowane są stany długotrwałe, co wyjaśnia hasło o chorobowości i zapadalności. Pomiar kolejności zapewnia dopiero badanie kohortowe.
Co wolno napisać we wnioskach
| Nie pisz | Pisz | Dlaczego |
|---|---|---|
| „Mała aktywność powoduje objawy depresyjne.” | „Mała aktywność współwystępowała z częstszym wynikiem PHQ-9 ≥ 10.” | Jeden pomiar nie ustala kierunku. |
| „Aktywność chroni przed depresją.” | „Związek utrzymał się po uwzględnieniu mierzonych zmiennych, ale nie wyklucza to wpływu niezmierzonych.” | Zakłócanie kontrolujesz tylko w zakresie tego, co zmierzono. |
| „20.8% Polaków ma depresję.” | „Wynik przesiewowy PHQ-9 ≥ 10 miało 20.8% pacjentów czterech przychodni.” | Nie ta populacja i nie rozpoznanie. |
| „Czynnik ryzyka depresji.” | „Czynnik związany z objawami” albo „korelat”. | „Ryzyko” sugeruje przyszłe zdarzenia. |
| „Należy wdrożyć program aktywności.” | „Warto sprawdzić tę zależność w badaniu podłużnym lub interwencyjnym.” | Sondaż nie ocenia skuteczności działań. |
Sposób opisu tych zastrzeżeń rozwija wpis o ograniczeniach badania.
Na co zwrócić uwagę w różnych dziedzinach
To częste konwencje i nasze obserwacje, a nie reguły.
| Dziedzina | Główny akcent | Typowy błąd |
|---|---|---|
| Psychologia | Konstrukty, właściwości skal, korelacje; zob. badanie korelacyjne | Mediacja na jednym pomiarze bez zastrzeżeń |
| Nauki o zdrowiu | Rozpowszechnienie z CI, STROBE, PR; zob. pracę z dietetyki i zdrowia publicznego i z pielęgniarstwa | „Depresja” zamiast wyniku przesiewowego |
| Fizjoterapia | Definicja dolegliwości, okres pytania, funkcjonalność w samoopisie | Wnioski o skuteczności terapii z porównania osób ćwiczących i niećwiczących |
| Zarządzanie | Wspólna metoda, organizacja jako klaster | „Wpływ” przywództwa na zaangażowanie z jednego pomiaru |
Najczęstsze błędy
- Brak mianownika. Podajesz liczbę respondentów, ale nie liczbę zaproszonych ani uprawnionych.
- Różne n bez wyjaśnienia. 472 w opisie, 439 w modelu i ani słowa dlaczego.
- Nazywanie wyniku przesiewowego rozpoznaniem.
- OR czytany jak „razy częściej” przy częstym wyniku.
- Zmienne korygujące wybrane po analizie według istotności w modelu surowym.
- Testy istotności w tabeli charakterystyki próby.
- Pominięcie okresu pytania („ostatnie 2 tygodnie”), który określa, co naprawdę zmierzono.
- Słowa „wpływ”, „skutek”, „czynnik ryzyka” we wnioskach.
Jeśli chcesz, żeby ktoś sprawdził opis metody i obliczenia, zobacz pomoc w analizie dla studentów.
Sondaż przekrojowy w R
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy rejestr rekrutacji i dane respondentów i zapisuje je w folderze nadrzędnym (../). Drugi liczy wynik PHQ-9, tabelę i modele, trzeci porównuje trzy mechanizmy. Przepisy uruchamiaj po kolei z jednego folderu. Dane możesz pobrać: sondaz-przekrojowy-poz-respondenci.csv (482 fikcyjne osoby: przychodnia, wiek, płeć, wykształcenie, choroba przewlekła, mała aktywność, dziewięć pozycji PHQ-9).
Rekrutacja, dane i odsetek odpowiedzi
R
# B472 – sondaż przekrojowy wśród pacjentów czterech przychodni POZ: rejestr rekrutacji i dane
# Dane symulowane. Scenariusz fikcyjny: objawy depresyjne (PHQ-9) a mała aktywność fizyczna.
set.seed(4721)

# 1. Kolejne osoby zaproszone w rejestracji: 730 osób, 30 niekwalifikujących się
N <- 730
przychodnie <- sample(c("A", "B", "C", "D"), N, TRUE, prob = c(.35, .30, .20, .15))
wiek <- pmin(pmax(round(rnorm(N, 52, 16)), 18), 85)
plec <- ifelse(runif(N) < .60, "K", "M")
wyk_p <- plogis(-0.2 - 0.025 * (wiek - 50))               # szansa na wykształcenie wyższe
wyksztalcenie <- ifelse(runif(N) < wyk_p, "wyższe",
                        ifelse(runif(N) < .6, "średnie", "podstawowe/zawodowe"))
choroba <- rbinom(N, 1, plogis(-0.4 + 0.05 * (wiek - 50)))
aktyw_mala <- rbinom(N, 1, plogis(-0.55 + 0.018 * (wiek - 50) + 0.6 * choroba -
                                    0.45 * (wyksztalcenie == "wyższe")))

# 2. Dziewięć pozycji PHQ-9 (0–3) z jednej cechy ukrytej
theta <- -0.95 + 0.62 * aktyw_mala + 0.55 * choroba + 0.28 * (plec == "K") -
  0.008 * (wiek - 50) + rnorm(N)
phq <- sapply(1:9, function(i) {
  x <- 0.80 * theta + rnorm(N, 0, 0.72)
  as.integer(cut(x, c(-Inf, -0.05, 0.85, 1.65, Inf))) - 1L
})
colnames(phq) <- paste0("phq", 1:9)
prawdziwy_wynik <- rowSums(phq)

# 3. Kto trafia do badania: kwalifikacja, udział, kompletność
powod_niekw <- rep(NA_character_, N)
niekw <- sample(N, 30)
powod_niekw[niekw] <- sample(c("niewystarczająca znajomość języka polskiego",
                               "stan uniemożliwiający samodzielne wypełnienie"),
                             30, TRUE, prob = c(.45, .55))
uprawniony <- is.na(powod_niekw)
p_udzial <- plogis(0.95 - 0.70 * (prawdziwy_wynik >= 10) + 0.012 * (wiek - 50) +
                     0.15 * (plec == "K"))
udzial <- uprawniony & runif(N) < p_udzial

status <- ifelse(!uprawniony, "niekwalifikowany", ifelse(udzial, "wypełnił", "odmowa"))
rejestr <- data.frame(przychodnia = przychodnie, wiek, plec, status, powod_niekw)

# 4. Braki w odpowiedziach respondentów
resp_i <- which(udzial)
n <- length(resp_i)
dane <- data.frame(id = seq_len(n), przychodnia = przychodnie[resp_i], wiek = wiek[resp_i],
                   plec = plec[resp_i], wyksztalcenie = wyksztalcenie[resp_i],
                   choroba_przewlekla = choroba[resp_i], mala_aktywnosc = aktyw_mala[resp_i],
                   phq[resp_i, ])
kol <- paste0("phq", 1:9)
ile_brakow <- sample(0:3, n, TRUE, prob = c(.885, .08, .02, .015))
for (i in which(ile_brakow > 0)) dane[i, sample(kol, ile_brakow[i])] <- NA
dane$wyksztalcenie[runif(n) < plogis(-3.3 + 0.04 * (dane$wiek - 50))] <- NA
dane$mala_aktywnosc[runif(n) < .03] <- NA
dane$choroba_przewlekla[runif(n) < .015] <- NA
write.csv(dane, "../sondaz-przekrojowy-poz-respondenci.csv", row.names = FALSE,
          fileEncoding = "UTF-8", na = "")
write.csv(rejestr[, c("przychodnia", "wiek", "plec", "status", "powod_niekw")],
          "b472-rejestr-rekrutacji.csv", row.names = FALSE, fileEncoding = "UTF-8", na = "")

# 5. Przepływ i odsetek odpowiedzi
ile <- table(status)
cat("Zaproszeni:", N, "\n")
print(table(powod_niekw))
cat("Uprawnieni:", sum(uprawniony), "\n")
cat("Odmowy:", ile[["odmowa"]], "\n")
cat("Wypełnili:", n, "\n")
cat(sprintf("Odsetek odpowiedzi (wypełnili / uprawnieni): %.1f%%\n", 100 * n / sum(uprawniony)))
cat("Odsetek odpowiedzi w przychodniach:\n")
print(round(100 * prop.table(table(przychodnie[uprawniony], udzial[uprawniony]), 1)[, "TRUE"], 1))

# 6. Respondenci a osoby, które odmówiły (rejestr: tylko wiek, płeć, przychodnia)
upr <- rejestr[uprawniony, ]
por <- aggregate(wiek ~ status, upr, function(x) c(M = mean(x), SD = sd(x)))
print(do.call(data.frame, por), digits = 4)
cat("Kobiety (%):\n"); print(round(100 * tapply(upr$plec == "K", upr$status, mean), 1))

# 7. Tylko w symulacji: prawdziwe rozpowszechnienie wśród wszystkich uprawnionych
cat(sprintf("Odsetek PHQ-9 >= 10 wśród wszystkich uprawnionych (prawdziwy): %.1f%%\n",
            100 * mean(prawdziwy_wynik[uprawniony] >= 10)))
cat(sprintf("Odsetek PHQ-9 >= 10 wśród osób, które wypełniły (przed brakami): %.1f%%\n",
            100 * mean(prawdziwy_wynik[udzial] >= 10)))
cat(sprintf("Udział wśród uprawnionych z PHQ-9 >= 10: %.1f%%; pozostałych: %.1f%%\n",
            100 * mean(udzial[uprawniony & prawdziwy_wynik >= 10]),
            100 * mean(udzial[uprawniony & prawdziwy_wynik < 10])))
Wynik w R
Zaproszeni: 730
powod_niekw
  niewystarczająca znajomość języka polskiego
                                           11
stan uniemożliwiający samodzielne wypełnienie
                                           19
Uprawnieni: 700
Odmowy: 218
Wypełnili: 482
Odsetek odpowiedzi (wypełnili / uprawnieni): 68.9%
Odsetek odpowiedzi w przychodniach:
   A    B    C    D
73.4 64.1 71.4 64.3
    status wiek.M wiek.SD
1   odmowa  49.68   15.23
2 wypełnił  52.75   15.40
Kobiety (%):
  odmowa wypełnił
    61.0     63.7
Odsetek PHQ-9 >= 10 wśród wszystkich uprawnionych (prawdziwy): 24.0%
Odsetek PHQ-9 >= 10 wśród osób, które wypełniły (przed brakami): 20.5%
Udział wśród uprawnionych z PHQ-9 >= 10: 58.9%; pozostałych: 72.0%
Wynik PHQ-9, braki, tabela i modele
R
# B472 – liczenie wyników: wynik PHQ-9, braki, rozpowszechnienie, tabela, modele
# Uruchom po b472-1-dane-i-przeplyw.R (korzysta z zapisanego pliku CSV).
library(sandwich)
d <- read.csv("../sondaz-przekrojowy-poz-respondenci.csv", fileEncoding = "UTF-8",
              na.strings = "", stringsAsFactors = FALSE)
kol <- paste0("phq", 1:9)

# 1. Wynik PHQ-9: przy jednym braku wynik proporcjonalny, przy dwóch i więcej – brak wyniku
b <- rowSums(is.na(d[, kol]))
d$phq_suma <- ifelse(b <= 1, rowMeans(d[, kol], na.rm = TRUE) * 9, NA)
cat("Wypełnili:", nrow(d), "| brak 1 pozycji:", sum(b == 1), "| brak >= 2 pozycji:", sum(b >= 2), "\n")
a <- d[b <= 1, ]
cat("Analizowani:", nrow(a), "\n")
a$phq10 <- as.integer(a$phq_suma >= 10)

# 2. Braki w pozostałych zmiennych
zm <- c("wiek", "plec", "wyksztalcenie", "choroba_przewlekla", "mala_aktywnosc")
print(sapply(a[zm], function(x) sum(is.na(x))))

# 3. Rzetelność: alfa Cronbacha na kompletnych odpowiedziach
x <- na.omit(a[, kol]); k <- ncol(x)
cat(sprintf("Alfa Cronbacha (n = %d): %.2f\n", nrow(x),
            k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x)))))

# 4. Rozpowszechnienie z przedziałem Wilsona (95%)
w <- prop.test(sum(a$phq10), nrow(a), correct = FALSE)
cat(sprintf("PHQ-9 >= 10: %d z %d = %.1f%%, 95%% CI [%.1f, %.1f]\n", sum(a$phq10), nrow(a),
            100 * mean(a$phq10), 100 * w$conf.int[1], 100 * w$conf.int[2]))
cat(sprintf("M PHQ-9 = %.2f, SD = %.2f, Me = %.1f\n", mean(a$phq_suma), sd(a$phq_suma), median(a$phq_suma)))

# 5. Tabela charakterystyki próby (bez testów istotności)
wiersz_nproc <- function(v, g) {
  nn <- sum(!is.na(v) & g); sprintf("%d (%.1f)", sum(v[g], na.rm = TRUE), 100 * sum(v[g], na.rm = TRUE) / nn)
}
kolumny <- list(Wszyscy = rep(TRUE, nrow(a)), `PHQ<10` = a$phq10 == 0, `PHQ>=10` = a$phq10 == 1)
tab <- sapply(kolumny, function(g) c(
  n = as.character(sum(g)),
  `Wiek, M (SD)` = sprintf("%.1f (%.1f)", mean(a$wiek[g]), sd(a$wiek[g])),
  `Kobiety, n (%)` = wiersz_nproc(a$plec == "K", g),
  `Podst./zawodowe, n (%)` = wiersz_nproc(a$wyksztalcenie == "podstawowe/zawodowe", g),
  `Średnie, n (%)` = wiersz_nproc(a$wyksztalcenie == "średnie", g),
  `Wyższe, n (%)` = wiersz_nproc(a$wyksztalcenie == "wyższe", g),
  `Choroba przewlekła, n (%)` = wiersz_nproc(a$choroba_przewlekla == 1, g),
  `Mała aktywność, n (%)` = wiersz_nproc(a$mala_aktywnosc == 1, g)))
print(noquote(tab))
cat("Odsetek PHQ-9 >= 10 według aktywności:\n")
print(with(a, addmargins(table(mala_aktywnosc, phq10))))
print(round(100 * tapply(a$phq10, a$mala_aktywnosc, mean), 1))

# 6. Modele na kompletnych danych (te same osoby w modelu surowym i skorygowanym)
m <- na.omit(a[, c("phq10", "mala_aktywnosc", "wiek", "plec", "wyksztalcenie",
                   "choroba_przewlekla", "przychodnia")])
m$wyksztalcenie <- relevel(factor(m$wyksztalcenie), ref = "wyższe")
cat("Modele: n =", nrow(m), "| PHQ-9 >= 10:", sum(m$phq10), "\n")
po <- function(fit, skala) {
  V <- if (skala == "PR") vcovHC(fit, type = "HC0") else vcov(fit)
  b <- coef(fit)["mala_aktywnosc"]; se <- sqrt(V["mala_aktywnosc", "mala_aktywnosc"])
  z <- b / se
  sprintf("%s = %.2f, 95%% CI [%.2f, %.2f], p %s", skala, exp(b), exp(b - 1.96 * se), exp(b + 1.96 * se),
          ifelse(2 * pnorm(-abs(z)) < .001, "< .001", sprintf("= %s", sub("^0", "", sprintf("%.3f", 2 * pnorm(-abs(z)))))))
}
f0 <- phq10 ~ mala_aktywnosc
f1 <- phq10 ~ mala_aktywnosc + wiek + plec + wyksztalcenie + choroba_przewlekla + przychodnia
cat("Surowe:      ", po(glm(f0, binomial, m), "OR"), "\n")
cat("Skorygowane: ", po(glm(f1, binomial, m), "OR"), "\n")
cat("Surowe:      ", po(glm(f0, poisson, m), "PR"), "\n")
cat("Skorygowane: ", po(glm(f1, poisson, m), "PR"), "\n")

# 7. Liczebność z precyzji: rozpowszechnienie 25%, margines ±4 pp, spodziewany udział 65%
n_pot <- ceiling(1.96^2 * .25 * .75 / .04^2)
cat("Potrzebne n:", n_pot, "| uprawnionych do zaproszenia:", ceiling(n_pot / .65), "\n")
Wynik w R
Wypełnili: 482 | brak 1 pozycji: 42 | brak >= 2 pozycji: 10
Analizowani: 472
              wiek               plec      wyksztalcenie choroba_przewlekla
                 0                  0                 17                  4
    mala_aktywnosc
                13
Alfa Cronbacha (n = 430): 0.88
PHQ-9 >= 10: 98 z 472 = 20.8%, 95% CI [17.3, 24.7]
M PHQ-9 = 5.54, SD = 5.36, Me = 4.0
                          Wszyscy     PHQ<10      PHQ>=10
n                         472         374         98
Wiek, M (SD)              52.7 (15.3) 52.0 (15.3) 55.6 (15.2)
Kobiety, n (%)            301 (63.8)  231 (61.8)  70 (71.4)
Podst./zawodowe, n (%)    95 (20.9)   72 (20.1)   23 (24.0)
Średnie, n (%)            161 (35.4)  128 (35.7)  33 (34.4)
Wyższe, n (%)             199 (43.7)  159 (44.3)  40 (41.7)
Choroba przewlekła, n (%) 200 (42.7)  135 (36.5)  65 (66.3)
Mała aktywność, n (%)     173 (37.7)  118 (32.4)  55 (57.9)
Odsetek PHQ-9 >= 10 według aktywności:
              phq10
mala_aktywnosc   0   1 Sum
           0   246  40 286
           1   118  55 173
           Sum 364  95 459
   0    1
14.0 31.8
Modele: n = 439 | PHQ-9 >= 10: 93
Surowe:       OR = 2.88, 95% CI [1.80, 4.60], p < .001
Skorygowane:  OR = 2.52, 95% CI [1.54, 4.12], p < .001
Surowe:       PR = 2.27, 95% CI [1.58, 3.25], p < .001
Skorygowane:  PR = 1.96, 95% CI [1.36, 2.83], p < .001
Potrzebne n: 451 | uprawnionych do zaproszenia: 694
Trzy mechanizmy, ta sama tabela
R
# B472 – trzy różne mechanizmy, ta sama tabela przekrojowa (dane symulowane)
# E = mała aktywność, D = PHQ-9 >= 10, U = wspólna przyczyna (np. przewlekły ból)
set.seed(4723)
n <- 200000

# Świat A: E -> D
A <- within(data.frame(E = rbinom(n, 1, .45)), D <- rbinom(n, 1, ifelse(E == 1, .30, .16)))
# Świat B: D -> E (te same rozkłady brzegowe i ten sam związek, odwrócony kierunek)
pD <- .45 * .30 + .55 * .16
B <- within(data.frame(D = rbinom(n, 1, pD)),
            E <- rbinom(n, 1, ifelse(D == 1, .45 * .30 / pD, .45 * .70 / (1 - pD))))
# Świat C: U -> E i U -> D, bez związku przyczynowego między E i D
U <- rbinom(n, 1, .5)
C <- data.frame(U = U, E = rbinom(n, 1, ifelse(U == 1, .70, .20)),
                D = rbinom(n, 1, ifelse(U == 1, .3616, .0844)))

opis <- function(x, nazwa, po_zmianie) {
  t <- table(x$E, x$D)
  t <- matrix(as.numeric(t), 2)
  or <- (t[2, 2] * t[1, 1]) / (t[2, 1] * t[1, 2])
  data.frame(swiat = nazwa, proc_E = round(100 * mean(x$E), 1),
             proc_D_gdy_E = round(100 * mean(x$D[x$E == 1]), 1),
             proc_D_gdy_nieE = round(100 * mean(x$D[x$E == 0]), 1), OR = round(or, 2),
             proc_D_teraz = round(100 * mean(x$D), 1),
             proc_D_gdyby_wszyscy_aktywni = round(100 * po_zmianie, 1))
}
# Co by się stało, gdyby u wszystkich zmienić E na „aktywny” (E = 0)
wyn <- rbind(opis(A, "A: E -> D", mean(rbinom(n, 1, .16))),
             opis(B, "B: D -> E", mean(B$D)),                # D nie zależy od E
             opis(C, "C: U -> E, U -> D", mean(C$D)))        # D zależy tylko od U
print(wyn, row.names = FALSE)
Wynik w R
             swiat proc_E proc_D_gdy_E proc_D_gdy_nieE   OR proc_D_teraz
         A: E -> D   45.1         30.3            16.2 2.25         22.6
         B: D -> E   44.8         30.0            16.1 2.24         22.3
 C: U -> E, U -> D   45.0         30.1            16.0 2.27         22.3
 proc_D_gdyby_wszyscy_aktywni
                         16.0
                         22.3
                         22.3
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem sandwich; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed oddaniem rozdziału sprawdź…
- Czy populacja docelowa, miejsca i sposób doboru są opisane osobno?
- Czy podano daty rekrutacji i liczby osób na każdym etapie, z powodami odpadania?
- Czy odsetek odpowiedzi ma jawny mianownik?
- Czy porównano osoby odmawiające z respondentami, jeśli było to możliwe?
- Czy każde narzędzie ma źródło, okres pytania, sposób liczenia i próg?
- Czy podano liczbę braków dla każdej zmiennej i regułę ich obsługi?
- Czy uzasadniono liczebność i wybór zmiennych korygujących?
- Czy wyniki surowe i skorygowane mają przedziały ufności?
- Czy we wnioskach nie ma języka przyczynowego ani uogólnień poza badaną grupę?
- Czy w załączniku jest wypełniona lista STROBE, jeśli wymaga jej promotor?
Najczęstsze pytania
Czy sondaż przekrojowy to to samo co badanie ankietowe?
Nie do końca. „Ankieta” to technika zbierania danych, a „przekrojowy” mówi o czasie: każdą osobę mierzysz raz. Ankieta może być też częścią badania podłużnego, a dane przekrojowe mogą pochodzić z dokumentacji. W metodzie napisz oba elementy: „sondaż przekrojowy z użyciem kwestionariusza do samodzielnego wypełnienia”.
Czy w pracy z badaniem przekrojowym mogę pisać o czynnikach ryzyka?
Lepiej nie. „Ryzyko” odnosi się do przyszłych zdarzeń, a w sondażu widzisz stan w jednym momencie. Pisz o czynnikach związanych z wynikiem albo o korelatach, a kierunek zależności wskaż jako hipotezę do sprawdzenia w badaniu podłużnym.
Jaki odsetek odpowiedzi w ankiecie wśród pacjentów jest wystarczający?
Nie ma progu, który gwarantuje brak obciążenia. Sam odsetek nie przesądza o tym, czy wyniki są zniekształcone (Groves, 2006). Podaj licznik i mianownik, porównaj respondentów z osobami, które odmówiły, i napisz, w którą stronę mógł działać brak odpowiedzi.
Co podać w badaniu przekrojowym: iloraz szans czy iloraz chorobowości?
Przy częstym wyniku podawaj iloraz chorobowości (PR), bo gdy PR > 1, iloraz szans jest zawsze większy od PR (Thompson i in., 1998). PR można oszacować regresją Poissona z odpornym estymatorem wariancji (Barros i Hirakata, 2003). Jeśli promotor wymaga regresji logistycznej, podaj OR i czytaj go jako iloraz szans, a nie „razy częściej”.
Czy do pracy magisterskiej muszę dołączyć listę STROBE?
Zależy to od wymagań uczelni i promotora; często nie jest obowiązkowa. Warto jednak użyć jej jako listy kontrolnej przy pisaniu, bo pokazuje, co powinno znaleźć się w opisie metody. Jeśli ją dołączysz, użyj wersji dla badań przekrojowych.
Powiązane hasła
Przeczytaj też
Porównanie grup istniejących
Pacjenci i osoby bez choroby, zawody, płeć: źródło każdej grupy, dobór grupy porównawczej, standaryzowane różnice, ANCOVA ostrożnie i gotowa metoda – z kodem R.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →PoradnikDiagram przepływu respondentów
Od 612 wejść w link do 413 analizowanych: etapy, kryteria wykluczeń i ich kolejność, odsetek odpowiedzi i diagram w R.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →PoradnikStatystyka w pracy ze zdrowia publicznego
Chorobowość z CI, iloraz szans a iloraz chorobowości, standaryzacja względem wieku, ważenie próby i trend z rejestrów: analizy, APA i kod R.
Czytaj →Opisujesz sondaż przekrojowy w swojej pracy?
Pomożemy opisać rekrutację i odsetek odpowiedzi, dobrać modele, policzyć iloraz chorobowości w R lub SPSS i sformułować wnioski tak, żebyś umiał(a) je samodzielnie obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barros, A. J. D., & Hirakata, V. N. (2003). Alternatives for logistic regression in cross-sectional studies: An empirical comparison of models that directly estimate the prevalence ratio. BMC Medical Research Methodology, 3(1), Article 21. https://doi.org/10.1186/1471-2288-3-21 ● Otwarty dostęp
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Kroenke, K., Spitzer, R. L., & Williams, J. B. W. (2001). The PHQ-9: Validity of a brief depression severity measure. Journal of General Internal Medicine, 16(9), 606–613. https://doi.org/10.1046/j.1525-1497.2001.016009606.x ● Otwarty dostęp: pełny tekst
- Savitz, D. A., & Wellenius, G. A. (2023). Can cross-sectional studies contribute to causal inference? It depends. American Journal of Epidemiology, 192(4), 514–516. https://doi.org/10.1093/aje/kwac037
- Setia, M. S. (2016). Methodology series module 3: Cross-sectional studies. Indian Journal of Dermatology, 61(3), 261–264. https://doi.org/10.4103/0019-5154.182410 ● Otwarty dostęp
- Thompson, M. L., Myers, J. E., & Kriebel, D. (1998). Prevalence odds ratio or prevalence ratio in the analysis of cross sectional data: What is to be done? Occupational and Environmental Medicine, 55(4), 272–277. https://doi.org/10.1136/oem.55.4.272 ● Otwarty dostęp
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., Egger, M., & STROBE Initiative. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), Article e297. https://doi.org/10.1371/journal.pmed.0040297 ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
- Wang, X., & Cheng, Z. (2020). Cross-sectional studies: Strengths, weaknesses, and recommendations. Chest, 158(1), S65–S71. https://doi.org/10.1016/j.chest.2020.03.012 ● Otwarty dostęp
Cytowania BibTeX
@article{barros2003alternatives, author={Barros, Aluísio J. D. and Hirakata, Vânia N.}, title={{Alternatives for logistic regression in cross-sectional studies: An empirical comparison of models that directly estimate the prevalence ratio}}, journal={BMC Medical Research Methodology}, year={2003}, volume={3}, number={1}, eid={21}, doi={10.1186/1471-2288-3-21}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{kroenke2001phq9, author={Kroenke, Kurt and Spitzer, Robert L. and Williams, Janet B. W.}, title={{The PHQ-9: Validity of a brief depression severity measure}}, journal={Journal of General Internal Medicine}, year={2001}, volume={16}, number={9}, pages={606--613}, doi={10.1046/j.1525-1497.2001.016009606.x}}@article{savitz2023can, author={Savitz, David A. and Wellenius, Gregory A.}, title={{Can cross-sectional studies contribute to causal inference? It depends}}, journal={American Journal of Epidemiology}, year={2023}, volume={192}, number={4}, pages={514--516}, doi={10.1093/aje/kwac037}}@article{setia2016methodology, author={Setia, Maninder Singh}, title={{Methodology series module 3: Cross-sectional studies}}, journal={Indian Journal of Dermatology}, year={2016}, volume={61}, number={3}, pages={261--264}, doi={10.4103/0019-5154.182410}}@article{thompson1998prevalence, author={Thompson, M. L. and Myers, J. E. and Kriebel, D.}, title={{Prevalence odds ratio or prevalence ratio in the analysis of cross sectional data: What is to be done?}}, journal={Occupational and Environmental Medicine}, year={1998}, volume={55}, number={4}, pages={272--277}, doi={10.1136/oem.55.4.272}}@article{vandenbroucke2007strengthening, author={Vandenbroucke, Jan P. and von Elm, Erik and Altman, Douglas G. and Gøtzsche, Peter C. and Mulrow, Cynthia D. and Pocock, Stuart J. and Poole, Charles and Schlesselman, James J. and Egger, Matthias and {STROBE Initiative}}, title={{Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e297}, doi={10.1371/journal.pmed.0040297}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}@article{wang2020cross, author={Wang, Xiaofeng and Cheng, Zhenshun}, title={{Cross-sectional studies: Strengths, weaknesses, and recommendations}}, journal={Chest}, year={2020}, volume={158}, number={1}, pages={S65--S71}, doi={10.1016/j.chest.2020.03.012}}