Co to jest alignment?
Alignment (Asparouhov i Muthén, 2014) to sposób porównania średnich i wariancji czynnika w wielu grupach, gdy pełna inwariancja pomiaru nie jest spełniona. Klasyczna sekwencja (konfiguracyjna, metryczna, skalarna) przy kilkunastu krajach zwykle kończy się słabo dopasowanym modelem skalarnym i dziesiątkami indeksów modyfikacji. Alignment zastępuje żmudne uwalnianie parametrów jednym krokiem optymalizacji i zakłada inwariancję przybliżoną, a nie dokładną.
Jak działa
Punktem wyjścia jest model konfiguracyjny CFA ze średnią 0 i wariancją 1 w każdej grupie. Ma on tyle samo stopni swobody i to samo dopasowanie dla dowolnych średnich i SD czynnika, więc alignment wybiera takie, przy których różnice ładunków i wyrazów wolnych między grupami są najprostsze: duże w nielicznych parametrach, bliskie zera w pozostałych. Służy do tego funkcja straty, która mocniej „nagradza” zerowe różnice niż kara za kilka dużych. Robitzsch (2020) pokazał, że wybór tej funkcji odpowiada założeniom o wzorcu nieinwariancji i wpływa na oszacowane średnie.
Co odczytać
Średnie i SD czynnika względem grupy odniesienia, reszty parametrów (duża reszta to pozycja nieinwariantna w danej grupie, podobnie jak DIF) oraz R² inwariancji: część zmienności ładunków lub wyrazów wolnych między grupami wyjaśnioną różnicami czynnika. Im więcej parametrów nieinwariantnych, tym mniej wiarygodne porównanie.
Przykład
W 8 krajach po 400 osób (dane symulowane) pięć z 48 wyrazów wolnych i jeden ładunek różnią się od reszty. Model skalarny ma CFI = .92 i RMSEA = .158. Alignment daje R² = .997 dla ładunków i .798 dla wyrazów wolnych, a reszty około 0.6 wskazują dokładnie te pięć wyrazów wolnych. Średni błąd średnich wynosi 0.067 SD wobec 0.105 w modelu skalarnym, który zawyża kraje 2 i 7 (0.47 zamiast 0.21; 1.56 zamiast 1.29).
Na rysunku
Oba rysunki korzystają z danych z przykładu: 8 krajów, 6 pozycji, pięć nieinwariantnych wyrazów wolnych i jeden ładunek.
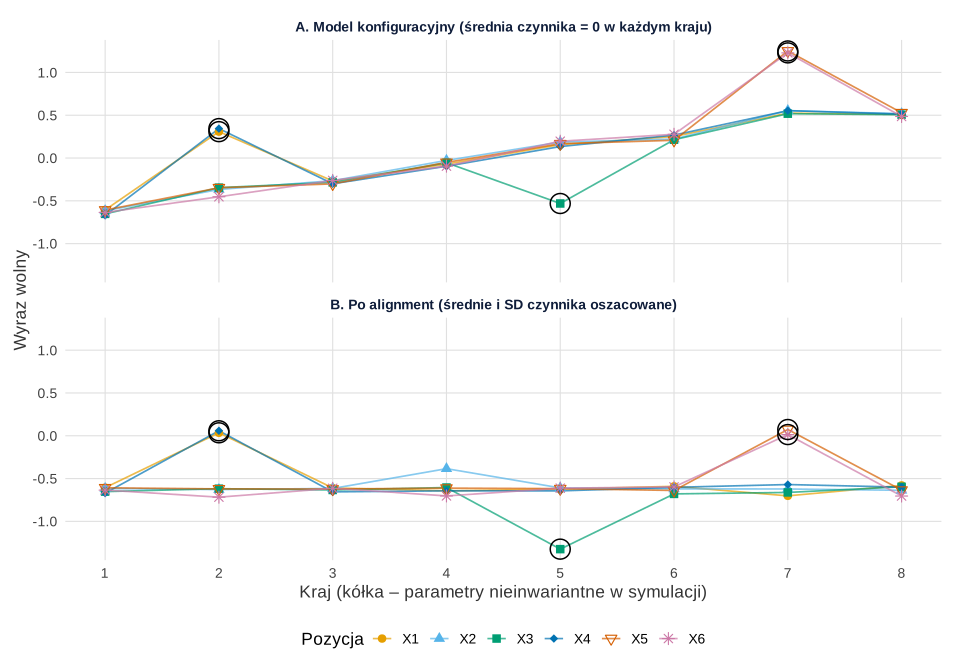
set.seed(7170)).Co widać. W modelu konfiguracyjnym (A) każdy kraj ma średnią czynnika równą 0. Różnice średnich między krajami trafiają więc do wyrazów wolnych i wszystkie linie razem rosną od kraju 1 do 8. Pięć nieinwariantnych parametrów (kółka) prawie ginie w tym wspólnym ruchu. Po alignment (B) 43 inwariantne wyrazy wolne leżą niemal na jednej linii: ich rozrzut (SD) spada z 0.399 do 0.050, a mediana wynosi −0.62. Pięć nieinwariantnych wyraźnie odstaje: cztery leżą przy zerze (0.01–0.07), jeden przy −1.32.
Na co uważać. Lekko odstaje też X2 w kraju 4 (−0.38), choć jego wyraz wolny jest inwariantny. To ślad nieinwariantnego ładunku, dlatego obok wyrazów wolnych trzeba oglądać reszty ładunków. W prawdziwych danych nie ma kółek. Alignment zakłada, że parametrów nieinwariantnych jest niewiele, i wskazuje je dopiero na podstawie tego założenia.
Podpis do pracy:
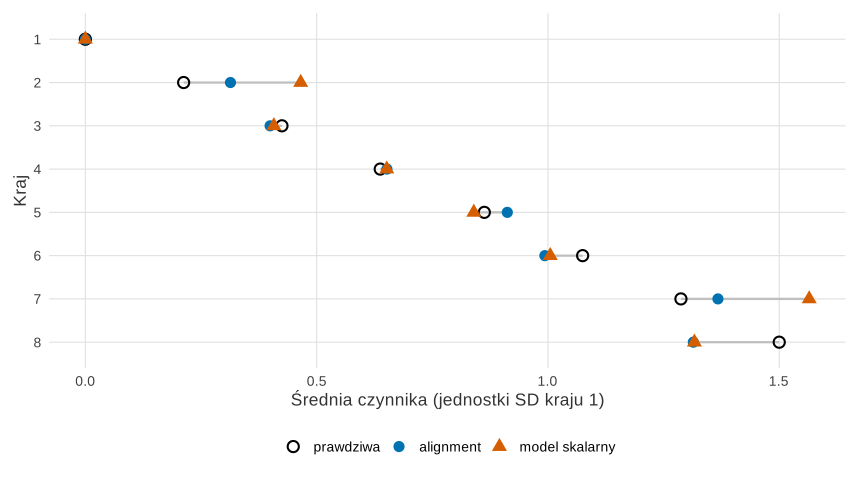
set.seed(7170)).Co widać. Ten wykres punktowy zestawia średnie czynnika z trzech źródeł. W krajach 2 i 7, gdzie są nieinwariantne wyrazy wolne, model skalarny zawyża średnie (0.47 i 1.56 wobec prawdziwych 0.21 i 1.29), a alignment jest bliżej (0.31 i 1.37). W pozostałych krajach obie metody dają podobne wyniki.
Na co uważać. W kraju 8 obie metody zaniżają średnią (1.31 i 1.32 wobec 1.50). Alignment usuwa skutki nieinwariancji, ale nie błąd losowy. Jedna symulowana próba nie mówi też, czy metoda jest obciążona – do tego potrzeba wielu powtórzeń.
Podpis do pracy:
Kod poniżej odtwarza oba rysunki i liczby z tych akapitów. Dane i ziarno 7170 są te same co w przykładzie (ziarno ustalone raz, niezmieniane); parametry nieinwariancji ustawiono ręcznie, tak jak tam. Kod definiuje sam paletę Okabe–Ito i motyw. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunków 1 i 2
# Rysunki 1–2. Wyrazy wolne przed alignment i po nim (1) oraz średnie czynnika: prawdziwe, z alignment i ze skalarnego (2)
suppressPackageStartupMessages({library(lavaan); library(sirt)})
library(ggplot2)
okabe <- c("#E69F00", "#56B4E9", "#009E73", "#0072B2", "#D55E00", "#CC79A7")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))

set.seed(7170)                                         # te same dane co w przykładzie hasła
G <- 8; n <- 400; I <- 6
alfa <- round(seq(-0.6, 0.6, length.out = G), 2)
psi  <- round(seq(0.8, 1.3, length.out = G), 2)
nu <- matrix(0, G, I); lam <- matrix(1, G, I)
nu[2, c(1, 4)] <- 0.7; nu[7, c(5, 6)] <- 0.7; nu[5, 3] <- -0.7
lam[4, 2] <- 0.6
dane <- do.call(rbind, lapply(1:G, function(g) {
  eta <- rnorm(n, alfa[g], psi[g])
  y <- sapply(1:I, function(i) nu[g, i] + lam[g, i] * eta + rnorm(n, 0, 0.6))
  data.frame(y, kraj = g)
}))
model <- "f =~ X1 + X2 + X3 + X4 + X5 + X6"
konf <- cfa(model, dane, group = "kraj", std.lv = TRUE, meanstructure = TRUE)
skal <- cfa(model, dane, group = "kraj", group.equal = c("loadings", "intercepts"))
est <- lavInspect(konf, "est")
L <- t(sapply(est, function(e) e$lambda[, 1]))
N <- t(sapply(est, function(e) e$nu[, 1]))
al <- invariance.alignment(lambda = L, nu = N)

# Rysunek 1: wyrazy wolne (kraj × pozycja) w modelu konfiguracyjnym i po alignment
dlugi <- function(M, etap) data.frame(etap = etap, kraj = rep(1:G, I), pozycja = rep(paste0("X", 1:I), each = G),
                                      nu = as.vector(M), nieinw = as.vector(nu != 0))
w1 <- rbind(dlugi(N, "A. Model konfiguracyjny (średnia czynnika = 0 w każdym kraju)"),
            dlugi(al$nu.aligned, "B. Po alignment (średnie i SD czynnika oszacowane)"))
round(c(sd_inwariantnych_przed = sd(N[nu == 0]), sd_inwariantnych_po = sd(al$nu.aligned[nu == 0]),
        mediana_inwariantnych_po = median(al$nu.aligned[nu == 0])), 3)   # rozrzut 43 parametrów inwariantnych
round(al$nu.aligned[nu != 0], 2)    # 5 nieinwariantnych po alignment: kraj 2 X1, kraj 5 X3, kraj 2 X4, kraj 7 X5, X6
round(al$nu.aligned[4, 2], 2)       # X2 w kraju 4: inny ładunek przesuwa też wyraz wolny
p1 <- ggplot(w1, aes(kraj, nu, colour = pozycja, shape = pozycja, group = pozycja)) +
  geom_line(linewidth = 0.6, alpha = 0.7) +
  geom_point(size = 2.6) +
  geom_point(data = subset(w1, nieinw), shape = 1, size = 6.5, colour = "black", stroke = 0.8) +
  facet_wrap(~ etap, ncol = 1) +
  scale_colour_manual(values = okabe, name = "Pozycja") +
  scale_shape_manual(values = c(16, 17, 15, 18, 25, 8), name = "Pozycja") +
  scale_x_continuous(breaks = 1:G) +
  guides(colour = guide_legend(nrow = 1), shape = guide_legend(nrow = 1)) +
  labs(x = "Kraj (kółka – parametry nieinwariantne w symulacji)", y = "Wyraz wolny") +
  motyw

# Rysunek 2: średnie czynnika względem kraju 1 (w jednostkach SD kraju 1)
m_skal <- sapply(lavInspect(skal, "mean.lv"), `[`, 1) / sqrt(lavInspect(skal, "cov.lv")[[1]][1, 1])
w2 <- data.frame(kraj = rep(1:G, 3),
                 metoda = factor(rep(c("prawdziwa", "alignment", "model skalarny"), each = G),
                                 levels = c("prawdziwa", "alignment", "model skalarny")),
                 srednia = c((alfa - alfa[1]) / psi[1], al$pars$alpha0, m_skal))
round(xtabs(srednia ~ kraj + metoda, w2), 2)
p2 <- ggplot(w2, aes(srednia, factor(kraj, levels = G:1), colour = metoda, shape = metoda)) +
  geom_line(aes(group = kraj), colour = "grey75", linewidth = 0.8) +
  geom_point(size = 3.2, stroke = 1.1) +
  scale_colour_manual(values = c("black", "#0072B2", "#D55E00"), name = NULL) +
  scale_shape_manual(values = c(1, 16, 17), name = NULL) +
  labs(x = "Średnia czynnika (jednostki SD kraju 1)", y = "Kraj") +
  motyw
p1   # zapis: ggsave("niezmiennosc-pomiaru-alignment-wyrazy-wolne.svg", p1, width = 10, height = 7)
p2   # zapis: ggsave("niezmiennosc-pomiaru-alignment-srednie.svg", p2, width = 9, height = 5)
Wynik w R
  sd_inwariantnych_przed      sd_inwariantnych_po mediana_inwariantnych_po
                   0.399                    0.050                   -0.621
[1]  0.03 -1.32  0.06  0.07  0.01
[1] -0.38
    metoda
kraj prawdziwa alignment model skalarny
   1      0.00      0.00           0.00
   2      0.21      0.31           0.47
   3      0.42      0.40           0.41
   4      0.64      0.65           0.65
   5      0.86      0.91           0.84
   6      1.07      0.99           1.00
   7      1.29      1.37           1.56
   8      1.50      1.31           1.32
Jak opisać w pracy
Na co uważać
- Model konfiguracyjny musi pasować. Alignment nie poprawia złej struktury czynnikowej.
- Grupy stałe a losowe. Muthén i Asparouhov (2018) zestawiają alignment (grupy jako stały czynnik) z modelem dwupoziomowym z losowymi ładunkami i wyrazami wolnymi, wygodnym przy bardzo wielu grupach.
- Kompozyty to inna procedura. W PLS-SEM stosuje się MICOM.
Klasyczną sekwencję testów i inwariancję częściową opisuje wpis Inwariancja pomiaru krok po kroku.
Alignment w R
Kod symuluje 8 grup z częściową nieinwariancją, dopasowuje w lavaan model konfiguracyjny i skalarny, przekazuje ładunki i wyrazy wolne do sirt::invariance.alignment() i porównuje średnie z prawdziwymi. Liczby w tekście pochodzą z tego kodu.
Alignment na parametrach modelu konfiguracyjnego
R
set.seed(7170)
suppressPackageStartupMessages({library(lavaan); library(sirt)})
G <- 8; n <- 400; I <- 6                              # 8 krajów, po 400 osób, 6 pozycji
alfa <- round(seq(-0.6, 0.6, length.out = G), 2)       # prawdziwe średnie czynnika
psi  <- round(seq(0.8, 1.3, length.out = G), 2)        # prawdziwe SD czynnika
nu <- matrix(0, G, I); lam <- matrix(1, G, I)
nu[2, c(1, 4)] <- 0.7; nu[7, c(5, 6)] <- 0.7; nu[5, 3] <- -0.7  # 5 nieinwariantnych wyrazów wolnych
lam[4, 2] <- 0.6                                       # i jednym ładunkiem
dane <- do.call(rbind, lapply(1:G, function(g) {
  eta <- rnorm(n, alfa[g], psi[g])
  y <- sapply(1:I, function(i) nu[g, i] + lam[g, i] * eta + rnorm(n, 0, 0.6))
  data.frame(y, kraj = g)
}))
model <- "f =~ X1 + X2 + X3 + X4 + X5 + X6"
konf <- cfa(model, dane, group = "kraj", std.lv = TRUE, meanstructure = TRUE)
skal <- cfa(model, dane, group = "kraj", group.equal = c("loadings", "intercepts"))
round(rbind(konfiguracyjny = fitMeasures(konf, c("cfi", "rmsea")),
            skalarny = fitMeasures(skal, c("cfi", "rmsea"))), 3)
est <- lavInspect(konf, "est")
L <- t(sapply(est, function(e) e$lambda[, 1]))         # ładunki: kraje x pozycje
N <- t(sapply(est, function(e) e$nu[, 1]))             # wyrazy wolne
al <- invariance.alignment(lambda = L, nu = N)        # domyślna funkcja straty jak w Mplus
round(al$es.invariance, 3)                             # R2: odsetek zmienności wchłonięty przez czynnik
m_skal <- sapply(lavInspect(skal, "mean.lv"), `[`, 1)  # średnie z modelu skalarnego
wyn <- data.frame(prawdziwa = (alfa - alfa[1]) / psi[1], alignment = al$pars$alpha0,
                  skalarny = m_skal / sqrt(lavInspect(skal, "cov.lv")[[1]][1, 1]),
                  sd_prawd = psi / psi[1], sd_align = al$pars$psi0)
round(wyn, 2)                          # średnie w jednostkach SD kraju 1 (odniesienie: 0 i 1)
round(c(blad_align = mean(abs(wyn$alignment - wyn$prawdziwa)),
        blad_skalarny = mean(abs(wyn$skalarny - wyn$prawdziwa))), 3)
round(al$nu.resid, 2)                                  # duże reszty = parametry nieinwariantne
Wynik w R
                cfi rmsea
konfiguracyjny 1.00 0.012
skalarny       0.92 0.158
       loadings intercepts
R2        0.997      0.798
sqrtU2    0.055      0.450
rbar     -0.016      0.072
    prawdziwa alignment skalarny sd_prawd sd_align
1.f      0.00      0.00     0.00     1.00     1.00
2.f      0.21      0.31     0.47     1.09     1.08
3.f      0.42      0.40     0.41     1.17     1.10
4.f      0.64      0.65     0.65     1.26     1.19
5.f      0.86      0.91     0.84     1.36     1.28
6.f      1.07      0.99     1.00     1.45     1.33
7.f      1.29      1.37     1.56     1.54     1.44
8.f      1.50      1.31     1.32     1.62     1.42
   blad_align blad_skalarny
        0.067         0.105
     X1    X2    X3    X4    X5    X6
1 -0.07 -0.02  0.07 -0.13 -0.07 -0.06
2  0.57 -0.04  0.10  0.60 -0.09 -0.15
3 -0.07 -0.02  0.09 -0.11 -0.09 -0.04
4 -0.10  0.21  0.12 -0.10 -0.08 -0.13
5 -0.08 -0.02 -0.60 -0.10 -0.08 -0.04
6 -0.05 -0.03  0.04 -0.06 -0.10 -0.03
7 -0.16 -0.03  0.06 -0.03  0.61  0.59
8 -0.04 -0.05  0.13 -0.06 -0.10 -0.13
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety lavaan i sirt). Rysunki 1 i 2 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- sirt (wersja 4.2-133): Robitzsch, A. (2025). sirt: Supplementary item response theory models (R package version 4.2-133) [Computer software]. https://doi.org/10.32614/CRAN.package.sirt
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy użyć alignment zamiast klasycznego testu inwariancji?
Gdy grup jest dużo (np. kilkanaście krajów), model skalarny jest słabo dopasowany, a indeksów modyfikacji jest tyle, że ręczne uwalnianie parametrów staje się zgadywaniem. Przy dwóch–trzech grupach zwykle wystarczy klasyczna sekwencja i inwariancja częściowa.
Co oznacza R² w wynikach alignment?
R² dla ładunków i wyrazów wolnych mówi, jaką część zmienności tych parametrów między grupami wyjaśniają różnice średnich i wariancji czynnika. Wartość bliska 1 oznacza niemal pełną inwariancję, niższa – że część różnic tkwi w samych pozycjach.
Czy alignment zastępuje sprawdzenie dopasowania modelu?
Nie. Alignment ma takie samo dopasowanie jak model konfiguracyjny, więc ten model musi być dobrze dopasowany w każdej grupie. Metoda nie naprawia złej struktury czynnikowej, tylko pozwala porównać średnie przy drobnych różnicach parametrów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Inwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikNiezmienność skali marki w trzech krajach
Zaufanie do marki w Polsce, Czechach i na Słowacji: wielogrupowa CFA, częściowa niezmienność, średnie latentne kontra sumy i symulacja – pięć rysunków z R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Asparouhov, T., & Muthén, B. (2014). Multiple-group factor analysis alignment. Structural Equation Modeling: A Multidisciplinary Journal, 21(4), 495–508. https://doi.org/10.1080/10705511.2014.919210
- Muthén, B., & Asparouhov, T. (2018). Recent methods for the study of measurement invariance with many groups: Alignment and random effects. Sociological Methods & Research, 47(4), 637–664. https://doi.org/10.1177/0049124117701488
- Robitzsch, A. (2020). Lp loss functions in invariance alignment and Haberman linking with few or many groups. Stats, 3(3), 246–283. https://doi.org/10.3390/stats3030019 ● Otwarty dostęp
Cytowania BibTeX
@article{asparouhov2014multiple, author={Asparouhov, Tihomir and Muthén, Bengt}, title={{Multiple-group factor analysis alignment}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2014}, volume={21}, number={4}, pages={495--508}, doi={10.1080/10705511.2014.919210}}@article{muthen2018recent, author={Muthén, Bengt and Asparouhov, Tihomir}, title={{Recent methods for the study of measurement invariance with many groups: Alignment and random effects}}, journal={Sociological Methods \& Research}, year={2018}, volume={47}, number={4}, pages={637--664}, doi={10.1177/0049124117701488}}@article{robitzsch2020lp, author={Robitzsch, Alexander}, title={{Lp loss functions in invariance alignment and Haberman linking with few or many groups}}, journal={Stats}, year={2020}, volume={3}, number={3}, pages={246--283}, doi={10.3390/stats3030019}}