Dwa pytania o każdą zmienną
Zmienna to cecha, która przyjmuje różne wartości u różnych osób albo w różnych sytuacjach: poziom stresu, płeć, wynik testu, warunek eksperymentalny. W pracy dyplomowej o każdej zmiennej trzeba odpowiedzieć na dwa niezależne pytania. Jaką rolę pełni w Twoim modelu? I na jakiej skali jest mierzona? Pierwsza odpowiedź mówi, gdzie zmienna stoi w hipotezie i na rysunku modelu. Druga mówi, jakie statystyki i testy w ogóle mają do niej sens.
Rola nie jest cechą samej zmiennej. Ta sama kolumna w danych, np. zamartwianie się przed snem, może być w jednym badaniu wynikiem, w drugim mechanizmem, a w trzecim warunkiem, od którego zależy siła związku. O roli decyduje pytanie badawcze i teoria, nie program statystyczny. Jak przejść od tematu do pytań i hipotez, opisuje wpis pytania badawcze i hipotezy, a jak zamienić pojęcie w mierzalną zmienną – wpis co to jest operacjonalizacja. Tu zajmujemy się tym, co dzieje się pomiędzy: nazwaniem ról i ich skutkami dla analizy.
Zmienna zależna i niezależna
Zmienna zależna (dependent variable, w skrócie Y) to wynik, który chcesz wyjaśnić albo przewidzieć: jakość snu, wynik egzaminu, nasilenie objawów. Zmienna niezależna (X) to czynnik, którego związek z wynikiem badasz. W eksperymencie badacz sam ustala jej wartości, czyli przeprowadza manipulację eksperymentalną i losowo przydziela osoby do warunków. Dopiero taki plan pozwala mówić o wpływie przyczynowym (Shadish i in., 2002).
W badaniu ankietowym nikt niczym nie manipuluje. Zmienną „niezależną” nazywa się wtedy umownie zmienną, która w modelu stoi po stronie wyjaśniającej. Bezpieczniejsze nazwy to predyktor i zmienna wyjaśniana (kryterium), a w wynikach – „wiąże się z”, a nie „wpływa na”. Rola X i Y wynika z hipotezy, nie z danych: korelacja stresu ze snem wygląda tak samo, niezależnie od tego, którą zmienną nazwiesz zależną.
Mediator i moderator
Baron i Kenny (1986) zwrócili uwagę, że badacze używają tych dwóch pojęć zamiennie, choć opisują zupełnie inne zjawiska. Kraemer i in. (2002) ujmują różnicę krótko: moderator mówi, u kogo i w jakich warunkach efekt jest inny, a mediator – dlaczego i jak efekt powstaje.
- Mediator (M) leży na drodze od X do Y: X wpływa na M, a M na Y. Stres nasila zamartwianie się przed snem, a zamartwianie pogarsza sen. Pytanie badawcze brzmi „przez co?”. Analizuje się je jako mediację, a kluczowym wynikiem jest efekt pośredni ab z przedziałem ufności z bootstrapu (Hayes, 2022).
- Moderator (W) zmienia siłę albo kierunek związku X z Y. Stres może silniej pogarszać sen u osób z małym wsparciem społecznym niż u osób z dużym. Pytanie brzmi „kiedy?” albo „u kogo?”. Analizuje się je jako moderację, czyli regresję z efektem interakcji X × W.
Z tej różnicy wynikają wymagania wobec planu badania. Mediator musi pojawić się w czasie po X, a przed Y. Gdy wszystko mierzysz jedną ankietą, model mediacji opisuje układ korelacji, a nie proces. Maxwell i Cole (2007) pokazali, że przekrojowe analizy mediacji dają zwykle wyraźnie obciążone oszacowania procesu rozłożonego w czasie. Moderator z kolei powinien być cechą, której X nie zmienia: płcią, cechą osobowości, warunkiem zmierzonym przed interwencją. Kraemer i in. (2002) opisują tę ramę dla badań klinicznych z randomizacją.
Obie analizy krok po kroku pokazują wpisy analiza mediacji krok po kroku i analiza moderacji krok po kroku. Tu wystarczy zapamiętać, że to dwa różne modele, a nie dwie nazwy tego samego. Przykład w R w dalszej części wpisu pokazuje to na liczbach.
Zmienna kontrolna, zakłócająca i zderzeniowa
Zmienna zakłócająca (confounder) to wspólna przyczyna X i Y. Jeśli praca zarobkowa zwiększa stres i jednocześnie skraca sen, część korelacji stresu ze snem wynika z pracy, a nie ze stresu. Zmienna kontrolna to zmienna, którą dodajesz do modelu właśnie po to, żeby usunąć takie zakłócenie. Zakłócająca to więc rola w świecie, a kontrolna – decyzja w analizie.
Ta decyzja wymaga uzasadnienia. Spector i Brannick (2011) nazywają automatyczne dorzucanie zmiennych kontrolnych „metodologiczną miejską legendą”: te same wyniki mogą powstać przez różne mechanizmy, więc dla każdej zmiennej kontrolnej trzeba jawnie określić jej rolę. Wysocki i in. (2022) dodają, że przy źle dobranych zmiennych kontrolnych oszacowanie bywa bardziej obciążone niż bez nich. Dlatego zmienne kontrolne dobiera się według założonej struktury przyczynowej. Najczęstszy przypadek, wiek i płeć, omawia wpis czy kontrolować wiek i płeć.
Dwóch rodzajów zmiennych nie kontroluje się, gdy pytasz o efekt całkowity X. Pierwszy to mediator: kontrola zamartwiania „zabiera” stresowi tę część związku, która przez zamartwianie przechodzi. Drugi to zmienna zderzeniowa, czyli wspólny skutek X i Y. Warunkowanie na niej, przez kontrolę albo dobór próby, tworzy pozorny związek (Elwert i Winship, 2014). Jak rozpoznać te sytuacje na rysunku, pokazuje wpis o grafach przyczynowych DAG.
Skale pomiaru
Drugie pytanie dotyczy poziomu pomiaru. Klasyczny podział Stevensa (1946) wyróżnia cztery skale. Każda kolejna ma wszystkie własności poprzedniej i jedną więcej.
| Skala | Co mówią liczby | Przykład | Typowe statystyki |
|---|---|---|---|
| Nominalna | tylko „takie samo – inne” | kierunek studiów, płeć, warunek eksperymentalny | n (%), dominanta, chi-kwadrat |
| Porządkowa | kolejność, bez równych odstępów | wykształcenie, ranking, pojedyncza pozycja „zdecydowanie nie – zdecydowanie tak” | mediana, kwartyle, testy rangowe, korelacja Spearmana |
| Interwałowa | równe odstępy, umowne zero | temperatura w °C, wynik standaryzowany | M, SD, korelacja Pearsona, regresja |
| Ilorazowa | równe odstępy i prawdziwe zero | czas reakcji, liczba godzin snu, wiek | jak wyżej oraz ilorazy („dwa razy dłużej”) |
Podział jest przydatny, ale nie działa jak automat do wyboru testu. Velleman i Wilkinson (1993) pokazują, że typ skali zależy od pytania badawczego i wiedzy o danych, a sztywne przepisy prowadzą do niepotrzebnego rangowania danych. Najczęstszy spór dotyczy skali Likerta: pojedyncza pozycja jest porządkowa, a średnia z kilku pozycji jest zwykle traktowana jak zmienna ilościowa. Argumenty obu stron zbiera wpis czy skala Likerta jest ilościowa.
Rodzaj zmiennej a analiza: tabela zbiorcza
Poniższa tabela łączy role z poprzednich sekcji z decyzjami w analizie. Przykłady pochodzą z jednego tematu: stres a jakość snu u osób studiujących.
| Rodzaj zmiennej | Przykład | Co to oznacza dla analizy |
|---|---|---|
| Zależna (Y) | jakość snu, wynik ogólny kwestionariusza | stoi po lewej stronie modelu; jej skala wyznacza rodzaj analizy (regresja liniowa, logistyczna, porządkowa) |
| Niezależna (X) | warunek: trening relaksacji albo lista oczekujących; poziom stresu w ankiecie | w eksperymencie – porównanie grup i wniosek przyczynowy; w ankiecie – predyktor i język związku |
| Mediator (M) | zamartwianie się przed snem | dwa równania (X → M, X + M → Y); efekt pośredni ab z CI z bootstrapu; najlepiej pomiar w czasie między X a Y |
| Moderator (W) | wsparcie społeczne, płeć | jedno równanie z iloczynem X × W; centrowanie zmiennych ciągłych, efekty proste, wykres interakcji |
| Kontrolna | praca zarobkowa, wiek | dodana do modelu z uzasadnieniem przyczynowym; wynik z kontrolą i bez niej |
| Zakłócająca | praca zarobkowa wpływająca na stres i sen | jeśli zmierzona – kontroluj; jeśli nie – opisz jako ograniczenie wniosków |
| Zderzeniowa | korzystanie z poradni (skutek stresu i złego snu) | nie kontroluj i nie dobieraj próby według niej |
Gdy znasz już rolę i skalę każdej zmiennej, wybór testu sprowadza się do kilku pytań. Przeprowadzi Cię przez nie kreator doboru testu statystycznego. Jak narysować całość jako schemat z hipotezami H1–H3, pokazuje wpis model badawczy – schemat hipotez.
Przykład: ta sama zmienna jako mediator i jako moderator
Załóżmy, że badasz 240 osób studiujących (dane symulowane). Mierzysz stres akademicki (średnia z pozycji 1–5; M = 2.96, SD = 0.72), zamartwianie się przed snem (1–5; M = 2.72, SD = 0.72) i jakość snu w skali 0–21, gdzie więcej punktów oznacza gorszy sen (M = 6.80, SD = 2.82). Dane wygenerowano tak, że zamartwianie pośredniczy między stresem a snem. Efekt całkowity stresu wynosi b = 1.59, SE = 0.23, t(238) = 6.80, p < .001.
Model 1: zamartwianie jako mediator. Stres wiąże się z zamartwianiem (a = 0.54, SE = 0.05, p < .001), a zamartwianie ze snem przy stałym stresie (b = 1.33, SE = 0.26, p < .001). Efekt pośredni wynosi ab = 0.72, 95% CI [0.40, 1.07] (bootstrap percentylowy, 5000 prób), a efekt bezpośredni c′ = 0.87, p = .001. Przez zamartwianie przechodzi więc 45.4% efektu całkowitego.
Model 2: zamartwianie jako moderator. Interakcja stres × zamartwianie (oba predyktory wycentrowane) jest bliska zera: b = 0.15, SE = 0.29, t(236) = 0.52, p = .606, 95% CI [−0.42, 0.72]. Dodanie iloczynu zwiększa R² z .244 do .245. Wniosek z tego modelu brzmi: siła związku stresu ze snem nie zależy od poziomu zamartwiania.
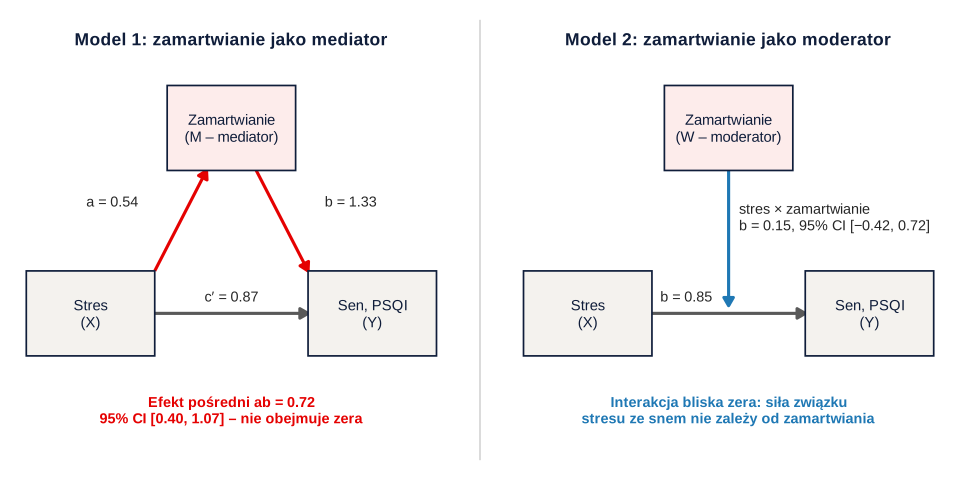
Oba modele są poprawne statystycznie, ale odpowiadają na różne pytania. Model moderacji nie mówi nic o tym, że prawie połowa związku przechodzi przez zamartwianie. Współczynnik stresu w nim (b = 0.85) jest prawie taki sam jak efekt bezpośredni c′, bo zamartwianie siedzi w modelu jak zmienna kontrolna. Odwrotnie też bywa źle: brak efektu pośredniego nie wyklucza moderacji. Dane nie rozstrzygną, która rola jest właściwa – rozstrzyga ją teoria i kolejność pomiaru, zapisane przed analizą. Tu wiemy, że mediacja jest prawdziwa, bo sami wygenerowaliśmy dane. W prawdziwym badaniu przekrojowym ten sam wynik byłby tylko zgodny z mediacją.
Mediator a moderator w R
Kod używa tylko bazowego R. Mediację liczy dwoma modelami lm(), a przedział ufności dla efektu pośredniego – bootstrapem percentylowym w funkcji zdefiniowanej w kodzie. Moderację liczy jednym modelem z iloczynem wycentrowanych predyktorów. W pracy możesz użyć pakietu lavaan albo makra PROCESS (Hayes, 2022), które dają te same oszacowania.
1. Zamartwianie jako mediator i jako moderator
R
# B233 – ta sama zmienna jako mediator i jako moderator: dwa różne modele
# Dane symulowane, set.seed(2331): 240 osób studiujących; stres akademicki (1–5),
# zamartwianie się przed snem (1–5) i jakość snu w PSQI (0–21, więcej = gorszy sen).
# Dane wygenerowano tak, że zamartwianie się POŚREDNICZY między stresem a snem.
set.seed(2331)
n <- 240
stres <- pmin(5, pmax(1, rnorm(n, 3.0, 0.7)))
zamartwianie <- pmin(5, pmax(1, 0.9 + 0.6 * stres + rnorm(n, 0, 0.6)))
psqi <- round(pmin(21, pmax(0, 0.5 + 0.7 * stres + 1.5 * zamartwianie + rnorm(n, 0, 2.4))))
dane <- data.frame(stres = round(stres, 2), zamartwianie = round(zamartwianie, 2), psqi)

# Krok 1. Opis i korelacje
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane), 2)

# Krok 2. Efekt całkowity stresu (bez trzeciej zmiennej)
round(coef(summary(lm(psqi ~ stres, data = dane))), 3)

# Krok 3. Zamartwianie jako MEDIATOR: stres -> zamartwianie -> sen
# Ścieżka a: stres -> zamartwianie; ścieżki b i c' (efekt bezpośredni): sen ~ stres + zamartwianie
m_a <- lm(zamartwianie ~ stres, data = dane)
m_b <- lm(psqi ~ stres + zamartwianie, data = dane)
round(rbind(a = coef(summary(m_a))["stres", ], b = coef(summary(m_b))["zamartwianie", ],
            c_prim = coef(summary(m_b))["stres", ]), 3)
efekt_posredni <- function(d) {
  unname(coef(lm(zamartwianie ~ stres, data = d))["stres"] *
         coef(lm(psqi ~ stres + zamartwianie, data = d))["zamartwianie"])
}
ab <- efekt_posredni(dane)
boot_ab <- replicate(5000, efekt_posredni(dane[sample(n, replace = TRUE), ]))
round(c(posredni_ab = ab, CI_dolna = quantile(boot_ab, .025, names = FALSE),
        CI_gorna = quantile(boot_ab, .975, names = FALSE), proporcja_posrednia = ab / coef(lm(psqi ~ stres, data = dane))[["stres"]]), 3)

# Krok 4. Zamartwianie jako MODERATOR: czy siła związku stresu ze snem zależy od zamartwiania?
dane$stres_c <- dane$stres - mean(dane$stres)
dane$zam_c <- dane$zamartwianie - mean(dane$zamartwianie)
mod <- lm(psqi ~ stres_c * zam_c, data = dane)
round(coef(summary(mod)), 3)
round(confint(mod)["stres_c:zam_c", ], 3)
round(c(R2 = summary(mod)$r.squared, R2_bez_interakcji = summary(lm(psqi ~ stres_c + zam_c, data = dane))$r.squared), 3)
Wynik w R
   stres zamartwianie psqi
M   2.96         2.72 6.80
SD  0.72         0.72 2.82
             stres zamartwianie psqi
stres         1.00         0.54 0.40
zamartwianie  0.54         1.00 0.46
psqi          0.40         0.46 1.00
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    2.104      0.710   2.964    0.003
stres          1.586      0.233   6.798    0.000
       Estimate Std. Error t value Pr(>|t|)
a         0.540      0.055   9.892    0.000
b         1.334      0.264   5.056    0.000
c_prim    0.866      0.264   3.282    0.001
        posredni_ab            CI_dolna            CI_gorna proporcja_posrednia
              0.720               0.405               1.066               0.454
              Estimate Std. Error t value Pr(>|t|)
(Intercept)      6.754      0.178  37.874    0.000
stres_c          0.855      0.265   3.223    0.001
zam_c            1.329      0.264   5.028    0.000
stres_c:zam_c    0.150      0.291   0.517    0.606
 2.5 % 97.5 %
-0.423  0.723
               R2 R2_bez_interakcji
            0.245             0.244
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet stats); rysunek wykonano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Jak opisać zmienne w rozdziale metodologicznym
W rozdziale metod zmienne opisuje się zwykle w osobnym podrozdziale, przed narzędziami. Dla każdej podaj rolę, sposób pomiaru, zakres i kierunek wyniku oraz skalę. Hipotezy zapisz tymi samymi nazwami zmiennych. Miejsce tego podrozdziału w całym rozdziale pokazuje wpis rozdział metodologiczny – jak go napisać.
Ostatnie zdanie jest ważne przy każdej mediacji w badaniu przekrojowym. Komisja często pyta właśnie o to, skąd wiadomo, że mediator poprzedza wynik.
Najczęstsze błędy
- Mediator i moderator używane zamiennie, np. hipoteza o moderacji testowana analizą mediacji. Najpierw zapisz pytanie: „przez co?” czy „kiedy?” (Baron i Kenny, 1986).
- Rola wybrana po wynikach. Sprawdzenie obu modeli i opisanie tego, który „wyszedł”, to szukanie istotności. Rolę ustal przed analizą.
- Moderator, na który wpływa X. Jeśli stres zmienia wsparcie, wsparcie przestaje być czystym moderatorem i może być mediatorem.
- Kontrola mediatora albo zderzacza przy pytaniu o efekt całkowity. Zaniża efekt albo tworzy pozorny związek.
- Zmienne kontrolne „z przyzwyczajenia”, bez uzasadnienia, jaką ścieżkę mają zamknąć (Spector i Brannick, 2011).
- Język przyczynowy w badaniu ankietowym. Pisz „wiąże się”, „przewiduje”, a nie „wpływa”, chyba że zmienną niezależną manipulowano.
- Skala pomylona z rolą. Płeć może być zmienną niezależną, moderatorem albo kontrolną; to, że jest nominalna, mówi tylko, jak ją zakodować.
Plan całej analizy, od opisu zmiennych po testy hipotez, znajdziesz w przewodniku po statystyce w pracy dyplomowej. Jeśli chcesz, żeby ktoś sprawdził role zmiennych i dobór analiz w Twojej pracy, skorzystaj z oferty analizy statystyczne dla studentów.
Najczęstsze pytania
Czym różni się mediator od moderatora?
Mediator leży na drodze od X do Y i wyjaśnia, przez co X wiąże się z Y (np. stres → zamartwianie → sen). Moderator zmienia siłę lub kierunek związku X z Y i odpowiada na pytanie, kiedy albo u kogo efekt jest inny. Mediację bada się efektem pośrednim ab, a moderację – interakcją X × W w regresji (Baron i Kenny, 1986).
Czy ta sama zmienna może być mediatorem i moderatorem?
Ta sama kolumna w danych może pełnić różne role w różnych badaniach, ale w jednej hipotezie ma jedną rolę, ustaloną z teorii przed analizą. W przykładzie z tego wpisu zamartwianie jako mediator dało efekt pośredni 0.72, 95% CI [0.40, 1.07], a jako moderator – interakcję bliską zera. To dwa różne pytania, a nie dwa sposoby sprawdzenia tego samego.
Czym różni się zmienna kontrolna od zakłócającej?
Zmienna zakłócająca to wspólna przyczyna X i Y, która tworzy część ich związku. Zmienna kontrolna to zmienna, którą dodajesz do modelu, żeby to zakłócenie usunąć. Kontrola ma sens tylko z uzasadnieniem przyczynowym; kontrolowanie mediatora albo zmiennej zderzeniowej zniekształca wynik (Wysocki i in., 2022).
Jaka jest zmienna zależna i niezależna w badaniu ankietowym?
Zależna to wynik, który chcesz wyjaśnić (np. jakość snu), a niezależna – zmienna po stronie wyjaśniającej (np. stres). Ponieważ w ankiecie nikt nie manipuluje zmienną niezależną, lepiej nazywać ją predyktorem i pisać o związku, a nie o wpływie.
Na jakiej skali jest mierzona skala Likerta?
Pojedyncza pozycja Likerta jest porządkowa. Średnia albo suma z kilku pozycji jest zwykle traktowana jako zmienna ilościowa i analizowana średnimi, korelacją Pearsona czy regresją. Typ skali nie jest jednak sztywnym przepisem na test: zależy też od pytania badawczego (Velleman i Wilkinson, 1993).
Powiązane hasła
Przeczytaj też
Model badawczy – schemat hipotez
Prostokąty i strzałki, mediator na ścieżce, moderator strzałką na strzałkę, zmienne kontrolne i hipotezy H1–Hn – z trzema wzorami rysunków i wskazówką, jaką analizą sprawdzić model.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →Nie wiesz, czy Twoja zmienna to mediator, moderator czy zmienna kontrolna?
Sprawdzimy role zmiennych w Twoim modelu, zapis hipotez i dobór analiz oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baron, R. M., & Kenny, D. A. (1986). The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Elwert, F., & Winship, C. (2014). Endogenous selection bias: The problem of conditioning on a collider variable. Annual Review of Sociology, 40(1), 31–53. https://doi.org/10.1146/annurev-soc-071913-043455 ● Otwarty dostęp
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Kraemer, H. C., Wilson, G. T., Fairburn, C. G., & Agras, W. S. (2002). Mediators and moderators of treatment effects in randomized clinical trials. Archives of General Psychiatry, 59(10), 877–883. https://doi.org/10.1001/archpsyc.59.10.877
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989x.12.1.23
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Spector, P. E., & Brannick, M. T. (2011). Methodological urban legends: The misuse of statistical control variables. Organizational Research Methods, 14(2), 287–305. https://doi.org/10.1177/1094428110369842
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Velleman, P. F., & Wilkinson, L. (1993). Nominal, ordinal, interval, and ratio typologies are misleading. The American Statistician, 47(1), 65–72. https://doi.org/10.1080/00031305.1993.10475938
- Wysocki, A. C., Lawson, K. M., & Rhemtulla, M. (2022). Statistical control requires causal justification. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095823. https://doi.org/10.1177/25152459221095823 ● Otwarty dostęp
Cytowania BibTeX
@article{baron1986moderator, author={Baron, Reuben M. and Kenny, David A.}, title={{The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations}}, journal={Journal of Personality and Social Psychology}, year={1986}, volume={51}, number={6}, pages={1173--1182}, doi={10.1037/0022-3514.51.6.1173}}@article{elwert2014endogenous, author={Elwert, Felix and Winship, Christopher}, title={{Endogenous selection bias: The problem of conditioning on a collider variable}}, journal={Annual Review of Sociology}, year={2014}, volume={40}, number={1}, pages={31--53}, doi={10.1146/annurev-soc-071913-043455}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@article{kraemer2002mediators, author={Kraemer, Helena Chmura and Wilson, G. Terence and Fairburn, Christopher G. and Agras, W. Stewart}, title={{Mediators and moderators of treatment effects in randomized clinical trials}}, journal={Archives of General Psychiatry}, year={2002}, volume={59}, number={10}, pages={877--883}, doi={10.1001/archpsyc.59.10.877}}@article{maxwell2007bias, author={Maxwell, Scott E. and Cole, David A.}, title={{Bias in cross-sectional analyses of longitudinal mediation}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={23--44}, doi={10.1037/1082-989x.12.1.23}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{spector2011methodological, author={Spector, Paul E. and Brannick, Michael T.}, title={{Methodological urban legends: The misuse of statistical control variables}}, journal={Organizational Research Methods}, year={2011}, volume={14}, number={2}, pages={287--305}, doi={10.1177/1094428110369842}}@article{stevens1946theory, author={Stevens, S. S.}, title={{On the theory of scales of measurement}}, journal={Science}, year={1946}, volume={103}, number={2684}, pages={677--680}, doi={10.1126/science.103.2684.677}}@article{velleman1993nominal, author={Velleman, Paul F. and Wilkinson, Leland}, title={{Nominal, ordinal, interval, and ratio typologies are misleading}}, journal={The American Statistician}, year={1993}, volume={47}, number={1}, pages={65--72}, doi={10.1080/00031305.1993.10475938}}@article{wysocki2022statistical, author={Wysocki, Anna C. and Lawson, Katherine M. and Rhemtulla, Mijke}, title={{Statistical control requires causal justification}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095823}, doi={10.1177/25152459221095823}}