Dlaczego w badaniu jakościowym nie ma wzoru na liczebność
W badaniu ilościowym liczebność wynika z celu statystycznego: chcesz oszacować odsetek z określoną dokładnością albo wykryć efekt z określoną mocą. Pokazujemy to w poradniku dobór liczebności próby i w kalkulatorze liczebności próby, a w wersji dla licencjatu – we wpisie ile osób do ankiety. W wywiadach takiego celu nie ma. Nie szacujesz parametru populacji, tylko szukasz zróżnicowania doświadczeń i ich znaczeń. Dlatego uczestników wybierasz celowo (dobór celowy), a nie losowo, a „za mała próba” znaczy co innego niż w ankiecie.
Nie oznacza to, że liczba wywiadów jest dowolna. Recenzent i promotor zapytają, dlaczego wywiadów jest 12, a nie 6 albo 30. Vasileiou i in. (2018) przeanalizowali badania wywiadowe z trzech czasopism o zdrowiu z 15 lat. Uzasadnienie liczebności pojawiało się rzadko, a jeśli już, to zwykle jako powołanie się na nasycenie albo na względy praktyczne. Liczebności często bez uzasadnienia nazywano „małymi” i opisywano jako ograniczenie. Ten wpis pokazuje, jak zrobić to lepiej.
Co to jest nasycenie i skąd się wzięło
Nasycenie (saturacja) to moment, w którym kolejne dane nie wnoszą już nic nowego do analizy. Pojęcie wywodzi się z teorii ugruntowanej. Tam oznacza nasycenie kategorii teoretycznych i łączy się z doborem teoretycznym: kolejnych uczestników wybierasz na podstawie tego, czego jeszcze brakuje w powstającej teorii. Z czasem termin przeszedł do niemal wszystkich badań jakościowych i stracił ostrość.
Saunders i in. (2018) wyróżniają cztery podejścia do nasycenia. Różnią się tym, czy rozumowanie jest bardziej indukcyjne, czy dedukcyjne, i czy nacisk pada na zbieranie danych, na ich analizę, czy na budowanie teorii. Autorzy zwracają uwagę na słabość logiczną tego pojęcia. Nasycenie to przewidywanie o tym, czego nie zaobserwowano, na podstawie tego, co już zaobserwowano. Zalecają, by rozumieć je zgodnie z pytaniem badawczym, stanowiskiem teoretycznym i przyjętą metodą analizy. W pracy nie wystarczy więc napisać „prowadzono wywiady do nasycenia”. Trzeba powiedzieć, jakiego nasycenia i jak je oceniano.
Nasycenie kodów a nasycenie znaczeń
Hennink, Kaiser i Marconi (2017) przeanalizowali 25 wywiadów pogłębionych i porównali dwa sposoby oceny nasycenia:
- Nasycenie kodów (code saturation) to moment, w którym przestają pojawiać się nowe kody, czyli znasz już zakres poruszanych spraw. W ich danych nastąpiło po 9 wywiadach.
- Nasycenie znaczeń (meaning saturation) to moment, w którym rozumiesz te sprawy w pełni: ich odmiany, warunki i powiązania. Wymagało od 16 do 24 wywiadów.
Autorzy podsumowują to tak: nasycenie kodów mówi, że badacz „usłyszał wszystko”, a nasycenie znaczeń – że „wszystko zrozumiał”. Dla pracy dyplomowej wniosek jest praktyczny. Jeśli Twoim celem jest zrozumienie, a nie lista tematów, nie kończ zbierania danych w chwili, gdy przestały pojawiać się nowe kody. O tym, jak powstają kody, piszemy w haśle kodowanie otwarte, osiowe i selektywne.
Co pokazały badania empiryczne nad nasyceniem
Poniższe liczby to wyniki konkretnych badań na konkretnych danych, a nie normy. Każde z nich miało określoną populację, temat i sposób kodowania.
| Badanie | Materiał | Wynik | Na co uważać |
|---|---|---|---|
| Guest, Bunce i Johnson (2006) | 60 wywiadów pogłębionych z kobietami w dwóch krajach Afryki Zachodniej | Nasycenie w pierwszych 12 wywiadach; zręby metatematów już po 6 | Wynik z jednego zbioru danych o określonej populacji |
| Hennink, Kaiser i Marconi (2017) | 25 wywiadów pogłębionych | Nasycenie kodów po 9 wywiadach, nasycenie znaczeń po 16–24 | Wynik zależy od tego, które nasycenie oceniasz |
| Francis i in. (2010) | Dwa badania wywiadowe oparte na teorii planowanego zachowania | Reguła: 10 wywiadów do analizy wstępnej, potem stop po 3 kolejnych bez nowych idei; w drugim badaniu nasycenie po 17. wywiadzie | W pierwszym badaniu nasycenia nie osiągnięto dla wszystkich kategorii |
| Hennink i Kaiser (2022) | Przegląd systematyczny 23 badań nad nasyceniem | Badania na danych empirycznych: 9–17 wywiadów lub 4–8 wywiadów grupowych | Dotyczy głównie jednorodnych grup, wąskich celów i nasycenia kodów |
Hennink i Kaiser (2022) piszą wprost, że badania wielokrajowe, metatematy i nasycenie znaczeń wymagały większych prób. Te liczby pomagają oszacować liczebność przed badaniem, ale tylko razem z cechami Twojego projektu. Liczbę wywiadów grupowych omawiamy osobno we wpisie o zogniskowanym wywiadzie grupowym (FGI).
Moc informacyjna: ile wnosi każdy uczestnik
Malterud, Siersma i Guassora (2016) proponują zamiast nasycenia pojęcie mocy informacyjnej (information power). Zasada jest prosta: im więcej informacji istotnych dla pytania badawczego niesie próba, tym mniej uczestników potrzebujesz. Moc informacyjna zależy od pięciu elementów: celu badania, specyficzności próby, wykorzystania ugruntowanej teorii, jakości dialogu i strategii analizy. Model służy zarówno do planowania, jak i do oceny liczebności w trakcie zbierania danych.
Tabela pokazuje, jak zastosować tę zasadę w praktyce. Kierunki wynikają z ogólnej reguły autorów, a przykłady są fikcyjne.
| Element | Pytanie kontrolne | Przykład fikcyjny: mniej wywiadów | Przykład fikcyjny: więcej wywiadów |
|---|---|---|---|
| Cel badania | Jak szerokie jest pytanie? | Doświadczenie pierwszego dyżuru nocnego u stażystów pielęgniarstwa | „Jak studenci przeżywają studia?” |
| Specyficzność próby | Czy uczestnicy mają dokładnie to doświadczenie? | Sami pracujący na nocnych zmianach | Studenci „w ogóle”, część bez badanego doświadczenia |
| Teoria | Czy analizę prowadzi gotowa rama? | Kodowanie według przyjętego modelu stresu | Badanie eksploracyjne bez ramy |
| Jakość dialogu | Czy rozmowy są bogate? | Doświadczony rozmówca, dobry kontakt | Krótkie odpowiedzi, pierwsze wywiady w życiu |
| Strategia analizy | Analiza pogłębiona kilku osób czy porównania wielu? | Szczegółowa analiza pojedynczych opowieści | Porównania między podgrupami |
Moc informacyjna nie daje liczby. Daje argumenty, które możesz wpisać do rozdziału metodologicznego i sprawdzać w trakcie badania. Po kilku wywiadach widzisz na przykład, że rozmowy są krótsze, niż zakładałeś, więc planujesz kilka więcej.
Krytyka nasycenia: stanowisko Braun i Clarke
Braun i Clarke (2021) kwestionują przydatność nasycenia w refleksyjnej analizie tematycznej. Ich zdaniem nasycenie danych, tematów, kodów, a nawet znaczeń pasuje do odmian analizy tematycznej nastawionych na rzetelność kodowania, ale nie do podejścia, w którym znaczenie powstaje w interpretacji badacza, a nie jest „wydobywane” z danych. Decyzja, ile wywiadów przeprowadzić i kiedy skończyć, jest wtedy zawsze sytuacyjna i subiektywna i nie da się jej w pełni ustalić przed analizą.
Co z tego wynika dla Ciebie? Jeśli robisz refleksyjną analizę tematyczną, nie pisz o „osiągnięciu nasycenia”. Uzasadnij liczebność bogactwem danych, celem i mocą informacyjną. Opisz też swoją rolę w interpretacji (refleksyjność badacza). Jeśli korzystasz z książki kodów i liczysz zgodność koderów, nasycenie kodów jest spójne z Twoim podejściem.
Symulacja: krzywa nowych kodów (przykład ilustracyjny)
Żeby zobaczyć, co naprawdę mierzy „krzywa nasycenia”, zasymulowaliśmy w R fikcyjne badanie wywiadów ze studentami pracującymi zawodowo. Założyliśmy pulę 45 kodów o różnej częstości. Pojedynczy wywiad zawierał średnio 12.9 kodu. To ilustracja mechanizmu, a nie wskazówka, ile wywiadów potrzeba: liczby zależą wyłącznie od przyjętych założeń symulacji. Zbiór możesz pobrać jako plik CSV.
Zastosowaliśmy regułę zatrzymania w duchu Francis i in. (2010): 10 wywiadów do analizy wstępnej, a potem koniec po 3 kolejnych wywiadach bez nowego kodu.
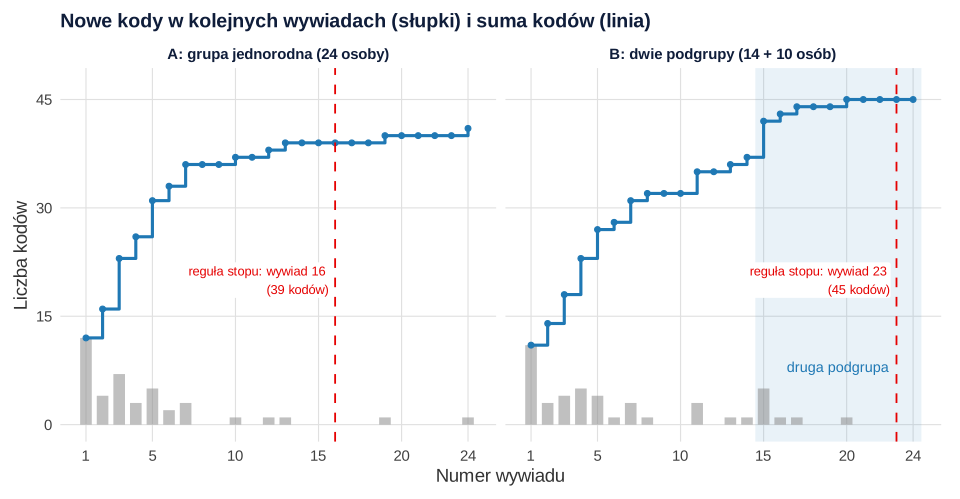
Z symulacji płyną trzy wnioski:
- Odsetek „nasycenia” liczy się względem kodów, które już masz. W grupie jednorodnej 80% kodów obecnych w danych pojawiło się do 6. wywiadu, a 90% do 10. Ale w 24 wywiadach wystąpiło 41 z 45 kodów puli: 4 rzadkie doświadczenia nie pojawiły się wcale. Reguła zatrzymała badanie po 16. wywiadzie przy 39 kodach. Badanie empiryczne nigdy nie widzi kodów, których nie usłyszało.
- Wypłaszczenie krzywej może wynikać z doboru. W scenariuszu B najpierw przeprowadzono 14 wywiadów z łatwo dostępną podgrupą. W wywiadach 8–10 pojawił się tylko 1 nowy kod, co wyglądało na nasycenie. Po 14 wywiadach było jednak tylko 3 z 10 kodów typowych dla drugiej podgrupy. Sam 15. wywiad, pierwszy z drugiej podgrupy, przyniósł 5 nowych kodów.
- Moment zatrzymania zależy od kolejności wywiadów. Te same 24 wywiady z grupy jednorodnej ułożyliśmy losowo 1000 razy (rysunek 2).
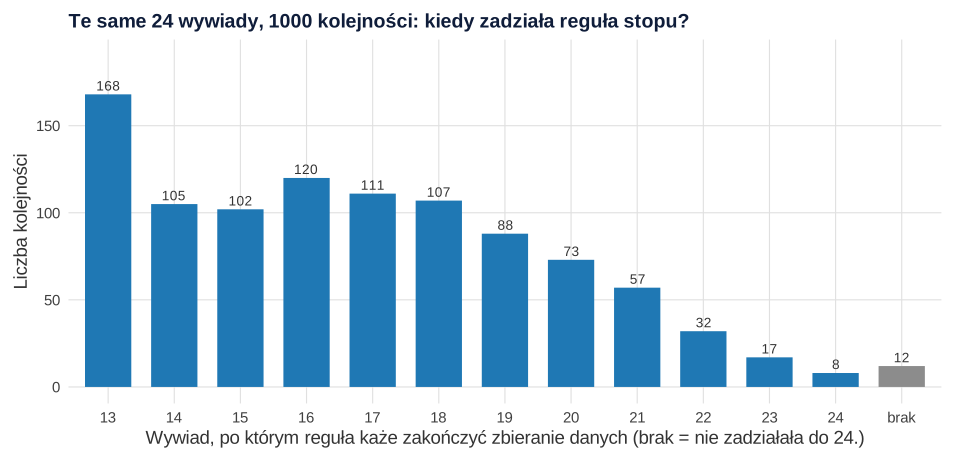
Mediana momentu zatrzymania wyniosła 16. wywiad, a 10. i 90. centyl rozkładu to 13. i 21. wywiad. W 168 kolejnościach na 1000 reguła zadziałała już po 13. wywiadzie, a w 12 kolejnościach na 1000 nie zadziałała do końca. W chwili zatrzymania badacz miał zwykle 97.6% kodów obecnych w całym zbiorze (mediana), ale w 10% kolejności – 92.7% lub mniej. Dlatego Guest, Namey i Chen (2020) proponują opisywać nasycenie jawnie, przez trzy parametry: wielkość bazową (base size), długość serii (run length) i próg nowych informacji. Czytelnik wie wtedy, co dokładnie oznacza „nasycenie” w Twoim badaniu.
Krzywa nowych kodów w R: symulacja ilustracyjna
Kod odtwarza wszystkie liczby z sekcji o symulacji i z obu rysunków. Symuluje obecność 45 kodów w 24 wywiadach w dwóch scenariuszach, liczy nowe kody w kolejnych wywiadach, stosuje regułę zatrzymania „10 + 3” i sprawdza, jak moment zatrzymania zależy od kolejności wywiadów. Wystarczy podstawowa instalacja R. Wynik jest ilustracją mechanizmu, a nie normą liczebności.
1. Nowe kody, reguła zatrzymania i kolejność wywiadów (rysunki 1–2)
R
# B179 – przepis 1: symulowana krzywa pojawiania się nowych kodów (wynik ilustracyjny, nie norma)
# Wpis: /blog/ile-wywiadow-nasycenie-proby-jakosciowej/
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript uruchom.R b179-1-krzywa-kodow.R
# Fikcyjne badanie: wywiady ze studentami, którzy pracują zawodowo w trakcie studiów.
# Każdy kod z „puli” ma własne prawdopodobieństwo pojawienia się w wywiadzie.
set.seed(17901)
K <- 45                                        # liczba kodów w puli (w prawdziwym badaniu nieznana)
p_kod <- sort(rbeta(K, 0.7, 2.2), decreasing = TRUE)
n_wyw <- 24

# Scenariusz A: grupa jednorodna (24 studentów studiów niestacjonarnych)
A <- matrix(rbinom(n_wyw * K, 1, rep(p_kod, each = n_wyw)), nrow = n_wyw)

# Scenariusz B: grupa niejednorodna – najpierw 14 osób niestacjonarnych (łatwo dostępnych), potem 10 stacjonarnych;
# 10 kodów (np. konflikt zajęć z grafikiem zmian) występuje częściej w drugiej podgrupie
p_B2 <- p_kod; spec <- 36:45; p_B2[spec] <- pmin(0.9, p_kod[spec] + 0.45)
p_B1 <- p_kod; p_B1[spec] <- p_kod[spec] * 0.15
B <- rbind(matrix(rbinom(14 * K, 1, rep(p_B1, each = 14)), nrow = 14),
           matrix(rbinom(10 * K, 1, rep(p_B2, each = 10)), nrow = 10))

dane <- rbind(data.frame(scenariusz = "A", wywiad = 1:n_wyw, A), data.frame(scenariusz = "B", wywiad = 1:n_wyw, B))
names(dane)[-(1:2)] <- sprintf("kod_%02d", 1:K)
write.csv(dane, "../nasycenie-kody-dane.csv", row.names = FALSE)   # 1 = kod obecny w wywiadzie

nowe_kody <- function(M) {                     # liczba kodów, które pojawiają się po raz pierwszy w wywiadzie i
  widziane <- rep(FALSE, ncol(M)); nowe <- integer(nrow(M))
  for (i in seq_len(nrow(M))) { n <- M[i, ] == 1 & !widziane; nowe[i] <- sum(n); widziane <- widziane | M[i, ] == 1 }
  nowe
}
# reguła zatrzymania w duchu Francis i in. (2010): próba wstępna 10 wywiadów, potem stop po 3 kolejnych bez nowych kodów
stop_regula <- function(nowe, start = 10, bieg = 3) {
  for (i in (start + bieg):length(nowe)) if (all(nowe[(i - bieg + 1):i] == 0)) return(i)
  NA_integer_
}
podsumuj <- function(M) {
  nowe <- nowe_kody(M); kum <- cumsum(nowe); razem <- max(kum)
  c(kody_w_danych = razem, kody_nieobecne_z_puli = ncol(M) - razem,
    sr_kodow_na_wywiad = round(mean(rowSums(M)), 1),
    wyw_80proc = which(kum >= 0.8 * razem)[1], wyw_90proc = which(kum >= 0.9 * razem)[1],
    wyw_100proc = which(kum == razem)[1], stop_po = stop_regula(nowe),
    kody_przy_stopie = kum[stop_regula(nowe)])
}
krzywe <- data.frame(wywiad = 1:n_wyw, nowe_A = nowe_kody(A), kum_A = cumsum(nowe_kody(A)),
                     nowe_B = nowe_kody(B), kum_B = cumsum(nowe_kody(B)))
print(krzywe, row.names = FALSE)
rbind(A_jednorodna = podsumuj(A), B_niejednorodna = podsumuj(B))
# co by było, gdyby badanie skończyło się na łatwo dostępnej podgrupie (14 pierwszych wywiadów B)?
c(kody_po_14 = sum(colSums(B[1:14, ]) > 0), kody_specyficzne_po_14 = sum(colSums(B[1:14, spec]) > 0),
  kody_specyficzne_po_24 = sum(colSums(B[, spec]) > 0), nowe_w_wyw_8_do_10 = sum(nowe_kody(B)[8:10]))

# Kolejność ma znaczenie: te same 24 wywiady A w 1000 losowych kolejnościach
R <- 1000
wyn <- t(replicate(R, {
  M <- A[sample(n_wyw), ]; nowe <- nowe_kody(M); s <- stop_regula(nowe)
  c(stop = s, odsetek_kodow = if (is.na(s)) NA else sum(nowe[1:s]) / sum(nowe))
}))
c(bez_zatrzymania = sum(is.na(wyn[, "stop"])))
summary(wyn[, "stop"])
round(quantile(wyn[, "stop"], c(.10, .50, .90), na.rm = TRUE), 1)
round(quantile(wyn[, "odsetek_kodow"], c(.10, .50, .90), na.rm = TRUE), 3)
table(wyn[, "stop"], useNA = "ifany")
saveRDS(list(krzywe = krzywe, wyn = wyn, A = A, B = B, sB = stop_regula(nowe_kody(B)), sA = stop_regula(nowe_kody(A))), "b179-1.rds")
Wynik w R
 wywiad nowe_A kum_A nowe_B kum_B
      1     12    12     11    11
      2      4    16      3    14
      3      7    23      4    18
      4      3    26      5    23
      5      5    31      4    27
      6      2    33      1    28
      7      3    36      3    31
      8      0    36      1    32
      9      0    36      0    32
     10      1    37      0    32
     11      0    37      3    35
     12      1    38      0    35
     13      1    39      1    36
     14      0    39      1    37
     15      0    39      5    42
     16      0    39      1    43
     17      0    39      1    44
     18      0    39      0    44
     19      1    40      0    44
     20      0    40      1    45
     21      0    40      0    45
     22      0    40      0    45
     23      0    40      0    45
     24      1    41      0    45
                kody_w_danych kody_nieobecne_z_puli sr_kodow_na_wywiad wyw_80proc wyw_90proc
A_jednorodna               41                     4               12.9          6         10
B_niejednorodna            45                     0               14.4         13         15
                wyw_100proc stop_po kody_przy_stopie
A_jednorodna             24      16               39
B_niejednorodna          20      23               45
            kody_po_14 kody_specyficzne_po_14 kody_specyficzne_po_24     nowe_w_wyw_8_do_10
                    37                      3                     10                      1
bez_zatrzymania
             12
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.    NA's
  13.00   14.00   16.00   16.73   19.00   24.00      12
10% 50% 90%
 13  16  21
  10%   50%   90%
0.927 0.976 1.000

  13   14   15   16   17   18   19   20   21   22   23   24 <NA>
 168  105  102  120  111  107   88   73   57   32   17    8   12
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje podstawowej instalacji); rysunki przygotowano w ggplot2. W pracy podaj wersje faktycznie użytych programów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Jak uzasadnić liczbę wywiadów w pracy
Dobre uzasadnienie ma cztery elementy. Planujesz je przed badaniem, a weryfikujesz w trakcie:
- Plan wstępny jako przedział, np. 12–20 wywiadów, oparty na mocy informacyjnej i na wynikach badań empirycznych podobnych do Twojego, z cytowaniem konkretnego badania.
- Struktura próby. Jeśli porównujesz podgrupy, zaplanuj wywiady w każdej z nich. Rekrutację opisujemy we wpisie gdzie znaleźć respondentów.
- Kryterium zakończenia ustalone z góry, zgodne z metodą analizy. Może to być reguła zatrzymania, ocena nasycenia znaczeń albo, w refleksyjnej analizie tematycznej, ocena bogactwa danych bez odwołania do nasycenia.
- Przejrzysty opis po badaniu: ile wywiadów przeprowadzono, jak oceniano wystarczalność danych i czego próba nie obejmuje. Notuj te decyzje na bieżąco w memo analitycznym.
Analiza powinna iść równolegle ze zbieraniem danych. Kto najpierw nagra 20 wywiadów, a potem je koduje, nie może później twierdzić, że przerwał zbieranie danych z powodu nasycenia. Praktyczną stronę wywiadów (scenariusz, nagranie, transkrypcja) opisujemy w poradniku wywiad pogłębiony w pracy dyplomowej, a przy badaniu jednego przypadku logika liczebności jest inna – zob. studium przypadku.
Wzór jest fikcyjny, a liczby w nim są przykładowe. Dostosuj go do swojego badania i metody analizy. Jak włączyć taki akapit do całego opisu metody, pokazujemy we wpisie jak opisać badanie jakościowe w rozdziale metodologicznym. Uzasadnienie liczebności to też jeden z argumentów za wiarygodnością badania jakościowego. Ogólne zasady rozdziału znajdziesz w poradniku rozdział metodologiczny.
Najczęstsze błędy
- „Przeprowadzono wywiady do osiągnięcia nasycenia” bez żadnych szczegółów. Napisz, jakie nasycenie i jak je oceniano (Saunders i in., 2018).
- Liczba z jednego badania jako norma. „Wystarczy 12 wywiadów” to błędne odczytanie Guest i in. (2006). Ich wynik dotyczy konkretnych danych.
- Nasycenie deklarowane po fakcie. Bez analizy równoległej ze zbieraniem danych nie da się go ocenić.
- Jednorodna podgrupa jako cała populacja. Płaska krzywa w łatwo dostępnej grupie nie mówi nic o osobach, z którymi nie rozmawiałeś.
- Przepraszanie za „małą próbę”. To myślenie ilościowe. W badaniu jakościowym zamiast reprezentatywności statystycznej uzasadniasz, że dane wystarczają do odpowiedzi na pytanie (Vasileiou i in., 2018).
- Nasycenie w refleksyjnej analizie tematycznej. Takie połączenie jest niespójne (Braun i Clarke, 2021).
Jeśli łączysz wywiady z ankietą, liczebność każdej części uzasadniasz osobno, według jej własnej logiki. Schematy takich badań opisujemy we wpisie o badaniach mieszanych.
Najczęstsze pytania
Ile wywiadów potrzeba do pracy magisterskiej?
Nie ma jednej liczby. Badania empiryczne nad nasyceniem w jednorodnych grupach z wąskim celem osiągały je zwykle po 9–17 wywiadach (Hennink i Kaiser, 2022), ale to wyniki konkretnych badań, a nie norma. Zaplanuj przedział, uzasadnij go mocą informacyjną (Malterud i in., 2016) i ustal z góry kryterium zakończenia zbierania danych.
Czym się różni nasycenie kodów od nasycenia znaczeń?
Nasycenie kodów oznacza, że przestały pojawiać się nowe kody, czyli znasz zakres poruszanych spraw. Nasycenie znaczeń oznacza, że rozumiesz te sprawy w pełni, z ich odmianami i powiązaniami. U Hennink, Kaiser i Marconi (2017) pierwsze nastąpiło po 9 wywiadach, a drugie wymagało 16–24.
Co to jest moc informacyjna w badaniu jakościowym?
To pojęcie zaproponowane przez Malterud, Siersmę i Guassorę (2016) w miejsce nasycenia: im więcej istotnych dla pytania informacji niesie próba, tym mniej uczestników potrzeba. Zależy od celu badania, specyficzności próby, wykorzystania teorii, jakości dialogu i strategii analizy. Daje argumenty do uzasadnienia liczebności, a nie gotową liczbę.
Czy w analizie tematycznej trzeba osiągnąć nasycenie?
W refleksyjnej analizie tematycznej nie. Braun i Clarke (2021) uważają nasycenie za niespójne z tym podejściem, bo znaczenie powstaje w interpretacji, a decyzja o liczbie wywiadów jest sytuacyjna. Nasycenie kodów pasuje natomiast do analizy z książką kodów i oceną zgodności koderów.
Jak opisać nasycenie danych w rozdziale metodologicznym?
Napisz, jakie nasycenie oceniano (kodów czy znaczeń), jak i kiedy: np. 10 wywiadów do analizy wstępnej i stop po 3 kolejnych bez nowych kodów (Francis i in., 2010). Dodaj, że analiza szła równolegle ze zbieraniem danych, i wskaż, czego próba nie obejmuje. Samo zdanie „do osiągnięcia nasycenia” nie wystarczy.
Powiązane hasła
Przeczytaj też
Wywiad pogłębiony w pracy dyplomowej
Scenariusz z dopytaniami, pilotaż, zgoda na nagranie, transkrypcja dosłowna a wygładzona, anonimizacja, przechowywanie danych i wzór opisu procedury.
Czytaj →PoradnikAnaliza tematyczna krok po kroku
Sześć faz według Braun i Clarke, podejście refleksyjne a książka kodowa, przykład kodowania „fragment → kod → temat”, typowe błędy i wzór opisu.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Planujesz wywiady do pracy i nie wiesz, jak uzasadnić ich liczbę?
Przejrzymy plan doboru uczestników i kryterium zakończenia zbierania danych oraz wyjaśnimy każdą decyzję tak, żebyś umiał(a) samodzielnie ją opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Braun, V., & Clarke, V. (2021). To saturate or not to saturate? Questioning data saturation as a useful concept for thematic analysis and sample-size rationales. Qualitative Research in Sport, Exercise and Health, 13(2), 201–216. https://doi.org/10.1080/2159676x.2019.1704846 ● Otwarty dostęp: pełny tekst
- Francis, J. J., Johnston, M., Robertson, C., Glidewell, L., Entwistle, V., Eccles, M. P., & Grimshaw, J. M. (2010). What is an adequate sample size? Operationalising data saturation for theory-based interview studies. Psychology & Health, 25(10), 1229–1245. https://doi.org/10.1080/08870440903194015 ● Otwarty dostęp: pełny tekst
- Guest, G., Bunce, A., & Johnson, L. (2006). How many interviews are enough? An experiment with data saturation and variability. Field Methods, 18(1), 59–82. https://doi.org/10.1177/1525822x05279903
- Guest, G., Namey, E., & Chen, M. (2020). A simple method to assess and report thematic saturation in qualitative research. PLOS ONE, 15(5), Article e0232076. https://doi.org/10.1371/journal.pone.0232076 ● Otwarty dostęp
- Hennink, M. M., Kaiser, B. N., & Marconi, V. C. (2017). Code saturation versus meaning saturation: How many interviews are enough? Qualitative Health Research, 27(4), 591–608. https://doi.org/10.1177/1049732316665344 ● Otwarty dostęp: pełny tekst
- Hennink, M., & Kaiser, B. N. (2022). Sample sizes for saturation in qualitative research: A systematic review of empirical tests. Social Science & Medicine, 292, Article 114523. https://doi.org/10.1016/j.socscimed.2021.114523 ● Otwarty dostęp
- Malterud, K., Siersma, V. D., & Guassora, A. D. (2016). Sample size in qualitative interview studies: Guided by information power. Qualitative Health Research, 26(13), 1753–1760. https://doi.org/10.1177/1049732315617444
- Saunders, B., Sim, J., Kingstone, T., Baker, S., Waterfield, J., Bartlam, B., Burroughs, H., & Jinks, C. (2018). Saturation in qualitative research: Exploring its conceptualization and operationalization. Quality & Quantity, 52(4), 1893–1907. https://doi.org/10.1007/s11135-017-0574-8 ● Otwarty dostęp
- Vasileiou, K., Barnett, J., Thorpe, S., & Young, T. (2018). Characterising and justifying sample size sufficiency in interview-based studies: Systematic analysis of qualitative health research over a 15-year period. BMC Medical Research Methodology, 18(1), Article 148. https://doi.org/10.1186/s12874-018-0594-7 ● Otwarty dostęp
Cytowania BibTeX
@article{braun2021saturate, author={Braun, Virginia and Clarke, Victoria}, title={{To saturate or not to saturate? Questioning data saturation as a useful concept for thematic analysis and sample-size rationales}}, journal={Qualitative Research in Sport, Exercise and Health}, year={2021}, volume={13}, number={2}, pages={201--216}, doi={10.1080/2159676x.2019.1704846}}@article{francis2010adequate, author={Francis, Jill J. and Johnston, Marie and Robertson, Clare and Glidewell, Liz and Entwistle, Vikki and Eccles, Martin P. and Grimshaw, Jeremy M.}, title={{What is an adequate sample size? Operationalising data saturation for theory-based interview studies}}, journal={Psychology \& Health}, year={2010}, volume={25}, number={10}, pages={1229--1245}, doi={10.1080/08870440903194015}}@article{guest2006many, author={Guest, Greg and Bunce, Arwen and Johnson, Laura}, title={{How many interviews are enough? An experiment with data saturation and variability}}, journal={Field Methods}, year={2006}, volume={18}, number={1}, pages={59--82}, doi={10.1177/1525822x05279903}}@article{guest2020simple, author={Guest, Greg and Namey, Emily and Chen, Mario}, title={{A simple method to assess and report thematic saturation in qualitative research}}, journal={PLOS ONE}, year={2020}, volume={15}, number={5}, eid={e0232076}, doi={10.1371/journal.pone.0232076}}@article{hennink2017code, author={Hennink, Monique M. and Kaiser, Bonnie N. and Marconi, Vincent C.}, title={{Code saturation versus meaning saturation: How many interviews are enough?}}, journal={Qualitative Health Research}, year={2017}, volume={27}, number={4}, pages={591--608}, doi={10.1177/1049732316665344}}@article{hennink2022sample, author={Hennink, Monique and Kaiser, Bonnie N.}, title={{Sample sizes for saturation in qualitative research: A systematic review of empirical tests}}, journal={Social Science \& Medicine}, year={2022}, volume={292}, eid={114523}, doi={10.1016/j.socscimed.2021.114523}}@article{malterud2016sample, author={Malterud, Kirsti and Siersma, Volkert Dirk and Guassora, Ann Dorrit}, title={{Sample size in qualitative interview studies: Guided by information power}}, journal={Qualitative Health Research}, year={2016}, volume={26}, number={13}, pages={1753--1760}, doi={10.1177/1049732315617444}}@article{saunders2018saturation, author={Saunders, Benjamin and Sim, Julius and Kingstone, Tom and Baker, Shula and Waterfield, Jackie and Bartlam, Bernadette and Burroughs, Heather and Jinks, Clare}, title={{Saturation in qualitative research: Exploring its conceptualization and operationalization}}, journal={Quality \& Quantity}, year={2018}, volume={52}, number={4}, pages={1893--1907}, doi={10.1007/s11135-017-0574-8}}@article{vasileiou2018characterising, author={Vasileiou, Konstantina and Barnett, Julie and Thorpe, Susan and Young, Terry}, title={{Characterising and justifying sample size sufficiency in interview-based studies: Systematic analysis of qualitative health research over a 15-year period}}, journal={BMC Medical Research Methodology}, year={2018}, volume={18}, number={1}, eid={148}, doi={10.1186/s12874-018-0594-7}}