Socjologia pyta o zbiorowość, nie o pojedynczą osobę
Ilościowa praca z socjologii opisuje, jak zjawisko rozkłada się w konkretnej zbiorowości i z jakim położeniem społecznym się wiąże. W pracy z psychologii punktem wyjścia bywa mechanizm w jednostce. Tutaj szybciej pojawia się pytanie: u kogo, gdzie i na ile da się to przenieść na innych. Dlatego w tym wpisie najwięcej miejsca zajmują pojęcia, populacja, dobór i granice uogólniania. Technikę liczenia opisuje osobno statystyka w pracy z socjologii, a ogólny układ rozdziału – poradnik o rozdziale metodologicznym. Porównanie kierunków znajdziesz we wpisie o tym, czym różnią się prace z różnych dziedzin.
Prowadzi nas jeden fikcyjny temat magisterski: zaufanie społeczne a aktywność sąsiedzka w trzech małych miastach. Miasta A, B i C mają razem 14 000 dorosłych mieszkańców. Wszystkie wyniki pochodzą z danych symulowanych. Symulacja daje coś, czego w prawdziwym badaniu nie ma: znamy całą populację, więc widać, co próba robi z wynikiem. Opisane niżej układy to częste konwencje, nie reguły dyscypliny. Wymagania uczelni i promotora mają pierwszeństwo.
Od tematu do pytania o zjawisko społeczne
Zanim wybierzesz teorię, ustal, co chcesz wiedzieć o zbiorowości. Lukę w literaturze uzasadnisz łatwiej, gdy pytanie ma określoną formę. W badaniach sondażowych zwykle należy do jednego z trzech typów.
| Typ pytania | Przykład | Czego wymaga |
|---|---|---|
| Rozkład | Jaki odsetek mieszkańców pomagał sąsiadom w ostatnim roku? | próby, która pozwala mówić o całej populacji |
| Zróżnicowanie | Czym różnią się w tym mieszkańcy z wykształceniem wyższym i zawodowym? | wystarczająco licznych kategorii społecznych |
| Związek | Czy osoby o wyższym zaufaniu częściej angażują się w sprawy sąsiedzkie po uwzględnieniu wieku i stażu zamieszkania? | teorii, wskaźników i zmiennych kontrolnych |
Pierwszy typ jest najbardziej wrażliwy na sposób doboru, trzeci mniej, ale też nie jest od niego wolny. To rozróżnienie wróci przy wnioskach.
Jak bywa napisane: „Celem pracy jest zbadanie wpływu zaufania na aktywność społeczną mieszkańców małych miast”.
Co jest nie tak: „wpływ” obiecuje przyczynowość, której schemat przekrojowy nie daje. „Aktywność społeczna” może znaczyć wszystko od wolontariatu po głosowanie. „Małe miasta” nie są zbiorowością, którą zbadano.
Hipotezę uzasadnij łańcuchem argumentu, jak we wpisie o wyprowadzaniu hipotezy z teorii. Pilnuj przy tym poziomu analizy. Portes (1998) ostrzega, że rozciąganie kapitału społecznego z zasobu jednostki na cechę społeczności i całych narodów grozi utratą jego wartości poznawczej. Jeśli pytasz 341 osób o ich działania, wnioskujesz o osobach. Z trzech miast nie zrobisz wniosku o „miastach ufnych”, a przeniesienie związku z poziomu zbiorowości na jednostki to błąd ekologiczny.
Koncept, wymiar, wskaźnik
Operacjonalizacja w socjologii ma zwykle postać drzewa: koncept dzielisz na wymiary, a każdemu przypisujesz wskaźniki, czyli konkretne pytania z kodowaniem. Szerzej o tym etapie pisze podręcznik Babbiego (2024). Adcock i Collier (2001) radzą oddzielać spór o to, czym jest pojęcie, od pytania, czy wskaźnik dobrze je mierzy, i przypominają, że ocena trafności zależy od kontekstu. W pracy oznacza to dwa osobne akapity: najpierw definicja, potem pomiar.
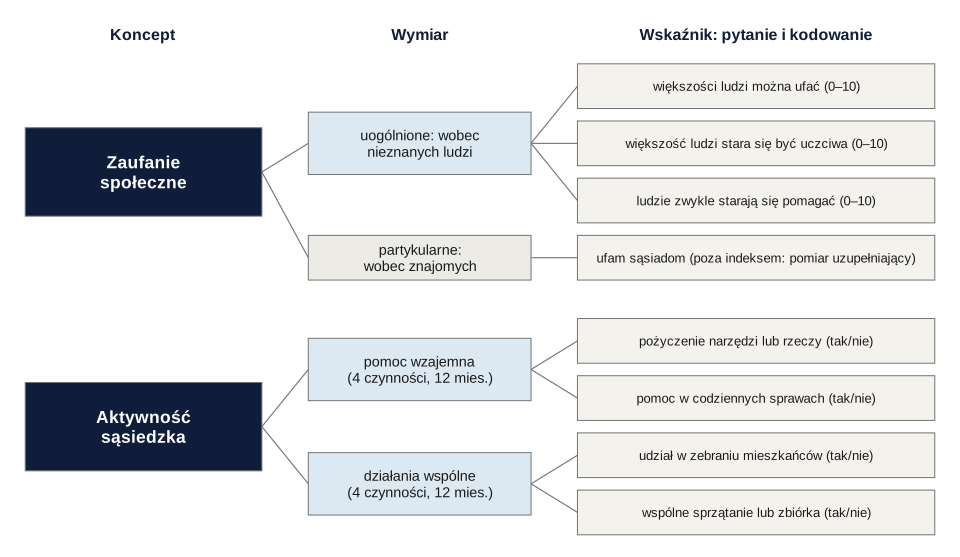
Z drzewa wynikają trzy decyzje, które opisz wprost:
- Który wymiar badasz. Zaufanie do nieznajomych to coś innego niż zaufanie do sąsiadów. W przykładzie wskaźnik główny dotyczy zaufania uogólnionego, a pytanie o sąsiadów jest dodatkowe, bo mogłoby zlewać się z aktywnością sąsiedzką.
- Skąd wziąłeś pytania. Trzy pytania wzorowano na pytaniach znanych z dużych sondaży. Oficjalne polskie brzmienie weź z kwestionariusza badania i podaj źródło. Pytanie o „większość ludzi” też ma granice: Delhey i in. (2011) pokazali, że w większości z 51 krajów odnosi się ono głównie do osób spoza własnego kręgu, ale szerokość tego kręgu wyraźnie różni się między krajami.
- Jak łączysz wskaźniki. Trzy pytania o zaufanie traktujemy jako odbicie jednej postawy, więc alfa ma sens (α = .85). Osiem czynności sąsiedzkich to raczej indeks: pożyczenie wiertarki i udział w zebraniu nie muszą iść w parze. Taki wynik liczysz jako sumę, bez oceny alfą (zob. model refleksyjny i formatywny).
Aktywność mierzysz deklaracjami, a pomoc innym jest ceniona. Pisz więc o „deklarowanej aktywności” i uwzględnij aprobatę społeczną w ograniczeniach. Okres odniesienia (12 miesięcy) podaj w treści pytania.
Populacja i operat: kogo dotyczy badanie
Trzy określenia często zlewają się w jedno, a każde znaczy co innego. Populacja docelowa to zbiorowość, o której chcesz mówić. Operat to lista lub inny sposób dotarcia do jej członków. Próba to ci, którzy naprawdę trafili do analizy. Każde przejście między nimi jest osobnym źródłem błędu, co porządkuje rama całkowitego błędu badania sondażowego.
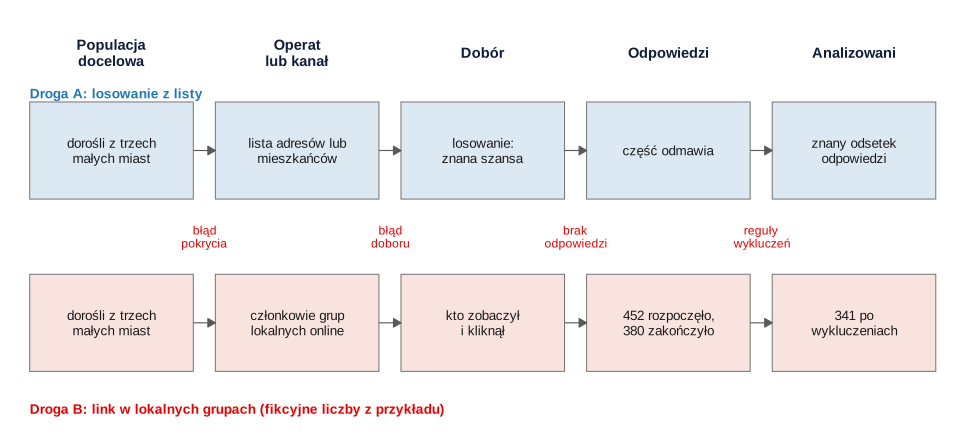
Student rzadko dostaje listę mieszkańców miasta. To nie powód, by pomijać ten etap. Napisz, że operatu nie było, i nazwij kanał, który go zastąpił.
Jak bywa napisane: „Badaniem objęto reprezentatywną próbę mieszkańców małych miast”.
Co jest nie tak: nie wiadomo, jakich miast, jak dobrano osoby i względem czego próba miałaby być reprezentatywna.
Dobór i jego granice
Metody doboru opisuje wpis o doborze próby w pracy dyplomowej. Tu liczy się to, co dana droga oznacza w małym mieście.
| Sposób | Co daje | Granica |
|---|---|---|
| Losowanie adresów lub osób z listy | znaną szansę wyboru i przedział ufności w pełnym sensie | wymaga dostępu do listy; odmowy i tak zostają |
| Próba kwotowa na miejscu | strukturę wieku i płci zbliżoną do populacji | ankieter wybiera tych, którzy są pod ręką; struktura nie gwarantuje trafności |
| Link w grupach lokalnych | szybkie i tanie dotarcie | odpowiadają głównie osoby z dostępem i zainteresowane tematem |
Trzecia droga jest najczęstsza i ma konkretną wadę: ogłoszenie o sąsiedztwie czytają ludzie związani z sąsiedztwem. Selekcja dotyczy więc samej badanej zmiennej. Bethlehem (2010) wskazuje, że o ile problem niepełnego pokrycia internetem może z czasem maleć, samoselekcja prowadzi do niewiarygodnych wyników. Cornesse i in. (2020) zauważają, że trafność wnioskowania z prób nielosowych zależy całkowicie od przyjętych modeli. Nie znaczy to, że taka praca jest bezwartościowa. Znaczy, że musisz napisać, jakie założenia przyjmujesz. Kanały rekrutacji dobieraj z myślą o tym, kogo każdy z nich pomija.
Podaj też przepływ respondentów. Przy publicznym linku nie znasz liczby osób, które ogłoszenie zobaczyły, więc odsetka odpowiedzi nie policzysz. Nie zastępuj go odsetkiem osób, które doszły do końca ankiety.
Zmienne społeczno-demograficzne
W socjologii metryczka jest częścią odpowiedzi na pytanie badawcze. Pełni trzy funkcje: opisuje próbę, pozwala porównać ją z populacją i dostarcza zmiennych wyjaśniających. Kategorie zaplanuj przed zbieraniem danych tak, by pasowały do danych statystyki publicznej, np. GUS. Jeśli zapytasz o wiek w innych przedziałach, porównanie będzie niemożliwe. Sposób prezentacji tabeli opisuje poradnik o charakterystyce próby.
| Cecha | Populacja (%) | Próba, n = 341 (%) |
|---|---|---|
| Wiek 18–34 | 20.1 | 44.6 |
| Wiek 35–59 | 53.1 | 47.2 |
| Wiek 60+ | 26.8 | 8.2 |
| Wykształcenie zawodowe lub niższe | 34.3 | 17.0 |
| Wykształcenie średnie | 38.3 | 29.0 |
| Wykształcenie wyższe | 27.4 | 54.0 |
| Kobiety | 51.8 | 63.6 |
Do modelu nie wkładaj całej metryczki odruchowo. Każdą zmienną kontrolną uzasadnij: wiek i staż zamieszkania mogą wiązać się z zaufaniem i z sieciami sąsiedzkimi. Zmienna, która jest skutkiem zaufania, nie powinna być „kontrolowana”.
Wagi – krótko i bez złudzeń
Wagi poststratyfikacyjne dopasowują strukturę próby do znanej struktury populacji. Procedurę krok po kroku opisuje poradnik o ważeniu danych sondażowych. W pracy pokaż jej skutek. Po ważeniu według wieku i wykształcenia wagi wyniosły od 0.31 do 5.95, efekt schematu 1.92, a efektywna liczebność spadła z 341 do 177.
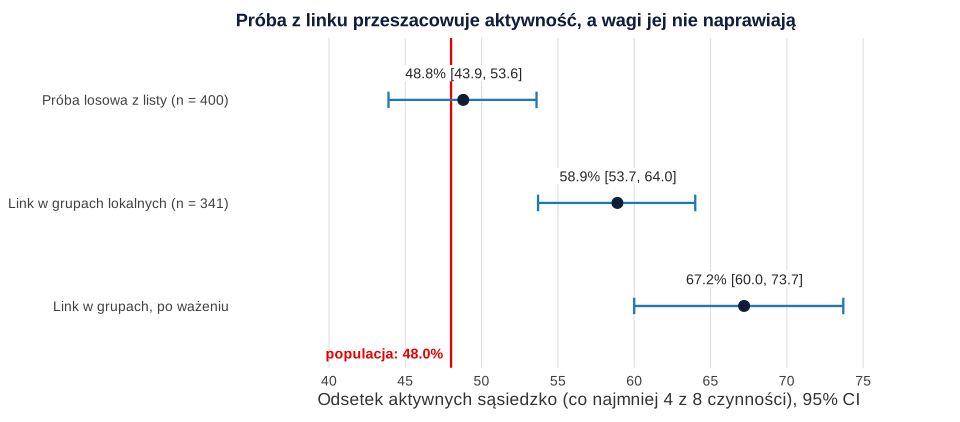
W populacji aktywnych jest 48.0%. Próba losowa z listy daje 48.8%, a próba z linku 58.9%. Po ważeniu wynik oddalił się od prawdy do 67.2%. W próbie było mało starszych osób z niższym wykształceniem, a trafiły do niej przede wszystkim te zaangażowane w sprawy okolicy. Wagi zwielokrotniły właśnie ich odpowiedzi. Nie zawsze tak będzie, bo wagi potrafią też zmniejszyć obciążenie. Działają jednak tylko wtedy, gdy zmienne użyte do ważenia wyjaśniają, kto trafił do próby. W prawdziwym badaniu nie sprawdzisz tego wprost.
Związek zachował kierunek, ale był słabszy: współczynnik zaufania w regresji wyniósł 0.38 w populacji i 0.29 w próbie z linku. Solon i in. (2015) przypominają, że wagi przy opisie populacji i wagi przy szacowaniu efektów to dwie różne decyzje, a motywy ważenia w drugim przypadku często nie mają zastosowania. Jeśli ważysz, pokaż wyniki z wagami i bez nich.
Wtórna analiza: ESS albo PGSS zamiast własnej ankiety
Gdy pytanie dotyczy większej zbiorowości, uczciwszą drogą bywa analiza gotowego sondażu. Dostęp, wagi i dokumentację Europejskiego Sondażu Społecznego i Polskiego Generalnego Sondażu Społecznego opisuje wpis o analizie danych z dużych badań sondażowych, a ogólne zasady – reanaliza i wtórna analiza danych. W tekście pracy zmienia się kilka rzeczy:
- Koncept dopasowujesz do istniejących pytań. Napisz, czego wskaźnik nie obejmuje. Aktywności sąsiedzkiej może nie być wprost, jest tylko zbliżona aktywność w organizacjach.
- Populację i dobór opisujesz według dokumentacji. Podaj edycję, rok, schemat i wskaż, skąd pochodzą te informacje.
- Sprawdzasz podgrupę. Ustal, czy zbiór pozwala wyróżnić małe miasta i ile osób wtedy zostaje.
- Uwzględniasz schemat. West i in. (2016) oceniają, że pomijanie złożonego schematu doboru w analizach wtórnych wygląda na bardzo częste i prowadzi do obciążonych oszacowań oraz niewłaściwych błędów standardowych.
Opis wyników: odsetki, tabela, model
Układ wyników prowadź według pytań. Najpierw opis (P1), potem związek (H1). Jeśli ankieta ma wiele pozycji, nie testuj wszystkiego ze wszystkim: pomocny jest wpis o wynikach ankiety z wieloma pytaniami. Dla czytelności łączymy tu zaufanie w tercyle, a analizę główną prowadzimy na wyniku ciągłym.
| Zaufanie (tercyle) | n | Aktywni (≥ 4 czynności) | Odsetek w wierszu |
|---|---|---|---|
| Niskie | 135 | 67 | 49.6% |
| Średnie | 117 | 74 | 63.2% |
| Wysokie | 89 | 60 | 67.4% |
Jak bywa napisane: „Zaufanie istotnie wpływa na aktywność (p = .015). Mieszkańcy małych miast, którzy ufają innym, są bardziej aktywni”.
Co jest nie tak: podano jedną liczbę, nie ma wielkości związku ani modelu z kontrolą, „wpływa” jest nieuprawnione, a podmiotem zdania stali się wszyscy mieszkańcy małych miast.
Wynik 0–8 jest ograniczony, więc regresja liniowa jest tu przybliżeniem. Warto sprawdzić, czy wnioski są podobne w regresji porządkowej. Szczegóły tabel i testów znajdziesz w poradniku o statystyce dla socjologów. Przedziału ufności dla 58.9% nie przedstawiaj jako marginesu błędu dla mieszkańców: przy próbie z linku opisuje on co najwyżej precyzję przy założeniu losowości. Rysunek 3 pokazuje, jak daleko od populacji może leżeć taki przedział.
Dyskusja i wnioski: co wolno uogólnić
Granica wniosku zależy od tego, jak powstała próba i o co pytasz. Trafność zewnętrzną oceń osobno dla odsetków i dla związków.
| Nie pisz | Napisz |
|---|---|
| 59% mieszkańców małych miast angażuje się w sprawy sąsiedzkie. | Wśród 341 respondentów z lokalnych grup internetowych 58.9% zadeklarowało co najmniej cztery czynności. |
| Zaufanie zwiększa aktywność sąsiedzką. | Osoby o wyższym zaufaniu deklarowały więcej działań sąsiedzkich. |
| Wyniki są reprezentatywne dzięki ważeniu. | Ważenie objęło wiek i wykształcenie i nie koryguje selekcji związanej z zainteresowaniem tematem. |
| W miastach o niskim zaufaniu trzeba… | Wynik można potraktować jako wskazówkę do dalszego badania, np. na próbie losowej. |
Kierunek związku omów w świetle literatury, a nie własnej tabeli. Popularna wersja teorii kapitału społecznego głosi, że zaangażowanie buduje zaufanie. van Ingen i Bekkers (2015) na pięciu panelach krajowych stwierdzili, że uczestnicy organizacji rzeczywiście ufają bardziej, ale wynika to najpewniej z selekcji, a efekty przyczynowe były bardzo małe lub nieistotne. Dotyczy to zaangażowania obywatelskiego, nie sąsiedztwa, więc przenoś ten wniosek ostrożnie. Sondaż przekrojowy tego sporu nie rozstrzygnie, co wyjaśnia hasło korelacja a przyczynowość.
Najczęstsze błędy
- „Reprezentatywna” próba z linku. Słowo bez podania cechy i populacji nic nie znaczy, a duże n nie usuwa selekcji.
- Koncept bez definicji. Rozdział teoretyczny kończy się przeglądem definicji, a kwestionariusz mierzy coś innego.
- Skala z przypadku. Alfa policzona dla indeksu czynności, które nie muszą się ze sobą wiązać.
- Metryczka nieporównywalna. Przedziały wieku lub wykształcenia inne niż w danych o populacji.
- Wagi bez raportu. Brak zakresu wag, efektywnej liczebności i wyników bez ważenia.
- Dane wtórne jak własna ankieta. Pominięcie wag i schematu, brak numeru edycji zbioru.
- Zbiorowość w podmiocie zdania. „Polacy”, „mieszkańcy miast” zamiast „badani”.
Ogólne zasady znajdziesz w poradnikach o ograniczeniach i wnioskach.
Lista kontrolna przed oddaniem rozdziału
- Pytanie określa zbiorowość, miejsce i czas, bez słowa „wpływ”.
- Każdy koncept ma definicję, wymiary i wskaźniki z kodowaniem.
- Wiadomo, skąd pochodzą pytania i jak je łączono w wyniki.
- Rozróżniono populację docelową, operat lub kanał rekrutacji i próbę.
- Podano przepływ respondentów, a odsetek odpowiedzi tylko wtedy, gdy znany jest mianownik.
- Strukturę próby porównano z danymi o populacji.
- Zmienne kontrolne mają uzasadnienie.
- Jeśli są wagi: podano sposób ich budowy, zakres, efektywną liczebność i wyniki bez wag.
- Przy danych wtórnych podano edycję zbioru, wagę i schemat.
- Wnioski dotyczą badanych, a uogólnienia mają wskazane założenia.
- Opisano zgodę i ochronę danych według zasad uczelni.
Bibliografia oprogramowania
Liczby w fikcyjnym przykładzie pochodzą z danych symulowanych w R 4.5.3, a rysunki przygotowano w pakietach ggplot2 i svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różni się praca z socjologii od pracy z psychologii?
Praca z psychologii często zaczyna od mechanizmu w jednostce i właściwości narzędzia. W socjologii więcej miejsca zajmuje opis zbiorowości: kogo dotyczy badanie, jak dotarto do respondentów, jakie kategorie społeczne porównano i na ile można uogólnić wyniki. To konwencje, więc ostateczny układ ustal z promotorem.
Jak w pracy z socjologii przejść od pojęcia do pytania w ankiecie?
Zdefiniuj koncept, podziel go na wymiary, a do każdego dobierz wskaźniki, czyli pytania z ustalonym kodowaniem. Opisz, skąd pochodzą pytania i jak łączysz je w wynik. Inaczej potraktuj skalę postawy, a inaczej indeks czynności, których nie trzeba wykonywać razem.
Czy ankietę rozesłaną w grupach na Facebooku można nazwać próbą reprezentatywną?
Nie. To próba nielosowa, która powstaje przez samodzielne zgłaszanie się osób. Możesz porównać jej strukturę z populacją i opisać różnice, ale zgodność wieku czy płci nie oznacza, że odpowiedzi odzwierciedlają populację. Pisz o „badanych”, a nie o wszystkich mieszkańcach.
Czy mogę napisać pracę magisterską z socjologii na danych ESS lub PGSS?
Często tak, ale ustal to z promotorem. Dopasowujesz wtedy pojęcia do istniejących pytań, opisujesz populację i dobór według dokumentacji, podajesz edycję zbioru i stosujesz zalecane wagi. Sprawdź wcześniej, czy zbiór pozwala wyodrębnić interesującą Cię podgrupę.
Czy ważenie próby internetowej poprawia wyniki?
Czasem tak, ale nie ma gwarancji. Ważenie koryguje strukturę pod względem użytych zmiennych, a nie selekcję związaną z zainteresowaniem tematem. W przykładzie odsetek aktywnych wynosi 48.0% w populacji, 58.9% w próbie z linku i 67.2% po ważeniu. Raportuj wyniki z wagami i bez nich.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z socjologii
Sondaż, tabele krzyżowe z resztami, ważenie próby, regresja logistyczna z AME i skale postaw: plan analiz, APA, dane XLSX i kod R.
Czytaj →PoradnikJak napisać pracę z pedagogiki
Przedmiot, problemy, hipotezy, zmienne i wskaźniki, metoda–technika–narzędzie, klasy i zgody na przykładzie motywacji do czytania, z wersjami źle i dobrze.
Czytaj →PoradnikJak napisać pracę z zarządzania i ekonomii
Luka, jedna rama teoretyczna, model z hipotezami H1a/H1b, skale anglojęzyczne, wspólna metoda, panel firm i implikacje menedżerskie – z przykładami do poprawienia.
Czytaj →PoradnikPodsumowanie wyników w pracy – jak napisać
Trzy miejsca podsumowania, różnica względem wniosków, tabela „hipoteza – test – wynik – werdykt”, wynik nieistotny i akapity wzorcowe dla trzech typów prac.
Czytaj →PoradnikWażenie danych sondażowych krok po kroku
Wagi schematu, korekta braku odpowiedzi, raking w R, przycinanie wag, efektywna liczebność Kisha, błąd standardowy i wzór opisu.
Czytaj →Piszesz pracę z socjologii na danych sondażowych?
Pomożemy rozpisać pojęcia na wskaźniki, opisać dobór próby, zastosować wagi lub dane z dużych sondaży i przygotować wyniki – w R lub SPSS, z wyjaśnieniem, które pozwoli Ci samodzielnie obronić analizę.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Adcock, R., & Collier, D. (2001). Measurement validity: A shared standard for qualitative and quantitative research. American Political Science Review, 95(3), 529–546. https://doi.org/10.1017/s0003055401003100 ● Otwarty dostęp: pełny tekst
- Babbie, E. (2024). Badania społeczne w praktyce. Wydawnictwo Naukowe PWN.
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Cornesse, C., Blom, A. G., Dutwin, D., Krosnick, J. A., De Leeuw, E. D., Legleye, S., Pasek, J., Pennay, D., Phillips, B., Sakshaug, J. W., Struminskaya, B., & Wenz, A. (2020). A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research. Journal of Survey Statistics and Methodology, 8(1), 4–36. https://doi.org/10.1093/jssam/smz041 ● Otwarty dostęp
- Delhey, J., Newton, K., & Welzel, C. (2011). How general is trust in “most people”? Solving the radius of trust problem. American Sociological Review, 76(5), 786–807. https://doi.org/10.1177/0003122411420817
- Portes, A. (1998). Social capital: Its origins and applications in modern sociology. Annual Review of Sociology, 24(1), 1–24. https://doi.org/10.1146/annurev.soc.24.1.1
- Solon, G., Haider, S. J., & Wooldridge, J. M. (2015). What are we weighting for? Journal of Human Resources, 50(2), 301–316. https://doi.org/10.3368/jhr.50.2.301
- van Ingen, E., & Bekkers, R. (2015). Generalized trust through civic engagement? Evidence from five national panel studies. Political Psychology, 36(3), 277–294. https://doi.org/10.1111/pops.12105 ● Otwarty dostęp
- West, B. T., Sakshaug, J. W., & Aurelien, G. A. S. (2016). How big of a problem is analytic error in secondary analyses of survey data? PLOS ONE, 11(6), Article e0158120. https://doi.org/10.1371/journal.pone.0158120 ● Otwarty dostęp
Cytowania BibTeX
@article{adcock2001measurement, author={Adcock, Robert and Collier, David}, title={{Measurement validity: A shared standard for qualitative and quantitative research}}, journal={American Political Science Review}, year={2001}, volume={95}, number={3}, pages={529--546}, doi={10.1017/s0003055401003100}}@book{babbie2024badania, author={Babbie, Earl}, title={{Badania społeczne w praktyce}}, year={2024}, publisher={Wydawnictwo Naukowe PWN}}@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{cornesse2020review, author={Cornesse, Carina and Blom, Annelies G. and Dutwin, David and Krosnick, Jon A. and De Leeuw, Edith D. and Legleye, Stéphane and Pasek, Josh and Pennay, Darren and Phillips, Benjamin and Sakshaug, Joseph W. and Struminskaya, Bella and Wenz, Alexander}, title={{A review of conceptual approaches and empirical evidence on probability and nonprobability sample survey research}}, journal={Journal of Survey Statistics and Methodology}, year={2020}, volume={8}, number={1}, pages={4--36}, doi={10.1093/jssam/smz041}}@article{delhey2011how, author={Delhey, Jan and Newton, Kenneth and Welzel, Christian}, title={{How general is trust in “most people”? Solving the radius of trust problem}}, journal={American Sociological Review}, year={2011}, volume={76}, number={5}, pages={786--807}, doi={10.1177/0003122411420817}}@article{portes1998social, author={Portes, Alejandro}, title={{Social capital: Its origins and applications in modern sociology}}, journal={Annual Review of Sociology}, year={1998}, volume={24}, number={1}, pages={1--24}, doi={10.1146/annurev.soc.24.1.1}}@article{solon2015what, author={Solon, Gary and Haider, Steven J. and Wooldridge, Jeffrey M.}, title={{What are we weighting for?}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={301--316}, doi={10.3368/jhr.50.2.301}}@article{vaningen2015generalized, author={van Ingen, Erik and Bekkers, René}, title={{Generalized trust through civic engagement? Evidence from five national panel studies}}, journal={Political Psychology}, year={2015}, volume={36}, number={3}, pages={277--294}, doi={10.1111/pops.12105}}@article{west2016how, author={West, Brady T. and Sakshaug, Joseph W. and Aurelien, Guy Alain S.}, title={{How big of a problem is analytic error in secondary analyses of survey data?}}, journal={PLOS ONE}, year={2016}, volume={11}, number={6}, eid={e0158120}, doi={10.1371/journal.pone.0158120}}