DIF: ta sama cecha, inna odpowiedź
O zróżnicowanym funkcjonowaniu pozycji (DIF) mówimy, gdy osoby z dwóch grup, które mają ten sam poziom mierzonej cechy, różnią się prawdopodobieństwem danej odpowiedzi. Sama różnica odsetków między grupami to jeszcze nie DIF. Jeśli starsi dorośli mają średnio więcej objawów depresyjnych, częściej odpowiadają „tak” na każdą pozycję. To prawdziwa różnica w cesze (ang. impact), a nie wada pomiaru. Dlatego każda metoda DIF porównuje grupy dopiero po dopasowaniu osób pod względem poziomu cechy.
Swaminathan i Rogers (1990) rozróżnili dwa rodzaje DIF:
- DIF jednorodny (ang. uniform): jedna grupa ma przewagę na całym zakresie cechy. Krzywe charakterystyczne pozycji są równoległe i przesunięte. W IRT różni się próg (trudność) pozycji.
- DIF niejednorodny (ang. non-uniform): różnica zależy od poziomu cechy, a krzywe mogą się przecinać. Różni się dyskryminacja, czyli w regresji logistycznej występuje interakcja grupy z poziomem cechy.
W modelu Rascha wszystkie pozycje mają tę samą dyskryminację, więc da się w nim opisać tylko DIF jednorodny. Teorię IRT przypomina wpis teoria reagowania na pozycje testowe. W poradniku IRT w R krok po kroku DIF jest jednym z kroków analizy modelu. Tutaj porównujemy trzy metody na tych samych danych: Mantela–Haenszela, regresję logistyczną i IRT.
Zmienna dopasowująca, kotwica i oczyszczanie
Każda metoda potrzebuje miary cechy, według której dopasowujesz osoby. W metodach obserwacyjnych jest to zwykle wynik sumaryczny skali, a w IRT – cecha ukryta θ, której skalę wyznaczają pozycje kotwiczące (ang. anchor items). Tu pojawia się błędne koło. Jeśli pozycja z DIF wchodzi do wyniku dopasowującego, zniekształca dopasowanie i może „przenosić” DIF na inne pozycje.
Rozwiązaniem jest oczyszczanie (ang. purification). Najpierw testujesz wszystkie pozycje. Potem liczysz wynik dopasowujący tylko z pozycji bez DIF i powtarzasz testy. Zwick (2012) w przeglądzie procedur ETS pokazuje, że oczyszczanie poprawia wykrywanie, gdy DIF ma głównie jeden kierunek, ale może je pogorszyć, gdy DIF w różnych pozycjach się równoważy. Gdy nie wiesz, jakiego wzorca się spodziewać, oczyszczanie jest zalecane. W pakiecie lordif oczyszczanie odbywa się iteracyjnie, aż do uzyskania stabilnego zestawu pozycji z DIF (Choi i in., 2011).
Przykład: lista objawów u młodszych i starszych dorosłych
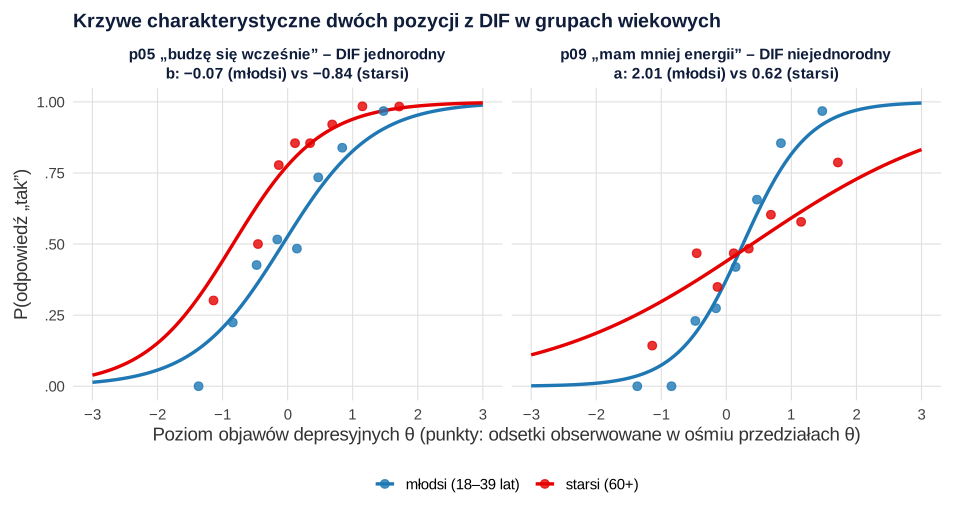
Symulowaliśmy odpowiedzi tak/nie na 12 pozycji listy objawów depresyjnych. Grupą odniesienia są osoby młodsze (18–39 lat, n = 500), a grupą ogniskową starsze (60+, n = 500). Dane powstały z modelu dwuparametrycznego (2PL) i są dychotomiczne. Starsi mają w nich nieco wyższy średni poziom cechy, a dwie pozycje wbudowano z DIF:
- p05 „budzę się dużo wcześniej niż zwykle” – DIF jednorodny: przy tym samym nasileniu depresji starsi częściej odpowiadają „tak”;
- p09 „mam mniej energii niż zwykle” – DIF niejednorodny: u starszych pozycja słabiej różnicuje osoby (zmęczenie ma też inne przyczyny), więc krzywe się przecinają.
Wynik ogólny (0–12) wyniósł M = 4.90 (SD = 3.14) u młodszych i M = 5.85 (SD = 2.97) u starszych. Dane są symulowane (set.seed(2170)) i możesz je pobrać jako plik CSV (1000 wierszy: id, grupa, p01–p12).
Krok 1. Mantel–Haenszel i klasyfikacja ETS
Procedura Mantela–Haenszela (Mantel i Haenszel, 1959) dzieli próbę na warstwy według wyniku dopasowującego. W każdej warstwie tworzy tabelę 2 × 2 (grupa × odpowiedź), a następnie łączy je w test χ²MH i wspólny iloraz szans αMH. W bazowym R robi to funkcja mantelhaen.test() na tablicy grupa × odpowiedź × warstwa. Wartość αMH = 1 oznacza brak DIF. ETS przelicza ją na skalę delta:
Według reguł ETS opisanych przez Henninger i in. (2023) pozycja należy do kategorii A (DIF pomijalny), gdy |ΔMH| ≤ 1 albo ΔMH nie różni się istotnie od zera. Kategoria C (duży DIF) wymaga |ΔMH| ≥ 1.5 i wartości istotnie większej od 1. Pozostałe pozycje trafiają do kategorii B (umiarkowany DIF). Gdy obowiązuje model Rascha, a DIF jest jednorodny, ΔMH odpowiada różnicy trudności pozycji pomnożonej przez −2.35 (Henninger i in., 2023).
W pierwszym przebiegu tylko p05 miała wyraźny DIF: χ²MH = 40.37, αMH = 0.345, ΔMH = 2.50 (SE = 0.40), kategoria C, p po korekcie Holma < .001. Szanse odpowiedzi „tak” u młodszych stanowiły więc około jednej trzeciej szans starszych o tym samym wyniku. Po usunięciu p05 z wyniku dopasowującego p05 pozostała w kategorii C, a wszystkie inne pozycje w kategorii A.
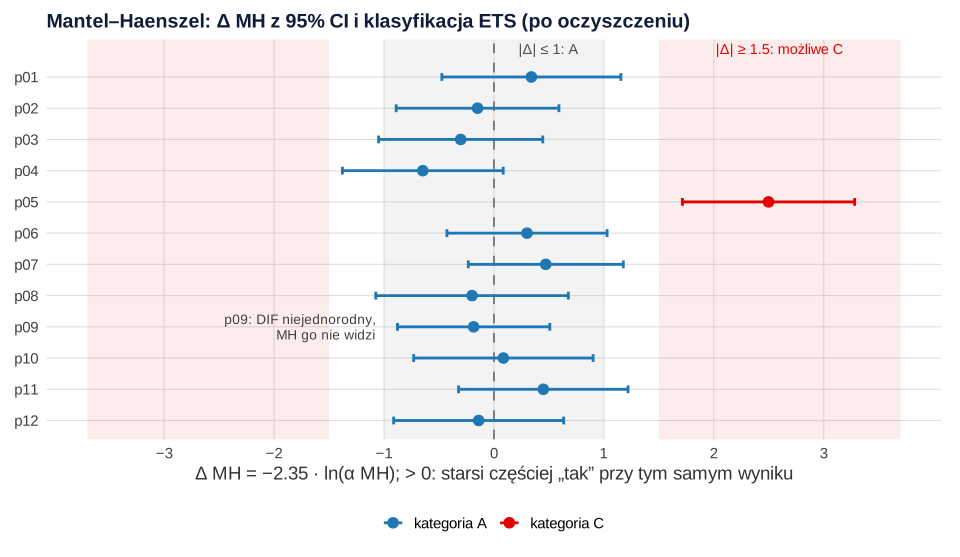
Rysunek pokazuje słabość metody. Pozycja p09 ma ΔMH = −0.18 (p = .649), choć jej krzywe w grupach wyraźnie się różnią. Wspólny iloraz szans uśrednia warstwy, więc przewaga starszych przy niskich wynikach i młodszych przy wysokich się znosi. Rogers i Swaminathan (1993) piszą wprost, że Mantel–Haenszel jest wrażliwy tylko na DIF jednego typu.
Krok 2. Regresja logistyczna: trzy modele zagnieżdżone
Swaminathan i Rogers (1990) zaproponowali, by dla każdej pozycji dopasować regresję logistyczną odpowiedzi na wynik dopasowujący S i grupę G:
Porównanie M0 z M1 testuje DIF jednorodny, M1 z M2 – niejednorodny, a M0 z M2 daje łączny test o 2 stopniach swobody (Choi i in., 2011). Każde porównanie to test ilorazu wiarygodności różnicy dewiancji. W symulacjach procedura ta miała większą moc niż Mantel–Haenszel dla DIF niejednorodnego i podobną dla jednorodnego (Rogers i Swaminathan, 1993).
Przy dużych próbach istotne bywają nawet znikome różnice, dlatego do testu dodaje się miarę efektu: zmianę pseudo-R² między M0 a M2. Pierwsze proponowane progi (.13 i .26) późniejsze badania uznały za zbyt wysokie (Choi i in., 2011). Jodoin i Gierl (2001) zaproponowali niższe: ΔR² < .035 to efekt pomijalny, .035–.070 umiarkowany, a powyżej .070 duży. Pokazali też, że kryterium efektu wyraźnie zmniejsza liczbę fałszywych alarmów w dużych próbach, choć kosztem mocy. W przykładzie liczymy ΔR² Nagelkerkego.
| Pozycja | χ²(2), M0 a M2 | p jednorodny | p niejednorodny | ΔR² | Klasa według Jodoin i Gierla |
|---|---|---|---|---|---|
| p05 | 45.46, p < .001 | < .001 | .394 | .042 | umiarkowany |
| p09 | 27.65, p < .001 | .933 | < .001 | .026 | pomijalny |
Regresja poprawnie rozpoznała typ DIF obu pozycji. W p09 test jest jednoznaczny, a ΔR² mieści się w klasie „pomijalny”. Progi efektu to umowne kryteria, a nie werdykt. Przy DIF niejednorodnym zawsze obejrzyj krzywe w grupach (rysunek 2) i sprawdź, jak DIF wpływa na wynik całej skali.
Krok 3. IRT: model wielogrupowy z kotwicą
W IRT dopasowujesz model 2PL w obu grupach (mirt::multipleGroup) z wolną średnią i wariancją cechy w grupie ogniskowej. Następnie funkcją DIF() testujesz równość parametrów pozycji testem ilorazu wiarygodności (Chalmers, 2012). Kluczowy jest wybór kotwicy. Stark i in. (2006) zalecają testować dyskryminacje i progi razem, względem modelu bazowego, w którym ograniczona jest tylko kotwica, z poprawką Bonferroniego. Takie podejście okazało się skuteczniejsze niż wyjście od modelu, w którym wszystkie parametry są równe. Postępowaliśmy w trzech krokach:
- Przegląd (
scheme = "drop"): każda pozycja testowana przy pozostałych jako kotwicy. Wskazał p05 (χ²(2) = 41.83) i p09 (χ²(2) = 29.58), obie z p po korekcie < .001. - Kotwica: cztery pozycje najdalej od DIF w przeglądzie (p11, p08, p06, p02).
- Test właściwy (
scheme = "add"): pozostałe osiem pozycji kolejno uwalniane przy stałej kotwicy. DIF potwierdził się tylko dla p05 (χ²(2) = 31.91) i p09 (χ²(2) = 25.85), z p po korekcie Holma < .001.
Osobne testy pokazały, który parametr się różni. W p05 był to wyraz wolny d, czyli próg (χ²(1) = 29.13, p < .001), a nie dyskryminacja (χ²(1) = 0.16, p = .690). W p09 było odwrotnie: dyskryminacja (χ²(1) = 25.50, p < .001), a nie próg (p = .173). W modelu końcowym próg p05 wyniósł −0.07 u młodszych i −0.84 u starszych, a dyskryminacja p09 odpowiednio 2.01 i 0.62. Średnia cechy u starszych wyniosła 0.28 (przy średniej 0 i wariancji 1 u młodszych), co jest różnicą w cesze, a nie DIF.
Porównanie trzech metod
| Mantel–Haenszel | Regresja logistyczna | IRT (mirt) | |
|---|---|---|---|
| p05 (DIF jednorodny) | Δ = 2.50, kategoria C | p < .001, ΔR² = .042 | p < .001 (próg) |
| p09 (DIF niejednorodny) | niewykryty, Δ = −0.18 | p < .001, ΔR² = .026 | p < .001 (dyskryminacja) |
| p04 (bez DIF) | p = .021 bez korekty, .232 po korekcie (przebieg 1) | p = 1.000 po korekcie | p = .439 po korekcie |
| Dopasowanie | wynik sumaryczny | wynik sumaryczny (lub θ) | θ z pozycji kotwiczących |
| Miara efektu | ΔMH, kategorie A/B/C | ΔR², współczynniki β2 i β3 | różnice parametrów, DTF |
| Kiedy wybrać | szybki przegląd, mniejsze próby, DIF jednorodny | standard dla skal, oba typy DIF | gdy i tak kalibrujesz pozycje w IRT |
Metody zgodziły się co do p05, różniły w ocenie p09 i nie dały fałszywych alarmów po korekcie. Wniosek praktyczny: jeśli podajesz tylko Mantela–Haenszela, napisz, że metoda nie wykrywa DIF niejednorodnego, albo uzupełnij ją regresją logistyczną.
Wiele pozycji, wiele testów
Przy 12 pozycjach wykonujesz 12 testów, a przy oczyszczaniu i kilku metodach jeszcze więcej. Bez kontroli problemu wielokrotnych porównań fałszywe alarmy są niemal pewne. W przykładzie p04 bez DIF miała w MH p = .021, a w przeglądzie IRT p = .007. Po korekcie Holma oba wyniki przestały być istotne. Korektę (Holm, Benjamini–Hochberg albo Bonferroni) zapisz w planie analizy. Wybór omawia wpis poprawki na wielokrotne porównania. Zwick (2012) przypomina też drugą stronę: reguła kategorii C często słabo wykrywa DIF nawet w dużych próbach. Brak flagi nie dowodzi więc braku DIF.
DIF a inwariancja pomiaru w CFA
To samo pytanie zadaje inwariancja pomiaru w wielogrupowej CFA. Nierówne ładunki odpowiadają DIF niejednorodnemu (brak inwariancji metrycznej), a nierówne wyrazy wolne lub progi – jednorodnemu (brak inwariancji skalarnej). Stark i in. (2006) pokazali, że CFA i IRT wykrywają DIF podobnie dobrze, gdy stosujesz tę samą strategię kotwicy. Różnica leży głównie w perspektywie. Inwariancja zaczyna od całej skali i schodzi do pozycji, a DIF zaczyna od pozycji. Procedurę w lavaan opisuje inwariancja pomiaru krok po kroku, dla pozycji porządkowych przydaje się kategorialna CFA z WLSMV, a DIF względem zmiennej ciągłej, np. wieku w latach, zbadasz modelem MIMIC.
Co zrobić z pozycją z DIF
- Przeanalizuj treść. DIF to sygnał statystyczny, a nie dowód stronniczości. Zapytaj ekspertów i osoby z grupy ogniskowej, czy sformułowanie znaczy dla nich to samo. Przy przekładach to część adaptacji narzędzia (zob. adaptacja kulturowa kwestionariusza).
- Sprawdź skutek dla skali (DTF). Chalmers i in. (2016) zauważają, że łączny skutek DIF na poziomie testu bywa ważniejszy niż DIF pojedynczych pozycji. W przykładzie oczekiwany wynik starszych był średnio o 0.05 pkt wyższy niż młodszych o tym samym θ (sDTF = −0.05, 95% CI [−0.10, −0.02]), a bezwzględna różnica wyniosła 0.16 pkt, czyli 1.3% zakresu skali. Efekty obu pozycji częściowo się znoszą: przy θ = −1 starsi mają oczekiwany wynik 2.28 wobec 1.82, a przy θ = 2 – 10.33 wobec 10.54.
- Usuń pozycję, gdy DIF jest duży, treść tłumaczy go jako zniekształcenie, a skala bez niej zachowuje trafność i rzetelność.
- Rozdziel parametry w grupach (częściowa inwariancja), gdy porównujesz grupy na θ. Tak zbudowany jest model końcowy z przykładu.
- Zostaw i zgłoś, gdy DIF jest pomijalny, a DTF znikomy. Opisz wtedy, na podstawie jakich kryteriów podjęto decyzję.
Jak opisać analizę DIF w artykule
Podaj zmienną grupującą i liczebności grup, zmienną dopasowującą, sposób oczyszczania lub wyboru kotwicy, testy, korektę na wielokrotne testy, miary efektu i ich progi oraz decyzję o każdej pozycji z DIF. Wzór na podstawie przykładu:
Jeśli recenzent pyta o DIF albo o porównywalność skali między grupami, możemy wspólnie zaplanować i sprawdzić analizę w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane i zapisuje plik dif-dane.csv (możesz go pobrać tutaj). Mantel–Haenszel i regresja logistyczna działają w bazowym R, a część IRT wymaga pakietu mirt.
1. Dane i procedura Mantela–Haenszela
R
# Dane symulowane: lista 12 objawów depresyjnych (0 = nie, 1 = tak), młodsi (18–39 lat, grupa odniesienia)
# i starsi dorośli (60+, grupa ogniskowa), po 500 osób. Starsi mają średnio nieco wyższy poziom cechy (impact, nie DIF).
# Wbudowany DIF: p05 (wczesne budzenie się) – jednorodny; p09 (mniej energii) – niejednorodny.
set.seed(2170)
n <- 500
grupa <- factor(rep(c("mlodsi", "starsi"), each = n), levels = c("mlodsi", "starsi"))
theta <- c(rnorm(n, 0, 1), rnorm(n, 0.3, 1))
a <- c(1.4, 1.1, 1.7, 1.2, 1.3, 1.5, 1.0, 1.6, 1.4, 1.2, 1.8, 1.1)   # dyskryminacje (2PL)
b <- c(-0.8, -0.4, 0.0, 0.3, -0.2, 0.6, 0.9, 1.2, 0.2, 1.5, 0.4, 1.0)  # trudności (progi)
A <- matrix(a, 2 * n, 12, byrow = TRUE); B <- matrix(b, 2 * n, 12, byrow = TRUE)
starsi <- grupa == "starsi"
B[starsi, 5] <- b[5] - 0.7            # p05: starsi częściej odpowiadają „tak” przy tym samym θ
A[!starsi, 9] <- 1.9; A[starsi, 9] <- 0.6   # p09: inna dyskryminacja, krzywe się przecinają
X <- (matrix(runif(2 * n * 12), 2 * n) < plogis(A * (theta - B))) * 1L
colnames(X) <- sprintf("p%02d", 1:12)
write.csv(data.frame(id = 1:(2 * n), grupa, X), "dif-dane.csv", row.names = FALSE)

# Wynik ogólny w grupach (różnica średnich to jeszcze nie DIF)
wynik <- rowSums(X)
round(sapply(split(wynik, grupa), function(x) c(M = mean(x), SD = sd(x))), 2)

# Mantel–Haenszel dla pozycji j: warstwy = wynik dopasowujący (kotwice + badana pozycja)
mh_dif <- function(j, kotwice = colnames(X)) {
  dop <- rowSums(X[, union(kotwice, colnames(X)[j]), drop = FALSE])
  ok <- ave(dop, dop, FUN = length) > 1                     # warstwy z co najmniej 2 osobami
  tab <- table(grupa[ok], factor(X[ok, j], levels = 1:0), dop[ok])   # odniesienie × odpowiedź × warstwa
  t <- mantelhaen.test(tab)
  alfa <- unname(t$estimate)                                # wspólny iloraz szans MH
  s <- 2.35 * (log(t$conf.int[2]) - log(t$conf.int[1])) / (2 * qnorm(.975))   # SE delty
  d <- -2.35 * log(alfa)                                    # Δ MH w metryce ETS
  pA <- 2 * pnorm(-abs(d) / s)                              # H0: Δ = 0
  pC <- pnorm((-1 - abs(d)) / s) + pnorm((1 - abs(d)) / s)  # H0: |Δ| ≤ 1
  ets <- if (abs(d) <= 1 || pA >= .05) "A" else if (abs(d) >= 1.5 && pC < .05) "C" else "B"
  data.frame(pozycja = colnames(X)[j], chi2_MH = unname(t$statistic), p = t$p.value,
             alfa_MH = alfa, delta_MH = d, SE_delta = s, ETS = ets)
}
pokaz <- function(r) { r[sapply(r, is.numeric)] <- lapply(r[sapply(r, is.numeric)], round, 3); print(r, row.names = FALSE) }

# Krok 1: wszystkie pozycje w wyniku dopasowującym, korekta Holma
mh1 <- do.call(rbind, lapply(1:12, mh_dif)); mh1$p_Holm <- p.adjust(mh1$p, "holm"); pokaz(mh1)

# Krok 2: oczyszczanie – pozycje z istotnym DIF usuwamy z wyniku dopasowującego
kotwice_mh <- setdiff(colnames(X), mh1$pozycja[mh1$p_Holm < .05]); kotwice_mh
mh2 <- do.call(rbind, lapply(1:12, mh_dif, kotwice = kotwice_mh)); mh2$p_Holm <- p.adjust(mh2$p, "holm"); pokaz(mh2)
Wynik w R
   mlodsi starsi
M    4.90   5.85
SD   3.14   2.97
 pozycja chi2_MH     p alfa_MH delta_MH SE_delta ETS p_Holm
     p01   0.007 0.931   0.970    0.072    0.413   A  1.000
     p02   0.797 0.372   1.168   -0.365    0.374   A  1.000
     p03   2.556 0.110   1.311   -0.636    0.381   A  1.000
     p04   5.317 0.021   1.459   -0.888    0.373   A  0.232
     p05  40.369 0.000   0.345    2.498    0.400   C  0.000
     p06   0.032 0.858   0.960    0.096    0.373   A  1.000
     p07   0.687 0.407   0.870    0.326    0.360   A  1.000
     p08   0.598 0.439   1.181   -0.390    0.447   A  1.000
     p09   0.889 0.346   1.163   -0.356    0.353   A  1.000
     p10   0.011 0.916   1.035   -0.081    0.416   A  1.000
     p11   0.037 0.848   0.955    0.108    0.392   A  1.000
     p12   0.479 0.489   1.137   -0.302    0.393   A  1.000
 [1] "p01" "p02" "p03" "p04" "p06" "p07" "p08" "p09" "p10" "p11" "p12"
 pozycja chi2_MH     p alfa_MH delta_MH SE_delta ETS p_Holm
     p01   0.530 0.466   0.865    0.340    0.416   A      1
     p02   0.099 0.753   1.066   -0.149    0.378   A      1
     p03   0.506 0.477   1.137   -0.303    0.381   A      1
     p04   2.745 0.098   1.317   -0.647    0.373   A      1
     p05  40.369 0.000   0.345    2.498    0.400   C      0
     p06   0.532 0.466   0.880    0.300    0.372   A      1
     p07   1.537 0.215   0.818    0.471    0.360   A      1
     p08   0.121 0.728   1.089   -0.199    0.447   A      1
     p09   0.207 0.649   1.082   -0.185    0.354   A      1
     p10   0.014 0.907   0.964    0.086    0.416   A      1
     p11   1.114 0.291   0.826    0.449    0.393   A      1
     p12   0.074 0.786   1.061   -0.139    0.394   A      1
2. Regresja logistyczna: trzy modele zagnieżdżone
R
# Regresja logistyczna (Swaminathan i Rogers, 1990): trzy modele zagnieżdżone dla każdej pozycji
# M0: wynik dopasowujący; M1: + grupa (DIF jednorodny); M2: + interakcja (DIF niejednorodny)
r2_nagelkerke <- function(m) {
  N <- length(m$y)
  (1 - exp((m$deviance - m$null.deviance) / N)) / (1 - exp(-m$null.deviance / N))
}
lr_dif <- function(j, kotwice = colnames(X)) {
  y <- X[, j]
  s <- rowSums(X[, union(kotwice, colnames(X)[j]), drop = FALSE])
  m0 <- glm(y ~ s, family = binomial)
  m1 <- glm(y ~ s + grupa, family = binomial)
  m2 <- glm(y ~ s * grupa, family = binomial)
  data.frame(pozycja = colnames(X)[j],
             chi2_2df = m0$deviance - m2$deviance,
             p_2df = pchisq(m0$deviance - m2$deviance, 2, lower.tail = FALSE),
             p_jednorodny = pchisq(m0$deviance - m1$deviance, 1, lower.tail = FALSE),
             p_niejednorodny = pchisq(m1$deviance - m2$deviance, 1, lower.tail = FALSE),
             dR2_calk = r2_nagelkerke(m2) - r2_nagelkerke(m0),
             b_grupa = unname(coef(m1)["grupastarsi"]),
             b_interakcja = unname(coef(m2)["s:grupastarsi"]))
}
lr1 <- do.call(rbind, lapply(1:12, lr_dif)); lr1$p_Holm <- p.adjust(lr1$p_2df, "holm")
kotwice_lr <- setdiff(colnames(X), lr1$pozycja[lr1$p_Holm < .05]); kotwice_lr
# Oczyszczony wynik dopasowujący i klasyfikacja ΔR² według Jodoin i Gierla (2001)
lr2 <- do.call(rbind, lapply(1:12, lr_dif, kotwice = kotwice_lr)); lr2$p_Holm <- p.adjust(lr2$p_2df, "holm")
lr2$efekt <- cut(lr2$dR2_calk, c(-Inf, .035, .070, Inf), labels = c("pomijalny", "umiarkowany", "duży"), right = FALSE)
pokaz(lr2)
Wynik w R
 [1] "p01" "p02" "p03" "p04" "p06" "p07" "p08" "p10" "p11" "p12"
 pozycja chi2_2df p_2df p_jednorodny p_niejednorodny dR2_calk b_grupa
     p01    1.472 0.479        0.268           0.619    0.001   0.190
     p02    0.157 0.925        0.981           0.693    0.000   0.004
     p03    0.651 0.722        0.448           0.786    0.001  -0.122
     p04    3.961 0.138        0.058           0.538    0.004  -0.302
     p05   45.464 0.000        0.000           0.394    0.042   1.117
     p06    0.673 0.714        0.412           0.996    0.001   0.130
     p07    6.879 0.032        0.142           0.030    0.007   0.225
     p08    0.525 0.769        0.470           0.961    0.001  -0.137
     p09   27.652 0.000        0.933           0.000    0.026  -0.013
     p10    0.806 0.668        0.966           0.370    0.001  -0.008
     p11    4.223 0.121        0.187           0.115    0.004   0.221
     p12    1.508 0.470        0.680           0.247    0.001  -0.071
 b_interakcja p_Holm       efekt
        0.050  1.000   pomijalny
        0.031  1.000   pomijalny
        0.024  1.000   pomijalny
        0.050  1.000   pomijalny
        0.073  0.000 umiarkowany
        0.000  1.000   pomijalny
       -0.151  0.321   pomijalny
        0.005  1.000   pomijalny
       -0.363  0.000   pomijalny
        0.072  1.000   pomijalny
       -0.143  1.000   pomijalny
        0.097  1.000   pomijalny
3. IRT: kotwica, DIF() i DTF w pakiecie mirt
R
# DIF w IRT: model 2PL w dwóch grupach (mirt), kotwice i testy ilorazu wiarygodności
suppressPackageStartupMessages(library(mirt))
# Krok 1: przegląd – każda pozycja testowana przy pozostałych jako kotwicach (schemat „drop”)
mg_wszystkie <- multipleGroup(X, 1, group = grupa, itemtype = "2PL",
                              invariance = c(colnames(X), "free_means", "free_var"), verbose = FALSE)
przeglad <- DIF(mg_wszystkie, which.par = c("a1", "d"), scheme = "drop", p.adjust = "holm", verbose = FALSE)
round(przeglad[, c("X2", "df", "p", "adj_p")], 3)

# Krok 2: kotwica = 4 pozycje najdalej od DIF w przeglądzie
kotwice_irt <- rownames(przeglad)[order(przeglad$p, decreasing = TRUE)][1:4]; kotwice_irt
mg_kotwice <- multipleGroup(X, 1, group = grupa, itemtype = "2PL",
                            invariance = c(kotwice_irt, "free_means", "free_var"), verbose = FALSE)
# Krok 3: pozostałe pozycje testowane po kolei przy ustalonej kotwicy (schemat „add”), korekta Holma
irt <- DIF(mg_kotwice, which.par = c("a1", "d"), scheme = "add",
           items2test = setdiff(colnames(X), kotwice_irt), p.adjust = "holm", verbose = FALSE)
round(irt[, c("X2", "df", "p", "adj_p")], 3)
# Który parametr się różni: osobno dyskryminacja (a1) i próg (d)
round(DIF(mg_kotwice, which.par = "a1", scheme = "add", items2test = c("p05", "p09"), verbose = FALSE)[, c("X2", "p")], 3)
round(DIF(mg_kotwice, which.par = "d", scheme = "add", items2test = c("p05", "p09"), verbose = FALSE)[, c("X2", "p")], 3)

# Model końcowy: parametry p05 i p09 swobodne w grupach, pozostałe wspólne
dif_irt <- rownames(irt)[irt$adj_p < .05]
mg_koniec <- multipleGroup(X, 1, group = grupa, itemtype = "2PL", SE = TRUE, verbose = FALSE,
                           invariance = c(setdiff(colnames(X), dif_irt), "free_means", "free_var"))
wsp <- coef(mg_koniec, IRTpars = TRUE, simplify = TRUE)
lapply(wsp, function(g) round(g$items[dif_irt, c("a", "b")], 2))
round(c(srednia_starsi = wsp$starsi$means[[1]], wariancja_starsi = wsp$starsi$cov[[1]]), 2)

# Skutek na poziomie testu (DTF): oczekiwany wynik 0–12 w grupach przy tym samym θ
set.seed(2171)
DTF(mg_koniec, draws = 500)
th <- matrix(c(-2, -1, 0, 1, 2))
round(sapply(c("mlodsi", "starsi"), function(g) expected.test(extract.group(mg_koniec, g), th)), 2)
Wynik w R
        X2 df     p adj_p
p01  1.849  2 0.397 1.000
p02  1.748  2 0.417 1.000
p03  5.624  2  0.06 0.541
p04  9.796  2 0.007 0.075
p05  41.83  2     0 0.000
p06   1.65  2 0.438 1.000
p07  2.834  2 0.242 1.000
p08  1.202  2 0.548 1.000
p09 29.581  2     0 0.000
p10  2.707  2 0.258 1.000
p11  0.324  2  0.85 1.000
p12  5.035  2 0.081 0.645
[1] "p11" "p08" "p06" "p02"
        X2 df     p adj_p
p01  1.087  2 0.581 1.000
p03  1.936  2  0.38 1.000
p04  5.231  2 0.073 0.439
p05 31.909  2     0 0.000
p07  3.539  2  0.17 0.852
p09 25.846  2     0 0.000
p10  1.525  2 0.467 1.000
p12  2.738  2 0.254 1.000
        X2    p
p05  0.159 0.69
p09 25.496    0
        X2     p
p05 29.129     0
p09  1.857 0.173
$mlodsi
       a     b
p05 1.46 -0.07
p09 2.01  0.26

$starsi
       a     b
p05 1.48 -0.84
p09 0.62  0.40

  srednia_starsi wariancja_starsi
            0.28             0.97
$observed
   sDTF.score sDTF(%).score    uDTF.score uDTF(%).score
  -0.05380978   -0.44841487    0.15923570    1.32696418

$CIs
         sDTF.score sDTF(%).score uDTF.score uDTF(%).score
CI_97.5 -0.01738326    -0.1448605  0.2637227     2.1976894
CI_2.5  -0.09805806    -0.8171505  0.1025310     0.8544254

$tests
P(sDTF.score = 0)
      0.009074957

     mlodsi starsi
[1,]   0.58   0.85
[2,]   1.82   2.28
[3,]   4.59   4.90
[4,]   8.17   8.05
[5,]  10.54  10.33
4. Zestawienie trzech metod
R
# Porównanie trzech metod (po oczyszczeniu, korekta Holma, α = .05)
porownanie <- data.frame(pozycja = colnames(X),
  MH_delta = round(mh2$delta_MH, 2), MH_ETS = mh2$ETS, MH_p_Holm = round(mh2$p_Holm, 3),
  LR_dR2 = round(lr2$dR2_calk, 3), LR_p_Holm = round(lr2$p_Holm, 3),
  IRT_p_Holm = round(irt$adj_p[match(colnames(X), rownames(irt))], 3))
porownanie$IRT_p_Holm[is.na(porownanie$IRT_p_Holm)] <- NA   # kotwice nie są testowane
print(porownanie, row.names = FALSE)
Wynik w R
 pozycja MH_delta MH_ETS MH_p_Holm LR_dR2 LR_p_Holm IRT_p_Holm
     p01     0.34      A         1  0.001     1.000      1.000
     p02    -0.15      A         1  0.000     1.000         NA
     p03    -0.30      A         1  0.001     1.000      1.000
     p04    -0.65      A         1  0.004     1.000      0.439
     p05     2.50      C         0  0.042     0.000      0.000
     p06     0.30      A         1  0.001     1.000         NA
     p07     0.47      A         1  0.007     0.321      0.852
     p08    -0.20      A         1  0.001     1.000         NA
     p09    -0.18      A         1  0.026     0.000      0.000
     p10     0.09      A         1  0.001     1.000      1.000
     p11     0.45      A         1  0.004     1.000         NA
     p12    -0.14      A         1  0.001     1.000      1.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje mantelhaen.test(), glm(), p.adjust()) i w pakiecie mirt (funkcje multipleGroup(), DIF(), DTF()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mirt (wersja 1.47): Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Różnica średnich pozycji uznana za DIF. Bez dopasowania na poziomie cechy mylisz DIF z rzeczywistą różnicą między grupami.
- Tylko Mantel–Haenszel. DIF niejednorodny zostaje wtedy niewidoczny.
- Brak oczyszczania i kotwica wybrana „na oko”. Pozycja z DIF w kotwicy przesuwa skalę i wywołuje pozorny DIF w innych pozycjach.
- Same wartości p. W dużej próbie flagę dostaje każda drobna różnica, a w małej nawet duży DIF bywa nieistotny. Podawaj miarę efektu i DTF.
- Automatyczne usuwanie pozycji. Decyzja wymaga analizy treści i oceny skutku dla skali (zob. przewodnik po psychometrii).
Najczęstsze pytania
Jak w R sprawdzić, czy DIF jest jednorodny, czy niejednorodny?
Dopasuj dla pozycji trzy modele glm(..., family = binomial): z samym wynikiem dopasowującym, z dodaną grupą i z interakcją wynik × grupa. Porównanie dwóch pierwszych testuje DIF jednorodny, a dwóch ostatnich niejednorodny (Swaminathan i Rogers, 1990). W mirt to samo pokażą osobne testy DIF() dla wyrazu wolnego d (próg) i dyskryminacji a1.
Czy metoda Mantela–Haenszela wykrywa DIF niejednorodny?
Zwykle nie. Wspólny iloraz szans uśrednia warstwy, więc gdy krzywe grup się przecinają, przewagi w różnych częściach skali się znoszą (Rogers i Swaminathan, 1993). W przykładzie pozycja z wyraźnym DIF niejednorodnym miała Δ MH = −0.18 i kategorię A. Uzupełnij więc MH regresją logistyczną albo IRT.
Jakie ΔR² oznacza istotny praktycznie DIF w regresji logistycznej?
Najczęściej stosuje się kryteria Jodoin i Gierla (2001): ΔR² poniżej .035 to DIF pomijalny, od .035 do .070 umiarkowany, a powyżej .070 duży. Starsze, wyższe progi uznano za zbyt mało czułe (Choi i in., 2011). Traktuj progi jako umowę i uzupełniaj je wykresem krzywych oraz oceną skutku dla całej skali.
Czy pozycję z DIF trzeba usunąć ze skali?
Nie automatycznie. Najpierw sprawdź treść pozycji i oceń łączny skutek DIF dla wyniku skali (DTF; Chalmers i in., 2016). Pozycję możesz usunąć, zostawić z parametrami swoistymi dla grup albo zostawić i opisać, gdy DIF jest pomijalny. Każdą decyzję uzasadnij w raporcie.
Czym różni się analiza DIF od testu inwariancji pomiaru w CFA?
Pytanie jest to samo: czy parametry pomiaru są równe w grupach. Nierówne ładunki odpowiadają DIF niejednorodnemu, a nierówne wyrazy wolne lub progi jednorodnemu. CFA zaczyna zwykle od całej skali, a DIF od pojedynczych pozycji. Przy tej samej strategii kotwicy obie metody działają podobnie dobrze (Stark i in., 2006).
Powiązane hasła
Przeczytaj też
IRT w R krok po kroku: pakiet mirt
Pełna analiza na prawdziwych danych: Rasch i 2PL, dopasowanie, informacja, oceny θ, GRM dla skali Likerta, porównanie z CFA i DIF — z kodem.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikAdaptacja kulturowa kwestionariusza
Dziesięć etapów według ITC: zgoda autora, przekład, CVI, wywiady poznawcze, pilotaż, CFA i inwariancja w R, rzetelność, trafność, normy i opis APA.
Czytaj →Recenzent pyta, czy skala działa tak samo w porównywanych grupach?
Pomożemy zaplanować i przeprowadzić analizę DIF i inwariancji pomiaru, dobrać kotwicę i kryteria oraz wyjaśnić wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06 ● Otwarty dostęp
- Chalmers, R. P., Counsell, A., & Flora, D. B. (2016). It might not make a big DIF: Improved differential test functioning statistics that account for sampling variability. Educational and Psychological Measurement, 76(1), 114–140. https://doi.org/10.1177/0013164415584576 ● Otwarty dostęp: pełny tekst
- Choi, S. W., Gibbons, L. E., & Crane, P. K. (2011). lordif: An R package for detecting differential item functioning using iterative hybrid ordinal logistic regression/item response theory and Monte Carlo simulations. Journal of Statistical Software, 39(8), 1–30. https://doi.org/10.18637/jss.v039.i08 ● Otwarty dostęp
- Henninger, M., Debelak, R., & Strobl, C. (2023). A new stopping criterion for Rasch trees based on the Mantel–Haenszel effect size measure for differential item functioning. Educational and Psychological Measurement, 83(1), 181–212. https://doi.org/10.1177/00131644221077135 ● Otwarty dostęp
- Jodoin, M. G., & Gierl, M. J. (2001). Evaluating Type I error and power rates using an effect size measure with the logistic regression procedure for DIF detection. Applied Measurement in Education, 14(4), 329–349. https://doi.org/10.1207/s15324818ame1404_2
- Mantel, N., & Haenszel, W. (1959). Statistical aspects of the analysis of data from retrospective studies of disease. Journal of the National Cancer Institute, 22(4), 719–748. https://doi.org/10.1093/jnci/22.4.719
- Rogers, H. J., & Swaminathan, H. (1993). A comparison of logistic regression and Mantel-Haenszel procedures for detecting differential item functioning. Applied Psychological Measurement, 17(2), 105–116. https://doi.org/10.1177/014662169301700201 ● Otwarty dostęp: pełny tekst
- Stark, S., Chernyshenko, O. S., & Drasgow, F. (2006). Detecting differential item functioning with confirmatory factor analysis and item response theory: Toward a unified strategy. Journal of Applied Psychology, 91(6), 1292–1306. https://doi.org/10.1037/0021-9010.91.6.1292
- Swaminathan, H., & Rogers, H. J. (1990). Detecting differential item functioning using logistic regression procedures. Journal of Educational Measurement, 27(4), 361–370. https://doi.org/10.1111/j.1745-3984.1990.tb00754.x
- Zwick, R. (2012). A review of ETS differential item functioning assessment procedures: Flagging rules, minimum sample size requirements, and criterion refinement. ETS Research Report Series, 2012(1). https://doi.org/10.1002/j.2333-8504.2012.tb02290.x ● Otwarty dostęp
Cytowania BibTeX
@article{chalmers2012mirt, author={Chalmers, R. Philip}, title={{mirt: A multidimensional item response theory package for the R environment}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={6}, pages={1--29}, doi={10.18637/jss.v048.i06}}@article{chalmers2016might, author={Chalmers, R. Philip and Counsell, Alyssa and Flora, David B.}, title={{It might not make a big DIF: Improved differential test functioning statistics that account for sampling variability}}, journal={Educational and Psychological Measurement}, year={2016}, volume={76}, number={1}, pages={114--140}, doi={10.1177/0013164415584576}}@article{choi2011lordif, author={Choi, Seung W. and Gibbons, Laura E. and Crane, Paul K.}, title={{lordif: An R package for detecting differential item functioning using iterative hybrid ordinal logistic regression/item response theory and Monte Carlo simulations}}, journal={Journal of Statistical Software}, year={2011}, volume={39}, number={8}, pages={1--30}, doi={10.18637/jss.v039.i08}}@article{henninger2023new, author={Henninger, Mirka and Debelak, Rudolf and Strobl, Carolin}, title={{A new stopping criterion for Rasch trees based on the Mantel–Haenszel effect size measure for differential item functioning}}, journal={Educational and Psychological Measurement}, year={2023}, volume={83}, number={1}, pages={181--212}, doi={10.1177/00131644221077135}}@article{jodoin2001evaluating, author={Jodoin, Michael G. and Gierl, Mark J.}, title={{Evaluating Type I error and power rates using an effect size measure with the logistic regression procedure for DIF detection}}, journal={Applied Measurement in Education}, year={2001}, volume={14}, number={4}, pages={329--349}, doi={10.1207/s15324818ame1404_2}}@article{mantel1959statistical, author={Mantel, Nathan and Haenszel, William}, title={{Statistical aspects of the analysis of data from retrospective studies of disease}}, journal={Journal of the National Cancer Institute}, year={1959}, volume={22}, number={4}, pages={719--748}, doi={10.1093/jnci/22.4.719}}@article{rogers1993comparison, author={Rogers, H. Jane and Swaminathan, Hariharan}, title={{A comparison of logistic regression and Mantel-Haenszel procedures for detecting differential item functioning}}, journal={Applied Psychological Measurement}, year={1993}, volume={17}, number={2}, pages={105--116}, doi={10.1177/014662169301700201}}@article{stark2006detecting, author={Stark, Stephen and Chernyshenko, Oleksandr S. and Drasgow, Fritz}, title={{Detecting differential item functioning with confirmatory factor analysis and item response theory: Toward a unified strategy}}, journal={Journal of Applied Psychology}, year={2006}, volume={91}, number={6}, pages={1292--1306}, doi={10.1037/0021-9010.91.6.1292}}@article{swaminathan1990detecting, author={Swaminathan, Hariharan and Rogers, H. Jane}, title={{Detecting differential item functioning using logistic regression procedures}}, journal={Journal of Educational Measurement}, year={1990}, volume={27}, number={4}, pages={361--370}, doi={10.1111/j.1745-3984.1990.tb00754.x}}@article{zwick2012review, author={Zwick, Rebecca}, title={{A review of ETS differential item functioning assessment procedures: Flagging rules, minimum sample size requirements, and criterion refinement}}, journal={ETS Research Report Series}, year={2012}, volume={2012}, number={1}, doi={10.1002/j.2333-8504.2012.tb02290.x}}