Kiedy analiza sieciowa, a kiedy model czynnikowy
Klasyczna psychometria zakłada, że pozycje skali korelują, bo mierzą tę samą zmienną ukrytą. Podejście sieciowe proponuje inne wyjaśnienie: objawy wpływają na siebie nawzajem. Borsboom i Cramer (2013) opisują zaburzenie jako układ oddziałujących objawów (np. zamartwianie → bezsenność → zmęczenie), a nie skutek jednego wspólnego czynnika. Fried i in. (2017) w przeglądzie badań z lat 2010–2016 pokazują, że takie modele stosowano głównie do wyjaśniania współwystępowania zaburzeń, do predykcji i do szukania celów interwencji. Podstawy pojęciowe – czym jest węzeł, krawędź i sieć korelacji cząstkowych – opisuje hasło sieć psychometryczna, a wskaźniki ważności węzłów hasło centralność w sieci. Tutaj przechodzimy przez pełną analizę w R, od surowych odpowiedzi do tabeli i opisu w artykule.
| Pytanie | Podejście |
|---|---|
| Które objawy lub pozycje łączą się ze sobą po kontroli pozostałych? Które łączą dwa zaburzenia? | przekrojowa sieć korelacji cząstkowych (ten poradnik) |
| Ile wymiarów ma narzędzie i które pozycje do nich należą? | EFA i CFA; eksploracyjnie także wspólnoty w sieci (krok 7) |
| Czy skala ma czynnik ogólny i czynniki specyficzne? | model bifactor i ESEM |
| Jak objawy zmieniają się w czasie u tej samej osoby? | sieci z danych podłużnych lub intensywnych pomiarów; dla dwóch zmiennych modele cross-lagged |
Te podejścia nie wykluczają się. Sieć z danych przekrojowych to w gruncie rzeczy inny opis tej samej macierzy korelacji. Dlatego w doktoracie warto ją traktować jako uzupełnienie modelu czynnikowego, a nie dowód, że model czynnikowy jest fałszywy.
Badanie przykładowe: objawy depresji i lęku u studentów
Przykład (dane symulowane): 520 studentów oceniło, jak często w ostatnich dwóch tygodniach odczuwało dziesięć objawów, na skali 0 (wcale), 1 (kilka dni), 2 (ponad połowę dni), 3 (prawie codziennie). Pięć objawów to objawy depresyjne: obniżony nastrój, anhedonia (utrata zainteresowań), problemy ze snem, zmęczenie i poczucie winy. Pięć to objawy lękowe: zamartwianie, napięcie, niepokój ruchowy, drażliwość i obawa przed katastrofą. Na rysunkach używamy skrótów (NAS, ANH, SEN, ZMĘ, WIN, ZAM, NAP, NIE, DRA, KAT). Pozycje tylko przypominają popularne przesiewowe skale objawów; o liczeniu wyników PHQ-9 i GAD-7 piszemy w tekście GAD-7 i PHQ-9 – jak policzyć wynik.
Dane wygenerowaliśmy ze znanej sieci z 16 krawędziami, w tym czterema „mostami” między objawami depresyjnymi i lękowymi. Dzięki temu pod koniec sprawdzimy, ile prawdy odtworzyła analiza, czego przy prawdziwych danych zrobić się nie da. Dane pobierzesz tutaj: sieci-psychometryczne-dane.csv (520 wierszy, 10 kolumn z wartościami 0–3, bez braków).
Rozkłady są typowe dla objawów w próbie nieklinicznej: od 54.4% do 59.2% osób wybrało odpowiedź 0, średnie wynosiły od 0.61 do 0.72, a skośność od 1.04 do 1.23. Przy takiej skośności i czterech kategoriach odpowiedzi zwykła korelacja Pearsona jest zaniżona, a duża liczba zer przypomina efekt podłogi.
Krok 1. Dane porządkowe: korelacje polichoryczne
Sieć korelacji cząstkowych szacuje się z macierzy korelacji, więc pierwszy wybór dotyczy właśnie jej. Odpowiedzi 0–3 są na skali porządkowej. Korelacja polichoryczna zakłada, że za każdą pozycją stoi ciągła zmienna o rozkładzie normalnym, podzielona progami na kategorie, i szacuje korelację tych zmiennych (Olsson, 1979). Epskamp i in. (2018) wskazują, że przy danych porządkowych macierz polichoryczna może być podstawą sieci. Funkcja cor_auto() z pakietu qgraph sama rozpoznaje zmienne porządkowe i liczy dla nich korelacje polichoryczne.
W przykładzie korelacje polichoryczne wynosiły od −.099 do .491, a korelacje Spearmana – od −.073 do .377. Średnio polichoryczne były wyższe o .031. Różnica wydaje się mała, ale przy dziesięciu węzłach przekłada się na inną gęstość sieci. Baba i in. (2004) przypominają przy tym, że zerowa korelacja cząstkowa oznacza warunkową niezależność tylko przy wielowymiarowym rozkładzie normalnym. Przy pozycjach porządkowych to założenie dotyczy zmiennych ciągłych, które zakładamy pod odpowiedziami, i warto je w pracy nazwać.
Zanim przejdziesz dalej, przejrzyj treść pozycji. Dwie pozycje, które pytają prawie o to samo (np. „trudności z zasypianiem” i „budzenie się w nocy”), dadzą bardzo silną krawędź i zawyżą centralność obu węzłów. Pakiety do automatycznego wykrywania takich par (np. networktools) nie były w naszym środowisku dostępne, dlatego w przykładzie ograniczyliśmy się do oceny treści i macierzy korelacji: żadna para nie korelowała wyżej niż .491.
Krok 2. Estymacja sieci: EBICglasso
Zwykła macierz korelacji cząstkowych (odwrócona macierz korelacji) daje dla 10 węzłów 45 niezerowych wartości. W przykładzie 27 z nich miało wartość bezwzględną poniżej .05, czyli w dużej mierze był to szum próby. Dlatego sieci szacuje się z regularyzacją. Graphical lasso (Friedman i in., 2008) nakłada na odwrotność macierzy kowariancji karę typu lasso, która zeruje słabe korelacje cząstkowe i zmniejsza pozostałe. Siłę kary wybiera kryterium EBIC z parametrem γ: im wyższe γ, tym oszczędniejsza sieć. Epskamp i Fried (2018) opisują krok po kroku estymację takiej sieci, najpopularniejszego modelu sieciowego w psychologii, i omawiają m.in. problem danych nienormalnych i liczebności próby. Regularyzacja chroni też przed przeuczeniem, czyli dopasowaniem sieci do przypadkowych cech jednej próby.
Sieć EBICglasso z γ = 0.5 zachowała 17 z 45 możliwych krawędzi (gęstość .378). Przy γ = 0.25 krawędzi było 20, a przy γ = 0 – 21. Najsilniejsze krawędzie to:
- nastrój – anhedonia: .385,
- sen – zmęczenie: .365,
- zamartwianie – obawa przed katastrofą: .291,
- napięcie – niepokój: .279,
- zamartwianie – napięcie: .219,
- nastrój – poczucie winy: .201.
Jedna krawędź była ujemna (nastrój – niepokój, −.028), a dwie z najsilniejszych krawędzi łączących obie grupy objawów prowadziły od zamartwiania: do nastroju (.120) i do snu (.047). Wagi krawędzi to regularyzowane korelacje cząstkowe, więc są mniejsze od zwykłych korelacji i nie można ich porównywać z progami dla r.
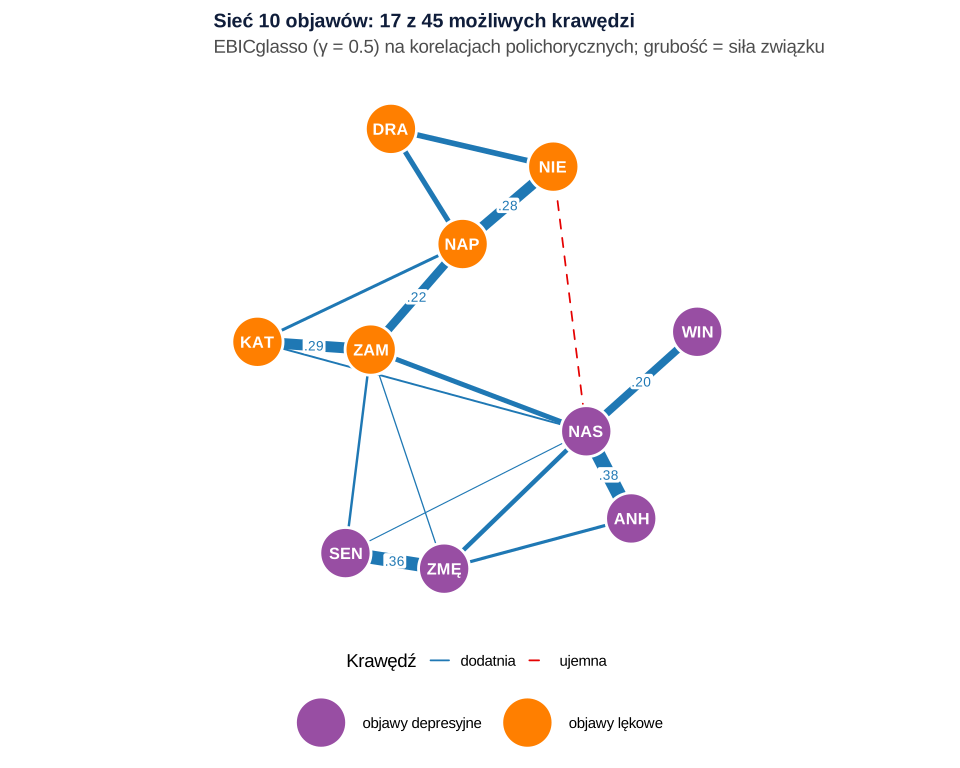
Czytając rysunek, patrz na grubość i kolor krawędzi, a nie na odległości. Algorytm układu zbliża silnie połączone węzły, ale dwa węzły narysowane blisko siebie nie muszą być połączone. Grubość krawędzi skaluj tak samo, gdy porównujesz dwie sieci (np. dwie grupy), bo inaczej wrażenie różnicy może wynikać z samej skali rysunku.
Ile prawdy odtworzyła sieć: czułość i swoistość
Ponieważ dane są symulowane, możemy porównać sieć z siecią, z której je wygenerowaliśmy. EBICglasso wykrył 13 z 16 prawdziwych krawędzi (czułość .812) i poprawnie pominął 25 z 29 krawędzi zerowych (swoistość .862). Korelacja oszacowanych wag z prawdziwymi wyniosła .923. Cztery fałszywie dodatnie krawędzie były bardzo słabe: od −.028 do .033. Pominięte krawędzie miały w populacji wagi .10–.12 (w tym jedna ujemna). Najsłabsze krawędzie sieci regularyzowanej to najmniej pewna część wyniku.
| Metoda | Krawędzie | Czułość | Swoistość | r wag z prawdziwymi |
|---|---|---|---|---|
| EBICglasso, γ = 0.5 | 17 | .812 | .862 | .923 |
EBICglasso z progowaniem (threshold = TRUE) | 9 | .562 | 1.000 | .879 |
nieregularyzowany wybór modelu (ggmModSelect) | 13 | .750 | .966 | .931 |
Tabela dobrze ilustruje wniosek z dużej symulacji Isvoranu i Epskampa (2023): między wykrywaniem krawędzi a ostrożnością zawsze jest kompromis, a metodę estymacji trzeba dobrać do pytania badawczego. Jeśli interesują Cię słabe krawędzie łączące dwa zaburzenia, zależy Ci na czułości. Jeśli chcesz mieć pewność, że każda pokazana krawędź istnieje, wybierz metodę bardziej swoistą i pogódź się z tym, że część krawędzi zniknie. Ważne, by decyzję podjąć przed analizą i opisać ją w pracy.
Krok 3. Centralność i siła mostowa
Centralność opisuje położenie węzła w sieci. Najczęściej raportuje się siłę (sumę wartości bezwzględnych wag krawędzi węzła). Gdy w sieci są krawędzie ujemne, dodaje się oczekiwany wpływ (EI), czyli sumę wag ze znakiem (Robinaugh i in., 2016). Siłę mostową liczymy podobnie jak siłę, ale tylko z krawędzi prowadzących do drugiej grupy objawów (tu: z depresyjnych do lękowych i odwrotnie).
Tabela 1
Wskaźniki centralności dziesięciu objawów depresji i lęku w sieci EBICglasso
| Objaw | Siła | EI | Siła mostowa | Pośrednictwo |
|---|---|---|---|---|
| Objawy depresyjne | ||||
| Nastrój | 0.884 | 0.829 | 0.181 | 50 |
| Anhedonia | 0.453 | 0.453 | 0.000 | 0 |
| Sen | 0.423 | 0.423 | 0.047 | 0 |
| Zmęczenie | 0.556 | 0.556 | 0.015 | 16 |
| Poczucie winy | 0.201 | 0.201 | 0.000 | 0 |
| Objawy lękowe | ||||
| Zamartwianie | 0.693 | 0.693 | 0.182 | 46 |
| Napięcie | 0.687 | 0.687 | 0.000 | 28 |
| Niepokój | 0.446 | 0.391 | 0.028 | 0 |
| Drażliwość | 0.264 | 0.264 | 0.000 | 0 |
| Obawa przed katastrofą | 0.388 | 0.388 | 0.033 | 0 |
Uwaga. N = 520. Sieć regularyzowanych korelacji cząstkowych (EBICglasso, γ = 0.5) oszacowana z korelacji polichorycznych. Siła – suma wartości bezwzględnych wag krawędzi; EI – oczekiwany wpływ (suma wag ze znakiem); siła mostowa – suma wartości bezwzględnych wag krawędzi do objawów drugiej grupy; pośrednictwo – liczba najkrótszych ścieżek przechodzących przez węzeł, podana tylko dla porównania (niestabilne, zob. tekst). Współczynnik stabilności CS: siła i EI .55, pośrednictwo .35. Dane symulowane.
Największą siłę miał nastrój (0.884), a za nim zamartwianie (0.693) i napięcie (0.687). EI różni się od siły tylko dla dwóch węzłów, nastroju i niepokoju, bo tylko je łączy krawędź ujemna (−.028). Siła mostowa wskazała dwa objawy, które w tej sieci łączą obie grupy: zamartwianie (0.182) i nastrój (0.181). Taki wynik pasuje do sieciowego wyjaśnienia współwystępowania zaburzeń, ale go nie dowodzi.
Pośrednictwo (betweenness) podajemy tylko dla porównania. Sześć z dziesięciu węzłów miało pośrednictwo równe 0, choć ich siła wynosiła od 0.201 do 0.453. Bringmann i in. (2019) pokazują, że pośrednictwo i bliskość opierają się na założeniach o przepływie po najkrótszych ścieżkach, które słabo pasują do sieci psychologicznych. W kroku 5 zobaczysz, że w przykładzie pośrednictwo jest też mniej stabilne.
Krok 4. Dokładność krawędzi: bootstrap
Pojedyncza sieć to jedno oszacowanie, a nie prawda. Epskamp i in. (2018) proponują trzy kontrole: dokładność wag krawędzi, stabilność centralności i testy różnic. Ich pakiet bootnet nie był w naszym środowisku zainstalowany, dlatego obie procedury zapisaliśmy w kodzie wprost: w pętli losujemy próby, za każdym razem liczymy korelacje polichoryczne i sieć EBICglasso, a potem zestawiamy wyniki. Bootstrap nieparametryczny, czyli losowanie osób ze zwracaniem, autorzy zalecają właśnie przy danych porządkowych. Ogólną logikę metody opisuje hasło bootstrap.
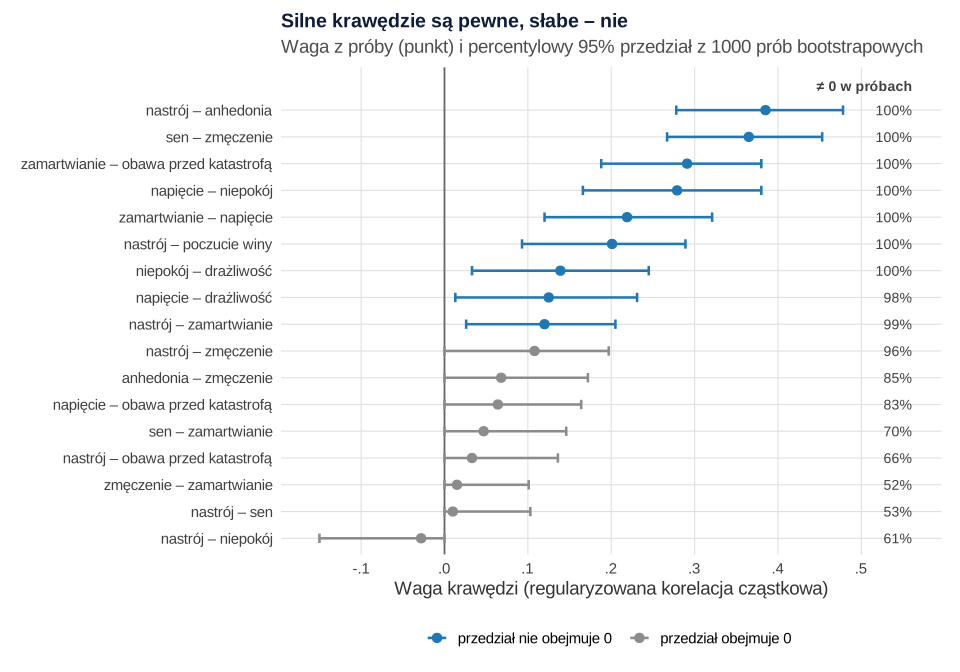
Dziewięć najsilniejszych krawędzi ma przedziały wyraźnie powyżej zera i pojawia się w 98–100% prób. Osiem słabszych ma przedziały obejmujące zero. Nie traktuj tego jak testu istotności. Epskamp i in. (2018) podkreślają, że bootstrapowe przedziały wag sieci regularyzowanej pokazują dokładność oszacowań i pozwalają porównywać krawędzie, ale nie są testami różnicy od zera. Wniosek jest prostszy: kolejność silnych krawędzi jest pewna, a o istnieniu słabych dane mówią niewiele.
To samo dotyczy różnic w centralności. Różnica siły nastroju i zamartwiania wyniosła 0.192, 95% CI [−0.039, 0.472], a zamartwiania i napięcia 0.005, 95% CI [−0.262, 0.255]. Choć nastrój ma w tabeli 1 najwyższą siłę, dane nie pozwalają twierdzić, że jest wyraźnie bardziej centralny niż zamartwianie. Pamiętaj też, że takich porównań jest wiele, a w praktyce nie stosuje się do nich poprawek (zob. problem wielokrotnych porównań).
Krok 5. Stabilność centralności: współczynnik CS
Drugi bootstrap usuwa część osób (bez zwracania) i sprawdza, czy kolejność węzłów pod względem centralności się utrzymuje. Usuwaliśmy od 5% do 75% próby, po 200 podprób na każdym poziomie. Współczynnik stabilności CS to największy odsetek osób, który można usunąć, by z prawdopodobieństwem 95% korelacja centralności z wynikiem pełnej próby wynosiła co najmniej .70. Epskamp i in. (2018) na podstawie symulacji zalecają, by CS nie był niższy niż .25, a najlepiej przekraczał .50, i zaznaczają, że to progi umowne.
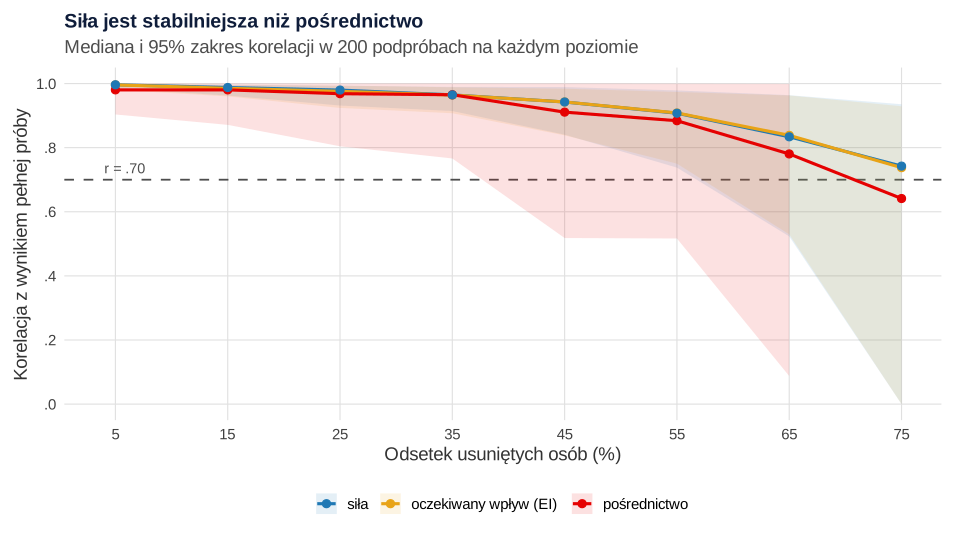
CS wyniósł .55 dla siły i EI oraz .35 dla pośrednictwa. Przy usunięciu 65% osób (zostaje 182) korelacja siły z wynikiem pełnej próby przekraczała .70 w 87.0% podprób, a pośrednictwa – tylko w 59.5%. Przy 75% usuniętych osób (zostaje 130) w 12 z 200 podprób EBIC wybrał sieć pustą, bez żadnej krawędzi. To przestroga dla małych prób: przy kilkuset osobach i kilkunastu węzłach sieć regularyzowana może nie wykryć niczego, a brak krawędzi nie oznacza wtedy braku związków.
Przy CS równym .55 kolejność siły możesz interpretować, ale ostrożnie i bez mocnych twierdzeń o różnicach między sąsiednimi węzłami. Kolejności pośrednictwa nie interpretuj.
Krok 6. Wspólnoty węzłów i liczba wymiarów
Sieć można też podzielić na wspólnoty, czyli grupy węzłów silniej połączonych ze sobą niż z resztą. Często używa się do tego algorytmu walktrap, który wyznacza wspólnoty na podstawie krótkich błądzeń losowych po sieci (Pons i Latapy, 2006). Na tym połączeniu opiera się eksploracyjna analiza grafów (EGA): Golino i Epskamp (2017) szacują sieć graphical lasso z EBIC i liczą wspólnoty walktrap jako oszacowanie liczby wymiarów, a w ich symulacji EGA działała porównywalnie z analizą równoległą. Pakietu EGAnet nie było w naszym środowisku, więc to samo policzyliśmy funkcją cluster_walktrap() z pakietu igraph na wartościach bezwzględnych wag.
Walktrap podzielił sieć na cztery wspólnoty o modularności .457: nastrój, anhedonia i poczucie winy; sen i zmęczenie; zamartwianie i obawa przed katastrofą; napięcie, niepokój i drażliwość. Treściowo to sensowny podział (objawy afektywne, somatyczne, poznawcze i pobudzenie), ale inny niż dwa wymiary, z których generowaliśmy dane. W 1000 próbach bootstrapowych cztery wspólnoty wyszły w 56.8% prób, trzy w 39.4%, dwie w 3.1%, a pięć w 0.7%. Liczba wymiarów wskazana przez sieć bywa więc niestabilna i nie zastępuje modelu czynnikowego. Jeśli chcesz uzasadnić strukturę narzędzia, porównaj wynik z EFA i CFA (zob. analiza czynnikowa EFA i CFA).
Jak opisać analizę sieciową w artykule
Burger i in. (2023) zaproponowali standardy raportowania analiz sieciowych danych przekrojowych, bo bez nich łatwo o nadmierną swobodę decyzji i wybiórczy opis. W części „Metoda” podaj co najmniej:
- listę węzłów z treścią pozycji (albo jej opisem, gdy narzędzie jest chronione prawem autorskim) i uzasadnienie ich wyboru;
- rodzaj korelacji (polichoryczne, Spearmana) i sposób postępowania z brakami;
- metodę estymacji z parametrami (EBICglasso, γ = 0.5, progowanie lub nie) oraz pakiet i jego wersję;
- wybrane wskaźniki centralności z uzasadnieniem;
- procedury dokładności i stabilności (liczbę prób bootstrapowych, poziomy usuwania osób, wynik CS);
- wszystkie decyzje podjęte po obejrzeniu danych.
Wzór opisu wyników:
Rysunek sieci przygotuj tak, by dało się go odczytać w czerni i bieli albo przez osoby z zaburzeniami widzenia barw: krawędzie ujemne oznacz także linią przerywaną, a nie tylko kolorem. Więcej o przygotowaniu rysunków do czasopisma piszemy w tekście tabele i rysunki do artykułu naukowego.
Co sieć mówi, a czego nie
- Krawędź z danych przekrojowych nie ma kierunku. Sieć pokazuje związek dwóch objawów po kontroli pozostałych, a nie to, który wywołuje który. Teoria sieciowa (Borsboom i Cramer, 2013) mówi o przyczynowych oddziaływaniach, ale dane z jednego pomiaru tego nie rozstrzygną (zob. korelacja a przyczynowość). Związek warunkowy może też wynikać z pominiętej zmiennej, np. wspólnej przyczyny spoza sieci.
- Centralny objaw to hipoteza, nie cel terapii. Fried i in. (2017) odnotowują, że wiele badań sugerowało celowanie w najbardziej centralne objawy. Sprawdzenie tej hipotezy wymaga jednak badania podłużnego albo eksperymentu, a Bringmann i in. (2019) przypominają, że trzeba najpierw jasno określić, co „centralny” ma znaczyć.
- Sieci słabo się replikują. Forbes i in. (2017) w dwóch dużych próbach epidemiologicznych stwierdzili, że sieci warunkowej niezależności objawów depresji i lęku słabo się powtarzały: 44% objawów okazało się „najbardziej wpływowe” według co najmniej jednego wskaźnika, a tylko 13–21% krawędzi powtórzyło się we wszystkich sieciach. Pokaż więc dokładność i stabilność, zanim zinterpretujesz szczegóły (zob. replikowalność).
- Węzły zależą od narzędzia. Pojedyncza pozycja kwestionariusza ma duży błąd pomiaru, a dobór pozycji wyznacza, jakie krawędzie w ogóle mogą się pojawić. Ta sama analiza na innej skali tego samego zaburzenia może dać inną sieć.
Najczęstsze błędy w analizie sieci psychometrycznych
- Korelacje Pearsona dla skośnych pozycji porządkowych. Zaniżają związki i zmieniają gęstość sieci. Użyj korelacji polichorycznych i napisz o tym.
- Interpretowanie każdej krawędzi jako „istotnej”. Regularyzacja to nie test istotności. Najsłabsze krawędzie są najmniej pewne, co w przykładzie widać po fałszywie dodatnich krawędziach o wagach od −.028 do .033.
- Ranking centralności bez stabilności. Bez CS i przedziałów różnic nie wiesz, czy kolejność węzłów nie jest przypadkowa.
- Raportowanie pośrednictwa i bliskości jako miar ważności. W sieciach psychologicznych są trudne do uzasadnienia i zwykle mniej stabilne.
- Pozycje o prawie identycznej treści jako osobne węzły. Dają sztucznie silną krawędź i zawyżają centralność.
- Za mała próba. W przykładzie przy 130 osobach 12 z 200 podprób (6%) dało sieć pustą. Przy małej próbie brak krawędzi nie znaczy braku związku.
- Wnioski przyczynowe i kliniczne z jednego pomiaru. Sieć przekrojowa generuje hipotezy, a ich sprawdzenie wymaga innych schematów badania.
- Porównanie sieci dwóch grup „na oko”. Różnice w gęstości rysunków nie są testem. Do porównań służą osobne procedury (np. test porównania sieci), które także trzeba opisać.
Jeśli planujesz analizę sieciową w doktoracie albo artykule i chcesz, by ktoś sprawdził dobór węzłów, metodę estymacji i opis stabilności, zanim tekst trafi do recenzentów, zajrzyj do oferty analiz dla badaczy. Jeśli pracujesz z danymi z kilku pomiarów, zobacz też poradnik krzywe wzrostu (LGM).
Przykład w R
Kod odtwarza wszystkie liczby, tabele i rysunki z tego poradnika. Uruchom przepisy po kolei w katalogu roboczym z podkatalogiem kod/: przepis 1 tworzy plik CSV i zapisuje prawdziwą sieć, przepis 2 zapisuje oszacowaną sieć, z której korzysta przepis 3. Pakiet bootnet nie był dostępny, dlatego bootstrap zapisano w pętlach; jeśli masz bootnet, te same analizy wykonasz funkcjami estimateNetwork(), bootnet() i corStability().
1. Dane: symulacja ze znanej sieci i przegląd odpowiedzi
R
# B86, przepis 1: dane do przykładu (dane symulowane) – 10 objawów depresji i lęku u 520 studentów
# Dane powstają z znanej sieci korelacji cząstkowych (dwie grupy objawów, kilka krawędzi „mostowych”),
# a odpowiedzi są porządkowe: 0 = wcale, 1 = kilka dni, 2 = ponad połowę dni, 3 = prawie codziennie.
set.seed(8620)
wezly <- c("nastroj", "anhedonia", "sen", "zmeczenie", "wina",           # objawy depresyjne
           "zamartwianie", "napiecie", "niepokoj", "drazliwosc", "katastrofa")  # objawy lękowe
k <- length(wezly)
P <- matrix(0, k, k, dimnames = list(wezly, wezly))      # prawdziwe korelacje cząstkowe
krawedz <- function(a, b, w) { P[a, b] <<- w; P[b, a] <<- w }
krawedz("nastroj", "anhedonia", .35); krawedz("nastroj", "wina", .25); krawedz("anhedonia", "zmeczenie", .20)
krawedz("sen", "zmeczenie", .35);     krawedz("nastroj", "zmeczenie", .12); krawedz("wina", "anhedonia", .12)
krawedz("zamartwianie", "katastrofa", .35); krawedz("zamartwianie", "napiecie", .25); krawedz("napiecie", "niepokoj", .30)
krawedz("napiecie", "drazliwosc", .20);    krawedz("niepokoj", "drazliwosc", .15); krawedz("katastrofa", "napiecie", .10)
krawedz("sen", "zamartwianie", .20);  krawedz("nastroj", "zamartwianie", .15)   # krawędzie mostowe
krawedz("zmeczenie", "drazliwosc", .12); krawedz("wina", "niepokoj", -.10)
K <- diag(k) - P; dimnames(K) <- dimnames(P)
min(eigen(K)$values) > 0                                   # macierz precyzji dodatnio określona
S <- cov2cor(solve(K))
z <- MASS::mvrnorm(520, rep(0, k), S)
progi <- c(-Inf, 0.15, 0.95, 1.65, Inf)                    # rozkłady prawoskośne, jak w skalach objawów
dane <- as.data.frame(apply(z, 2, function(x) as.integer(cut(x, progi)) - 1L))
names(dane) <- wezly
write.csv(dane, "sieci-psychometryczne-dane.csv", row.names = FALSE)
saveRDS(P, "kod/b86-prawdziwa-siec.rds")
sum(P[upper.tri(P)] != 0)                                  # liczba krawędzi w prawdziwej sieci

# Przegląd: rozkłady odpowiedzi (%), średnie i skośność
dim(dane)
round(100 * t(sapply(dane, function(x) table(factor(x, levels = 0:3)) / length(x))), 1)
round(t(sapply(dane, function(x) c(M = mean(x), SD = sd(x), skosnosc = psych::skew(x)))), 2)
Wynik w R
[1] TRUE
[1] 16
[1] 520  10
                0    1    2   3
nastroj      55.2 27.5 11.7 5.6
anhedonia    55.0 27.1 13.7 4.2
sen          54.4 25.2 14.2 6.2
zmeczenie    58.3 23.8 12.7 5.2
wina         57.5 26.2 11.5 4.8
zamartwianie 55.6 26.9 12.7 4.8
napiecie     57.9 25.4 11.5 5.2
niepokoj     59.2 24.4 12.1 4.2
drazliwosc   55.8 28.5 10.6 5.2
katastrofa   56.0 25.4 12.7 6.0
                M   SD skosnosc
nastroj      0.68 0.89     1.15
anhedonia    0.67 0.87     1.08
sen          0.72 0.93     1.04
zmeczenie    0.65 0.89     1.19
wina         0.64 0.87     1.21
zamartwianie 0.67 0.88     1.13
napiecie     0.64 0.88     1.22
niepokoj     0.61 0.86     1.23
drazliwosc   0.65 0.87     1.21
katastrofa   0.69 0.91     1.13
2. Estymacja sieci, centralność i wspólnoty
R
# B86, przepis 2: estymacja sieci – korelacje polichoryczne, EBICglasso, porównanie z prawdziwą siecią
suppressPackageStartupMessages(library(qgraph))
dane <- read.csv("sieci-psychometryczne-dane.csv")
P <- readRDS("kod/b86-prawdziwa-siec.rds")
n <- nrow(dane)

# Korelacje: polichoryczne (cor_auto wykrywa zmienne porządkowe) i – dla porównania – Spearmana
R_pol <- cor_auto(dane, verbose = FALSE)
R_spe <- cor(dane, method = "spearman")
round(range(R_pol[upper.tri(R_pol)]), 3); round(range(R_spe[upper.tri(R_spe)]), 3)
round(mean(R_pol[upper.tri(R_pol)] - R_spe[upper.tri(R_spe)]), 3)   # o ile polichoryczne są średnio wyższe

# Sieć: regularyzowane korelacje cząstkowe (graphical lasso, EBIC, gamma = 0.5)
W <- EBICglasso(R_pol, n = n, gamma = 0.5)
gora <- upper.tri(W)
sum(W[gora] != 0); choose(ncol(W), 2)                      # liczba krawędzi niezerowych / możliwych
round(sum(W[gora] != 0) / choose(ncol(W), 2), 3)           # gęstość sieci
kr <- data.frame(od = rownames(W)[row(W)[gora]], do = colnames(W)[col(W)[gora]], waga = W[gora], prawda = P[gora])
kr <- kr[order(-abs(kr$waga)), ]; kr$waga <- round(kr$waga, 3)
head(kr[kr$waga != 0, ], 20)

# Nieregularyzowane korelacje cząstkowe – ile „krawędzi” daje zwykłe odwrócenie macierzy?
Pc <- -cov2cor(solve(R_pol)); diag(Pc) <- 0
round(range(Pc[gora]), 3); sum(abs(Pc[gora]) < .05)        # wszystkie niezerowe, część bliska zeru

# Wrażliwość na gamma: liczba krawędzi przy gamma = 0, 0.25, 0.5
sapply(c(0, 0.25, 0.5), function(g) sum(EBICglasso(R_pol, n = n, gamma = g)[gora] != 0))

# Zgodność z prawdziwą siecią (znamy ją, bo dane są symulowane)
prawdziwe <- P[gora] != 0; szac <- W[gora] != 0
round(c(czulosc = mean(szac[prawdziwe]), swoistosc = mean(!szac[!prawdziwe]),
        r_wag = cor(W[gora], P[gora])), 3)
kr[kr$waga != 0 & kr$prawda == 0, ]                        # krawędzie fałszywie dodatnie
kr[kr$waga == 0 & kr$prawda != 0, ]                        # krawędzie pominięte

# Alternatywy o większej swoistości: EBICglasso z progowaniem i nieregularyzowany wybór modelu (ggmModSelect)
W_prog <- EBICglasso(R_pol, n = n, gamma = 0.5, threshold = TRUE)
W_sel <- ggmModSelect(R_pol, n = n, gamma = 0, verbose = FALSE)$graph
ocena <- function(M) { s <- M[gora] != 0
  c(krawedzie = sum(s), czulosc = mean(s[prawdziwe]), swoistosc = mean(!s[!prawdziwe]), r_wag = cor(M[gora], P[gora])) }
round(rbind(glasso = ocena(W), glasso_prog = ocena(W_prog), ggmModSelect = ocena(W_sel)), 3)

# Centralność: siła i oczekiwany wpływ (EI) liczone wprost z macierzy wag
sila <- colSums(abs(W)); ei <- colSums(W)
round(cbind(sila = sila, EI = ei, sila_z = as.numeric(scale(sila))), 3)[order(-sila), ]
# kontrola z funkcją pakietu qgraph i – dla porównania – pośrednictwo (betweenness)
all.equal(unname(centrality(W)$OutDegree), unname(sila))
setNames(centrality(W)$Betweenness, colnames(W))

# Wspólnoty (społeczności) węzłów: algorytm walktrap na wartościach bezwzględnych wag
g <- igraph::graph_from_adjacency_matrix(abs(W), mode = "undirected", weighted = TRUE, diag = FALSE)
wt <- igraph::cluster_walktrap(g)
spol <- igraph::membership(wt); spol
round(igraph::modularity(wt), 3)
# Siła mostowa: suma |wag| krawędzi do węzłów z drugiej, teoretycznej grupy objawów (depresja a lęk)
teoria <- rep(c("depresja", "lek"), each = 5)
most <- sapply(seq_len(ncol(W)), function(j) sum(abs(W[j, teoria != teoria[j]])))
names(most) <- colnames(W); round(sort(most, decreasing = TRUE), 3)

saveRDS(list(W = W, spol = spol, sila = sila, ei = ei, most = most), "kod/b86-siec.rds")
Wynik w R
[1] -0.099  0.491
[1] -0.073  0.377
[1] 0.031
[1] 17
[1] 45
[1] 0.378
             od           do   waga prawda
1       nastroj    anhedonia  0.385   0.35
6           sen    zmeczenie  0.365   0.35
42 zamartwianie   katastrofa  0.291   0.35
28     napiecie     niepokoj  0.279   0.30
21 zamartwianie     napiecie  0.219   0.25
7       nastroj         wina  0.201   0.25
36     niepokoj   drazliwosc  0.139   0.15
35     napiecie   drazliwosc  0.125   0.20
11      nastroj zamartwianie  0.120   0.15
4       nastroj    zmeczenie  0.108   0.12
5     anhedonia    zmeczenie  0.068   0.20
43     napiecie   katastrofa  0.064   0.10
13          sen zamartwianie  0.047   0.20
37      nastroj   katastrofa  0.033   0.00
22      nastroj     niepokoj -0.028   0.00
14    zmeczenie zamartwianie  0.015   0.00
2       nastroj          sen  0.010   0.00
[1] -0.123  0.444
[1] 27
[1] 21 20 17
  czulosc swoistosc     r_wag
    0.812     0.862     0.923
          od           do   waga prawda
37   nastroj   katastrofa  0.033      0
22   nastroj     niepokoj -0.028      0
14 zmeczenie zamartwianie  0.015      0
2    nastroj          sen  0.010      0
          od         do waga prawda
8  anhedonia       wina    0   0.12
26      wina   niepokoj    0  -0.10
32 zmeczenie drazliwosc    0   0.12
             krawedzie czulosc swoistosc r_wag
glasso              17   0.812     0.862 0.923
glasso_prog          9   0.562     1.000 0.879
ggmModSelect        13   0.750     0.966 0.931
              sila    EI sila_z
nastroj      0.884 0.829  1.845
zamartwianie 0.693 0.693  0.926
napiecie     0.687 0.687  0.900
zmeczenie    0.556 0.556  0.269
anhedonia    0.453 0.453 -0.224
niepokoj     0.446 0.391 -0.256
sen          0.423 0.423 -0.369
katastrofa   0.388 0.388 -0.533
drazliwosc   0.264 0.264 -1.129
wina         0.201 0.201 -1.429
[1] TRUE
     nastroj    anhedonia          sen    zmeczenie         wina zamartwianie
          50            0            0           16            0           46
    napiecie     niepokoj   drazliwosc   katastrofa
          28            0            0            0
     nastroj    anhedonia          sen    zmeczenie         wina zamartwianie
           1            1            3            3            1            4
    napiecie     niepokoj   drazliwosc   katastrofa
           2            2            2            4
[1] 0.457
zamartwianie      nastroj          sen   katastrofa     niepokoj    zmeczenie
       0.182        0.181        0.047        0.033        0.028        0.015
   anhedonia         wina     napiecie   drazliwosc
       0.000        0.000        0.000        0.000

# Komunikaty i ostrzeżenia (liczba wystąpień):
# [1×] Note: Network with lowest lambda selected as best network: assumption of sparsity might be violated.
3. Dokładność i stabilność: bootstrap
R
# B86, przepis 3: dokładność i stabilność sieci – bootstrap krawędzi i bootstrap z usuwaniem osób
# (pakiet bootnet nie był dostępny, dlatego procedury Epskampa i in. (2018) zapisano wprost w pętlach)
suppressPackageStartupMessages(library(qgraph))
dane <- read.csv("sieci-psychometryczne-dane.csv")
siec <- readRDS("kod/b86-siec.rds"); W <- siec$W
n <- nrow(dane); k <- ncol(dane); gora <- upper.tri(W)
szacuj <- function(d) EBICglasso(cor_auto(d, verbose = FALSE), n = nrow(d), gamma = 0.5)
posrednictwo <- function(w) centrality(w)$Betweenness

# 1. Bootstrap nieparametryczny: 1000 prób z losowaniem osób ze zwracaniem
set.seed(8630)
B <- 1000
boot <- replicate(B, { w <- szacuj(dane[sample(n, n, replace = TRUE), ])
  c(w[gora], colSums(abs(w)),
    igraph::membership(igraph::cluster_walktrap(igraph::graph_from_adjacency_matrix(abs(w), mode = "undirected", weighted = TRUE, diag = FALSE))) |> max()) })
nk <- sum(gora)
kraw_boot <- boot[1:nk, ]; sila_boot <- boot[nk + 1:k, ]; spol_boot <- boot[nk + k + 1, ]
nazwy <- paste(rownames(W)[row(W)[gora]], colnames(W)[col(W)[gora]], sep = "–")
kb <- data.frame(krawedz = nazwy, waga = W[gora],
                 ci_dol = apply(kraw_boot, 1, quantile, .025), ci_gora = apply(kraw_boot, 1, quantile, .975),
                 niezerowa = rowMeans(kraw_boot != 0))
kb <- kb[order(-kb$waga), ]
kb[, 2:5] <- round(kb[, 2:5], 3)
kb[kb$waga != 0 | kb$niezerowa > .5, ]
sum(kb$waga != 0 & kb$ci_dol <= 0 & kb$ci_gora >= 0)       # krawędzie z przedziałem obejmującym 0
# Różnica siły: nastrój a zamartwianie (bootstrapowy 95% przedział różnicy)
d <- sila_boot["nastroj", ] - sila_boot["zamartwianie", ]
round(c(roznica = unname(siec$sila["nastroj"] - siec$sila["zamartwianie"]), quantile(d, c(.025, .975))), 3)
d2 <- sila_boot["zamartwianie", ] - sila_boot["napiecie", ]
round(c(roznica = unname(siec$sila["zamartwianie"] - siec$sila["napiecie"]), quantile(d2, c(.025, .975))), 3)
# Liczba wspólnot walktrap w próbach bootstrapowych (%)
round(100 * table(spol_boot) / B, 1)
saveRDS(kb, "kod/b86-bootstrap-krawedzi.rds")

# 2. Bootstrap z usuwaniem osób (case-dropping): stabilność kolejności centralności
set.seed(8631)
odsetki <- c(.05, .15, .25, .35, .45, .55, .65, .75)
pow <- 200
oryg <- list(sila = siec$sila, EI = siec$ei, posrednictwo = posrednictwo(W))
stab <- do.call(rbind, lapply(odsetki, function(p) {
  m <- round(n * (1 - p))
  t(replicate(pow, { w <- szacuj(dane[sample(n, m), ])
    c(odsetek = p, pusta = all(w == 0),
      sila = cor(colSums(abs(w)), oryg$sila),
      EI = cor(colSums(w), oryg$EI),
      posrednictwo = suppressWarnings(cor(posrednictwo(w), oryg$posrednictwo))) }))
}))
stab <- as.data.frame(stab)
# Współczynnik CS: największy odsetek usuniętych osób, przy którym w ≥ 95% prób korelacja z oryginałem ≥ .70
cs <- sapply(c("sila", "EI", "posrednictwo"), function(m) {
  ok <- tapply(stab[[m]], stab$odsetek, function(r) mean(!is.na(r) & r >= .7) >= .95)   # pusta sieć = brak zgodności
  if (!ok[1]) 0 else max(odsetki[cumprod(ok) == 1]) })
round(cs, 2)
# mediana korelacji z oryginałem (pusta sieć lub brak zmienności = korelacja 0)
st0 <- stab; for (m in c("sila", "EI", "posrednictwo")) st0[[m]][is.na(st0[[m]])] <- 0
round(sapply(split(st0[, c("sila", "EI", "posrednictwo")], st0$odsetek), function(x) apply(x, 2, median)), 3)
# odsetek prób, w których korelacja z oryginałem była ≥ .70, i liczba pustych sieci
round(sapply(split(stab, stab$odsetek), function(x) c(sila = mean(!is.na(x$sila) & x$sila >= .7),
                                                     posrednictwo = mean(!is.na(x$posrednictwo) & x$posrednictwo >= .7),
                                                     puste = sum(x$pusta))), 3)
saveRDS(stab, "kod/b86-stabilnosc.rds")
Wynik w R
                   krawedz   waga ci_dol ci_gora niezerowa
1        nastroj–anhedonia  0.385  0.278   0.478     1.000
6            sen–zmeczenie  0.365  0.267   0.453     1.000
42 zamartwianie–katastrofa  0.291  0.188   0.380     1.000
28       napiecie–niepokoj  0.279  0.166   0.380     1.000
21   zamartwianie–napiecie  0.219  0.120   0.321     1.000
7             nastroj–wina  0.201  0.093   0.289     0.999
36     niepokoj–drazliwosc  0.139  0.033   0.245     0.995
35     napiecie–drazliwosc  0.125  0.013   0.231     0.981
11    nastroj–zamartwianie  0.120  0.026   0.205     0.991
4        nastroj–zmeczenie  0.108  0.000   0.197     0.965
5      anhedonia–zmeczenie  0.068  0.000   0.172     0.853
43     napiecie–katastrofa  0.064  0.000   0.164     0.832
13        sen–zamartwianie  0.047  0.000   0.146     0.704
37      nastroj–katastrofa  0.033  0.000   0.136     0.665
14  zmeczenie–zamartwianie  0.015  0.000   0.101     0.517
2              nastroj–sen  0.010  0.000   0.103     0.529
22        nastroj–niepokoj -0.028 -0.150   0.000     0.610
[1] 8
roznica    2.5%   97.5%
  0.192  -0.039   0.472
roznica    2.5%   97.5%
  0.005  -0.262   0.255
spol_boot
   2    3    4    5
 3.1 39.4 56.8  0.7
        sila           EI posrednictwo
        0.55         0.55         0.35
              0.05  0.15  0.25  0.35  0.45  0.55  0.65  0.75
sila         0.996 0.988 0.980 0.965 0.942 0.907 0.834 0.742
EI           0.996 0.985 0.976 0.964 0.943 0.908 0.838 0.738
posrednictwo 0.980 0.980 0.968 0.965 0.911 0.884 0.780 0.641
             0.05 0.15  0.25 0.35 0.45  0.55  0.65   0.75
sila            1    1 1.000 1.00 1.00 0.990 0.870  0.570
posrednictwo    1    1 0.995 0.99 0.94 0.795 0.595  0.435
puste           0    0 0.000 0.00 0.00 0.000 1.000 12.000

# Komunikaty i ostrzeżenia (liczba wystąpień):
# [155×] OSTRZEŻENIE: A dense regularized network was selected (lambda < 0.1 * lambda.max). Recent work indicates a possible drop in specificity. Interpret the presence of the smallest edges with care. Setting threshold = TRUE will enforce higher specificity, at the cost of sensitivity.
# [26×] OSTRZEŻENIE: the standard deviation is zero
# [13×] An empty network was selected to be the best fitting network. Possibly set 'lambda.min.ratio' higher to search more sparse networks. You can also change the 'gamma' parameter to improve sensitivity (at the cost of specificity).
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami qgraph (EBICglasso, centralność; korelacje polichoryczne funkcja cor_auto() liczy przez lavaan), lavaan, glasso (algorytm graphical lasso wywoływany przez qgraph), igraph (wspólnoty walktrap), MASS (symulacja danych) i psych (skośność); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- qgraph (wersja 1.9.8): Epskamp, S., Cramer, A. O. J., Waldorp, L. J., Schmittmann, V. D., & Borsboom, D. (2012). qgraph: Network visualizations of relationships in psychometric data. Journal of Statistical Software, 48(4), 1–18. https://doi.org/10.18637/jss.v048.i04
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- glasso (wersja 1.11): Friedman, J., Hastie, T., & Tibshirani, R. (2019). glasso: Graphical lasso: Estimation of Gaussian graphical models (R package version 1.11) [Computer software]. https://doi.org/10.32614/CRAN.package.glasso
- igraph (wersja 2.2.2): Csárdi, G., & Nepusz, T. (2006). The igraph software package for complex network research. InterJournal, Complex Systems, 1695. https://igraph.org
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy do analizy sieci z pozycji Likerta używać korelacji polichorycznych?
Zwykle tak, zwłaszcza przy kilku kategoriach odpowiedzi i skośnych rozkładach, bo korelacja Pearsona zaniża wtedy związki. W qgraph zrobi to funkcja cor_auto(), która rozpoznaje zmienne porządkowe. Korelacja polichoryczna zakłada jednak, że pod odpowiedziami stoi ciągła zmienna o rozkładzie normalnym, więc nazwij to założenie w pracy.
Jak policzyć współczynnik stabilności CS bez pakietu bootnet?
Losuj podpróby bez zwracania, usuwając np. 5%, 15%… 75% osób, w każdej szacuj sieć i licz korelację centralności z wynikiem pełnej próby. CS to największy odsetek usuniętych osób, przy którym co najmniej 95% podprób ma korelację ≥ .70. Pustą sieć licz jako brak zgodności. Pełny kod pokazujemy w przepisie 3.
Jaka wartość współczynnika CS jest wystarczająca w analizie sieciowej?
Epskamp i in. (2018) na podstawie symulacji zalecają, by CS nie był niższy niż .25, a najlepiej przekraczał .50, zaznaczając, że to progi umowne. Przy CS poniżej .25 nie interpretuj kolejności węzłów. Nawet przy wyższym CS sprawdź przedziały różnic centralności, zanim napiszesz, że jeden objaw jest bardziej centralny od drugiego.
Co oznacza siła mostowa w sieci objawów dwóch zaburzeń?
Siła mostowa to suma wartości bezwzględnych wag krawędzi, które łączą węzeł z objawami drugiej grupy, np. objaw lękowy z objawami depresyjnymi. Wysoka siła mostowa wskazuje objawy, przez które w sieci łączą się oba zaburzenia. To opis związków warunkowych w danych, a nie dowód, że ten objaw przenosi jedno zaburzenie na drugie.
Jak opisać wyniki analizy sieciowej w sekcji wyników artykułu?
Podaj liczbę węzłów i osób, rodzaj korelacji, metodę estymacji z parametrem γ, liczbę krawędzi i najsilniejsze z nich, wybrane wskaźniki centralności oraz wyniki bootstrapu: przedziały krawędzi i współczynnik CS. Zakończ zdaniem o ograniczeniu danych przekrojowych. Gotowy wzór znajdziesz w sekcji o raporcie.
Powiązane hasła
Przeczytaj też
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikModel bifactor i ESEM
Od CFA do bifactor-ESEM na jednym kwestionariuszu: ładunki krzyżowe, czynnik ogólny, omega H, ECV, trafność podskal, tabela APA i kod lavaan.
Czytaj →PoradnikKrzywe wzrostu (LGM) i modele zmiany
Krzywa wzrostu w lavaan na danych do pobrania: kształt zmiany, ujemna wariancja, kodowanie czasu, predyktor tempa, porównanie z lme4 i tabele APA.
Czytaj →Planujesz analizę sieciową w doktoracie lub artykule?
Pomożemy dobrać węzły i metodę estymacji, wykonamy analizę z bootstrapem dokładności i stabilności w R i wyjaśnimy wyniki tak, żebyś mógł je opisać i obronić przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Baba, K., Shibata, R., & Sibuya, M. (2004). Partial correlation and conditional correlation as measures of conditional independence. Australian & New Zealand Journal of Statistics, 46(4), 657–664. https://doi.org/10.1111/j.1467-842x.2004.00360.x
- Borsboom, D., & Cramer, A. O. J. (2013). Network analysis: An integrative approach to the structure of psychopathology. Annual Review of Clinical Psychology, 9(1), 91–121. https://doi.org/10.1146/annurev-clinpsy-050212-185608
- Bringmann, L. F., Elmer, T., Epskamp, S., Krause, R. W., Schoch, D., Wichers, M., Wigman, J. T. W., & Snippe, E. (2019). What do centrality measures measure in psychological networks? Journal of Abnormal Psychology, 128(8), 892–903. https://doi.org/10.1037/abn0000446 ● Otwarty dostęp: pełny tekst
- Burger, J., Isvoranu, A.-M., Lunansky, G., Haslbeck, J. M. B., Epskamp, S., Hoekstra, R. H. A., Fried, E. I., Borsboom, D., & Blanken, T. F. (2023). Reporting standards for psychological network analyses in cross-sectional data. Psychological Methods, 28(4), 806–824. https://doi.org/10.1037/met0000471 ● Otwarty dostęp: pełny tekst
- Epskamp, S., & Fried, E. I. (2018). A tutorial on regularized partial correlation networks. Psychological Methods, 23(4), 617–634. https://doi.org/10.1037/met0000167 ● Otwarty dostęp: pełny tekst
- Epskamp, S., Borsboom, D., & Fried, E. I. (2018). Estimating psychological networks and their accuracy: A tutorial paper. Behavior Research Methods, 50(1), 195–212. https://doi.org/10.3758/s13428-017-0862-1 ● Otwarty dostęp
- Forbes, M. K., Wright, A. G. C., Markon, K. E., & Krueger, R. F. (2017). Evidence that psychopathology symptom networks have limited replicability. Journal of Abnormal Psychology, 126(7), 969–988. https://doi.org/10.1037/abn0000276 ● Otwarty dostęp
- Fried, E. I., van Borkulo, C. D., Cramer, A. O. J., Boschloo, L., Schoevers, R. A., & Borsboom, D. (2017). Mental disorders as networks of problems: A review of recent insights. Social Psychiatry and Psychiatric Epidemiology, 52(1), 1–10. https://doi.org/10.1007/s00127-016-1319-z ● Otwarty dostęp
- Friedman, J., Hastie, T., & Tibshirani, R. (2008). Sparse inverse covariance estimation with the graphical lasso. Biostatistics, 9(3), 432–441. https://doi.org/10.1093/biostatistics/kxm045 ● Otwarty dostęp: pełny tekst
- Golino, H. F., & Epskamp, S. (2017). Exploratory graph analysis: A new approach for estimating the number of dimensions in psychological research. PLOS ONE, 12(6), Article e0174035. https://doi.org/10.1371/journal.pone.0174035 ● Otwarty dostęp
- Isvoranu, A.-M., & Epskamp, S. (2023). Which estimation method to choose in network psychometrics? Deriving guidelines for applied researchers. Psychological Methods, 28(4), 925–946. https://doi.org/10.1037/met0000439 ● Otwarty dostęp: pełny tekst
- Olsson, U. (1979). Maximum likelihood estimation of the polychoric correlation coefficient. Psychometrika, 44(4), 443–460. https://doi.org/10.1007/BF02296207
- Pons, P., & Latapy, M. (2006). Computing communities in large networks using random walks. Journal of Graph Algorithms and Applications, 10(2), 191–218. https://doi.org/10.7155/jgaa.00124 ● Otwarty dostęp
- Robinaugh, D. J., Millner, A. J., & McNally, R. J. (2016). Identifying highly influential nodes in the complicated grief network. Journal of Abnormal Psychology, 125(6), 747–757. https://doi.org/10.1037/abn0000181 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{baba2004partial, author={Baba, Kunihiro and Shibata, Ritei and Sibuya, Masaaki}, title={{Partial correlation and conditional correlation as measures of conditional independence}}, journal={Australian \& New Zealand Journal of Statistics}, year={2004}, volume={46}, number={4}, pages={657--664}, doi={10.1111/j.1467-842x.2004.00360.x}}@article{borsboom2013network, author={Borsboom, Denny and Cramer, Angélique O. J.}, title={{Network analysis: An integrative approach to the structure of psychopathology}}, journal={Annual Review of Clinical Psychology}, year={2013}, volume={9}, number={1}, pages={91--121}, doi={10.1146/annurev-clinpsy-050212-185608}}@article{bringmann2019what, author={Bringmann, Laura F. and Elmer, Timon and Epskamp, Sacha and Krause, Robert W. and Schoch, David and Wichers, Marieke and Wigman, Johanna T. W. and Snippe, Evelien}, title={{What do centrality measures measure in psychological networks?}}, journal={Journal of Abnormal Psychology}, year={2019}, volume={128}, number={8}, pages={892--903}, doi={10.1037/abn0000446}}@article{burger2023reporting, author={Burger, Julian and Isvoranu, Adela-Maria and Lunansky, Gabriela and Haslbeck, Jonas M. B. and Epskamp, Sacha and Hoekstra, Ria H. A. and Fried, Eiko I. and Borsboom, Denny and Blanken, Tessa F.}, title={{Reporting standards for psychological network analyses in cross-sectional data}}, journal={Psychological Methods}, year={2023}, volume={28}, number={4}, pages={806--824}, doi={10.1037/met0000471}}@article{epskamp2018tutorial, author={Epskamp, Sacha and Fried, Eiko I.}, title={{A tutorial on regularized partial correlation networks}}, journal={Psychological Methods}, year={2018}, volume={23}, number={4}, pages={617--634}, doi={10.1037/met0000167}}@article{epskamp2018estimating, author={Epskamp, Sacha and Borsboom, Denny and Fried, Eiko I.}, title={{Estimating psychological networks and their accuracy: A tutorial paper}}, journal={Behavior Research Methods}, year={2018}, volume={50}, number={1}, pages={195--212}, doi={10.3758/s13428-017-0862-1}}@article{forbes2017evidence, author={Forbes, Miriam K. and Wright, Aidan G. C. and Markon, Kristian E. and Krueger, Robert F.}, title={{Evidence that psychopathology symptom networks have limited replicability}}, journal={Journal of Abnormal Psychology}, year={2017}, volume={126}, number={7}, pages={969--988}, doi={10.1037/abn0000276}}@article{fried2017mental, author={Fried, Eiko I. and van Borkulo, Claudia D. and Cramer, Angélique O. J. and Boschloo, Lynn and Schoevers, Robert A. and Borsboom, Denny}, title={{Mental disorders as networks of problems: A review of recent insights}}, journal={Social Psychiatry and Psychiatric Epidemiology}, year={2017}, volume={52}, number={1}, pages={1--10}, doi={10.1007/s00127-016-1319-z}}@article{friedman2008sparse, author={Friedman, Jerome and Hastie, Trevor and Tibshirani, Robert}, title={{Sparse inverse covariance estimation with the graphical lasso}}, journal={Biostatistics}, year={2008}, volume={9}, number={3}, pages={432--441}, doi={10.1093/biostatistics/kxm045}}@article{golino2017exploratory, author={Golino, Hudson F. and Epskamp, Sacha}, title={{Exploratory graph analysis: A new approach for estimating the number of dimensions in psychological research}}, journal={PLOS ONE}, year={2017}, volume={12}, number={6}, eid={e0174035}, doi={10.1371/journal.pone.0174035}}@article{isvoranu2023which, author={Isvoranu, Adela-Maria and Epskamp, Sacha}, title={{Which estimation method to choose in network psychometrics? Deriving guidelines for applied researchers}}, journal={Psychological Methods}, year={2023}, volume={28}, number={4}, pages={925--946}, doi={10.1037/met0000439}}@article{olsson1979maximum, author={Olsson, Ulf}, title={{Maximum likelihood estimation of the polychoric correlation coefficient}}, journal={Psychometrika}, year={1979}, volume={44}, number={4}, pages={443--460}, doi={10.1007/bf02296207}}@article{pons2006computing, author={Pons, Pascal and Latapy, Matthieu}, title={{Computing communities in large networks using random walks}}, journal={Journal of Graph Algorithms and Applications}, year={2006}, volume={10}, number={2}, pages={191--218}, doi={10.7155/jgaa.00124}}@article{robinaugh2016identifying, author={Robinaugh, Donald J. and Millner, Alexander J. and McNally, Richard J.}, title={{Identifying highly influential nodes in the complicated grief network}}, journal={Journal of Abnormal Psychology}, year={2016}, volume={125}, number={6}, pages={747--757}, doi={10.1037/abn0000181}}