Czym jest teoria generalizowalności
Klasyczna teoria testów dzieli wynik obserwowany na wynik prawdziwy i jeden, niezróżnicowany błąd. Każdy sposób szacowania rzetelności widzi jednak inny kawałek tego błędu. Alfa Cronbacha widzi różnice między pozycjami, test–retest – zmiany w czasie, ICC – różnice między oceniającymi. Gdy wypracowanie ocenia kilku egzaminatorów, a uczeń pisze kilka wypracowań na różne tematy, błąd ma kilka źródeł naraz. Każdy z tych współczynników pokaże wtedy tylko część prawdy.
Teoria generalizowalności (ang. generalizability theory, G-teoria) rozwiązuje ten problem. Cronbach, Gleser, Nanda i Rajaratnam (1972) opisali ją jako teorię wiarygodności (ang. dependability) pomiarów zachowania. Pełny wykład zawiera podręcznik Brennana (2001), a przystępne wprowadzenie – książka Shavelsona i Webb (1991). Zamiast pytać, ile wynosi „rzetelność”, pytasz, na jakie warunki pomiaru chcesz uogólnić wynik. Warunki te opisują fasety (ang. facets), czyli źródła błędu: oceniający, zadania, okazje pomiaru, wersje testu. Średni wynik osoby we wszystkich dopuszczalnych warunkach to wynik uniwersum (ang. universe score), odpowiednik wyniku prawdziwego. Krótką definicję i słownik pojęć znajdziesz w haśle teoria generalizowalności.
Przegląd teorii dla psychologów opublikowali Shavelson, Webb i Rowley (1989), a praktyczny przewodnik po planowaniu i interpretacji – Briesch i in. (2014). Analiza ma dwa etapy:
- badanie G (ang. G study) szacuje komponenty wariancji dla osób, faset i ich interakcji;
- badanie D (ang. decision study) używa tych komponentów, żeby przewidzieć współczynniki dla planu, który zastosujesz w przyszłości, np. z dwoma oceniającymi zamiast czterech.
Przykład: oceny wypracowań
Osiemdziesięciu uczniów napisało po 4 wypracowania na różne tematy (zadania). Każde wypracowanie ocenili ci sami 4 egzaminatorzy w skali punktowej (0–25 pkt). To schemat w pełni skrzyżowany osoba × oceniający × zadanie, zapisywany jako p × r × t: 80 × 4 × 4 = 1280 ocen, M = 12.87, SD = 2.89. Dane są symulowane (set.seed(2402)) i możesz je pobrać jako plik CSV. Obie fasety traktujemy jako losowe. Egzaminatorzy i tematy są próbą z szerszego zbioru, a wynik ucznia ma znaczyć coś niezależnie od tego, kto go ocenił i jaki temat wylosował.
Badanie G: komponenty wariancji w lme4
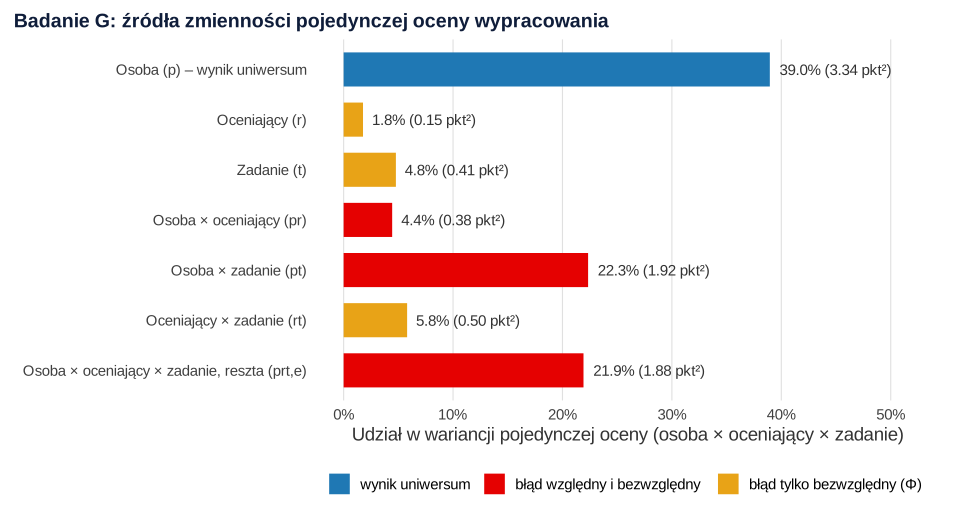
W schemacie p × r × t pojedyncza ocena rozkłada się na siedem składników. Są to efekty osoby, oceniającego i zadania, trzy interakcje dwuczynnikowe oraz reszta. Reszta łączy interakcję trzech czynników z błędem losowym, bo przy jednej ocenie w komórce nie da się ich rozdzielić (prt,e). Tradycyjnie komponenty liczy się ze średnich kwadratów analizy wariancji w programach takich jak GENOVA. Pakiet gtheory w R nie jest tu potrzebny. Jiang (2018) pokazał, że te same komponenty daje model mieszany w lme4 (Bates i in., 2015), w którym każda faseta i każda interakcja to osobny efekt losowy:
To ta sama logika co w modelach z efektami skrzyżowanymi, tyle że tam interesują nas efekty stałe, a tu wyłącznie wariancje. Estymacja REML (zob. REML a ML) nie daje ujemnych wariancji. W metodzie ANOVA zdarzają się one przy małych komponentach i zwykle zastępuje się je zerem.
| Źródło | σ² (pkt²) | % | Rola |
|---|---|---|---|
| Osoba (p) | 3.34 | 39.0 | wynik uniwersum |
| Oceniający (r) | 0.15 | 1.8 | błąd bezwzględny |
| Zadanie (t) | 0.41 | 4.8 | błąd bezwzględny |
| Osoba × oceniający (pr) | 0.38 | 4.4 | błąd względny i bezwzględny |
| Osoba × zadanie (pt) | 1.92 | 22.3 | błąd względny i bezwzględny |
| Oceniający × zadanie (rt) | 0.50 | 5.8 | błąd bezwzględny |
| Reszta (prt,e) | 1.88 | 21.9 | błąd względny i bezwzględny |
Odsetki to już wynik merytoryczny. Vispoel, Morris i Kilinc (2018) zachęcają, by raportować je jako udział poszczególnych źródeł błędu. Różnice między uczniami to 39% wariancji pojedynczej oceny. Egzaminatorzy są dość zgodni: łagodność oceniającego (r) to 1.8%, a interakcja osoba × oceniający 4.4%. Dużym źródłem błędu jest za to interakcja osoba × zadanie (22.3%). Ranking uczniów zależy od tematu: jeden lepiej pisze rozprawkę, inny opis. Tego żadna analiza zgodności sędziów nie wykryje.
Współczynniki G i Φ: decyzje względne i bezwzględne
G-teoria rozróżnia dwa rodzaje decyzji (Briesch i in., 2014). Decyzja względna porządkuje osoby, np. przy wyborze 10 najlepszych prac albo przy korelacji wyniku z inną zmienną. Liczy się wtedy tylko to, co zmienia kolejność osób, czyli interakcje z osobą. Decyzja bezwzględna porównuje wynik z ustalonym progiem, np. 15 pkt na zaliczenie. Wtedy szkodzi też to, że ktoś trafił na surowszego egzaminatora albo trudniejszy temat. Do błędu dochodzą więc efekty główne faset i ich interakcja.
Komponenty dzielimy przez liczbę warunków, bo wynik ucznia to średnia z nr oceniających i nt zadań. Przy planie z badania (4 × 4) współczynnik G wynosi .83, a Φ = .80 (dokładnie .795). Pierwiastki wariancji błędu to 0.83 pkt dla decyzji względnych i 0.93 pkt dla bezwzględnych. To odpowiedniki standardowego błędu pomiaru dla średniej z 16 ocen. Φ jest zawsze nie większe od G. Różnica jest mała, gdy oceniający i zadania mają podobny poziom trudności.
Komponenty z 80 uczniów, 4 egzaminatorów i 4 tematów są niepewne, zwłaszcza dla faset z czterema poziomami. Parametryczny bootstrap (200 replikacji bootMer) daje 95% CI dla G [.76, .87] i dla Φ [.69, .85]. Podawaj takie przedziały, bo punktowa wartość .80 przy dolnej granicy .69 to słaba podstawa do decyzji o zaliczeniu.
Badanie D: ilu oceniających i ile zadań
Badanie D to największa praktyczna zaleta G-teorii. Te same komponenty wstawiasz do wzorów z inną liczbą oceniających i zadań i sprawdzasz, który plan daje akceptowalny współczynnik najmniejszym kosztem. Shavelson i Webb (1991) opisują to jako szukanie najefektywniejszej drogi do zakładanej precyzji. To uogólnienie wzoru Spearmana–Browna na kilka faset naraz.
| Plan (oceniający × zadania) | Ocen na ucznia | G | Φ |
|---|---|---|---|
| 1 × 1 | 1 | .44 | .39 |
| 2 × 2 | 4 | .67 | .62 |
| 3 × 2 (dodany oceniający) | 6 | .71 | .66 |
| 2 × 3 (dodane zadanie) | 6 | .75 | .70 |
| 1 × 9 | 9 | .81 | .76 |
| 2 × 5 | 10 | .81 | .78 |
| 2 × 7 | 14 | .85 | .81 |
| 4 × 4 (plan badania) | 16 | .83 | .80 |
Wniosek jest jednoznaczny. Przy tym samym koszcie dodatkowe zadanie poprawia wynik bardziej niż dodatkowy egzaminator, bo największy komponent błędu to pt, a dzieli się go tylko przez liczbę zadań. Żeby osiągnąć G ≥ .80, wystarczy 2 egzaminatorów i 5 wypracowań (10 ocen na ucznia). Przy jednym egzaminatorze potrzeba 9 wypracowań. Dla decyzji zaliczeniowych (Φ ≥ .80) najtańszy jest plan 2 × 7, który wymaga 14 ocen, mniej niż obecne 16. Czterech egzaminatorów to przy tych komponentach marnowanie ich czasu.
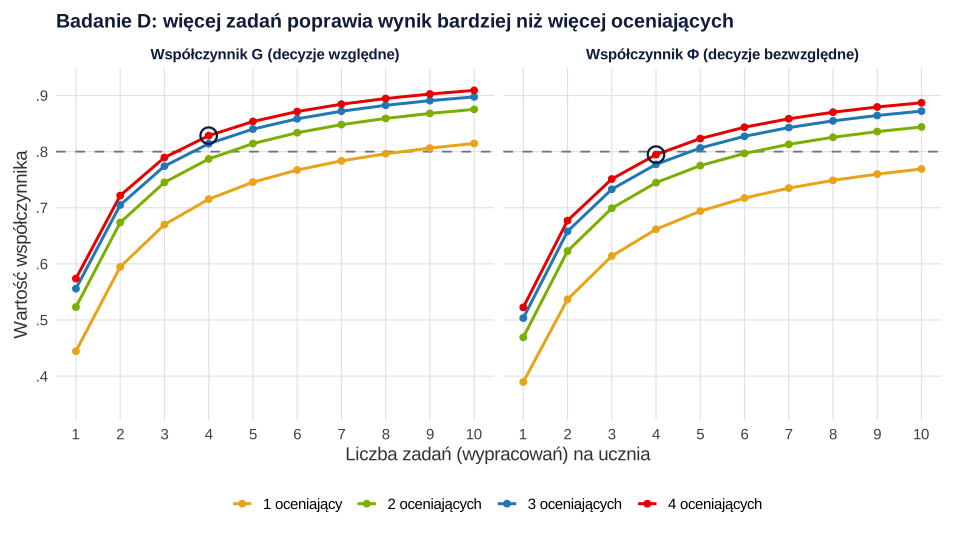
Pamiętaj o założeniu badania D: nowe warunki pochodzą z tego samego uniwersum co w badaniu G. Wyniki dla 10 zadań przy 4 tematach w badaniu G to ekstrapolacja. Nie przenoś też komponentów na inną populację, np. z uczniów liceum na studentów, bo σ²p zależy od zróżnicowania próby.
Relacja do ICC i alfy Cronbacha
Alfa i ICC to szczególne przypadki współczynnika G dla schematu z jedną fasetą. Brennan (2001) pokazuje, że w schemacie osoba × pozycja alfa Cronbacha (1951) jest współczynnikiem G. Podobnie forma spójności ICC dla średniej z k ocen, ICC(C,k) według McGraw i Wong (1996), odpowiada G, a forma zgodności bezwzględnej ICC(A,k) – Φ dla schematu osoba × oceniający. Problem pojawia się, gdy faset jest więcej, a współczynnik liczysz na danych uśrednionych po jednej z nich. Faseta, która znika z analizy, nie znika z danych. Jej interakcja z osobą trafia do wyniku „prawdziwego”.
| Współczynnik | Jak policzony | Wartość | Co pomija |
|---|---|---|---|
| Alfa Cronbacha | 4 zadania jako pozycje, oceny uśrednione po egzaminatorach | .85 | błąd pr (traktuje go jako wynik prawdziwy) |
| ICC(C,4) | 4 egzaminatorów, oceny uśrednione po zadaniach | .95 | błąd pt |
| ICC(A,4) | jak wyżej, zgodność bezwzględna | .93 | błąd pt i t |
| G (p × r × t) | oba źródła błędu naraz | .83 | – |
| Φ (p × r × t) | oba źródła i efekty główne | .80 | – |
ICC = .95 wygląda imponująco i w artykule o zgodności sędziów byłby to dobry wynik. Mówi jednak tylko tyle, że egzaminatorzy zgadzają się co do tych czterech wypracowań. Nie mówi, że wynik ucznia uogólnia się na inne tematy. Wartości z tabeli policzone w pakiecie psych są identyczne z wartościami odtworzonymi z komponentów wariancji. To dowód, że rozbieżność wynika z definicji uniwersum, a nie z błędu obliczeń. Wybór miary dla jednej fasety opisujemy we wpisie zgodność sędziów: kappa, ICC i alfa Krippendorffa, a o tym, co robić z samą alfą – we wpisie alfa Cronbacha – rzetelność skali.
Fasety stałe, zagnieżdżone i niezbilansowane dane
Schemat w pełni skrzyżowany to wygodny punkt wyjścia, ale nie jedyny. Kilka decyzji trzeba podjąć przed analizą:
- Faseta losowa czy stała. Jeśli tematy wypracowań są zawsze te same i nie chcesz uogólniać na inne, faseta zadań jest stała. Wtedy σ²pt/nt przechodzi do wyniku uniwersum, a współczynnik rośnie. Decyzja wynika z interpretacji wyniku, a nie z wygody.
- Zagnieżdżenie. Gdy każde wypracowanie ocenia inna para egzaminatorów, oceniający są zagnieżdżeni w zadaniach (p × (r:t)). Komponentów r i rt nie da się wtedy rozdzielić. W lme4 zapisujesz to jako
(1 | zadanie:oceniajacy). - Braki i niezbilansowanie. Klasyczne wzory ANOVA wymagają kompletnych danych. REML w modelu mieszanym radzi sobie z brakami. Jiang (2018) podkreśla, że model mieszany w R jest elastyczniejszy od specjalistycznych programów, takich jak GENOVA i urGENOVA. W badaniu D przyjmij wtedy planowaną, zbilansowaną liczbę warunków.
- Wielkość badania G. Wariancję fasety szacujesz z liczby jej poziomów, a nie z liczby osób. Dwóch oceniających daje bardzo niepewne σ²r, nawet przy 500 uczniach. Gdy fasety mają podobną strukturę jak w klinice, przyda się też wpis o badaniu rzetelności pomiaru klinicznego.
Jak opisać badanie G i D
W metodzie podaj schemat (skrzyżowany lub zagnieżdżony), które fasety są losowe, a które stałe, liczbę poziomów każdej fasety i metodę estymacji. W wynikach umieść tabelę komponentów z odsetkami, współczynniki G i Φ z przedziałami oraz badanie D dla rozważanych planów (Vispoel i in., 2018). W ścieżce walidacji skali ten etap uzupełnia analizy opisane w przewodniku psychometria i budowa skal.
Jeśli planujesz badanie rzetelności z kilkoma źródłami błędu albo recenzent pyta, dlaczego ICC nie wystarcza, możemy wspólnie zaprojektować badanie G i D oraz przygotować obliczenia w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik teoria-g-oceny-wypracowan.csv (możesz go pobrać tutaj), szacuje komponenty wariancji w lme4, liczy G i Φ oraz ich przedziały bootstrapowe (ok. pół minuty). Drugi wykonuje badanie D i porównuje wyniki z alfą Cronbacha i ICC. Potrzebne pakiety: lme4 i psych. Pakiet gtheory nie jest potrzebny.
1. Badanie G: komponenty wariancji, G i Φ
R
# Dane symulowane: 80 uczniów (osoba) napisało 4 wypracowania na różne tematy (zadanie);
# każde wypracowanie ocenili ci sami 4 egzaminatorzy (oceniajacy) w skali 0–20 pkt.
# Schemat w pełni skrzyżowany: osoba × oceniający × zadanie, 80 × 4 × 4 = 1280 ocen.
suppressPackageStartupMessages(library(lme4))
set.seed(2402)
n_os <- 80; n_oc <- 4; n_za <- 4
oceny <- expand.grid(osoba = sprintf("u%02d", 1:n_os), oceniajacy = paste0("E", 1:n_oc),
                     zadanie = paste0("Z", 1:n_za), stringsAsFactors = TRUE)
# komponenty wariancji przyjęte w symulacji (w pkt²)
sd_wart <- c(p = sqrt(4), r = sqrt(0.6), t = sqrt(0.8), pr = sqrt(0.4), pt = sqrt(2.0), rt = sqrt(0.2), e = sqrt(2.0))
efekt <- function(czynnik, sd) rnorm(nlevels(czynnik), 0, sd)[as.integer(czynnik)]
oceny$wynik <- round(12 + efekt(oceny$osoba, sd_wart[["p"]]) + efekt(oceny$oceniajacy, sd_wart[["r"]]) +
  efekt(oceny$zadanie, sd_wart[["t"]]) + efekt(interaction(oceny$osoba, oceny$oceniajacy), sd_wart[["pr"]]) +
  efekt(interaction(oceny$osoba, oceny$zadanie), sd_wart[["pt"]]) +
  efekt(interaction(oceny$oceniajacy, oceny$zadanie), sd_wart[["rt"]]) + rnorm(nrow(oceny), 0, sd_wart[["e"]]), 1)
write.csv(oceny, "teoria-g-oceny-wypracowan.csv", row.names = FALSE)
c(ocen = nrow(oceny), M = round(mean(oceny$wynik), 2), SD = round(sd(oceny$wynik), 2))

# 1. Badanie G: komponenty wariancji z modelu mieszanego (REML) – każda faseta i interakcja jako efekt losowy
m_g <- lmer(wynik ~ 1 + (1 | osoba) + (1 | oceniajacy) + (1 | zadanie) + (1 | osoba:oceniajacy) +
              (1 | osoba:zadanie) + (1 | oceniajacy:zadanie), data = oceny, REML = TRUE)
vc <- as.data.frame(VarCorr(m_g))
skladnik <- c(osoba = "p", oceniajacy = "r", zadanie = "t", "osoba:oceniajacy" = "pr",
              "osoba:zadanie" = "pt", "oceniajacy:zadanie" = "rt", Residual = "prt,e")
s2 <- setNames(vc$vcov, skladnik[vc$grp])[c("p", "r", "t", "pr", "pt", "rt", "prt,e")]
data.frame(wariancja = round(s2, 3), procent = round(100 * s2 / sum(s2), 1))

# 2. Współczynnik G (decyzje względne) i Φ (decyzje bezwzględne) dla planu z badania: 4 oceniających, 4 zadania
wspolczynniki <- function(s2, nr, nt) {
  blad_wzgl <- s2[["pr"]] / nr + s2[["pt"]] / nt + s2[["prt,e"]] / (nr * nt)
  blad_bezwz <- blad_wzgl + s2[["r"]] / nr + s2[["t"]] / nt + s2[["rt"]] / (nr * nt)
  c(oceniajacy = nr, zadania = nt, blad_wzgl = blad_wzgl, blad_bezwz = blad_bezwz,
    G = s2[["p"]] / (s2[["p"]] + blad_wzgl), Phi = s2[["p"]] / (s2[["p"]] + blad_bezwz))
}
round(wspolczynniki(s2, nr = 4, nt = 4), 3)
# błąd standardowy pomiaru wyniku średniego ucznia (pierwiastek wariancji błędu) w punktach
round(sqrt(wspolczynniki(s2, 4, 4)[c("blad_wzgl", "blad_bezwz")]), 2)

# 3. Niepewność: parametryczny bootstrap komponentów wariancji, G i Φ (200 replikacji)
stat_g <- function(m) {
  v <- as.data.frame(VarCorr(m)); s <- setNames(v$vcov, skladnik[v$grp])
  wspolczynniki(s, 4, 4)[c("G", "Phi")]
}
boot <- bootMer(m_g, stat_g, nsim = 200, seed = 2403)
round(t(apply(boot$t, 2, quantile, probs = c(.025, .975))), 3)
Wynik w R
   ocen       M      SD
1280.00   12.87    2.89
      wariancja procent
p         3.342    39.0
r         0.152     1.8
t         0.410     4.8
pr        0.381     4.4
pt        1.917    22.3
rt        0.498     5.8
prt,e     1.881    21.9
oceniajacy    zadania  blad_wzgl blad_bezwz          G        Phi
     4.000      4.000      0.692      0.864      0.828      0.795
 blad_wzgl blad_bezwz
      0.83       0.93
     2.5% 97.5%
G   0.757 0.871
Phi 0.692 0.849
2. Badanie D oraz porównanie z alfą i ICC
R
# Kontynuacja przepisu 1 (te same dane oceny, komponenty s2 i funkcja wspolczynniki)
suppressPackageStartupMessages(library(psych))

# 1. Badanie D: G i Φ dla różnych liczb oceniających (1–4) i zadań (1–10)
plan_d <- expand.grid(nr = 1:4, nt = 1:10)
plan_d <- cbind(plan_d, t(mapply(function(r, t) wspolczynniki(s2, r, t)[c("G", "Phi")], plan_d$nr, plan_d$nt)))
plan_d$ocen_na_ucznia <- plan_d$nr * plan_d$nt
round(subset(plan_d, nt %in% c(1, 2, 4, 6, 8)), 3)
# najtańsze plany (najmniej ocen na ucznia), które osiągają G ≥ .80 i Φ ≥ .80
tani <- function(kol) { ok <- plan_d[plan_d[[kol]] >= .80, ]; head(ok[order(ok$ocen_na_ucznia, -ok[[kol]]), ], 3) }
round(tani("G"), 3)
round(tani("Phi"), 3)
# czy lepiej dodać oceniającego, czy zadanie? (od planu 2 oceniających × 2 zadania)
round(rbind(start = wspolczynniki(s2, 2, 2), plus_oceniajacy = wspolczynniki(s2, 3, 2),
            plus_zadanie = wspolczynniki(s2, 2, 3))[, c("G", "Phi")], 3)

# 2. Alfa Cronbacha: zadania jako pozycje, wynik zadania = średnia z 4 oceniających
szer_z <- with(oceny, tapply(wynik, list(osoba, zadanie), mean))
alfa <- suppressMessages(psych::alpha(szer_z, warnings = FALSE))$total$raw_alpha
# to samo z komponentów: alfa „widzi” tylko fasetę zadań, interakcja osoba × oceniający wchodzi do wyniku prawdziwego
alfa_g <- (s2[["p"]] + s2[["pr"]] / 4) / (s2[["p"]] + s2[["pr"]] / 4 + (s2[["pt"]] + s2[["prt,e"]] / 4) / 4)
round(c(alfa = alfa, alfa_z_komponentow = alfa_g, G_pelny = wspolczynniki(s2, 4, 4)[["G"]]), 3)

# 3. ICC: oceniający jako „sędziowie”, wynik oceniającego = średnia z 4 zadań
szer_r <- with(oceny, tapply(wynik, list(osoba, oceniajacy), mean))
icc <- psych::ICC(szer_r, lmer = FALSE)$results
icc_k <- setNames(icc$ICC[icc$type %in% c("ICC3k", "ICC2k")], c("ICC2k_A_k", "ICC3k_C_k"))
# ICC „widzi” tylko fasetę oceniających, interakcja osoba × zadanie wchodzi do wyniku prawdziwego
uniw <- s2[["p"]] + s2[["pt"]] / 4
icc_c <- uniw / (uniw + (s2[["pr"]] + s2[["prt,e"]] / 4) / 4)
icc_a <- uniw / (uniw + (s2[["pr"]] + s2[["prt,e"]] / 4 + s2[["r"]] + s2[["rt"]] / 4) / 4)
round(c(icc_k, ICC_C_z_komponentow = icc_c, ICC_A_z_komponentow = icc_a,
        G_pelny = wspolczynniki(s2, 4, 4)[["G"]], Phi_pelny = wspolczynniki(s2, 4, 4)[["Phi"]]), 3)
Wynik w R
   nr nt     G   Phi ocen_na_ucznia
1   1  1 0.444 0.390              1
2   2  1 0.523 0.469              2
3   3  1 0.556 0.503              3
4   4  1 0.574 0.522              4
5   1  2 0.594 0.537              2
6   2  2 0.674 0.623              4
7   3  2 0.705 0.658              6
8   4  2 0.722 0.677              8
13  1  4 0.715 0.662              4
14  2  4 0.787 0.745              8
15  3  4 0.814 0.777             12
16  4  4 0.828 0.795             16
21  1  6 0.767 0.717              6
22  2  6 0.834 0.797             12
23  3  6 0.858 0.827             18
24  4  6 0.871 0.844             24
29  1  8 0.796 0.749              8
30  2  8 0.859 0.826             16
31  3  8 0.883 0.855             24
32  4  8 0.895 0.870             32
   nr nt     G   Phi ocen_na_ucznia
33  1  9 0.806 0.760              9
37  1 10 0.815 0.769             10
18  2  5 0.814 0.775             10
   nr nt     G   Phi ocen_na_ucznia
26  2  7 0.848 0.813             14
19  3  5 0.840 0.807             15
30  2  8 0.859 0.826             16
                    G   Phi
start           0.674 0.623
plus_oceniajacy 0.705 0.658
plus_zadanie    0.745 0.699
              alfa alfa_z_komponentow            G_pelny
             0.852              0.852              0.828
          ICC2k_A_k           ICC3k_C_k ICC_C_z_komponentow ICC_A_z_komponentow
              0.931               0.947               0.947               0.931
            G_pelny           Phi_pelny
              0.828               0.795
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lmer(), bootMer(), alpha(), ICC()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Raportowanie samego ICC przy kilku źródłach błędu. W przykładzie ICC = .95, a współczynnik G dla tego samego wyniku .83. Uśrednienie po zadaniach ukryło największy komponent błędu.
- Mylenie G i Φ. Do decyzji z progiem (zaliczenie, kwalifikacja, punkt odcięcia) potrzebny jest Φ, bo surowość egzaminatora zmienia wtedy decyzję.
- Badanie D bez badania G na właściwym uniwersum. Komponenty z czterech tematów nie mówią wiele o planie z dziesięcioma innymi. Przewidywania poza zakresem traktuj jako przybliżenie.
- Fasety z dwoma poziomami. Wariancja oceniających oszacowana z dwóch osób jest bardzo niepewna. Podawaj przedziały ufności i planuj więcej poziomów fasety, a nie więcej osób.
- Arbitralna decyzja o facecie stałej. Uznanie zadań za stałe podnosi współczynnik, ale zawęża wniosek do tych konkretnych zadań. Napisz to wprost w artykule.
Najczęstsze pytania
Czym różni się współczynnik G od współczynnika Φ w teorii generalizowalności?
Współczynnik G uwzględnia tylko błąd, który zmienia kolejność osób (interakcje osoby z fasetami), więc służy do decyzji względnych i korelacji. Φ dodaje do błędu efekty główne faset i ich interakcje, np. surowość egzaminatora albo trudność zadania, więc służy do decyzji względem progu. Φ jest zawsze nie większe od G; w przykładzie .80 wobec .83.
Jak policzyć komponenty wariancji do teorii generalizowalności w R bez pakietu gtheory?
Dopasuj w lme4 model z samym wyrazem wolnym i osobnym efektem losowym dla osoby, każdej fasety i każdej interakcji, np. (1 | osoba:oceniajacy). Wariancje z VarCorr() to komponenty badania G, a reszta to interakcja najwyższego rzędu z błędem. Jiang (2018) opisał to podejście krok po kroku; współczynniki G, Φ i badanie D liczysz potem ze wzorów.
Czy w badaniu D lepiej dodać oceniającego, czy zadanie?
Zależy od komponentów z badania G. Dodatkowy poziom fasety dzieli przez większą liczbę tylko te komponenty, które są z nią związane. W przykładzie interakcja uczeń × temat (22% wariancji) była znacznie większa niż uczeń × egzaminator (4%), więc trzecie zadanie podniosło G z .67 do .75, a trzeci egzaminator tylko do .71.
Dlaczego ICC sędziów jest wysokie, a współczynnik generalizowalności niski?
ICC liczone na wynikach uśrednionych po zadaniach traktuje interakcję osoby z zadaniem jako część wyniku prawdziwego. Mierzy zgodność sędziów co do tych konkretnych prac, a nie to, czy wynik uogólnia się na inne zadania. Jeśli zadania są losową próbą, raportuj G lub Φ ze schematu z obiema fasetami.
Ilu oceniających i zadań potrzeba w badaniu G?
Precyzja komponentu fasety zależy od liczby jej poziomów, a nie od liczby osób. Przy dwóch oceniających wariancja oceniających jest bardzo niepewna nawet przy setkach uczestników. Planuj możliwie wiele poziomów każdej losowej fasety i podawaj przedziały ufności dla G i Φ, np. z parametrycznego bootstrapu.
Powiązane hasła
Przeczytaj też
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikBadanie rzetelności pomiaru klinicznego
Plan badania powtarzalności, forma ICC, SEM i MDC95, wykres Blanda–Altmana, zgodność dwóch urządzeń i raport według GRRAS – z przykładem w R.
Czytaj →PoradnikEfekty skrzyżowane: uczestnicy × bodźce
Skrzyżowane efekty losowe osób i bodźców w lme4, maksymalna struktura, symulacja błędu I rodzaju, moc zależna od liczby bodźców i opis APA.
Czytaj →Planujesz badanie rzetelności z kilkoma oceniającymi i zadaniami?
Pomożemy zaprojektować badanie G i D, oszacować komponenty wariancji, wybrać liczbę oceniających i zadań oraz opisać wyniki tak, żebyś mógł(a) je samodzielnie obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Brennan, R. L. (2001). Generalizability theory. Springer. https://doi.org/10.1007/978-1-4757-3456-0
- Briesch, A. M., Swaminathan, H., Welsh, M., & Chafouleas, S. M. (2014). Generalizability theory: A practical guide to study design, implementation, and interpretation. Journal of School Psychology, 52(1), 13–35. https://doi.org/10.1016/j.jsp.2013.11.008
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/bf02310555 ● Otwarty dostęp
- Cronbach, L. J., Gleser, G. C., Nanda, H., & Rajaratnam, N. (1972). The dependability of behavioral measurements: Theory of generalizability for scores and profiles. Wiley.
- Jiang, Z. (2018). Using the linear mixed-effect model framework to estimate generalizability variance components in R. Methodology, 14(3), 133–142. https://doi.org/10.1027/1614-2241/a000149
- McGraw, K. O., & Wong, S. P. (1996). Forming inferences about some intraclass correlation coefficients. Psychological Methods, 1(1), 30–46. https://doi.org/10.1037/1082-989X.1.1.30
- Shavelson, R. J., & Webb, N. M. (1991). Generalizability theory: A primer. Sage.
- Shavelson, R. J., Webb, N. M., & Rowley, G. L. (1989). Generalizability theory. American Psychologist, 44(6), 922–932. https://doi.org/10.1037/0003-066x.44.6.922
- Vispoel, W. P., Morris, C. A., & Kilinc, M. (2018). Applications of generalizability theory and their relations to classical test theory and structural equation modeling. Psychological Methods, 23(1), 1–26. https://doi.org/10.1037/met0000107
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@book{brennan2001generalizability, author={Brennan, Robert L.}, title={{Generalizability theory}}, year={2001}, publisher={Springer}, doi={10.1007/978-1-4757-3456-0}}@article{briesch2014generalizability, author={Briesch, Amy M. and Swaminathan, Hariharan and Welsh, Megan and Chafouleas, Sandra M.}, title={{Generalizability theory: A practical guide to study design, implementation, and interpretation}}, journal={Journal of School Psychology}, year={2014}, volume={52}, number={1}, pages={13--35}, doi={10.1016/j.jsp.2013.11.008}}@article{cronbach1951coefficient, author={Cronbach, Lee J.}, title={{Coefficient alpha and the internal structure of tests}}, journal={Psychometrika}, year={1951}, volume={16}, number={3}, pages={297--334}, doi={10.1007/bf02310555}}@book{cronbach1972dependability, author={Cronbach, Lee J. and Gleser, Goldine C. and Nanda, Harinder and Rajaratnam, Nageswari}, title={{The dependability of behavioral measurements: Theory of generalizability for scores and profiles}}, year={1972}, publisher={Wiley}, url={https://openlibrary.org/works/OL17977727W}}@article{jiang2018using, author={Jiang, Zhehan}, title={{Using the linear mixed-effect model framework to estimate generalizability variance components in R}}, journal={Methodology}, year={2018}, volume={14}, number={3}, pages={133--142}, doi={10.1027/1614-2241/a000149}}@article{mcgraw1996forming, author={McGraw, Kenneth O. and Wong, S. P.}, title={{Forming inferences about some intraclass correlation coefficients}}, journal={Psychological Methods}, year={1996}, volume={1}, number={1}, pages={30--46}, doi={10.1037/1082-989x.1.1.30}}@book{shavelson1991generalizability, author={Shavelson, Richard J. and Webb, Noreen M.}, title={{Generalizability theory: A primer}}, year={1991}, publisher={Sage}, url={https://openlibrary.org/isbn/9780803937451}}@article{shavelson1989generalizability, author={Shavelson, Richard J. and Webb, Noreen M. and Rowley, Glenn L.}, title={{Generalizability theory}}, journal={American Psychologist}, year={1989}, volume={44}, number={6}, pages={922--932}, doi={10.1037/0003-066x.44.6.922}}@article{vispoel2018applications, author={Vispoel, Walter P. and Morris, Carrie A. and Kilinc, Murat}, title={{Applications of generalizability theory and their relations to classical test theory and structural equation modeling}}, journal={Psychological Methods}, year={2018}, volume={23}, number={1}, pages={1--26}, doi={10.1037/met0000107}}