Co to jest teoria generalizowalności?
Teoria generalizowalności (teoria G, ang. generalizability theory) to rozszerzenie klasycznej teorii rzetelności. Klasyczna teoria ma jeden błąd pomiaru, a teoria G rozkłada go na źródła, zwane fasetami: oceniających, zadania, okazje pomiaru. Brennan (2001) opisuje ją jako zastosowanie analizy wariancji do komponentów wariancji. Bloch i Norman (2012) wyjaśniają ją krok po kroku na przykładach z edukacji medycznej, m.in. egzaminów OSCE i skal ocen.
Badanie G i badanie D
Badanie G szacuje komponenty wariancji, np. w schemacie osoba × oceniający × zadanie: wariancję osób, faset i ich interakcji. Badanie D używa ich do pytania „co, jeśli”: jak zmieni się rzetelność przy innej liczbie oceniających lub zadań, i wskazać najtańszą drogę do wymaganej precyzji (Shavelson i Webb, 1991). Współczynnik G (ρ²) dotyczy decyzji względnych, czyli porządkowania osób, i obejmuje tylko interakcje z osobami. Współczynnik Φ dotyczy decyzji bezwzględnych, np. progu zaliczenia, więc wlicza też główne efekty faset, takie jak surowość oceniających. Dla jednej fasety G odpowiada ICC zgodności średnich ocen, a w schemacie osoba × pozycja – alfie Cronbacha.
Przykład
W symulowanych danych 40 osób oceniło 3 oceniających w 4 zadaniach. Osoby odpowiadały za 50.4% wariancji, interakcja osoba × zadanie za 18.1%, a osoba × oceniający za 5.9%. Obecny plan dał G = .875 i Φ = .807. Badanie D pokazało, że 2 oceniających i 8 zadań (G = .898) to lepszy plan niż 3 oceniających i 4 zadania, bo więcej błędu wnoszą zadania niż oceniający.
Na rysunku
Rysunek używa komponentów wariancji z przykładu (dane symulowane, set.seed(3794)). Pokazuje, co dzieje się z nimi w badaniu D: każdy składnik błędu dzieli się przez liczbę oceniających, zadań albo ich iloczyn. Sześć planów ma ten sam koszt, 12 ocen na osobę; plan 1 × 1 (jedna ocena) jest punktem odniesienia.
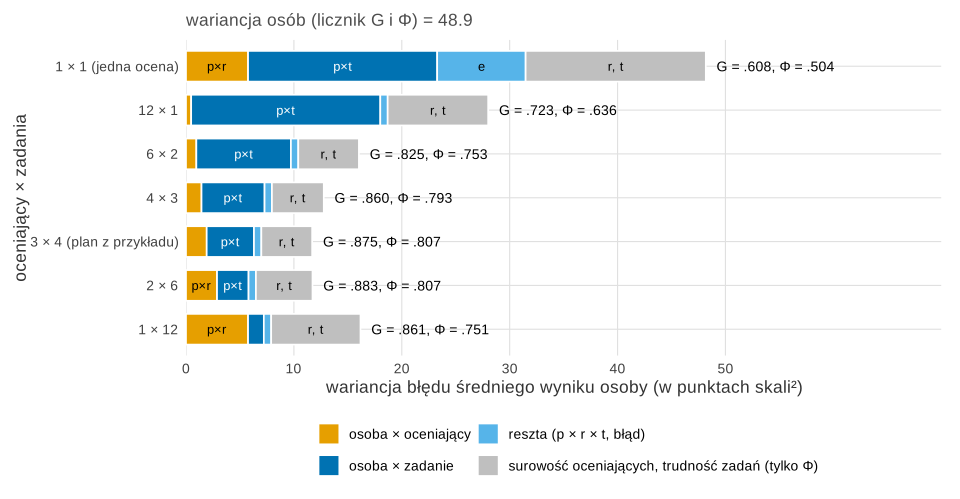
Co widać. Wariancja osób wynosi 48.9 i jest licznikiem obu współczynników, więc o wyniku decyduje tylko długość słupka błędu. Przy jednym zadaniu dominuje interakcja osoba × zadanie (17.53), której nie zmniejszy żadna liczba oceniających: 12 oceniających daje G = .723. Gdy te same 12 ocen rozłożyć na 2 oceniających i 6 zadań, składniki osoba × oceniający i osoba × zadanie są prawie równe (2.88 i 2.92), a G rośnie do .883. Plan 1 × 12 znów traci (G = .861), bo zostaje cała wariancja osoba × oceniający, a dla Φ także cała surowość jedynego oceniającego.
Na co uważać. Rysunek traktuje komponenty z badania G jak znane wartości. Przy 3 oceniających i 4 zadaniach są one niepewne, więc różnica między planami 3 × 4 i 2 × 6 (.875 i .883) mieści się w błędzie oszacowania. Nie pokazuje też kosztu: dodatkowe zadanie i dodatkowy oceniający rzadko kosztują tyle samo. Krzywe G i Φ dla wielu planów i komponenty pojedynczej oceny pokazuje wpis Teoria generalizowalności – badania G i D.
Podpis do pracy:
Kod poniżej odtwarza dane i komponenty wariancji z przykładu, a potem liczy błąd względny i bezwzględny oraz G i Φ dla każdego planu. Rysunek na stronie różni się od wyniku kodu tylko motywem (czcionka, siatka).
Kod R rysunku 1
library(ggplot2)
suppressPackageStartupMessages(library(lme4))
kol <- c("osoba × oceniający" = "#E69F00", "osoba × zadanie" = "#0072B2",
         "reszta (p × r × t, błąd)" = "#56B4E9", "surowość oceniających, trudność zadań (tylko Φ)" = "grey75")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
set.seed(3794)                                      # te same dane co w przykładzie powyżej
np <- 40; nr <- 3; nt <- 4
d <- expand.grid(p = factor(1:np), r = factor(1:nr), t = factor(1:nt))
efekt <- function(f, sd) rnorm(nlevels(f), sd = sd)[f]
d$wynik <- 50 + efekt(d$p, 6) + efekt(d$r, 2) + efekt(d$t, 3) +
  efekt(interaction(d$p, d$r), 2) + efekt(interaction(d$p, d$t), 4) +
  efekt(interaction(d$r, d$t), 1) + rnorm(nrow(d), sd = 3)
m <- lmer(wynik ~ 1 + (1 | p) + (1 | r) + (1 | t) + (1 | p:r) + (1 | p:t) + (1 | r:t), data = d)
vc <- as.data.frame(VarCorr(m)); s2 <- setNames(vc$vcov, vc$grp)
# plany badania D: pojedyncza ocena i sześć planów po 12 ocen na osobę
plany <- data.frame(n_r = c(1, 12, 6, 4, 3, 2, 1), n_t = c(1, 1, 2, 3, 4, 6, 12))
plany$plan <- sprintf("%d × %d", plany$n_r, plany$n_t)
plany$plan[c(1, 5)] <- c("1 × 1 (jedna ocena)", "3 × 4 (plan z przykładu)")
skl <- with(plany, data.frame(
  "osoba × oceniający" = s2["p:r"] / n_r, "osoba × zadanie" = s2["p:t"] / n_t,
  "reszta (p × r × t, błąd)" = s2["Residual"] / (n_r * n_t),
  "surowość oceniających, trudność zadań (tylko Φ)" = s2["r"] / n_r + s2["t"] / n_t + s2["r:t"] / (n_r * n_t),
  check.names = FALSE))
plany$bl_wzgl <- rowSums(skl[, 1:3]); plany$bl_abs <- rowSums(skl)
plany$G <- s2["p"] / (s2["p"] + plany$bl_wzgl); plany$Phi <- s2["p"] / (s2["p"] + plany$bl_abs)
tab <- cbind(plany[, c("n_r", "n_t")], round(skl, 2), round(plany[, c("bl_wzgl", "bl_abs")], 2), round(plany[, c("G", "Phi")], 3))
names(tab)[3:6] <- c("p_r", "p_t", "reszta", "tylko_Phi")
print(tab, row.names = FALSE)
round(s2["p"], 2)                                   # wariancja osób: licznik obu współczynników
bz <- function(x) sub("^0", "", sprintf("%.3f", x))
dl <- data.frame(plan = rep(plany$plan, 4), skladnik = rep(names(skl), each = nrow(plany)),
                 war = unlist(skl, use.names = FALSE))
dl$plan <- factor(dl$plan, rev(plany$plan)); dl$skladnik <- factor(dl$skladnik, rev(names(skl)))
dl$skrot <- c("p×r", "p×t", "e", "r, t")[match(dl$skladnik, names(skl))]
plany$opis <- sprintf("G = %s, Φ = %s", bz(plany$G), bz(plany$Phi))
p1 <- ggplot(dl, aes(war, plan)) +
  geom_col(aes(fill = skladnik), colour = "white", width = 0.7) +
  geom_text(aes(label = ifelse(war > 2.2, skrot, ""), colour = skrot == "p×t", group = skladnik),
            position = position_stack(vjust = 0.5), size = 3.4, show.legend = FALSE) +
  scale_colour_manual(values = c("FALSE" = "black", "TRUE" = "white"), guide = "none") +
  geom_text(data = plany, aes(x = bl_abs + 1, y = plan, label = opis), hjust = 0, size = 3.7) +
  scale_fill_manual(values = kol, breaks = names(kol), name = NULL) +
  scale_x_continuous(limits = c(0, 70), breaks = seq(0, 50, 10), expand = expansion(mult = c(0, 0))) +
  guides(fill = guide_legend(nrow = 2)) +
  labs(x = "wariancja błędu średniego wyniku osoby (w punktach skali²)", y = "oceniający × zadania",
       subtitle = sprintf("wariancja osób (licznik G i Φ) = %.1f", s2["p"])) + motyw
# print(p1)   # albo: ggsave("teoria-generalizowalnosci-plany-badania-d.svg", p1, width = 10, height = 5.2)
Wynik w R
 n_r n_t  p_r   p_t reszta tylko_Phi bl_wzgl bl_abs     G   Phi
   1   1 5.75 17.53   8.20     16.70   31.48  48.18 0.608 0.504
  12   1 0.48 17.53   0.68      9.31   18.69  28.01 0.723 0.636
   6   2 0.96  8.77   0.68      5.62   10.41  16.03 0.825 0.753
   4   3 1.44  5.84   0.68      4.80    7.96  12.77 0.860 0.793
   3   4 1.92  4.38   0.68      4.71    6.98  11.69 0.875 0.807
   2   6 2.88  2.92   0.68      5.24    6.48  11.72 0.883 0.807
   1  12 5.75  1.46   0.68      8.28    7.90  16.17 0.861 0.751
   p
48.9
Jak opisać w pracy
Na co uważać
- Mało poziomów fasety. Wariancję oceniających przy trzech osobach oceniających szacuje się bardzo niepewnie.
- G czy Φ. Przy progach i normach podaj Φ; wynika z niej też błąd pomiaru dla decyzji bezwzględnych.
- Schemat zagnieżdżony. Gdy każdy oceniający ocenia inne osoby, część komponentów się zlewa.
Pełne badanie G i D w R pokazuje wpis Teoria generalizowalności – badania G i D, a prostsze miary zgodności – Zgodność sędziów: kappa, ICC, alfa.
Teoria generalizowalności w R
Pakiet gtheory nie jest potrzebny: kod szacuje komponenty wariancji schematu skrzyżowanego modelem mieszanym w lme4, a współczynniki G i Φ dla różnych planów liczy ze wzorów.
Badanie G i D dla schematu osoba × oceniający × zadanie
R
suppressPackageStartupMessages(library(lme4))
set.seed(3794)
np <- 40; nr <- 3; nt <- 4                         # 40 osób × 3 oceniających × 4 zadania
d <- expand.grid(p = factor(1:np), r = factor(1:nr), t = factor(1:nt))
efekt <- function(f, sd) rnorm(nlevels(f), sd = sd)[f]
d$wynik <- 50 + efekt(d$p, 6) + efekt(d$r, 2) + efekt(d$t, 3) +
  efekt(interaction(d$p, d$r), 2) + efekt(interaction(d$p, d$t), 4) +
  efekt(interaction(d$r, d$t), 1) + rnorm(nrow(d), sd = 3)

m <- lmer(wynik ~ 1 + (1 | p) + (1 | r) + (1 | t) + (1 | p:r) + (1 | p:t) + (1 | r:t),
          data = d, REML = TRUE)
vc <- as.data.frame(VarCorr(m))
s2 <- setNames(vc$vcov, vc$grp)                     # komponenty wariancji
round(s2, 2)
round(100 * s2 / sum(s2), 1)                        # procent wariancji całkowitej

wsp <- function(n_r, n_t) {                         # badanie D: współczynniki G i Phi
  bl_wzgl <- s2["p:r"] / n_r + s2["p:t"] / n_t + s2["Residual"] / (n_r * n_t)
  bl_abs  <- bl_wzgl + s2["r"] / n_r + s2["t"] / n_t + s2["r:t"] / (n_r * n_t)
  c(G = unname(s2["p"] / (s2["p"] + bl_wzgl)), Phi = unname(s2["p"] / (s2["p"] + bl_abs)))
}
plan <- expand.grid(oceniajacy = c(1, 2, 3), zadania = c(2, 4, 8))
round(cbind(plan, t(mapply(wsp, plan$oceniajacy, plan$zadania))), 3)
Wynik w R
     p:t      p:r        p      r:t        t        r Residual
   17.53     5.75    48.90     0.55     8.64     7.51     8.20
     p:t      p:r        p      r:t        t        r Residual
    18.1      5.9     50.4      0.6      8.9      7.7      8.4
  oceniajacy zadania     G   Phi
1          1       2 0.724 0.614
2          2       2 0.781 0.691
3          3       2 0.802 0.721
4          1       4 0.801 0.690
5          2       4 0.855 0.774
6          3       4 0.875 0.807
7          1       8 0.845 0.735
8          2       8 0.898 0.824
9          3       8 0.917 0.859
Bibliografia oprogramowania
Wyniki i rysunek pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety lme4 i ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0-1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym współczynnik G różni się od współczynnika Φ?
G obejmuje tylko błędy zmieniające kolejność osób (interakcje z osobami), więc pasuje do porównań względnych. Φ dodaje główne efekty faset, np. to, że jeden oceniający jest surowszy od innych; jest niższy od G i właściwy przy progach zaliczenia.
Ile osób i oceniających potrzeba do badania G?
Nie ma jednej liczby, ale komponent fasety szacuje się z liczby jej poziomów. Przy 2–3 oceniających wariancja oceniających jest bardzo niepewna, więc w badaniu G lepiej mieć ich więcej niż w docelowym pomiarze, a w badaniu D wnioskować ostrożnie.
Jak policzyć teorię G w R bez pakietu gtheory?
Dopasuj lme4::lmer(wynik ~ 1 + (1|p) + (1|r) + (1|t) + (1|p:r) + (1|p:t) + (1|r:t)), odczytaj komponenty z VarCorr() i wstaw je do wzorów na G i Φ, dzieląc wariancje błędu przez planowaną liczbę oceniających i zadań.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Teoria generalizowalności – badania G i D
Fasety i komponenty wariancji w lme4, współczynniki G i Φ, badanie D: ilu oceniających i zadań potrzeba, relacja do ICC i alfy, przykład w R.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bloch, R., & Norman, G. (2012). Generalizability theory for the perplexed: A practical introduction and guide: AMEE Guide No. 68. Medical Teacher, 34(11), 960–992. https://doi.org/10.3109/0142159x.2012.703791
- Brennan, R. L. (2001). Generalizability theory. Springer. https://doi.org/10.1007/978-1-4757-3456-0
- Shavelson, R. J., & Webb, N. M. (1991). Generalizability theory: A primer. Sage.
Cytowania BibTeX
@article{bloch2012generalizability, author={Bloch, Ralph and Norman, Geoffrey}, title={{Generalizability theory for the perplexed: A practical introduction and guide: AMEE Guide No. 68}}, journal={Medical Teacher}, year={2012}, volume={34}, number={11}, pages={960--992}, doi={10.3109/0142159x.2012.703791}}@book{brennan2001generalizability, author={Brennan, Robert L.}, title={{Generalizability theory}}, year={2001}, publisher={Springer}, doi={10.1007/978-1-4757-3456-0}}@book{shavelson1991generalizability, author={Shavelson, Richard J. and Webb, Noreen M.}, title={{Generalizability theory: A primer}}, year={1991}, publisher={Sage}, url={https://openlibrary.org/isbn/9780803937451}}