Kiedy szukać klas trajektorii
Model krzywej wzrostu opisuje jedną średnią trajektorię i rozrzut osób wokół niej. Zakłada przy tym, że wszyscy pochodzą z jednej populacji. Czasem teoria przewiduje kilka odmiennych przebiegów, np. objawy niskie i stabilne, narastające albo malejące. Wtedy pytanie brzmi nie „jak szybko rośnie średnia”, ale „jakie odrębne przebiegi zmian występują w próbie i jak często”. Odpowiadają na nie modele mieszanin dla danych podłużnych: LCGA (ang. latent class growth analysis) i model mieszanin wzrostu, GMM (ang. growth mixture model).
Nagin (1999) zaproponował podejście grupowe, które identyfikuje grupy trajektorii z danych, zamiast je zakładać. Szacuje odsetek populacji w każdej grupie i pozwala powiązać przynależność z cechami osób. Muthén i Shedden (1999) połączyli klasy ukryte z modelem współczynników losowych i pokazali, jak klasy trajektorii przewidują późniejszy wynik. Jung i Wickrama (2008) opisują obie metody jako sposób wyodrębnienia jednorodnych podpopulacji w heterogenicznej próbie.
Ten poradnik nie powtarza podstaw. Model z jedną trajektorią w lavaan pokazuje wpis krzywe wzrostu (LGM), a w lme4 – modele wzrostu w lme4. Logikę klas, BLRT i analizę zmiennych zewnętrznych omawia analiza klas latentnych krok po kroku, a model mieszaniny dla wyników ciągłych – segmentacja respondentów: k-średnich i LPA.
LCGA a GMM: czy osoby w klasie się różnią?
W LCGA każda osoba z klasy k ma tę samą trajektorię, a odchylenia od niej to tylko błąd losowy. Dla trajektorii liniowej:
GMM dodaje w każdej klasie efekty losowe: losowy wyraz wolny u0i i losowe nachylenie u1i. Osoby z tej samej klasy mogą więc zaczynać z różnego poziomu i zmieniać się w różnym tempie. Ram i Grimm (2009) traktują LCGA jako szczególny przypadek GMM, w którym zróżnicowanie osób wewnątrz klas ustalono na zero. Prawdopodobieństwo danych osoby to w obu modelach średnia ważona gęstości w klasach, z wagami równymi udziałom klas. Szczegóły i definicje zebraliśmy w haśle model mieszanin wzrostu (GMM) i LCGA.
| Model | Klasy | Zróżnicowanie osób w klasie | Zaleta | Ryzyko |
|---|---|---|---|---|
| Krzywa wzrostu (LGM, model wielopoziomowy) | jedna | wariancje wyrazu wolnego i nachylenia | prosty, dobrze zbadany | uśrednia odmienne przebiegi |
| LCGA | kilka | brak (tylko błąd losowy) | stabilna estymacja, prosta interpretacja | nadmiarowe klasy, gdy osoby w klasie się różnią |
| GMM | kilka | efekty losowe w każdej klasie | realistyczny opis zmienności | problemy ze zbieżnością, wiele decyzji o wariancjach |
Przykład: objawy depresyjne od 12. do 16. roku życia
Czterystu nastolatków co rok wypełniało skalę objawów depresyjnych (0–30, wyższy wynik oznacza silniejsze objawy). Mamy pięć pomiarów, w wieku od 12 do 16 lat; czas kodujemy w latach od pierwszego pomiaru, więc wyraz wolny oznacza poziom w wieku 12 lat. Dane są symulowane (set.seed(2321)) z trzech trajektorii: niskiej stabilnej, narastającej i wysokiej malejącej. W obrębie trajektorii osoby nieco różnią się poziomem i tempem, tak jak w prawdziwych danych. Braków przybywało z czasem: od 19 osób w drugim pomiarze do 57 w piątym, łącznie 8.5% pomiarów. Plik możesz pobrać jako CSV (400 wierszy: id, w1–w5, klasa_prawdziwa; ostatnia kolumna istnieje tylko w symulacji). Planowanie liczby pomiarów i odstępów opisuje wpis badanie podłużne w doktoracie.
LCGA jako algorytm EM w R
Popularne pakiety lcmm i flexmix nie były zainstalowane w środowisku, w którym liczyliśmy przykład. LCGA da się jednak zapisać jako skończoną mieszaninę regresji trajektorii i oszacować krótką funkcją w podstawowym R. Służy do tego algorytm EM, ogólna metoda szukania maksimum wiarygodności przy danych niepełnych, której zastosowania obejmują modele mieszanin (Dempster i in., 1977). Tutaj „brakującą” informacją jest klasa każdej osoby. Algorytm powtarza dwa kroki:
- Krok E. Dla każdej osoby liczy prawdopodobieństwo a posteriori przynależności do każdej klasy przy bieżących trajektoriach.
- Krok M. Na nowo szacuje udziały klas i trajektorie ważoną regresją liniową, z wagami równymi tym prawdopodobieństwom, oraz wspólną wariancję reszt.
Algorytm może utknąć w maksimum lokalnym, dlatego każdy model szacowaliśmy z 30 losowych startów i sprawdzaliśmy, ile z nich osiąga najlepszy logarytm wiarygodności. Braki w pojedynczych pomiarach po prostu pomijamy w wiarygodności osoby. To poprawne przy brakach typu MAR, tak jak FIML w metodzie największej wiarygodności (zob. braki danych MCAR, MAR i MNAR). Model z K klasami ma 3K parametrów: dwa współczynniki trajektorii na klasę, wariancję reszt i K − 1 udziałów.
Ile klas? BIC, entropia i BLRT
W symulacjach Nylunda i in. (2007), obejmujących także modele mieszanin wzrostu, najlepszym kryterium informacyjnym okazało się BIC, a bootstrapowy test ilorazu wiarygodności (BLRT) był bardzo spójnym wskaźnikiem liczby klas. Zwykły test χ² różnicy wiarygodności nie ma tu poprawnego rozkładu. BLRT tworzy go więc, losując wiele zbiorów danych z modelu z K − 1 klasami (szczegóły i kod w poradniku o LCA). Entropia względna (od 0 do 1) mierzy, jak pewnie model przydziela osoby do klas. Ram i Grimm (2009) uznają wartości powyżej .80 za pewną klasyfikację i przy podobnym BIC proponują wybierać model o wyższej entropii. Tein i in. (2013) pokazali jednak w symulacjach dla profili latentnych, że sama entropia słabo wskazuje właściwą liczbę klas.
| Liczba klas | logL | Parametry | BIC | ΔBIC | Entropia | Najmniejsza klasa (%) | Replikacja logL |
|---|---|---|---|---|---|---|---|
| 1 | −5383.63 | 3 | 10785.23 | — | — | 100.0 | 30/30 |
| 2 | −5150.16 | 6 | 10336.27 | −448.96 | .858 | 38.8 | 30/30 |
| 3 | −4803.78 | 9 | 9661.48 | −674.79 | .958 | 16.2 | 30/30 |
| 4 | −4780.20 | 12 | 9632.30 | −29.18 | .808 | 15.9 | 29/30 |
| 5 | −4766.93 | 15 | 9623.73 | −8.57 | .787 | 10.6 | 16/30 |
Najniższe BIC ma model z pięcioma klasami. Spadek BIC przy trzeciej klasie wynosi jednak 674.79, a przy czwartej i piątej już tylko 29.18 i 8.57. Entropia spada z .958 do .787, a najlepsze rozwiązanie z pięcioma klasami powtórzyło się tylko w 16 z 30 startów. Rysunek 1 pokazuje, skąd się wzięły dodatkowe klasy.
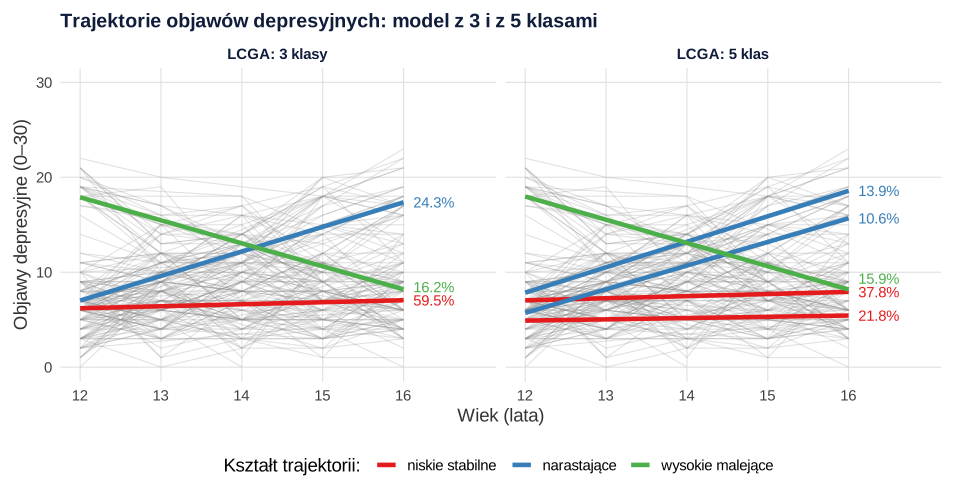
Czwarta i piąta klasa to kopie trajektorii niskiej (4.90 i 7.04 pkt w wieku 12 lat, prawie bez zmiany) i narastającej (5.72 i 7.84 pkt, wzrost o 2.49 i 2.68 pkt na rok). Średnie prawdopodobieństwa przynależności (AvePP) spadają w nich do .78–.87. To typowy ślad zróżnicowania osób wewnątrz klas. LCGA nie ma efektów losowych, więc różnice poziomu może opisać tylko kolejnymi klasami. Decyzję podjęliśmy więc na podstawie spadku BIC, entropii, replikacji i treści trajektorii, a nie samego minimum BIC. Wybraliśmy trzy klasy. Konsekwentnym krokiem byłoby teraz sprawdzenie GMM z losowym wyrazem wolnym (kod niżej). Takie kryteria zapisz z góry w planie analizy.
| Klasa | Poziom w wieku 12 lat | Zmiana na rok | Udział (%) | n | AvePP |
|---|---|---|---|---|---|
| Niska stabilna | 6.20 | 0.21 | 59.5 | 239 | .983 |
| Narastająca | 7.02 | 2.59 | 24.3 | 96 | .972 |
| Wysoka malejąca | 17.89 | −2.42 | 16.2 | 65 | .986 |
Odchylenie standardowe reszt wyniosło 2.74 pkt. W symulacji znamy prawdziwe klasy: model przypisał do właściwej trajektorii 97.2% osób. W prawdziwym badaniu tej liczby nie znasz, dlatego raportuj AvePP i entropię. Pamiętaj też o ostrzeżeniu Bauera i Currana (2003): przy nienormalnym rozkładzie pomiarów model mieszanin może wskazać kilka klas, choć populacja jest jednorodna. Klasy są modelem heterogeniczności, a nie dowodem istnienia „typów” ludzi.
Kontrola: podejście dwuetapowe w mclust
Prostszą alternatywą jest analiza w dwóch etapach. Najpierw dla każdej osoby z co najmniej trzema pomiarami liczysz osobną regresję wyniku na czas (397 z 400 osób). Potem pary „wyraz wolny, nachylenie” grupujesz modelem mieszaniny rozkładów normalnych w pakiecie mclust. Pakiet porównuje 14 parametryzacji macierzy kowariancji i wybiera model o najwyższym BIC, liczonym jako 2·logL − k·ln(n), czyli z odwrotnym znakiem niż w tabeli wyżej (Scrucca i in., 2016). Podstawy tego podejścia omawia hasło analiza profili latentnych.
mclust wybrał trzy skupienia w modelu EEE, BIC = −3365.55 wobec −3383.23 dla czterech. Średnie skupień (6.33 i 0.19, 6.86 i 2.68, 17.96 i −2.48) są bliskie trajektoriom LCGA. Zgodność podziałów jest wysoka: skorygowany indeks Randa (ARI) między LCGA a mclust wynosi .942, a z prawdziwymi klasami .910 dla LCGA i .918 dla mclust. Różne przydziały dotyczą 7 osób: pięciu na granicy trajektorii niskiej i narastającej oraz dwóch na granicy niskiej i wysokiej malejącej.
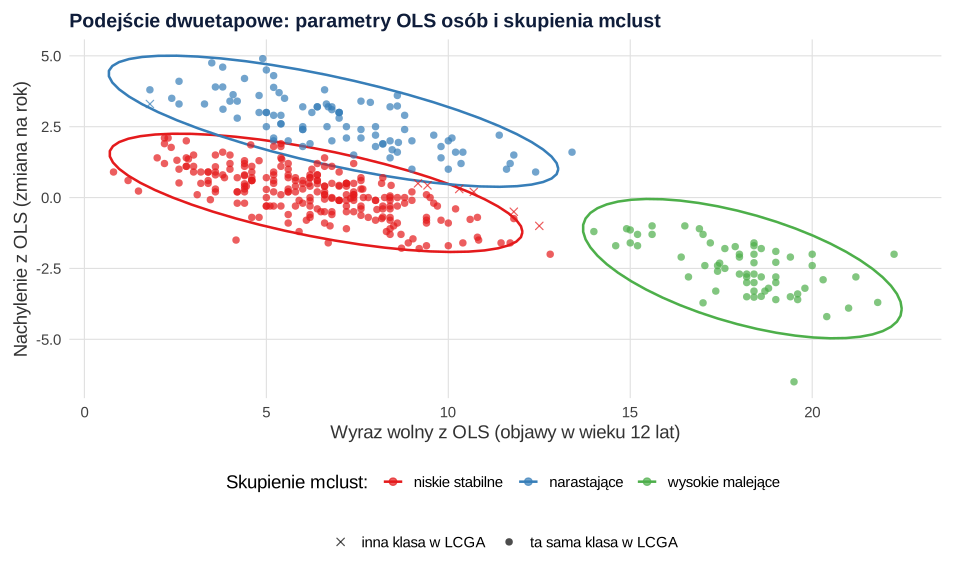
Dlaczego mclust wskazał trzy grupy, a LCGA według BIC pięć? Model EEE pozwala, by osoby w skupieniu różniły się poziomem i tempem, a rozrzut ten opisuje elipsa wspólna dla skupień. Działa więc jak zgrubny odpowiednik GMM. Podejście dwuetapowe ma jednak ograniczenia. Traktuje oszacowania z kilku pomiarów jak wartości bez błędu, wyklucza osoby z małą liczbą pomiarów i nie daje poprawnych błędów standardowych parametrów klas. Traktuj je jako kontrolę, a nie zamiennik modelu mieszaniny (zob. też analiza skupień).
GMM w praktyce: decyzje i pułapki
GMM wymaga decyzji, których LCGA nie ma: które efekty losowe dopuścić, czy ich wariancje są równe w klasach i czy kształt zmiany jest wspólny. Ram i Grimm (2009) proponują cztery kroki: definicję problemu (ile klas oczekujesz i czym mają się różnić), specyfikację, estymację oraz wybór i interpretację modelu. Autorzy traktują GMM jako kierowaną eksplorację, a nie test jednej hipotezy.
- Zacznij od modelu z jedną klasą i sprawdź kształt zmiany (liniowy, kwadratowy, ładunki swobodne), jak w poradniku o krzywych wzrostu.
- Porównuj LCGA i GMM z tą samą liczbą klas. Jeżeli GMM z mniejszą liczbą klas ma niższe BIC niż LCGA z większą, dodatkowe klasy LCGA opisywały zapewne zmienność wewnątrz grup.
- Używaj wielu startów (w
lcmmfunkcjagridsearch()) i sprawdzaj, czy najlepszy wynik się powtarza. Ujemne wariancje i brak zbieżności to sygnał, że model jest zbyt złożony. - Pamiętaj o założeniach rozkładu. Ostrzeżenie Bauera i Currana (2003) dotyczy szczególnie GMM: skośny rozkład objawów może „wyprodukować” klasy.
Kod GMM w pakiecie lcmm znajdziesz w trzecim przepisie w sekcji z kodem. Jest oznaczony jako niewykonany i nie podajemy z niego żadnych liczb. Ten sam model wielopoziomowy z jedną klasą to model z wpisu o lme4; GMM dodaje do niego mieszaninę klas.
Jak raportować: lista GRoLTS
Analizy trajektorii raportuje się bardzo różnie, choć wymagają wielu decyzji. Dlatego van de Schoot i in. (2017) opracowali w czterorundowym badaniu delfickim z ekspertami listę GRoLTS (Guidelines for Reporting on Latent Trajectory Studies). Wskazuje ona, co trzeba podać, raportując LCGA i GMM. Autorzy zastosowali ją do 38 artykułów o trajektoriach stresu pourazowego. Przed wysłaniem tekstu porównaj go z oryginalną listą. Z naszego przykładu wynika minimum, które warto podać:
- kodowanie czasu, liczba i terminy pomiarów, odsetek braków w każdym pomiarze i przyjęte założenie o brakach;
- rozkład zmiennej, program i wersja, funkcja czasu, struktura wariancji wewnątrz klas (LCGA czy GMM i które efekty losowe);
- liczba startów i powtarzalność najlepszego logL, wszystkie porównane modele z logL, BIC, entropią i wielkością najmniejszej klasy;
- kryteria wyboru liczby klas ustalone przed analizą, wykres średnich trajektorii na tle danych osób, AvePP oraz kod analizy.
Jeśli przygotowujesz artykuł z analizą trajektorii albo odpowiadasz recenzentowi na pytania o liczbę klas, możemy pomóc w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa pierwsze przepisy uruchamiasz po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik trajektorie-dane.csv (możesz go pobrać tutaj) i szacuje LCGA własnym algorytmem EM. Drugi wykonuje podejście dwuetapowe w mclust. Trzeci pokazuje zapis GMM w pakiecie lcmm, którego nie uruchamialiśmy.
1. LCGA: algorytm EM, BIC, entropia i replikacja
R
# Dane symulowane: objawy depresyjne (skala 0–30, wyższy = silniejsze) u 400 nastolatków,
# 5 corocznych pomiarów w wieku 12–16 lat; w populacji są 3 trajektorie o różnych kształtach
set.seed(2321)
N <- 400; czas <- 0:4                                  # czas = lata od pierwszego pomiaru (wiek 12)
klasa_prawdziwa <- sample(1:3, N, replace = TRUE, prob = c(.60, .25, .15))
b0 <- c(6, 7, 18)[klasa_prawdziwa] + rnorm(N, 0, 1.2)  # niewielkie różnice osób wewnątrz trajektorii
b1 <- c(0.2, 2.6, -2.4)[klasa_prawdziwa] + rnorm(N, 0, 0.25)
Y <- outer(b0, rep(1, 5)) + outer(b1, czas) + matrix(rnorm(N * 5, 0, 2.5), N)
Y <- pmin(pmax(round(Y), 0), 30)
brak <- matrix(runif(N * 5) < rep(c(0, .04, .08, .12, .16), each = N), N)      # braki rosnące w czasie
Y[brak] <- NA
colnames(Y) <- paste0("w", 1:5)
dane <- data.frame(id = 1:N, Y, klasa_prawdziwa)
write.csv(dane, "trajektorie-dane.csv", row.names = FALSE, na = "")
round(colMeans(Y, na.rm = TRUE), 2); colSums(is.na(Y))

# LCGA = skończona mieszanina regresji trajektorii bez efektów losowych (Nagin, 1999):
# w klasie k:  y_it ~ N(b0_k + b1_k * czas_t, sigma^2), pomiary niezależne w obrębie klasy, braki pomijane (MAR)
lcga_em <- function(Y, czas, K, starty = 30, maxit = 500, tol = 1e-8) {
  obs <- !is.na(Y); X <- cbind(1, czas); N <- nrow(Y)
  logdens <- function(B, s) sapply(1:K, function(k) {
    mu <- matrix(X %*% B[, k], N, ncol(Y), byrow = TRUE)
    rowSums(dnorm(Y, mu, s, log = TRUE), na.rm = TRUE)
  })
  jeden_start <- function() {
    post <- matrix(0, N, K); post[cbind(1:N, sample(K, N, replace = TRUE))] <- 1   # losowy podział na start
    ll_old <- -Inf
    for (it in 1:maxit) {
      # krok M: udziały klas, ważona regresja w każdej klasie, wspólna wariancja reszt
      pi_k <- colMeans(post)
      B <- sapply(1:K, function(k) {
        w <- post[, k] * obs                                  # waga osoby × dostępny pomiar
        XtW <- t(X) %*% diag(colSums(w)) %*% X
        Xty <- t(X) %*% colSums(w * ifelse(obs, Y, 0))
        solve(XtW, Xty)
      })
      res2 <- sapply(1:K, function(k) sum(post[, k] * rowSums((Y - matrix(X %*% B[, k], N, ncol(Y), byrow = TRUE))^2, na.rm = TRUE)))
      s <- sqrt(sum(res2) / sum(obs))
      # krok E: prawdopodobieństwa a posteriori
      lj <- sweep(logdens(B, s), 2, log(pi_k), "+")
      m <- apply(lj, 1, max); ll <- sum(m + log(rowSums(exp(lj - m))))
      post <- exp(lj - m); post <- post / rowSums(post)
      if (ll - ll_old < tol) break
      ll_old <- ll
    }
    list(ll = ll, pi = colMeans(post), B = B, sigma = s, post = post, iter = it)
  }
  fits <- replicate(starty, jeden_start(), simplify = FALSE)
  lls <- sapply(fits, `[[`, "ll"); best <- fits[[which.max(lls)]]
  o <- order(best$B[1, ] + best$B[2, ])                       # klasy uporządkowane wg średniego poziomu
  best$B <- best$B[, o, drop = FALSE]; best$pi <- best$pi[o]; best$post <- best$post[, o, drop = FALSE]
  p <- 3 * K                                                 # 2K współczynników + sigma + (K − 1) udziałów
  ent <- if (K == 1) NA else 1 - sum(-best$post * log(pmax(best$post, 1e-300))) / (N * log(K))
  c(best, list(K = K, npar = p, BIC = -2 * best$ll + p * log(N), entropia = ent,
               replikacja = sum(abs(lls - max(lls)) < 0.01), starty = starty))
}

# Modele z 1–5 klasami, każdy z 30 losowych startów
lcga <- lapply(1:5, function(K) lcga_em(Y, czas, K))
tab <- t(sapply(lcga, function(f) c(K = f$K, logL = round(f$ll, 2), npar = f$npar, BIC = round(f$BIC, 2),
                                    entropia = round(f$entropia, 3), najmniejsza_proc = round(100 * min(f$pi), 1),
                                    replikacja = f$replikacja)))
print(as.data.frame(tab), row.names = FALSE)

# Różnice BIC między kolejnymi modelami (ujemna = model z większą liczbą klas lepszy)
round(diff(tab[, "BIC"]), 2)

# Szczegóły modeli z 3 i 5 klasami: trajektorie (wyraz wolny = poziom w wieku 12 lat, nachylenie = zmiana na rok),
# udziały, liczebności według największego prawdopodobieństwa a posteriori i średnie prawdopodobieństwo przynależności (AvePP)
opis_klas <- function(f) {
  kl <- max.col(f$post)
  round(rbind(wyraz_wolny = f$B[1, ], nachylenie = f$B[2, ], udzial = f$pi, n = tabulate(kl, f$K),
              AvePP = sapply(1:f$K, function(k) mean(f$post[kl == k, k]))), 3)
}
opis_klas(lcga[[3]]); round(lcga[[3]]$sigma, 2)
opis_klas(lcga[[5]])
klasa_lcga <- max.col(lcga[[3]]$post)
table(LCGA_3 = klasa_lcga, prawdziwa = dane$klasa_prawdziwa)
table(LCGA_5 = max.col(lcga[[5]]$post), prawdziwa = dane$klasa_prawdziwa)
Wynik w R
  w1   w2   w3   w4   w5
8.28 8.74 8.88 9.47 9.69
w1 w2 w3 w4 w5
 0 19 46 47 57
 K     logL npar      BIC entropia najmniejsza_proc replikacja
 1 -5383.63    3 10785.23       NA            100.0         30
 2 -5150.16    6 10336.27    0.858             38.8         30
 3 -4803.78    9  9661.48    0.958             16.2         30
 4 -4780.20   12  9632.30    0.808             15.9         29
 5 -4766.93   15  9623.73    0.787             10.6         16
[1] -448.96 -674.79  -29.18   -8.57
               [,1]   [,2]   [,3]
wyraz_wolny   6.202  7.018 17.890
nachylenie    0.213  2.586 -2.424
udzial        0.595  0.243  0.162
n           239.000 96.000 65.000
AvePP         0.983  0.972  0.986
[1] 2.74
              [,1]    [,2]   [,3]   [,4]   [,5]
wyraz_wolny  4.900   7.035  5.718  7.841 17.973
nachylenie   0.135   0.223  2.490  2.684 -2.448
udzial       0.218   0.378  0.106  0.139  0.159
n           82.000 159.000 40.000 56.000 63.000
AvePP        0.802   0.833  0.784  0.865  1.000
      prawdziwa
LCGA_3   1   2   3
     1 233   5   1
     2   4  92   0
     3   1   0  64
      prawdziwa
LCGA_5   1   2   3
     1  82   0   0
     2 154   3   2
     3   2  38   0
     4   0  56   0
     5   0   0  63
2. Podejście dwuetapowe: OLS osób i mclust
R
# Podejście dwuetapowe: (1) osobna regresja liniowa dla każdej osoby, (2) mclust na parach (wyraz wolny, nachylenie)
# Wymaga obiektów Y, czas, dane, lcga i klasa_lcga z przepisu 1
suppressPackageStartupMessages(library(mclust))
ols <- t(apply(Y, 1, function(y) { ok <- !is.na(y)
  if (sum(ok) >= 3) coef(lm(y[ok] ~ czas[ok])) else c(NA, NA) }))   # co najmniej 3 pomiary
colnames(ols) <- c("wyraz_wolny", "nachylenie")
pelne <- complete.cases(ols); sum(!pelne)                      # osoby wykluczone (mniej niż 3 pomiary)
round(apply(ols[pelne, ], 2, function(x) c(M = mean(x), SD = sd(x))), 2)

mc <- Mclust(ols[pelne, ], G = 1:5)                            # 14 parametryzacji kowariancji × 1–5 skupień
summary(mc)                                                    # model i liczba skupień o najwyższym BIC
round(apply(mc$BIC, 1, max, na.rm = TRUE), 2)                  # najlepszy BIC dla każdej liczby skupień (więcej = lepiej)
round(mc$parameters$mean, 2)                                   # średnie skupień: wyraz wolny i nachylenie

# Zgodność podziałów: skorygowany indeks Randa (1 = identyczne, 0 = przypadkowe)
prawda <- dane$klasa_prawdziwa[pelne]
round(c(LCGA3_prawda = adjustedRandIndex(klasa_lcga[pelne], prawda),
        mclust_wybrany_prawda = adjustedRandIndex(mc$classification, prawda),
        LCGA3_mclust = adjustedRandIndex(klasa_lcga[pelne], mc$classification)), 3)
# Odsetek osób przypisanych do prawdziwej trajektorii (numeracja klas i skupień zgadza się tu z symulacją – sprawdź tabelą)
round(c(LCGA3 = 100 * mean(klasa_lcga == dane$klasa_prawdziwa), mclust = 100 * mean(mc$classification == prawda)), 1)
Wynik w R
[1] 3
   wyraz_wolny nachylenie
M         8.34       0.33
SD        4.81       1.84
----------------------------------------------------
Gaussian finite mixture model fitted by EM algorithm
----------------------------------------------------

Mclust EEE (ellipsoidal, equal volume, shape and orientation) model with 3
components:

 log-likelihood   n df       BIC      ICL
      -1649.865 397 11 -3365.553 -3384.96

Clustering table:
  1   2   3
241  93  63
       1        2        3        4        5
-3725.57 -3467.29 -3365.55 -3383.23 -3390.45
            [,1] [,2]  [,3]
wyraz_wolny 6.33 6.86 17.96
nachylenie  0.19 2.68 -2.48
         LCGA3_prawda mclust_wybrany_prawda          LCGA3_mclust
                0.910                 0.918                 0.942
 LCGA3 mclust
  97.2   97.5
3. LCGA i GMM w pakiecie lcmm (wymaga pakietu lcmm, niewykonany)
R
# Wymaga pakietu lcmm – kod NIEWYKONANY (pakietu nie było w naszym środowisku), dlatego na stronie nie ma jego wyników
library(lcmm)
# Format długi: jeden wiersz = jeden pomiar osoby (obiekt dane z przepisu 1)
dlugie <- reshape(dane[, c("id", paste0("w", 1:5))], direction = "long", varying = paste0("w", 1:5),
                  v.names = "objawy", timevar = "czas", times = 0:4, idvar = "id")
dlugie <- dlugie[order(dlugie$id, dlugie$czas), ]

# LCGA: bez efektów losowych (w hlme domyślnie random = ~ -1)
lcga1 <- hlme(objawy ~ czas, subject = "id", ng = 1, data = dlugie)
lcga3 <- gridsearch(hlme(objawy ~ czas, mixture = ~ czas, subject = "id", ng = 3, data = dlugie),
                    rep = 50, maxiter = 30, minit = lcga1)

# GMM: losowy wyraz wolny i nachylenie w klasach; nwg = TRUE – macierz efektów losowych
# przemnożona w każdej klasie przez własny współczynnik proporcjonalności
gmm1 <- hlme(objawy ~ czas, random = ~ 1 + czas, subject = "id", ng = 1, data = dlugie)
gmm2 <- gridsearch(hlme(objawy ~ czas, mixture = ~ czas, random = ~ 1 + czas, subject = "id",
                        ng = 2, nwg = TRUE, data = dlugie), rep = 50, maxiter = 30, minit = gmm1)
gmm3 <- gridsearch(hlme(objawy ~ czas, mixture = ~ czas, random = ~ 1 + czas, subject = "id",
                        ng = 3, nwg = TRUE, data = dlugie), rep = 50, maxiter = 30, minit = gmm1)

summarytable(lcga1, lcga3, gmm1, gmm2, gmm3, which = c("G", "loglik", "npm", "BIC", "entropy", "%class"))
postprob(gmm3)   # liczebności klas i średnie prawdopodobieństwa a posteriori (AvePP)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1 i 2 w R 4.5.3 (podstawowe funkcje R i pakiet mclust); rysunki przygotowano w pakiecie ggplot2. Przepis 3 nie był uruchamiany.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mclust (wersja 6.1.2): Scrucca, L., Fraley, C., Murphy, T. B., & Raftery, A. E. (2023). Model-based clustering, classification, and density estimation using mclust in R. Chapman and Hall/CRC. https://doi.org/10.1201/9781003277965
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Liczba klas tylko według minimum BIC albo tylko według entropii. Patrz na spadek BIC, replikację, wielkość klas, AvePP i treść trajektorii.
- LCGA bez sprawdzenia GMM. Równoległe klasy różniące się tylko poziomem to sygnał, że osoby w klasie się różnią.
- Jeden start algorytmu. Rozwiązanie, które nie powtarza się w kilku startach, może być maksimum lokalnym.
- Klasy jako „typy” ludzi. Klasy mogą wynikać ze skośnego rozkładu albo z ciągłej zmienności (Bauer i Curran, 2003).
- Analiza przypisanej klasy jak zmiennej obserwowanej bez uwzględnienia niepewności przydziału. Poprawki trzykrokowe opisuje poradnik o LCA.
- Brak wykresu trajektorii na tle danych i brak tabeli wszystkich porównanych modeli.
Najczęstsze pytania
Ile osób potrzeba do analizy trajektorii LCGA lub GMM?
Nie ma jednej reguły. Nylund i in. (2007) badali w symulacjach próby od 200 do 1000 osób, a Tein i in. (2013) pokazali dla profili latentnych, że moc wykrycia właściwej liczby klas zależy przede wszystkim od separacji klas, a także od liczby wskaźników i liczebności. Planuj próbę z myślą o najmniejszej spodziewanej klasie, a nie o całości.
Czy entropia pozwala wybrać liczbę klas trajektorii?
Nie samodzielnie. Entropia mówi, jak pewnie model przydziela osoby do klas. Tein i in. (2013) wykazali, że słabo wskazuje właściwą liczbę klas. Ram i Grimm (2009) proponują ją jako kryterium pomocnicze, gdy modele mają podobne BIC. W przykładzie entropia była najwyższa przy trzech klasach (.958), choć BIC malał do pięciu.
Czy LCGA można policzyć bez programu Mplus?
Tak. W R LCGA i GMM szacuje funkcja hlme() z pakietu lcmm, a LCGA da się też zapisać jako skończoną mieszaninę regresji i oszacować własnym algorytmem EM, jak w tym poradniku. W opisie metody podaj program, wersję, liczbę startów i powtarzalność najlepszego rozwiązania.
Co to jest lista GRoLTS?
To wytyczne raportowania badań trajektorii latentnych (LCGA i GMM), opracowane przez van de Schoota i in. (2017) w czterorundowym badaniu delfickim z ekspertami. Wskazują, co podać w artykule, by czytelnik mógł ocenić decyzje modelowe. Przed wysłaniem tekstu porównaj go z oryginalną listą.
Czy klasy trajektorii oznaczają, że w populacji istnieją odrębne typy osób?
Niekoniecznie. Bauer i Curran (2003) pokazali, że przy nienormalnym rozkładzie pomiarów model mieszanin wzrostu może wskazać kilka klas, choć populacja jest jednorodna. LCGA dodaje też klasy, gdy osoby w obrębie trajektorii różnią się poziomem. Traktuj klasy jako użyteczny opis zróżnicowania, a nie dowód istnienia typów.
Powiązane hasła
Przeczytaj też
Krzywe wzrostu (LGM) i modele zmiany
Krzywa wzrostu w lavaan na danych do pobrania: kształt zmiany, ujemna wariancja, kodowanie czasu, predyktor tempa, porównanie z lme4 i tabele APA.
Czytaj →PoradnikModele wzrostu w lme4
Losowy wyraz wolny i nachylenie czasu, kodowanie czasu, nieregularne terminy, predyktor × czas, braki MAR, porównanie z LGM i wzór opisu APA.
Czytaj →PoradnikAnaliza klas latentnych (LCA) krok po kroku
Wiele startów EM, BIC i BLRT, lokalna niezależność, profile i entropia, poprawka BCH dla zmiennych zewnętrznych i opis APA – z kodem R.
Czytaj →Analizujesz trajektorie w doktoracie albo artykule?
Pomożemy dobrać model (LCGA czy GMM), uzasadnić liczbę klas, przygotować tabele i wykresy zgodne z GRoLTS oraz odpowiedzieć recenzentom, tak żebyś mógł(a) samodzielnie obronić każdą decyzję.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bauer, D. J., & Curran, P. J. (2003). Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes. Psychological Methods, 8(3), 338–363. https://doi.org/10.1037/1082-989X.8.3.338
- Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B (Methodological), 39(1), 1–22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x ● Otwarty dostęp: pełny tekst
- Jung, T., & Wickrama, K. A. S. (2008). An introduction to latent class growth analysis and growth mixture modeling. Social and Personality Psychology Compass, 2(1), 302–317. https://doi.org/10.1111/j.1751-9004.2007.00054.x
- Muthén, B., & Shedden, K. (1999). Finite mixture modeling with mixture outcomes using the EM algorithm. Biometrics, 55(2), 463–469. https://doi.org/10.1111/j.0006-341x.1999.00463.x
- Nagin, D. S. (1999). Analyzing developmental trajectories: A semiparametric, group-based approach. Psychological Methods, 4(2), 139–157. https://doi.org/10.1037/1082-989x.4.2.139
- Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling: A Multidisciplinary Journal, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
- Ram, N., & Grimm, K. J. (2009). Methods and measures: Growth mixture modeling: A method for identifying differences in longitudinal change among unobserved groups. International Journal of Behavioral Development, 33(6), 565–576. https://doi.org/10.1177/0165025409343765 ● Otwarty dostęp: pełny tekst
- Scrucca, L., Fop, M., Murphy, T. B., & Raftery, A. E. (2016). mclust 5: Clustering, classification and density estimation using Gaussian finite mixture models. The R Journal, 8(1), 289–317. https://doi.org/10.32614/RJ-2016-021 ● Otwarty dostęp
- Tein, J.-Y., Coxe, S., & Cham, H. (2013). Statistical power to detect the correct number of classes in latent profile analysis. Structural Equation Modeling: A Multidisciplinary Journal, 20(4), 640–657. https://doi.org/10.1080/10705511.2013.824781 ● Otwarty dostęp: pełny tekst
- van de Schoot, R., Sijbrandij, M., Winter, S. D., Depaoli, S., & Vermunt, J. K. (2017). The GRoLTS-Checklist: Guidelines for Reporting on Latent Trajectory Studies. Structural Equation Modeling: A Multidisciplinary Journal, 24(3), 451–467. https://doi.org/10.1080/10705511.2016.1247646 ● Otwarty dostęp
Cytowania BibTeX
@article{bauer2003distributional, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={338--363}, doi={10.1037/1082-989x.8.3.338}}@article{dempster1977maximum, author={Dempster, A. P. and Laird, N. M. and Rubin, D. B.}, title={{Maximum likelihood from incomplete data via the EM algorithm}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1977}, volume={39}, number={1}, pages={1--22}, doi={10.1111/j.2517-6161.1977.tb01600.x}}@article{jung2008introduction, author={Jung, Tony and Wickrama, K. A. S.}, title={{An introduction to latent class growth analysis and growth mixture modeling}}, journal={Social and Personality Psychology Compass}, year={2008}, volume={2}, number={1}, pages={302--317}, doi={10.1111/j.1751-9004.2007.00054.x}}@article{muthen1999finite, author={Muthén, Bengt and Shedden, Kerby}, title={{Finite mixture modeling with mixture outcomes using the EM algorithm}}, journal={Biometrics}, year={1999}, volume={55}, number={2}, pages={463--469}, doi={10.1111/j.0006-341x.1999.00463.x}}@article{nagin1999analyzing, author={Nagin, Daniel S.}, title={{Analyzing developmental trajectories: A semiparametric, group-based approach}}, journal={Psychological Methods}, year={1999}, volume={4}, number={2}, pages={139--157}, doi={10.1037/1082-989x.4.2.139}}@article{nylund2007deciding, author={Nylund, Karen L. and Asparouhov, Tihomir and Muthén, Bengt O.}, title={{Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={4}, pages={535--569}, doi={10.1080/10705510701575396}}@article{ram2009methods, author={Ram, Nilam and Grimm, Kevin J.}, title={{Methods and measures: Growth mixture modeling: A method for identifying differences in longitudinal change among unobserved groups}}, journal={International Journal of Behavioral Development}, year={2009}, volume={33}, number={6}, pages={565--576}, doi={10.1177/0165025409343765}}@article{scrucca2016mclust, author={Scrucca, Luca and Fop, Michael and Murphy, T. Brendan and Raftery, Adrian E.}, title={{mclust 5: Clustering, classification and density estimation using Gaussian finite mixture models}}, journal={The R Journal}, year={2016}, volume={8}, number={1}, pages={289--317}, doi={10.32614/rj-2016-021}}@article{tein2013statistical, author={Tein, Jenn-Yun and Coxe, Stefany and Cham, Heining}, title={{Statistical power to detect the correct number of classes in latent profile analysis}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2013}, volume={20}, number={4}, pages={640--657}, doi={10.1080/10705511.2013.824781}}@article{vandeschoot2017grolts, author={van de Schoot, Rens and Sijbrandij, Marit and Winter, Sonja D. and Depaoli, Sarah and Vermunt, Jeroen K.}, title={{The GRoLTS-Checklist: Guidelines for Reporting on Latent Trajectory Studies}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2017}, volume={24}, number={3}, pages={451--467}, doi={10.1080/10705511.2016.1247646}}