Po co plan zarządzania danymi
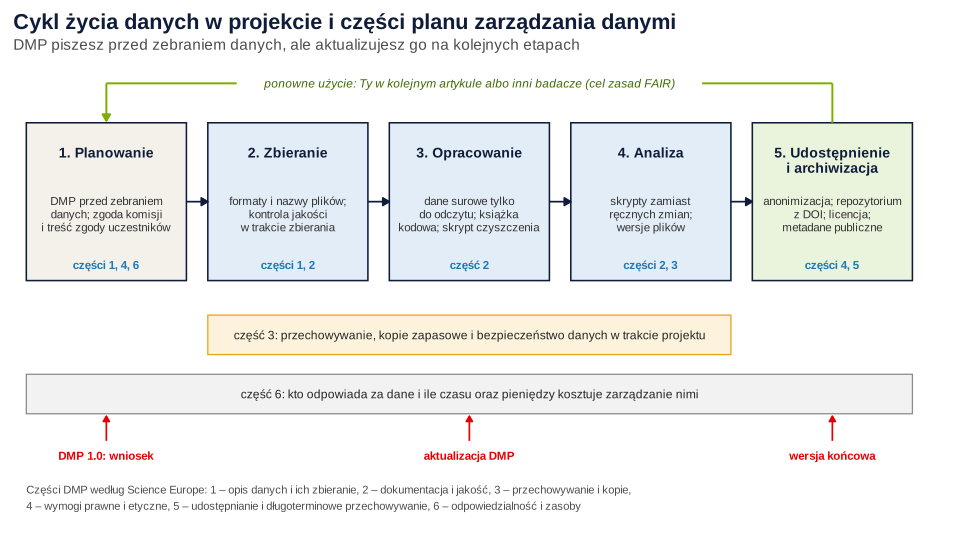
Plan zarządzania danymi (ang. data management plan, DMP) to krótki dokument, w którym przed zebraniem danych zapisujesz, jakie dane powstaną, jak je opiszesz, gdzie będą przechowywane, kto ma do nich dostęp i co się z nimi stanie po zakończeniu projektu. Wymaga go coraz więcej grantodawców, ale najwięcej zyskuje autor: decyzji o formatach i treści zgody uczestników nie zmienisz po zebraniu danych.
DMP nie zastępuje dwóch innych dokumentów, które opisujemy osobno. Plan analiz do wniosku grantowego mówi, jak przetestujesz hipotezy i dlaczego wystarczy Ci próba. Pakiet replikacyjny to gotowy zestaw danych, kodu i README dołączany do artykułu. DMP planuje, jak dane mają powstać, żeby pakiet dało się potem złożyć w kilka godzin.
Przykładem będzie projekt, w którym zespół zbiera ankietę online w trzech falach (około 600 pielęgniarek i pielęgniarzy) i prowadzi 20 nagrywanych wywiadów pogłębionych.
Sześć części DMP według Science Europe
Science Europe, stowarzyszenie europejskich organizacji finansujących i wykonujących badania, opublikowało wspólny zestaw wymagań podstawowych dla DMP, żeby ograniczyć mnogość formularzy. Szablon wymienia sześć tematów, które musi obejmować każdy DMP. Kolejność można zmieniać, ale żadnego tematu nie wolno pominąć (Science Europe, 2021; odczyt oficjalnej strony i szablonu 29 października 2026 r.). Poniżej streszczamy pytania przewodnie i pokazujemy, co wpisać w projekcie z przykładu.
| Część DMP | O co pytają wytyczne (streszczenie) | Przykład: ankieta w trzech falach i wywiady |
|---|---|---|
| 1. Opis danych i ich zbieranie lub ponowne użycie | Jak powstaną nowe dane albo skąd pochodzą istniejące; jakie rodzaje, formaty i objętość | Odpowiedzi z ankiety (CSV, około 2 MB na falę), nagrania audio (około 20 godzin), transkrypcje (DOCX → TXT) |
| 2. Dokumentacja i jakość danych | Jakie metadane i dokumentacja towarzyszą danym; jak kontrolujesz jakość | Książka kodowa, README, protokół transkrypcji, pytania kontrolne uwagi, reguły czyszczenia w skrypcie |
| 3. Przechowywanie i kopie zapasowe w trakcie badań | Gdzie i jak przechowujesz dane oraz metadane; jak chronisz dane wrażliwe | Uczelniany dysk sieciowy z kopią automatyczną; nagrania zaszyfrowane; klucz pseudonimizacji w osobnym miejscu |
| 4. Wymogi prawne i etyczne, kodeksy postępowania | Ochrona danych osobowych, prawa autorskie i własność danych, kwestie etyczne | Zgoda komisji etycznej; zgoda uczestników obejmuje udostępnienie zanonimizowanych danych; inspektor ochrony danych uczelni |
| 5. Udostępnianie i długoterminowe przechowywanie | Jak i kiedy udostępnisz dane, jakie są ograniczenia, gdzie trafią na dłużej, jakie narzędzia są potrzebne, czy zbiór dostanie trwały identyfikator (np. DOI) | Ankieta: repozytorium z DOI po publikacji głównego artykułu; wywiady: tylko metadane i przewodnik do wywiadu, transkrypcje z dostępem kontrolowanym albo bez udostępnienia |
| 6. Odpowiedzialność i zasoby | Kto odpowiada za dane; ile czasu i pieniędzy kosztuje zarządzanie nimi i doprowadzenie ich do stanu FAIR | Kierowniczka projektu odpowiada za DMP, doktorant prowadzi książkę kodową; w kosztorysie godziny na anonimizację transkrypcji |
Michener (2015) radzi traktować DMP jak dokument żywy: wracać do niego regularnie, wyznaczyć osobę, która go aktualizuje, i prowadzić historię zmian. Zaleca też co najmniej trzy kopie danych w dwóch odległych miejscach i sprawdzanie, czy kopię da się odtworzyć.
Zasady FAIR w praktyce
Zasady FAIR sformułowała w 2016 r. grupa przedstawicieli uczelni, przemysłu, grantodawców i wydawców (Wilkinson i in., 2016). Dane mają być łatwe do znalezienia (Findable), dostępne (Accessible), interoperacyjne (Interoperable) i nadające się do ponownego użycia (Reusable). Autorzy kładą nacisk na to, żeby dane mogły odnaleźć i wykorzystać także maszyny, a nie tylko ludzie. W tabeli przekładamy szczegółowe zasady na decyzje w projekcie.
| Litera | Co mówią zasady | Co to znaczy w Twoim projekcie |
|---|---|---|
| F – Findable | Globalnie unikalny i trwały identyfikator; bogate metadane; indeksowanie w przeszukiwalnym zasobie | Zbiór w repozytorium, które nadaje DOI; opis ze słowami kluczowymi, autorami i ORCID |
| A – Accessible | Dostęp przez standardowy protokół, który w razie potrzeby pozwala na uwierzytelnienie; metadane dostępne także wtedy, gdy danych już nie ma | Strona zbioru działa bez logowania, nawet gdy same pliki wymagają wniosku o dostęp |
| I – Interoperable | Formalny, wspólny język opisu; słowniki zgodne z FAIR; odwołania do innych danych | Otwarte formaty (CSV w UTF-8 zamiast pliku z programu komercyjnego); kody braków i nazwy skal opisane w książce kodowej |
| R – Reusable | Bogaty opis, jasna licencja, pochodzenie danych, standardy dziedzinowe | Licencja w pliku LICENSE, skrypt od danych surowych do analitycznych, odwołanie do użytych kwestionariuszy |
Najczęstsze nieporozumienie brzmi: „FAIR znaczy otwarte”. Tak nie jest. Zasada A1.2 dopuszcza uwierzytelnianie i autoryzację tam, gdzie to konieczne, a zasada A2 wymaga, żeby metadane były dostępne nawet wtedy, gdy dane przestały być dostępne (Wilkinson i in., 2016). Transkrypcje wywiadów z przykładu mogą więc być „FAIR” bez publikowania ich w całości: opis zbioru i DOI są publiczne, a pliki dostaje tylko osoba, która spełni warunki dostępu. Różnicę między danymi FAIR a otwartymi danymi zaznacz w DMP wprost.
Ostatnia litera jest najtrudniejsza. Hardwicke i in. (2018) sprawdzili artykuły w czasopiśmie, które wprowadziło obowiązek udostępniania danych. Odsetek artykułów z danymi nadającymi się do ponownego użycia wzrósł z 22% do 62%. Mimo to części wyników nie udało się odtworzyć bez pomocy autorów. Udostępnienie pliku to dopiero połowa pracy.
Książka kodowa jako metadane
W badaniach ilościowych najważniejszym elementem metadanych jest książka kodowa: dla każdej zmiennej nazwa, etykieta, treść pytania, wartości i ich znaczenie, kody braków danych oraz informacja, które pozycje są odwrócone. Arslan (2019) pokazuje, że książkę kodową można generować automatycznie z danych i etykiet. Powstaje wtedy dokument czytelny zarówno dla ludzi, jak i dla maszyn, z opisem skal, rzetelności i wzorców braków.
Obok książki kodowej w części 2 planu opisz:
- README projektu – co jest w którym folderze, skąd pochodzą dane, jak je cytować;
- pochodzenie danych (zasada R1.2) – skrypt, który z danych surowych tworzy plik analityczny, łącznie z regułami z czyszczenia danych z ankiety online;
- strukturę plików – np. osobny wiersz na osobę i falę (format długi) i stały identyfikator uczestnika we wszystkich falach;
- kontrolę jakości – pytania kontrolne uwagi, sprawdzanie zakresów, podwójne kodowanie części transkrypcji.
Wilson i in. (2017) zalecają, żeby dane surowe przechowywać bez zmian i tylko do odczytu, a każdą zmianę robić skryptem. Wpisz tę regułę do DMP jako zasadę zespołu.
Gdzie przechowywać i gdzie udostępnić dane
W DMP rozdziel dwa miejsca. W trakcie projektu dane leżą w bezpiecznym magazynie roboczym, zwykle na infrastrukturze uczelni z kopią zapasową i kontrolą dostępu. Po zakończeniu projektu dane trafiają do repozytorium, które zapewnia trwały identyfikator i długoterminowe przechowywanie. Przewodnik Science Europe zawiera też kryteria wyboru repozytoriów godnych zaufania (Science Europe, 2021).
Repozytoria możesz podzielić na trzy grupy:
- dziedzinowe – prowadzone dla jednej dyscypliny lub rodzaju danych, np. archiwa danych społecznych; mają najlepsze standardy metadanych;
- uczelniane i krajowe – prowadzone przez uczelnię lub konsorcjum; zwykle ze wsparciem specjalistów od danych;
- ogólne – przyjmują dane z każdej dziedziny i nadają DOI; dobre, gdy nie ma repozytorium dziedzinowego, ale opis zbioru zależy w całości od Ciebie.
Przy wyborze sprawdź cztery rzeczy: czy repozytorium nadaje DOI, czy deklaruje długoterminowe przechowywanie, czy obsługuje dostęp kontrolowany (ważne dla danych jakościowych) i czy wymagane przez grantodawcę repozytorium nie jest wskazane z góry. Jak złożyć gotowy pakiet w OSF, pokazujemy krok po kroku w poradniku o pakiecie replikacyjnym (zob. też preprint, open access i ORCID).
Licencje: CC BY i CC0 w zarysie
Zasada R1.1 wymaga jasnej licencji (Wilkinson i in., 2016). Na stronie „About CC licenses” Creative Commons opisuje sześć licencji, od najbardziej do najmniej otwartej, oraz osobne narzędzie CC0 (Creative Commons, b.d.). Dla danych badawczych najczęściej rozważa się dwie możliwości:
- CC BY – inni mogą kopiować, zmieniać i wykorzystywać dane, także komercyjnie, pod warunkiem uznania autorstwa;
- CC0 – nie jest licencją, tylko zrzeczeniem się praw w zakresie, w jakim pozwala na to prawo; cytowanie pozostaje dobrym zwyczajem naukowym, a nie warunkiem prawnym (FAQ Creative Commons, b.d.).
Według FAQ Creative Commons licencje w wersji 4.0 obejmują także prawa do baz danych, a warianty „tylko niekomercyjnie” (NC) i „bez utworów zależnych” (ND) nie są zalecane dla baz danych przeznaczonych do użytku naukowego. To samo FAQ przypomina, że licencje CC dotyczą praw autorskich, a nie prywatności ani etyki badań. Licencja nie zastąpi więc anonimizacji ani zgody uczestników. To ogólny opis, a nie porada prawna. Ostateczny wybór uzgodnij z działem prawnym lub specjalistą od danych na uczelni i z warunkami grantodawcy. Licencje z perspektywy osoby korzystającej z cudzych danych omawiamy we wpisie o reanalizie i wtórnej analizie danych.
Anonimizacja przed udostępnieniem
Zanim zdecydujesz, co udostępnisz, ustal, co wolno udostępnić. Zasady usuwania identyfikatorów bezpośrednich i pośrednich opisuje hasło anonimizacja i pseudonimizacja danych, a obowiązki wobec uczestników – hasło świadoma zgoda i RODO w badaniach. W DMP zapisz co najmniej trzy decyzje:
- treść zgody – czy uczestnicy zgadzają się na udostępnienie zanonimizowanych danych innym badaczom; zgody nie da się rozszerzyć po fakcie, więc to decyzja z etapu planowania i wniosku do komisji etycznej;
- pseudonimizacja w trakcie projektu – identyfikator uczestnika zamiast nazwiska lub adresu e-mail, a klucz łączący oba przechowywany oddzielnie i usunięty w zapisanym terminie;
- poziom dostępu – dane otwarte, dostęp kontrolowany na wniosek albo brak udostępnienia z uzasadnieniem.
W przykładzie dane z ankiety po usunięciu metryczki szczegółowej (np. dokładnego wieku zastąpionego przedziałem i nazwy szpitala) mogą trafić do repozytorium jako otwarte. Transkrypcje wywiadów z małej grupy zawodowej trudno zanonimizować bez utraty treści. Rozsądną decyzją jest dostęp kontrolowany albo udostępnienie tylko przewodnika do wywiadu i opisu kodów.
Wymagania grantodawców: co sprawdzić
Szablony DMP różnią się między grantodawcami, programami, a nawet edycjami tego samego konkursu: inne są nazwy punktów, limity objętości i moment złożenia planu (z wnioskiem albo po przyznaniu finansowania). Michener (2015) radzi zacząć od najnowszego ogłoszenia i wytycznych grantodawcy. Przed złożeniem wniosku sprawdź w aktualnych dokumentach:
- czy DMP jest częścią wniosku i czy recenzenci go oceniają;
- jaki jest limit objętości i czy obowiązuje konkretny formularz;
- czy wskazano termin udostępnienia danych i minimalny czas ich przechowywania;
- czy koszty przygotowania i przechowywania danych można wpisać do kosztorysu;
- czy plan trzeba aktualizować w trakcie projektu i w raporcie końcowym.
Jak pogodzić plan danych z resztą części empirycznej doktoratu, pokazujemy w tekście analiza statystyczna w doktoracie, a całą ścieżkę od planu badań do otwartych danych porządkuje przewodnik doktorat i publikacje.
Wzór konspektu DMP do skopiowania
Konspekt odpowiada sześciu częściom z szablonu Science Europe. Jeśli Twój grantodawca ma własny formularz, przenieś odpowiedzi do jego punktów. W nawiasach kwadratowych wpisz własne dane. Uzupełnione sekcje warto zestawić z planem analizy statystycznej i prerejestracją, żeby nazwy zmiennych i reguły wykluczeń były w obu dokumentach takie same.
1. Opis danych i ich zbieranie
– Nowe dane: [rodzaj, np. ankieta online w trzech falach, N ≈ 600; 20 wywiadów audio]. Dane istniejące: [źródło i warunki użycia albo „nie dotyczy”].
– Formaty i objętość: [CSV w UTF-8, około 6 MB; audio około 20 h; transkrypcje TXT].
2. Dokumentacja i jakość danych
– Metadane: książka kodowa (nazwa, etykieta, treść pytania, wartości, kody braków, pozycje odwrócone), README, protokół transkrypcji.
– Kontrola jakości: [pytania kontrolne uwagi, sprawdzanie zakresów, podwójne kodowanie 20% transkrypcji]. Dane surowe tylko do odczytu, zmiany wyłącznie skryptem.
3. Przechowywanie i kopie zapasowe w trakcie badań
– Miejsce: [infrastruktura uczelni] z automatyczną kopią; [liczba] kopii w [liczba] lokalizacjach; test odtworzenia co [okres].
– Bezpieczeństwo: dostęp tylko dla [role]; klucz pseudonimizacji przechowywany oddzielnie i usunięty [termin].
4. Wymogi prawne i etyczne
– Zgoda komisji etycznej: [nazwa komisji, numer, data]. Zgoda uczestników obejmuje [udostępnienie zanonimizowanych danych / tylko wyniki zbiorcze].
– Dane osobowe: [zakres, podstawa przetwarzania ustalona z inspektorem ochrony danych]. Prawa do narzędzi: [kwestionariusze objęte prawem autorskim nie są udostępniane].
5. Udostępnianie i długoterminowe przechowywanie
– Co: [zanonimizowane dane z ankiety, książka kodowa, skrypty]; czego nie udostępniamy i dlaczego: [transkrypcje – dostęp kontrolowany].
– Gdzie i kiedy: [repozytorium] z DOI, najpóźniej [moment, np. publikacja głównego artykułu]; przechowywanie przez [okres].
– Licencja: [CC BY 4.0 / CC0] dla danych, [licencja] dla kodu. Narzędzia potrzebne do użycia danych: [R, wersja].
6. Odpowiedzialność i zasoby
– Odpowiada za DMP: [imię i rola]; książkę kodową prowadzi: [rola]; aktualizacja planu: [kiedy, np. po każdej fali].
– Koszty: [godziny pracy na anonimizację i dokumentację, opłata za repozytorium lub „brak”].
Najczęstsze błędy
- „Dane dostępne na uzasadnioną prośbę”. Gabelica i in. (2022) napisali do autorów, którzy złożyli taką deklarację. Dane przekazało tylko 6.8% z nich, a 93% nie odpowiedziało albo odmówiło. Repozytorium z DOI jest pewniejsze niż skrzynka mailowa.
- DMP napisany raz, do szuflady. Plan, którego nikt nie aktualizuje, rozjeżdża się z rzeczywistością po pierwszej fali danych.
- Zgoda uczestników, która nie przewiduje udostępniania. Tego nie naprawisz po zebraniu danych.
- Utożsamianie FAIR z danymi otwartymi. Dane wrażliwe mogą mieć dostęp kontrolowany, ale metadane i DOI powinny być publiczne.
- Brak książki kodowej i README. Plik bez opisu spełnia literę „A”, ale nie spełnia litery „R”.
- Licencja wybrana bez sprawdzenia warunków grantodawcy i uczelni albo licencja NC lub ND dla danych, które mają służyć nauce.
- Brak kosztów w kosztorysie. Anonimizacja transkrypcji i opis zbioru to realne godziny pracy.
Jeśli przygotowujesz wniosek i chcesz, żeby plan danych, plan analiz i dokumentacja zbioru były ze sobą spójne, możemy przejrzeć je razem w ramach wsparcia statystycznego dla badaczy.
Najczęstsze pytania
Ile stron powinien mieć plan zarządzania danymi?
Tyle, ile dopuszcza formularz grantodawcy – limity różnią się między programami, więc sprawdź aktualne wytyczne. Bez limitu wystarczy zwykle kilka akapitów na każdą z sześciu części. Michener (2015) radzi, żeby przy ostrym limicie napisać zwięzłe streszczenie, a szczegóły (np. pełną książkę kodową) przenieść do załącznika lub dokumentacji projektu.
Kiedy napisać DMP, jeśli projekt nie ma jeszcze finansowania?
Przed zebraniem danych, najlepiej razem z wnioskiem do komisji etycznej. Wtedy ustalasz treść zgody uczestników, sposób pseudonimizacji i miejsce przechowywania danych, a tych decyzji nie da się poprawić po badaniu. Plan przyda się także później, gdy będziesz składać wniosek grantowy albo pakiet replikacyjny do artykułu.
Co wpisać w DMP, gdy danych jakościowych nie da się zanonimizować?
Napisz to wprost i uzasadnij. Możesz zaplanować dostęp kontrolowany w repozytorium, udostępnienie tylko fragmentów albo brak udostępnienia samych transkrypcji. Publicznie udostępnij przewodnik do wywiadu, opis kodów i metadane zbioru. Zasady FAIR dopuszczają ograniczony dostęp, jeśli opis danych pozostaje dostępny (Wilkinson i in., 2016).
Czy w DMP trzeba wskazać konkretne repozytorium?
Najlepiej tak, bo recenzent ocenia wykonalność planu. Podaj rodzaj repozytorium (dziedzinowe, uczelniane lub ogólne), uzasadnij wybór i sprawdź, czy nadaje DOI, zapewnia długoterminowe przechowywanie i obsługuje dostęp kontrolowany. Jeśli grantodawca wskazuje repozytorium, wybór jest przesądzony. Gdy zmienisz decyzję w trakcie projektu, zaktualizuj plan.
Kto w zespole powinien odpowiadać za plan zarządzania danymi?
Jedna wskazana osoba, zwykle kierownik projektu albo wyznaczony członek zespołu, który aktualizuje plan i pilnuje terminów. Szablon Science Europe wymaga, żeby w DMP wskazać odpowiedzialną osobę lub rolę i zasoby przeznaczone na zarządzanie danymi (Science Europe, 2021). Zadania takie jak prowadzenie książki kodowej możesz rozdzielić, ale zapisz, kto za co odpowiada.
Powiązane hasła
Przeczytaj też
Pakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikPlan analiz do wniosku grantowego
Hipotezy przypisane do modeli, symulacja mocy przy randomizacji klas, braki danych, analiza wrażliwości δ, tabela ryzyk i wzór tekstu do metodyki.
Czytaj →PoradnikDoktorat i publikacje – przewodnik
Osiem etapów od planu doktoratu do artykułu: moc i prerejestracja, cykl artykułów, raport JARS, czasopismo i preprint, recenzja oraz otwarte dane.
Czytaj →Piszesz DMP do wniosku albo przygotowujesz dane do udostępnienia?
Pomożemy uspójnić plan zarządzania danymi z planem analiz, przygotować książkę kodową i skrypty od danych surowych do wyników oraz wyjaśnić decyzje tak, żebyś mógł(a) samodzielnie obronić je przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Arslan, R. C. (2019). How to automatically document data with the codebook package to facilitate data reuse. Advances in Methods and Practices in Psychological Science, 2(2), 169–187. https://doi.org/10.1177/2515245919838783 ● Otwarty dostęp
- Creative Commons. (b.d.). About CC licenses. Pobrano 29 października 2026 z https://creativecommons.org/share-your-work/cclicenses/ ● Otwarty dostęp
- Creative Commons. (b.d.). Frequently asked questions. Pobrano 29 października 2026 z https://creativecommons.org/faq/ ● Otwarty dostęp
- Gabelica, M., Bojčić, R., & Puljak, L. (2022). Many researchers were not compliant with their published data sharing statement: A mixed-methods study. Journal of Clinical Epidemiology, 150, 33–41. https://doi.org/10.1016/j.jclinepi.2022.05.019
- Hardwicke, T. E., Mathur, M. B., MacDonald, K., Nilsonne, G., Banks, G. C., Kidwell, M. C., Hofelich Mohr, A., Clayton, E., Yoon, E. J., Henry Tessler, M., Lenne, R. L., Altman, S., Long, B., & Frank, M. C. (2018). Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition. Royal Society Open Science, 5(8), Article 180448. https://doi.org/10.1098/rsos.180448 ● Otwarty dostęp
- Michener, W. K. (2015). Ten simple rules for creating a good data management plan. PLOS Computational Biology, 11(10), Article e1004525. https://doi.org/10.1371/journal.pcbi.1004525 ● Otwarty dostęp
- Science Europe. (2021, 27 stycznia). Practical guide to the international alignment of research data management (Extended edition). https://scienceeurope.org/our-resources/practical-guide-to-the-international-alignment-of-research-data-management/ ● Otwarty dostęp
- Wilkinson, M. D., Dumontier, M., Aalbersberg, I. J., Appleton, G., Axton, M., Baak, A., Blomberg, N., Boiten, J.-W., da Silva Santos, L. B., Bourne, P. E., Bouwman, J., Brookes, A. J., Clark, T., Crosas, M., Dillo, I., Dumon, O., Edmunds, S., Evelo, C. T., Finkers, R., . . . Mons, B. (2016). The FAIR Guiding Principles for scientific data management and stewardship. Scientific Data, 3(1), Article 160018. https://doi.org/10.1038/sdata.2016.18 ● Otwarty dostęp
- Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), Article e1005510. https://doi.org/10.1371/journal.pcbi.1005510 ● Otwarty dostęp
Cytowania BibTeX
@article{arslan2019how, author={Arslan, Ruben C.}, title={{How to automatically document data with the codebook package to facilitate data reuse}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={2}, pages={169--187}, doi={10.1177/2515245919838783}}@misc{ccndlicenses, author={{Creative Commons}}, title={{About CC licenses}}, url={https://creativecommons.org/share-your-work/cclicenses/}}@misc{creativecommonsndfaq, author={{Creative Commons}}, title={{Frequently asked questions}}, url={https://creativecommons.org/faq/}}@article{gabelica2022many, author={Gabelica, Mirko and Bojčić, Ružica and Puljak, Livia}, title={{Many researchers were not compliant with their published data sharing statement: A mixed-methods study}}, journal={Journal of Clinical Epidemiology}, year={2022}, volume={150}, pages={33--41}, doi={10.1016/j.jclinepi.2022.05.019}}@article{hardwicke2018data, author={Hardwicke, Tom E. and Mathur, Maya B. and MacDonald, Kyle and Nilsonne, Gustav and Banks, George C. and Kidwell, Mallory C. and Hofelich Mohr, Alicia and Clayton, Elizabeth and Yoon, Erica J. and Henry Tessler, Michael and Lenne, Richie L. and Altman, Sara and Long, Bria and Frank, Michael C.}, title={{Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition}}, journal={Royal Society Open Science}, year={2018}, volume={5}, number={8}, eid={180448}, doi={10.1098/rsos.180448}}@article{michener2015ten, author={Michener, William K.}, title={{Ten simple rules for creating a good data management plan}}, journal={PLOS Computational Biology}, year={2015}, volume={11}, number={10}, eid={e1004525}, doi={10.1371/journal.pcbi.1004525}}@misc{scienceeurope2021practical, author={{Science Europe}}, title={{Practical guide to the international alignment of research data management (Extended edition)}}, year={2021}, url={https://scienceeurope.org/our-resources/practical-guide-to-the-international-alignment-of-research-data-management/}}@article{wilkinson2016fair, author={Wilkinson, Mark D. and Dumontier, Michel and Aalbersberg, IJsbrand Jan and Appleton, Gabrielle and Axton, Myles and Baak, Arie and Blomberg, Niklas and Boiten, Jan-Willem and da Silva Santos, Luiz Bonino and Bourne, Philip E. and Bouwman, Jildau and Brookes, Anthony J. and Clark, Tim and Crosas, Mercè and Dillo, Ingrid and Dumon, Olivier and Edmunds, Scott and Evelo, Chris T. and Finkers, Richard and Gonzalez-Beltran, Alejandra and Gray, Alasdair J.G. and Groth, Paul and Goble, Carole and Grethe, Jeffrey S. and Heringa, Jaap and ’t Hoen, Peter A.C and Hooft, Rob and Kuhn, Tobias and Kok, Ruben and Kok, Joost and Lusher, Scott J. and Martone, Maryann E. and Mons, Albert and Packer, Abel L. and Persson, Bengt and Rocca-Serra, Philippe and Roos, Marco and van Schaik, Rene and Sansone, Susanna-Assunta and Schultes, Erik and Sengstag, Thierry and Slater, Ted and Strawn, George and Swertz, Morris A. and Thompson, Mark and van der Lei, Johan and van Mulligen, Erik and Velterop, Jan and Waagmeester, Andra and Wittenburg, Peter and Wolstencroft, Katherine and Zhao, Jun and Mons, Barend}, title={{The FAIR Guiding Principles for scientific data management and stewardship}}, journal={Scientific Data}, year={2016}, volume={3}, number={1}, eid={160018}, doi={10.1038/sdata.2016.18}}@article{wilson2017good, author={Wilson, Greg and Bryan, Jennifer and Cranston, Karen and Kitzes, Justin and Nederbragt, Lex and Teal, Tracy K.}, title={{Good enough practices in scientific computing}}, journal={PLOS Computational Biology}, year={2017}, volume={13}, number={6}, eid={e1005510}, doi={10.1371/journal.pcbi.1005510}}