Po co metaanaliza sieciowa
Klasyczna metaanaliza łączy badania porównujące te same dwie interwencje. W wielu dziedzinach pytanie brzmi jednak inaczej: która z kilku dostępnych metod działa najlepiej? Badań porównujących każdą parę bezpośrednio zwykle brakuje. Większość nowych interwencji testuje się z listą oczekujących albo z placebo, a tylko część – ze sobą nawzajem. Metaanaliza sieciowa (ang. network meta-analysis, NMA) łączy w jednym modelu wszystkie porównania tworzące sieć. Dowody bezpośrednie (badania A z B) uzupełnia dowodami pośrednimi (A z C i B z C). Dla każdej pary daje spójne oszacowanie, a dla par bez badań – oszacowanie wyłącznie pośrednie (Salanti, 2012).
Najprostszy przypadek opisali Bucher i in. (1997). Jeśli dAC i dBC to zbiorcze efekty A i B wobec wspólnego komparatora C, efekt pośredni A wobec B wynosi:
Porównuje się więc efekty względne z poszczególnych badań, a nie surowe ramiona. Takie porównanie zachowuje randomizację w obrębie każdego badania. Zestawienie ramienia A z jednego badania z ramieniem B z innego jest w praktyce porównaniem obserwacyjnym i bywa obciążone (Bucher i in., 1997). Wariancje się sumują, więc pojedyncze porównanie pośrednie jest mniej precyzyjne niż bezpośrednie o tej samej liczbie badań.
Ten wpis zakłada, że znasz zwykłą metaanalizę. Wybór miary efektu, model efektów losowych i heterogeniczność omawia poradnik metaanaliza krok po kroku, efekty zależne – metaanaliza wielopoziomowa, a pojedynczą parę porównań policzysz w kalkulatorze metaanalizy. Tu skupiamy się na tym, co nowe w sieci.
Założenia: przechodniość i spójność
Dowody pośrednie są wiarygodne tylko wtedy, gdy spełnione jest założenie przechodniości (ang. transitivity). Badania różnych porównań muszą być na tyle podobne, że każdego uczestnika sieci można by wylosować do dowolnej z interwencji. Salanti (2012) przedstawia to założenie w kilku równoważnych sformułowaniach. Praktycznie sprowadza się ono do pytania o modyfikatory efektu. Jeśli badania iCBT a listy oczekujących obejmują łagodne przypadki, a badania CBT grupowej a listy oczekujących – ciężkie, porównanie pośrednie iCBT z CBT grupową jest zakłócone (Higgins i in., 2012). Komparator wspólny dla obu zbiorów badań musi też oznaczać to samo. Lista oczekujących w jednym zbiorze i „zwykła opieka” w drugim to dwa różne węzły.
Przechodniości nie da się sprawdzić testem. Ocenia się ją merytorycznie: zestawia rozkłady potencjalnych modyfikatorów efektu (wiek, nasilenie objawów, czas trwania interwencji, ryzyko błędu) w poszczególnych porównaniach. Gdy różnice są wyraźne, pomaga metaregresja (zob. metaregresja i analiza moderatorów) albo zawężenie sieci.
Statystycznym odbiciem przechodniości jest spójność (ang. consistency): dowody bezpośrednie i pośrednie o tym samym porównaniu powinny się zgadzać z dokładnością do błędu losowego. Brak zgodności nazywa się niespójnością. Higgins i in. (2012) odróżniają niespójność pętli (A–B–C) od niespójności projektu, czyli różnic między badaniami dwu- i wieloramiennymi o tych samych porównaniach.
Przykład: cztery interwencje na lęk uogólniony
Symulowany przegląd objął 17 badań randomizowanych (N = 2185) z czterema węzłami: listą oczekujących (WL), CBT grupową (CBTg), internetową CBT z przewodnikiem (iCBT) i treningiem uważności (MBI). Wynik to objawy lęku w GAD-7 po interwencji (0–21 pkt, mniej = lepiej). Wszystkie badania używają tej samej skali, więc miarą efektu jest różnica średnich (MD) w punktach. Przy różnych skalach użyłbyś standaryzowanej różnicy średnich. Dane na poziomie ramion (badanie, leczenie, n, średnia, SD; set.seed(2509)) możesz pobrać jako plik CSV.
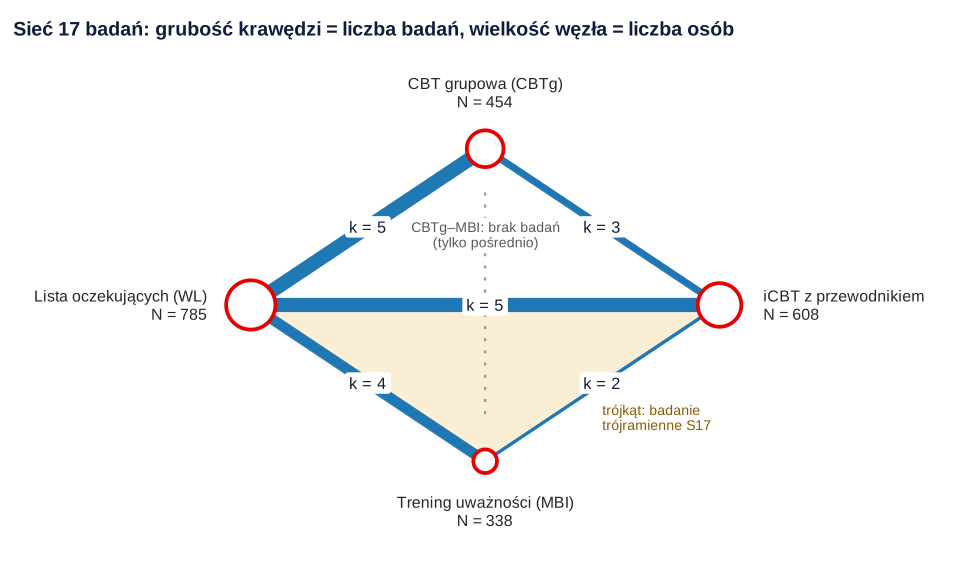
Rysunek sieci to pierwszy wynik każdej NMA. Pokazuje, które porównania mają dowody bezpośrednie, gdzie są zamknięte pętle (tylko w nich da się badać spójność) i czy jakiś węzeł wisi na jednym badaniu. Higgins i in. (2012) proponują rysunki, na których badania wieloramienne są wyraźnie zaznaczone, bo nie są zbiorem niezależnych par.
Model kontrastów w metafor::rma.mv
Każde badanie wnosi kontrasty wobec swojego pierwszego ramienia: MD i jej wariancję, czyli sumę wariancji średnich w obu ramionach. Badanie trójramienne daje dwa kontrasty (iCBT − WL i MBI − WL) ze wspólnym ramieniem WL, więc nie są one niezależne. Ich kowariancja równa się wariancji średniej w ramieniu wspólnym. W przykładzie wariancje obu kontrastów wynoszą 0.475 i 0.527, a kowariancja 0.215. Pominięcie jej liczyłoby ramię kontrolne dwa razy.
Model zapisuje każdy kontrast jako różnicę dwóch parametrów podstawowych: efektów CBTg, iCBT i MBI wobec WL. Kontrast iCBT − CBTg ma w macierzy schematu −1 przy CBTg i +1 przy iCBT. To właśnie wymusza spójność. Efekty losowe mają wspólne τ² dla wszystkich porównań i korelację 1/2 między kontrastami tego samego badania, co wynika z założenia jednakowej heterogeniczności wszystkich porównań. Taki model spójności dopasowuje się jako wielowymiarową metaregresję (White i in., 2012). W pakiecie metafor robi to funkcja rma.mv() z macierzą kowariancji V, moderatorami bez wyrazu wolnego i random = ~ porownanie | badanie (Viechtbauer, 2010).
Wyniki (REML): τ² = 0.48 (τ = 0.69 pkt), test resztowej heterogeniczności QE(15) = 25.54, p = .043 (zob. I² i τ²). Wszystkie sześć porównań odczytujesz z trzech parametrów:
| Porównanie | MD [95% CI] | p | Dowody bezpośrednie |
|---|---|---|---|
| CBTg vs WL | −3.11 [−3.94, −2.27] | < .001 | 5 badań |
| iCBT vs WL | −2.46 [−3.21, −1.71] | < .001 | 5 badań |
| MBI vs WL | −2.70 [−3.65, −1.75] | < .001 | 4 badania |
| iCBT vs CBTg | 0.65 [−0.25, 1.55] | .157 | 3 badania |
| MBI vs CBTg | 0.41 [−0.80, 1.62] | .505 | brak (tylko pośrednie) |
| MBI vs iCBT | −0.24 [−1.30, 0.82] | .657 | 2 badania |
Wszystkie interwencje zmniejszają objawy wobec listy oczekujących o 2.5–3.1 pkt. Różnice między interwencjami aktywnymi są mniejsze niż 1 pkt i niepewne: każdy z trzech przedziałów ufności obejmuje zero. W publikacji takie zestawienie podaje się zwykle jako tabelę ligową albo wykres lasu wobec wspólnego komparatora. Warto dodać przedziały predykcji, bo przy τ = 0.69 pkt efekt w nowym badaniu może się wyraźnie różnić od średniego.
Niespójność: lokalnie i globalnie
Lokalnie sprawdzasz, czy w konkretnym porównaniu dowody bezpośrednie zgadzają się z pośrednimi. Dias i in. (2010) zaproponowali w tym celu node splitting. Dowody o wybranym porównaniu dzieli się na bezpośrednie (badania tej pary) i pośrednie (reszta sieci), szacuje każdą część osobno i testuje różnicę. W wersji częstościowej dla porównania iCBT–CBTg wystarczą dwa modele: zwykła metaanaliza trzech badań CBTg–iCBT i model sieci bez tych badań. Różnicę ocenia się testem z = różnica / √(SEbezp² + SEpośr²), tak jak u Buchera i in. (1997).
| Źródło (iCBT − CBTg) | MD (SE) | 95% CI |
|---|---|---|
| Bezpośrednie (3 badania) | 0.39 (0.86) | [−1.30, 2.09] |
| Pośrednie (14 badań) | 0.84 (0.64) | [−0.42, 2.11] |
| Sieć (łącznie) | 0.65 (0.46) | [−0.25, 1.55] |
Różnica bezpośrednie − pośrednie wynosi −0.45 pkt, SE = 1.08, z = −0.42, p = .678. Zauważ, że oszacowanie z sieci jest precyzyjniejsze niż każde z osobna. To główna korzyść z NMA, ale tylko przy spójnych dowodach.
Globalnie testujesz całą sieć naraz. Higgins i in. (2012) proponują model interakcji projekt × leczenie, w którym każdy projekt (zestaw porównywanych ramion, np. WL–iCBT–MBI) ma własne efekty. W rma.mv() to model z osobnym parametrem dla każdej pary projekt–porównanie (7 zamiast 3). Oba modele dopasowujesz metodą ML i porównujesz testem ilorazu wiarygodności: χ²(4) = 5.42, p = .247.
Brak istotności nie dowodzi spójności. W przykładzie tylko dwie pętle są zamknięte, a test ma 4 stopnie swobody i małą moc. Zwróć też uwagę, że τ² w modelu niespójności spada z 0.27 do 0.02 (ML). Niespójność i heterogeniczność trudno rozdzielić, gdy na porównanie przypada kilka badań. Dlatego niespójność ocenia się łącznie z oceną przechodniości, a nie samym testem. Przy wielu porównaniach lokalnych rośnie też ryzyko fałszywych alarmów.
Ranking i SUCRA – z ostrożnością
NMA często kończy się rankingiem interwencji. Salanti i in. (2011) pokazali, jak przedstawiać prawdopodobieństwa rang i oceniać rangi łącznie. Najpopularniejszą miarą jest SUCRA (ang. surface under the cumulative ranking curve). To pole pod skumulowaną krzywą rang, od 0 (zawsze ostatnie miejsce) do 1 (zawsze pierwsze). Dla a interwencji SUCRA = Σk=1…a−1 P(ranga ≤ k) / (a − 1).
W modelu częstościowym rozkład rang uzyskasz przez losowanie. Pobierasz 10 000 wektorów parametrów z wielowymiarowego rozkładu normalnego z oszacowaniami i macierzą kowariancji modelu, w każdym losowaniu porządkujesz interwencje, a potem zliczasz rangi. Rücker i Schwarzer (2015) pokazali, że ten sam ranking daje bez losowania P-score, czyli średnia jednostronnych p. W przykładzie obie miary zgadzają się do drugiego miejsca po przecinku.
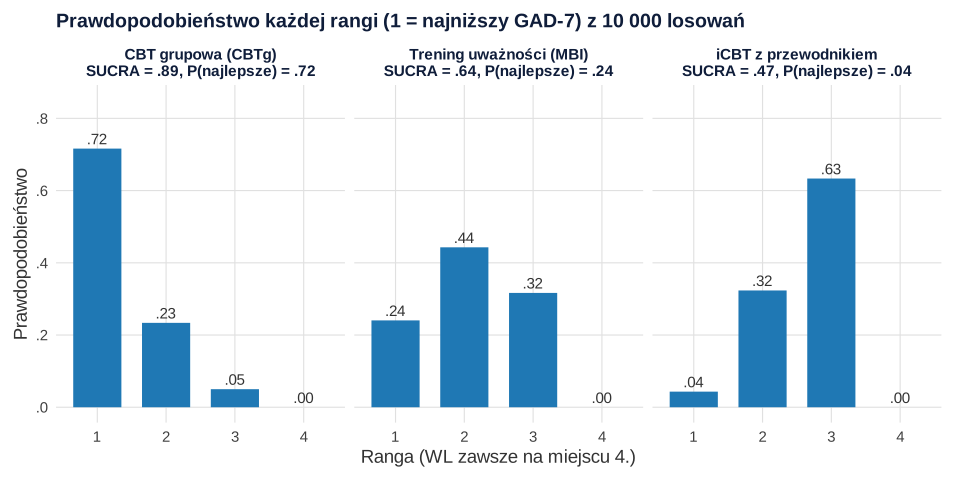
| Interwencja | MD vs WL | P(najlepsza) | Średnia ranga | SUCRA | P-score | 95% przedział rang |
|---|---|---|---|---|---|---|
| CBTg | −3.11 | .72 | 1.33 | .89 | .89 | 1–3 |
| MBI | −2.70 | .24 | 2.08 | .64 | .64 | 1–3 |
| iCBT | −2.46 | .04 | 2.59 | .47 | .47 | 1–3 |
| WL | 0 | .00 | 4.00 | .00 | .00 | 4–4 |
SUCRA CBTg = .89 wygląda jak mocny wynik, ale różnica CBTg a iCBT nie jest istotna, a CBTg a MBI wynosi 0.41 pkt z przedziałem od −0.80 do 1.62. Przedział rang każdej interwencji aktywnej obejmuje miejsca 1–3. Zwróć też uwagę na MBI: ma prawie sześć razy większą szansę na pierwsze miejsce niż iCBT, choć ich średnie różnią się o 0.24 pkt. Wynika to głównie z mniejszej precyzji: interwencja z mniejszą liczbą danych ma szerszy rozkład, więc częściej trafia na skrajne miejsca. Trinquart i in. (2016) ponownie przeanalizowali 58 sieci. W 28% z nich prawdopodobieństwo, że lider rankingu nie jest najlepszy, wynosiło co najmniej 50%. Rücker i Schwarzer (2015) dodają, że ani SUCRA, ani P-score nie mówią więcej niż przedziały ufności. Ranking podawaj zawsze razem z efektami i ich niepewnością, nigdy zamiast nich. Nie wybieraj też „zwycięzcy” wyłącznie na podstawie SUCRA. Ranking pokazuje porządek oszacowań, a nie wielkość różnic ani pewność danych.
PRISMA-NMA i opis wyników
Przegląd z metaanalizą sieciową raportuje się według rozszerzenia PRISMA-NMA. To lista 32 punktów z przykładami i objaśnieniami (Hutton i in., 2015). Ogólne zasady PRISMA 2020 znajdziesz w haśle przegląd systematyczny i PRISMA i we wpisie wytyczne raportowania. Elementy specyficzne dla sieci to:
- rysunek sieci z liczbą badań i uczestników, z zaznaczonymi badaniami wieloramiennymi;
- sposób oceny przechodniości (tabela modyfikatorów efektu według porównań);
- model (miara efektu, efekty losowe, wspólne τ², obsługa badań wieloramiennych) i oprogramowanie;
- metody oceny niespójności lokalnej i globalnej oraz ich wyniki;
- wszystkie porównania parami z CI (tabela ligowa), a ranking tylko jako dodatek, z opisem niepewności;
- ocena ryzyka błędu, małych badań i pewności dowodów (RoB 2, błąd publikacji, GRADE).
Plan sieci, czyli węzły, sposób ich łączenia i analizy niespójności, wpisz do protokołu i zarejestruj przed analizą. Decyzja, czy „zwykła opieka” i „lista oczekujących” to jeden węzeł, zmienia wyniki.
Jeśli przygotowujesz przegląd z metaanalizą sieciową do publikacji albo grantu, możemy wspólnie sprawdzić strukturę sieci, model i raport w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik metaanaliza-sieciowa-dane.csv (możesz go pobrać tutaj) i dopasowuje model sieci w pakiecie metafor. Drugi bada niespójność, trzeci liczy ranking. Czwarty powtarza analizę w pakiecie netmeta jako kontrolę.
1. Dane, kontrasty z kowariancją i model sieci
R
# Dane symulowane: 17 badań randomizowanych porównujących interwencje na lęk uogólniony u dorosłych.
# Wynik: GAD-7 po interwencji (0–21, niższy = mniej objawów). Leczenia: WL – lista oczekujących,
# CBTg – CBT grupowa, iCBT – internetowa CBT z przewodnikiem, MBI – trening uważności.
suppressPackageStartupMessages(library(metafor))
set.seed(2509)
leki <- c("WL", "CBTg", "iCBT", "MBI")
d_prawda <- c(WL = 0, CBTg = -3.5, iCBT = -3.0, MBI = -2.2)   # prawdziwe różnice średnich wobec WL
tau <- 0.8                                                     # heterogeniczność między badaniami (pkt)
projekty <- c(rep("WL-CBTg", 5), rep("WL-iCBT", 4), rep("WL-MBI", 3), rep("CBTg-iCBT", 3), "iCBT-MBI", "WL-iCBT-MBI")
ramiona <- do.call(rbind, lapply(seq_along(projekty), function(i) {
  tr <- strsplit(projekty[i], "-")[[1]]; k <- length(tr)
  S <- matrix(tau^2 / 2, k - 1, k - 1); diag(S) <- tau^2      # efekty losowe ramion, korelacja 1/2
  delta <- c(0, d_prawda[tr[-1]] - d_prawda[tr[1]] + MASS::mvrnorm(1, rep(0, k - 1), S))
  n <- sample(30:90, k, replace = TRUE); sd_r <- 4.5
  data.frame(badanie = sprintf("S%02d", i), leczenie = tr, n = n,
             srednia = round(rnorm(1, 11, 1.5) + delta + rnorm(k, 0, sd_r / sqrt(n)), 2),
             sd = round(sd_r * sqrt(rchisq(k, n - 1) / (n - 1)), 2))
}))
rownames(ramiona) <- NULL
write.csv(ramiona, "metaanaliza-sieciowa-dane.csv", row.names = FALSE)
head(ramiona, 5)

# Liczba badań i uczestników w każdym porównaniu bezpośrednim (krawędzie sieci) i w każdym węźle
table(projekt = projekty)
aggregate(n ~ leczenie, data = ramiona, FUN = sum)

# Kontrasty: każde ramię wobec pierwszego ramienia badania (MD i jej wariancja)
kontrasty <- do.call(rbind, lapply(split(ramiona, ramiona$badanie), function(b) {
  data.frame(badanie = b$badanie[1], projekt = paste(b$leczenie, collapse = "-"), od = b$leczenie[1], do = b$leczenie[-1],
             yi = b$srednia[-1] - b$srednia[1], vi = b$sd[-1]^2 / b$n[-1] + b$sd[1]^2 / b$n[1],
             v_wspolna = b$sd[1]^2 / b$n[1])
}))
rownames(kontrasty) <- NULL
kontrasty$porownanie <- paste(kontrasty$od, kontrasty$do, sep = "-")
# Macierz kowariancji: w badaniu wieloramiennym dwa kontrasty dzielą ramię odniesienia
V <- matrix(0, nrow(kontrasty), nrow(kontrasty))
for (b in unique(kontrasty$badanie)) {
  w <- which(kontrasty$badanie == b)
  V[w, w] <- kontrasty$v_wspolna[w[1]]
  diag(V)[w] <- kontrasty$vi[w]
}
# Macierz schematu: +1 dla leczenia „do”, −1 dla leczenia „od” (WL = odniesienie, bez kolumny)
X <- sapply(leki[-1], function(t) (kontrasty$do == t) - (kontrasty$od == t))
kontrasty <- cbind(kontrasty, X)
print(transform(kontrasty[13:18, c("badanie", "porownanie", "yi", "vi", "CBTg", "iCBT", "MBI")], yi = round(yi, 2), vi = round(vi, 3)), row.names = FALSE)
round(V[17:18, 17:18], 3)   # badanie trójramienne S17: kowariancja = wariancja średniej w ramieniu WL

# Model spójności: efekty losowe z jednym τ² i korelacją 1/2 między kontrastami tego samego badania
nma <- rma.mv(yi, V, mods = ~ 0 + CBTg + iCBT + MBI, random = ~ porownanie | badanie, rho = 1/2, data = kontrasty)
nma

# Wszystkie 6 porównań parami z sieci (wiersz minus kolumna)
pary <- t(combn(leki, 2))
L <- t(apply(pary, 1, function(p) (leki[-1] == p[2]) - (leki[-1] == p[1])))
wsz <- predict(nma, newmods = L)
data.frame(porownanie = paste(pary[, 2], "vs", pary[, 1]), MD = round(wsz$pred, 2),
           dolny = round(wsz$ci.lb, 2), gorny = round(wsz$ci.ub, 2),
           p = round(2 * pnorm(-abs(wsz$pred / wsz$se)), 4))
Wynik w R
  badanie leczenie  n srednia   sd
1     S01       WL 33   10.19 4.90
2     S01     CBTg 60    6.66 4.66
3     S02       WL 35   11.18 4.61
4     S02     CBTg 43    8.84 3.96
5     S03       WL 74   10.23 4.52
projekt
  CBTg-iCBT    iCBT-MBI     WL-CBTg     WL-iCBT WL-iCBT-MBI      WL-MBI
          3           1           5           4           1           3
  leczenie   n
1     CBTg 454
2     iCBT 608
3      MBI 338
4       WL 785
 badanie porownanie    yi    vi CBTg iCBT MBI
     S13  CBTg-iCBT -0.78 0.904   -1    1   0
     S14  CBTg-iCBT -0.24 0.828   -1    1   0
     S15  CBTg-iCBT  1.93 0.518   -1    1   0
     S16   iCBT-MBI  1.39 0.803    0   -1   1
     S17    WL-iCBT -2.21 0.475    0    1   0
     S17     WL-MBI -3.67 0.527    0    0   1
      [,1]  [,2]
[1,] 0.475 0.215
[2,] 0.215 0.527

Multivariate Meta-Analysis Model (k = 18; method: REML)

Variance Components:

outer factor: badanie    (nlvls = 17)
inner factor: porownanie (nlvls = 5)

            estim    sqrt  fixed
tau^2      0.4797  0.6926     no
rho        0.5000            yes

Test for Residual Heterogeneity:
QE(df = 15) = 25.5416, p-val = 0.0431

Test of Moderators (coefficients 1:3):
QM(df = 3) = 87.1632, p-val < .0001

Model Results:

      estimate      se     zval    pval    ci.lb    ci.ub
CBTg   -3.1083  0.4255  -7.3043  <.0001  -3.9423  -2.2742  ***
iCBT   -2.4567  0.3828  -6.4182  <.0001  -3.2070  -1.7065  ***
MBI    -2.6965  0.4851  -5.5581  <.0001  -3.6474  -1.7456  ***

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

    porownanie    MD dolny gorny      p
1   CBTg vs WL -3.11 -3.94 -2.27 0.0000
2   iCBT vs WL -2.46 -3.21 -1.71 0.0000
3    MBI vs WL -2.70 -3.65 -1.75 0.0000
4 iCBT vs CBTg  0.65 -0.25  1.55 0.1572
5  MBI vs CBTg  0.41 -0.80  1.62 0.5048
6  MBI vs iCBT -0.24 -1.30  0.82 0.6573
2. Niespójność: rozdzielenie dowodów i test globalny
R
# Wymaga obiektów z przepisu 1 (kontrasty, V, nma)
# 1. Rozdzielenie dowodów dla porównania CBTg–iCBT: bezpośrednie (3 badania CBTg-iCBT) a pośrednie (reszta sieci)
bezp_id <- kontrasty$projekt == "CBTg-iCBT"
bezp <- rma(yi, vi, data = kontrasty[bezp_id, ])                       # iCBT − CBTg tylko z badań bezpośrednich
posr_fit <- rma.mv(yi, V[!bezp_id, !bezp_id], mods = ~ 0 + CBTg + iCBT + MBI,
                   random = ~ porownanie | badanie, rho = 1/2, data = kontrasty[!bezp_id, ])
posr <- predict(posr_fit, newmods = c(-1, 1, 0))                       # iCBT − CBTg tylko drogą przez WL i MBI
siec <- predict(nma, newmods = c(-1, 1, 0))
roznica <- c(bezp$beta) - posr$pred
se_r <- sqrt(bezp$se^2 + posr$se^2)
data.frame(zrodlo = c("bezpośrednie", "pośrednie", "sieć (łącznie)"),
           MD = round(c(bezp$beta, posr$pred, siec$pred), 2), SE = round(c(bezp$se, posr$se, siec$se), 2),
           dolny = round(c(bezp$ci.lb, posr$ci.lb, siec$ci.lb), 2), gorny = round(c(bezp$ci.ub, posr$ci.ub, siec$ci.ub), 2))
round(c(roznica = roznica, SE = se_r, z = roznica / se_r, p = 2 * pnorm(-abs(roznica / se_r))), 3)

# 2. Globalny test: model spójności a model interakcji projekt × leczenie (każdy projekt ma własne efekty)
kontrasty$proj_por <- paste(kontrasty$projekt, kontrasty$porownanie)
spojny_ml <- rma.mv(yi, V, mods = ~ 0 + CBTg + iCBT + MBI, random = ~ porownanie | badanie, rho = 1/2,
                    data = kontrasty, method = "ML")
niespojny_ml <- rma.mv(yi, V, mods = ~ 0 + proj_por, random = ~ porownanie | badanie, rho = 1/2,
                       data = kontrasty, method = "ML")
anova(spojny_ml, niespojny_ml)
round(c(tau2_spojny = spojny_ml$tau2, tau2_niespojny = niespojny_ml$tau2), 3)
Wynik w R
          zrodlo   MD   SE dolny gorny
1   bezpośrednie 0.39 0.86 -1.30  2.09
2      pośrednie 0.84 0.64 -0.42  2.11
3 sieć (łącznie) 0.65 0.46 -0.25  1.55
roznica      SE       z       p
 -0.448   1.078  -0.416   0.678

        df     AIC     BIC    AICc   logLik    LRT   pval      QE
Full     8 61.6873 68.8102 77.6873 -22.8436               19.0681
Reduced  4 59.1060 62.6675 62.1830 -25.5530 5.4188 0.2470 25.5416

   tau2_spojny tau2_niespojny
         0.272          0.024
3. Ranking: SUCRA z losowania i P-score
R
# Wymaga obiektu nma z przepisu 1. Ranking: niższy GAD-7 = lepiej, więc najlepsze jest najbardziej ujemne MD wobec WL
set.seed(2462)
los <- MASS::mvrnorm(10000, mu = coef(nma), Sigma = vcov(nma))     # losowania z rozkładu oszacowań
los <- cbind(WL = 0, los)
rangi <- t(apply(los, 1, rank))                                     # ranga 1 = najniższy wynik GAD-7
p_rang <- sapply(colnames(los), function(t) table(factor(rangi[, t], levels = 1:4)) / nrow(rangi))
round(p_rang, 3)                                                    # wiersze: ranga 1–4, kolumny: leczenia
sucra <- apply(p_rang, 2, function(p) sum(cumsum(p)[1:3]) / 3)
srednia_ranga <- colSums(p_rang * 1:4)

# P-score (Rücker i Schwarzer, 2015): średnia z P(leczenie lepsze od każdego innego) – bez losowania
b <- c(WL = 0, coef(nma)); S <- rbind(0, cbind(0, vcov(nma))); dimnames(S) <- list(names(b), names(b))
p_score <- sapply(names(b), function(i) mean(sapply(setdiff(names(b), i), function(j)
  pnorm((b[j] - b[i]) / sqrt(S[i, i] + S[j, j] - 2 * S[i, j])))))
data.frame(leczenie = names(b), MD_vs_WL = round(b, 2), p_najlepsze = round(p_rang[1, ], 3),
           srednia_ranga = round(srednia_ranga, 2), SUCRA = round(sucra, 3), P_score = round(p_score, 3), row.names = NULL)

# Niepewność rangi: 95% przedział rang z losowań
t(apply(rangi, 2, quantile, probs = c(.025, .975)))
Wynik w R
  WL  CBTg  iCBT   MBI
1  0 0.716 0.043 0.240
2  0 0.234 0.323 0.443
3  0 0.050 0.633 0.317
4  1 0.000 0.000 0.000
  leczenie MD_vs_WL p_najlepsze srednia_ranga SUCRA P_score
1       WL     0.00       0.000          4.00 0.000   0.000
2     CBTg    -3.11       0.716          1.33 0.889   0.890
3     iCBT    -2.46       0.043          2.59 0.470   0.469
4      MBI    -2.70       0.240          2.08 0.641   0.641
     2.5% 97.5%
WL      4     4
CBTg    1     3
iCBT    1     3
MBI     1     3
4. Ta sama analiza w pakiecie netmeta
R
# Ta sama analiza w pakiecie netmeta – kontrola wyników z metafor
library(netmeta)
ramiona <- read.csv("../metaanaliza-sieciowa-dane.csv")   # plik z przepisu 1: jeden wiersz = jedno ramię badania
# Z danych ramion pakiet sam tworzy kontrasty i uwzględnia badania wieloramienne
pary <- pairwise(treat = leczenie, n = n, mean = srednia, sd = sd, studlab = badanie, data = ramiona, sm = "MD")
nm <- netmeta(pary, reference.group = "WL", common = FALSE, random = TRUE, method.tau = "REML")
# Oszacowania wobec listy oczekujących (WL) i heterogeniczność
round(cbind(MD = nm$TE.random[, "WL"], dolny = nm$lower.random[, "WL"], gorny = nm$upper.random[, "WL"]), 2)
round(c(tau2 = nm$tau2, Q = nm$Q, df = nm$df.Q, p = nm$pval.Q), 3)
netsplit(nm, legend = FALSE)                  # dowody bezpośrednie a pośrednie dla każdego porównania
decomp.design(nm)                             # Q: heterogeniczność a niespójność (projekt × leczenie)
netrank(nm, small.values = "desirable")       # P-score; niższy GAD-7 = lepiej
Wynik w R
        MD dolny gorny
CBTg -3.11 -3.94 -2.27
iCBT -2.46 -3.21 -1.71
MBI  -2.70 -3.65 -1.75
WL    0.00  0.00  0.00
  tau2      Q     df      p
 0.480 25.542 15.000  0.043
Separate indirect from direct evidence (SIDE) using back-calculation method

Random effects model:

 comparison k prop     nma  direct  indir.    Diff     z p-value
  CBTg:iCBT 3 0.53 -0.6515 -0.4768 -0.8471  0.3703  0.40  0.6881
    CBTg:WL 5 0.69 -3.1083 -3.2220 -2.8517 -0.3703 -0.40  0.6881
   iCBT:MBI 2 0.51  0.2398  0.1766  0.3044 -0.1278 -0.12  0.9059
    iCBT:WL 5 0.68 -2.4567 -2.2328 -2.9433  0.7105  0.86  0.3884
     MBI:WL 4 0.81 -2.6965 -2.9438 -1.6113 -1.3325 -1.07  0.2856

Legend:
 comparison - Treatment comparison
 k          - Number of studies providing direct evidence
 prop       - Direct evidence proportion
 nma        - Estimated treatment effect (MD) in network meta-analysis
 direct     - Estimated treatment effect (MD) derived from direct evidence
 indir.     - Estimated treatment effect (MD) derived from indirect evidence
 Diff       - Difference between direct and indirect treatment estimates
 z          - z-value of test for disagreement (direct versus indirect)
 p-value    - p-value of test for disagreement (direct versus indirect)
Q statistics to assess homogeneity / consistency

                    Q df p-value
Total           25.54 15  0.0431
Within designs  19.07 11  0.0599
Between designs  6.47  4  0.1665

Design-specific decomposition of within-designs Q statistic

    Design    Q df p-value
 CBTg:iCBT 6.37  2  0.0413
    WL:MBI 4.78  2  0.0914
   WL:CBTg 6.14  4  0.1892
   WL:iCBT 1.77  3  0.6209

Between-designs Q statistic after detaching of single designs
(influential designs have p-value markedly different from 0.1665)

 Detached design    Q df p-value
        iCBT:MBI 2.13  3  0.5450
     WL:iCBT:MBI 2.39  2  0.3023
         WL:iCBT 6.20  3  0.1021
          WL:MBI 6.36  3  0.0954
       CBTg:iCBT 6.39  3  0.0940
         WL:CBTg 6.39  3  0.0940

Q statistic to assess consistency under the assumption of
a full design-by-treatment interaction random effects model

                   Q df p-value tau.within tau2.within
Between designs 3.78  4  0.4362     0.7303      0.5333
     P-score
CBTg  0.8897
MBI   0.6412
iCBT  0.4691
WL    0.0000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (pakiet metafor, funkcje rma.mv() i rma(), oraz MASS::mvrnorm()); przepis 4 – kontrola w pakiecie netmeta; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- netmeta (wersja 3.7-0): Balduzzi, S., Rücker, G., Nikolakopoulou, A., Papakonstantinou, T., Salanti, G., Efthimiou, O., & Schwarzer, G. (2023). netmeta: An R package for network meta-analysis using frequentist methods. Journal of Statistical Software, 106(2). https://doi.org/10.18637/jss.v106.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównywanie ramion z różnych badań. Łącz kontrasty z badań, a nie surowe średnie ramion.
- Badanie wieloramienne jako kilka niezależnych par. Bez kowariancji ramię wspólne liczy się wielokrotnie, a przedziały są za wąskie.
- Brak oceny przechodniości. Nieistotny test niespójności przy kilku pętlach jej nie zastąpi.
- Węzły zdefiniowane po obejrzeniu wyników albo łączenie różnych komparatorów (lista oczekujących, zwykła opieka, placebo) w jeden węzeł bez uzasadnienia.
- Ranking zamiast efektów. SUCRA bez przedziałów ufności i bez przedziałów rang sugeruje pewność, której nie ma.
- Pominięcie oceny pewności dowodów. Porównanie wyłącznie pośrednie (tu CBTg–MBI) wymaga ostrożniejszego wniosku niż bezpośrednie.
Najczęstsze pytania
Ile badań potrzeba do metaanalizy sieciowej?
Nie ma jednej granicy. Sieć musi być połączona, czyli każda interwencja musi być powiązana z resztą choć jednym porównaniem. Badanie spójności wymaga zamkniętych pętli. Przy kilku badaniach na porównanie oszacowanie τ² jest niepewne, a testy niespójności mają małą moc (w przykładzie z 17 badaniami test globalny miał 4 stopnie swobody). Węzeł oparty na jednym badaniu traktuj jako słabe ogniwo i oceń pewność jego dowodów.
Czym różni się przechodniość od spójności w metaanalizie sieciowej?
Przechodniość to założenie merytoryczne: badania różnych porównań są podobne pod względem modyfikatorów efektu, więc porównanie pośrednie ma sens (Salanti, 2012). Spójność to jej statystyczny ślad: dowody bezpośrednie i pośrednie o tym samym porównaniu zgadzają się z dokładnością do błędu losowego. Przechodniość oceniasz, zestawiając charakterystyki badań, a spójność – testami lokalnymi i globalnymi.
Jak uwzględnić badanie trójramienne w metaanalizie sieciowej?
Wprowadź z niego dwa kontrasty wobec wspólnego ramienia i dodaj ich kowariancję, równą wariancji średniej w ramieniu wspólnym. Przy wspólnym τ² dla wszystkich porównań korelacja efektów losowych dwóch kontrastów z tego samego badania wynosi 1/2. Traktowanie trzech par jako niezależnych badań liczy wspólne ramię wielokrotnie i zawęża przedziały ufności.
Czy wysoka wartość SUCRA oznacza, że interwencja jest najlepsza?
Nie. SUCRA porządkuje oszacowania z uwzględnieniem ich precyzji, ale nie mówi, o ile jedna interwencja jest lepsza od innej, ani czy różnica jest pewna. W przykładzie CBT grupowa miała SUCRA .89, choć jej przewaga nad iCBT była nieistotna, a 95% przedział rang obejmował miejsca 1–3. Trinquart i in. (2016) pokazali, że rankingi z metaanaliz sieciowych są zwykle bardzo nieprecyzyjne.
Czy metaanalizę sieciową można zrobić bez pakietu netmeta?
Tak. Model kontrastów z efektami losowymi to wielowymiarowa metaregresja (White i in., 2012), którą dopasujesz funkcją rma.mv() z pakietu metafor: z macierzą kowariancji kontrastów, moderatorami dla interwencji wobec węzła odniesienia i efektem losowym porównania w badaniu. Ranking policzysz z losowań z rozkładu oszacowań albo jako P-score. Pakiet netmeta upraszcza rysunki i tabele, ale nie jest konieczny.
Powiązane hasła
Przeczytaj też
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikMetaanaliza wielopoziomowa, umbrella review i PRISMA 2020
Wielkość efektu i przeliczanie danych, modele efektów losowych, metaanaliza trójpoziomowa, umbrella review z klasami dowodów, PRISMA 2020 i kod R.
Czytaj →PoradnikMetaregresja i analiza moderatorów
Moderatory ciągłe i kategoryczne w metafor, Knapp–Hartung, QM i QE, pseudo-R², test permutacyjny, wykres bąbelkowy i opis APA.
Czytaj →Przygotowujesz metaanalizę sieciową do publikacji?
Pomożemy zdefiniować węzły, ocenić przechodniość, dopasować model z badaniami wieloramiennymi, sprawdzić niespójność i opisać wyniki według PRISMA-NMA, tak żebyś mógł(a) samodzielnie obronić każdą decyzję przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bucher, H. C., Guyatt, G. H., Griffith, L. E., & Walter, S. D. (1997). The results of direct and indirect treatment comparisons in meta-analysis of randomized controlled trials. Journal of Clinical Epidemiology, 50(6), 683–691. https://doi.org/10.1016/s0895-4356(97)00049-8
- Dias, S., Welton, N. J., Caldwell, D. M., & Ades, A. E. (2010). Checking consistency in mixed treatment comparison meta-analysis. Statistics in Medicine, 29(7–8), 932–944. https://doi.org/10.1002/sim.3767
- Higgins, J. P. T., Jackson, D., Barrett, J. K., Lu, G., Ades, A. E., & White, I. R. (2012). Consistency and inconsistency in network meta-analysis: Concepts and models for multi-arm studies. Research Synthesis Methods, 3(2), 98–110. https://doi.org/10.1002/jrsm.1044 ● Otwarty dostęp
- Hutton, B., Salanti, G., Caldwell, D. M., Chaimani, A., Schmid, C. H., Cameron, C., Ioannidis, J. P. A., Straus, S., Thorlund, K., Jansen, J. P., Mulrow, C., Catalá-López, F., Gøtzsche, P. C., Dickersin, K., Boutron, I., Altman, D. G., & Moher, D. (2015). The PRISMA extension statement for reporting of systematic reviews incorporating network meta-analyses of health care interventions: Checklist and explanations. Annals of Internal Medicine, 162(11), 777–784. https://doi.org/10.7326/m14-2385
- Rücker, G., & Schwarzer, G. (2015). Ranking treatments in frequentist network meta-analysis works without resampling methods. BMC Medical Research Methodology, 15(1), Article 58. https://doi.org/10.1186/s12874-015-0060-8 ● Otwarty dostęp
- Salanti, G. (2012). Indirect and mixed-treatment comparison, network, or multiple-treatments meta-analysis: Many names, many benefits, many concerns for the next generation evidence synthesis tool. Research Synthesis Methods, 3(2), 80–97. https://doi.org/10.1002/jrsm.1037
- Salanti, G., Ades, A. E., & Ioannidis, J. P. A. (2011). Graphical methods and numerical summaries for presenting results from multiple-treatment meta-analysis: An overview and tutorial. Journal of Clinical Epidemiology, 64(2), 163–171. https://doi.org/10.1016/j.jclinepi.2010.03.016
- Trinquart, L., Attiche, N., Bafeta, A., Porcher, R., & Ravaud, P. (2016). Uncertainty in treatment rankings: Reanalysis of network meta-analyses of randomized trials. Annals of Internal Medicine, 164(10), 666–673. https://doi.org/10.7326/m15-2521
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03 ● Otwarty dostęp
- White, I. R., Barrett, J. K., Jackson, D., & Higgins, J. P. T. (2012). Consistency and inconsistency in network meta-analysis: Model estimation using multivariate meta-regression. Research Synthesis Methods, 3(2), 111–125. https://doi.org/10.1002/jrsm.1045 ● Otwarty dostęp
Cytowania BibTeX
@article{bucher1997results, author={Bucher, Heiner C. and Guyatt, Gordon H. and Griffith, Lauren E. and Walter, Stephen D.}, title={{The results of direct and indirect treatment comparisons in meta-analysis of randomized controlled trials}}, journal={Journal of Clinical Epidemiology}, year={1997}, volume={50}, number={6}, pages={683--691}, doi={10.1016/s0895-4356(97)00049-8}}@article{dias2010checking, author={Dias, S. and Welton, N. J. and Caldwell, D. M. and Ades, A. E.}, title={{Checking consistency in mixed treatment comparison meta-analysis}}, journal={Statistics in Medicine}, year={2010}, volume={29}, number={7–8}, pages={932--944}, doi={10.1002/sim.3767}}@article{higgins2012consistency, author={Higgins, J. P. T. and Jackson, D. and Barrett, J. K. and Lu, G. and Ades, A. E. and White, I. R.}, title={{Consistency and inconsistency in network meta-analysis: Concepts and models for multi-arm studies}}, journal={Research Synthesis Methods}, year={2012}, volume={3}, number={2}, pages={98--110}, doi={10.1002/jrsm.1044}}@article{hutton2015prisma, author={Hutton, Brian and Salanti, Georgia and Caldwell, Deborah M. and Chaimani, Anna and Schmid, Christopher H. and Cameron, Chris and Ioannidis, John P. A. and Straus, Sharon and Thorlund, Kristian and Jansen, Jeroen P. and Mulrow, Cynthia and Catalá-López, Ferrán and Gøtzsche, Peter C. and Dickersin, Kay and Boutron, Isabelle and Altman, Douglas G. and Moher, David}, title={{The PRISMA extension statement for reporting of systematic reviews incorporating network meta-analyses of health care interventions: Checklist and explanations}}, journal={Annals of Internal Medicine}, year={2015}, volume={162}, number={11}, pages={777--784}, doi={10.7326/m14-2385}}@article{rucker2015ranking, author={Rücker, Gerta and Schwarzer, Guido}, title={{Ranking treatments in frequentist network meta-analysis works without resampling methods}}, journal={BMC Medical Research Methodology}, year={2015}, volume={15}, number={1}, eid={58}, doi={10.1186/s12874-015-0060-8}}@article{salanti2012indirect, author={Salanti, Georgia}, title={{Indirect and mixed-treatment comparison, network, or multiple-treatments meta-analysis: Many names, many benefits, many concerns for the next generation evidence synthesis tool}}, journal={Research Synthesis Methods}, year={2012}, volume={3}, number={2}, pages={80--97}, doi={10.1002/jrsm.1037}}@article{salanti2011graphical, author={Salanti, Georgia and Ades, A. E. and Ioannidis, John P. A.}, title={{Graphical methods and numerical summaries for presenting results from multiple-treatment meta-analysis: An overview and tutorial}}, journal={Journal of Clinical Epidemiology}, year={2011}, volume={64}, number={2}, pages={163--171}, doi={10.1016/j.jclinepi.2010.03.016}}@article{trinquart2016uncertainty, author={Trinquart, Ludovic and Attiche, Nassima and Bafeta, Aïida and Porcher, Raphaël and Ravaud, Philippe}, title={{Uncertainty in treatment rankings: Reanalysis of network meta-analyses of randomized trials}}, journal={Annals of Internal Medicine}, year={2016}, volume={164}, number={10}, pages={666--673}, doi={10.7326/m15-2521}}@article{viechtbauer2010conducting, author={Viechtbauer, Wolfgang}, title={{Conducting meta-analyses in R with the metafor package}}, journal={Journal of Statistical Software}, year={2010}, volume={36}, number={3}, pages={1--48}, doi={10.18637/jss.v036.i03}}@article{white2012consistency, author={White, Ian R. and Barrett, Jessica K. and Jackson, Dan and Higgins, Julian P. T.}, title={{Consistency and inconsistency in network meta-analysis: Model estimation using multivariate meta-regression}}, journal={Research Synthesis Methods}, year={2012}, volume={3}, number={2}, pages={111--125}, doi={10.1002/jrsm.1045}}