Pięć metod, pięć różnych pytań
Gdy w metaanalizie podejrzewasz błąd publikacji, recenzent zwykle oczekuje wykresu lejkowego i testu Eggera. To dobry początek, ale oba narzędzia odpowiadają tylko na pytanie, czy małe badania dają inne wyniki niż duże. Nie mówią, jaki byłby efekt bez selekcji. Do tego służą metody korekty, a każda z nich opiera się na innym założeniu o tym, jak powstała luka w literaturze.
Ten wpis zestawia te metody na jednym zbiorze danych. Sam przebieg metaanalizy, łącznie z podstawowym lejkiem i testem Eggera, opisuje krok 9c poradnika metaanaliza krok po kroku. Tu interesuje nas, co każda metoda mówi o tej samej literaturze, dlaczego wyniki się rozchodzą i jak to opisać.
| Metoda | Pytanie | Kluczowe założenie |
|---|---|---|
| Lejek, test Eggera | Czy jest efekt małych badań? | asymetria wynika z selekcji, a nie z różnic między badaniami |
| Trim-and-fill | Jak zmieni się efekt po dopisaniu „brakujących” badań? | brakuje najbardziej skrajnych badań z jednej strony lejka |
| PET-PEESE | Jaki byłby efekt badania o nieskończonej precyzji? | efekt zależy od SE (PET) albo od wariancji (PEESE) wyłącznie przez selekcję |
| Model selekcji | Jak bardzo wynik nieistotny ma mniejszą szansę publikacji i jaki jest efekt po uwzględnieniu tej szansy? | prawdopodobieństwo publikacji zależy tylko od wartości p |
| p-curve | Czy istotne wyniki niosą wartość dowodową? | analizowane wartości p są niezależne i dotyczą testowanej hipotezy |
Przykład: 120 badań, z których opublikowano 37
Symulujemy literaturę, w której znamy prawdę. Przeprowadzono 120 badań porównujących dwie grupy, po 15–150 osób w grupie. Prawdziwy średni efekt to δ = 0.20, a efekty badań różnią się nieco między sobą (τ = 0.10). Każde badanie daje g Hedgesa z wariancją. Do druku trafia każde badanie z wynikiem istotnym i dodatnim (jednostronne p < .025, czyli dwustronne p < .05 w oczekiwanym kierunku) i co dziesiąte z pozostałych. To prosty model efektu szuflady.
Opublikowano 37 badań. Wszystkie 29 badań istotnych i tylko 8 z 91 nieistotnych. Metaanaliza efektów losowych wszystkich 120 badań daje g = 0.19, 95% CI [0.15, 0.23], ale tego zbioru nikt nie zobaczy. Ta sama metaanaliza na 37 opublikowanych badaniach daje g = 0.39, 95% CI [0.33, 0.45], czyli efekt dwukrotnie zawyżony, przy niemal zerowej heterogeniczności (τ² = 0.002, I² = 7.1%). Przedział nie obejmuje prawdy. Selekcja nie poszerza go, tylko przesuwa. Dane opublikowanych badań możesz pobrać jako plik CSV (37 wierszy: badanie, n_na_grupe, g, v, p_jedn).
Lejek i test Eggera: sygnał, nie korekta
Rysunek 1 pokazuje, skąd bierze się zawyżenie. Opublikowane badania (czerwone punkty) leżą prawie wyłącznie poza szarym polem wyników nieistotnych. Im mniejsze badanie, tym większy efekt potrzebny do przekroczenia progu istotności, więc małe opublikowane badania mają duże efekty. Lewa dolna część lejka jest pusta.
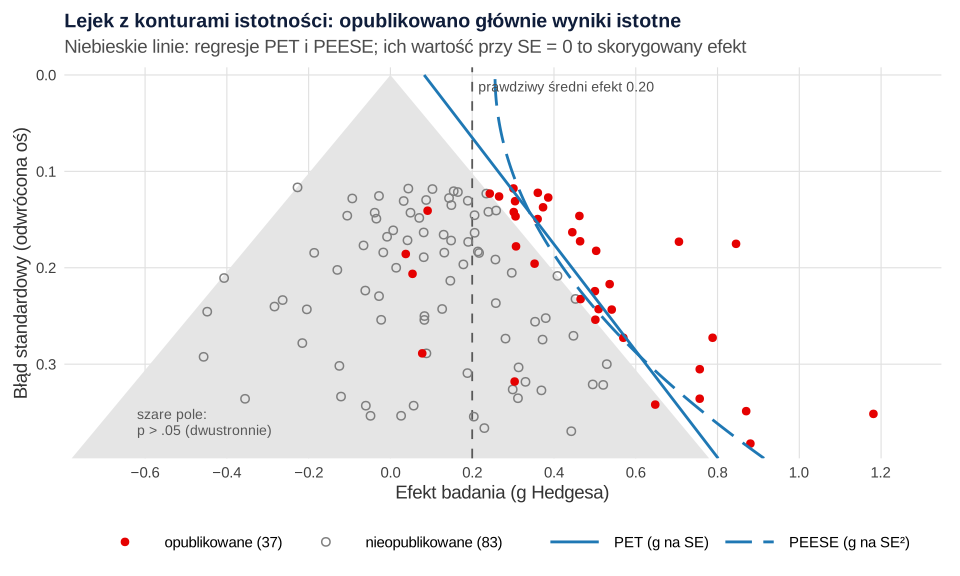
Test Eggera, czyli ważona regresja efektu na błąd standardowy, potwierdza asymetrię: t(35) = 3.71, p < .001. Egger i in. (1997) ostrzegali jednak, że przy niewielu małych badaniach test ma małą zdolność wykrycia błędu. Sterne i in. (2011) przypominają z kolei, że asymetria lejka ma wiele możliwych przyczyn poza błędem publikacji, na przykład intensywniejsze interwencje w małych badaniach albo słabszą jakość tych badań. Istotny test Eggera mówi więc „coś zależy od wielkości badania”, a nie „efekt jest zawyżony o tyle”.
Trim-and-fill: korekta, która często nie wystarcza
Trim-and-fill (Duval i Tweedie, 2000) szacuje liczbę badań brakujących po jednej stronie lejka i dopisuje ich lustrzane odbicia. W przykładzie metoda dopisała 10 badań po lewej stronie, a efekt zmalał do g = 0.34, 95% CI [0.27, 0.41]. To nadal ponad półtora raza więcej niż prawda, choć w rzeczywistości brakuje 83 badań, a nie 10.
Powód jest prosty. Metoda zakłada, że brakują badania najbardziej skrajne, symetryczne do tych, które widać. Selekcja według istotności usuwa jednak całe pasmo wyników nieistotnych, także bliskich średniej. Peters i in. (2007) pokazali dodatkowo, że przy dużej heterogeniczności trim-and-fill może zaniżać efekt także wtedy, gdy błędu publikacji nie ma, i zalecali traktować metodę jako analizę wrażliwości.
PET-PEESE: regresja do badania idealnego
PET-PEESE rozwija pomysł testu Eggera. Zamiast pytać, czy nachylenie efektu względem błędu standardowego jest różne od zera, pyta o wyraz wolny: jaki efekt miałoby badanie o błędzie standardowym równym zeru. Są dwa warianty regresji ważonej wagami 1/v:
Stanley i Doucouliagos (2014) wyprowadzili oba warianty jako przybliżenia średniej z rozkładu uciętego przez selekcję. W ich symulacjach PEESE miał w większości warunków najmniejsze obciążenie i błąd średniokwadratowy. Zaproponowali też estymator warunkowy: gdy PET wskazuje na efekt różny od zera, raportuje się PEESE, a w przeciwnym razie PET. Logika jest taka, że gdy efekt istnieje, PET zwykle go zaniża, a gdy efektu nie ma, PEESE może go zawyżać.
W przykładzie PET daje b0 = 0.08, 95% CI [−0.09, 0.26], t(35) = 0.95, jednostronne p = .174, a PEESE b0 = 0.26, 95% CI [0.17, 0.35]. PET nie jest istotny, więc reguła warunkowa wybiera PET, który ma przedział obejmujący zero, choć prawdziwy efekt wynosi 0.20. PEESE trafiłby lepiej, ale nie został wybrany. Przy kilkudziesięciu badaniach PET ma małą moc i potrafi „skorygować” realny, mały efekt do zera. Zauważ też, że wartość graniczna z regtest() (0.08) to ten sam wyraz wolny PET.
Model selekcji (Vevea i Hedges)
Model selekcji modeluje wprost mechanizm z naszej symulacji. Vevea i Hedges (1995) zaproponowali model, w którym prawdopodobieństwo publikacji zależy od jednostronnej wartości p, a efekt łączny, heterogeniczność i wagi selekcji szacuje się łącznie metodą największej wiarygodności. W wersji z jednym progiem (p = .025, często nazywanej 3PSM) wynik istotny ma wagę 1, a model szacuje względną szansę publikacji wyniku nieistotnego.
W przykładzie ta szansa wyniosła 0.07, 95% CI [0.00, 0.16]. Prawdziwa wartość to 0.10. Test ilorazu wiarygodności odrzuca model bez selekcji, χ²(1) = 23.09, p < .001. Skorygowany efekt to g = 0.23, 95% CI [0.11, 0.36]. Przedział obejmuje prawdziwe 0.20, choć jest szeroki. To najlepszy wynik w zestawieniu, ale nie przypadkiem: symulacja spełnia założenie modelu co do joty. W prawdziwej literaturze selekcja zależy też od kierunku efektu, czasopisma i decyzji analitycznych (p-hacking), a przy kilku nieistotnych badaniach waga selekcji i efekt są bardzo niepewne. Model z wieloma progami wymaga dostatecznej liczby badań w każdym przedziale p.
p-curve: czy w istotnych wynikach jest sygnał
p-curve (Simonsohn i in., 2014) zadaje inne pytanie. Bierze tylko wyniki istotne i patrzy na rozkład ich wartości p. Gdy prawdziwego efektu nie ma, istotne wartości p rozkładają się równomiernie między 0 a .05. Gdy efekt istnieje, przeważają bardzo małe wartości (rozkład prawoskośny). Prawoskośna p-curve pozwala więc wykluczyć selektywne raportowanie jako jedyne wyjaśnienie wyników.
Test prawoskośności liczymy ręcznie. Każdą istotną wartość p dzielimy przez próg, otrzymując pp-wartość (przy braku efektu rozkład jednostajny). Następnie łączymy je metodą Stouffera: Z = Σ Φ−1(ppi) / √k. Wśród 29 istotnych badań 37.9% miało dwustronne p < .01, a test dał Z = −2.97, p = .001. Literatura ma więc wartość dowodową: za wynikami stoi prawdziwy efekt, a nie sama selekcja.
Zwróć uwagę, czego p-curve nie robi w tej postaci. Nie mówi, jak duży jest efekt, i nie koryguje średniej 0.39. Przydaje się, gdy podejrzewasz, że cała literatura może być artefaktem. Wymaga też starannego wyboru jednej wartości p na badanie, tej związanej z testowaną hipotezą.
Fail-safe N: dlaczego go nie raportować
Fail-safe N Rosenthala (1979) mówi, ile nieopublikowanych badań z zerowym wynikiem musiałoby leżeć w szufladach, żeby łączny wynik stracił istotność. W przykładzie wynosi 2519. Brzmi uspokajająco, a tymczasem w szufladzie leżą 83 badania, a efekt jest zawyżony dwukrotnie. Ta liczba odpowiada na niewłaściwe pytanie z kilku powodów:
- dotyczy istotności łącznego testu, a nie wielkości efektu: literatura może być „odporna” i jednocześnie mocno zawyżona;
- zakłada, że brakujące badania mają średnio efekt zerowy, podczas gdy w szufladzie mogą leżeć także efekty ujemne albo małe dodatnie;
- nie uwzględnia heterogeniczności ani wielkości badań i rośnie niemal automatycznie z liczbą badań;
- nie daje skorygowanego oszacowania, więc nie nadaje się do analizy wrażliwości.
Jeśli recenzent o niego prosi, podaj go z tym wyjaśnieniem i obok metod opisanych wyżej.
Porównanie metod na jednym zbiorze
| Metoda | Wynik w przykładzie | Wniosek | Główne ograniczenie |
|---|---|---|---|
| Efekty losowe, opublikowane | g = 0.39 [0.33, 0.45] | efekt zawyżony dwukrotnie | brak korekty |
| Test Eggera | t(35) = 3.71, p < .001 | asymetria lejka | mała moc przy kilku badaniach; asymetria ma też inne przyczyny |
| Trim-and-fill | k0 = 10; g = 0.34 [0.27, 0.41] | korekta za słaba | zakłada brak badań skrajnych, a nie nieistotnych |
| PET | g = 0.08 [−0.09, 0.26] | korekta za silna | zaniża efekt, gdy efekt istnieje |
| PEESE | g = 0.26 [0.17, 0.35] | blisko prawdy | przy braku efektu może go zawyżać |
| PET-PEESE (wybrano PET) | g = 0.08 [−0.09, 0.26] | „efekt niepewny” | wybór zależy od testu PET o małej mocy |
| Model selekcji (3PSM) | g = 0.23 [0.11, 0.36]; waga 0.07 | najbliżej prawdy | wrażliwy na błędną specyfikację, potrzebuje wielu badań |
| p-curve | Z = −2.97, p = .001 | jest wartość dowodowa | nie szacuje tu wielkości efektu |
| Fail-safe N | 2519 | „odporność” pozorna | nie mówi nic o zawyżeniu efektu |
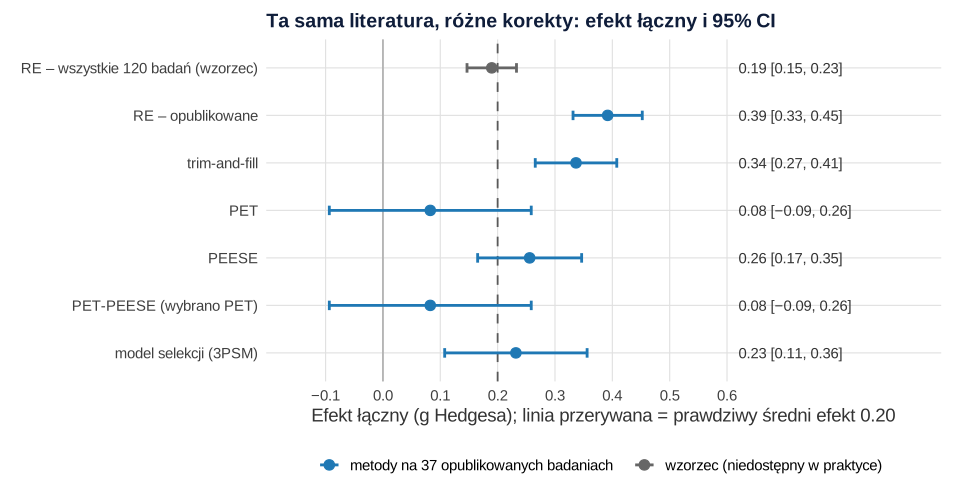
Oszacowania z tych samych 37 badań rozciągają się od 0.08 do 0.39. Przewaga modelu selekcji wynika z jednej symulacji zbudowanej według jego założeń, więc nie jest rekomendacją. Carter i in. (2019) porównali metody w warunkach typowych dla psychologii, z różnym nasileniem błędu publikacji, wątpliwych praktyk badawczych i heterogeniczności. Żadna metoda nie była konsekwentnie najlepsza. Zalecili analizę wrażliwości: raportować kilka metod, wskazać warunki, w których każda zawodzi, i opisać, jak wniosek zależy od tego, który scenariusz jest najbardziej prawdopodobny.
W praktyce przydaje się prosta reguła. Jeśli wszystkie korekty zgadzają się co do kierunku i rzędu wielkości efektu, wniosek jest odporny. Jeśli rozchodzą się tak jak tutaj (od zera do wartości nieskorygowanej), wniosek brzmi: efekt jest prawdopodobnie dodatni, ale jego wielkości nie da się wiarygodnie ustalić z opublikowanej literatury. Taki wynik warto wpisać do analizy wrażliwości, a nie ukrywać. Gdy efekty są heterogeniczne, metody korekty można łączyć z moderatorami (zob. metaregresja), ale wtedy tym bardziej potrzeba wielu badań.
Jak opisać ocenę błędu publikacji
Zapisz zestaw metod w protokole przeglądu, zanim zobaczysz wyniki. Wybór tej korekty, która „wychodzi najlepiej”, to ten sam problem co p-hacking w badaniu pierwotnym. W raporcie podaj efekt nieskorygowany, wynik każdej metody z przedziałem ufności, wybór wariantu (np. próg modelu selekcji, reguła PET-PEESE) i ogólny wniosek. Wzór opisu dla przykładu:
Najlepszą ochroną przed błędem publikacji pozostaje wyszukiwanie w rejestrach badań i literaturze nieopublikowanej oraz w dłuższej perspektywie prerejestracja i registered reports. Jeśli prowadzisz przegląd z zależnymi efektami, zobacz też metaanalizę wielopoziomową. Prosty model efektów losowych z wykresem lasu policzysz w kalkulatorze metaanalizy, a pełny zestaw analiz wrażliwości możemy przygotować wspólnie w ramach wsparcia dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy symuluje 120 badań, „publikuje” część z nich, zapisuje plik blad-publikacji-dane.csv (możesz go pobrać tutaj) i liczy zwykłą metaanalizę. Drugi stosuje wszystkie metody z tekstu. Potrzebny jest pakiet metafor (Viechtbauer, 2010); PET-PEESE i p-curve liczymy funkcjami podstawowego R.
1. Symulacja literatury z błędem publikacji
R
# Dane symulowane: 120 przeprowadzonych badań (dwie grupy), prawdziwy średni efekt δ = 0.20, τ = 0.10
# Publikacja: każde badanie z wynikiem istotnym i dodatnim (jednostronne p < .025), pozostałe z prawdopodobieństwem .10
# Uwaga: wszystkie modele liczysz na opublikowanych badaniach (plik CSV); pełny zbiór służy tylko do porównania
suppressPackageStartupMessages(library(metafor))
set.seed(2450)
k <- 120
n <- round(exp(runif(k, log(15), log(150))))          # osób w grupie: od 15 do 150
delta <- rnorm(k, 0.20, 0.10)                          # prawdziwe efekty badań
df <- 2 * n - 2
t_obs <- rt(k, df, ncp = delta * sqrt(n / 2))          # statystyka t każdego badania
d <- t_obs * sqrt(2 / n)
J <- 1 - 3 / (4 * df - 1)                              # poprawka Hedgesa
g <- J * d
v <- 2 / n + g^2 / (4 * n)                             # wariancja g przy równych grupach
p_jedn <- pnorm(g / sqrt(v), lower.tail = FALSE)      # jednostronne p z testu z (tak liczy je też selmodel)
opublikowane <- p_jedn < .025 | runif(k) < .10
dane <- data.frame(badanie = sprintf("B%03d", 1:k), n_na_grupe = n, g, v, p_jedn, opublikowane)
write.csv(transform(dane[dane$opublikowane, 1:5], g = round(g, 4), v = round(v, 5), p_jedn = signif(p_jedn, 4)),
          "blad-publikacji-dane.csv", row.names = FALSE)

c(przeprowadzone = k, opublikowane = sum(opublikowane),
  istotne_wsrod_opublikowanych = sum(p_jedn[opublikowane] < .025))

wszystkie <- rma(g, v, data = dane)                    # punkt odniesienia: niedostępny w praktyce
pub <- dane[dane$opublikowane, ]
pub$sei <- sqrt(pub$v)
re <- rma(g, v, data = pub)                            # zwykła metaanaliza opublikowanych badań
round(c(g_wszystkie = coef(wszystkie)[[1]], g_opublikowane = coef(re)[[1]], dolny = re$ci.lb, gorny = re$ci.ub,
        tau2 = re$tau2, I2 = re$I2), 3)
Wynik w R
              przeprowadzone                 opublikowane
                         120                           37
istotne_wsrod_opublikowanych
                          29
   g_wszystkie g_opublikowane          dolny          gorny           tau2
         0.190          0.392          0.331          0.452          0.002
            I2
         7.139
2. Egger, trim-and-fill, PET-PEESE, model selekcji, p-curve i fail-safe N
R
# Metody wykrywania i korekty błędu publikacji na opublikowanych badaniach (obiekty z przepisu 1)
# 1. Test Eggera: klasyczna regresja ważona (model = "lm") z błędem standardowym jako predyktorem
egger <- regtest(re, model = "lm", predictor = "sei")
egger

# 2. Trim-and-fill (estymator L0)
tf <- trimfill(re)
tf

# 3. PET i PEESE: regresja ważona efektu na SE (PET) albo na wariancję (PEESE); wyraz wolny = efekt przy SE = 0
pet <- lm(g ~ sei, weights = 1 / v, data = pub)
peese <- lm(g ~ v, weights = 1 / v, data = pub)
wiersz <- function(m) {
  s <- summary(m)$coefficients[1, ]
  ci <- confint(m)[1, ]
  round(c(b0 = s[["Estimate"]], SE = s[["Std. Error"]], dolny = ci[[1]], gorny = ci[[2]], t = s[["t value"]],
          p_jedn = pt(s[["t value"]], df.residual(m), lower.tail = FALSE)), 3)
}
rbind(PET = wiersz(pet), PEESE = wiersz(peese))
# Reguła warunkowa: jeśli PET wskazuje efekt > 0 (jednostronne p < .05), raportuj PEESE, w przeciwnym razie PET
pet_peese <- if (wiersz(pet)[["p_jedn"]] < .05) "PEESE" else "PET"
pet_peese

# 4. Model selekcji Vevea–Hedgesa: funkcja skokowa z progiem jednostronnego p = .025 (model trzyparametrowy)
sel <- selmodel(re, type = "stepfun", steps = c(.025, 1))
sel

# 5. p-curve (ręcznie): tylko wyniki istotne i dodatnie, test prawoskośności metodą Stouffera
istotne <- pub[pub$p_jedn < .025, ]
pp <- istotne$p_jedn / .025                           # pp-wartość: p warunkowo na istotności
z_stouffer <- sum(qnorm(pp)) / sqrt(length(pp))
round(c(k_istotnych = nrow(istotne), odsetek_p_dwustr_ponizej_.01 = mean(2 * istotne$p_jedn < .01),
        Z = z_stouffer, p = pnorm(z_stouffer)), 3)

# 6. Fail-safe N Rosenthala: ile badań z efektem zerowym „zniosłoby” istotność
fsn(g, v, data = pub)

# 7. Zestawienie: efekt łączny i 95% CI według metody
pet_ci <- confint(pet)[1, ]; peese_ci <- confint(peese)[1, ]
zestawienie <- data.frame(
  metoda = c("RE – wszystkie 120 badań (wzorzec)", "RE – opublikowane", "trim-and-fill", "PET", "PEESE",
             paste0("PET-PEESE (wybrano ", pet_peese, ")"), "model selekcji (3PSM)"),
  g = c(coef(wszystkie), coef(re), tf$beta[1], coef(pet)[1], coef(peese)[1],
        if (pet_peese == "PET") coef(pet)[1] else coef(peese)[1], sel$beta[1]),
  dolny = c(wszystkie$ci.lb, re$ci.lb, tf$ci.lb, pet_ci[1], peese_ci[1],
            if (pet_peese == "PET") pet_ci[1] else peese_ci[1], sel$ci.lb),
  gorny = c(wszystkie$ci.ub, re$ci.ub, tf$ci.ub, pet_ci[2], peese_ci[2],
            if (pet_peese == "PET") pet_ci[2] else peese_ci[2], sel$ci.ub))
print(cbind(zestawienie[1], round(zestawienie[-1], 2)), row.names = FALSE)
Wynik w R
Regression Test for Funnel Plot Asymmetry

Model:     weighted regression with multiplicative dispersion
Predictor: standard error

Test for Funnel Plot Asymmetry: t = 3.7143, df = 35, p = 0.0007
Limit Estimate (as sei -> 0):   b = 0.0825 (CI: -0.0935, 0.2586)


Estimated number of missing studies on the left side: 10 (SE = 3.9812)

Random-Effects Model (k = 47; tau^2 estimator: REML)

tau^2 (estimated amount of total heterogeneity): 0.0196 (SE = 0.0117)
tau (square root of estimated tau^2 value):      0.1400
I^2 (total heterogeneity / total variability):   35.09%
H^2 (total variability / sampling variability):  1.54

Test for Heterogeneity:
Q(df = 46) = 78.4420, p-val = 0.0020

Model Results:

estimate      se    zval    pval   ci.lb   ci.ub
  0.3367  0.0363  9.2855  <.0001  0.2656  0.4077  ***

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

         b0    SE  dolny gorny     t p_jedn
PET   0.083 0.087 -0.094 0.259 0.952  0.174
PEESE 0.256 0.045  0.165 0.346 5.728  0.000
[1] "PET"

Random-Effects Model (k = 37; tau^2 estimator: ML)

tau^2 (estimated amount of total heterogeneity): 0.0031 (SE = 0.0097)
tau (square root of estimated tau^2 value):      0.0556

Test for Heterogeneity:
LRT(df = 1) = 0.1180, p-val = 0.7312

Model Results:

estimate      se    zval    pval   ci.lb   ci.ub
  0.2318  0.0634  3.6590  0.0003  0.1077  0.3560  ***

Test for Selection Model Parameters:
LRT(df = 1) = 23.0892, p-val < .0001

Selection Model Results:

                     k  estimate      se      zval    pval   ci.lb   ci.ub
0     < p <= 0.025  29    1.0000     ---       ---     ---     ---     ---
0.025 < p <= 1       8    0.0741  0.0448  -20.6854  <.0001  0.0000  0.1618  ***

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

                 k_istotnych odsetek_p_dwustr_ponizej_.01
                      29.000                        0.379
                           Z                            p
                      -2.973                        0.001

Fail-safe N Calculation Using the Rosenthal Approach

Observed Significance Level: <.0001
Target Significance Level:   0.05

Fail-safe N: 2519

                             metoda    g dolny gorny
 RE – wszystkie 120 badań (wzorzec) 0.19  0.15  0.23
                  RE – opublikowane 0.39  0.33  0.45
                      trim-and-fill 0.34  0.27  0.41
                                PET 0.08 -0.09  0.26
                              PEESE 0.26  0.17  0.35
            PET-PEESE (wybrano PET) 0.08 -0.09  0.26
              model selekcji (3PSM) 0.23  0.11  0.36
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje rma(), regtest(), trimfill(), selmodel() i fsn() z pakietu metafor oraz lm() z pakietu stats); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Test Eggera nieistotny, więc nie ma błędu publikacji”. Przy kilkunastu badaniach test ma małą moc, a symetria lejka nie wyklucza selekcji.
- Jedna metoda korekty podana jako „prawdziwy” efekt. Każda opiera się na innym założeniu. Podaj kilka i opisz ich zgodność.
- Trim-and-fill jako dowód, że problemu nie ma. Mała liczba dopisanych badań nie oznacza małego zawyżenia: w przykładzie metoda dopisała 10 badań przy 83 brakujących.
- Fail-safe N jako argument za odpornością wyników. Duża liczba nie mówi nic o wielkości efektu.
- Metody wybrane po obejrzeniu wyników. Zestaw analiz i progi wpisz do protokołu.
- p-curve na wszystkich wartościach p z artykułu. Do analizy bierze się jedną wartość na badanie, dotyczącą testowanej hipotezy.
- Korekta zamiast wyszukiwania. Metody statystyczne nie zastąpią przeszukania rejestrów i literatury nieopublikowanej.
Najczęstsze pytania
Którą metodę oceny błędu publikacji wybrać do metaanalizy?
Żadnej jednej. Lejek z konturami istotności i test Eggera pokazują, czy jest efekt małych badań, a trim-and-fill, PET-PEESE i model selekcji szacują efekt po korekcie przy różnych założeniach. Carter i in. (2019) nie znaleźli metody konsekwentnie najlepszej i zalecają raportować kilka metod zaplanowanych w protokole jako analizę wrażliwości.
Czy trim-and-fill wystarczy jako korekta błędu publikacji?
Zwykle nie. Metoda zakłada, że brakuje najbardziej skrajnych badań z jednej strony lejka, a selekcja według istotności usuwa całe pasmo wyników nieistotnych. W przykładzie dopisała 10 badań przy 83 brakujących i obniżyła efekt tylko z 0.39 do 0.34 przy prawdziwym 0.20. Traktuj ją jako jedną z analiz wrażliwości (Peters i in., 2007).
Kiedy w PET-PEESE raportować PEESE, a kiedy PET?
Według reguły warunkowej Stanleya i Doucouliagosa (2014): jeśli wyraz wolny PET jest istotnie większy od zera, raportujesz PEESE, w przeciwnym razie PET. Pamiętaj, że PET ma małą moc przy kilkudziesięciu badaniach i zaniża efekt, który istnieje. W przykładzie reguła wybrała PET (0.08), choć PEESE (0.26) był bliżej prawdy (0.20).
Czym p-curve różni się od modelu selekcji w metaanalizie?
Model selekcji szacuje efekt łączny i względną szansę publikacji wyniku nieistotnego, zakładając, że publikacja zależy od wartości p. p-curve analizuje tylko wyniki istotne i sprawdza, czy ich wartości p są prawoskośne, czyli czy za wynikami stoi prawdziwy efekt (Simonsohn i in., 2014). W tej postaci nie koryguje średniego efektu.
Co zrobić, gdy metody korekty błędu publikacji dają różne wyniki?
Opisz rozrzut zamiast wybierać najkorzystniejszy wynik. Jeśli korekty zgadzają się co do kierunku i rzędu wielkości, wniosek jest odporny. Jeśli rozciągają się od zera do wartości nieskorygowanej, napisz, że efekt jest prawdopodobnie zawyżony, a jego wielkość niepewna, i wskaż, które założenia metod wydają się najbardziej realistyczne w Twojej dziedzinie.
Powiązane hasła
Przeczytaj też
Metaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikMetaregresja i analiza moderatorów
Moderatory ciągłe i kategoryczne w metafor, Knapp–Hartung, QM i QE, pseudo-R², test permutacyjny, wykres bąbelkowy i opis APA.
Czytaj →PoradnikKalkulator metaanalizy z wykresem lasu
Model stały i losowy (REML, DL, Knapp–Hartung), Q, I², H², przedział predykcji i wykres lasu SVG z efektów i SE albo przedziałów ufności.
Czytaj →Recenzent pyta o błąd publikacji w Twojej metaanalizie?
Pomożemy zaplanować i policzyć zestaw analiz wrażliwości (lejek, test Eggera, PET-PEESE, model selekcji, p-curve) oraz opisać rozbieżne wyniki tak, żebyś mógł(a) samodzielnie obronić wnioski.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Carter, E. C., Schönbrodt, F. D., Gervais, W. M., & Hilgard, J. (2019). Correcting for bias in psychology: A comparison of meta-analytic methods. Advances in Methods and Practices in Psychological Science, 2(2), 115–144. https://doi.org/10.1177/2515245919847196 ● Otwarty dostęp: pełny tekst
- Duval, S., & Tweedie, R. (2000). Trim and fill: A simple funnel-plot-based method of testing and adjusting for publication bias in meta-analysis. Biometrics, 56(2), 455–463. https://doi.org/10.1111/j.0006-341x.2000.00455.x
- Egger, M., Davey Smith, G., Schneider, M., & Minder, C. (1997). Bias in meta-analysis detected by a simple, graphical test. BMJ, 315(7109), 629–634. https://doi.org/10.1136/bmj.315.7109.629 ● Otwarty dostęp: pełny tekst
- Peters, J. L., Sutton, A. J., Jones, D. R., Abrams, K. R., & Rushton, L. (2007). Performance of the trim and fill method in the presence of publication bias and between-study heterogeneity. Statistics in Medicine, 26(25), 4544–4562. https://doi.org/10.1002/sim.2889
- Rosenthal, R. (1979). The file drawer problem and tolerance for null results. Psychological Bulletin, 86(3), 638–641. https://doi.org/10.1037/0033-2909.86.3.638
- Simonsohn, U., Nelson, L. D., & Simmons, J. P. (2014). P-curve: A key to the file-drawer. Journal of Experimental Psychology: General, 143(2), 534–547. https://doi.org/10.1037/a0033242
- Stanley, T. D., & Doucouliagos, H. (2014). Meta-regression approximations to reduce publication selection bias. Research Synthesis Methods, 5(1), 60–78. https://doi.org/10.1002/jrsm.1095
- Sterne, J. A. C., Sutton, A. J., Ioannidis, J. P. A., Terrin, N., Jones, D. R., Lau, J., Carpenter, J., Rücker, G., Harbord, R. M., Schmid, C. H., Tetzlaff, J., Deeks, J. J., Peters, J., Macaskill, P., Schwarzer, G., Duval, S., Altman, D. G., Moher, D., & Higgins, J. P. T. (2011). Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials. BMJ, 343, Article d4002. https://doi.org/10.1136/bmj.d4002 ● Otwarty dostęp
- Vevea, J. L., & Hedges, L. V. (1995). A general linear model for estimating effect size in the presence of publication bias. Psychometrika, 60(3), 419–435. https://doi.org/10.1007/bf02294384
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03 ● Otwarty dostęp
Cytowania BibTeX
@article{carter2019correcting, author={Carter, Evan C. and Schönbrodt, Felix D. and Gervais, Will M. and Hilgard, Joseph}, title={{Correcting for bias in psychology: A comparison of meta-analytic methods}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={2}, pages={115--144}, doi={10.1177/2515245919847196}}@article{duval2000trim, author={Duval, Sue and Tweedie, Richard}, title={{Trim and fill: A simple funnel-plot-based method of testing and adjusting for publication bias in meta-analysis}}, journal={Biometrics}, year={2000}, volume={56}, number={2}, pages={455--463}, doi={10.1111/j.0006-341x.2000.00455.x}}@article{egger1997bias, author={Egger, Matthias and Davey Smith, George and Schneider, Martin and Minder, Christoph}, title={{Bias in meta-analysis detected by a simple, graphical test}}, journal={BMJ}, year={1997}, volume={315}, number={7109}, pages={629--634}, doi={10.1136/bmj.315.7109.629}}@article{peters2007performance, author={Peters, Jaime L. and Sutton, Alex J. and Jones, David R. and Abrams, Keith R. and Rushton, Lesley}, title={{Performance of the trim and fill method in the presence of publication bias and between-study heterogeneity}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={25}, pages={4544--4562}, doi={10.1002/sim.2889}}@article{rosenthal1979file, author={Rosenthal, Robert}, title={{The file drawer problem and tolerance for null results}}, journal={Psychological Bulletin}, year={1979}, volume={86}, number={3}, pages={638--641}, doi={10.1037/0033-2909.86.3.638}}@article{simonsohn2014pcurve, author={Simonsohn, Uri and Nelson, Leif D. and Simmons, Joseph P.}, title={{P-curve: A key to the file-drawer}}, journal={Journal of Experimental Psychology: General}, year={2014}, volume={143}, number={2}, pages={534--547}, doi={10.1037/a0033242}}@article{stanley2014meta, author={Stanley, T. D. and Doucouliagos, Hristos}, title={{Meta-regression approximations to reduce publication selection bias}}, journal={Research Synthesis Methods}, year={2014}, volume={5}, number={1}, pages={60--78}, doi={10.1002/jrsm.1095}}@article{sterne2011recommendations, author={Sterne, Jonathan A. C. and Sutton, Alex J. and Ioannidis, John P. A. and Terrin, Norma and Jones, David R. and Lau, Joseph and Carpenter, James and Rücker, Gerta and Harbord, Roger M. and Schmid, Christopher H. and Tetzlaff, Jennifer and Deeks, Jonathan J. and Peters, Jaime and Macaskill, Petra and Schwarzer, Guido and Duval, Sue and Altman, Douglas G. and Moher, David and Higgins, Julian P. T.}, title={{Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials}}, journal={BMJ}, year={2011}, volume={343}, eid={d4002}, doi={10.1136/bmj.d4002}}@article{vevea1995general, author={Vevea, Jack L. and Hedges, Larry V.}, title={{A general linear model for estimating effect size in the presence of publication bias}}, journal={Psychometrika}, year={1995}, volume={60}, number={3}, pages={419--435}, doi={10.1007/bf02294384}}@article{viechtbauer2010conducting, author={Viechtbauer, Wolfgang}, title={{Conducting meta-analyses in R with the metafor package}}, journal={Journal of Statistical Software}, year={2010}, volume={36}, number={3}, pages={1--48}, doi={10.18637/jss.v036.i03}}