Co to jest p-curve?
P-curve (krzywa p) to rozkład istotnych statystycznie wartości p (p < .05) z zestawu badań i metoda jego analizy (Simonsohn i in., 2014). Odpowiada na pytanie, czy wyniki mają wartość dowodową, czy da się je wyjaśnić samym selektywnym raportowaniem: błędem publikacji i p-hackingiem.
Logika metody
Gdy efektu nie ma, wartości p mają rozkład jednostajny, więc istotne wyniki rozkładają się równo między .00 a .05 – krzywa jest płaska. Gdy efekt istnieje, wartości bliskich .01 jest więcej niż bliskich .04 – krzywa jest prawoskośna. P-hacking zatrzymuje się tuż pod progiem, więc spłaszcza krzywą albo przechyla ją w lewo. Metoda korzysta tylko z wyników istotnych, więc nie potrzebuje badań z szuflady.
Każde p zamienia się na pp-wartość (p/.05), a pp-wartości łączy się metodą Stouffera. Istotnie ujemne Z oznacza prawoskośność. Drugi test sprawdza, czy krzywa jest bardziej płaska niż przy mocy 33%. Jeśli tak, wartość dowodowa jest niewystarczająca (Simonsohn i in., 2015).
Przykład
W symulowanej literaturze o prawdziwym d = 0.20 było 26 istotnych wyników: 14 miało p < .01, a tylko jeden leżał między .04 a .05. Test prawoskośności: Z = −4.28, p < .001. W drugim zbiorze prawdziwy efekt wynosił zero: z 300 badań istotnych i dodatnich było 12, Z = −0.41, p = .341, a test płaskości wobec mocy 33% znalazł się na granicy, p = .0497.
Na rysunku
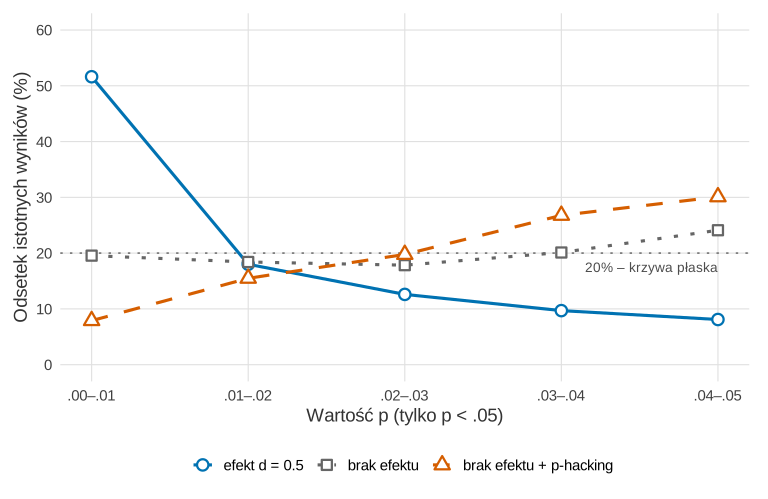
Co widać. Przy prawdziwym efekcie (d = 0.5, 30 osób w grupie) 51.6% istotnych wyników ma p < .01, a tylko 8.1% leży między .04 a .05 – krzywa jest prawoskośna. Bez efektu każdy przedział łapie około 20% wyników (od 17.8% do 24.1%, błąd Monte Carlo około 1.8 punktu procentowego, bo istotnych było tylko 527). P-hacking przy braku efektu – dokładanie po 5 osób do grupy, aż p spadnie poniżej .05 – daje krzywą lewoskośną: 7.9% przy .00–.01 i 30.1% przy .04–.05. Tak działa opcjonalne zatrzymywanie: zatrzymuje się, gdy p ledwo przekroczy próg.
Na co uważać. Krzywe zbudowano z tysięcy wyników, a prawdziwa p-curve ma ich zwykle kilkanaście lub kilkadziesiąt – jej słupki skaczą znacznie bardziej niż szara linia, dlatego wniosek opiera się na testach, nie na kształcie „na oko”. Gdy prawdziwy efekt i p-hacking występują razem, krzywa może pozostać prawoskośna. Parametry scenariuszy (d, liczebności, sposób dokładania osób) dobrano ręcznie; liczbę badań zwiększono z 10 000 do 20 000 po pierwszym uruchomieniu, bo krzywa bez efektu była zbyt zaszumiona, a ziarna 3880 nie zmieniano.
Podpis do pracy:
Kod R rysunku 1
# Rysunek 1: p-curve przy prawdziwym efekcie, przy braku efektu i przy p-hackingu (symulacja)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("#0072B2", "grey40", "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA))

p_t <- function(a, b) t.test(a, b, var.equal = TRUE)$p.value
set.seed(3880)
R <- 20000                                    # badań w każdym scenariuszu
# 1) prawdziwy efekt d = 0.5, 30 osób w grupie
p_efekt <- replicate(R, { a <- rnorm(30, 0.5); b <- rnorm(30); c(p_t(a, b), mean(a) > mean(b)) })
# 2) brak efektu, 30 osób w grupie
p_zero  <- replicate(R, { a <- rnorm(30); b <- rnorm(30); c(p_t(a, b), mean(a) > mean(b)) })
# 3) p-hacking przy braku efektu: start od 20 osób w grupie, dokładanie po 5 (do 50), stop przy p < .05
p_hack  <- replicate(R, {
  a <- rnorm(20); b <- rnorm(20)
  repeat {
    p <- p_t(a, b)
    if ((p < .05 && mean(a) > mean(b)) || length(a) >= 50) break
    a <- c(a, rnorm(5)); b <- c(b, rnorm(5))
  }
  c(p, mean(a) > mean(b))
})
krzywa <- function(m, nazwa) {                # tylko istotne wyniki w oczekiwanym kierunku
  p <- m[1, m[1, ] < .05 & m[2, ] == 1]
  odsetek <- as.numeric(table(cut(p, seq(0, .05, .01)))) / length(p)
  data.frame(scenariusz = nazwa, przedzial = 1:5, odsetek = odsetek,
             blad_MC = sqrt(odsetek * (1 - odsetek) / length(p)), istotnych = length(p))
}
pc <- rbind(krzywa(p_efekt, "efekt d = 0.5"), krzywa(p_zero, "brak efektu"),
            krzywa(p_hack, "brak efektu + p-hacking"))
pc$scenariusz <- factor(pc$scenariusz, unique(pc$scenariusz))
print(transform(pc, odsetek = round(100 * odsetek, 1), blad_MC = round(100 * blad_MC, 1)), row.names = FALSE)

p1 <- ggplot(pc, aes(przedzial, 100 * odsetek, colour = scenariusz, linetype = scenariusz, shape = scenariusz)) +
  geom_hline(yintercept = 20, linetype = "dotted", colour = "grey50") +
  geom_line(linewidth = 1.1) + geom_point(size = 3.2, fill = "white", stroke = 1.2) +
  annotate("text", x = 5, y = 17.5, hjust = 1, size = 3.6, colour = "grey30", label = "20% – krzywa płaska") +
  scale_x_continuous(breaks = 1:5, labels = c(".00–.01", ".01–.02", ".02–.03", ".03–.04", ".04–.05")) +
  scale_y_continuous(limits = c(0, 60), breaks = seq(0, 60, 10)) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("solid", "dotted", "dashed"), name = NULL) +
  scale_shape_manual(values = c(21, 22, 24), name = NULL) +
  labs(x = "Wartość p (tylko p < .05)", y = "Odsetek istotnych wyników (%)") + motyw

p1   # zapis: ggsave("p-curve-trzy-krzywe.svg", p1, width = 8, height = 5.2)
Wynik w R
              scenariusz przedzial odsetek blad_MC istotnych
           efekt d = 0.5         1    51.6     0.5      9525
           efekt d = 0.5         2    18.0     0.4      9525
           efekt d = 0.5         3    12.6     0.3      9525
           efekt d = 0.5         4     9.7     0.3      9525
           efekt d = 0.5         5     8.1     0.3      9525
             brak efektu         1    19.5     1.7       527
             brak efektu         2    18.4     1.7       527
             brak efektu         3    17.8     1.7       527
             brak efektu         4    20.1     1.7       527
             brak efektu         5    24.1     1.9       527
 brak efektu + p-hacking         1     7.9     0.7      1356
 brak efektu + p-hacking         2    15.5     1.0      1356
 brak efektu + p-hacking         3    19.8     1.1      1356
 brak efektu + p-hacking         4    26.8     1.2      1356
 brak efektu + p-hacking         5    30.1     1.2      1356
Rysunek na stronie powstał z tego kodu z motywem serwisu (dane, geometrie i skale identyczne). Kod liczy się kilka sekund.
Jak opisać w pracy
Na co uważać
- Dobór wartości p. Z każdego badania bierze się jedno p dla hipotezy autorów, a wyniki muszą być niezależne. Błędy w doborze wartości p mogą zniekształcić wynik analizy (Simonsohn i in., 2015).
- Mało wyników. Przy kilkunastu istotnych p oba testy mają małą moc.
- Wartość dowodowa to nie wielkość efektu. Prawoskośna krzywa mówi, że efekt istnieje, ale nie mówi, jak jest duży. Do korekty efektu łącznego służą m.in. PET-PEESE i model selekcji.
Zestawienie metod pokazuje wpis Błąd publikacji w metaanalizie.
P-curve w R
Pakiet do p-curve nie jest potrzebny: funkcja pcurve() liczy pp-wartości, test prawoskośności Stouffera i test płaskości wobec mocy 33% dla testów z. Kod porównuje literaturę z prawdziwym efektem i literaturę bez efektu.
Test prawoskośności i płaskości dla dwóch symulowanych literatur
R
suppressPackageStartupMessages(library(metafor))
gen <- function(d, k) {                       # k badań; d – prawdziwy efekt (tau = 0.10)
  n  <- sample(15:100, k, replace = TRUE)     # osób w grupie
  yi <- sapply(n, function(m) { a <- rnorm(m, rnorm(1, d, 0.10)); b <- rnorm(m)
                                (mean(a) - mean(b)) / sqrt((var(a) + var(b)) / 2) })
  dat <- data.frame(n = n, yi = yi, vi = 2 / n + yi^2 / (4 * n))
  dat$sei <- sqrt(dat$vi)
  dat$p   <- 2 * pnorm(abs(dat$yi / dat$sei), lower.tail = FALSE)  # p dwustronne
  dat[(dat$p < .05 & dat$yi > 0) | runif(k) < .15, ]                 # „publikacja”
}
pcurve <- function(dat) {                     # tylko istotne wyniki w oczekiwanym kierunku
  s  <- dat[dat$p < .05 & dat$yi > 0, ]
  z  <- s$yi / s$sei
  pp <- s$p / .05                             # pp-wartości przy H0: brak efektu
  ncp <- qnorm(.975) - qnorm(2/3)             # moc 33% (test z)
  pp33 <- 3 * pnorm(z, ncp, lower.tail = FALSE)
  Zr <- sum(qnorm(pp)) / sqrt(nrow(s))        # prawoskośność (Stouffer)
  Zf <- sum(qnorm(pp33)) / sqrt(nrow(s))      # płaskość wobec mocy 33%
  c(k = nrow(s), Z_prawo = Zr, p_prawo = pnorm(Zr),
    Z_33 = Zf, p_33 = pnorm(Zf, lower.tail = FALSE))
}
set.seed(387); dat <- gen(0.2, 120)           # prawdziwe d = 0.2
set.seed(388); d0  <- gen(0, 300)             # prawdziwe d = 0
round(rbind(efekt = pcurve(dat), zero = pcurve(d0)), 4)
s <- dat[dat$p < .05 & dat$yi > 0, ]
table(cut(s$p, seq(0, .05, .01)))             # rozkład istotnych p
s0 <- d0[d0$p < .05 & d0$yi > 0, ]
table(cut(s0$p, seq(0, .05, .01)))
Wynik w R
       k Z_prawo p_prawo    Z_33   p_33
efekt 26 -4.2763  0.0000 -0.7491 0.7731
zero  12 -0.4094  0.3411  1.6477 0.0497

   (0,0.01] (0.01,0.02] (0.02,0.03] (0.03,0.04] (0.04,0.05]
         14           5           4           2           1

   (0,0.01] (0.01,0.02] (0.02,0.03] (0.03,0.04] (0.04,0.05]
          5           2           2           0           3
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet metafor i funkcja t.test() z pakietu stats); rysunek wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.2.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Co oznacza prawoskośna p-curve?
Że wśród istotnych wyników jest więcej bardzo małych wartości p (ok. .01) niż bliskich progu (ok. .04). Taki rozkład powstaje, gdy efekt istnieje, więc zestaw badań ma wartość dowodową.
Czy p-curve wymaga nieopublikowanych badań?
Nie. Analiza korzysta wyłącznie z wyników istotnych, czyli tych, które zwykle są publikowane. To jej przewaga nad metodami potrzebującymi pełnego lejka badań.
Jak policzyć p-curve w R?
Wystarczy kilka linijek: pp-wartość to p/.05, a test prawoskośności to pnorm(sum(qnorm(pp)) / sqrt(k)). Test płaskości wymaga pp-wartości liczonych przy mocy 33% – pełny kod jest w przykładzie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Błąd publikacji w metaanalizie – metody
Lejek i test Eggera, trim-and-fill, PET-PEESE, model selekcji, p-curve i fail-safe N porównane na jednej symulacji w R, z wzorem opisu.
Czytaj →PoradnikMetaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Simonsohn, U., Nelson, L. D., & Simmons, J. P. (2014). P-curve: A key to the file-drawer. Journal of Experimental Psychology: General, 143(2), 534–547. https://doi.org/10.1037/a0033242
- Simonsohn, U., Simmons, J. P., & Nelson, L. D. (2015). Better P-curves: Making P-curve analysis more robust to errors, fraud, and ambitious P-hacking, a reply to Ulrich and Miller (2015). Journal of Experimental Psychology: General, 144(6), 1146–1152. https://doi.org/10.1037/xge0000104 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{simonsohn2014pcurve, author={Simonsohn, Uri and Nelson, Leif D. and Simmons, Joseph P.}, title={{P-curve: A key to the file-drawer}}, journal={Journal of Experimental Psychology: General}, year={2014}, volume={143}, number={2}, pages={534--547}, doi={10.1037/a0033242}}@article{simonsohn2015better, author={Simonsohn, Uri and Simmons, Joseph P. and Nelson, Leif D.}, title={{Better P-curves: Making P-curve analysis more robust to errors, fraud, and ambitious P-hacking, a reply to Ulrich and Miller (2015)}}, journal={Journal of Experimental Psychology: General}, year={2015}, volume={144}, number={6}, pages={1146--1152}, doi={10.1037/xge0000104}}