Ocena ekspercka jako metoda pretestu
Zanim kwestionariusz trafi do respondentów, warto pokazać go osobom, które znają temat albo metodologię badań sondażowych. Najprostsza wersja to nieformalna prośba o uwagi. Ten wpis dotyczy wersji formalnej: każdy ekspert ocenia każdą pozycję według tej samej instrukcji i na tych samych skalach, a decyzje o zmianach wynikają z liczb ustalonych przed zebraniem ocen.
Ocena ekspercka nie wymaga zbierania danych od respondentów, więc jest tania i szybka. Nie jest przy tym metodą słabszą od innych. Presser i Blair (1994) porównali cztery metody pretestu na jednym kwestionariuszu. Panele ekspertów wykryły średnio najwięcej problemów i obok wywiadów poznawczych jako jedyne wskazały wiele problemów analitycznych, czyli takich, które utrudnią późniejszą analizę danych. Obok kodowania zachowań dawały też najbardziej powtarzalne wyniki między kolejnymi próbami. Problemy ankieterów wykrywał natomiast głównie zwykły pretest i kodowanie zachowań.
Podstawy wskaźnika CVI opisuje hasło trafność treściowa (CVI), a miary zgodności – wpis zgodność sędziów: kappa, ICC i alfa Krippendorffa. Tu łączymy je w jedną procedurę: lista kontrolna QAS-99, oceny trafności i jasności, zgodność ekspertów i reguła decyzji. Wszystko liczymy na jednym symulowanym panelu w R.
QAS-99: lista kontrolna problemów z pytaniem
QAS-99 (ang. Question Appraisal System) to formalny system oceny pytań. Oceniający przechodzi przez każde pytanie etapami, od odczytania do udzielenia odpowiedzi, i przy każdym etapie zaznacza, czy widzi problem. Rothgeb i in. (2007) porównali taki formalny system z nieformalnym przeglądem ekspertów i z wywiadem poznawczym na trzech kwestionariuszach w trzech instytucjach badawczych. Maitland i Presser (2016) uwzględnili QAS wśród metod oceny pytań, które nie wymagają zbierania danych.
| Etap QAS-99 | O co pyta oceniający | Przykład problemu |
|---|---|---|
| Czytanie | Czy pytanie łatwo przeczytać w całości? | Długie zdanie z wtrąceniem |
| Instrukcje | Czy wiadomo, ile odpowiedzi zaznaczyć i czego dotyczy pytanie? | Brak informacji „zaznacz wszystkie pasujące” |
| Jasność | Czy słowa i okres odniesienia są jednoznaczne? | „Ostatnio”, termin fachowy bez definicji |
| Założenia | Czy pytanie zakłada coś, co nie dotyczy wszystkich? | Pytanie o przełożonego zadane także osobom pracującym na własny rachunek; pytanie dwuznaczne |
| Wiedza i pamięć | Czy respondent zna odpowiedź i umie ją przypomnieć? | Liczba e-maili w ostatnim miesiącu |
| Drażliwość i stronniczość | Czy brzmienie jest drażliwe albo podsuwa odpowiedź? | Pytanie sugerujące |
| Kategorie odpowiedzi | Czy kategorie pasują do pytania, są rozłączne i wyczerpujące? | Skala zgody przy pytaniu o częstość, nakładające się przedziały w kafeterii |
| Inne | Czy jest problem spoza listy? | Pozycja nie pasuje do instrukcji całej skali |
Lista ma dwie zalety. Ekspert treściowy, który nie zna metodologii sondaży, dostaje gotowy zestaw rzeczy do sprawdzenia. Zgłoszenia od kilku ekspertów można też zliczać według kategorii, a więc porównywać. W przykładzie pomijamy etapy „czytanie” i „inne” i używamy sześciu kategorii.
Panel ekspertów: kto, ilu i z jaką instrukcją
Lynn (1986) to klasyczny artykuł o ustalaniu i ilościowym ujęciu trafności treściowej. Grant i Davis (1997) zwracają uwagę, że błędy w ocenie biorą się często z nieprzemyślanego doboru i przygotowania ekspertów. Szczególnie często pomija się zapoznanie ich z podstawami pojęciowymi i modelem pomiaru narzędzia. W praktyce oznacza to trzy decyzje.
- Skład. Połącz ekspertów od treści konstruktu (badacze, praktycy) z co najmniej jedną osobą od metodologii kwestionariuszy. Pierwsi ocenią trafność, drudzy wyłapią więcej problemów z listy QAS. Przy narzędziu dla konkretnej grupy dodaj osobę, która z tą grupą pracuje.
- Liczba. Polit i in. (2007) proponują próg I-CVI ≥ .78 przy co najmniej trzech ekspertach. Ile osób zaprosić, pokazuje symulacja niżej. Licz się z tym, że część zaproszonych nie odeśle ocen.
- Pakiet dla eksperta. Definicja konstruktu i jego wymiarów, opis populacji i trybu ankiety, cała instrukcja dla respondenta, pozycje w docelowej kolejności z kategoriami odpowiedzi, dwie skale ocen (trafność i jasność, 1–4) z opisem punktów, lista QAS z krótkim opisem kategorii i pole na komentarz przy każdej pozycji.
Regułę decyzji zapisz przed rozesłaniem pakietu. Bez niej łatwo dopasować próg do wyników. Gdy chcesz, by eksperci doszli do wspólnego stanowiska w kilku rundach, sięgnij po metodę delficką i jasno zdefiniuj konsensus ekspertów.
Przykład: 8 ekspertów i 20 pozycji
Zespół przygotował 20-pozycyjną skalę przeciążenia cyfrowego w pracy (narzędzie fikcyjne). Ośmiu ekspertów oceniło każdą pozycję pod względem trafności (1–4) i jasności (1–4) oraz zaznaczyło problemy z listy QAS. Dane są symulowane, więc znamy prawdę. Pozycje P6, P13 i P18 wykraczają poza konstrukt. P4 i P11 są niejasne, P16 zawiera ukryte założenie, P8 wymaga trudnego przypomnienia, a P20 ma kategorie odpowiedzi niepasujące do pytania. Eksperci różnią się surowością i spostrzegawczością: każdy wykrywa prawdziwy problem z innym prawdopodobieństwem, od 35% do 75%.
Reguła decyzji, ustalona przed zebraniem ocen, ma trzy poziomy. Pozycja z I-CVI < .78 idzie do przeglądu treści. Pozycja trafna, ale z jasnością < .78 (odsetek ocen 3–4) albo zgłoszona przez co najmniej dwóch ekspertów w tej samej kategorii QAS, idzie do poprawy brzmienia. Pozostałe zostają bez zmian. Przy ośmiu ekspertach próg .78 oznacza co najmniej 7 ocen „trafna”, czyli dopuszcza jedną ocenę negatywną.
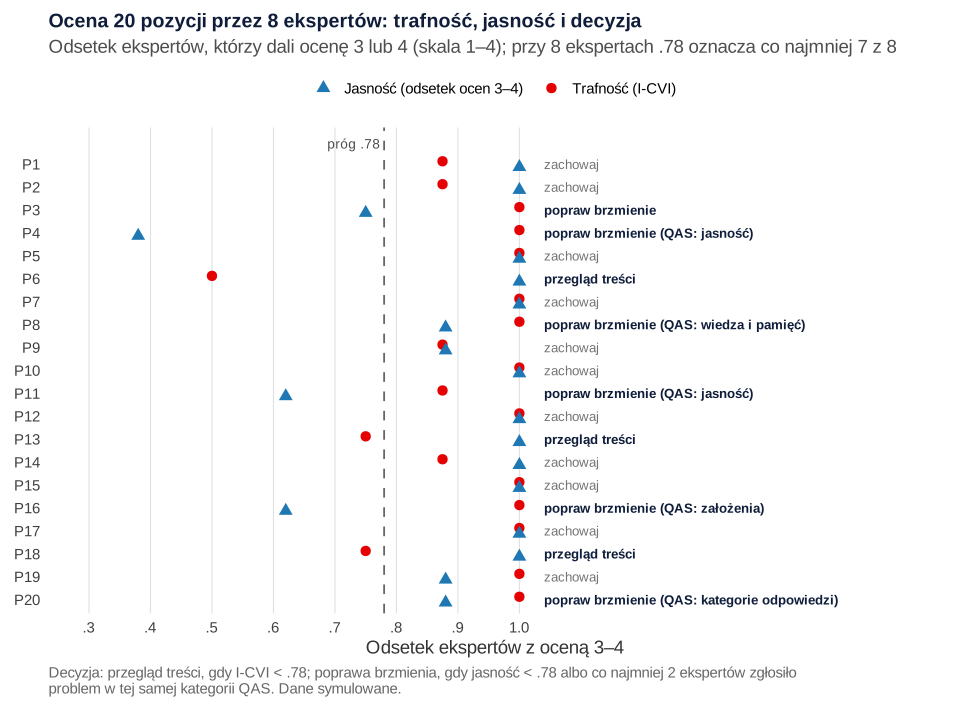
Trzy pozycje spoza konstruktu wypadły poniżej progu: P6 z I-CVI = .50 (κ* = .31) oraz P13 i P18 z I-CVI = .75. Te dwie ostatnie pokazują, jak gruba jest ta miara przy małym panelu. Sześć ocen „trafna” na osiem daje I-CVI = .75, czyli poniżej progu, choć zmodyfikowana kappa wynosi .72. Siedem ocen daje już .875 (κ* = .87). Pozycja graniczna P9 dostała 7 ocen i przeszła.
Do poprawy brzmienia trafiło sześć pozycji. Pięć z nich to prawdziwe problemy. P11 zgłosiło w kategorii „jasność” wszystkich ośmiu ekspertów, P4 sześciu, P8 („wiedza i pamięć”) i P16 („założenia”) po czterech, a P20 („kategorie odpowiedzi”) trzech. Zwróć uwagę na P8 i P20. Ich jasność wyniosła .88, więc sama skala jasności by je przepuściła. Wyłapała je dopiero lista QAS. Szósta pozycja, P3, trafiła do poprawy tylko z powodu jasności .75 (dwie oceny 1–2) bez żadnego zgłoszenia QAS. W symulacji P3 nie ma wady. Taki sygnał przejrzyj razem z komentarzami ekspertów, zanim cokolwiek zmienisz.
Dla całej skali S-CVI/Ave = .919, a S-CVI/UA = .600. Po usunięciu trzech pozycji spoza konstruktu wskaźniki wzrosły do .963 i .706. Na wniosek z oceny ekspertów składa się jednak przede wszystkim tabela decyzji dla poszczególnych pozycji, a nie jedna liczba dla całej skali.
Zgodność ekspertów: co policzyć i jak czytać
CVI mówi, czy eksperci uznają pozycję za trafną. Miary zgodności odpowiadają na inne pytanie: czy oceny ekspertów są wymienne, czyli czy wynik zależy od tego, kogo zaprosisz. Recenzenci często o nie pytają. W przykładzie policzyliśmy je dla trzech zapisów tych samych ocen.
| Dane | Zgodność obserwowana | Miara klasyczna | Miara Gweta |
|---|---|---|---|
| Trafność 1–4 | .817 (ważona) | alfa Krippendorffa (porządkowa) = .250 | AC2 (porządkowy) = .608 |
| Trafna (3–4) czy nie | .866 | kappa Fleissa = .103 | AC1 = .843 |
| Zgłoszony problem QAS | .791 | kappa Fleissa = .389 | AC1 = .683 |
Dla ocen trafności 1–4 ICC(A,1) wyniosło .307, 95% CI [.160, .525], a ICC(A,8) dla średniej z ośmiu ocen .780, 95% CI [.601, .899] (zob. ICC). Pojedynczy ekspert jest więc mało rzetelny. Średnia z panelu jest rzetelna, bo przypadkowe różnice między ekspertami się uśredniają.
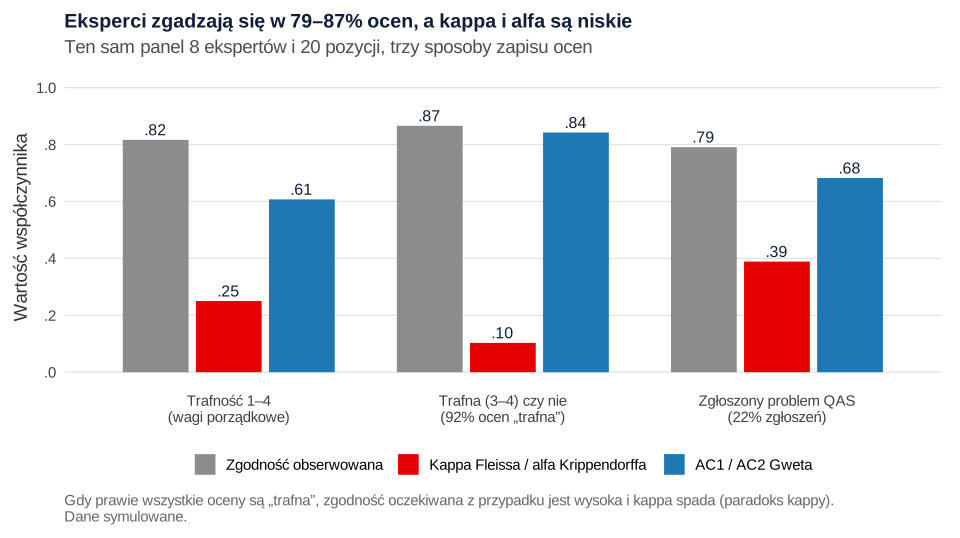
Najbardziej uderza drugi wiersz tabeli. Eksperci zgodzili się w 86.6% par ocen, a kappa Fleissa wyniosła .103. To paradoks kappy: 91.9% wszystkich ocen to „trafna”, więc zgodność oczekiwana z przypadku jest bardzo wysoka i niewiele zostaje na zgodność ponad przypadek. Gwet (2008) zaproponował współczynnik AC1, stabilniejszy przy wysokiej zgodności. Tu wyniósł .843. Ten sam mechanizm obniża alfę Krippendorffa dla ocen 1–4. Paradoks nie wynika z wylosowanego panelu. W 1000 panelach 8-osobowych mediana kappy wyniosła .187 (90% wyników od .041 do .379), a AC1 – .821 (od .705 do .902).
W ocenie eksperckiej paradoks pojawia się prawie zawsze, bo dobrze przygotowane pozycje mają być oceniane jako trafne. Podaj więc zgodność obserwowaną, miarę klasyczną i AC1 Gweta razem, z odsetkiem ocen „trafna”. Nie wybieraj miary tylko dlatego, że daje wyższą liczbę. Kiedy która miara pasuje, wyjaśnia wpis o zgodności sędziów.
Eksperci się nie zgadzają, a panel i tak działa
Niska zgodność zgłoszeń QAS (kappa .389) nie znaczy, że ocena ekspercka zawiodła. Olson (2010) poprosiła sześciu ekspertów o ocenę pytań, dla których istniały dane walidacyjne z dokumentacji. Oceny poszczególnych ekspertów były bardzo niespójne. Średnie oceny panelu trafnie wskazały jednak pytania z większym odsetkiem braków odpowiedzi i nietrafnych odpowiedzi.
Symulacja daje ten sam obraz. Pojedynczy ekspert wskazał średnio 65% prawdziwych problemów (od 20% do 100% zależnie od osoby) i zgłaszał fałszywy alarm przy 7.5% dobrych pozycji. Reguła „co najmniej dwóch ekspertów w tej samej kategorii” wykryła w tym panelu wszystkie pięć problemów i nie dała fałszywego alarmu. Każdy ekspert zauważa coś innego, a zliczanie zgłoszeń według kategorii odsiewa pojedyncze pomyłki.
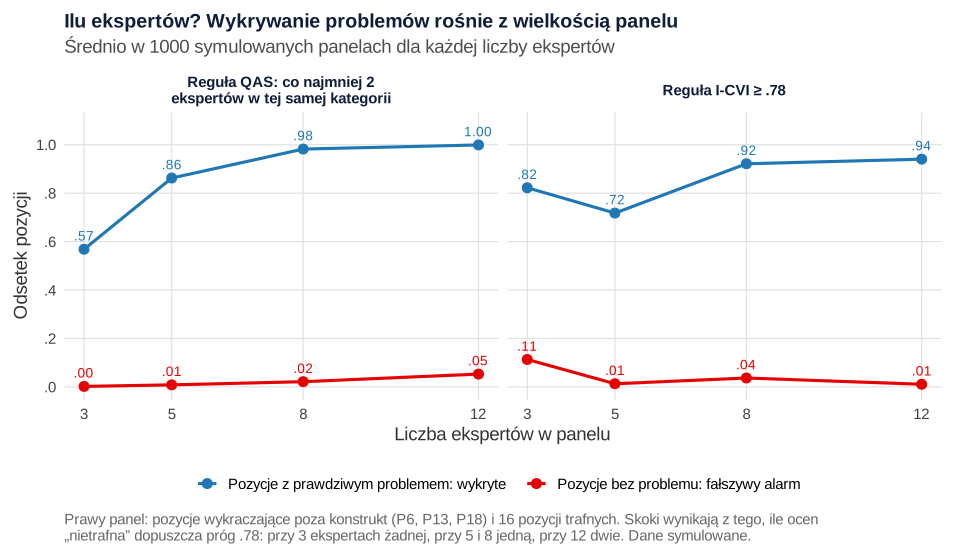
Ilu ekspertów zaprosić? Przy trzech osobach reguła QAS wykryła średnio 57% prawdziwych problemów, przy pięciu 86%, przy ośmiu 98%. Przy dwunastu fałszywe alarmy wzrosły do 5%, bo dwa przypadkowe zgłoszenia łatwiej zebrać w większym panelu. Wtedy podnieś próg, np. do 25% ekspertów. Reguła I-CVI zachowuje się nieregularnie, bo próg .78 dopuszcza różną liczbę ocen negatywnych: przy trzech ekspertach żadnej, przy pięciu i ośmiu jedną, przy dwunastu dwie. Przy trzech ekspertach co dziewiąta dobra pozycja (11%) spadała poniżej progu, a przy pięciu wykrycie słabych pozycji spadło do 72%. Panel ośmiu osób wychwycił wszystkie trzy słabe pozycje w 79.6% powtórzeń, więc nasz przykład jest typowy. Pięć do dziesięciu ekspertów to w tym scenariuszu rozsądny zakres. Liczby zależą jednak od spostrzegawczości ekspertów i siły problemów, więc w ważnym projekcie powtórz symulację z własnymi założeniami.
Ekspert, wywiad poznawczy czy pilotaż
Metody pretestu wykrywają różne problemy i najlepiej działają razem. Maitland i Presser (2016) porównali, jak dobrze różne metody przewidują rzetelność odpowiedzi. Zalecili łączenie metod: zestaw obejmujący m.in. QAS, przegląd ekspercki i wywiady poznawcze przewidywał rzetelność tak dobrze jak wszystkie siedem badanych metod razem. Presser i in. (2004) przypominają przy tym, że raporty z badań rzadko mówią, czy i jak pretest przeprowadzono.
| Metoda | Co wykrywa najlepiej | Czego nie wykryje |
|---|---|---|
| Ocena ekspercka z QAS i CVI | Pozycje spoza konstruktu, luki w treści, problemy analityczne, typowe wady brzmienia | Jak naprawdę rozumieją pytanie respondenci |
| Wywiad poznawczy | Rozumienie słów, przywoływanie informacji, dopasowanie odpowiedzi | Rozkłady, braki danych i czas w większej próbie |
| Pilotaż | Czas wypełniania, rozkłady, braki, spójność skal | Przyczynę problemu w konkretnej pozycji |
| Eksperyment split-ballot | Czy zmiana brzmienia zmienia rozkład odpowiedzi | Która wersja jest trafniejsza, jeśli brak kryterium |
Rozsądna kolejność to ocena ekspercka, poprawki, wywiady poznawcze z poprawionymi pozycjami i dopiero potem pilotaż oraz test techniczny ankiety online. Przy adaptacji istniejącego narzędzia ocena ekspertów to jeden z etapów adaptacji kulturowej kwestionariusza. Ocena trafności przez respondentów to osobne zagadnienie – trafność fasadowa. Pełną ścieżkę od definicji konstruktu do walidacji opisuje wpis jak zbudować i zwalidować skalę psychometryczną.
Jak opisać ocenę ekspercką w artykule
Opisz skład panelu (dziedziny, nie nazwiska), liczbę zaproszonych i odsyłających ocen, materiały i skale ocen, regułę decyzji ustaloną przed zebraniem ocen, wskaźniki dla pozycji i skali, miary zgodności z zgodnością obserwowaną oraz listę zmian.
Jeśli przygotowujesz walidację nowej skali i chcesz zaplanować panel, regułę decyzji i analizę zgodności, możemy to zrobić wspólnie w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi i trzeci korzystają z funkcji i obiektów z pierwszego). Pierwszy zapisuje oceny ekspertów do pliku oceny-ekspertow.csv (możesz go pobrać tutaj). Potrzebne pakiety: irr i irrCAC.
1. I-CVI, kappa zmodyfikowana, jasność i zgłoszenia QAS
R
# Krok 1. Panel 8 ekspertów ocenia 20 pozycji nowej skali (dane symulowane)
# Każdy ekspert: trafność 1–4, jasność 1–4 i kody problemów z listy QAS (0/1 w sześciu kategoriach).
kat <- c("instrukcje", "jasnosc", "zalozenia", "wiedza_pamiec", "drazliwosc", "kategorie_odp")
I <- 20; K <- 8
# Prawda znana tylko w symulacji: P6, P13 i P18 wykraczają poza konstrukt, P9 jest graniczna;
# P4 i P11 są niejasne, P16 zawiera ukryte założenie, P8 wymaga trudnego przypomnienia, P20 ma złe kategorie odpowiedzi.
mu_traf <- rep(3.6, I); mu_traf[c(6, 13, 18)] <- 2.6; mu_traf[9] <- 3.1
mu_jas <- rep(3.6, I); mu_jas[c(4, 11, 16)] <- 2.5
problem <- rep(NA_character_, I)
problem[c(4, 11)] <- "jasnosc"; problem[16] <- "zalozenia"; problem[8] <- "wiedza_pamiec"; problem[20] <- "kategorie_odp"

panel <- function(K, fa = 0.012) {
  b <- rnorm(K, 0, 0.3)                    # łagodność / surowość eksperta
  czulosc <- runif(K, 0.35, 0.75)          # jak często ekspert zauważa prawdziwy problem
  ocena <- function(mu) pmin(pmax(round(outer(mu, b, "+") + matrix(rnorm(I * K, 0, 0.55), I)), 1), 4)
  qas <- array(0L, c(I, K, length(kat)), dimnames = list(NULL, NULL, kat))
  for (i in 1:I) for (j in 1:K) for (c in seq_along(kat))
    qas[i, j, c] <- rbinom(1, 1, if (!is.na(problem[i]) && kat[c] == problem[i]) czulosc[j] else fa)
  list(traf = ocena(mu_traf), jas = ocena(mu_jas), qas = qas)
}

set.seed(3692)
p <- panel(K)
oceny <- data.frame(pozycja = rep(paste0("P", 1:I), K), ekspert = rep(paste0("E", 1:K), each = I),
                    trafnosc = c(p$traf), jasnosc = c(p$jas), apply(p$qas, 3, c))
write.csv(oceny, "oceny-ekspertow.csv", row.names = FALSE)

# Trafność treściowa: I-CVI i kappa zmodyfikowana (Polit i in., 2007)
A <- rowSums(p$traf >= 3)
icvi <- A / K
pc <- choose(K, A) * 0.5^K
kappa_gw <- (icvi - pc) / (1 - pc)
jasn <- rowMeans(p$jas >= 3)                              # odsetek ocen 3–4 dla jasności
flagi <- apply(p$qas, c(1, 2), max)                       # czy ekspert zgłosił jakikolwiek problem
n_kat <- apply(p$qas, c(1, 3), sum)                       # ilu ekspertów zgłosiło problem w danej kategorii
decyzja <- ifelse(icvi < .78, "przeglad tresci",
                  ifelse(jasn < .78 | apply(n_kat, 1, max) >= 2, "popraw brzmienie", "zachowaj"))
tab <- data.frame(pozycja = paste0("P", 1:I), A, I_CVI = icvi, pc = round(pc, 3), kappa_gw = round(kappa_gw, 2),
                  jasnosc = round(jasn, 2), flagi_QAS = rowSums(flagi), max_kat = apply(n_kat, 1, max),
                  kategoria = ifelse(apply(n_kat, 1, max) >= 2, kat[apply(n_kat, 1, which.max)], "-"), decyzja)
print(tab, row.names = FALSE)
cat("Najmniejsza liczba ocen 3–4 dająca I-CVI >= .78 przy", K, "ekspertach:", ceiling(.78 * K), "\n")
round(c(S_CVI_Ave = mean(icvi), S_CVI_UA = mean(icvi == 1),
        S_CVI_Ave_po_usunieciu = mean(icvi[icvi >= .78]), S_CVI_UA_po_usunieciu = mean(icvi[icvi >= .78] == 1)), 3)
table(decyzja)
Wynik w R
 pozycja A I_CVI    pc kappa_gw jasnosc flagi_QAS max_kat     kategoria
      P1 7 0.875 0.031     0.87    1.00         1       1             -
      P2 7 0.875 0.031     0.87    1.00         0       0             -
      P3 8 1.000 0.004     1.00    0.75         0       0             -
      P4 8 1.000 0.004     1.00    0.38         7       6       jasnosc
      P5 8 1.000 0.004     1.00    1.00         1       1             -
      P6 4 0.500 0.273     0.31    1.00         1       1             -
      P7 8 1.000 0.004     1.00    1.00         1       1             -
      P8 8 1.000 0.004     1.00    0.88         4       4 wiedza_pamiec
      P9 7 0.875 0.031     0.87    0.88         0       0             -
     P10 8 1.000 0.004     1.00    1.00         1       1             -
     P11 7 0.875 0.031     0.87    0.62         8       8       jasnosc
     P12 8 1.000 0.004     1.00    1.00         1       1             -
     P13 6 0.750 0.109     0.72    1.00         1       1             -
     P14 7 0.875 0.031     0.87    1.00         1       1             -
     P15 8 1.000 0.004     1.00    1.00         0       0             -
     P16 8 1.000 0.004     1.00    0.62         4       4     zalozenia
     P17 8 1.000 0.004     1.00    1.00         0       0             -
     P18 6 0.750 0.109     0.72    1.00         0       0             -
     P19 8 1.000 0.004     1.00    0.88         1       1             -
     P20 8 1.000 0.004     1.00    0.88         3       3 kategorie_odp
          decyzja
         zachowaj
         zachowaj
 popraw brzmienie
 popraw brzmienie
         zachowaj
  przeglad tresci
         zachowaj
 popraw brzmienie
         zachowaj
         zachowaj
 popraw brzmienie
         zachowaj
  przeglad tresci
         zachowaj
         zachowaj
 popraw brzmienie
         zachowaj
  przeglad tresci
         zachowaj
 popraw brzmienie
Najmniejsza liczba ocen 3–4 dająca I-CVI >= .78 przy 8 ekspertach: 7
             S_CVI_Ave               S_CVI_UA S_CVI_Ave_po_usunieciu
                 0.919                  0.600                  0.963
 S_CVI_UA_po_usunieciu
                 0.706
decyzja
popraw brzmienie  przeglad tresci         zachowaj
               6                3               11
2. Zgodność ekspertów i trafność zgłoszeń panelu
R
# Krok 2. Zgodność ekspertów: oceny trafności 1–4, trafność dychotomiczna i zgłoszenia QAS
# (wymaga obiektów z kroku 1)
suppressPackageStartupMessages({library(irr); library(irrCAC)})
traf <- as.data.frame(p$traf)                 # 20 pozycji × 8 ekspertów
traf_01 <- as.data.frame((p$traf >= 3) * 1)   # trafna (3–4) vs nietrafna (1–2)
qas_01 <- as.data.frame(flagi)                # zgłoszony jakikolwiek problem QAS

wiersz <- function(x) c(zgodnosc_obs = x$pa, wspolczynnik = x$coeff.val, SE = x$coeff.se)
icc1 <- icc(traf, model = "twoway", type = "agreement", unit = "single")
icck <- icc(traf, model = "twoway", type = "agreement", unit = "average")
round(c(ICC_A1 = icc1$value, dolna = icc1$lbound, gorna = icc1$ubound,
        ICC_Ak = icck$value, dolna = icck$lbound, gorna = icck$ubound), 3)
zg <- rbind(
  traf_alfa_Krippendorffa_ord = wiersz(krippen.alpha.raw(traf, weights = "ordinal")$est),
  traf_AC2_Gweta_ord          = wiersz(gwet.ac1.raw(traf, weights = "ordinal")$est),
  traf01_kappa_Fleissa        = wiersz(fleiss.kappa.raw(traf_01)$est),
  traf01_AC1_Gweta            = wiersz(gwet.ac1.raw(traf_01)$est),
  qas_kappa_Fleissa           = wiersz(fleiss.kappa.raw(qas_01)$est),
  qas_AC1_Gweta               = wiersz(gwet.ac1.raw(qas_01)$est))
print(round(zg, 3))
cat("Odsetek ocen 'trafna' (3–4):", round(mean(p$traf >= 3), 3), "; odsetek zgłoszeń QAS:", round(mean(flagi), 3), "\n")

# Czy panel znajduje prawdziwe problemy? (prawda znana tylko w symulacji)
prawdziwy <- !is.na(problem)
reg_panel <- apply(n_kat, 1, max) >= 2                   # reguła: >= 2 ekspertów w tej samej kategorii QAS
pojedynczy <- t(sapply(1:K, function(j) c(czulosc = mean(flagi[prawdziwy, j]), falszywe_alarmy = mean(flagi[!prawdziwy, j]))))
round(rbind(pojedynczy_ekspert_srednio = colMeans(pojedynczy),
            pojedynczy_min = apply(pojedynczy, 2, min), pojedynczy_max = apply(pojedynczy, 2, max),
            panel_regula_2_w_kategorii = c(mean(reg_panel[prawdziwy]), mean(reg_panel[!prawdziwy]))), 3)
Wynik w R
ICC_A1  dolna  gorna ICC_Ak  dolna  gorna
 0.307  0.160  0.525  0.780  0.601  0.899
                            zgodnosc_obs wspolczynnik    SE
traf_alfa_Krippendorffa_ord        0.817        0.250 0.088
traf_AC2_Gweta_ord                 0.815        0.608 0.055
traf01_kappa_Fleissa               0.866        0.103 0.080
traf01_AC1_Gweta                   0.866        0.843 0.057
qas_kappa_Fleissa                  0.791        0.389 0.146
qas_AC1_Gweta                      0.791        0.683 0.084
Odsetek ocen 'trafna' (3–4): 0.919 ; odsetek zgłoszeń QAS: 0.219
                           czulosc falszywe_alarmy
pojedynczy_ekspert_srednio    0.65           0.075
pojedynczy_min                0.20           0.000
pojedynczy_max                1.00           0.200
panel_regula_2_w_kategorii    1.00           0.000
3. Ilu ekspertów? Powtórzenia panelu
R
# Krok 3. Ile ekspertów? 1000 powtórzeń panelu dla 3, 5, 8 i 12 osób (wymaga funkcji z kroku 1)
suppressPackageStartupMessages(library(irrCAC))
prawdziwy <- !is.na(problem)
jeden_panel <- function(K) {
  p <- panel(K)
  icvi <- rowSums(p$traf >= 3) / K
  n_kat <- apply(p$qas, c(1, 3), sum)
  reg <- apply(n_kat, 1, max) >= 2
  flagi <- as.data.frame(apply(p$qas, c(1, 2), max))
  t01 <- as.data.frame((p$traf >= 3) * 1)
  c(wykryte_problemy = mean(reg[prawdziwy]), falszywe_alarmy = mean(reg[!prawdziwy]),
    slabe_pozycje_ponizej_78 = mean(icvi[c(6, 13, 18)] < .78), dobre_ponizej_78 = mean(icvi[-c(6, 9, 13, 18)] < .78),
    kappa_traf01 = fleiss.kappa.raw(t01)$est$coeff.val, AC1_traf01 = gwet.ac1.raw(t01)$est$coeff.val)
}
set.seed(3693)
mc <- do.call(rbind, lapply(c(3, 5, 8, 12), function(K) data.frame(K = K, t(replicate(1000, jeden_panel(K))))))
write.csv(round(mc, 4), "mc-panel.csv", row.names = FALSE)
print(round(aggregate(. ~ K, data = mc[, 1:5], FUN = mean), 3), row.names = FALSE)
k8 <- mc[mc$K == 8, ]
round(rbind(kappa_Fleissa = quantile(k8$kappa_traf01, c(.05, .5, .95)), AC1_Gweta = quantile(k8$AC1_traf01, c(.05, .5, .95))), 3)
cat("Odsetek paneli 8-osobowych, w których wszystkie trzy słabe pozycje mają I-CVI < .78:",
    mean(k8$slabe_pozycje_ponizej_78 == 1), "\n")
Wynik w R
  K wykryte_problemy falszywe_alarmy slabe_pozycje_ponizej_78 dobre_ponizej_78
  3            0.568           0.002                    0.822            0.113
  5            0.862           0.009                    0.718            0.013
  8            0.982           0.022                    0.921            0.037
 12            0.999           0.053                    0.940            0.011
                 5%   50%   95%
kappa_Fleissa 0.041 0.187 0.379
AC1_Gweta     0.705 0.821 0.902
Odsetek paneli 8-osobowych, w których wszystkie trzy słabe pozycje mają I-CVI < .78: 0.796
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 z pakietami irr i irrCAC; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- irr (wersja 0.85): Gamer, M., Lemon, J., Fellows, I., & Singh, P. (2026). irr: Various coefficients of interrater reliability and agreement (R package version 0.85) [Computer software]. https://doi.org/10.32614/CRAN.package.irr
- irrCAC (wersja 1.4): Gwet, K. L. (2026). irrCAC: Computing the extent of agreement among raters with chance-corrected agreement coefficient (CAC) (R package version 1.4) [Computer software]. https://doi.org/10.32614/CRAN.package.irrCAC
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Sam S-CVI zamiast decyzji dla pozycji. S-CVI/Ave = .92 nie mówi, które trzy pozycje usunąć.
- Próg dopasowany po zebraniu ocen. Regułę zapisz w protokole przed rozesłaniem pakietu.
- Tylko skala trafności. Bez listy QAS i komentarzy nie wyłapiesz pozycji takich jak P8 i P20, trafnych, ale źle zadanych.
- Kappa bez kontekstu. Przy 90% ocen „trafna” niska kappa jest regułą. Podaj zgodność obserwowaną, odsetek ocen „trafna” i AC1.
- Pojedyncze zgłoszenie jako wyrok. Jeden ekspert myli się częściej niż panel. Zliczaj zgłoszenia według kategorii.
- Eksperci zamiast respondentów. Ocena ekspercka nie zastępuje wywiadu poznawczego ani pilotażu.
Najczęstsze pytania
Ilu ekspertów zaprosić do oceny kwestionariusza?
Próg I-CVI ≥ .78 zaproponowano dla co najmniej trzech ekspertów, ale tak mały panel łatwo przeoczy problem. W symulacji reguła „co najmniej dwóch ekspertów w tej samej kategorii QAS” wykrywała 57% prawdziwych problemów przy trzech ekspertach, 86% przy pięciu i 98% przy ośmiu. Rozsądny zakres to zwykle 5–10 osób, z zapasem na tych, którzy nie odeślą ocen.
Czym jest QAS-99 i jak go użyć w ocenie eksperckiej?
QAS-99 to lista kontrolna, która prowadzi oceniającego przez kolejne etapy odpowiadania na pytanie: czytanie, instrukcje, jasność, założenia, wiedzę i pamięć, drażliwość, kategorie odpowiedzi i inne problemy. Każdy ekspert zaznacza kategorie problemów przy każdej pozycji, a zgłoszenia zlicza się według kategorii. W przykładzie dwie wadliwe pozycje miały dobrą ocenę jasności i wyłapała je dopiero ta lista.
Którą miarę zgodności ekspertów podać przy ocenie trafności pozycji?
Podaj zgodność obserwowaną, miarę klasyczną (kappę Fleissa albo alfę Krippendorffa) i AC1 lub AC2 Gweta oraz odsetek ocen „trafna”. Przy ocenach 1–4 dodaj ICC dla pojedynczego eksperta i dla średniej z panelu. W przykładzie kappa wyniosła .10, a AC1 .84 przy 87% zgodności, bo 92% ocen brzmiało „trafna”.
Czy ocena ekspercka może zastąpić wywiady poznawcze i pilotaż?
Nie. Eksperci dobrze wskazują pozycje spoza konstruktu i typowe wady brzmienia, ale nie wiedzą, jak pytanie rozumieją respondenci. Rozsądna kolejność to ocena ekspercka, poprawki, wywiady poznawcze i dopiero pilotaż.
Co zrobić, gdy tylko jeden ekspert zgłosił problem z pozycją?
Przeczytaj jego komentarz, ale nie zmieniaj pozycji automatycznie. Pojedynczy ekspert w symulacji wykrywał średnio 65% prawdziwych problemów i zgłaszał fałszywy alarm przy 7.5% dobrych pozycji, a reguła co najmniej dwóch zgłoszeń w tej samej kategorii nie dała w tym panelu żadnego fałszywego alarmu.
Powiązane hasła
Przeczytaj też
Trafność treściowa testu wiedzy
Ocena ekspertów dla testu wiedzy: I-CVI, CVR z wartościami krytycznymi, klucz, tabela specyfikacji i druga runda – przykład w R z gotowym opisem.
Czytaj →PoradnikZgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikWywiad poznawczy w pilotażu krok po kroku
Protokół do pobrania, dwie rundy wywiadów, arkusz kodowania według etapów odpowiadania, zliczenie problemów w R, poprawki pytań i wzór opisu w pracy.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Przygotowujesz panel ekspertów dla nowej skali?
Pomożemy zaplanować skład panelu i regułę decyzji, policzyć CVI i zgodność ekspertów oraz przygotować opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Grant, J. S., & Davis, L. L. (1997). Selection and use of content experts for instrument development. Research in Nursing & Health, 20(3), 269–274. https://doi.org/10.1002/(sici)1098-240x(199706)20:3<269::aid-nur9>3.0.co;2-g
- Gwet, K. L. (2008). Computing inter-rater reliability and its variance in the presence of high agreement. British Journal of Mathematical and Statistical Psychology, 61(1), 29–48. https://doi.org/10.1348/000711006x126600
- Lynn, M. R. (1986). Determination and quantification of content validity. Nursing Research, 35(6), 382–386. https://doi.org/10.1097/00006199-198611000-00017
- Maitland, A., & Presser, S. (2016). How accurately do different evaluation methods predict the reliability of survey questions? Journal of Survey Statistics and Methodology, 4(3), 362–381. https://doi.org/10.1093/jssam/smw014
- Olson, K. (2010). An examination of questionnaire evaluation by expert reviewers. Field Methods, 22(4), 295–318. https://doi.org/10.1177/1525822x10379795
- Polit, D. F., Beck, C. T., & Owen, S. V. (2007). Is the CVI an acceptable indicator of content validity? Appraisal and recommendations. Research in Nursing & Health, 30(4), 459–467. https://doi.org/10.1002/nur.20199
- Presser, S., & Blair, J. (1994). Survey pretesting: Do different methods produce different results? Sociological Methodology, 24, 73. https://doi.org/10.2307/270979
- Presser, S., Couper, M. P., Lessler, J. T., Martin, E., Martin, J., Rothgeb, J. M., & Singer, E. (2004). Methods for testing and evaluating survey questions. Public Opinion Quarterly, 68(1), 109–130. https://doi.org/10.1093/poq/nfh008
- Rothgeb, J., Willis, G., & Forsyth, B. (2007). Questionnaire pretesting methods: Do different techniques and different organizations produce similar results? Bulletin of Sociological Methodology/Bulletin de Méthodologie Sociologique, 96(1), 5–31. https://doi.org/10.1177/075910630709600103 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{grant1997selection, author={Grant, Joan S. and Davis, Linda L.}, title={{Selection and use of content experts for instrument development}}, journal={Research in Nursing \& Health}, year={1997}, volume={20}, number={3}, pages={269--274}, doi={10.1002/(sici)1098-240x(199706)20:3<269::aid-nur9>3.0.co;2-g}}@article{gwet2008computing, author={Gwet, Kilem Li}, title={{Computing inter-rater reliability and its variance in the presence of high agreement}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2008}, volume={61}, number={1}, pages={29--48}, doi={10.1348/000711006x126600}}@article{lynn1986determination, author={Lynn, Mary R.}, title={{Determination and quantification of content validity}}, journal={Nursing Research}, year={1986}, volume={35}, number={6}, pages={382--386}, doi={10.1097/00006199-198611000-00017}}@article{maitland2016how, author={Maitland, Aaron and Presser, Stanley}, title={{How accurately do different evaluation methods predict the reliability of survey questions?}}, journal={Journal of Survey Statistics and Methodology}, year={2016}, volume={4}, number={3}, pages={362--381}, doi={10.1093/jssam/smw014}}@article{olson2010examination, author={Olson, Kristen}, title={{An examination of questionnaire evaluation by expert reviewers}}, journal={Field Methods}, year={2010}, volume={22}, number={4}, pages={295--318}, doi={10.1177/1525822x10379795}}@article{polit2007cvi, author={Polit, Denise F. and Beck, Cheryl Tatano and Owen, Steven V.}, title={{Is the CVI an acceptable indicator of content validity? Appraisal and recommendations}}, journal={Research in Nursing \& Health}, year={2007}, volume={30}, number={4}, pages={459--467}, doi={10.1002/nur.20199}}@article{presser1994survey, author={Presser, Stanley and Blair, Johnny}, title={{Survey pretesting: Do different methods produce different results?}}, journal={Sociological Methodology}, year={1994}, volume={24}, pages={73}, doi={10.2307/270979}}@article{presser2004methods, author={Presser, Stanley and Couper, Mick P. and Lessler, Judith T. and Martin, Elizabeth and Martin, Jean and Rothgeb, Jennifer M. and Singer, Eleanor}, title={{Methods for testing and evaluating survey questions}}, journal={Public Opinion Quarterly}, year={2004}, volume={68}, number={1}, pages={109--130}, doi={10.1093/poq/nfh008}}@article{rothgeb2007questionnaire, author={Rothgeb, Jennifer and Willis, Gordon and Forsyth, Barbara}, title={{Questionnaire pretesting methods: Do different techniques and different organizations produce similar results?}}, journal={Bulletin of Sociological Methodology/Bulletin de Méthodologie Sociologique}, year={2007}, volume={96}, number={1}, pages={5--31}, doi={10.1177/075910630709600103}}