Co to jest AC1 Gweta?
AC1 Gweta (ang. Gwet’s AC1, first-order agreement coefficient) to współczynnik zgodności oceniających dla danych nominalnych, skorygowany o zgodność przypadkową. Gwet (2008) zaproponował go jako stabilniejszą alternatywę dla kappy Cohena po analizie źródeł jej paradoksów. Działa dla dwóch i więcej oceniających; dla kategorii uporządkowanych służy jego odmiana ważona (AC2).
Wzór dla dwóch oceniających
Dla tabeli 2 × 2 z liczebnościami A (obaj „tak”), B, C (niezgodności), D (obaj „nie”) i N obiektów (Wongpakaran i in., 2013):
- zgodność obserwowana p = (A + D) / N;
- q = średni odsetek ocen „tak” obu oceniających, czyli suma ich brzegów „tak” podzielona przez 2N;
- zgodność przypadkowa e(γ) = 2q(1 − q);
- AC1 = (p − e(γ)) / (1 − e(γ)).
Kappa liczy zgodność przypadkową z iloczynów brzegów, więc przy rzadkiej kategorii rośnie ona prawie do p i kappa gwałtownie spada. W AC1 zgodność przypadkowa jest wtedy mała.
Przykład
Dwaj oceniający zgadzają się w 90 ze 100 przypadków. Przy zrównoważonych kategoriach kappa i AC1 wynoszą po 0.800. Gdy „nie” jest rzadkie (85 zgodnych „tak”, 5 zgodnych „nie”), kappa spada do 0.444, a AC1 wynosi 0.878. Wongpakaran i in. (2013) w ocenach zaburzeń osobowości stwierdzili, że AC1 mniej zależy od częstości cechy niż kappa i pozostaje bliski odsetkowi zgodności.
Na rysunku
Rysunek rozciąga przykład na wszystkie pośrednie sytuacje. Każda tabela ma 100 obiektów i tę samą zgodność 90% (zawsze 5 + 5 niezgodności), a zmienia się tylko podział 90 zgodnych ocen między „tak” i „nie”. Oś pozioma pokazuje średni odsetek ocen „tak” obu oceniających – od 50% do 94%, czyli do sytuacji, w której zgodnych „nie” zostaje tylko 4.
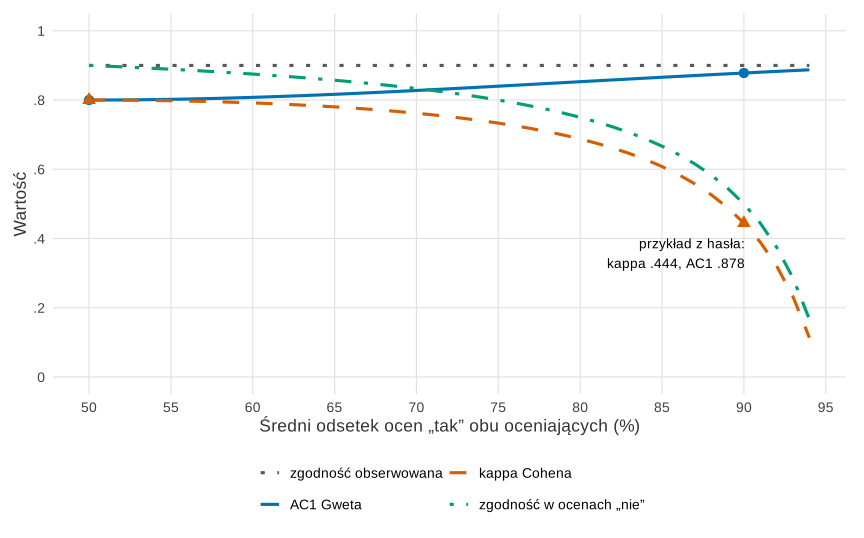
Co widać. Przy zrównoważonych kategoriach kappa i AC1 są równe (.800). Gdy „tak” staje się dominujące, krzywe się rozchodzą: przy 80% ocen „tak” kappa wynosi .687, a AC1 .853; przy 90% – .444 i .878 (punkty z przykładu); przy 94% kappa spada do .113, a AC1 rośnie do .887. Zgodność obserwowana przez cały czas wynosi 90%. To właśnie paradoks kappy: ta sama liczba zgodnych decyzji daje skrajnie różne kappy w zależności od częstości kategorii.
Na co uważać. AC1 nie „rozwiązuje” problemu, tylko odpowiada na inne pytanie. Zielona linia pokazuje, że zgodność w ocenach „nie” spada równie szybko jak kappa – przy 94% ocen „tak” wynosi .167. AC1 trzyma się blisko zgodności obserwowanej, bo jest zdominowany przez zgodne „tak”, i nie ostrzega, że oceniający prawie nigdy nie zgadzają się co do rzadkiej kategorii. Dlatego przy nierównych kategoriach podaj obie miary oraz zgodność w ocenach pozytywnych i negatywnych. Ten sam paradoks dla wielu sędziów, pokazany symulacją, znajdziesz w haśle kappa Fleissa.
Podpis do pracy:
Kod poniżej liczy wszystkie tabele ze wzorów podanych wyżej i odtwarza rysunek. Nic nie jest losowane; liczbę obiektów (100) i niezgodności (5 + 5) ustawiono ręcznie tak jak w przykładzie. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Kappa Cohena i AC1 Gweta przy stałej zgodności 90% i coraz rzadszej kategorii „nie”
library(ggplot2)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))

# Tabele 2 x 2 po 100 obiektów: zawsze 5 + 5 niezgodności, zmienia się podział 90 zgodnych na „tak” (A) i „nie” (D)
miary <- function(A, B = 5, C = 5, D = 90 - A) {
  N <- A + B + C + D
  p <- (A + D) / N
  A1 <- A + C; B1 <- A + B
  e_k <- (A1 / N) * (B1 / N) + ((N - A1) / N) * ((N - B1) / N)
  q <- (A1 + B1) / (2 * N); e_g <- 2 * q * (1 - q)
  c(czestosc_tak = q, zgodnosc = p, kappa = (p - e_k) / (1 - e_k), AC1 = (p - e_g) / (1 - e_g),
    p_neg = 2 * D / (2 * D + B + C))
}
tab <- as.data.frame(t(sapply(45:89, miary)))
round(tab[tab$czestosc_tak %in% c(0.50, 0.70, 0.80, 0.90, 0.94), ], 3)

d <- rbind(data.frame(q = tab$czestosc_tak, miara = "zgodność obserwowana", y = tab$zgodnosc),
           data.frame(q = tab$czestosc_tak, miara = "AC1 Gweta", y = tab$AC1),
           data.frame(q = tab$czestosc_tak, miara = "kappa Cohena", y = tab$kappa),
           data.frame(q = tab$czestosc_tak, miara = "zgodność w ocenach „nie”", y = tab$p_neg))
d$miara <- factor(d$miara, levels = c("zgodność obserwowana", "AC1 Gweta", "kappa Cohena", "zgodność w ocenach „nie”"))
przyklad <- d[d$q %in% c(0.50, 0.90) & d$miara %in% c("AC1 Gweta", "kappa Cohena"), ]
p1 <- ggplot(d, aes(100 * q, y, colour = miara, linetype = miara)) +
  geom_line(linewidth = 1.1) +
  geom_point(data = przyklad, aes(shape = miara), size = 3.2, show.legend = FALSE) +
  annotate("text", x = 90, y = 0.40, label = "przykład z hasła:\nkappa .444, AC1 .878", hjust = 1, vjust = 1, size = 3.6) +
  scale_colour_manual(values = c("grey35", "#0072B2", "#D55E00", "#009E73"), name = NULL) +
  scale_linetype_manual(values = c("dotted", "solid", "dashed", "dotdash"), name = NULL) +
  scale_shape_manual(values = c(16, 17)) +
  scale_x_continuous(breaks = seq(50, 95, 5)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2), labels = function(x) sub("^0\\.", ".", x)) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "Średni odsetek ocen „tak” obu oceniających (%)", y = "Wartość") +
  motyw
p1   # zapis: ggsave("ac1-gwety-kappa-czestosc.svg", p1, width = 9, height = 5.6)
Wynik w R
   czestosc_tak zgodnosc kappa   AC1 p_neg
1          0.50      0.9 0.800 0.800 0.900
21         0.70      0.9 0.762 0.828 0.833
31         0.80      0.9 0.687 0.853 0.750
41         0.90      0.9 0.444 0.878 0.500
45         0.94      0.9 0.113 0.887 0.167
Jak opisać w pracy
Na co uważać
Wysoki AC1 nie oznacza dobrej zgodności w każdej kategorii: w przykładzie zgodność w ocenach „nie” wynosi tylko 0.500. Dlatego Cicchetti i Feinstein (1990) zalecają raportować osobno zgodność w ocenach pozytywnych i negatywnych. Nie wybieraj współczynnika po obejrzeniu wyników – zaplanuj go razem z innymi miarami, np. kappą Fleissa lub alfą Krippendorffa. Szerzej o wyborze miar piszemy we wpisie o zgodności sędziów, a pojedynczą kappę policzysz w kalkulatorze kappy. Kategorie porządkowe wymagają wag, jak w kappie ważonej.
AC1 Gweta w R
Kod liczy AC1 ręcznie ze wzoru dla dwóch oceniających, obok kappy Cohena i zgodności w ocenach pozytywnych i negatywnych. Funkcja irrCAC::gwet.ac1.table() daje ten sam wynik co obliczenie ręczne (0.800 i 0.878).
Kappa a AC1 przy rzadkiej kategorii
R
# AC1 Gweta i kappa Cohena dla 2 oceniających i 2 kategorii
# A = obaj "tak", D = obaj "nie", B i C = niezgodności
ac1_kappa <- function(A, B, C, D) {
  N <- A + B + C + D
  p <- (A + D) / N                                 # zgodność obserwowana
  A1 <- A + C; B1 <- A + B                         # brzegi "tak" obu oceniających
  e_k <- (A1 / N) * (B1 / N) + ((N - A1) / N) * ((N - B1) / N)
  q <- (A1 + B1) / (2 * N)
  e_g <- 2 * q * (1 - q)                           # zgodność przypadkowa wg Gweta
  round(c(zgodnosc = p, kappa = (p - e_k) / (1 - e_k), AC1 = (p - e_g) / (1 - e_g),
          p_pos = 2 * A / (2 * A + B + C), p_neg = 2 * D / (2 * D + B + C)), 3)
}
rbind(zrownowazone = ac1_kappa(45, 5, 5, 45),
      rzadkie_nie = ac1_kappa(85, 5, 5, 5))
# Ten sam AC1 z pakietu irrCAC (tabele 2 x 2 jako macierze)
library(irrCAC)
sapply(list(zrownowazone = matrix(c(45, 5, 5, 45), 2), rzadkie_nie = matrix(c(85, 5, 5, 5), 2)),
       function(t) round(gwet.ac1.table(t)$coeff.val, 3))
Wynik w R
             zgodnosc kappa   AC1 p_pos p_neg
zrownowazone      0.9 0.800 0.800 0.900   0.9
rzadkie_nie       0.9 0.444 0.878 0.944   0.5
zrownowazone  rzadkie_nie
       0.800        0.878
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem irrCAC 1.4. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- irrCAC (wersja 1.4): Gwet, K. L. (2026). irrCAC: Computing the extent of agreement among raters with chance-corrected agreement coefficient (CAC) (R package version 1.4) [Computer software]. https://doi.org/10.32614/CRAN.package.irrCAC
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego AC1 Gweta jest wyższy od kappy przy rzadkiej kategorii?
Kappa szacuje zgodność przypadkową z iloczynów brzegów, która przy rzadkiej kategorii jest bliska obserwowanej. W AC1 zgodność przypadkowa jest wtedy mała, więc współczynnik pozostaje blisko odsetka zgodności.
Czy AC1 Gweta może zastąpić kappę Cohena w pracy?
Lepiej podać oba współczynniki, wybrane przed analizą, wraz z odsetkiem zgodności. Przy niezrównoważonych kategoriach dodaj zgodność w ocenach pozytywnych i negatywnych osobno.
Jak policzyć AC1 Gweta w R bez pakietu irrCAC?
Policz zgodność p, średni odsetek ocen „tak” q, zgodność przypadkową 2q(1 − q) i podstaw do (p − e) / (1 − e). Kod na tej stronie robi to dla tabeli 2 × 2, a irrCAC::gwet.ac1.table() daje ten sam wynik.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Zgodność sędziów: kappa, ICC, alfa
Kappa Cohena i ważona, kappa Fleissa, formy ICC i alfa Krippendorffa na jednym przykładzie z trzema sędziami: wybór miary, paradoksy kappy i raport.
Czytaj →PoradnikKalkulator kappy Cohena i testu McNemara
Kappa Cohena i kappa ważona z przedziałem ufności dla dwóch oceniających oraz test McNemara w czterech wersjach z przedziałem dla różnicy odsetków.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cicchetti, D. V., & Feinstein, A. R. (1990). High agreement but low kappa: II. Resolving the paradoxes. Journal of Clinical Epidemiology, 43(6), 551–558. https://doi.org/10.1016/0895-4356(90)90159-m
- Gwet, K. L. (2008). Computing inter-rater reliability and its variance in the presence of high agreement. British Journal of Mathematical and Statistical Psychology, 61(1), 29–48. https://doi.org/10.1348/000711006x126600
- Wongpakaran, N., Wongpakaran, T., Wedding, D., & Gwet, K. L. (2013). A comparison of Cohen’s Kappa and Gwet’s AC1 when calculating inter-rater reliability coefficients: A study conducted with personality disorder samples. BMC Medical Research Methodology, 13(1), Article 61. https://doi.org/10.1186/1471-2288-13-61 ● Otwarty dostęp
Cytowania BibTeX
@article{cicchetti1990high, author={Cicchetti, Domenic V. and Feinstein, Alvan R.}, title={{High agreement but low kappa: II. Resolving the paradoxes}}, journal={Journal of Clinical Epidemiology}, year={1990}, volume={43}, number={6}, pages={551--558}, doi={10.1016/0895-4356(90)90159-m}}@article{gwet2008computing, author={Gwet, Kilem Li}, title={{Computing inter-rater reliability and its variance in the presence of high agreement}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2008}, volume={61}, number={1}, pages={29--48}, doi={10.1348/000711006x126600}}@article{wongpakaran2013comparison, author={Wongpakaran, Nahathai and Wongpakaran, Tinakon and Wedding, Danny and Gwet, Kilem L.}, title={{A comparison of Cohen’s Kappa and Gwet’s AC1 when calculating inter-rater reliability coefficients: A study conducted with personality disorder samples}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={61}, doi={10.1186/1471-2288-13-61}}