Co to jest wartość q Storeya?
Wartość q (ang. q-value) to miara istotności pojedynczego wyniku wyrażona przez odsetek fałszywych odkryć (FDR), a nie przez odsetek fałszywie pozytywnych wyników, jak wartość p. Storey (2002) opisał ją jako odpowiednik wartości p dla dodatniego FDR (pFDR): q danego testu to najmniejszy FDR, przy którym ten wynik byłby jeszcze uznany za istotny. Storey i Tibshirani (2003) zastosowali ją w badaniach genomowych, w których testuje się tysiące cech naraz.
FDR a wartość q
FDR jest cechą procedury: procedura Benjaminiego–Hochberga (Benjamini i Hochberg, 1995) ustala z góry poziom, np. .05, i wyznacza zbiór odrzuconych hipotez. Wartość q jest cechą pojedynczego wyniku: progu nie trzeba wybierać przed analizą, a czytelnik może przyjąć własny. Storey (2002) odwrócił kolejność – najpierw ustala się obszar odrzuceń, potem szacuje związany z nim odsetek błędów. Różnicę między FDR a FWER opisuje hasło problem wielokrotnych porównań.
Jak się ją liczy
- odsetek prawdziwych hipotez zerowych π₀ szacuje się jako liczbę wartości p większych od λ (np. 0.5) podzieloną przez m(1 − λ) – powyżej λ leżą głównie p z hipotez prawdziwych, które mają rozkład jednostajny;
- q dla i-tej najmniejszej wartości p to π₀ · m · p(i) / i, z poprawką, by q nie malało przy rosnących p;
- przy π₀ = 1 wartości q są równe p skorygowanym metodą BH, więc ogólnie q = π₀ · pBH.
Przykład
W symulacji 1000 testów (800 bez efektu) oszacowano π₀ = 0.824. Przy progu .05 procedura BH dała 124 odkrycia, a wartości q – 139. Faktyczny odsetek fałszywych odkryć wyniósł w tej jednej symulacji 5.6% i 7.9%: dodatkowe odkrycia nie są darmowe. Storey (2002) w prostych przykładach liczbowych uzyskał ponad ośmiokrotny wzrost mocy w porównaniu z procedurą BH.
Na rysunku
Te same 1000 symulowanych testów co w przykładzie (800 bez efektu, 200 z efektem). Panel A pokazuje, skąd bierze się π₀, panel B – dlaczego wartości q dają więcej odkryć niż p skorygowane metodą BH.
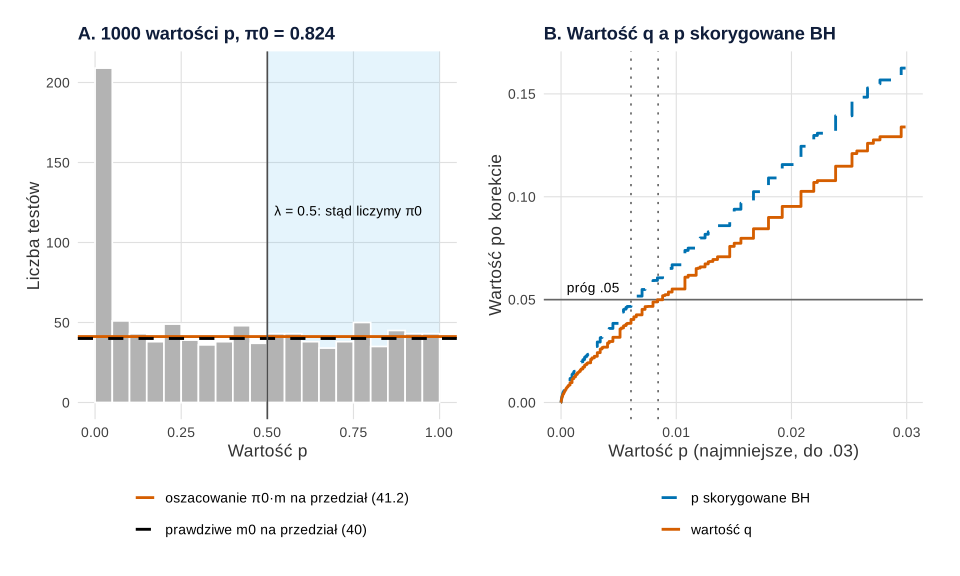
set.seed(591)).Co widać. W panelu A wartości p z prawdziwych hipotez zerowych tworzą płaskie „tło” histogramu, a efekty – pik przy zerze (209 testów z p < .05). Powyżej λ = 0.5 leży 412 wartości p, prawie same z tła, więc tło szacuje się na 41.2 testu na przedział, czyli π₀ = 0.824 (prawdziwe tło: 40 i 0.8). W panelu B linia wartości q leży poniżej linii BH, bo q = π₀ · pBH. Próg .05 przepuszcza więc p do .00842 zamiast do .00607, czyli 139 wyników zamiast 124.
Na co uważać. Oszacowanie π₀ zależy od λ i od tego, czy tło histogramu jest naprawdę płaskie. Gdy testy są zależne albo wartości p pochodzą z testów dyskretnych, „tło” może się garbić i π₀ będzie niedokładne. Panel B nie pokazuje, ile z dodatkowych 15 odkryć jest fałszywych – w tej symulacji faktyczny odsetek fałszywych odkryć wzrósł z 5.6% do 7.9% (zob. przykład). Histogram z tłem i efektami oznaczonymi kolorem oraz posortowane p z progami Bonferroniego, Holma i BH pokazuje wpis wielokrotne testy w obrazkach.
Podpis do pracy:
Podpis dotyczy panelu A. Kod odtwarza rysunek i liczby z akapitu na tych samych danych co przykład; ziarno 591 ustalono raz i nie zmieniano. Kod definiuje sam paletę Okabe–Ito i motyw; rysunek na stronie różni się tylko krojem czcionki.
Kod R rysunku 1
# Rysunek 1. Histogram 1000 wartości p z oszacowaniem π0 (A) i wartości q a p skorygowane BH (B)
# Te same dane co w przykładzie: 800 testów bez efektu, 200 z efektem (set.seed(591)).
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
set.seed(591)
m0 <- 800; m1 <- 200
p <- c(2 * pnorm(-abs(rnorm(m0))), 2 * pnorm(-abs(rnorm(m1, mean = 3))))
m <- length(p); lambda <- 0.5; szer <- 0.05                  # szerokość przedziału histogramu
pi0 <- min(1, sum(p > lambda) / (m * (1 - lambda)))
bh <- p.adjust(p, method = "BH"); q <- pmin(1, pi0 * bh)
round(pi0, 3)
c(p_powyzej_lambda = sum(p > lambda), p_ponizej_0.05 = sum(p < szer))
c(na_przedzial_szac = pi0 * m * szer, na_przedzial_prawda = m0 * szer)
c(BH = sum(bh <= 0.05), q = sum(q <= 0.05))                     # liczba odkryć przy progu .05
prog <- c(BH = max(p[bh <= 0.05]), q = max(p[q <= 0.05]))       # największe p uznane za odkrycie
signif(prog, 3)

# A: histogram p; nad λ leżą prawie same p z prawdziwych H0, więc ich gęstość szacuje π0
poziomy <- data.frame(y = c(pi0 * m * szer, m0 * szer), co = c(sprintf("oszacowanie π0·m na przedział (%.1f)", pi0 * m * szer),
                                                             sprintf("prawdziwe m0 na przedział (%.0f)", m0 * szer)))
pA <- ggplot(data.frame(p), aes(p)) +
  annotate("rect", xmin = lambda, xmax = 1, ymin = 0, ymax = Inf, fill = "#56B4E9", alpha = 0.15) +
  geom_histogram(breaks = seq(0, 1, by = szer), fill = "grey70", colour = "white") +
  geom_hline(data = poziomy, aes(yintercept = y, linetype = co, colour = co), linewidth = 1) +
  geom_vline(xintercept = lambda, colour = "grey30") +
  annotate("text", x = 0.52, y = 120, label = "λ = 0.5: stąd liczymy π0", hjust = 0, size = 3.6) +
  scale_colour_manual(values = c("#D55E00", "black"), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(title = sprintf("A. 1000 wartości p, π0 = %.3f", pi0), x = "Wartość p", y = "Liczba testów") +
  motyw

# B: q = π0 · p_BH leży poniżej p_BH, więc ten sam próg .05 przepuszcza więcej wyników
dB <- rbind(data.frame(p = p, wartosc = bh, miara = "p skorygowane BH"),
            data.frame(p = p, wartosc = q, miara = "wartość q"))
dB <- dB[dB$p <= 0.03, ]
pB <- ggplot(dB, aes(p, wartosc, colour = miara, linetype = miara)) +
  geom_hline(yintercept = 0.05, colour = "grey40") +
  geom_vline(xintercept = prog, colour = "grey40", linetype = "dotted") +
  geom_step(linewidth = 1) +
  annotate("text", x = 0.0005, y = 0.056, label = "próg .05", hjust = 0, size = 3.6) +
  scale_colour_manual(values = c("#0072B2", "#D55E00"), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(title = "B. Wartość q a p skorygowane BH", x = "Wartość p (najmniejsze, do .03)", y = "Wartość po korekcie") +
  motyw
p1 <- pA + pB
p1   # zapis: ggsave("wartosc-q-storeya-histogram-p-i-q.svg", p1, width = 10, height = 6)
Wynik w R
[1] 0.824
p_powyzej_lambda   p_ponizej_0.05
             412              209
  na_przedzial_szac na_przedzial_prawda
               41.2                40.0
 BH   q
124 139
     BH       q
0.00607 0.00842
Jak opisać w pracy
Na co uważać
Wartość q nie jest prawdopodobieństwem, że ta konkretna hipoteza zerowa jest prawdziwa – opisuje odsetek błędów wśród wszystkich wyników co najmniej tak istotnych. Przy kilkunastu testach π₀ szacuje się niestabilnie; bezpieczniej podać wtedy p skorygowane BH, a gdy liczy się każdy błąd I rodzaju – użyć poprawki Holma. Przegląd metod korekty znajdziesz we wpisie o poprawkach na wielokrotne porównania.
Wartość q Storeya w R
Kod szacuje π₀ ręcznie dla jednej wartości λ = 0.5 i liczy wartości q jako π₀ razy p skorygowane metodą BH. Funkcja qvalue::qvalue() z tą samą λ daje ten sam wynik co obliczenie ręczne (π₀ = 0.824, 139 odkryć).
Wartości q a procedura BH w 1000 testach
R
# Wartość q Storeya ręcznie (jedna wartość lambda) i porównanie z BH
set.seed(591)
m0 <- 800; m1 <- 200                                  # 800 hipotez prawdziwych, 200 z efektem
p <- c(2 * pnorm(-abs(rnorm(m0))),                    # p z testów bez efektu (rozkład jednostajny)
       2 * pnorm(-abs(rnorm(m1, mean = 3))))           # p z testów z efektem
m <- length(p); lambda <- 0.5
pi0 <- min(1, sum(p > lambda) / (m * (1 - lambda)))   # szacowany odsetek hipotez zerowych
bh <- p.adjust(p, method = "BH")                       # skorygowane p wg BH
q <- pmin(1, pi0 * bh)                                 # q = pi0 * (m p_(i) / i), monotonizowane
prawda <- rep(c("H0", "H1"), c(m0, m1))
round(pi0, 3)
c(BH = sum(bh <= 0.05), q = sum(q <= 0.05))           # liczba odkryć przy progu 0.05
round(c(FDP_BH = mean(prawda[bh <= 0.05] == "H0"),    # faktyczny odsetek fałszywych odkryć
  FDP_q = mean(prawda[q <= 0.05] == "H0")), 3)
# To samo pakietem qvalue (ta sama lambda = 0.5)
library(qvalue)
qobj <- qvalue(p, lambda = 0.5)
round(qobj$pi0, 3)                                     # pi0 z pakietu
sum(qobj$qvalues <= 0.05)                              # liczba odkryć przy q <= 0.05
all.equal(qobj$qvalues, q)                             # zgodność z obliczeniem ręcznym
Wynik w R
[1] 0.824
 BH   q
124 139
FDP_BH  FDP_q
 0.056  0.079
[1] 0.824
[1] 139
[1] TRUE
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety base i stats oraz qvalue). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- qvalue (wersja 2.42.0): Storey, J. D., Bass, A. J., Dabney, A., & Robinson, D. (2025). qvalue: Q-value estimation for false discovery rate control [R package]. http://github.com/jdstorey/qvalue
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym różni się wartość q od p skorygowanego metodą Benjaminiego–Hochberga?
Skorygowane p według BH zakłada, że wszystkie hipotezy zerowe mogą być prawdziwe (π₀ = 1). Wartość q mnoży je przez oszacowane π₀, więc jest taka sama lub mniejsza. Gdy prawie wszystkie hipotezy zerowe są prawdziwe, oba wyniki są niemal równe.
Kiedy stosować wartości q Storeya?
Przy setkach i tysiącach testów, np. w genomice lub przeszukiwaniu wielu zmiennych, gdy akceptujesz pewien odsetek fałszywych odkryć. Przy kilku hipotezach głównych badania konfirmacyjnego lepsza jest kontrola FWER, np. poprawka Holma.
Jak policzyć wartości q w R bez pakietu qvalue?
Oszacuj π₀ jako odsetek p większych od λ podzielony przez 1 − λ, a potem policz pmin(1, π₀ · p.adjust(p, "BH")). Kod na tej stronie robi to dla 1000 symulowanych testów.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Storey, J. D. (2002). A direct approach to false discovery rates. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 64(3), 479–498. https://doi.org/10.1111/1467-9868.00346
- Storey, J. D., & Tibshirani, R. (2003). Statistical significance for genomewide studies. Proceedings of the National Academy of Sciences, 100(16), 9440–9445. https://doi.org/10.1073/pnas.1530509100 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@article{storey2002direct, author={Storey, John D.}, title={{A direct approach to false discovery rates}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2002}, volume={64}, number={3}, pages={479--498}, doi={10.1111/1467-9868.00346}}@article{storey2003statistical, author={Storey, John D. and Tibshirani, Robert}, title={{Statistical significance for genomewide studies}}, journal={Proceedings of the National Academy of Sciences}, year={2003}, volume={100}, number={16}, pages={9440--9445}, doi={10.1073/pnas.1530509100}}