Przykład: infolinia regionalnego przewoźnika kolejowego
Fikcyjny regionalny przewoźnik kolejowy prowadzi infolinię czynną od 6:00 do 22:00. Po wybraniu sprawy w menu (rozkład jazdy, bilety i zwroty, reklamacje, utrudnienia w ruchu) dzwoniący trafia do kolejki. Część rozłącza się, zanim ktoś odbierze. Kierownik pyta: ile czasu dzwoniący są gotowi czekać i o ile spadnie liczba rozłączeń, jeśli skrócimy czekanie o 30 sekund?
W III kwartale 2026 roku (92 dni) centrala zapisała 119 444 połączenia od 41 525 osób; 9444 to ponowne próby po rozłączeniu. Odebrano 80.5% połączeń (36.0% od razu, bez czekania), 17.1% skończyło się rozłączeniem w kolejce, a 2.4% – rozłączeniem w ciągu pierwszych 5 sekund. Od 1 sierpnia co drugie losowo wybrane połączenie słyszało komunikat o swojej pozycji w kolejce (33.3% wszystkich połączeń kwartału).
Wynik to czas od wejścia do kolejki do rozłączenia – czyli cierpliwość. U obsłużonych go nie znamy: wiemy tylko, że była dłuższa niż ich czekanie. To zadanie dla analizy przeżycia. Wpis o obsadzie infolinii (Erlang C i symulacja) cierpliwość zakładał; tu ją szacujemy z danych, tak jak w analizie danych bankowego call center, która rozkłada pracę infolinii na przyjścia, cierpliwość i czas obsługi (Brown i in., 2005).
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Cierpliwość ma rozkład Weibulla o kształcie 1.3 i skali 210 s. Skalę mnożą: sprawa (bilety × 1.3, reklamacje × 1.8, utrudnienia × 0.8), pora (szczyt poranny × 0.75, popołudniowy × 0.85, wieczór × 1.1), komunikat (× 1.35) i ukryta cierpliwość osoby (log-normalnie, odchylenie 0.3). Oferowany czas oczekiwania nie zależy od cierpliwości: z rozkładu gamma o średniej 140 s rano, 70 s w dzień, 110 s po południu i 45 s wieczorem, z szansą odebrania od razu od 25% do 60% i losowym obciążeniem dnia. 3% połączeń to pomyłki (rozłączenie w 0.5–5 s), a 45% rozłączonych dzwoni ponownie w ciągu 1–20 minut. Po pierwszym uruchomieniu zmieniliśmy trzy parametry: liczbę pierwszych prób ze 103 000 na 110 000 (dawała 113 037 połączeń zamiast ok. 120 000) oraz średnie czekanie w szczycie porannym ze 170 na 140 s i popołudniowym ze 130 na 110 s, bo rano rozłączało się 32.5% połączeń. Ziarna 754 nie zmienialiśmy. Dane: rezygnacja-infolinia-polaczenia.csv (kolumny: osoba, start – sekundy od 1 lipca, 0:00, typ – R rozkład jazdy, B bilety i zwroty, K reklamacje, U utrudnienia, komunikat 0/1, czas w kolejce w sekundach, rozlaczenie 1/0).
Rysunek 1: wejście do kolejki – rozłączenie albo obsługa
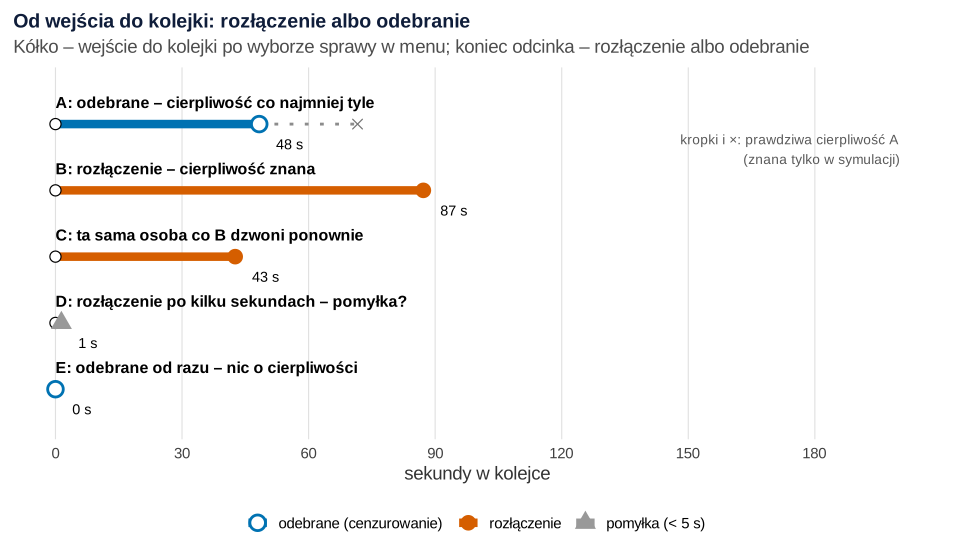
set.seed(754)).Co widać. Zegar rusza w chwili wejścia do kolejki. Połączenia wybrano regułą: pierwsze danego rodzaju 2 września. B rozłączył się po 87 s – jego cierpliwość znamy. A odebrano po 48 s: wiemy tylko, że wytrzymałby co najmniej 48 s. To obserwacja cenzurowana. E nic nie mówi o cierpliwości, a D to najpewniej pomyłka.
Jak może zmylić. C to ta sama osoba co B. Dwa porzucenia to tu jedna niezałatwiona sprawa, nie dwie (pułapki).
Podpis do pracy:
Rysunek 2: dlaczego średnia z samych rozłączeń myli
Najprostszy raport centrali: „średni czas do rozłączenia” liczony z połączeń porzuconych. Do analizy bierzemy 73 547 połączeń, które czekały, bez pomyłek; 20 438 z nich skończyło się rozłączeniem.
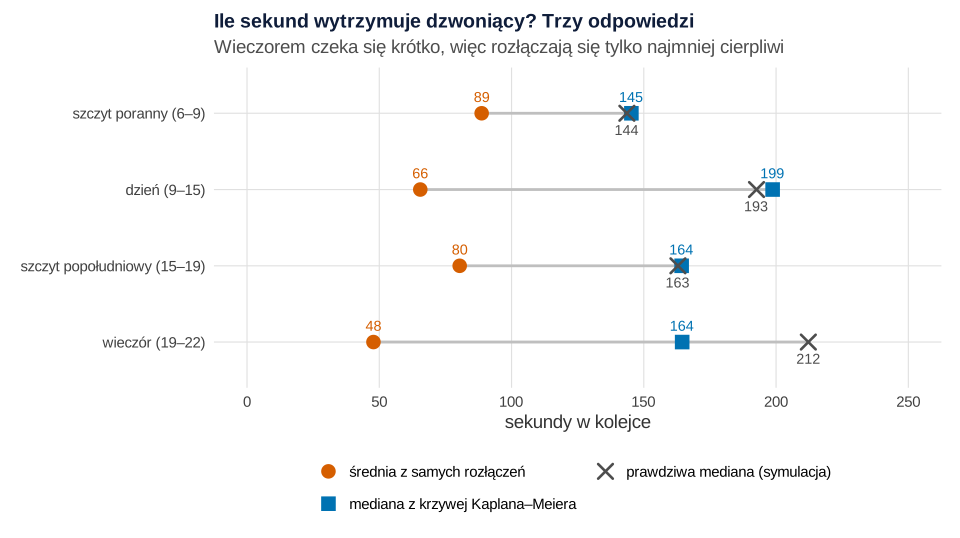
set.seed(754)).Co widać. Średnia z rozłączeń to 81.2 s, a prawdziwa średnia cierpliwość – 235.5 s (mediana 169.7 s). Średnia z rozłączeń mierzy nie cierpliwość, tylko to, jak długo kazano czekać. Wieczorem, gdy kolejki są krótkie, rozłączają się tylko najmniej cierpliwi: średnia wynosi 47.8 s i wieczór wygląda na porę najbardziej nerwową. Naprawdę jest najspokojniejszy (prawdziwa mediana 212.2 s). Krzywa Kaplana–Meiera, która traktuje odebranych jako „co najmniej tyle”, daje medianę bliską prawdy: rano 145 s, 95% CI [142, 149], przy prawdziwej 143.6.
Jak może zmylić. Kaplan–Meier też nie widzi dalej niż dane. Wieczorem mało kto czeka ponad 3 minuty, więc mediana 164 s ma przedział [158, –] bez górnej granicy. Estymator wymaga, by cenzurowanie nie zależało od cierpliwości (Kaplan i Meier, 1958). W większości badań mechanizm cenzurowania jest nieznany i trzeba go założyć (Leung i in., 1997). Tu odebranie zależy od obciążenia kolejki, nie od cierpliwości dzwoniącego.
Podpis do pracy:
Rysunek 3: krzywe Kaplana–Meiera – kto czeka dłużej
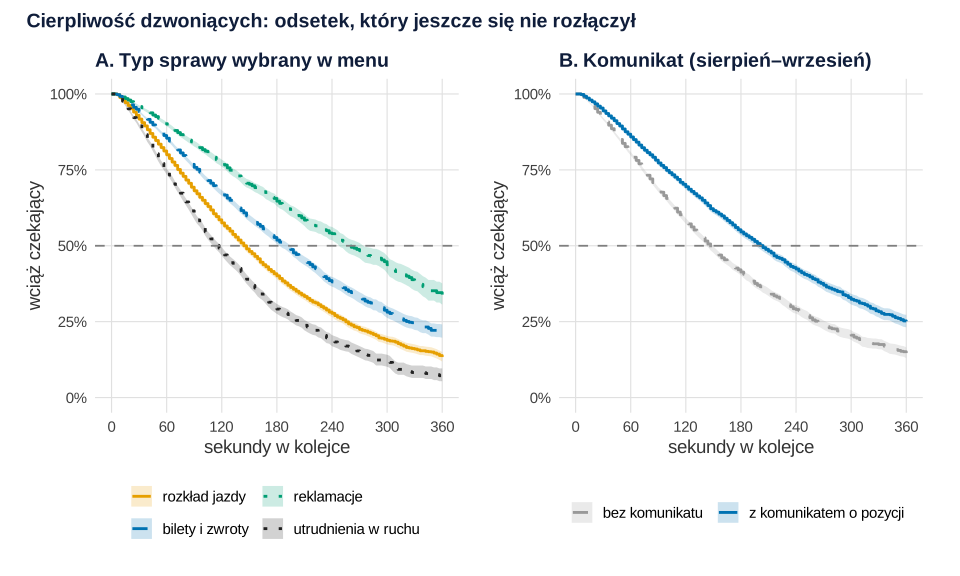
set.seed(754)).Co widać. Najkrócej czekają dzwoniący w sprawie utrudnień w ruchu (mediana 114 s, 95% CI [111, 119]); po 2 minutach czeka jeszcze 48.1% z nich. Przy reklamacjach mediana to 258 s [249, 274], a po 2 minutach czeka 77.2%. Komunikat porównujemy tylko w sierpniu i wrześniu, bo wtedy go losowano: mediana rośnie z 146 s [143, 149] do 202 s [196, 208], test log-rank: χ²(1) = 460, p < .001.
Jak może zmylić. Krzywe dla typu sprawy mieszają pory dnia, a rano dzwoni się w innych sprawach niż wieczorem. Efekty wzajemnie skorygowane daje model (rysunki 4 i 5). Komunikat był losowany, więc tę różnicę można czytać przyczynowo; różnic między sprawami – nie.
Zdanie do Wyników:
Rysunek 4: model parametryczny – Weibull, log-normalny czy wykładniczy?
Do prognozy potrzebna jest krzywa cierpliwości także tam, gdzie danych jest mało. Daje ją model parametryczny – w R survreg() z pakietu survival. To model AFT: zmienne wydłużają albo skracają czas, co łatwo zinterpretować (Wei, 1992).
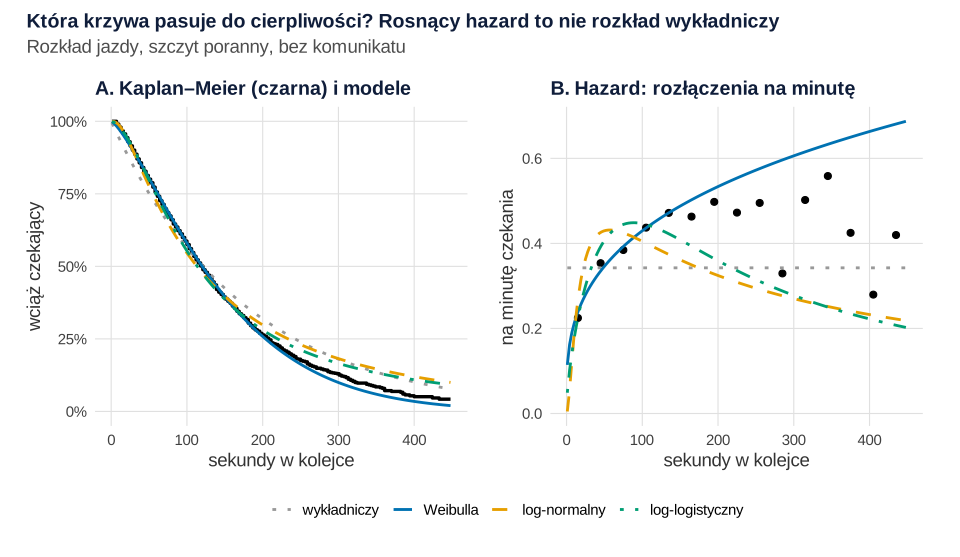
set.seed(754)).Co widać. W jednorodnej grupie (rozkład jazdy, rano, bez komunikatu; 6385 połączeń) hazard rośnie: w pierwszych 30 s rozłącza się 0.23 osoby na minutę czekania, po 3 minutach – około 0.5. Im dłużej ktoś czeka, tym chętniej rezygnuje. Rozkład wykładniczy ma stały hazard i pasuje najgorzej. Rozkład Weibulla ma najmniejsze AIC (35 876 wobec 35 885 dla log-logistycznego, 35 913 dla log-normalnego i 36 206 dla wykładniczego). Model Weibulla z typem sprawy, porą i komunikatem daje kształt 1.34 (prawda: 1.3), a komunikat wydłuża cierpliwość 1.36 raza, 95% CI [1.33, 1.39].
Jak może zmylić. W modelu na wszystkich połączeniach wygrywa log-logistyczny (ΔAIC = 78 przed Weibullem). Mieszanina ludzi o różnej cierpliwości spłaszcza hazard w ogonie, także w jednej grupie po 4 minutach. Dlatego prognozę sprawdzamy w obu modelach (rysunek 6).
Zdanie do Wyników:
Rysunek 5: model Coxa – pora, sprawa i komunikat
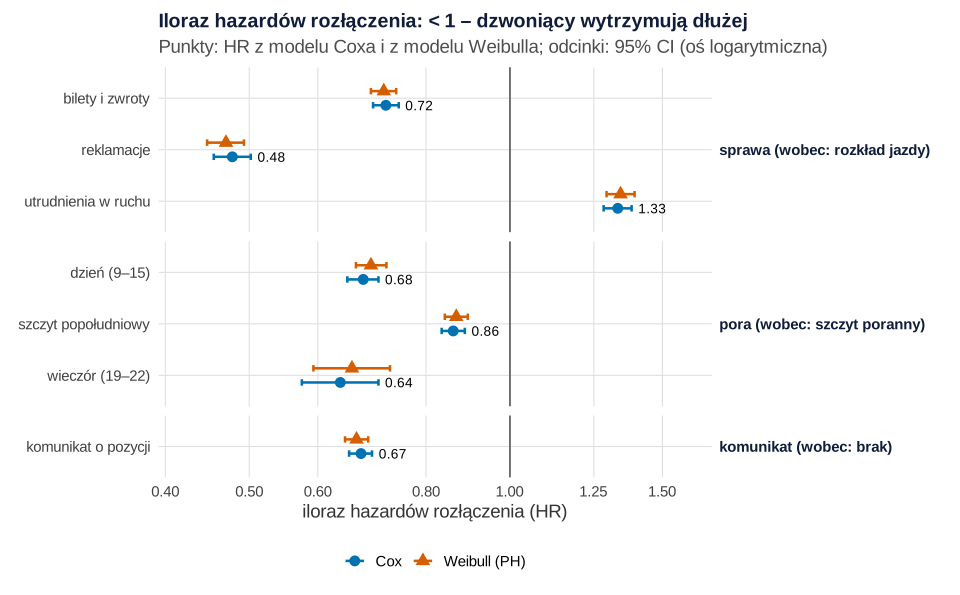
set.seed(754)).Co widać. Model Coxa (Cox, 1972) nie zakłada kształtu krzywej. Iloraz hazardów poniżej 1 oznacza, że dzwoniący rozłączają się wolniej. Komunikat: HR = 0.67, 95% CI [0.65, 0.69]. Reklamacje: HR = 0.48 [0.45, 0.50], a utrudnienia w ruchu: HR = 1.33 [1.28, 1.38] wobec rozkładu jazdy. Wieczorem (HR = 0.64) i w dzień (0.68) ludzie są cierpliwsi niż w szczycie porannym. Ilorazy z modelu Weibulla prawie się pokrywają, bo Weibull jest jednocześnie modelem proporcjonalnych hazardów i AFT (Carroll, 2003). Reszty Schoenfelda nie wskazują na złamanie proporcjonalności: χ²(7) = 8.18, p = .32.
Jak może zmylić. Ta sama osoba może dzwonić wiele razy, więc liczymy błędy odporne na klastrowanie według osoby. Tu są najwyżej o 2% większe od zwykłych, bo powtórzeń jest mało. HR dla pory i sprawy to związek, nie przyczyna.
Zdanie do Wyników:
Rysunek 6: co da skrócenie czekania o 30 s
Model daje odsetek rozłączeń jako funkcję czasu oczekiwania: szansa, że ktoś odpadnie, zanim minie w sekund, to 1 − S(w). Brakuje drugiego składnika: jak długo naprawdę kazano czekać. Oferowany czas oczekiwania też jest cenzurowany – rozłączeniem – więc jego rozkład w każdej porze szacujemy krzywą Kaplana–Meiera, z odebraniem jako zdarzeniem. Odsetek rozłączeń to średnia z 1 − S(w) ważona tym rozkładem. Skrócenie o 30 s przesuwa każde czekanie: w → max(w − 30, 0).
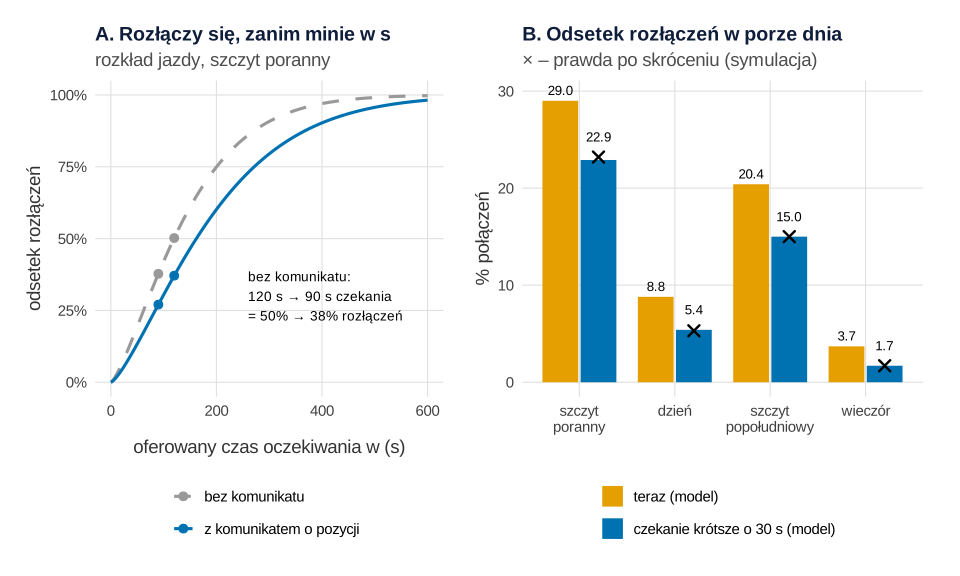
set.seed(754)).Co widać. Najpierw kontrola: model odtwarza obecny odsetek rozłączeń (rano 29.0% wobec 29.0% w danych, w dzień 8.8% wobec 8.7%). Czekanie krótsze o 30 s obniża go rano do 22.9% (prawda z symulacji: 23.2%), po południu z 20.4% do 15.0%, a wieczorem z 3.7% do 1.7%. Na cały kwartał to 5419 rozłączeń mniej, 95% CI [5365, 5474], z 20 438. Model log-logistyczny daje te same spadki co do 0.1 pp. Panel A tłumaczy, dlaczego skrócenie najbardziej opłaca się w szczycie: przy 120 s czekania rozłącza się co drugi dzwoniący w sprawie rozkładu jazdy, przy 90 s – 38%.
Jak może zmylić. Przedział uwzględnia tylko niepewność parametrów (300 losowań z rozkładu oszacowań), nie błąd postaci modelu: prawdziwy spadek to 5284, poza przedziałem. Podawaj go z analizą wrażliwości na wybór rozkładu. Prognoza zakłada też, że krótsze czekanie nie zmienia samej kolejki. W praktyce więcej osób dotrwa do rozmowy, więc konsultanci będą bardziej zajęci. Klasyczne modele kolejek są bardzo przydatne, ale mają wyraźne ograniczenia (Gans i in., 2003). Erlang C zakłada, że nikt się nie rozłącza; model z niecierpliwymi klientami (Erlang A, M/M/N+M) dodaje wykładniczą cierpliwość (Garnett i in., 2002). Nasze dane pokazują rosnący hazard, więc obsadę lepiej sprawdzić symulacją z oszacowanym rozkładem Weibulla.
Zdanie do Wyników:
Co z tym zrobić w firmie
- Nie raportuj „średniego czasu do rozłączenia” z samych porzuceń. Raportuj medianę cierpliwości z krzywej Kaplana–Meiera i odsetek wciąż czekających po 60 i 120 s (rysunek 3).
- Skróć czekanie tam, gdzie krzywa jest najbardziej stroma – w szczycie porannym. Te same 30 s rano to 6.1 pp mniej rozłączeń, wieczorem – 2.0 pp.
- Włącz komunikat o pozycji dla wszystkich. To efekt z losowego porównania, a kosztuje mniej niż dodatkowy konsultant.
- Sprawy o utrudnieniach w ruchu obsługuj priorytetowo albo krótkim nagraniem o aktualnych opóźnieniach – ci dzwoniący odpadają najszybciej.
- Obsadę policz symulacją z rozkładem cierpliwości z modelu, nie ze wzoru bez rozłączeń.
Podobne decyzje oparte na czasie do zdarzenia opisują wpisy o krzywej rezerwacji i czasie do anulowania oraz o cenie biletu a czasie do spektaklu, a inne tematy z obsługi i przewozów – Statystyka w pracy z logistyki.
Jak opisać w pracy
Tabela do Wyników:
| Typ sprawy | n połączeń | Mediana cierpliwości (s) [95% CI] | Czeka po 120 s (%) | HR (Cox) [95% CI] |
|---|---|---|---|---|
| Rozkład jazdy | 29 725 | 144 [141, 147] | 57.5 | 1 (odniesienie) |
| Bilety i zwroty | 22 036 | 190 [183, 195] | 67.4 | 0.72 [0.69, 0.74] |
| Reklamacje | 10 569 | 258 [249, 274] | 77.2 | 0.48 [0.45, 0.50] |
| Utrudnienia w ruchu | 11 217 | 114 [111, 119] | 48.1 | 1.33 [1.28, 1.38] |
Procedurę ogólną krok po kroku opisuje wpis Kaplan–Meier i model Coxa.
Kod R: dane, Kaplan–Meier, modele parametryczne, Cox i prognoza
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy 1–7 po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a kolejne korzystają z obiektów poprzednich. Przepis 8 jest samodzielny. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 i 6 – każdy zaczyna się od własnego set.seed(754). Ziarno 754 ustalono raz i nie zmieniano go. Pozostałe przepisy nie losują, więc uruchomione po przepisie 1 dadzą te same liczby co na stronie. Ręcznie ustalono: liczbę pierwszych prób i osób, profil godzinowy, udziały spraw, rozkład oferowanego czasu oczekiwania według pory, kształt i skalę rozkładu Weibulla cierpliwości z mnożnikami, zmienność osób, odsetek pomyłek i szansę ponownej próby (przepis 1). Po pierwszym uruchomieniu zmieniono trzy z nich: liczbę pierwszych prób (103 000 → 110 000) i średnie czekanie w szczycie porannym (170 → 140 s) i popołudniowym (130 → 110 s). Kolumny T, W (dla rozłączonych) i pomylka to ukryty mechanizm, którego centrala nie zna – używają go tylko porównania z prawdą w przepisach 2, 6 i 7; w pliku CSV ich nie ma. Cały kod liczy się w kilka sekund.
1. Dane i oś czasu połączenia: Rysunek 1
R
# Rysunek 1. Fikcyjna infolinia regionalnego przewoźnika kolejowego: połączenia z III kwartału 2026
# i oś czasu połączenia od wejścia do kolejki do rozłączenia albo odebrania
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii; sprawdzenie w przepisie 8) i prosty motyw
kol_wynik <- c("odebrane (cenzurowanie)" = "#0072B2", "rozłączenie" = "#D55E00", "pomyłka (< 5 s)" = "#999999")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Infolinia czynna 6:00–22:00, 1 lipca – 30 września 2026 (92 dni). Wszystkie parametry ustalono ręcznie.
set.seed(754)                                       # ziarno ustalone raz, bez dobierania pod wynik
n0 <- 110000                                        # pierwsze próby dodzwonienia się
n_os <- 72000                                       # osoby (numery telefonów); część dzwoni wiele razy
pory <- c("szczyt poranny (6–9)", "dzień (9–15)", "szczyt popołudniowy (15–19)", "wieczór (19–22)")
typy <- c("rozkład jazdy", "bilety i zwroty", "reklamacje", "utrudnienia w ruchu")
waga_godz <- c(6, 10, 9, 6, 5, 5, 5, 5, 5, 6, 8, 9, 7, 4, 3, 2)    # godziny 6, 7, …, 21
osoby <- data.frame(osoba = sprintf("O%05d", 1:n_os), u = rnorm(n_os, 0, 0.3),   # u – ukryta cierpliwość osoby
                    waga = rgamma(n_os, shape = 0.8))
dzien_obc <- rgamma(92, shape = 10, scale = 0.1)    # obciążenie dnia (średnio 1)

pora_z_godz <- function(g) pory[findInterval(g, c(6, 9, 15, 19))]
nowe_polaczenia <- function(n, osoba, typ, start) {           # start – sekundy od 1 lipca 2026, 0:00
  dzien <- start %/% 86400 + 1
  godz <- (start %% 86400) / 3600
  pora <- pora_z_godz(godz)
  komunikat <- dzien >= 32 & runif(n) < 0.5                     # od 1 sierpnia losowo co drugie połączenie
  # oferowany czas oczekiwania W: tyle czekałby dzwoniący, gdyby się nie rozłączył
  p_od_razu <- c(0.25, 0.45, 0.30, 0.60)[match(pora, pory)]
  sr_w <- c(140, 70, 110, 45)[match(pora, pory)] * dzien_obc[dzien]
  W <- ifelse(runif(n) < p_od_razu, 0, rgamma(n, shape = 1.5, scale = sr_w / 1.5))
  # cierpliwość T: rozkład Weibulla (kształt 1.3), skala zależna od sprawy, pory, komunikatu i osoby
  skala <- 210 * c(1, 1.3, 1.8, 0.8)[match(typ, typy)] * c(0.75, 1, 0.85, 1.1)[match(pora, pory)] *
    1.35^komunikat * exp(osoby$u[match(osoba, osoby$osoba)])
  T <- rweibull(n, shape = 1.3, scale = skala)
  pomylka <- runif(n) < 0.03                                    # pomyłki: rozłączenie w ciągu 5 s
  T[pomylka] <- runif(sum(pomylka), 0.5, 5)
  data.frame(osoba, typ, start, dzien, godz, pora, komunikat, pomylka, W = round(W, 1), T = round(T, 1))
}
start0 <- (sample(92, n0, replace = TRUE) - 1) * 86400 +
  (5 + sample(16, n0, replace = TRUE, prob = waga_godz)) * 3600 + runif(n0, 0, 3600)
runda <- nowe_polaczenia(n0, sample(osoby$osoba, n0, replace = TRUE, prob = osoby$waga),
                         sample(typy, n0, replace = TRUE, prob = c(0.40, 0.30, 0.15, 0.15)), start0)
runda$proba <- 1L
polaczenia <- runda
for (r in 2:4) {                                    # ponowne próby po rozłączeniu (nie po pomyłce)
  ponow <- subset(runda, T < W & !pomylka & runif(nrow(runda)) < 0.45)
  start <- ponow$start + ponow$T + runif(nrow(ponow), 60, 1200)
  ponow <- ponow[start %% 86400 < 22 * 3600, ]; start <- start[start %% 86400 < 22 * 3600]
  runda <- nowe_polaczenia(nrow(ponow), ponow$osoba, ponow$typ, start)
  runda$proba <- r
  polaczenia <- rbind(polaczenia, runda)
}
polaczenia <- polaczenia[order(polaczenia$start), ]
polaczenia$id <- sprintf("P%06d", seq_len(nrow(polaczenia)))
# Co zapisuje centrala: czas w kolejce i to, czy połączenie odebrano, czy dzwoniący się rozłączył
polaczenia$czas <- pmin(polaczenia$T, polaczenia$W)
polaczenia$rozlaczenie <- as.integer(polaczenia$T < polaczenia$W)
polaczenia$wynik <- factor(ifelse(polaczenia$rozlaczenie == 0, "odebrane (cenzurowanie)",
                                  ifelse(polaczenia$czas < 5, "pomyłka (< 5 s)", "rozłączenie")), names(kol_wynik))
polaczenia$pora <- factor(polaczenia$pora, pory)
polaczenia$typ <- factor(polaczenia$typ, typy)
rownames(polaczenia) <- NULL
# Kolumny T, W (gdy niewidoczne) i pomylka to ukryty mechanizm – w danych firmy ich nie ma

c(polaczenia = nrow(polaczenia), osoby = length(unique(polaczenia$osoba)),
  ponowne_proby = sum(polaczenia$proba > 1))
round(100 * prop.table(table(polaczenia$wynik)), 1)
round(100 * mean(polaczenia$czas == 0), 1)                     # % odebranych bez czekania
round(100 * tapply(polaczenia$czas == 0, polaczenia$pora, mean), 1)   # % odebranych od razu wg pory
round(100 * prop.table(table(polaczenia$typ)), 1)
round(100 * mean(polaczenia$komunikat), 1)

# Oś czasu: pięć połączeń z 2 września 2026 wybranych regułą (pierwsze danego rodzaju tego dnia)
wrz <- subset(polaczenia, dzien == 64)
b <- subset(wrz, proba == 1 & rozlaczenie == 1 & czas >= 60 & czas <= 150 & osoba %in% wrz$osoba[wrz$proba == 2])[1, ]
wybor <- rbind(subset(wrz, rozlaczenie == 0 & czas >= 40 & czas <= 90 & T < 400)[1, ], b,
               subset(wrz, osoba == b$osoba & proba == b$proba + 1)[1, ],
               subset(wrz, wynik == "pomyłka (< 5 s)")[1, ], subset(wrz, czas == 0)[1, ])
wybor$opis <- c("A: odebrane – cierpliwość co najmniej tyle", "B: rozłączenie – cierpliwość znana",
                "C: ta sama osoba co B dzwoni ponownie", "D: rozłączenie po kilku sekundach – pomyłka?",
                "E: odebrane od razu – nic o cierpliwości")
wybor$godzina <- sprintf("%02d:%02d", floor(wybor$godz), floor(60 * (wybor$godz %% 1)))
wybor[, c("id", "osoba", "godzina", "typ", "czas", "wynik", "T")]
wybor$y <- 5:1
wybor$etyk <- ifelse(wybor$czas == 0, "0 s", paste(round(wybor$czas), "s"))
p1 <- ggplot(wybor) +
  geom_segment(aes(x = czas, xend = T, y = y, yend = y), data = subset(wybor, rozlaczenie == 0 & czas > 0),
               colour = "grey55", linewidth = 1, linetype = "dotted") +
  geom_point(aes(x = T, y = y), data = subset(wybor, rozlaczenie == 0 & czas > 0), shape = 4, size = 3,
             colour = "grey45") +
  geom_segment(aes(x = 0, xend = czas, y = y, yend = y, colour = wynik), linewidth = 3) +
  geom_point(aes(x = 0, y = y), shape = 21, fill = "white", size = 3.5) +
  geom_point(aes(x = czas, y = y, colour = wynik, shape = wynik), size = 4.5, stroke = 1.5, fill = "white") +
  geom_text(aes(x = 0, y = y + 0.33, label = opis), hjust = 0, size = 4.2, fontface = "bold") +
  geom_text(aes(x = czas, y = y - 0.3, label = etyk), hjust = 0, nudge_x = 4, size = 3.8) +
  annotate("text", x = 200, y = 4.62, label = "kropki i ×: prawdziwa cierpliwość A\n(znana tylko w symulacji)",
           hjust = 1, size = 3.6, colour = "grey35") +
  scale_colour_manual(values = kol_wynik, breaks = names(kol_wynik), name = NULL, drop = FALSE) +
  scale_shape_manual(values = c("odebrane (cenzurowanie)" = 21, "rozłączenie" = 16, "pomyłka (< 5 s)" = 17),
                     breaks = names(kol_wynik), name = NULL, drop = FALSE) +
  scale_x_continuous(limits = c(0, 200), breaks = seq(0, 180, 30)) +
  scale_y_continuous(limits = c(0.5, 5.6), breaks = NULL) +
  labs(title = "Od wejścia do kolejki: rozłączenie albo odebranie",
       subtitle = "Kółko – wejście do kolejki po wyborze sprawy w menu; koniec odcinka – rozłączenie albo odebranie",
       x = "sekundy w kolejce", y = NULL) +
  motyw
p1   # zapis: ggsave("rezygnacja-infolinia-os-czasu.svg", p1, width = 10, height = 5.8)
Wynik w R
   polaczenia         osoby ponowne_proby
       119444         41525          9444

odebrane (cenzurowanie)             rozłączenie         pomyłka (< 5 s)
                   80.5                    17.1                     2.4
[1] 36
       szczyt poranny (6–9)                dzień (9–15)
                       25.0                        45.2
szczyt popołudniowy (15–19)             wieczór (19–22)
                       29.8                        59.6

      rozkład jazdy     bilety i zwroty          reklamacje utrudnienia w ruchu
               40.6                29.8                14.4                15.3
[1] 33.3
           id  osoba godzina                 typ czas                   wynik
81613 P081613 O58563   06:00       rozkład jazdy 48.3 odebrane (cenzurowanie)
81642 P081642 O66131   06:21 utrudnienia w ruchu 87.2             rozłączenie
81656 P081656 O66131   06:28 utrudnienia w ruchu 42.6             rozłączenie
81650 P081650 O05423   06:25     bilety i zwroty  1.4         pomyłka (< 5 s)
81615 P081615 O15554   06:02       rozkład jazdy  0.0 odebrane (cenzurowanie)
         T
81613 71.6
81642 87.2
81656 42.6
81650  1.4
81615 74.5
2. Średnia z rozłączeń a prawda: Rysunek 2
R
# Rysunek 2. Dlaczego średni czas do rozłączenia liczony z samych porzuceń myli
# (wymaga obiektów z przepisu 1: polaczenia, pory, motyw)
library(survival)
# Analiza cierpliwości: połączenia, które czekały (czas > 0), bez rozłączeń poniżej 5 s (pomyłki)
cierp <- subset(polaczenia, czas > 0 & !(rozlaczenie == 1 & czas < 5))
c(polaczenia_w_analizie = nrow(cierp), rozlaczenia = sum(cierp$rozlaczenie))
prawda <- subset(polaczenia, !pomylka)              # prawdziwa cierpliwość T znana tylko w symulacji
c(srednia_z_rozlaczen = mean(cierp$czas[cierp$rozlaczenie == 1]),
  srednia_wszystkich_czasow = mean(cierp$czas),
  prawdziwa_srednia = mean(prawda$T), prawdziwa_mediana = median(prawda$T)) |> round(1)
km_pora <- survfit(Surv(czas, rozlaczenie) ~ pora, data = cierp)
km_pora
tab <- data.frame(pora = factor(pory, pory),
                  z_rozlaczen = tapply(cierp$czas[cierp$rozlaczenie == 1], cierp$pora[cierp$rozlaczenie == 1], mean),
                  km_mediana = summary(km_pora)$table[, "median"],
                  prawdziwa_mediana = tapply(prawda$T, prawda$pora, median),
                  proc_rozlaczen_czekajacych = 100 * tapply(cierp$rozlaczenie, cierp$pora, mean), row.names = NULL)
tab[, -1] <- round(tab[, -1], 1)
tab

d2 <- rbind(data.frame(pora = tab$pora, s = tab$z_rozlaczen, miara = "średnia z samych rozłączeń"),
            data.frame(pora = tab$pora, s = tab$km_mediana, miara = "mediana z krzywej Kaplana–Meiera"),
            data.frame(pora = tab$pora, s = tab$prawdziwa_mediana, miara = "prawdziwa mediana (symulacja)"))
d2$miara <- factor(d2$miara, unique(d2$miara))
d2$pora <- factor(d2$pora, rev(pory))
p2 <- ggplot(d2, aes(x = s, y = pora)) +
  geom_line(aes(group = pora), colour = "grey75", linewidth = 1) +
  geom_point(aes(colour = miara, shape = miara), size = 4.2, stroke = 1.4) +
  geom_text(aes(label = round(s), colour = miara, vjust = ifelse(grepl("prawdziwa", miara), 2.1, -1.1)),
            size = 3.8, show.legend = FALSE) +
  scale_colour_manual(values = c("#D55E00", "#0072B2", "grey30"), name = NULL) +
  scale_shape_manual(values = c(16, 15, 4), name = NULL) +
  scale_x_continuous(limits = c(0, 250), breaks = seq(0, 250, 50)) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(title = "Ile sekund wytrzymuje dzwoniący? Trzy odpowiedzi",
       subtitle = "Wieczorem czeka się krótko, więc rozłączają się tylko najmniej cierpliwi",
       x = "sekundy w kolejce", y = NULL) +
  motyw
p2   # zapis: ggsave("rezygnacja-infolinia-srednia-z-rozlaczen.svg", p2, width = 10, height = 5.6)
Wynik w R
polaczenia_w_analizie           rozlaczenia
                73547                 20438
      srednia_z_rozlaczen srednia_wszystkich_czasow         prawdziwa_srednia
                     81.2                      73.4                     235.5
        prawdziwa_mediana
                    169.7
Call: survfit(formula = Surv(czas, rozlaczenie) ~ pora, data = cierp)

                                     n events median 0.95LCL 0.95UCL
pora=szczyt poranny (6–9)        23803   9292    145     142     149
pora=dzień (9–15)                19725   3192    199     190     215
pora=szczyt popołudniowy (15–19) 25792   7561    164     160     169
pora=wieczór (19–22)              4227    393    164     158      NA
                         pora z_rozlaczen km_mediana prawdziwa_mediana
1        szczyt poranny (6–9)        88.7      145.3             143.6
2                dzień (9–15)        65.5      198.7             192.6
3 szczyt popołudniowy (15–19)        80.4      164.3             162.9
4             wieczór (19–22)        47.8      164.5             212.2
  proc_rozlaczen_czekajacych
1                       39.0
2                       16.2
3                       29.3
4                        9.3
3. Krzywe Kaplana–Meiera i test log-rank: Rysunek 3
R
# Rysunek 3. Krzywe Kaplana–Meiera cierpliwości: typ sprawy z menu i komunikat o pozycji w kolejce
# (wymaga obiektów z przepisów 1–2: cierp, typy, motyw)
library(survival)
library(patchwork)
km_typ <- survfit(Surv(czas, rozlaczenie) ~ typ, data = cierp)
km_typ
matrix(round(100 * summary(km_typ, times = c(60, 120))$surv, 1), ncol = 2, byrow = TRUE,
       dimnames = list(typy, c("po 60 s", "po 120 s")))    # % wciąż czekających
# Komunikat losowano od 1 sierpnia, więc porównanie tylko na sierpniu i wrześniu
sw <- subset(cierp, dzien >= 32)
km_kom <- survfit(Surv(czas, rozlaczenie) ~ komunikat, data = sw)
km_kom
survdiff(Surv(czas, rozlaczenie) ~ komunikat, data = sw)

do_ramki <- function(km, grupy) {
  s <- summary(km, times = seq(0, 360, 3), extend = TRUE)
  data.frame(t = s$time, s = s$surv, d = s$lower, g = s$upper,
             grupa = factor(s$strata, levels = names(km$strata), labels = grupy))   # kolejność jak w danych
}
kol_typ <- c("#E69F00", "#0072B2", "#009E73", "#222222")
kol_kom <- c("#999999", "#0072B2")
d3a <- do_ramki(km_typ, typy)
d3b <- do_ramki(km_kom, c("bez komunikatu", "z komunikatem o pozycji"))
rysuj_km <- function(d, kol, linie, tytul) {
  ggplot(d, aes(t, s, colour = grupa, fill = grupa, linetype = grupa)) +
    geom_ribbon(aes(ymin = d, ymax = g), alpha = 0.2, colour = NA) +
    geom_step(linewidth = 1) +
    geom_hline(yintercept = 0.5, colour = "grey50", linetype = "dashed") +
    scale_colour_manual(values = kol, name = NULL) + scale_fill_manual(values = kol, name = NULL) +
    scale_linetype_manual(values = linie, name = NULL) +
    scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
    scale_x_continuous(breaks = seq(0, 360, 60)) +
    guides(colour = guide_legend(ncol = 2)) +
    labs(title = tytul, x = "sekundy w kolejce", y = "wciąż czekający") + motyw
}
p3 <- rysuj_km(d3a, kol_typ, c("solid", "dashed", "dotdash", "dotted"), "A. Typ sprawy wybrany w menu") +
  rysuj_km(d3b, kol_kom, c("dashed", "solid"), "B. Komunikat (sierpień–wrzesień)") +
  plot_annotation(title = "Cierpliwość dzwoniących: odsetek, który jeszcze się nie rozłączył",
                  theme = motyw)
p3   # zapis: ggsave("rezygnacja-infolinia-kaplan-meier.svg", p3, width = 10, height = 6)
Wynik w R
Call: survfit(formula = Surv(czas, rozlaczenie) ~ typ, data = cierp)

                            n events median 0.95LCL 0.95UCL
typ=rozkład jazdy       29725   9121    144     141     147
typ=bilety i zwroty     22036   5346    190     183     195
typ=reklamacje          10569   1915    258     249     274
typ=utrudnienia w ruchu 11217   4056    114     111     119
                    po 60 s po 120 s
rozkład jazdy          80.0     57.5
bilety i zwroty        85.4     67.4
reklamacje             90.1     77.2
utrudnienia w ruchu    74.4     48.1
Call: survfit(formula = Surv(czas, rozlaczenie) ~ komunikat, data = sw)

                    n events median 0.95LCL 0.95UCL
komunikat=FALSE 24149   7242    146     143     149
komunikat=TRUE  24551   5728    202     196     208
Call:
survdiff(formula = Surv(czas, rozlaczenie) ~ komunikat, data = sw)

                    N Observed Expected (O-E)^2/E (O-E)^2/V
komunikat=FALSE 24149     7242     6027       245       460
komunikat=TRUE  24551     5728     6943       213       460

 Chisq= 460  on 1 degrees of freedom, p= <2e-16
4. Modele parametryczne i AIC: Rysunek 4
R
# Rysunek 4. Model parametryczny cierpliwości: wykładniczy, Weibulla, log-normalny czy log-logistyczny?
# (wymaga obiektów z przepisów 1–2: cierp, motyw)
library(survival)
library(patchwork)
rozklady <- c("exponential", "weibull", "lognormal", "loglogistic")
nazwy <- c("wykładniczy", "Weibulla", "log-normalny", "log-logistyczny")
# a) modele z typem sprawy, porą i komunikatem – porównanie AIC
modele <- lapply(rozklady, function(r) survreg(Surv(czas, rozlaczenie) ~ typ + pora + komunikat,
                                                 data = cierp, dist = r))
aic <- sapply(modele, AIC)
data.frame(rozklad = nazwy, AIC = round(aic), delta_AIC = round(aic - min(aic)))
m_weib <- modele[[2]]
summary(m_weib)
c(ksztalt_weibulla = 1 / m_weib$scale)
round(exp(cbind(wspolczynnik_czasu = coef(m_weib), confint(m_weib)))[-1, ], 3)   # ilorazy czasu (AFT)
# b) dla rysunku: jedna jednorodna grupa (rozkład jazdy, szczyt poranny, bez komunikatu) –
#    modele bez zmiennych na tle krzywej Kaplana–Meiera i hazardu z tabeli trwania życia
g0 <- subset(cierp, typ == "rozkład jazdy" & pora == pory[1] & !komunikat)
km0 <- survfit(Surv(czas, rozlaczenie) ~ 1, data = g0)
km0
m0 <- lapply(rozklady, function(r) survreg(Surv(czas, rozlaczenie) ~ 1, data = g0, dist = r))
data.frame(rozklad = nazwy, AIC_grupa = round(sapply(m0, AIC)))
t_s <- seq(1, 450, 3)
przezycie <- function(m, t) {           # S(t) dla modeli survreg bez zmiennych
  mu <- coef(m)[1]; s <- m$scale; z <- (log(t) - mu) / s
  switch(m$dist, exponential = exp(-t / exp(mu)), weibull = exp(-exp(z)), lognormal = 1 - pnorm(z),
         loglogistic = 1 / (1 + exp(z)))
}
hazard <- function(m, t) {              # h(t) = f(t) / S(t), numerycznie (na sekundę)
  (log(przezycie(m, t)) - log(przezycie(m, t + 1))) }
d4 <- do.call(rbind, lapply(1:4, function(i)
  data.frame(t = t_s, s = przezycie(m0[[i]], t_s), h = hazard(m0[[i]], t_s), model = nazwy[i])))
d4$model <- factor(d4$model, nazwy)
s_km <- summary(km0, times = t_s, extend = TRUE)
d4km <- data.frame(t = s_km$time, s = s_km$surv)
# Hazard empiryczny: rozłączenia na sekundę czekania w przedziałach 30-sekundowych (tabela trwania życia)
br <- seq(0, 450, 30)
hz <- sapply(seq_len(length(br) - 1), function(j) {
  w <- pmin(g0$czas, br[j + 1]) - br[j]; w <- w[w > 0]
  sum(g0$rozlaczenie == 1 & g0$czas > br[j] & g0$czas <= br[j + 1]) / sum(w) })
d4h <- data.frame(t = br[-1] - 15, h = hz)
hz_tab <- data.frame(sekundy = paste(br[-length(br)], br[-1], sep = "–"), na_minute = round(60 * hz, 3))
hz_tab
kol_mod <- c("#999999", "#0072B2", "#E69F00", "#009E73")
lin_mod <- c("dotted", "solid", "dashed", "dotdash")
p4a <- ggplot() +
  geom_step(aes(t, s), data = d4km, colour = "black", linewidth = 1.2) +
  geom_line(aes(t, s, colour = model, linetype = model), data = d4, linewidth = 1) +
  scale_colour_manual(values = kol_mod, name = NULL) + scale_linetype_manual(values = lin_mod, name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  labs(title = "A. Kaplan–Meier (czarna) i modele", x = "sekundy w kolejce", y = "wciąż czekający") + motyw
p4b <- ggplot() +
  geom_point(aes(t, 60 * h), data = d4h, colour = "black", size = 2) +
  geom_line(aes(t, 60 * h, colour = model, linetype = model), data = d4, linewidth = 1) +
  scale_colour_manual(values = kol_mod, name = NULL) + scale_linetype_manual(values = lin_mod, name = NULL) +
  labs(title = "B. Hazard: rozłączenia na minutę", x = "sekundy w kolejce", y = "na minutę czekania") + motyw
p4 <- (p4a + p4b) + plot_layout(guides = "collect") &
  theme(legend.position = "bottom")
p4 <- p4 + plot_annotation(title = "Która krzywa pasuje do cierpliwości? Rosnący hazard to nie rozkład wykładniczy",
                           subtitle = "Rozkład jazdy, szczyt poranny, bez komunikatu",
                           theme = motyw)
p4   # zapis: ggsave("rezygnacja-infolinia-modele-parametryczne.svg", p4, width = 10, height = 5.8)
Wynik w R
          rozklad    AIC delta_AIC
1     wykładniczy 266018      2789
2        Weibulla 263307        78
3    log-normalny 263524       295
4 log-logistyczny 263229         0

Call:
survreg(formula = Surv(czas, rozlaczenie) ~ typ + pora + komunikat,
    data = cierp, dist = r)
                                   Value Std. Error      z       p
(Intercept)                      5.05651    0.01030 490.82 < 2e-16
typbilety i zwroty               0.25028    0.01287  19.44 < 2e-16
typreklamacje                    0.56330    0.01885  29.89 < 2e-16
typutrudnienia w ruchu          -0.21934    0.01408 -15.57 < 2e-16
poradzień (9–15)                 0.27515    0.01565  17.58 < 2e-16
poraszczyt popołudniowy (15–19)  0.10632    0.01160   9.16 < 2e-16
porawieczór (19–22)              0.31353    0.03878   8.08 6.2e-16
komunikatTRUE                    0.30420    0.01165  26.12 < 2e-16
Log(scale)                      -0.29368    0.00521 -56.37 < 2e-16

Scale= 0.746

Weibull distribution
Loglik(model)= -131644.5   Loglik(intercept only)= -133121.1
	Chisq= 2953.14 on 7 degrees of freedom, p= 0
Number of Newton-Raphson Iterations: 8
n= 73547

ksztalt_weibulla
        1.341356
                                wspolczynnik_czasu 2.5 % 97.5 %
typbilety i zwroty                           1.284 1.252  1.317
typreklamacje                                1.756 1.693  1.823
typutrudnienia w ruchu                       0.803 0.781  0.826
poradzień (9–15)                             1.317 1.277  1.358
poraszczyt popołudniowy (15–19)              1.112 1.087  1.138
porawieczór (19–22)                          1.368 1.268  1.476
komunikatTRUE                                1.356 1.325  1.387
Call: survfit(formula = Surv(czas, rozlaczenie) ~ 1, data = g0)

        n events median 0.95LCL 0.95UCL
[1,] 6385   2936    118     114     122
          rozklad AIC_grupa
1     wykładniczy     36206
2        Weibulla     35876
3    log-normalny     35913
4 log-logistyczny     35885
   sekundy na_minute
1     0–30     0.225
2    30–60     0.354
3    60–90     0.384
4   90–120     0.437
5  120–150     0.472
6  150–180     0.463
7  180–210     0.498
8  210–240     0.472
9  240–270     0.495
10 270–300     0.329
11 300–330     0.502
12 330–360     0.558
13 360–390     0.425
14 390–420     0.280
15 420–450     0.420
5. Model Coxa i porównanie z Weibullem: Rysunek 5
R
# Rysunek 5. Model Coxa: kto rozłącza się szybciej – i czy Weibull mówi to samo
# (wymaga obiektów z przepisów 1–4: cierp, m_weib, motyw)
library(survival)
cox <- coxph(Surv(czas, rozlaczenie) ~ typ + pora + komunikat, data = cierp, cluster = osoba)
summary(cox)
cox.zph(cox)                                       # proporcjonalność hazardów (reszty Schoenfelda)
# Ta sama osoba dzwoni wiele razy: zwykłe i odporne (klaster = osoba) błędy standardowe
round(cbind(zwykly_se = sqrt(diag(cox$naive.var)), odporny_se = sqrt(diag(cox$var))), 4)
# HR z modelu Weibulla: exp(−współczynnik / skala), CI metodą delta
b <- coef(m_weib)[-1]; s <- m_weib$scale
V <- vcov(m_weib); k <- length(coef(m_weib))
gr <- cbind(diag(-1 / s, k - 1), b / s)            # pochodne −b/s po b i po log(skala)
se_w <- sqrt(diag(gr %*% V[c(2:k, k + 1), c(2:k, k + 1)] %*% t(gr)))
hr <- data.frame(zmienna = names(b),
                 model = rep(c("Cox", "Weibull (PH)"), each = length(b)),
                 hr = c(exp(coef(cox)), exp(-b / s)),
                 d = c(exp(confint(cox)[, 1]), exp(-b / s - 1.96 * se_w)),
                 g = c(exp(confint(cox)[, 2]), exp(-b / s + 1.96 * se_w)), row.names = NULL)
hr[, 3:5] <- round(hr[, 3:5], 3)
hr
etyk <- c("typbilety i zwroty" = "bilety i zwroty", "typreklamacje" = "reklamacje",
          "typutrudnienia w ruchu" = "utrudnienia w ruchu", "poradzień (9–15)" = "dzień (9–15)",
          "poraszczyt popołudniowy (15–19)" = "szczyt popołudniowy", "porawieczór (19–22)" = "wieczór (19–22)",
          "komunikatTRUE" = "komunikat o pozycji")
hr$etyk <- factor(etyk[hr$zmienna], rev(etyk))
hr$grupa <- ifelse(grepl("^typ", hr$zmienna), "sprawa (wobec: rozkład jazdy)",
                   ifelse(grepl("^pora", hr$zmienna), "pora (wobec: szczyt poranny)", "komunikat (wobec: brak)"))
hr$grupa <- factor(hr$grupa, unique(hr$grupa))
p5 <- ggplot(hr, aes(x = hr, y = etyk, colour = model, shape = model)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_errorbar(aes(xmin = d, xmax = g), width = 0.25, orientation = "y", position = position_dodge(width = 0.55), linewidth = 0.9) +
  geom_point(size = 3.4, position = position_dodge(width = 0.55)) +
  geom_text(aes(x = g, label = ifelse(model == "Cox", sprintf("%.2f", hr), "")), colour = "black", hjust = -0.25,
            size = 3.6, position = position_dodge(width = 0.55), show.legend = FALSE) +
  facet_grid(grupa ~ ., scales = "free_y", space = "free_y") +
  scale_x_log10(breaks = c(0.4, 0.5, 0.6, 0.8, 1, 1.25, 1.5), limits = c(0.42, 1.6)) +
  scale_colour_manual(values = c("Cox" = "#0072B2", "Weibull (PH)" = "#D55E00"), name = NULL) +
  scale_shape_manual(values = c("Cox" = 16, "Weibull (PH)" = 17), name = NULL) +
  labs(title = "Iloraz hazardów rozłączenia: < 1 – dzwoniący wytrzymują dłużej",
       subtitle = "Punkty: HR z modelu Coxa i z modelu Weibulla; odcinki: 95% CI (oś logarytmiczna)",
       x = "iloraz hazardów rozłączenia (HR)", y = NULL) +
  motyw + theme(strip.text.y = element_text(angle = 0, hjust = 0, face = "bold"))
p5   # zapis: ggsave("rezygnacja-infolinia-cox.svg", p5, width = 10, height = 6.2)
Wynik w R
Call:
coxph(formula = Surv(czas, rozlaczenie) ~ typ + pora + komunikat,
    data = cierp, cluster = osoba)

  n= 73547, number of events= 20438

                                    coef exp(coef) se(coef) robust se       z
typbilety i zwroty              -0.32985   0.71903  0.01724   0.01745 -18.907
typreklamacje                   -0.73881   0.47768  0.02520   0.02527 -29.238
typutrudnienia w ruchu           0.28641   1.33164  0.01889   0.01909  15.000
poradzień (9–15)                -0.39065   0.67661  0.02069   0.02093 -18.665
poraszczyt popołudniowy (15–19) -0.15051   0.86027  0.01552   0.01582  -9.515
porawieczór (19–22)             -0.45124   0.63684  0.05175   0.05195  -8.686
komunikatTRUE                   -0.39662   0.67259  0.01562   0.01558 -25.455
                                Pr(>|z|)
typbilety i zwroty                <2e-16 ***
typreklamacje                     <2e-16 ***
typutrudnienia w ruchu            <2e-16 ***
poradzień (9–15)                  <2e-16 ***
poraszczyt popołudniowy (15–19)   <2e-16 ***
porawieczór (19–22)               <2e-16 ***
komunikatTRUE                     <2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

                                exp(coef) exp(-coef) lower .95 upper .95
typbilety i zwroty                 0.7190      1.391    0.6949    0.7440
typreklamacje                      0.4777      2.093    0.4546    0.5019
typutrudnienia w ruchu             1.3316      0.751    1.2827    1.3824
poradzień (9–15)                   0.6766      1.478    0.6494    0.7049
poraszczyt popołudniowy (15–19)    0.8603      1.162    0.8340    0.8874
porawieczór (19–22)                0.6368      1.570    0.5752    0.7051
komunikatTRUE                      0.6726      1.487    0.6524    0.6934

Concordance= 0.607  (se = 0.002 )
Likelihood ratio test= 2875  on 7 df,   p=<2e-16
Wald test            = 2701  on 7 df,   p=<2e-16
Score (logrank) test = 2805  on 7 df,   p=<2e-16,   Robust = 2449  p=<2e-16

  (Note: the likelihood ratio and score tests assume independence of
     observations within a cluster, the Wald and robust score tests do not).
           chisq df    p
typ       3.1316  3 0.37
pora      4.9302  3 0.18
komunikat 0.0214  1 0.88
GLOBAL    8.1831  7 0.32
     zwykly_se odporny_se
[1,]    0.0172     0.0174
[2,]    0.0252     0.0253
[3,]    0.0189     0.0191
[4,]    0.0207     0.0209
[5,]    0.0155     0.0158
[6,]    0.0517     0.0520
[7,]    0.0156     0.0156
                           zmienna        model    hr     d     g
1               typbilety i zwroty          Cox 0.719 0.695 0.744
2                    typreklamacje          Cox 0.478 0.455 0.502
3           typutrudnienia w ruchu          Cox 1.332 1.283 1.382
4                 poradzień (9–15)          Cox 0.677 0.649 0.705
5  poraszczyt popołudniowy (15–19)          Cox 0.860 0.834 0.887
6              porawieczór (19–22)          Cox 0.637 0.575 0.705
7                    komunikatTRUE          Cox 0.673 0.652 0.693
8               typbilety i zwroty Weibull (PH) 0.715 0.691 0.739
9                    typreklamacje Weibull (PH) 0.470 0.447 0.493
10          typutrudnienia w ruchu Weibull (PH) 1.342 1.293 1.393
11                poradzień (9–15) Weibull (PH) 0.691 0.664 0.720
12 poraszczyt popołudniowy (15–19) Weibull (PH) 0.867 0.841 0.894
13             porawieczór (19–22) Weibull (PH) 0.657 0.593 0.727
14                   komunikatTRUE Weibull (PH) 0.665 0.645 0.686
6. Prognoza odsetka rozłączeń przy czekaniu krótszym o 30 s: Rysunek 6
R
# Rysunek 6. Odsetek rozłączeń jako funkcja czasu oczekiwania i prognoza: co da skrócenie czekania o 30 s?
# (wymaga obiektów z przepisów 1–4: polaczenia, modele, m_weib, pory, motyw)
library(survival)
library(patchwork)
bez_pomylek <- subset(polaczenia, !(rozlaczenie == 1 & czas < 5))   # wszystkie połączenia poza pomyłkami
# Szansa rozłączenia przed upływem w sekund z modelu survreg: Weibull F = 1 − exp(−(w / e^lp)^(1/s)),
# log-logistyczny F = 1 − 1 / (1 + (w / e^lp)^(1/s))
F_model <- function(X, w, b, s, rozklad = "weibull") {
  z <- outer(exp(-(X %*% b) / s)[, 1], w^(1 / s))
  if (rozklad == "weibull") 1 - exp(-z) else 1 - 1 / (1 + z)
}
# Oferowany czas oczekiwania W też jest cenzurowany – rozłączeniem. Jego rozkład w każdej porze:
# Kaplan–Meier z odebraniem jako zdarzeniem (W nie zależy od cierpliwości dzwoniącego).
siatka <- 0:1800
skladniki <- lapply(pory, function(p) {
  dp <- subset(bez_pomylek, pora == p)
  g <- survfit(Surv(czas, 1 - rozlaczenie) ~ 1, data = dp)
  Sg <- c(1, summary(g, times = siatka, extend = TRUE)$surv)
  masa <- -diff(Sg); masa[length(masa)] <- masa[length(masa)] + tail(Sg, 1)  # ogon dopisany do 1800 s
  wz <- aggregate(list(n = dp$id), dp[, c("typ", "pora", "komunikat")], length)  # wzorce zmiennych
  list(dp = dp, masa = masa, n = wz$n, X = model.matrix(delete.response(terms(m_weib)), wz, xlev = m_weib$xlevels))
})
prognoza <- function(sk, b = coef(m_weib), s = m_weib$scale, skrot = 0, rozklad = "weibull")
  sum(sk$n * (F_model(sk$X, pmax(siatka - skrot, 0), b, s, rozklad) %*% sk$masa)) / sum(sk$n)
wyn <- do.call(rbind, lapply(skladniki, function(sk) {
  dp <- sk$dp
  data.frame(pora = dp$pora[1], n = nrow(dp), obserwowany = 100 * mean(dp$rozlaczenie),
             model_teraz = 100 * prognoza(sk), model_minus_30s = 100 * prognoza(sk, skrot = 30),
             prawda_minus_30s = 100 * mean(dp$T < pmax(dp$W - 30, 0)))   # prawda znana tylko w symulacji
}))
wyn$spadek_pp <- wyn$model_teraz - wyn$model_minus_30s
wyn[, 3:7] <- round(wyn[, 3:7], 1)
wyn
# Cała infolinia: o ile mniej rozłączeń w kwartale, z niepewnością parametrów modelu (300 losowań)
cala <- function(b, s, skrot) sum(sapply(skladniki, function(sk) nrow(sk$dp) * prognoza(sk, b, s, skrot)))
set.seed(754)
los <- MASS::mvrnorm(300, c(coef(m_weib), log(m_weib$scale)), vcov(m_weib))
mniej <- apply(los, 1, function(v) { b <- v[-length(v)]; s <- exp(v[length(v)]); cala(b, s, 0) - cala(b, s, 30) })
c(rozlaczen_obserwowanych = sum(bez_pomylek$rozlaczenie),
  model_teraz = cala(coef(m_weib), m_weib$scale, 0),
  mniej_rozlaczen = cala(coef(m_weib), m_weib$scale, 0) - cala(coef(m_weib), m_weib$scale, 30),
  ci_dolna = unname(quantile(mniej, 0.025)), ci_gorna = unname(quantile(mniej, 0.975)),
  prawda_mniej = sum(bez_pomylek$rozlaczenie) - sum(bez_pomylek$T < pmax(bez_pomylek$W - 30, 0))) |> round()
# Wrażliwość na wybór rozkładu: spadek w pp z modelu log-logistycznego (przepis 4)
m_ll <- modele[[4]]
wrazliwosc <- cbind(weibull = wyn$spadek_pp, log_logistyczny = sapply(skladniki, function(sk)
  100 * (prognoza(sk, coef(m_ll), m_ll$scale, 0, "ll") - prognoza(sk, coef(m_ll), m_ll$scale, 30, "ll"))))
rownames(wrazliwosc) <- pory
round(wrazliwosc, 1)

# Panel A: krzywa F(w) dla sprawy „rozkład jazdy” w szczycie porannym, bez i z komunikatem
nd <- expand.grid(typ = "rozkład jazdy", pora = pory[1], komunikat = c(FALSE, TRUE))
Xnd <- model.matrix(delete.response(terms(m_weib)), nd, xlev = m_weib$xlevels)
w <- 0:600
d6a <- data.frame(w = rep(w, 2), F = as.vector(t(F_model(Xnd, w, coef(m_weib), m_weib$scale))),
                  grupa = rep(c("bez komunikatu", "z komunikatem o pozycji"), each = length(w)))
punkty <- subset(d6a, w %in% c(90, 120))
punkty
p6a <- ggplot(d6a, aes(w, F, colour = grupa, linetype = grupa)) +
  geom_line(linewidth = 1.1) +
  geom_point(data = punkty, size = 2.6) +
  annotate("text", x = 260, y = 0.3, hjust = 0, size = 3.6,
           label = sprintf("bez komunikatu:\n120 s → 90 s czekania\n= %.0f%% → %.0f%% rozłączeń", 100 * punkty$F[2], 100 * punkty$F[1])) +
  scale_colour_manual(values = c("#999999", "#0072B2"), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 1)) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "A. Rozłączy się, zanim minie w s", subtitle = "rozkład jazdy, szczyt poranny",
       x = "oferowany czas oczekiwania w (s)", y = "odsetek rozłączeń") + motyw
krotko <- function(x) factor(sub(" \\(.*", "", x), sub(" \\(.*", "", pory))
d6b <- rbind(data.frame(pora = wyn$pora, proc = wyn$model_teraz, wariant = "teraz (model)"),
             data.frame(pora = wyn$pora, proc = wyn$model_minus_30s, wariant = "czekanie krótsze o 30 s (model)"))
d6b$wariant <- factor(d6b$wariant, unique(d6b$wariant))
d6b$y_et <- ifelse(d6b$wariant == "teraz (model)", d6b$proc + 0.6,
                   pmax(d6b$proc, rep(wyn$prawda_minus_30s, 2)) + 1.6)        # etykieta nad znakiem ×
d6b$pora <- krotko(d6b$pora)
p6b <- ggplot(d6b, aes(pora, proc, fill = wariant)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75) +
  geom_text(aes(y = y_et, label = sprintf("%.1f", proc)), position = position_dodge(width = 0.8), vjust = 0, size = 3.5) +
  geom_point(aes(x = as.numeric(pora) + 0.2, y = prawda_minus_30s), data = transform(wyn, pora = krotko(pora)),
             inherit.aes = FALSE, shape = 4, size = 3, stroke = 1.3) +
  scale_fill_manual(values = c("#E69F00", "#0072B2"), name = NULL) +
  scale_x_discrete(labels = function(x) sub(" ", "\n", x)) +
  guides(fill = guide_legend(ncol = 1)) +
  labs(title = "B. Odsetek rozłączeń w porze dnia", subtitle = "× – prawda po skróceniu (symulacja)",
       x = NULL, y = "% połączeń") + motyw
p6 <- p6a + p6b + plot_layout(widths = c(1, 1.15))
p6   # zapis: ggsave("rezygnacja-infolinia-prognoza-30-s.svg", p6, width = 10, height = 6)
Wynik w R
                         pora     n obserwowany model_teraz model_minus_30s
1        szczyt poranny (6–9) 32086        29.0        29.0            22.9
2                dzień (9–15) 36625         8.7         8.8             5.4
3 szczyt popołudniowy (15–19) 37174        20.3        20.4            15.0
4             wieczór (19–22) 10678         3.7         3.7             1.7
  prawda_minus_30s spadek_pp
1             23.2       6.1
2              5.3       3.4
3             15.0       5.4
4              1.7       2.0
rozlaczen_obserwowanych             model_teraz         mniej_rozlaczen
                  20438                   20501                    5419
               ci_dolna                ci_gorna            prawda_mniej
                   5365                    5474                    5284
                            weibull log_logistyczny
szczyt poranny (6–9)            6.1             6.0
dzień (9–15)                    3.4             3.4
szczyt popołudniowy (15–19)     5.4             5.4
wieczór (19–22)                 2.0             2.0
      w         F                   grupa
91   90 0.3774374          bez komunikatu
121 120 0.5019639          bez komunikatu
692  90 0.2703055 z komunikatem o pozycji
722 120 0.3709397 z komunikatem o pozycji
7. Pułapki: ponowne połączenia i próg pomyłek
R
# Pułapki: ponowne połączenia tych samych osób i próg krótkich rozłączeń (pomyłek)
# (wymaga obiektów z przepisu 1: polaczenia)
library(survival)
# a) Ponowne połączenia: łączymy próby jednej osoby w „sprawę”, gdy przerwa jest krótsza niż 30 minut
p <- polaczenia[order(polaczenia$osoba, polaczenia$start), ]
koniec_poprz <- c(NA, (p$start + p$czas)[-nrow(p)])
nowa <- c(TRUE, p$osoba[-1] != p$osoba[-nrow(p)]) | (p$start - koniec_poprz > 1800)
p$sprawa <- cumsum(nowa)
ostatnie <- !duplicated(p$sprawa, fromLast = TRUE)
porzucone <- p$rozlaczenie == 1 & p$czas >= 5
pomylki <- p$rozlaczenie == 1 & p$czas < 5
c(polaczen = nrow(p), spraw = max(p$sprawa),
  proc_polaczen_porzuconych = 100 * sum(porzucone) / sum(!pomylki),       # bez pomyłek w mianowniku
  proc_porzuconych_z_ponowna_proba = 100 * mean(!ostatnie[porzucone]),
  proc_spraw_bez_rozmowy = 100 * mean(porzucone[ostatnie])) |> round(1)
table(proby_w_sprawie = pmin(tabulate(p$sprawa), 4))      # 4 = cztery lub więcej
# b) Próg pomyłek: co zmienia usunięcie rozłączeń krótszych niż 0, 3, 5, 10 s
progi <- sapply(c(0, 3, 5, 10), function(prog) {
  usun <- polaczenia$rozlaczenie == 1 & polaczenia$czas < prog
  d <- subset(polaczenia, !usun & czas > 0)
  c(prog_s = prog, proc_rozlaczen = 100 * mean(polaczenia$rozlaczenie[!usun]),
    usunieto_pomylek = sum(usun & polaczenia$pomylka), usunieto_prawdziwych = sum(usun & !polaczenia$pomylka),
    mediana_km = unname(summary(survfit(Surv(czas, rozlaczenie) ~ 1, data = d))$table["median"]),
    S_10s = 100 * summary(survfit(Surv(czas, rozlaczenie) ~ 1, data = d), times = 10)$surv)
})
round(t(progi), 1)
sum(polaczenia$pomylka & polaczenia$czas > 0 & polaczenia$rozlaczenie == 1)   # pomyłki w danych (prawda)
Wynik w R
                        polaczen                            spraw
                        119444.0                         109855.0
       proc_polaczen_porzuconych proc_porzuconych_z_ponowna_proba
                            17.5                             45.0
          proc_spraw_bez_rozmowy
                            10.2
proby_w_sprawie
     1      2      3      4
101344   7553    838    120
     prog_s proc_rozlaczen usunieto_pomylek usunieto_prawdziwych mediana_km
[1,]      0           19.5                0                    0      154.5
[2,]      3           18.4             1262                  326      158.5
[3,]      5           17.5             2270                  611      161.7
[4,]     10           16.9             2287                 1455      164.4
     S_10s
[1,]  95.0
[2,]  97.0
[3,]  98.8
[4,] 100.0
[1] 2287
8. Paleta a zaburzenia widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("odebrane – rozłączenie" = c("#0072B2", "#D55E00"),
             "bez – z komunikatem" = c("#999999", "#0072B2"),
             "rozkład jazdy – bilety" = c("#E69F00", "#0072B2"),
             "bilety – reklamacje" = c("#0072B2", "#009E73"),
             "reklamacje – utrudnienia" = c("#009E73", "#222222"),
             "rozkład jazdy – utrudnienia" = c("#E69F00", "#222222"),
             "wykładniczy – Weibull" = c("#999999", "#0072B2"),
             "log-normalny – log-logistyczny" = c("#E69F00", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
odebrane – rozłączenie                     114.6        108.3       91.9
bez – z komunikatem                         44.9         48.9       40.6
rozkład jazdy – bilety                     120.2        121.5      109.3
bilety – reklamacje                         70.1         55.4       58.0
reklamacje – utrudnienia                    65.1         43.6       50.8
rozkład jazdy – utrudnienia                 95.6         94.6       88.0
wykładniczy – Weibull                       44.9         48.9       40.6
log-normalny – log-logistyczny              88.7         66.3       51.5
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, średnie i AIC – bazowy R (pakiety stats i base); estymator Kaplana–Meiera (survfit()), test log-rank (survdiff()), modele parametryczne (survreg()), model Coxa z błędami odpornymi (coxph(), cluster) i test proporcjonalności (cox.zph()) – pakiet survival; losowanie parametrów modelu – MASS::mvrnorm(). Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Średnia z samych rozłączeń zaniża cierpliwość prawie trzykrotnie i odwraca kolejność pór dnia (rysunek 2).
- Ponowne połączenia tych samych osób. 45.0% rozłączonych zadzwoniło ponownie w ciągu 30 minut. Odsetek porzuconych połączeń (17.5%) to nie odsetek ludzi bez pomocy: po złączeniu prób jednej osoby w sprawę (przerwa krótsza niż 30 minut) bez rozmowy kończy się 10.2% spraw. Raportuj oba i licz błędy odporne na klastrowanie według osoby.
- Krótkie rozłączenia (pomyłki). Bez progu odsetek rozłączeń to 19.5%, a mediana cierpliwości – 154.5 s. Próg 5 s usuwa 2270 z 2287 pomyłek i 611 prawdziwych rozłączeń (17.5%, mediana 161.7 s), a próg 10 s – już 1455 prawdziwych. Ustal próg przed analizą, sprawdź wynik przy kilku progach i opisz go w Metodzie.
- Cenzurowanie zależne od cierpliwości. Jeśli system oddzwania albo wybiera z kolejki „stałych klientów”, odebranie zależy od cierpliwości, a Kaplan–Meier i modele są obciążone.
Najczęstsze pytania
Jak policzyć średni czas, po którym klienci rozłączają się na infolinii?
Nie licz średniej z samych porzuconych połączeń – mierzy ona, jak długo kazano czekać, a nie cierpliwość. W przykładzie dała 81.2 s, choć prawdziwa średnia cierpliwość to 235.5 s. Połączenia odebrane potraktuj jako obserwacje cenzurowane i podaj medianę cierpliwości z krzywej Kaplana–Meiera albo z modelu parametrycznego.
Jak oszacować, o ile spadnie odsetek porzuceń po skróceniu czasu oczekiwania?
Potrzebne są dwie krzywe: cierpliwości (np. model Weibulla) i oferowanego czasu oczekiwania (Kaplan–Meier z odebraniem jako zdarzeniem). Odsetek porzuceń to średnia szansy rozłączenia przed upływem czasu oczekiwania; skrócenie przesuwa ten czas. W przykładzie 30 s mniej obniża odsetek rozłączeń w porannym szczycie z 29.0% do 22.9%.
Który rozkład wybrać dla czasu cierpliwości: Weibulla czy log-normalny?
Porównaj AIC i wykres hazardu. Gdy ryzyko rozłączenia rośnie w miarę czekania, pasuje rozkład Weibulla z kształtem powyżej 1; rozkład wykładniczy zakłada stały hazard. Prognozę sprawdź w drugim modelu – w przykładzie modele Weibulla i log-logistyczny dały te same spadki odsetka rozłączeń.
Czy krótkie rozłączenia na infolinii liczyć jako porzucenia?
Rozłączenia w pierwszych sekundach to głównie pomyłki. Ustal próg przed analizą (np. 5 s), sprawdź wyniki przy kilku progach i opisz go w Metodzie. W przykładzie bez progu odsetek rozłączeń wynosił 19.5%, a z progiem 5 s – 17.5%.
Czy Erlang C uwzględnia klientów, którzy się rozłączają?
Nie – Erlang C zakłada, że każdy czeka do skutku. Model Erlang A (M/M/N+M) dodaje wykładniczą cierpliwość, a gdy dane pokazują rosnący hazard rozłączeń, obsadę lepiej sprawdzić symulacją kolejki z oszacowanym rozkładem cierpliwości.
Powiązane hasła
Przeczytaj też
Obsada infolinii – Erlang C i symulacja
Infolinia dostawcy energii: test Poissona, czas rozmowy, Erlang C ręcznie, symulacja kolejki z rozłączeniami i grafik w kwadransach – sześć rysunków z kodem R.
Czytaj →PoradnikKaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikKrzywa rezerwacji i pick-up
Kemping z 40 domkami: krzywa rezerwacji, prognoza obłożenia metodą pick-up, MAE według horyzontu i czas do anulowania (Kaplan–Meier, Cox) – z kodem R.
Czytaj →Analizujesz kolejki, czasy oczekiwania albo porzucenia w pracy dyplomowej?
Pomożemy zakodować czas w kolejce i cenzurowanie, dobrać krzywe Kaplana–Meiera, model Weibulla lub Coxa, policzyć prognozę i opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L., Gans, N., Mandelbaum, A., Sakov, A., Shen, H., Zeltyn, S., & Zhao, L. (2005). Statistical analysis of a telephone call center: A queueing-science perspective. Journal of the American Statistical Association, 100(469), 36–50. https://doi.org/10.1198/016214504000001808
- Carroll, K. J. (2003). On the use and utility of the Weibull model in the analysis of survival data. Controlled Clinical Trials, 24(6), 682–701. https://doi.org/10.1016/s0197-2456(03)00072-2
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Gans, N., Koole, G., & Mandelbaum, A. (2003). Telephone call centers: Tutorial, review, and research prospects. Manufacturing & Service Operations Management, 5(2), 79–141. https://doi.org/10.1287/msom.5.2.79.16071 ● Otwarty dostęp: pełny tekst
- Garnett, O., Mandelbaum, A., & Reiman, M. (2002). Designing a call center with impatient customers. Manufacturing & Service Operations Management, 4(3), 208–227. https://doi.org/10.1287/msom.4.3.208.7753
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Leung, K.-M., Elashoff, R. M., & Afifi, A. A. (1997). Censoring issues in survival analysis. Annual Review of Public Health, 18(1), 83–104. https://doi.org/10.1146/annurev.publhealth.18.1.83
- Wei, L. J. (1992). The accelerated failure time model: A useful alternative to the Cox regression model in survival analysis. Statistics in Medicine, 11(14–15), 1871–1879. https://doi.org/10.1002/sim.4780111409
Cytowania BibTeX
@article{brown2005statistical, author={Brown, Lawrence and Gans, Noah and Mandelbaum, Avishai and Sakov, Anat and Shen, Haipeng and Zeltyn, Sergey and Zhao, Linda}, title={{Statistical analysis of a telephone call center: A queueing-science perspective}}, journal={Journal of the American Statistical Association}, year={2005}, volume={100}, number={469}, pages={36--50}, doi={10.1198/016214504000001808}}@article{carroll2003use, author={Carroll, Kevin J.}, title={{On the use and utility of the Weibull model in the analysis of survival data}}, journal={Controlled Clinical Trials}, year={2003}, volume={24}, number={6}, pages={682--701}, doi={10.1016/s0197-2456(03)00072-2}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{gans2003telephone, author={Gans, Noah and Koole, Ger and Mandelbaum, Avishai}, title={{Telephone call centers: Tutorial, review, and research prospects}}, journal={Manufacturing \& Service Operations Management}, year={2003}, volume={5}, number={2}, pages={79--141}, doi={10.1287/msom.5.2.79.16071}}@article{garnett2002designing, author={Garnett, O. and Mandelbaum, A. and Reiman, M.}, title={{Designing a call center with impatient customers}}, journal={Manufacturing \& Service Operations Management}, year={2002}, volume={4}, number={3}, pages={208--227}, doi={10.1287/msom.4.3.208.7753}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{leung1997censoring, author={Leung, Kwan-Moon and Elashoff, Robert M. and Afifi, Abdelmonem A.}, title={{Censoring issues in survival analysis}}, journal={Annual Review of Public Health}, year={1997}, volume={18}, number={1}, pages={83--104}, doi={10.1146/annurev.publhealth.18.1.83}}@article{wei1992accelerated, author={Wei, L. J.}, title={{The accelerated failure time model: A useful alternative to the Cox regression model in survival analysis}}, journal={Statistics in Medicine}, year={1992}, volume={11}, number={14–15}, pages={1871--1879}, doi={10.1002/sim.4780111409}}