Przykład: kemping z 40 domkami i pytanie „ile domków zajmiemy w sierpniu?”
Fikcyjny kemping nad jeziorem ma 40 domków i sezon letni trwający 63 noce, od soboty na przełomie czerwca i lipca do początku września. System rezerwacji zapisuje dla każdej rezerwacji datę jej dokonania, datę przyjazdu, liczbę nocy i ewentualną datę odwołania. Mamy cztery sezony, 2023–2026: 1621 przyjętych rezerwacji, z czego 22.9% odwołano przed przyjazdem. Mediana wyprzedzenia to 53 dni, średni pobyt – 5.66 nocy.
Właścicielka pyta: ile domków będzie zajętych w każdą noc sezonu – żeby zaplanować sprzątanie, obsadę recepcji i promocje – i ile z dzisiejszych rezerwacji jeszcze się odwoła. Odpowiedź dają dwa narzędzia: krzywa rezerwacji z prognozą metodą pick-up oraz analiza czasu do anulowania.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie (pełna lista przy kodzie): zapytania o przyjazd rosną ku przełomowi lipca i sierpnia i przypadają głównie na soboty, popyt rośnie co roku (o 3%, 6% i 12% względem 2023), 55% gości rezerwuje z dużym wyprzedzeniem (średnio 110 dni), reszta w ostatnich tygodniach. Rezerwację przyjmujemy tylko wtedy, gdy na wszystkie noce jest wolny domek. Ryzyko odwołania rośnie z wyprzedzeniem (prawdziwy iloraz hazardów 1.15 na 30 dni) i maleje z długością pobytu (0.92 na noc). W 2026 roku kemping wprowadził nowość: −20% na pobyty od 22 sierpnia rezerwowane najwyżej 21 dni przed przyjazdem. Ziarno (753) ustaliliśmy raz. Dane pobierzesz jako krzywa-rezerwacji-kemping.csv.
Prognozy uczymy na sezonach 2023–2025 i sprawdzamy na sezonie 2026 – podział w czasie, jak we wpisie o przecieku danych i walidacji w czasie. Prognozę sprzedaży z samego szeregu czasowego opisuje wpis o sezonowości i promocjach; tu mamy coś więcej – rezerwacje, które już są na stanie.
Rysunek 1: krzywa rezerwacji
Dla każdej nocy pobytu liczymy, ile domków było zarezerwowanych (i jeszcze nieodwołanych) 180, 179, … 1 dzień wcześniej. To rezerwacje na stanie (ang. on the books). Linia, która z tych liczb powstaje, to krzywa rezerwacji (ang. booking curve); na rysunku – średnio dla nocy sezonu.
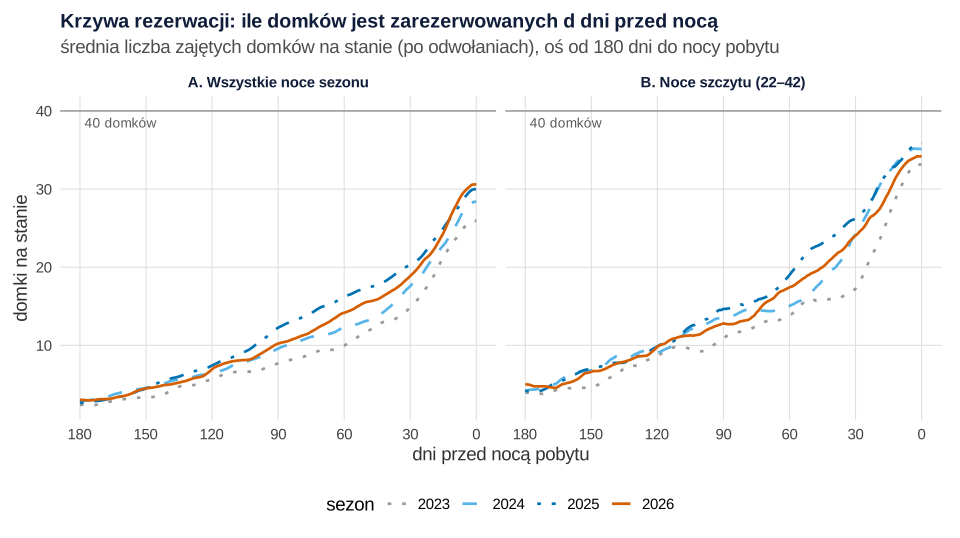
set.seed(753)).Co widać. Krzywe rosną powoli przez kilka miesięcy i przyspieszają w ostatnim miesiącu. W sezonach 2023–2025 na 30 dni przed nocą było na stanie 62.6% końcowego obłożenia, a na 90 dni – 35.1%. Średnie obłożenie rosło z 64.8% (2023) do 76.5% (2026). Krzywa 2026 kończy się najwyżej, choć w połowie drogi wyprzedzała ją krzywa 2025 – wzrost popytu widać dopiero blisko nocy, a prognoza musi go wychwycić.
Jak może zmylić. Średnia krzywa ukrywa różnice między nocami: soboty w szczycie zapełniają się wcześniej niż wtorki na początku lipca. Dlatego prognozujemy każdą noc osobno, a średnia służy tylko do oglądu.
Podpis do pracy:
Rysunek 2: metoda pick-up na jednej nocy
Metoda pick-up (ang. „dobór”, czyli przyrost rezerwacji) mówi: końcowe obłożenie = to, co już jest na stanie, plus to, co zwykle dochodzi od dziś do tej nocy. Wersja addytywna dodaje średni przyrost z poprzednich sezonów, a multiplikatywna mnoży stan przez średni stosunek obłożenia do stanu:
gdzie d to liczba dni do nocy, a średnie liczymy dla tej samej nocy sezonu (ten sam dzień tygodnia) w latach 2023–2025. Obok stoi prognoza historyczna – sama średnia obłożenia z lat, bez patrzenia na stan.
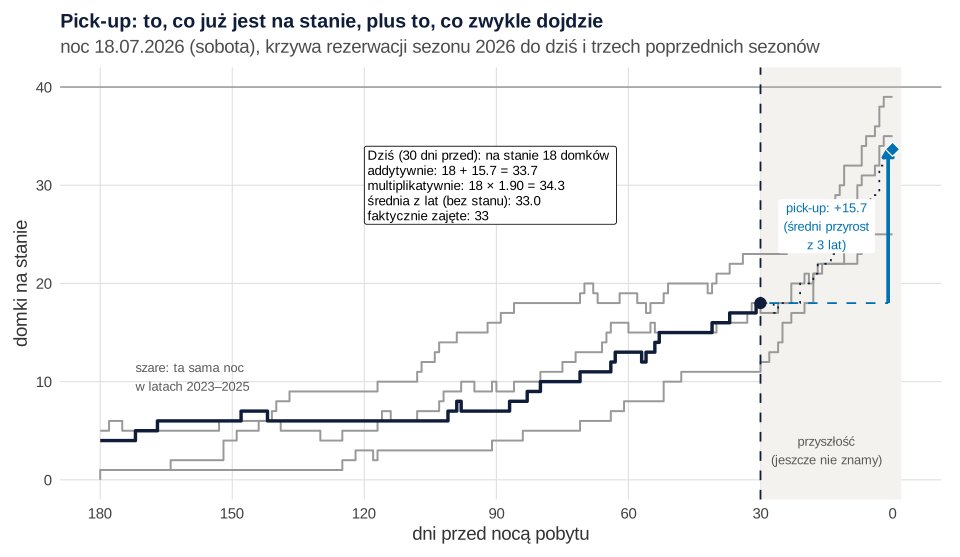
Co widać. 30 dni przed sobotą 18 lipca 2026 na stanie było 18 domków. W latach 2023–2025 tej samej nocy od tego momentu dochodziło 14, 17 i 16 domków, średnio 15.7. Prognoza addytywna to 18 + 15.7 = 33.7, multiplikatywna 18 × 1.90 = 34.3, historyczna 33.0. Faktycznie zajętych było 33 domki.
Jak może zmylić. Tu wszystkie trzy metody trafiły, bo sezon 2026 przypominał poprzednie. Pick-up zakłada, że przyszły przyrost będzie taki jak dawniej – nowa promocja albo zmiana ceny to założenie łamie (rysunek 3). Mnożnik bywa niestabilny: gdy na stanie jest 2–3 domki, mały błąd stanu mnoży się kilkukrotnie.
Krzywą rezerwacji jako całość, a nie tylko stan w jednym dniu, do prognozy w hotelu wykorzystali Tse i Poon (2015); Schwartz i Hiemstra (1997) wybierali z przeszłości krzywe o podobnym kształcie i dostali trafniejsze prognozy niż modele porównawcze w horyzontach od 1 do 99 dni.
Rysunek 3: cztery prognozy na 30 dni przed nocą
Ten sam rachunek robimy dla każdej z 63 nocy sezonu 2026. Czwarta metoda – połączona – to zwykła średnia prognozy historycznej i addytywnego pick-upu. Każdą prognozę obcinamy do 40 domków.
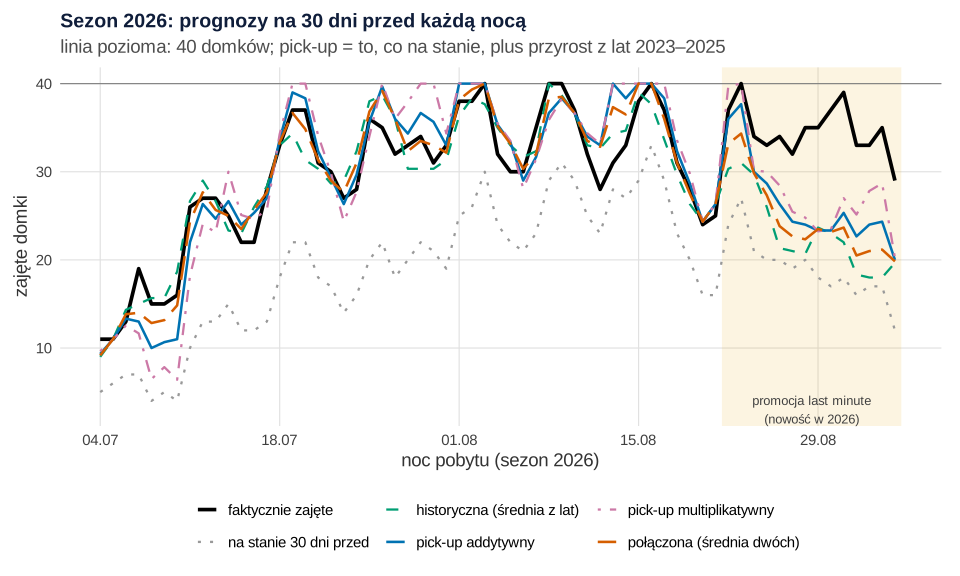
Co widać. 30 dni przed nocą na stanie było średnio 18.9 domku, a ostatecznie zajętych 30.6. Średni błąd bezwzględny (MAE, zob. miary błędu prognozy) wyniósł: historyczna 4.10 domku, pick-up addytywny 3.62, multiplikatywny 4.16, połączona 3.47. Wszystkie metody zaniżały (średni błąd od −1.00 do −2.49 domku).
Jak może zmylić. Ten wynik niesie 14 nocy z promocją: tam MAE wynosiło od 6.95 (multiplikatywny) do 11.67 (historyczna), a w nocach 1–49 – od 1.61 (połączona) do 3.37 (multiplikatywny). Historia nie zna promocji, więc żadna metoda jej nie przewidzi. Gdy zmieniasz cenę w trakcie sezonu, oceniaj prognozę osobno dla nocy objętych zmianą i dopisz efekt zmiany ręcznie albo modelem z ceną (zob. cena biletu a czas do spektaklu).
Zdanie do Wyników:
Rysunek 4: błąd prognozy a liczba dni do nocy
Prognozę robi się nie raz, lecz codziennie. Liczymy więc MAE osobno dla każdego horyzontu, od 150 dni do 1 dnia przed nocą.
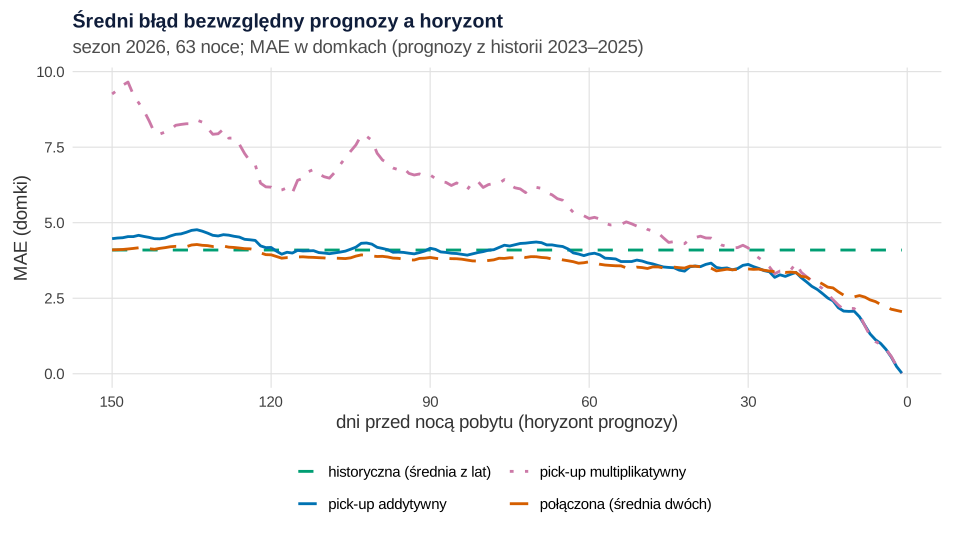
Co widać. W ostatnich 14 dniach pick-up (średnie MAE 1.38 addytywny, 1.40 multiplikatywny) wyraźnie wygrywa ze średnią z lat (4.10): większość gości już jest na stanie. Od 64 dni wzwyż addytywny pick-up ma większy błąd niż średnia z lat, bo rezerwacji na stanie jest mało, a ich losowe wahania przenoszą się na prognozę. Multiplikatywny przy 91–150 dniach ma średnio MAE 7.46. Połączona prognoza była najlepsza w 90 ze 150 horyzontów. To ten sam wniosek co w badaniu małych hoteli: kombinacja prognozy historycznej (długi horyzont) i opartej na rezerwacjach na stanie (krótki horyzont) poprawia trafność (Fiori i Foroni, 2019).
Jak może zmylić. Jeden sezon testowy to 63 noce z jednego roku; krzywe MAE mają swoje wahania. Zamiast stałej średniej możesz ważyć metody według horyzontu – wagi ustal na sezonach uczących, nie testowych.
Podpis do pracy:
Rysunek 5: czas do anulowania – Kaplan–Meier i model Coxa
Część rezerwacji na stanie zniknie. Pytanie „czy rezerwacja zostanie odwołana” ma ukryty czas: rezerwacja zrobiona 150 dni wcześniej ma 150 dni na odwołanie, a zrobiona tydzień wcześniej – tydzień. Liczymy więc czas od rezerwacji do odwołania. Przyjazd kończy obserwację: gość przyjechał, odwołania nie było – to obserwacja cenzurowana. Krzywa Kaplana–Meiera (Kaplan i Meier, 1958) uwzględnia, że każda rezerwacja jest obserwowana inaczej długo, a model Coxa (Cox, 1972) – wpływ zmiennych na dzienne ryzyko odwołania.
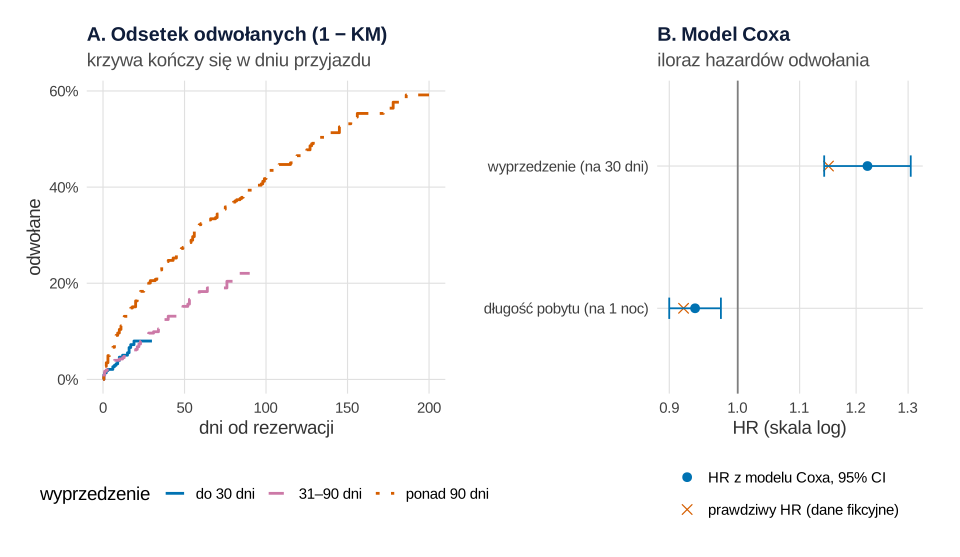
Co widać. Z 1192 rezerwacji z lat 2023–2025 odwołano 285. Naiwne odsetki odwołanych według wyprzedzenia to 5.3% (do 30 dni), 16.7% (31–90) i 50.2% (ponad 90). Część tej różnicy to sam czas: porównanie w tym samym momencie – 30 dni po rezerwacji – daje 8.0% [4.5, 11.3], 9.6% [6.5, 12.7] i 20.5% [16.5, 24.4]. Model Coxa: każde 30 dni wyprzedzenia mnoży dzienne ryzyko odwołania przez HR = 1.22, 95% CI [1.14, 1.31], p < .001; każda noc pobytu – przez 0.94 [0.90, 0.97], p = .001. Prawdziwe wartości (1.15 i 0.92) leżą w przedziałach. Podobnie w danych dziewięciu hoteli wczesne rezerwacje były odwoływane częściej, a wyprzedzenie należało do najważniejszych czynników (Falk i Vieru, 2018).
Jak może zmylić. Grupy różnią się długością obserwacji: krzywa „do 30 dni” kończy się po miesiącu, bo goście już przyjechali – nie przedłużaj jej w myślach. Sprawdź proporcjonalność hazardów (reszty Schoenfelda; tu globalnie p = .83). W prawdziwych danych odwołania skupiają się przed końcem darmowego odwołania – wtedy jeden HR nie wystarczy. Całą procedurę opisuje wpis Kaplan–Meier i model Coxa krok po kroku, a cenzurowanie przez obsługę zamiast przyjazdu – wpis o rezygnacji z czekania na infolinii.
Zdanie do Wyników:
Rysunek 6: ile rezerwacji na stanie się jeszcze odwoła
Model Coxa daje prognozę netto: dla każdej rezerwacji na stanie liczymy prawdopodobieństwo odwołania przed przyjazdem, pod warunkiem że do dziś jej nie odwołano – S(do przyjazdu) / S(dziś) z krzywej przeżycia tej rezerwacji. Suma tych prawdopodobieństw to oczekiwana liczba odwołań. Porównujemy to z rachunkiem naiwnym: „23.9% rezerwacji się odwołuje, więc odejmij 23.9% stanu”.
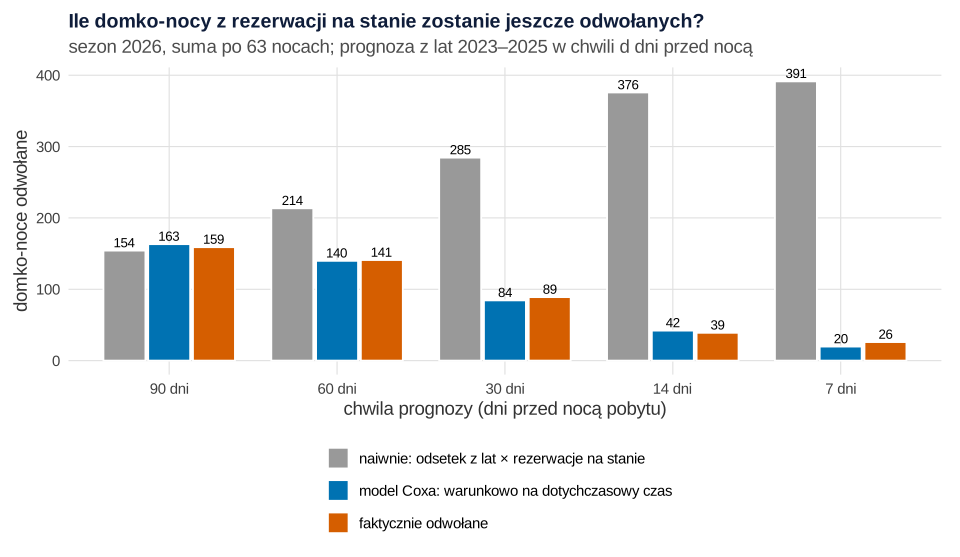
Co widać. 30 dni przed nocą na stanie było łącznie 1190 domko-nocy. Rachunek naiwny zapowiadał 285 odwołanych, model Coxa 84, a faktycznie odwołano 89. Na jedną noc: 4.52 według rachunku naiwnego, 1.34 według Coxa, faktycznie 1.41 (MAE na noc 3.10 wobec 0.88). Im bliżej nocy, tym większy błąd naiwny – rezerwacja, która „przeżyła” do tygodnia przed przyjazdem, rzadko już się odwołuje. Tylko przy 90 dniach obie metody są blisko (154 i 163 wobec 159).
Jak może zmylić. Model uczony na sezonach z inną polityką odwołań (np. bez opłaty) przeszacuje odwołania po jej wprowadzeniu. Addytywny pick-up liczony na stanie netto już zawiera przeciętne odwołania; model Coxa przydaje się, gdy mieszanka rezerwacji jest inna niż zwykle (np. więcej bardzo wczesnych) i gdy chcesz wiedzieć, ile domków realnie zwolni się do ponownej sprzedaży – to wejście do decyzji o overbookingu.
Co z tym zrobić w firmie
- Zapisuj stan rezerwacji codziennie (albo przechowuj datę rezerwacji i odwołania) – bez tego nie odtworzysz krzywej ani pick-upu.
- Dobierz metodę do horyzontu. Na ostatnie 2–3 tygodnie – pick-up addytywny; na kilka miesięcy – średnia z lat albo połączenie. Mnożnika nie używaj, gdy na stanie jest mało rezerwacji.
- Oceniaj prognozę według horyzontu (MAE na 7, 30, 90 dni) na sezonie, którego model nie widział.
- Odwołania licz warunkowo. Odejmuj oczekiwane odwołania z modelu czasu do anulowania, a nie stały odsetek – w przykładzie 30 dni przed nocą to 84 zamiast 285 domko-nocy.
- Notuj zmiany cen i promocje i oceniaj prognozy osobno dla nocy nimi objętych.
- Zapisuj zapytania odrzucone z braku wolnego domku – to jedyna droga do prawdziwego popytu w pełne noce.
Rozszerzenie addytywnego pick-upu o średnie ruchome działało w małym hotelu lepiej niż wersja klasyczna, szczególnie przy dłuższych horyzontach i gdy obiekt nie był pełny (Heo i in., 2023). Inne wpisy z serii: nieodwołane wizyty (no-show) i statystyka w pracy z turystyki i rekreacji.
Jak opisać w pracy
Opisz, co jest jednostką (noc pobytu), jak liczysz stan rezerwacji, jakie metody porównujesz, na jakim okresie uczysz i testujesz oraz jak definiujesz czas do odwołania i cenzurowanie.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, rezerwacje rez i tablicę stanów otb, przepis 3 – prognozy prog używane w przepisie 4, a przepis 5 – model cox używany w przepisie 6. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1 i zaczyna od set.seed(753); przepisy 2–7 nie losują. Ziarno ustalono raz i go nie zmieniano. Ręcznie ustalono: 40 domków, sezon 63 nocy od soboty najbliższej 1 lipca, kształt popytu w sezonie i w tygodniu, wzrost popytu z roku na rok (1.00, 1.03, 1.06, 1.12), rozkład długości pobytu, udział i rozkłady wyprzedzenia (55% planujących, średnio 110 dni, najwyżej 200; pozostali średnio 18 dni), promocję 2026 (pół raza więcej późnych zapytań na noce 50–63), hazard odwołania (Weibull o kształcie 0.8, HR 1.15 na 30 dni wyprzedzenia i 0.92 na noc pobytu), horyzonty 1–150 dni, noc na rysunku 2 i chwile prognozy na rysunku 6. Po pierwszym uruchomieniu zmieniono (ziarno bez zmian): (1) natężenie zapytań baza z 3.6 na 8 – w pierwszej wersji obłożenie wynosiło 27–36% i żadna noc nie była pełna, więc nie było czego prognozować ani pokazać ograniczenia pojemności; (2) skalę czasu do odwołania z 260 na 700 dni – pierwsza wersja dawała 33.3% odwołań, więcej niż chcieliśmy pokazać; (3) na rysunku 1 przesunięto etykietę „40 domków”, która wychodziła poza wykres; (4) na rysunku 5 zamieniono kolor żółty na różowy (żółty i pomarańczowy są przy deuteranopii za bliskie) i usunięto pasma ufności Kaplana–Meiera, które zasłaniały krzywe – przedziały podajemy w tekście. Każdy przepis liczy się w około sekundę.
1. Dane, rezerwacje na stanie i krzywe rezerwacji: Rysunek 1
R
# Rysunek 1. Fikcyjny kemping z 40 domkami: 4 sezony letnie rezerwacji i krzywe rezerwacji
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie: 40 domków, sezon = 63 noce od soboty najbliższej 1 lipca, sezony 2023–2026
set.seed(753)
K <- 40; N <- 63; lata <- 2023:2026
start <- sapply(lata, function(r) {                       # sobota najbliższa 1 lipca
  dni <- as.Date(sprintf("%d-07-01", r)) + (-3:3)
  as.numeric(dni[format(dni, "%u") == "6"]) })
start <- as.Date(start, origin = "1970-01-01")
dzien_tyg <- (0:(N - 1)) %% 7                               # 0 = sobota (przyjazdy najczęściej w soboty)
mn_tyg <- c(2.6, 0.9, 0.6, 0.6, 0.7, 0.9, 1.3)[dzien_tyg + 1]
fala <- 0.45 + 0.55 * exp(-((1:N - 30) / 17)^2)            # szczyt sezonu na przełomie lipca i sierpnia
trend <- c(1.00, 1.03, 1.06, 1.12)                          # popyt rośnie z roku na rok
noce_w <- c(`2` = .10, `3` = .14, `4` = .16, `5` = .14, `7` = .30, `10` = .08, `14` = .08)
baza <- 8                                                 # zapytania o przyjazd w przeciętny dzień

zapytania <- do.call(rbind, lapply(seq_along(lata), function(y) {
  lam <- baza * trend[y] * fala * mn_tyg
  n <- rpois(N, lam)
  a <- rep(1:N, n)
  planujacy <- runif(length(a)) < 0.55                     # 55% rezerwuje z dużym wyprzedzeniem
  L <- ifelse(planujacy, pmin(rgamma(length(a), shape = 3, rate = 3 / 110), 200), 1 + rexp(length(a), 1 / 17))
  z <- data.frame(sezon = lata[y], przyjazd = a, wyprz = L, promocja = FALSE)
  if (lata[y] == 2026) {                                   # 2026: −20% na pobyty od nocy 50, rezerwacje ≤ 21 dni
    a2 <- rep(50:N, rpois(N - 49, 0.5 * 0.45 * lam[50:N]))
    L2 <- 1 + 20 * runif(length(a2))
    z <- rbind(z, data.frame(sezon = 2026, przyjazd = a2, wyprz = L2, promocja = TRUE))
  }
  z$noce <- pmin(as.integer(sample(names(noce_w), nrow(z), TRUE, noce_w)), N - z$przyjazd + 1)
  z }))

# Odwołania: hazard Weibulla (kształt 0.8) od chwili rezerwacji, HR 1.15 na 30 dni wyprzedzenia,
# HR 0.92 na każdą noc pobytu; odwołanie liczy się tylko przed przyjazdem (potem obserwacja cenzurowana)
lp <- log(1.15) * zapytania$wyprz / 30 + log(0.92) * (zapytania$noce - 6)
T_odw <- 700 * (-log(runif(nrow(zapytania))) / exp(lp))^(1 / 0.8)
zapytania$t_odw <- ifelse(T_odw < zapytania$wyprz, T_odw, NA)

# Przyjmowanie rezerwacji w kolejności zgłoszeń: tylko gdy na wszystkie noce jest wolny domek
zapytania$b <- zapytania$przyjazd - zapytania$wyprz        # chwila rezerwacji (dzień sezonu, ułamkowo)
zapytania$przyjeta <- FALSE
for (r in lata) {
  i_s <- which(zapytania$sezon == r); i_s <- i_s[order(zapytania$b[i_s])]
  zaj <- rep(0, N); aktywne <- integer(0)
  for (i in i_s) {
    b <- zapytania$b[i]
    odw <- aktywne[!is.na(zapytania$t_odw[aktywne]) & zapytania$b[aktywne] + zapytania$t_odw[aktywne] <= b]
    for (j in odw) { nn <- zapytania$przyjazd[j] + 0:(zapytania$noce[j] - 1); zaj[nn] <- zaj[nn] - 1 }
    aktywne <- setdiff(aktywne, odw)
    nn <- zapytania$przyjazd[i] + 0:(zapytania$noce[i] - 1)
    if (all(zaj[nn] < K)) { zaj[nn] <- zaj[nn] + 1; zapytania$przyjeta[i] <- TRUE; aktywne <- c(aktywne, i) }
  }
}
rez <- zapytania[zapytania$przyjeta, ]
rez$odwolana <- as.integer(!is.na(rez$t_odw))
rez$data_przyjazdu <- start[match(rez$sezon, lata)] + rez$przyjazd - 1
rez$data_rezerwacji <- rez$data_przyjazdu - ceiling(rez$wyprz)
rez$data_odwolania <- ifelse(rez$odwolana == 1, format(rez$data_przyjazdu - ceiling(rez$wyprz - rez$t_odw)), "")
rez$wyprzedzenie <- as.integer(rez$data_przyjazdu - rez$data_rezerwacji)
rez$dni_do_odwolania <- ifelse(rez$odwolana == 1, as.integer(as.Date(rez$data_odwolania) - rez$data_rezerwacji), NA)
rez$id <- seq_len(nrow(rez))
write.csv(rez[c("id", "sezon", "data_rezerwacji", "data_przyjazdu", "noce", "wyprzedzenie", "odwolana",
                "data_odwolania", "dni_do_odwolania")], "krzywa-rezerwacji-kemping.csv", row.names = FALSE)

# Rezerwacje na stanie (on the books, OTB) d dni przed nocą s: zrobione do chwili s − d i jeszcze nieodwołane
H <- 0:180
otb <- array(0, c(length(lata), N, length(H)), dimnames = list(lata, 1:N, H))
for (y in seq_along(lata)) {
  rr <- rez[rez$sezon == lata[y], ]
  for (s in 1:N) {
    k <- rr[rr$przyjazd <= s & rr$przyjazd + rr$noce - 1 >= s, ]
    t <- s - H                                              # chwila „d dni przed nocą s”
    otb[y, s, ] <- sapply(t, function(tt) sum(k$b <= tt & (is.na(k$t_odw) | k$b + k$t_odw > tt)))
  }
}
final <- otb[, , "0"]                                       # domki zajęte w danej nocy (po odwołaniach)

cat("Zapytania:", nrow(zapytania), "| przyjęte rezerwacje:", nrow(rez), "| odrzucone (brak domku):",
    sum(!zapytania$przyjeta), "\n")
print(data.frame(sezon = lata, start = format(start), rezerwacje = as.vector(table(rez$sezon)),
                 odwolane_proc = round(100 * tapply(rez$odwolana, rez$sezon, mean), 1),
                 oblozenie_proc = round(100 * rowMeans(final) / K, 1),
                 noce_pelne = rowSums(final == K),
                 odrzucone = as.vector(tapply(!zapytania$przyjeta, zapytania$sezon, sum))))
cat("Mediana wyprzedzenia (dni):", median(rez$wyprzedzenie), "| średnia długość pobytu:", round(mean(rez$noce), 2),
    "| odwołane ogółem:", round(100 * mean(rez$odwolana), 1), "%\n")
cat("Odsetek końcowego obłożenia na stanie 30 i 90 dni przed nocą (sezony 2023–2025):",
    round(100 * sum(otb[1:3, , "30"]) / sum(final[1:3, ]), 1), "% i",
    round(100 * sum(otb[1:3, , "90"]) / sum(final[1:3, ]), 1), "%\n")

# Krzywe rezerwacji: średnio w sezonie i w nocach szczytu (noce 22–42) vs poza szczytem
krz <- do.call(rbind, lapply(seq_along(lata), function(y) rbind(
  data.frame(sezon = factor(lata[y]), d = H, otb = colMeans(otb[y, , ]), panel = "A. Wszystkie noce sezonu"),
  data.frame(sezon = factor(lata[y]), d = H, otb = colMeans(otb[y, 22:42, ]), panel = "B. Noce szczytu (22–42)"))))
p1 <- ggplot(krz, aes(d, otb, colour = sezon, linetype = sezon)) +
  geom_hline(yintercept = K, colour = "grey50", linewidth = 0.4) +
  annotate("text", x = 178, y = K - 1.5, label = "40 domków", hjust = 0, size = 3.6, colour = "grey35") +
  geom_line(linewidth = 0.95) +
  facet_wrap(~panel, ncol = 2) +
  scale_x_reverse(breaks = seq(180, 0, -30)) +
  scale_colour_manual(values = unname(kol[c("szary", "blekit", "niebieski", "pomaranczowy")]), name = "sezon") +
  scale_linetype_manual(values = c(3, 2, 4, 1), name = "sezon") +
  labs(title = "Krzywa rezerwacji: ile domków jest zarezerwowanych d dni przed nocą",
       subtitle = "średnia liczba zajętych domków na stanie (po odwołaniach), oś od 180 dni do nocy pobytu",
       x = "dni przed nocą pobytu", y = "domki na stanie") + motyw
p1                       # do pliku: ggsave("krzywa-rezerwacji-krzywe-sezonow.svg", p1, width = 10, height = 5.6)
Wynik w R
Zapytania: 1719 | przyjęte rezerwacje: 1621 | odrzucone (brak domku): 98
     sezon      start rezerwacje odwolane_proc oblozenie_proc noce_pelne
2023  2023 2023-07-01        371          24.5           64.8          6
2024  2024 2024-06-29        404          23.8           71.0          4
2025  2025 2025-06-28        417          23.5           75.0          3
2026  2026 2026-07-04        429          20.3           76.5          5
     odrzucone
2023        14
2024        17
2025        21
2026        46
Mediana wyprzedzenia (dni): 53 | średnia długość pobytu: 5.66 | odwołane ogółem: 22.9 %
Odsetek końcowego obłożenia na stanie 30 i 90 dni przed nocą (sezony 2023–2025): 62.6 % i 35.1 %
2. Schemat pick-up na jednej nocy: Rysunek 2
R
# Rysunek 2. Schemat metody pick-up na jednej nocy: sobota 18 lipca 2026, prognoza na 30 dni przed
# (korzysta z kol, motyw, otb, final, K i start z przepisu 1; bez losowania)
library(ggplot2)

s <- 15; d0 <- 30; dd <- as.character(d0)                    # noc nr 15 sezonu 2026 (sobota)
cat("Noc:", format(start[4] + s - 1, "%d.%m.%Y"), "\n")
przyrost <- final[1:3, s] - otb[1:3, s, dd]
cat("Lata 2023–2025 – na stanie", d0, "dni przed:", otb[1:3, s, dd], "| zajęte w nocy:", final[1:3, s],
    "| przyrost:", przyrost, "\n")
na_stanie <- otb[4, s, dd]; pu <- mean(przyrost); mn <- sum(final[1:3, s]) / sum(otb[1:3, s, dd])
cat("2026: na stanie", na_stanie, "| średni przyrost", round(pu, 2), "| prognoza addytywna",
    round(min(na_stanie + pu, K), 1), "| mnożnik", round(mn, 3), "| prognoza multiplikatywna",
    round(min(na_stanie * mn, K), 1), "| średnia z lat", round(mean(final[1:3, s]), 1),
    "| faktycznie", final[4, s], "\n")

H <- as.numeric(dimnames(otb)[[3]])
krz <- rbind(data.frame(d = H, otb = as.vector(t(otb[1:3, s, ])), sezon = rep(2023:2025, each = length(H)), typ = "hist"),
             data.frame(d = H, otb = otb[4, s, ], sezon = 2026, typ = ifelse(H >= d0, "2026 do dziś", "2026 później")))
krz$grp <- paste(krz$sezon, krz$typ)
p2 <- ggplot(krz, aes(d, otb, group = grp)) +
  annotate("rect", xmin = -2, xmax = d0, ymin = -Inf, ymax = Inf, fill = "#f4f2ee") +
  annotate("text", x = d0 / 2, y = 3, label = "przyszłość\n(jeszcze nie znamy)", size = 3.4, colour = "grey35") +
  geom_hline(yintercept = K, colour = "grey50", linewidth = 0.4) +
  geom_step(data = krz[krz$typ == "hist", ], colour = kol[["szary"]], linewidth = 0.7, direction = "vh") +
  geom_step(data = krz[krz$typ == "2026 później", ], colour = kol[["granat"]], linewidth = 0.6, linetype = 3,
            direction = "vh") +
  geom_step(data = krz[krz$typ == "2026 do dziś", ], colour = kol[["granat"]], linewidth = 1.2, direction = "vh") +
  geom_vline(xintercept = d0, colour = kol[["granat"]], linetype = 2) +
  annotate("point", x = d0, y = na_stanie, size = 3.4, colour = kol[["granat"]]) +
  annotate("segment", x = d0 - 2, xend = 1, y = na_stanie, yend = na_stanie, colour = kol[["niebieski"]], linetype = 2) +
  annotate("segment", x = 1, xend = 1, y = na_stanie, yend = min(na_stanie + pu, K), colour = kol[["niebieski"]],
           linewidth = 1.3, arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("point", x = 0, y = min(na_stanie + pu, K), shape = 23, size = 3.6, fill = kol[["niebieski"]], colour = "white") +
  annotate("label", x = 15, y = na_stanie + pu / 2,
           label = sprintf("pick-up: +%.1f\n(średni przyrost\nz 3 lat)", pu), size = 3.4, colour = kol[["niebieski"]],
           fill = "white", linewidth = 0) +
  annotate("label", x = 120, y = 30, hjust = 0, size = 3.5, lineheight = 0.95, fill = "white", linewidth = 0.3,
           label = sprintf(paste0("Dziś (%d dni przed): na stanie %d domków\n",
                                  "addytywnie: %d + %.1f = %.1f\n",
                                  "multiplikatywnie: %d × %.2f = %.1f\n",
                                  "średnia z lat (bez stanu): %.1f\n",
                                  "faktycznie zajęte: %d"),
                           d0, na_stanie, na_stanie, pu, min(na_stanie + pu, K), na_stanie, mn,
                           min(na_stanie * mn, K), mean(final[1:3, s]), final[4, s])) +
  annotate("text", x = 172, y = 10.5, label = "szare: ta sama noc\nw latach 2023–2025", hjust = 0, size = 3.4,
           colour = "grey35") +
  scale_x_reverse(breaks = seq(180, 0, -30), limits = c(180, -2)) +
  labs(title = "Pick-up: to, co już jest na stanie, plus to, co zwykle dojdzie",
       subtitle = sprintf("noc %s (sobota), krzywa rezerwacji sezonu 2026 do dziś i trzech poprzednich sezonów",
                          format(start[4] + s - 1, "%d.%m.%Y")),
       x = "dni przed nocą pobytu", y = "domki na stanie") + motyw
p2                       # do pliku: ggsave("krzywa-rezerwacji-schemat-pick-up.svg", p2, width = 10, height = 5.8)
Wynik w R
Noc: 18.07.2026
Lata 2023–2025 – na stanie 30 dni przed: 11 18 23 | zajęte w nocy: 25 35 39 | przyrost: 14 17 16
2026: na stanie 18 | średni przyrost 15.67 | prognoza addytywna 33.7 | mnożnik 1.904 | prognoza multiplikatywna 34.3 | średnia z lat 33 | faktycznie 33
3. Cztery prognozy dla sezonu 2026: Rysunek 3
R
# Rysunek 3. Prognoza obłożenia każdej nocy sezonu 2026 na 30 dni przed nocą: cztery metody
# (korzysta z kol, motyw, otb, final, K, N, lata i start z przepisu 1; bez losowania)
library(ggplot2)

hist_lata <- 1:3; test <- 4                                 # uczymy na 2023–2025, sprawdzamy na 2026
prognoza <- function(d) {
  dd <- as.character(d)
  na_stanie <- otb[test, , dd]
  historyczna <- colMeans(final[hist_lata, ])                                 # średnia z lat dla tej nocy
  pu_add <- colMeans(final[hist_lata, ] - otb[hist_lata, , dd])              # średni przyrost od d do nocy
  wsp <- colSums(final[hist_lata, ]) / pmax(colSums(otb[hist_lata, , dd]), 1)  # średni mnożnik
  ogr <- function(x) pmin(pmax(x, 0), K)                                     # nie więcej niż 40 domków
  data.frame(d = d, noc = 1:N, na_stanie = na_stanie, faktyczne = final[test, ],
             historyczna = ogr(historyczna), pickup_add = ogr(na_stanie + pu_add),
             pickup_mult = ogr(na_stanie * wsp), polaczona = ogr((historyczna + na_stanie + pu_add) / 2))
}
prog <- do.call(rbind, lapply(1:150, prognoza))
metody <- c(historyczna = "historyczna (średnia z lat)", pickup_add = "pick-up addytywny",
            pickup_mult = "pick-up multiplikatywny", polaczona = "połączona (średnia dwóch)")

p30 <- prog[prog$d == 30, ]
cat("Sezon 2026, 30 dni przed nocą: na stanie średnio", round(mean(p30$na_stanie), 1),
    "domków, faktycznie zajętych", round(mean(p30$faktyczne), 1), "\n")
print(round(sapply(names(metody), function(m) c(MAE = mean(abs(p30[[m]] - p30$faktyczne)),
                                               blad_sredni = mean(p30[[m]] - p30$faktyczne))), 2))
promo <- p30$noc >= 50
cat("MAE na 30 dni w nocach 50–63 (promocja 2026) i w nocach 1–49:\n")
print(round(sapply(names(metody), function(m) c(noce_50_63 = mean(abs(p30[[m]] - p30$faktyczne)[promo]),
                                               noce_1_49 = mean(abs(p30[[m]] - p30$faktyczne)[!promo]))), 2))

dl <- rbind(data.frame(noc = p30$noc, domki = p30$faktyczne, metoda = "faktycznie zajęte"),
            data.frame(noc = p30$noc, domki = p30$na_stanie, metoda = "na stanie 30 dni przed"),
            do.call(rbind, lapply(names(metody), function(m) data.frame(noc = p30$noc, domki = p30[[m]], metoda = metody[[m]]))))
dl$metoda <- factor(dl$metoda, c("faktycznie zajęte", "na stanie 30 dni przed", metody))
daty <- start[test] + c(0, 14, 28, 42, 56)
p3 <- ggplot(dl, aes(noc, domki, colour = metoda, linetype = metoda, linewidth = metoda)) +
  annotate("rect", xmin = 49.5, xmax = 63.5, ymin = -Inf, ymax = Inf, fill = kol[["zolty"]], alpha = 0.12) +
  annotate("text", x = 56.5, y = 3, label = "promocja last minute\n(nowość w 2026)", size = 3.4, colour = "grey25") +
  geom_hline(yintercept = K, colour = "grey50", linewidth = 0.4) +
  geom_line() +
  scale_colour_manual(values = c("black", kol[["szary"]], kol[["zielony"]], kol[["niebieski"]], kol[["rozowy"]],
                                 kol[["pomaranczowy"]]), name = NULL) +
  scale_linetype_manual(values = c(1, 3, 2, 1, 4, 5), name = NULL) +
  scale_linewidth_manual(values = c(1.3, 0.8, 0.8, 0.9, 0.8, 0.9), name = NULL) +
  scale_x_continuous(breaks = c(1, 15, 29, 43, 57), labels = format(daty, "%d.%m")) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2), linewidth = guide_legend(nrow = 2)) +
  labs(title = "Sezon 2026: prognozy na 30 dni przed każdą nocą",
       subtitle = "linia pozioma: 40 domków; pick-up = to, co na stanie, plus przyrost z lat 2023–2025",
       x = "noc pobytu (sezon 2026)", y = "zajęte domki") + motyw
p3                       # do pliku: ggsave("krzywa-rezerwacji-prognozy-2026.svg", p3, width = 10, height = 6)
Wynik w R
Sezon 2026, 30 dni przed nocą: na stanie średnio 18.9 domków, faktycznie zajętych 30.6
            historyczna pickup_add pickup_mult polaczona
MAE                4.10       3.62        4.16      3.47
blad_sredni       -2.49      -1.38       -1.00     -1.88
MAE na 30 dni w nocach 50–63 (promocja 2026) i w nocach 1–49:
           historyczna pickup_add pickup_mult polaczona
noce_50_63       11.67       8.29        6.95      9.98
noce_1_49         1.93       2.29        3.37      1.61
4. MAE według horyzontu: Rysunek 4
R
# Rysunek 4. Błąd prognozy (MAE) według liczby dni do nocy pobytu – sezon 2026
# (korzysta z kol, motyw, prog i metody z przepisu 3; bez losowania)
library(ggplot2)

mae <- do.call(rbind, lapply(names(metody), function(m)
  data.frame(metoda = metody[[m]], d = sort(unique(prog$d)),
             MAE = tapply(abs(prog[[m]] - prog$faktyczne), prog$d, mean))))
mae$metoda <- factor(mae$metoda, metody)
tab <- reshape(mae, idvar = "d", timevar = "metoda", direction = "wide")
names(tab) <- c("d", names(metody))
print(round(tab[tab$d %in% c(1, 7, 14, 30, 60, 90, 120, 150), ], 2), row.names = FALSE)
cat("Średnie MAE w przedziałach horyzontu:\n")
print(round(sapply(split(tab[-1], cut(tab$d, c(0, 14, 45, 90, 150))), colMeans), 2))
naj <- names(metody)[apply(tab[-1], 1, which.min)]
cat("Najmniejsze MAE – liczba horyzontów 1–150, na których metoda wygrywa:\n"); print(table(factor(naj, names(metody))))
prz <- tab$d[which(tab$pickup_add > tab$historyczna)[1]]
cat("Pierwszy horyzont, od którego pick-up addytywny ma większe MAE niż średnia z lat:", prz, "dni\n")

p4 <- ggplot(mae, aes(d, MAE, colour = metoda, linetype = metoda)) +
  geom_line(linewidth = 1) +
  scale_x_reverse(breaks = seq(150, 0, -30)) +
  scale_colour_manual(values = unname(kol[c("zielony", "niebieski", "rozowy", "pomaranczowy")]), name = NULL) +
  scale_linetype_manual(values = c(2, 1, 4, 5), name = NULL) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "Średni błąd bezwzględny prognozy a horyzont",
       subtitle = "sezon 2026, 63 noce; MAE w domkach (prognozy z historii 2023–2025)",
       x = "dni przed nocą pobytu (horyzont prognozy)", y = "MAE (domki)") + motyw
p4                       # do pliku: ggsave("krzywa-rezerwacji-mae-horyzont.svg", p4, width = 10, height = 5.6)
Wynik w R
   d historyczna pickup_add pickup_mult polaczona
   1         4.1       0.02        0.02      2.06
   7         4.1       1.32        1.25      2.44
  14         4.1       2.41        2.45      2.84
  30         4.1       3.62        4.16      3.47
  60         4.1       3.96        5.14      3.71
  90         4.1       4.15        6.58      3.85
 120         4.1       4.18        6.18      3.94
 150         4.1       4.47        9.26      4.10
Średnie MAE w przedziałach horyzontu:
            (0,14] (14,45] (45,90] (90,150]
historyczna   4.10    4.10    4.10     4.10
pickup_add    1.38    3.34    4.01     4.31
pickup_mult   1.40    3.86    5.69     7.46
polaczona     2.43    3.38    3.72     4.01
Najmniejsze MAE – liczba horyzontów 1–150, na których metoda wygrywa:

historyczna  pickup_add pickup_mult   polaczona
         28          28           4          90
Pierwszy horyzont, od którego pick-up addytywny ma większe MAE niż średnia z lat: 64 dni
5. Kaplan–Meier i model Coxa czasu do anulowania: Rysunek 5
R
# Rysunek 5. Czas od rezerwacji do anulowania: Kaplan–Meier według wyprzedzenia i model Coxa
# (korzysta z kol, motyw i rez z przepisu 1; bez losowania)
library(ggplot2)
library(patchwork)
library(survival)

# Czas obserwacji: od rezerwacji do odwołania albo do przyjazdu (przyjazd = obserwacja cenzurowana)
rez$czas <- ifelse(rez$odwolana == 1, rez$dni_do_odwolania, rez$wyprzedzenie)
rez$czas <- pmax(rez$czas, 0.5)                             # odwołanie w dniu rezerwacji liczymy jako pół dnia
rez$grupa <- cut(rez$wyprzedzenie, c(0, 30, 90, 200), labels = c("do 30 dni", "31–90 dni", "ponad 90 dni"))
ucz <- rez[rez$sezon <= 2025, ]                             # model uczymy na sezonach 2023–2025
cat("Rezerwacje 2023–2025:", nrow(ucz), "| odwołane:", sum(ucz$odwolana), "\n")
cat("Naiwny odsetek odwołanych według wyprzedzenia (%):\n")
print(round(100 * tapply(ucz$odwolana, ucz$grupa, mean), 1))

km <- survfit(Surv(czas, odwolana) ~ grupa, data = ucz)
print(summary(km, times = c(14, 30, 60, 90))$table[, c("records", "events")])
s <- summary(km, times = c(14, 30, 60, 90), extend = TRUE)
print(data.frame(grupa = sub("grupa=", "", s$strata), dni = s$time, w_ryzyku = s$n.risk,
                 odwolane_proc = round(100 * (1 - s$surv), 1),
                 CI_dolna = round(100 * (1 - s$upper), 1), CI_gorna = round(100 * (1 - s$lower), 1)))

cox <- coxph(Surv(czas, odwolana) ~ I(wyprzedzenie / 30) + noce, data = ucz)
hr <- data.frame(zmienna = c("wyprzedzenie (na 30 dni)", "długość pobytu (na 1 noc)"),
                 HR = exp(coef(cox)), dolna = exp(confint(cox))[, 1], gorna = exp(confint(cox))[, 2],
                 p = summary(cox)$coefficients[, "Pr(>|z|)"], prawda = c(1.15, 0.92))
print(cbind(hr[1], round(hr[-1], 3)), row.names = FALSE)
print(cox.zph(cox))                                         # proporcjonalność hazardów (reszty Schoenfelda)

kmd <- data.frame(t = km$time, F = 1 - km$surv,
                  grupa = rep(sub("grupa=", "", names(km$strata)), km$strata))
kmd <- rbind(data.frame(t = 0, F = 0, grupa = unique(kmd$grupa)), kmd)
kmd$grupa <- factor(kmd$grupa, levels(rez$grupa))
k3 <- unname(kol[c("niebieski", "rozowy", "pomaranczowy")])
pa <- ggplot(kmd, aes(t, F, colour = grupa)) +
  geom_step(aes(linetype = grupa), linewidth = 1) +
  scale_colour_manual(values = k3, name = "wyprzedzenie") +
  scale_linetype_manual(values = c(1, 2, 4), name = "wyprzedzenie") +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%")) +
  coord_cartesian(xlim = c(0, 200)) +
  labs(title = "A. Odsetek odwołanych (1 − KM)", subtitle = "krzywa kończy się w dniu przyjazdu",
       x = "dni od rezerwacji", y = "odwołane") + motyw
pb <- ggplot(hr, aes(HR, zmienna)) +
  geom_vline(xintercept = 1, colour = "grey50") +
  geom_point(aes(x = prawda, shape = "prawdziwy HR (dane fikcyjne)"), size = 3, colour = kol[["pomaranczowy"]]) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(aes(shape = "HR z modelu Coxa, 95% CI"), size = 3, colour = kol[["niebieski"]]) +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  scale_x_log10(breaks = c(0.85, 0.9, 1, 1.1, 1.2, 1.3)) +
  guides(shape = guide_legend(nrow = 2)) +
  labs(title = "B. Model Coxa", subtitle = "iloraz hazardów odwołania", x = "HR (skala log)", y = NULL) + motyw
p5 <- pa + pb + plot_layout(widths = c(1.35, 1))
p5                       # do pliku: ggsave("krzywa-rezerwacji-czas-do-anulowania.svg", p5, width = 10, height = 5.6)
Wynik w R
Rezerwacje 2023–2025: 1192 | odwołane: 285
Naiwny odsetek odwołanych według wyprzedzenia (%):
   do 30 dni    31–90 dni ponad 90 dni
         5.3         16.7         50.2
                   records events
grupa=do 30 dni        435     23
grupa=31–90 dni        353     59
grupa=ponad 90 dni     404    203
          grupa dni w_ryzyku odwolane_proc CI_dolna CI_gorna
1     do 30 dni  14      200           5.0      2.7      7.3
2     do 30 dni  30       11           8.0      4.5     11.3
3     do 30 dni  60        0           8.0      4.5     11.3
4     do 30 dni  90        0           8.0      4.5     11.3
5     31–90 dni  14      335           5.1      2.8      7.4
6     31–90 dni  30      319           9.6      6.5     12.7
7     31–90 dni  60      134          18.3     13.6     22.7
8     31–90 dni  90        4          22.1     15.7     28.0
9  ponad 90 dni  14      351          13.1      9.8     16.3
10 ponad 90 dni  30      321          20.5     16.5     24.4
11 ponad 90 dni  60      274          32.4     27.7     36.8
12 ponad 90 dni  90      245          39.4     34.4     43.9
                   zmienna    HR dolna gorna     p prawda
  wyprzedzenie (na 30 dni) 1.221 1.142 1.305 0.000   1.15
 długość pobytu (na 1 noc) 0.936 0.900 0.974 0.001   0.92
                    chisq df    p
I(wyprzedzenie/30) 0.0141  1 0.91
noce               0.3534  1 0.55
GLOBAL             0.3609  2 0.83
6. Oczekiwane odwołania rezerwacji na stanie: Rysunek 6
R
# Rysunek 6. Ile domko-nocy z rezerwacji na stanie zostanie jeszcze odwołanych? Sezon 2026
# (korzysta z kol, motyw, rez, N, K z przepisu 1 i z modelu cox z przepisu 5; bez losowania)
library(ggplot2)

H0 <- basehaz(cox, centered = FALSE)                        # skumulowany hazard bazowy (dla zmiennych = 0)
S <- function(t, lp) exp(-approx(H0$time, H0$hazard, xout = t, method = "constant", rule = 2, yleft = 0)$y * exp(lp))
udzial <- mean(rez$odwolana[rez$sezon <= 2025])             # odsetek odwołanych rezerwacji w latach 2023–2025
r26 <- rez[rez$sezon == 2026, ]
r26$lp <- coef(cox)[1] * r26$wyprzedzenie / 30 + coef(cox)[2] * r26$noce

wynik <- do.call(rbind, lapply(c(7, 14, 30, 60, 90), function(d) {
  do.call(rbind, lapply(1:N, function(s) {
    t <- s - d                                              # „dziś” = d dni przed nocą s
    k <- r26[r26$przyjazd <= s & r26$przyjazd + r26$noce - 1 >= s & r26$b <= t &
             (is.na(r26$t_odw) | r26$b + r26$t_odw > t), ]
    przed <- k[k$przyjazd > t, ]                            # jeszcze nie przyjechali – mogą odwołać
    u <- t - przed$b                                        # ile dni rezerwacja już „przeżyła”
    p_cox <- 1 - S(przed$wyprz, przed$lp) / S(u, przed$lp)  # P(odwołanie przed przyjazdem | dotąd nieodwołana)
    data.frame(d = d, noc = s, na_stanie = nrow(k), naiwnie = udzial * nrow(przed), cox = sum(p_cox),
               faktycznie = sum(!is.na(przed$t_odw)))
  }))
}))
sumy <- aggregate(cbind(na_stanie, naiwnie, cox, faktycznie) ~ d, wynik, sum)
cat("Odsetek odwołanych rezerwacji 2023–2025:", round(100 * udzial, 1), "%\n")
print(round(sumy, 1), row.names = FALSE)
w30 <- wynik[wynik$d == 30, ]
cat("30 dni przed: średnio na noc na stanie", round(mean(w30$na_stanie), 2), "| odwołań wg Coxa",
    round(mean(w30$cox), 2), "| naiwnie", round(mean(w30$naiwnie), 2), "| faktycznie", round(mean(w30$faktycznie), 2), "\n")
cat("MAE odwołań na noc (30 dni przed): Cox", round(mean(abs(w30$cox - w30$faktycznie)), 2), "| naiwnie",
    round(mean(abs(w30$naiwnie - w30$faktycznie)), 2), "\n")

dl <- rbind(data.frame(d = sumy$d, n = sumy$naiwnie, typ = "naiwnie: odsetek z lat × rezerwacje na stanie"),
            data.frame(d = sumy$d, n = sumy$cox, typ = "model Coxa: warunkowo na dotychczasowy czas"),
            data.frame(d = sumy$d, n = sumy$faktycznie, typ = "faktycznie odwołane"))
dl$typ <- factor(dl$typ, unique(dl$typ)); dl$dlab <- factor(paste(dl$d, "dni"), paste(c(90, 60, 30, 14, 7), "dni"))
p6 <- ggplot(dl, aes(dlab, n, fill = typ)) +
  geom_col(position = position_dodge(0.8), width = 0.75, colour = "white") +
  geom_text(aes(label = round(n)), position = position_dodge(0.8), vjust = -0.35, size = 3.5) +
  scale_fill_manual(values = unname(kol[c("szary", "niebieski", "pomaranczowy")]), name = NULL) +
  guides(fill = guide_legend(ncol = 1)) +
  labs(title = "Ile domko-nocy z rezerwacji na stanie zostanie jeszcze odwołanych?",
       subtitle = "sezon 2026, suma po 63 nocach; prognoza z lat 2023–2025 w chwili d dni przed nocą",
       x = "chwila prognozy (dni przed nocą pobytu)", y = "domko-noce odwołane") + motyw
p6                       # do pliku: ggsave("krzywa-rezerwacji-odwolania-netto.svg", p6, width = 10, height = 5.8)
Wynik w R
Odsetek odwołanych rezerwacji 2023–2025: 23.9 %
  d na_stanie naiwnie   cox faktycznie
  7      1832   391.4  19.7         26
 14      1572   375.9  42.1         39
 30      1190   284.5  84.4         89
 60       893   213.5 139.8        141
 90       645   154.2 163.2        159
30 dni przed: średnio na noc na stanie 18.89 | odwołań wg Coxa 1.34 | naiwnie 4.52 | faktycznie 1.41
MAE odwołań na noc (30 dni przed): Cox 0.88 | naiwnie 3.1
7. Sprawdzenie palety pod kątem zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace (bez losowania)
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "niebieski – zielony" = c("#0072B2", "#009E73"),
             "niebieski – różowy" = c("#0072B2", "#CC79A7"), "zielony – pomarańczowy" = c("#009E73", "#D55E00"),
             "różowy – pomarańczowy" = c("#CC79A7", "#D55E00"), "niebieski – żółty" = c("#0072B2", "#E69F00"),
             "żółty – pomarańczowy" = c("#E69F00", "#D55E00"), "szary – błękit" = c("#999999", "#56B4E9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
niebieski – zielony                         70.1         55.4       58.0
niebieski – różowy                          53.6         42.0       22.5
zielony – pomarańczowy                     102.4         53.5       37.3
różowy – pomarańczowy                       74.3         70.2       71.9
niebieski – żółty                          120.2        121.5      109.3
żółty – pomarańczowy                        33.4         18.4       24.9
szary – błękit                              37.4         38.3       33.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i prognozy pick-up obliczono funkcjami podstawowej instalacji R, krzywe Kaplana–Meiera, model Coxa i test proporcjonalności hazardów – pakietem survival. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Pełne noce ucinają popyt. W pełną noc obłożenie wynosi 40, choć chętnych było więcej: w przykładzie kemping odrzucił 98 zapytań (46 w 2026 roku), a pełnych nocy było od 3 do 6 w sezonie. Pick-up liczony z takiej historii mierzy sprzedaż, nie popyt – to dane ucięte i cenzurowane, jak we wpisie o popycie ukrytym przez braki towaru.
- Zmiana ceny w trakcie sezonu zmienia kształt krzywej – historia jej nie zna (rysunek 3).
- Odsetek odwołanych bez czasu miesza ryzyko z długością obserwacji (rysunek 5).
- Stały odsetek odwołań zawyża odwołania tuż przed przyjazdem (rysunek 6).
- Losowy podział nocy na uczące i testowe – noce jednego sezonu są powiązane; testuj na całym późniejszym sezonie.
- Inna sezonowość kalendarza – porównuj noce o tym samym dniu tygodnia, nie o tej samej dacie.
Najczęstsze pytania
Na czym polega metoda pick-up w prognozie obłożenia?
Bierzesz liczbę rezerwacji na stanie d dni przed nocą i dodajesz średni przyrost rezerwacji od d dni do tej nocy z poprzednich sezonów (wersja addytywna) albo mnożysz stan przez średni stosunek końcowego obłożenia do stanu (wersja multiplikatywna). W przykładzie kempingu 30 dni przed nocą 18 lipca było 18 domków, a przyrost wynosił średnio 15.7 – prognoza 33.7, faktycznie zajętych 33.
Która metoda prognozy obłożenia jest najlepsza – pick-up czy średnia z lat?
To zależy od horyzontu. W przykładzie w ostatnich 14 dniach pick-up addytywny miał średnie MAE 1.38 domku wobec 4.10 dla średniej z lat, ale od 64 dni wzwyż był gorszy od niej. Średnia prognozy historycznej i pick-upu była najlepsza w 90 ze 150 horyzontów. Oceniaj metody osobno dla każdego horyzontu na sezonie, którego model nie widział.
Czym różni się pick-up addytywny od multiplikatywnego?
Addytywny dodaje przeciętną liczbę rezerwacji, które jeszcze dojdą, a multiplikatywny mnoży stan przez przeciętny mnożnik. Mnożnik jest niestabilny, gdy na stanie jest mało rezerwacji: w przykładzie przy horyzontach 91–150 dni pick-up multiplikatywny miał średnie MAE 7.46 domku, a addytywny 4.31. Tuż przed nocą obie wersje dają podobne wyniki.
Jak prognozować odwołania rezerwacji?
Potraktuj czas od rezerwacji do odwołania jako czas do zdarzenia, a przyjazd jako obserwację cenzurowaną – krzywa Kaplana–Meiera i model Coxa. Dla rezerwacji na stanie licz prawdopodobieństwo odwołania pod warunkiem, że do dziś jej nie odwołano. W przykładzie 30 dni przed nocą daje to 84 odwołane domko-noce (faktycznie 89), a stały odsetek z lat (23.9%) – 285.
Dlaczego wczesne rezerwacje częściej się odwołuje?
Po części dlatego, że mają więcej czasu na odwołanie, a po części – bo dzienne ryzyko jest wyższe. W przykładzie naiwne odsetki odwołań wynosiły 5.3% przy wyprzedzeniu do 30 dni i 50.2% przy ponad 90 dniach; po 30 dniach od rezerwacji było to 8.0% i 20.5%, a model Coxa dał HR = 1.22 na każde 30 dni wyprzedzenia, 95% CI [1.14, 1.31].
Powiązane hasła
Przeczytaj też
Overbooking – ile rezerwacji ponad pojemność
Pensjonat z 24 pokojami: rozkład dwumianowy przyjazdów, koszt odmowy i pustego pokoju, optymalne N, bootstrap i grupy – z kodem R.
Czytaj →PoradnikKaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikPrognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →Piszesz pracę o rezerwacjach albo prognozujesz obłożenie w firmie?
Pomożemy przygotować dane rezerwacji, porównać metody prognozy na właściwym okresie testowym, zbudować model odwołań i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Falk, M., & Vieru, M. (2018). Modelling the cancellation behaviour of hotel guests. International Journal of Contemporary Hospitality Management, 30(10), 3100–3116. https://doi.org/10.1108/ijchm-08-2017-0509 ● Otwarty dostęp: pełny tekst
- Fiori, A. M., & Foroni, I. (2019). Reservation forecasting models for hospitality SMEs with a view to enhance their economic sustainability. Sustainability, 11(5), Article 1274. https://doi.org/10.3390/su11051274 ● Otwarty dostęp
- Heo, C. Y., Viverit, L., & Pereira, L. N. (2023). Does historical data still matter for demand forecasting in uncertain and turbulent times? An extension of the additive pickup time series method for SME hotels. Journal of Revenue and Pricing Management, 23(1), 39–43. https://doi.org/10.1057/s41272-023-00421-1 ● Otwarty dostęp
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Schwartz, Z., & Hiemstra, S. (1997). Improving the accuracy of hotel reservations forecasting: Curves similarity approach. Journal of Travel Research, 36(1), 3–14. https://doi.org/10.1177/004728759703600102
- Tse, T. S. M., & Poon, Y. T. (2015). Analyzing the use of an advance booking curve in forecasting hotel reservations. Journal of Travel & Tourism Marketing, 32(7), 852–869. https://doi.org/10.1080/10548408.2015.1063826
Cytowania BibTeX
@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{falk2018modelling, author={Falk, Martin and Vieru, Markku}, title={{Modelling the cancellation behaviour of hotel guests}}, journal={International Journal of Contemporary Hospitality Management}, year={2018}, volume={30}, number={10}, pages={3100--3116}, doi={10.1108/ijchm-08-2017-0509}}@article{fiori2019reservation, author={Fiori, Anna Maria and Foroni, Ilaria}, title={{Reservation forecasting models for hospitality SMEs with a view to enhance their economic sustainability}}, journal={Sustainability}, year={2019}, volume={11}, number={5}, eid={1274}, doi={10.3390/su11051274}}@article{heo2023does, author={Heo, Cindy Yoonjoung and Viverit, Luciano and Pereira, Lu{\'\i}s Nobre}, title={{Does historical data still matter for demand forecasting in uncertain and turbulent times? An extension of the additive pickup time series method for SME hotels}}, journal={Journal of Revenue and Pricing Management}, year={2023}, volume={23}, number={1}, pages={39--43}, doi={10.1057/s41272-023-00421-1}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{schwartz1997improving, author={Schwartz, Zvi and Hiemstra, Stephen}, title={{Improving the accuracy of hotel reservations forecasting: Curves similarity approach}}, journal={Journal of Travel Research}, year={1997}, volume={36}, number={1}, pages={3--14}, doi={10.1177/004728759703600102}}@article{tse2015analyzing, author={Tse, Tony Sze Ming and Poon, Yiu Tung}, title={{Analyzing the use of an advance booking curve in forecasting hotel reservations}}, journal={Journal of Travel \& Tourism Marketing}, year={2015}, volume={32}, number={7}, pages={852--869}, doi={10.1080/10548408.2015.1063826}}