Sześć typowych projektów w pracy z turystyki i rekreacji
Prace dyplomowe z turystyki i rekreacji to najczęściej badania ankietowe prowadzone wśród turystów, gości obiektów albo uczestników zajęć rekreacyjnych. Pytasz o zadowolenie z pobytu, o to, co jest dla gości ważne, po co przyjechali, ile wydają i czy polecą miejsce znajomym. Rzadziej analizujesz dane obiektu, np. liczbę noclegów w kolejnych miesiącach. Tabela zestawia sześć projektów omówionych w tym poradniku. Każdy ma inny problem analityczny: skala Likerta, pary ocen tych samych osób, analiza skupień, skośne kwoty w złotych, wskaźnik zbudowany z kategorii i dane miesięczne.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Satysfakcja z pobytu | Czy powracający goście są bardziej zadowoleni niż przyjeżdżający pierwszy raz? | skala 6 pozycji 1–5, grupa | rzetelność (α, ω), test Manna–Whitneya | korelacja rangowo-biseryjna |
| 2. Ważność i ocena atrybutów (IPA) | Które elementy oferty są ważne, a słabo ocenione? | ważność i ocena 8 atrybutów od tych samych osób | siatka IPA, test Wilcoxona dla par, korekta Holma | luka (ocena − ważność), rrb dla par |
| 3. Segmentacja według motywów | Jakie grupy turystów wyróżnić ze względu na motywy wyjazdu? | 6 motywów 1–7, typ noclegu | k-średnich, średnia sylwetka, chi-kwadrat | sylwetka, V Craméra |
| 4. Wydatki turystów | Od czego zależą dzienne wydatki na osobę? | zł na osobę dziennie, cechy pobytu | regresja na logarytmie wydatków, błędy HC3 | zmiana procentowa z 95% CI, R² |
| 5. Polecenie i NPS | Czy goście ośrodka A chętniej polecają go niż goście ośrodka B? | gotowość polecenia 0–10 | NPS z bootstrapowym CI, test Manna–Whitneya | różnica NPS z 95% CI, rrb |
| 6. Sezonowość ruchu | Jak silnie ruch w obiekcie koncentruje się w sezonie? | noclegi w kolejnych miesiącach | wskaźniki opisowe | indeks sezonowości, CV, współczynnik Giniego |
Wszystkie dane w przykładach są symulowane. Możesz je pobrać jako plik XLSX (osobny arkusz dla każdego projektu i arkusz z opisem) i powtórzyć analizy w swoim programie. Jeśli Twoja praca jest bliżej ekonomii przedsiębiorstwa turystycznego niż badań wśród gości, zajrzyj też do poradnika statystyka w pracy z zarządzania i ekonomii, gdzie omawiamy ankiety pracowników i modele ekonometryczne.
Zanim zaczniesz: kogo, gdzie i kiedy pytasz
Ankieta „na miejscu” to próba okolicznościowa. Turystów zwykle pyta się na plaży, przy wejściu do parku, w recepcji albo na szlaku. Taka próba nie jest losowa: częściej odpowiadają osoby, które mają czas, mówią po polsku i akurat przebywają w miejscu badania. Odsetki i średnie opisuj więc jako cechę badanej próby, a nie „turystów odwiedzających region”. Co oznacza reprezentatywność próby i dlaczego duża liczba ankiet jej nie zastąpi, wyjaśniamy osobno.
Termin badania zmienia wyniki. W turystyce kto przyjeżdża, zależy od miesiąca. Ankieta zebrana tylko w lipcu opisuje gości wakacyjnych: więcej rodzin z dziećmi, więcej osób na dłuższym pobycie. Jeśli możesz, rozłóż zbieranie danych na kilka terminów albo przynajmniej podaj w pracy daty, dni tygodnia i miejsca badania. Ankieter powinien zaczepiać osoby według prostej reguły (np. co trzecia osoba przechodząca obok punktu), a nie wybierać „sympatycznych” rozmówców.
Ustal jednostkę analizy. Turyści często podróżują w grupach. Jeśli ankietę wypełnia kilka osób z jednej rodziny, ich odpowiedzi są do siebie podobne, a wydatki bywają wspólne. Najprościej przyjąć regułę: jedna ankieta na grupę, wypełniana przez osobę dorosłą, a wydatki przeliczane na osobę. Zapisz w bazie liczbę osób w grupie, bo przyda się w analizie wydatków. Jak przygotować pytania i skale, opisujemy w poradniku jak zrobić ankietę do pracy dyplomowej.
Projekt 1. Satysfakcja z pobytu: skala i porównanie grup
Pytanie: czy turyści, którzy przyjechali do miejscowości kolejny raz, są bardziej zadowoleni z pobytu niż osoby przyjeżdżające pierwszy raz? Zmienne: sześć pozycji satysfakcji ocenianych od 1 do 5 (wypoczynek, atmosfera, obsługa, ceny, atrakcje, czystość), z których liczysz średni wynik skali, oraz grupa: pierwsza albo kolejna wizyta. Plan analiz: rzetelność skali, opis wyniku w grupach, porównanie dwóch grup niezależnych z wielkością efektu.
Zanim zsumujesz pozycje, sprawdź, czy mierzą jedną cechę. W przykładzie (320 turystów) alfa Cronbacha wyniosła α = .82, a omega McDonalda z jednoczynnikowej analizy czynnikowej ω = .82 (ładunki od .55 do .80). Średni wynik skali jest więc uzasadniony. Taki wynik ma jednak tylko kilkanaście możliwych wartości i często jest przesunięty ku górze skali, bo turyści na urlopie rzadko oceniają pobyt źle. Dlatego obok średniej i SD podaj medianę i kwartyle. Kiedy średnia ze skali Likerta ma sens, a kiedy lepsza jest mediana, omawiamy w tekście czy skala Likerta jest ilościowa.
Do porównania dwóch grup przy takim wyniku dobrze pasuje test U Manna–Whitneya. Osoby przyjeżdżające pierwszy raz (n = 168) miały M = 3.93, SD = 0.63, Me = 4.00, a powracające (n = 152) M = 4.13, SD = 0.64, Me = 4.17. Test: U = 10580, p = .008. Wielkością efektu jest korelacja rangowo-biseryjna rrb = −.17, 95% CI [−.29, −.05]. Znak ujemny wynika z kolejności grup w R (pierwsza wizyta jako grupa odniesienia) i oznacza niższe wyniki tej grupy. Efekt jest niewielki. Jak liczyć i opisywać miary efektu dla testów rangowych, pokazujemy w poradniku wielkość efektu dla testów nieparametrycznych.
Pamiętaj, że to badanie przekrojowe. Wyższa satysfakcja powracających nie znaczy, że kolejny przyjazd zwiększa zadowolenie. Bardziej prawdopodobne jest, że wracają ci, którym się podobało, a niezadowoleni po prostu nie przyjeżdżają ponownie i nie trafiają do próby.
Projekt 2. Ważność i ocena atrybutów (IPA)
Pytanie: które elementy oferty miejscowości są dla turystów ważne, a ocenione słabo? Zmienne: dla ośmiu atrybutów (np. czystość plaży i szlaków, baza noclegowa, ceny, oferta dla dzieci) każda osoba podaje ważność (1–5) i ocenę (1–5). Plan analiz: średnie ważności i oceny, siatka czterech ćwiartek, luka „ocena − ważność” sprawdzona testem dla par z korektą na wielokrotne porównania.
Analizę ważność–ocena (ang. importance–performance analysis, IPA) opisali Martilla i James (1977) jako prosty sposób łącznego pomiaru ważności i wykonania atrybutów, przydatny w planowaniu działań marketingowych. W turystyce stała się bardzo popularna. Średnie umieszczasz na wykresie: oś pozioma to ważność, pionowa to ocena, a linie podziału przechodzą przez średnią ważność i średnią ocenę wszystkich atrybutów (w przykładzie 3.69 i 3.65). Powstają cztery ćwiartki: „skup się tutaj” (ważne, słabo ocenione), „utrzymaj poziom”, „niski priorytet” i „możliwy nadmiar” (mało ważne, dobrze ocenione).
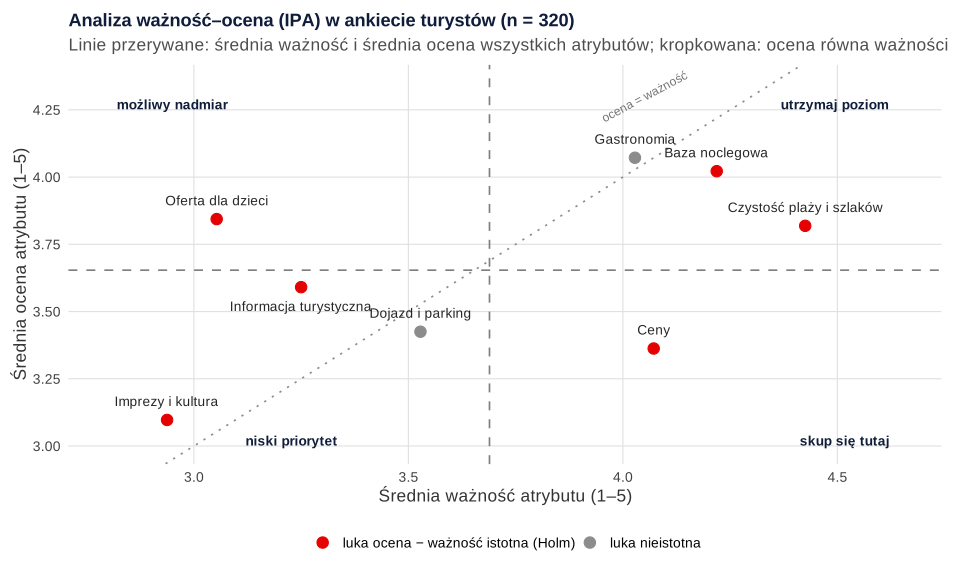
Sam wykres łatwo jednak przeinterpretować. Azzopardi i Nash (2013) w przeglądzie metodologicznym IPA wskazują problemy koncepcyjne i pomiarowe, które zagrażają trafności takich wniosków. Dwa z nich widać na rysunku 1. Po pierwsze, położenie linii podziału jest umowne: ich przesunięcie o kilka setnych może przenieść atrybut do innej ćwiartki. Po drugie, ćwiartka nie mówi, jak duża jest luka. Czystość plaży i szlaków leży w ćwiartce „utrzymaj poziom”, a ma prawie tak dużą lukę jak ceny: ocena była niższa od ważności o 0.61 punktu (rrb = −.65, p < .001 po korekcie Holma). Ceny, jedyny atrybut w ćwiartce „skup się tutaj”, miały lukę −0.71 (rrb = −.66, p < .001). Dlatego obok wykresu pokaż tabelę z lukami.
Ważność i ocena pochodzą od tych samych osób, więc lukę dla każdego atrybutu sprawdzasz testem Wilcoxona dla par, a jako efekt podajesz sparowaną korelację rangowo-biseryjną. Przy ośmiu testach skoryguj wartości p metodą Holma (o tym, kiedy korekta jest potrzebna, piszemy w haśle o problemie wielokrotnych porównań). W przykładzie po korekcie istotne były luki ujemne dla czystości, cen i bazy noclegowej (−0.20, p = .015) oraz dodatnie dla oferty dla dzieci (+0.79, p < .001), informacji turystycznej (+0.34, p < .001) i imprez (+0.16, p = .048). Luki dla gastronomii oraz dojazdu i parkingu były nieistotne.
Projekt 3. Segmentacja turystów według motywów wyjazdu
Pytanie: czy wśród turystów można wyróżnić grupy o podobnych motywach przyjazdu i czym te grupy się różnią? Zmienne: sześć motywów ocenianych od 1 do 7 (relaks, ucieczka od codzienności, przygoda, kontakt z przyrodą, poznawanie kultury, czas z rodziną) oraz typ noclegu jako zmienna do opisu segmentów. Plan analiz: standaryzacja motywów, analiza skupień metodą k-średnich dla kilku wartości k, wybór liczby segmentów, opis profili, porównanie segmentów pod względem zmiennych spoza segmentacji.
Liczebność. Segmentacja potrzebuje większej próby niż porównanie dwóch grup. Dolnicar i in. (2014) w symulacji na danych o znanej strukturze pokazali, że we wszystkich badanych warunkach wystarczała próba równa 70-krotności liczby zmiennych użytych do segmentacji. Przy sześciu motywach to 420 osób. W przykładzie jest ich 450 (75 na zmienną). Jeśli masz 150 ankiet, ogranicz liczbę zmiennych albo potraktuj segmentację jako analizę wstępną.
Wybór liczby segmentów. K-średnich zawsze podzieli dane na tyle grup, o ile poprosisz, dlatego porównaj kilka rozwiązań. Rousseeuw (1987) zaproponował sylwetkę: dla każdej osoby porównuje się, jak blisko jest członków własnego skupienia, a jak blisko najbliższego innego. Średnia szerokość sylwetki ocenia jakość podziału i może pomóc wybrać liczbę skupień (więcej w haśle wskaźnik sylwetki). W przykładzie średnia sylwetka wyniosła .30 dla k = 2, .31 dla k = 3, .21 dla k = 4 i .17 dla k = 5 i 6, więc wybrano trzy segmenty. Wartość .31 oznacza segmenty zauważalne, ale nakładające się. Tak wygląda większość segmentacji ankietowych i trzeba to uczciwie napisać.
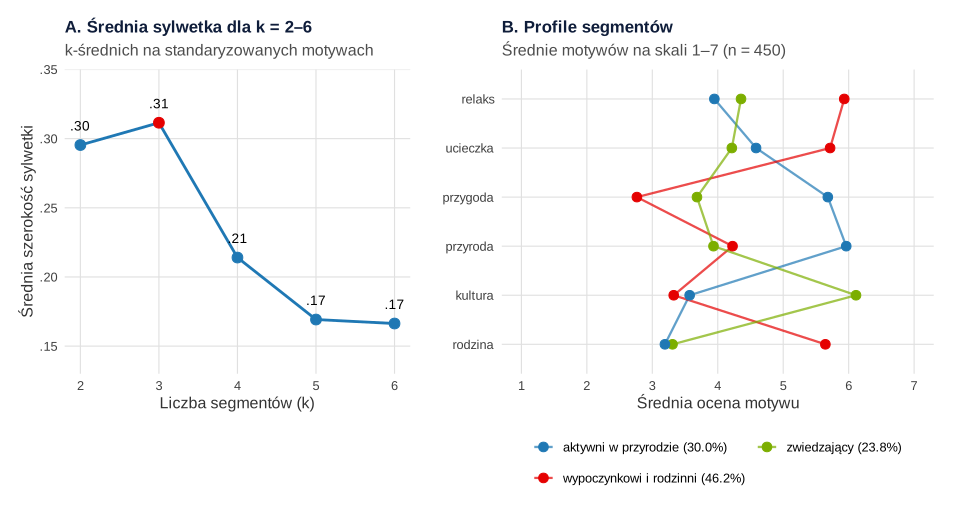
Profile i nazwy. Segmenty opisujesz średnimi motywów na oryginalnej skali 1–7, a nie wartościami standaryzowanymi. Największy segment (46.2%) najwyżej ocenił relaks (5.93), ucieczkę od codzienności (5.72) i czas z rodziną (5.64), a przygodę nisko (2.76). Nazwano go „wypoczynkowi i rodzinni”. Drugi (30.0%) wyróżniał się kontaktem z przyrodą (5.96) i przygodą (5.68): „aktywni w przyrodzie”. Trzeci (23.8%) najwyżej ocenił poznawanie kultury (6.11): „zwiedzający”. Nazwy to Twoja interpretacja, a nie wynik testu. W symulacji znamy prawdziwy podział, a k-średnich odtworzyło go dla 95.1% osób. W prawdziwym badaniu takiej kontroli nie masz, więc sprawdź przynajmniej, czy podobne segmenty wychodzą na losowej połowie próby.
Czym różnią się segmenty. Nie testuj różnic w motywach między segmentami: segmenty powstały właśnie po to, by się w nich różnić, więc taki test zawsze „wyjdzie”. Testuj zmienne, których nie użyto do segmentacji. W przykładzie typ noclegu zależał od segmentu: kemping lub agroturystykę wybrało 54.1% aktywnych w przyrodzie, 36.4% zwiedzających i 26.4% wypoczynkowych i rodzinnych. Test chi-kwadrat: χ²(4) = 47.02, p < .001, V Craméra = .23 (najmniejsza liczebność oczekiwana 29.0). Porównanie k-średnich z analizą profili latentnych opisujemy w poradniku segmentacja respondentów: k-średnich i LPA.
Projekt 4. Wydatki turystów: regresja na logarytmie
Pytanie: od czego zależą dzienne wydatki turysty na osobę? Zmienne: wydatki w złotych na osobę dziennie (bez dojazdu), liczba noclegów, liczba osób w grupie, typ noclegu (pensjonat lub apartament, hotel, kemping lub agroturystyka), wiek i pierwsza wizyta. Plan analiz: opis rozkładu wydatków, regresja wieloraka na logarytmie wydatków z odpornymi błędami standardowymi, interpretacja w procentach.
W przeglądzie 86 prac o wydatkach turystów Brida i Scuderi (2013) wskazują, że najczęściej uwzględnia się dochód, cechy społeczno-demograficzne i cechy podróży, a modele szacuje się głównie metodą najmniejszych kwadratów, regresją kwantylową, modelami Tobit i dwuetapowymi. W pracy dyplomowej zwykle wystarcza regresja wieloraka, ale nie na surowych złotych. Wydatki są prawoskośne: w przykładzie (400 turystów) średnia wyniosła 227.58 zł (SD = 140.46), mediana 189 zł, a zakres 41–906 zł (skośność 1.64). Model na złotych miał silnie skośne reszty (skośność 1.60), a test Breuscha–Pagana wskazał heteroskedastyczność, BP = 19.95, p = .003.
Po transformacji logarytmicznej rozkład stał się prawie symetryczny (skośność 0.11), reszty też (−0.04), a model wyjaśnił więcej zmienności: R² = .335, skorygowane R² = .325, F(6, 393) = 33.00, p < .001. Mimo nieistotnego testu Breuscha–Pagana (p = .228) użyto błędów standardowych HC3. Long i Ervin (2000) zalecają odporne błędy zawsze, gdy można podejrzewać heteroskedastyczność, bez uzależniania tej decyzji od testu wstępnego. Kiedy logarytm pomaga, a kiedy lepszy jest inny model, omawiamy w tekście kiedy transformować zmienną.
Interpretacja w procentach. Współczynnik b w modelu na logarytmie zamieniasz na zmianę procentową wzorem 100 × (eb − 1). Przy pozostałych zmiennych stałych goście hoteli wydawali o 40.3% więcej niż goście pensjonatów i apartamentów (95% CI [25.6, 56.6]), a goście kempingów i gospodarstw agroturystycznych o 36.2% mniej (95% CI [28.6, 43.0]). Każdy kolejny nocleg wiązał się z wydatkami dziennymi niższymi o 3.8% (95% CI [1.5, 6.0]), a każda dodatkowa osoba w grupie – o 5.6% (95% CI [2.6, 8.6]). Związek z wiekiem był słaby (+0.4% na rok, p = .041), a pierwsza wizyta nie miała istotnego związku z wydatkami (p = .341).
Prognoza w złotych. Jeśli chcesz podać przewidywane wydatki, nie wystarczy podnieść prognozy z logarytmu do potęgi e. Otrzymasz wtedy wartość bliską medianie, a nie średnią. Duan (1983) zaproponował poprawkę smearing: prognozę mnoży się przez średnią z e podniesionego do potęgi reszt modelu. W przykładzie średnia z prostych prognoz wynosiła 203.5 zł, a po poprawce (czynnik 1.113) 226.6 zł, przy średniej w danych 227.6 zł. Dla 41-letniego gościa hotelu, który przyjechał pierwszy raz z drugą osobą na cztery noclegi, prognoza wzrosła z 298.0 zł do 331.7 zł.
Projekt 5. Gotowość polecenia i NPS
Pytanie: czy goście ośrodka rekreacyjnego A chętniej polecają go znajomym niż goście ośrodka B? Zmienne: odpowiedź na pytanie o gotowość polecenia na skali 0–10 i ośrodek. Plan analiz: rozkład kategorii, Net Promoter Score (NPS) z przedziałem ufności, porównanie ośrodków na wskaźniku i na pełnej skali.
NPS to odsetek promotorów (odpowiedzi 9–10) minus odsetek krytyków (0–6), w punktach od −100 do 100. Ośrodki i organizacje turystyczne często go raportują, więc promotor może zaproponować go jako miarę lojalności. Pamiętaj jednak o dwóch ograniczeniach. Po pierwsze, Keiningham i in. (2007) na danych podłużnych z 21 firm nie potwierdzili, że NPS przewiduje wzrost przychodów lepiej niż inne miary satysfakcji i lojalności. Po drugie, wskaźnik powstaje z trzech kategorii, więc traci informację. Przejście gościa z 0 na 6 nie zmienia NPS, a z 8 na 9 – zmienia.
W przykładzie ośrodek A (n = 180) miał 49.4% promotorów i 17.2% krytyków, czyli NPS = 32.2, a ośrodek B (n = 160) 39.4% i 20.0%, czyli NPS = 19.4. Różnica 12.8 punktu wygląda na dużą, ale przedziały są szerokie. Przedział bootstrapowy (5000 powtórzeń) wyniósł [21.7, 43.3] dla A i [8.1, 30.6] dla B. Dla różnicy wyniósł [−3.1, 29.1], czyli obejmuje zero. Przedział ze wzoru dla rozkładu wielomianowego dał prawie te same granice. Analiza pełnej skali 0–10 prowadzi do tego samego wniosku: M = 7.88 (SD = 2.25) w A i 7.68 (SD = 2.09) w B, U = 15802, p = .115, rrb = .10, 95% CI [−.03, .22]. Przy kilkuset ankietach NPS jest więc mało precyzyjny i różnice rzędu kilkunastu punktów mogą wynikać z przypadku. Jak NPS wykorzystać w badaniu konsumenckim, opisujemy w poradniku statystyka w pracy z marketingu.
Projekt 6. Sezonowość ruchu turystycznego – opis
Pytanie: jak silnie liczba noclegów w obiekcie koncentruje się w kilku miesiącach roku? Zmienne: liczba noclegów w każdym miesiącu przez trzy lata. Plan analiz: wskaźniki opisowe i wykres liniowy miesięcy. Na poziomie pracy licencjackiej czy magisterskiej zwykle nie potrzebujesz testu statystycznego: chodzi o opis wzoru.
Sezonowość to powtarzający się co roku wzór wahań. Koenig-Lewis i Bischoff (2005) w przeglądzie badań nad sezonowością w turystyce omawiają jej definicje, przyczyny, skutki i sposoby pomiaru. Zwracają też uwagę, że dziedzina potrzebuje bardziej ścisłego podejścia ilościowego. W pracy dyplomowej przydają się cztery proste miary:
- indeks sezonowości dla miesiąca: średnia liczba noclegów w tym miesiącu podzielona przez średnią miesięczną z całego okresu, razy 100. W przykładzie sierpień miał indeks 208, lipiec 193, a listopad 45;
- stosunek najlepszego do najsłabszego miesiąca w roku: od 4.17 do 5.27 w trzech latach;
- współczynnik zmienności 12 wartości miesięcznych: 50.4%, 57.7% i 50.2%;
- współczynnik Giniego z 12 miesięcy: 0 oznacza równomierny ruch, a im wyższa wartość, tym silniejsza koncentracja (.26, .29 i .25). Pomocny jest też udział lipca i sierpnia w rocznej sumie: 32.6–34.8%.
Wskaźniki licz osobno dla każdego roku. Wtedy widać, czy sezonowość się zmienia, a nie tylko, jaka jest średnio. Jeśli Twoim celem jest prognoza albo ocena trendu, potrzebujesz modelu szeregu czasowego. Wtedy przeczytaj poradnik szeregi czasowe i ARIMA w praktyce. Trzy lata danych miesięcznych (36 obserwacji) to jednak niewiele do takiego modelu. Sezonowość ma też wpływ na projekty 1–5: jeśli ankietę zbierasz tylko w szczycie sezonu, opisujesz gości szczytu sezonu.
Jak opisać analizę statystyczną w pracy
W rozdziale o metodach opisz, gdzie i kiedy zbierano ankiety, jak dobierano respondentów, ile ankiet odrzucono i dlaczego, oraz jak liczono wyniki skal. Poniżej wzór akapitu dla projektów 1–4. Jeśli nie masz pewności, który test pasuje do Twojej hipotezy, skorzystaj z kreatora doboru testu. Gotowe zdania z wynikami w stylu APA przygotuje generator opisu wyników. Pełną ścieżkę od pytania badawczego do rozdziału wyników znajdziesz w przewodniku statystyka w pracy dyplomowej.
Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z sześciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu, a ostatni przepis – rysunki i plik XLSX do pobrania. Każdy z przepisów 1–4 tworzy własne dane symulowane, więc możesz go uruchomić osobno. Pełnym przykładem od danych do zdania APA jest przepis 3 z regresją wydatków. Kod uruchomiono w R 4.5.3 z ustawieniem LANG=en_US.UTF-8.
1. Projekty 1 i 2: rzetelność skali satysfakcji, test Manna–Whitneya i analiza ważność–ocena (IPA)
R
# Projekt 1: satysfakcja z pobytu i analiza ważność–ocena (IPA) – ankieta wśród turystów (dane symulowane).
# 320 turystów w miejscowości wypoczynkowej: 6 pozycji satysfakcji (1–5), pierwsza wizyta albo powrót,
# a dla 8 atrybutów miejsca – ważność (1–5) i ocena (1–5) od tych samych osób.
suppressPackageStartupMessages({ library(effectsize); library(psych) })
set.seed(22401)
n <- 320
powrot <- factor(sample(c("pierwsza wizyta", "kolejna wizyta"), n, TRUE, prob = c(.55, .45)),
                 levels = c("pierwsza wizyta", "kolejna wizyta"))
cecha <- rnorm(n) + 0.45 * (powrot == "kolejna wizyta")      # ogólne zadowolenie z pobytu
likert <- function(x, progi = c(-1.9, -1.0, -0.1, 0.9)) as.integer(cut(x, c(-Inf, progi, Inf)))
poz <- sapply(c(.80, .75, .70, .65, .72, .60), function(l) likert(l * cecha + sqrt(1 - l^2) * rnorm(n) + 0.35))
colnames(poz) <- c("s1_wypoczynek", "s2_atmosfera", "s3_obsluga", "s4_ceny", "s5_atrakcje", "s6_czystosc")
p1 <- data.frame(id = 1:n, powrot, poz)
p1$satysfakcja <- rowMeans(poz)

# Rzetelność skali: alfa Cronbacha i omega z jednoczynnikowej analizy czynnikowej
alpha(poz)$total[, c("raw_alpha", "std.alpha")]
l <- as.vector(fa(poz, nfactors = 1)$loadings)
round(c(ladunki_min = min(l), ladunki_max = max(l), omega = sum(l)^2 / (sum(l)^2 + sum(1 - l^2))), 2)

# Pierwsza a kolejna wizyta: opis, test Manna–Whitneya, korelacja rangowo-biseryjna
aggregate(satysfakcja ~ powrot, p1, function(x) round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x),
          Q1 = unname(quantile(x, .25)), Q3 = unname(quantile(x, .75))), 2))
wilcox.test(satysfakcja ~ powrot, data = p1, exact = FALSE)
rank_biserial(satysfakcja ~ powrot, data = p1)

# IPA: ważność i ocena 8 atrybutów u tych samych osób
atr <- c("Czystość plaży i szlaków", "Baza noclegowa", "Gastronomia", "Ceny", "Dojazd i parking",
         "Oferta dla dzieci", "Imprezy i kultura", "Informacja turystyczna")
waz_m <- c(4.5, 4.3, 4.0, 4.2, 3.6, 3.1, 2.9, 3.3)            # średnie „prawdziwe” w populacji
oce_m <- c(3.7, 4.0, 4.1, 3.2, 3.3, 3.8, 3.0, 3.6)
ipa_dane <- do.call(cbind, lapply(seq_along(atr), function(j) {
  w <- pmin(5, pmax(1, round(waz_m[j] + rnorm(n, 0, .8))))
  o <- pmin(5, pmax(1, round(oce_m[j] + 0.3 * cecha + rnorm(n, 0, .8))))
  setNames(data.frame(w, o), paste0(c("waz_", "oce_"), j))
}))
ipa <- do.call(rbind, lapply(seq_along(atr), function(j) {
  w <- ipa_dane[[paste0("waz_", j)]]; o <- ipa_dane[[paste0("oce_", j)]]
  wx <- wilcox.test(o, w, paired = TRUE, exact = FALSE)
  rb <- rank_biserial(o, w, paired = TRUE)
  data.frame(atrybut = atr[j], waznosc = mean(w), ocena = mean(o), luka = mean(o - w),
             r_rb = rb$r_rank_biserial, p = wx$p.value)
}))
ipa$p_holm <- p.adjust(ipa$p, "holm")
srodek <- c(waznosc = mean(ipa$waznosc), ocena = mean(ipa$ocena))
ipa$cwiartka <- with(ipa, ifelse(waznosc >= srodek[1] & ocena < srodek[2], "skup się tutaj",
                       ifelse(waznosc >= srodek[1], "utrzymaj poziom",
                       ifelse(ocena < srodek[2], "niski priorytet", "możliwy nadmiar"))))
round(srodek, 2)
print(transform(ipa, waznosc = round(waznosc, 2), ocena = round(ocena, 2), luka = round(luka, 2),
                r_rb = round(r_rb, 2), p = signif(p, 3), p_holm = signif(p_holm, 3)), row.names = FALSE)
Wynik w R
 raw_alpha std.alpha
 0.8163502 0.8155334
ladunki_min ladunki_max       omega
       0.55        0.80        0.82
           powrot satysfakcja.n satysfakcja.M satysfakcja.SD satysfakcja.Me satysfakcja.Q1 satysfakcja.Q3
1 pierwsza wizyta        168.00          3.93           0.63           4.00           3.67           4.33
2  kolejna wizyta        152.00          4.13           0.64           4.17           3.67           4.67

	Wilcoxon rank sum test with continuity correction

data:  satysfakcja by powrot
W = 10580, p-value = 0.00791
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |         95% CI
----------------------------------
-0.17             | [-0.29, -0.05]
waznosc   ocena
   3.69    3.65
                  atrybut waznosc ocena  luka  r_rb        p   p_holm        cwiartka
 Czystość plaży i szlaków    4.42  3.82 -0.61 -0.65 2.27e-18 1.36e-17 utrzymaj poziom
           Baza noclegowa    4.22  4.02 -0.20 -0.22 3.79e-03 1.51e-02 utrzymaj poziom
              Gastronomia    4.03  4.07  0.04  0.05 4.94e-01 4.94e-01 utrzymaj poziom
                     Ceny    4.07  3.36 -0.71 -0.66 1.33e-19 9.34e-19  skup się tutaj
         Dojazd i parking    3.53  3.42 -0.10 -0.10 1.89e-01 3.78e-01 niski priorytet
        Oferta dla dzieci    3.05  3.84  0.79  0.67 1.56e-21 1.25e-20 możliwy nadmiar
        Imprezy i kultura    2.94  3.10  0.16  0.18 1.59e-02 4.78e-02 niski priorytet
   Informacja turystyczna    3.25  3.59  0.34  0.34 3.70e-06 1.85e-05 niski priorytet
2. Projekt 3: segmentacja k-średnich, średnia sylwetka i opis segmentów
R
# Projekt 2: segmentacja turystów według motywów wyjazdu – analiza skupień k-średnich (dane symulowane).
# 450 turystów oceniło 6 motywów wyjazdu (1–7); typ noclegu jako zmienna do opisu segmentów.
suppressPackageStartupMessages({ library(cluster); library(effectsize) })
set.seed(22402)
n <- 450
mot <- c("relaks", "ucieczka", "przygoda", "przyroda", "kultura", "rodzina")
prawdziwy <- sample(1:3, n, TRUE, prob = c(.45, .30, .25))   # segmenty w populacji (nieznane badaczowi)
profil <- rbind(c(6.0, 5.6, 2.8, 4.2, 3.4, 5.6),               # wypoczynkowi i rodzinni
                c(4.0, 4.6, 5.9, 6.0, 3.6, 3.2),               # aktywni w przyrodzie
                c(4.2, 4.2, 3.6, 4.0, 6.1, 3.4))               # zwiedzający
X <- profil[prawdziwy, ] + matrix(rnorm(n * 6, 0, 1.05), n)
X[] <- pmin(7, pmax(1, round(X)))
colnames(X) <- mot
nocleg <- factor(ifelse(runif(n) < c(.25, .55, .30)[prawdziwy], "kemping lub agroturystyka",
                 ifelse(runif(n) < c(.70, .40, .35)[prawdziwy], "pensjonat lub apartament", "hotel")),
                 levels = c("hotel", "pensjonat lub apartament", "kemping lub agroturystyka"))
p2 <- data.frame(id = 1:n, X, nocleg)

cat("osób na zmienną:", n / ncol(X), "\n")              # reguła Dolnicar i in. (2014): co najmniej 70
Z <- scale(X)                                           # standaryzacja motywów
D <- dist(Z)
wyb <- do.call(rbind, lapply(2:6, function(k) {
  set.seed(100 + k)
  km <- kmeans(Z, centers = k, nstart = 50, iter.max = 100)
  data.frame(k = k, sylwetka = mean(silhouette(km$cluster, D)[, "sil_width"]),
             wewn_SS_proc = 100 * km$tot.withinss / km$totss)
}))
print(round(wyb, 3), row.names = FALSE)

k <- wyb$k[which.max(wyb$sylwetka)]; cat("wybrane k:", k, "\n")
set.seed(100 + k)
km <- kmeans(Z, centers = k, nstart = 50, iter.max = 100)
sil <- silhouette(km$cluster, D)
summary(sil)$clus.avg.widths
cat("osób z ujemną sylwetką:", sum(sil[, "sil_width"] < 0), "z", n, "\n")

# Profile segmentów na oryginalnej skali 1–7 (to opisujesz w pracy, nie centroidy z)
prof <- aggregate(X, list(segment = km$cluster), mean)
prof$n <- as.vector(table(km$cluster)); prof$proc <- round(100 * prof$n / n, 1)
print(cbind(prof[1], round(prof[2:7], 2), prof[8:9]), row.names = FALSE)

# Zgodność z segmentami „prawdziwymi” (znane tylko w symulacji)
zg <- table(znaleziony = km$cluster, prawdziwy); zg
cat("zgodność z prawdziwym podziałem (%):", round(100 * sum(apply(zg, 1, max)) / n, 1), "\n")

# Opis segmentów zmienną spoza segmentacji: typ noclegu
p2$segment <- factor(km$cluster)
tab <- table(p2$segment, p2$nocleg); tab
round(100 * prop.table(tab, 1), 1)
ch <- chisq.test(tab); ch
min(ch$expected)
cramers_v(tab, adjust = FALSE)
Wynik w R
osób na zmienną: 75
 k sylwetka wewn_SS_proc
 2    0.295       66.841
 3    0.312       51.839
 4    0.214       48.061
 5    0.169       45.338
 6    0.166       42.902
wybrane k: 3
        1         2         3
0.2805987 0.3427970 0.2877875
osób z ujemną sylwetką: 0 z 450
 segment relaks ucieczka przygoda przyroda kultura rodzina   n proc
       1   4.36     4.21     3.68     3.93    6.11    3.31 107 23.8
       2   5.93     5.72     2.76     4.23    3.33    5.64 208 46.2
       3   3.95     4.59     5.68     5.96    3.57    3.19 135 30.0
          prawdziwy
znaleziony   1   2   3
         1   5   6  96
         2 206   0   2
         3   3 126   6
zgodność z prawdziwym podziałem (%): 95.1

    hotel pensjonat lub apartament kemping lub agroturystyka
  1    41                       27                        39
  2    48                      105                        55
  3    33                       29                        73

    hotel pensjonat lub apartament kemping lub agroturystyka
  1  38.3                     25.2                      36.4
  2  23.1                     50.5                      26.4
  3  24.4                     21.5                      54.1

	Pearson's Chi-squared test

data:  tab
X-squared = 47.024, df = 4, p-value = 1.508e-09

[1] 29.00889
Cramer's V |       95% CI
-------------------------
0.23       | [0.17, 1.00]

- One-sided CIs: upper bound fixed at [1.00].
3. Projekt 4: regresja logarytmu wydatków z błędami HC3 i poprawka smearing – pełny przykład
R
# Projekt 3: od czego zależą dzienne wydatki turysty – regresja na logarytmie wydatków (dane symulowane).
# 400 turystów: wydatki na osobę dziennie (zł, bez dojazdu), liczba noclegów, wielkość grupy, typ noclegu,
# wiek i pierwsza wizyta.
suppressPackageStartupMessages({ library(sandwich); library(lmtest) })
set.seed(22403)
n <- 400
noclegi <- pmin(14, 1 + rpois(n, 4))
grupa <- sample(1:6, n, TRUE, prob = c(.15, .35, .15, .2, .1, .05))
nocleg <- factor(sample(c("pensjonat lub apartament", "hotel", "kemping lub agroturystyka"), n, TRUE, prob = c(.45, .3, .25)),
                 levels = c("pensjonat lub apartament", "hotel", "kemping lub agroturystyka"))
wiek <- round(pmin(75, pmax(18, rnorm(n, 41, 13))))
pierwsza <- rbinom(n, 1, .55)
log_w <- 5.45 - 0.035 * noclegi - 0.07 * (grupa - 1) + 0.38 * (nocleg == "hotel") -
  0.42 * (nocleg == "kemping lub agroturystyka") + 0.004 * (wiek - 41) + 0.10 * pierwsza +
  rnorm(n, 0, 0.45 + 0.08 * (nocleg == "hotel"))
p3 <- data.frame(id = 1:n, wydatki = round(exp(log_w)), noclegi, grupa, nocleg, wiek, pierwsza)

round(c(M = mean(p3$wydatki), SD = sd(p3$wydatki), Me = median(p3$wydatki), min = min(p3$wydatki),
        max = max(p3$wydatki), skosnosc = psych::skew(p3$wydatki), skosnosc_log = psych::skew(log(p3$wydatki))), 2)

# Model na surowych złotych: reszty skośne i heteroskedastyczne
m_zl <- lm(wydatki ~ noclegi + grupa + nocleg + wiek + pierwsza, data = p3)
round(c(R2_adj = summary(m_zl)$adj.r.squared, skosnosc_reszt = psych::skew(resid(m_zl))), 3)
bptest(m_zl)

# Model na logarytmie wydatków z błędami odpornymi HC3
m_log <- lm(log(wydatki) ~ noclegi + grupa + nocleg + wiek + pierwsza, data = p3)
round(c(R2 = summary(m_log)$r.squared, R2_adj = summary(m_log)$adj.r.squared, skosnosc_reszt = psych::skew(resid(m_log))), 3)
summary(m_log)$fstatistic
bptest(m_log)
ct <- coeftest(m_log, vcov = vcovHC(m_log, type = "HC3"))
ci <- coefci(m_log, vcov = vcovHC(m_log, type = "HC3"))
wyn <- data.frame(b = ct[, 1], SE_HC3 = ct[, 2], t = ct[, 3], p = ct[, 4],
                  zmiana_proc = 100 * (exp(ct[, 1]) - 1),
                  CI_d = 100 * (exp(ci[, 1]) - 1), CI_g = 100 * (exp(ci[, 2]) - 1))
print(round(wyn[-1, ], 3))
signif(wyn$p[-1], 3)
df.residual(m_log)

# Prognoza średnich wydatków: zwykłe exp() zaniża średnią, poprawka smearing Duana (1983)
profil <- data.frame(noclegi = 4, grupa = 2, nocleg = "hotel", wiek = 41, pierwsza = 1)
smear <- mean(exp(resid(m_log)))
round(c(exp_prognozy = unname(exp(predict(m_log, profil))), smearing = smear,
        prognoza_smearing = unname(exp(predict(m_log, profil))) * smear), 3)
round(c(srednia_w_danych = mean(p3$wydatki), srednia_exp_prognoz = mean(exp(fitted(m_log))),
        srednia_smearing = mean(exp(fitted(m_log)) * smear)), 1)
Wynik w R
           M           SD           Me          min          max     skosnosc skosnosc_log
      227.58       140.46       189.00        41.00       906.00         1.64         0.11
        R2_adj skosnosc_reszt
         0.257          1.599

	studentized Breusch-Pagan test

data:  m_zl
BP = 19.951, df = 6, p-value = 0.002825

            R2         R2_adj skosnosc_reszt
         0.335          0.325         -0.035
    value     numdf     dendf
 32.99847   6.00000 393.00000

	studentized Breusch-Pagan test

data:  m_log
BP = 8.1414, df = 6, p-value = 0.2279

                                     b SE_HC3      t     p zmiana_proc    CI_d    CI_g
noclegi                         -0.039  0.012 -3.203 0.001      -3.793  -6.049  -1.482
grupa                           -0.058  0.016 -3.596 0.000      -5.624  -8.564  -2.590
nocleghotel                      0.338  0.056  6.033 0.000      40.268  25.622  56.620
noclegkemping lub agroturystyka -0.450  0.057 -7.848 0.000     -36.241 -43.039 -28.632
wiek                             0.004  0.002  2.048 0.041       0.382   0.015   0.750
pierwsza                         0.045  0.048  0.954 0.341       4.649  -4.706  14.923
[1] 1.47e-03 3.64e-04 3.72e-09 4.04e-14 4.12e-02 3.41e-01
[1] 393
     exp_prognozy          smearing prognoza_smearing
          297.955             1.113           331.741
   srednia_w_danych srednia_exp_prognoz    srednia_smearing
              227.6               203.5               226.6
4. Projekty 5 i 6: NPS z przedziałem bootstrapowym i wskaźniki sezonowości
R
# Projekt 4: NPS dwóch ośrodków rekreacyjnych – przedział bootstrapowy i analiza pełnej skali 0–10.
# Projekt 5: sezonowość noclegów w obiekcie – wskaźniki opisowe (dane symulowane).
suppressPackageStartupMessages(library(effectsize))
set.seed(22404)
pk <- function(pr) sample(0:10, 1, prob = pr)
pr_A <- c(1, 1, 1, 2, 2, 4, 6, 12, 20, 25, 26)                 # rozkład odpowiedzi 0–10 w ośrodku A
pr_B <- c(1, 1, 1, 2, 3, 6, 9, 17, 22, 21, 17)                 # w ośrodku B
p4 <- data.frame(osrodek = factor(rep(c("A", "B"), c(180, 160))),
                 polecenie = c(sample(0:10, 180, TRUE, pr_A), sample(0:10, 160, TRUE, pr_B)))
p4$kategoria <- cut(p4$polecenie, c(-1, 6, 8, 10), labels = c("krytycy (0–6)", "neutralni (7–8)", "promotorzy (9–10)"))
nps <- function(x) 100 * (mean(x >= 9) - mean(x <= 6))
round(100 * prop.table(table(p4$osrodek, p4$kategoria), 1), 1)
tapply(p4$polecenie, p4$osrodek, nps)

# 95% CI dla NPS: wzór z rozkładu wielomianowego i bootstrap percentylowy (5000 powtórzeń)
ci_wzor <- function(x) { pp <- mean(x >= 9); pd <- mean(x <= 6); s <- nps(x)
  se <- 100 * sqrt((pp + pd - (pp - pd)^2) / length(x)); c(NPS = s, lo = s - 1.96 * se, hi = s + 1.96 * se) }
t(sapply(split(p4$polecenie, p4$osrodek), ci_wzor))
xA <- p4$polecenie[p4$osrodek == "A"]; xB <- p4$polecenie[p4$osrodek == "B"]
set.seed(224)
b <- replicate(5000, { a <- sample(xA, replace = TRUE); bb <- sample(xB, replace = TRUE); c(nps(a), nps(bb), nps(a) - nps(bb)) })
wyn_b <- rbind(A = quantile(b[1, ], c(.025, .975)), B = quantile(b[2, ], c(.025, .975)), roznica = quantile(b[3, ], c(.025, .975)))
cbind(oszacowanie = c(nps(xA), nps(xB), nps(xA) - nps(xB)), round(wyn_b, 1))

# Ta sama porównywana różnica na pełnej skali 0–10
aggregate(polecenie ~ osrodek, p4, function(x) round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x)), 2))
wilcox.test(polecenie ~ osrodek, data = p4, exact = FALSE)
rank_biserial(polecenie ~ osrodek, data = p4)

# Projekt 5: noclegi w obiekcie miesiąc po miesiącu przez 3 lata
set.seed(22405)
mies <- c("sty", "lut", "mar", "kwi", "maj", "cze", "lip", "sie", "wrz", "paź", "lis", "gru")
wzor <- c(.85, .95, .55, .60, .80, 1.25, 1.95, 2.05, 1.00, .60, .45, .95)   # profil sezonu
p5 <- data.frame(rok = rep(1:3, each = 12), miesiac = factor(rep(mies, 3), levels = mies))
p5$noclegi <- round(rnorm(36, 1500 * rep(wzor, 3) * (1 + 0.05 * (p5$rok - 1)), 90))
indeks <- 100 * tapply(p5$noclegi, p5$miesiac, mean) / mean(p5$noclegi)    # indeks sezonowości (średnia = 100)
round(indeks)
roczne <- sapply(split(p5$noclegi, p5$rok), function(x) {
  s <- sort(x); n <- length(s)
  c(suma = sum(x), max_min = max(x) / min(x), CV_proc = 100 * sd(x) / mean(x),
    udzial_lip_sie = 100 * sum(x[7:8]) / sum(x),
    gini = sum((2 * seq_len(n) - n - 1) * s) / (n * sum(s)))
})
round(roczne, 2)
Wynik w R
    krytycy (0–6) neutralni (7–8) promotorzy (9–10)
  A          17.2            33.3              49.4
  B          20.0            40.6              39.4
       A        B
32.22222 19.37500
       NPS        lo       hi
A 32.22222 21.262183 43.18226
B 19.37500  7.818779 30.93122
        oszacowanie 2.5% 97.5%
A          32.22222 21.7  43.3
B          19.37500  8.1  30.6
roznica    12.84722 -3.1  29.1
  osrodek polecenie.n polecenie.M polecenie.SD polecenie.Me
1       A      180.00        7.88         2.25         8.00
2       B      160.00        7.68         2.09         8.00

	Wilcoxon rank sum test with continuity correction

data:  polecenie by osrodek
W = 15802, p-value = 0.1145
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |        95% CI
---------------------------------
0.10              | [-0.03, 0.22]
sty lut mar kwi maj cze lip sie wrz paź lis gru
 86  95  53  59  74 127 193 208 101  62  45  98
                      1        2        3
suma           18201.00 18731.00 19446.00
max_min            4.17     5.27     4.57
CV_proc           50.39    57.73    50.19
udzial_lip_sie    32.61    34.82    32.80
gini               0.26     0.29     0.25
5. Rysunki i plik XLSX
R
# Rysunki i plik XLSX do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b224-rysunki.R > b224-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(svglite); library(patchwork); library(openxlsx) })
pdf(NULL)
invisible(capture.output({ for (f in c("b224-1-satysfakcja-ipa.R", "b224-2-segmentacja.R", "b224-3-wydatki.R",
                                         "b224-4-nps-sezonowosc.R")) source(f) }))
# Motyw rysunków i zapis SVG zdefiniowane lokalnie
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", trzeci = "#7CAE00", granat = "#0f1d3a", neutralny = "#8C8C8C")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = .4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100),
              round(file.info(plik)$size / 1024)))
}

# Rysunek 1: siatka ważność–ocena (IPA) dla 8 atrybutów miejscowości
d1 <- ipa
d1$istotna <- ifelse(d1$p_holm < .05, "luka ocena − ważność istotna (Holm)", "luka nieistotna")
print(d1[, c("atrybut", "waznosc", "ocena", "luka", "p_holm")], digits = 3, row.names = FALSE)
r1 <- ggplot(d1, aes(waznosc, ocena)) +
  geom_abline(slope = 1, intercept = 0, linetype = 3, colour = "grey55") +
  geom_vline(xintercept = srodek[["waznosc"]], linetype = 2, colour = "grey50") +
  geom_hline(yintercept = srodek[["ocena"]], linetype = 2, colour = "grey50") +
  geom_point(aes(colour = istotna), size = 3.6) +
  geom_text(aes(y = ocena + ifelse(atrybut == "Informacja turystyczna", -.07, .07), label = atrybut), size = 3.6, colour = "grey15") +
  annotate("text", x = c(4.62, 4.62, 3.12, 2.82), y = c(3.02, 4.27, 3.02, 4.27), hjust = c(1, 1, 0, 0), size = 3.6,
           fontface = "bold", colour = KOLORY[["granat"]],
           label = c("skup się tutaj", "utrzymaj poziom", "niski priorytet", "możliwy nadmiar")) +
  annotate("text", x = 4.05, y = 4.3, label = "ocena = ważność", colour = "grey45", size = 3.2, angle = 28) +
  scale_colour_manual(values = c(KOLORY[["akcent"]], KOLORY[["neutralny"]]),
                      breaks = c("luka ocena − ważność istotna (Holm)", "luka nieistotna"), name = NULL) +
  scale_x_continuous(limits = c(2.8, 4.65), breaks = seq(3, 4.5, .5)) +
  scale_y_continuous(limits = c(3.0, 4.35), breaks = seq(3, 4.25, .25)) +
  labs(title = "Analiza ważność–ocena (IPA) w ankiecie turystów (n = 320)",
       subtitle = "Linie przerywane: średnia ważność i średnia ocena wszystkich atrybutów; kropkowana: ocena równa ważności",
       x = "Średnia ważność atrybutu (1–5)", y = "Średnia ocena atrybutu (1–5)") + theme_metodolog(13)
zapisz_svg(r1, "../statystyka-turystyka-ipa.svg", szer = 10, wys = 6)

# Rysunek 2: wybór liczby segmentów (średnia sylwetka) i profile motywów
print(round(wyb, 3), row.names = FALSE)
r2a <- ggplot(wyb, aes(k, sylwetka)) + geom_line(colour = KOLORY[["drugi"]], linewidth = 1) +
  geom_point(aes(colour = k == 3), size = 3.4, show.legend = FALSE) +
  geom_text(aes(label = sub("^0", "", sprintf("%.2f", sylwetka))), nudge_y = .014, size = 3.6) +
  scale_colour_manual(values = c(`TRUE` = KOLORY[["akcent"]], `FALSE` = KOLORY[["drugi"]])) +
  scale_y_continuous(limits = c(.14, .34), labels = function(x) sub("^0", "", sprintf("%.2f", x))) +
  labs(title = "A. Średnia sylwetka dla k = 2–6", subtitle = "k-średnich na standaryzowanych motywach",
       x = "Liczba segmentów (k)", y = "Średnia szerokość sylwetki") + theme_metodolog(12)
nazwy <- c(`1` = "zwiedzający", `2` = "wypoczynkowi i rodzinni", `3` = "aktywni w przyrodzie")
d2 <- do.call(rbind, lapply(mot, function(v) data.frame(motyw = v, segment = paste0(nazwy[as.character(prof$segment)], " (", sprintf("%.1f", prof$proc), "%)"),
                                                     M = prof[[v]])))
d2$motyw <- factor(d2$motyw, levels = rev(mot))
print(d2, digits = 3, row.names = FALSE)
r2b <- ggplot(d2, aes(M, motyw, colour = segment, group = segment)) +
  geom_path(linewidth = .8, alpha = .7) + geom_point(size = 3) +
  scale_colour_manual(values = c(KOLORY[["drugi"]], KOLORY[["akcent"]], KOLORY[["trzeci"]]), name = NULL) +
  scale_x_continuous(limits = c(1, 7), breaks = 1:7) + guides(colour = guide_legend(nrow = 2)) +
  labs(title = "B. Profile segmentów", subtitle = "Średnie motywów na skali 1–7 (n = 450)", x = "Średnia ocena motywu", y = NULL) +
  theme_metodolog(12)
zapisz_svg(r2a + r2b + plot_layout(widths = c(1, 1.25)), "../statystyka-turystyka-segmenty.svg", szer = 10, wys = 5.4)

# Plik XLSX z danymi do pobrania
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z turystyki i rekreacji – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
opis <- data.frame(arkusz = c("P1_satysfakcja", "P1_IPA", "P2_motywy", "P3_wydatki", "P4_NPS", "P5_sezonowosc"),
  zawartosc = c("320 turystów: 6 pozycji satysfakcji (1–5), wynik skali i pierwsza albo kolejna wizyta",
                "te same 320 osoby: ważność (waz_1–waz_8) i ocena (oce_1–oce_8) ośmiu atrybutów miejscowości, skala 1–5",
                "450 turystów: 6 motywów wyjazdu (1–7), typ noclegu i segment z analizy k-średnich",
                "400 turystów: wydatki na osobę dziennie (zł), noclegi, wielkość grupy, typ noclegu, wiek, pierwsza wizyta (1 = tak)",
                "340 gości dwóch ośrodków rekreacyjnych: gotowość polecenia 0–10 i kategoria NPS",
                "noclegi w obiekcie w kolejnych miesiącach trzech lat"),
  uwaga = "Dane symulowane do nauki analizy; nie pochodzą z prawdziwego badania.")
atr_kody <- data.frame(kod = 1:8, atrybut = atr)
arkusze <- list(Opis = opis, P1_satysfakcja = p1, P1_IPA = cbind(id = 1:nrow(ipa_dane), ipa_dane),
                P2_motywy = p2, P3_wydatki = p3, P4_NPS = p4, P5_sezonowosc = p5)
for (nm in names(arkusze)) { addWorksheet(wb, nm); writeData(wb, nm, arkusze[[nm]]) }
writeData(wb, "Opis", atr_kody, startRow = nrow(opis) + 3)
saveWorkbook(wb, "../statystyka-turystyka-dane-przyklad.xlsx", overwrite = TRUE)
sapply(getSheetNames("../statystyka-turystyka-dane-przyklad.xlsx"), function(s) nrow(read.xlsx("../statystyka-turystyka-dane-przyklad.xlsx", s)))
cat("rozmiar KB:", round(file.info("../statystyka-turystyka-dane-przyklad.xlsx")$size / 1024), "\n")
Wynik w R
                  atrybut waznosc ocena    luka   p_holm
 Czystość plaży i szlaków    4.42  3.82 -0.6062 1.36e-17
           Baza noclegowa    4.22  4.02 -0.1969 1.51e-02
              Gastronomia    4.03  4.07  0.0438 4.94e-01
                     Ceny    4.07  3.36 -0.7094 9.34e-19
         Dojazd i parking    3.53  3.42 -0.1031 3.78e-01
        Oferta dla dzieci    3.05  3.84  0.7906 1.25e-20
        Imprezy i kultura    2.94  3.10  0.1594 4.78e-02
   Informacja turystyczna    3.25  3.59  0.3406 1.85e-05
Zapisano ../statystyka-turystyka-ipa.svg: w HTML width="1000" height="600" (9 KB)
 k sylwetka wewn_SS_proc
 2    0.295       66.841
 3    0.312       51.839
 4    0.214       48.061
 5    0.169       45.338
 6    0.166       42.902
    motyw                         segment    M
   relaks             zwiedzający (23.8%) 4.36
   relaks wypoczynkowi i rodzinni (46.2%) 5.93
   relaks    aktywni w przyrodzie (30.0%) 3.95
 ucieczka             zwiedzający (23.8%) 4.21
 ucieczka wypoczynkowi i rodzinni (46.2%) 5.72
 ucieczka    aktywni w przyrodzie (30.0%) 4.59
 przygoda             zwiedzający (23.8%) 3.68
 przygoda wypoczynkowi i rodzinni (46.2%) 2.76
 przygoda    aktywni w przyrodzie (30.0%) 5.68
 przyroda             zwiedzający (23.8%) 3.93
 przyroda wypoczynkowi i rodzinni (46.2%) 4.23
 przyroda    aktywni w przyrodzie (30.0%) 5.96
  kultura             zwiedzający (23.8%) 6.11
  kultura wypoczynkowi i rodzinni (46.2%) 3.33
  kultura    aktywni w przyrodzie (30.0%) 3.57
  rodzina             zwiedzający (23.8%) 3.31
  rodzina wypoczynkowi i rodzinni (46.2%) 5.64
  rodzina    aktywni w przyrodzie (30.0%) 3.19
Zapisano ../statystyka-turystyka-segmenty.svg: w HTML width="1000" height="540" (16 KB)
          Opis P1_satysfakcja         P1_IPA      P2_motywy     P3_wydatki
            15            320            320            450            400
        P4_NPS  P5_sezonowosc
           340             36
rozmiar KB: 75
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje wilcox.test(), kmeans(), chisq.test(), lm() i p.adjust() z pakietów stats i base); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- cluster (wersja 2.1.8.2): Maechler, M., Rousseeuw, P., Struyf, A., Hubert, M., & Hornik, K. (2026). cluster: Cluster analysis basics and extensions (R package version 2.1.8.2) [Computer software]. https://CRAN.R-project.org/package=cluster
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z turystyki i rekreacji
- Uogólnianie ankiety „na miejscu” na wszystkich turystów regionu, bez opisu terminu, miejsca i sposobu doboru respondentów.
- Badanie tylko w szczycie sezonu i wnioski o „turystach” w ogóle.
- Kilka ankiet od jednej rodziny traktowanych jak niezależne osoby, a wydatki grupy liczone jak wydatki jednej osoby.
- Wnioskowanie z samej ćwiartki IPA, bez tabeli luk i bez testu dla par.
- Segmentacja na zbyt małej próbie i testowanie różnic w motywach między segmentami utworzonymi z tych samych motywów.
- Regresja na surowych złotych przy silnie skośnych wydatkach albo interpretacja współczynnika z modelu na logarytmie tak, jakby był w złotych.
- Prognoza wydatków przez samo ex bez poprawki, która zaniża średnią.
- NPS bez przedziału ufności i ogłaszanie, że ośrodek A „wygrywa” różnicą kilkunastu punktów przy kilkuset ankietach.
- Wniosek przyczynowy z badania przekrojowego, np. „powrót do miejscowości zwiększa satysfakcję”.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej z turystyki i rekreacji?
To zależy od pytania. Satysfakcję dwóch grup turystów porównasz testem Manna–Whitneya (albo testem t, gdy wynik skali ma wiele wartości i zbliżony do normalnego rozkład), ważność i ocenę atrybutów – testem Wilcoxona dla par z korektą Holma, motywy wyjazdu – analizą skupień, a wydatki – regresją na logarytmie wydatków. Do każdej analizy dodaj wielkość efektu i opis próby: gdzie, kiedy i jak zbierano ankiety.
Jak przeprowadzić analizę IPA (ważność–ocena) w pracy dyplomowej?
Dla każdego atrybutu policz średnią ważność i średnią ocenę, umieść je na wykresie i podziel go liniami przez średnie wszystkich atrybutów. Obok wykresu podaj tabelę luk (ocena minus ważność) z testem Wilcoxona dla par i korektą Holma, bo położenie linii podziału jest umowne, a ćwiartka nie mówi, jak duża jest luka.
Ilu turystów potrzeba do segmentacji metodą k-średnich?
W symulacji Dolnicar i in. (2014) we wszystkich badanych warunkach wystarczała próba równa 70-krotności liczby zmiennych użytych do segmentacji, czyli 420 osób przy sześciu motywach. Przy mniejszej próbie ogranicz liczbę zmiennych albo przedstaw segmentację jako analizę wstępną i sprawdź, czy podobne segmenty powstają na losowej połowie próby.
Jak zinterpretować współczynnik regresji, gdy zmienną zależną są zlogarytmowane wydatki?
Przelicz go na zmianę procentową wzorem 100 × (eb − 1). Na przykład b = 0.338 dla hotelu oznacza wydatki wyższe o około 40% niż w kategorii odniesienia przy pozostałych zmiennych stałych. Do prognozy w złotych użyj poprawki smearing Duana, bo samo ex z prognozy zaniża średnią.
Czy NPS wystarczy jako miara lojalności turystów w pracy?
Może być jedną z miar, ale nie jedyną. NPS powstaje z trzech kategorii (0–6, 7–8, 9–10), więc traci informację, a przy kilkuset ankietach ma szeroki przedział ufności. Podaj go z 95% CI (np. bootstrapowym), a porównania grup wykonaj także na pełnej skali 0–10. Jego przewaga nad innymi miarami lojalności nie została potwierdzona w badaniu Keininghama i in. (2007).
Powiązane hasła
Przeczytaj też
Segmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę z turystyki i rekreacji i masz ankiety turystów, ale nie wiesz, jak je policzyć?
Pomożemy dobrać analizy do Twojego badania – od satysfakcji i IPA po segmentację i regresję wydatków – policzyć je z wielkością efektu i wyjaśnić tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Azzopardi, E., & Nash, R. (2013). A critical evaluation of importance–performance analysis. Tourism Management, 35, 222–233. https://doi.org/10.1016/j.tourman.2012.07.007
- Brida, J. G., & Scuderi, R. (2013). Determinants of tourist expenditure: A review of microeconometric models. Tourism Management Perspectives, 6, 28–40. https://doi.org/10.1016/j.tmp.2012.10.006 ● Otwarty dostęp: pełny tekst
- Dolnicar, S., Grün, B., Leisch, F., & Schmidt, K. (2014). Required sample sizes for data-driven market segmentation analyses in tourism. Journal of Travel Research, 53(3), 296–306. https://doi.org/10.1177/0047287513496475 ● Otwarty dostęp
- Duan, N. (1983). Smearing estimate: A nonparametric retransformation method. Journal of the American Statistical Association, 78(383), 605–610. https://doi.org/10.1080/01621459.1983.10478017
- Keiningham, T. L., Cooil, B., Andreassen, T. W., & Aksoy, L. (2007). A longitudinal examination of net promoter and firm revenue growth. Journal of Marketing, 71(3), 39–51. https://doi.org/10.1509/jmkg.71.3.039
- Koenig-Lewis, N., & Bischoff, E. E. (2005). Seasonality research: The state of the art. International Journal of Tourism Research, 7(4–5), 201–219. https://doi.org/10.1002/jtr.531
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Martilla, J. A., & James, J. C. (1977). Importance-performance analysis. Journal of Marketing, 41(1), 77–79. https://doi.org/10.1177/002224297704100112
- Rousseeuw, P. J. (1987). Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65. https://doi.org/10.1016/0377-0427(87)90125-7 ● Otwarty dostęp
Cytowania BibTeX
@article{azzopardi2013critical, author={Azzopardi, Ernest and Nash, Robert}, title={{A critical evaluation of importance–performance analysis}}, journal={Tourism Management}, year={2013}, volume={35}, pages={222--233}, doi={10.1016/j.tourman.2012.07.007}}@article{brida2013determinants, author={Brida, Juan Gabriel and Scuderi, Raffaele}, title={{Determinants of tourist expenditure: A review of microeconometric models}}, journal={Tourism Management Perspectives}, year={2013}, volume={6}, pages={28--40}, doi={10.1016/j.tmp.2012.10.006}}@article{dolnicar2014required, author={Dolnicar, Sara and Grün, Bettina and Leisch, Friedrich and Schmidt, Kathrin}, title={{Required sample sizes for data-driven market segmentation analyses in tourism}}, journal={Journal of Travel Research}, year={2014}, volume={53}, number={3}, pages={296--306}, doi={10.1177/0047287513496475}}@article{duan1983smearing, author={Duan, Naihua}, title={{Smearing estimate: A nonparametric retransformation method}}, journal={Journal of the American Statistical Association}, year={1983}, volume={78}, number={383}, pages={605--610}, doi={10.1080/01621459.1983.10478017}}@article{keiningham2007longitudinal, author={Keiningham, Timothy L. and Cooil, Bruce and Andreassen, Tor Wallin and Aksoy, Lerzan}, title={{A longitudinal examination of net promoter and firm revenue growth}}, journal={Journal of Marketing}, year={2007}, volume={71}, number={3}, pages={39--51}, doi={10.1509/jmkg.71.3.039}}@article{koeniglewis2005seasonality, author={Koenig-Lewis, Nicole and Bischoff, Eberhard E.}, title={{Seasonality research: The state of the art}}, journal={International Journal of Tourism Research}, year={2005}, volume={7}, number={4–5}, pages={201--219}, doi={10.1002/jtr.531}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{martilla1977importance, author={Martilla, John A. and James, John C.}, title={{Importance-performance analysis}}, journal={Journal of Marketing}, year={1977}, volume={41}, number={1}, pages={77--79}, doi={10.1177/002224297704100112}}@article{rousseeuw1987silhouettes, author={Rousseeuw, Peter J.}, title={{Silhouettes: A graphical aid to the interpretation and validation of cluster analysis}}, journal={Journal of Computational and Applied Mathematics}, year={1987}, volume={20}, pages={53--65}, doi={10.1016/0377-0427(87)90125-7}}