Przykład: sieć gabinetów fizjoterapii i pytanie „ile wizyt dopisać?”
Fikcyjna sieć ma 8 gabinetów fizjoterapii. W każdym fizjoterapeuta pracuje codziennie w jednym bloku: 8 terminów po 30 minut, rano (8:00–12:00) albo po południu (15:00–19:00). Przez dwa lata (2024–2025) umówiono 30 064 wizyty 6817 pacjentów; zajętych było 89.8% terminów. 22.7% wizyt to pierwsze wizyty, reszta to kolejne wizyty z serii zabiegów. Pacjenci, którzy się zgodzili, dostają dzień wcześniej przypomnienie SMS (72.0% wizyt).
Na 3543 wizyty nikt nie przyszedł. Sieć liczy jako nieprzyjście wizytę bez uprzedzenia albo odwołaną dopiero w ostatniej dobie, gdy nie dało się już nikogo wpisać (35.0% nieprzyjść). Kierowniczka pyta: w których blokach dopisać pacjenta z listy oczekujących ponad 8 terminów i ilu. Decyzja zapada 2 dni przed wizytą.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Ryzyko nieprzyjścia rośnie z wyprzedzeniem rezerwacji, przy pierwszej wizycie, z liczbą wcześniejszych nieprzyjść, w piątek, o 8:00–10:00 i w wakacje, a spada po SMS-ie. Każdy pacjent ma też ukrytą skłonność do nieprzychodzenia, której analityk nie widzi. Takie czynniki – długie wyprzedzenie i wcześniejsze nieprzyjścia – najczęściej wskazuje przegląd 105 badań nad nieprzyjściami (Dantas i in., 2018). Parametry ustawiliśmy ręcznie, ziarna (751 i kolejne) – raz. Dane pobierzesz jako no-show-fizjoterapia-wizyty.csv.
W odróżnieniu od obsady infolinii (Erlang C), gdzie zgłoszenia są losowe, tu wizyty są umówione, a niepewne jest tylko to, kto przyjdzie.
Rysunek 1: odsetek nieprzyjść i jego przedział
Ogółem pacjent nie przyszedł na 11.78% wizyt, 95% CI [11.43, 12.15] (przedział Wilsona). W 2024 r. było to 11.88% [11.38, 12.41], w 2025 r. 11.68% [11.18, 12.21], a w gabinetach od 10.1% do 12.7%.
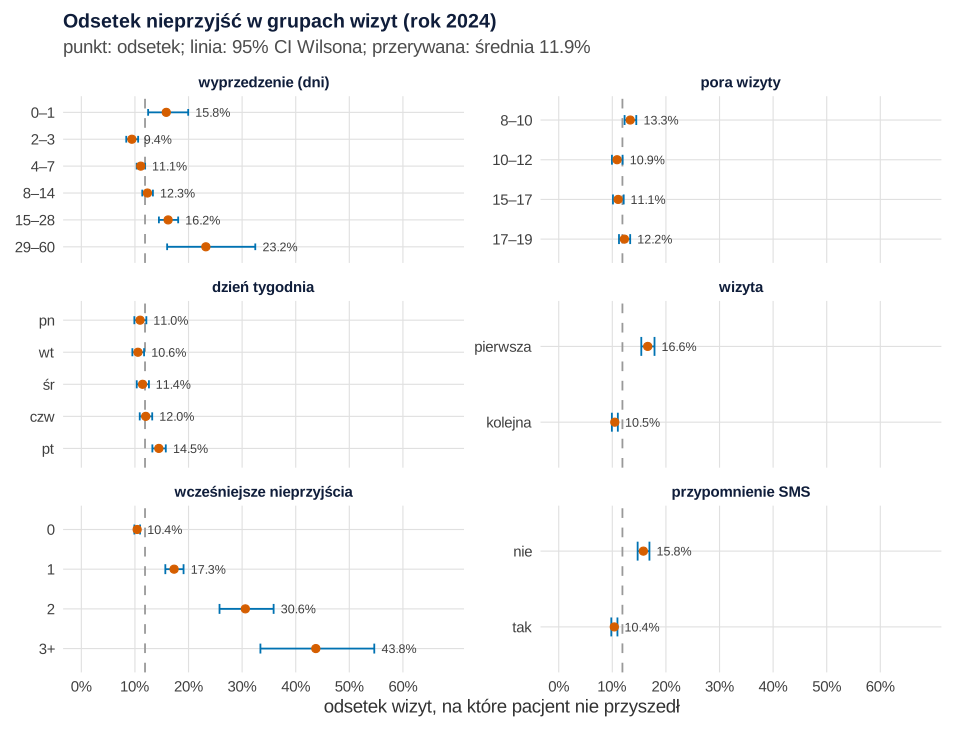
set.seed(751)).Co widać. Najsilniej różnicuje historia pacjenta: bez wcześniejszych nieprzyjść 10.4%, po jednym 17.3%, po dwóch 30.6%. Pierwsza wizyta to 16.6% wobec 10.5% przy kolejnej, a wizyta bez SMS-a – 15.8% wobec 10.4%. Ryzyko rośnie z wyprzedzeniem: 9.4% przy 2–3 dniach, 16.2% przy 15–28 dniach.
Jak może zmylić. Grupy się nakładają: rezerwacje na 0–1 dzień mają 15.8%, bo nie dostają SMS-a. Małe grupy (29–60 dni: 99 wizyt) mają szerokie przedziały. Wpływ cechy przy stałych pozostałych pokazuje dopiero model.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: model logistyczny ryzyka nieprzyjścia
Model to regresja logistyczna z sześcioma cechami znanymi 2 dni przed wizytą: wyprzedzenie rezerwacji (log2, więc współczynnik dotyczy dwukrotnie dłuższego wyprzedzenia), pora, dzień tygodnia, pierwsza wizyta, liczba wcześniejszych nieprzyjść (0, 1, 2, 3+) i zaplanowany SMS. Uczymy go na 15 070 wizytach z 2024 r. (1791 nieprzyjść, 137.8 zdarzenia na parametr).
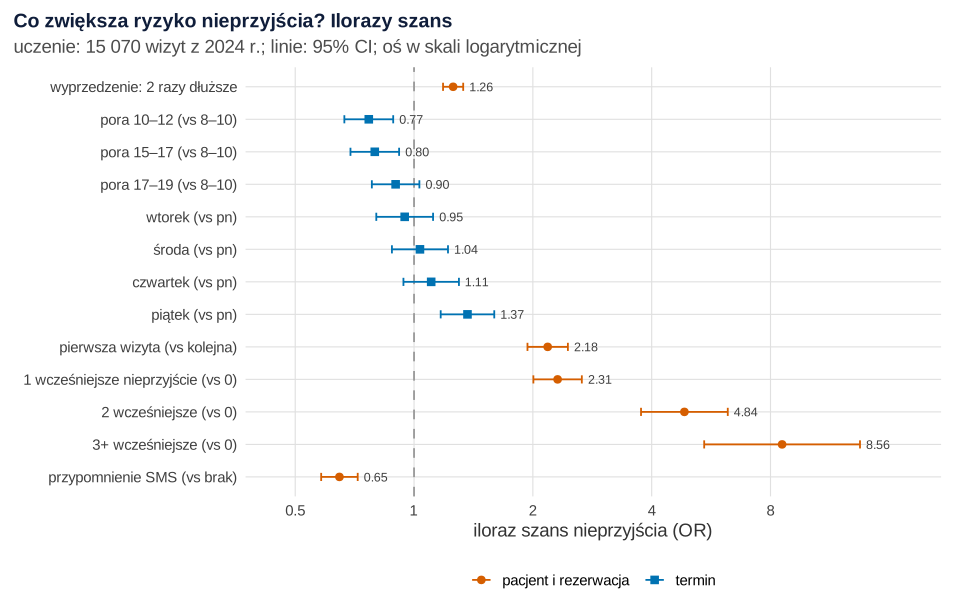
Co widać. Jedno wcześniejsze nieprzyjście ponad dwukrotnie zwiększa szanse kolejnego (iloraz szans OR = 2.31, 95% CI [2.01, 2.66]), a trzy lub więcej – ponad ośmiokrotnie (OR = 8.56 [5.43, 13.49]). Pierwsza wizyta ma OR = 2.18 [1.94, 2.45], piątek – 1.37 [1.17, 1.60], dwukrotnie dłuższe wyprzedzenie – 1.26 [1.18, 1.33], SMS – 0.65 [0.58, 0.72]. Na skali prawdopodobieństwa: kolejna wizyta we wtorek o 10:00 pacjenta bez nieprzyjść ma ryzyko 5.8% przy rezerwacji 7 dni wcześniej z SMS-em, 8.7% bez SMS-a i 8.6% przy rezerwacji 28 dni wcześniej z SMS-em.
Jak może zmylić. To model prognozy, nie przyczyn. SMS nie był losowany (nie dostają go rezerwacje na 0–1 dzień i pacjenci bez zgody). Skuteczność przypomnień sprawdza eksperyment losowy; w przeglądzie Cochrane SMS-y zwiększały zgłaszalność na wizyty (Gurol-Urganci i in., 2013).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: walidacja w czasie, kalibracja i przeciek
Model sprawdzamy na 2025 r., którego nie widział przy uczeniu – to walidacja w czasie. Do decyzji o grafiku potrzebne jest coś więcej niż ranking: prawdopodobieństwa muszą się zgadzać z rzeczywistością. To kalibracja, którą obok dyskryminacji warto raportować zawsze (Steyerberg i in., 2010); w niezależnych danych ocenia się jej wyraz wolny i nachylenie (Steyerberg i Vergouwe, 2014).
Obok – model z dodaną kolumną z systemu recepcji „odwołał dzień wcześniej”. Każda taka wizyta jest nieprzyjściem, a kolumnę wypełnia się już po decyzji o grafiku. To klasyczny przeciek: informacja o wyniku, której w chwili prognozy nie ma (Kaufman i in., 2012).
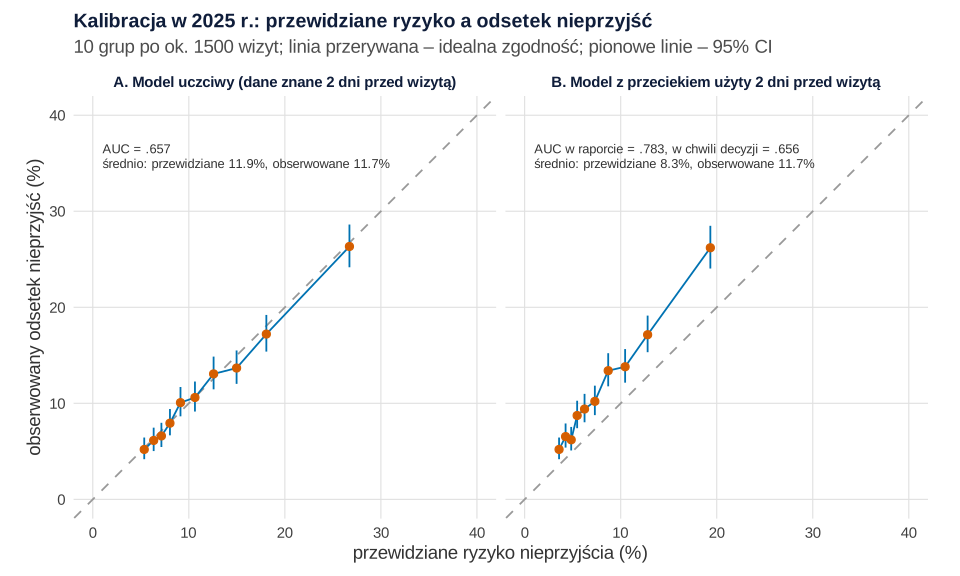
Co widać. Model uczciwy ma AUC = .657, 95% CI [.643, .671]. Średnio przewidział 11.9% nieprzyjść przy 11.7% obserwowanych; wyraz wolny kalibracji wynosi −0.02, nachylenie 0.98, a wynik Briera .099. Punkty leżą przy przekątnej od 5% do 27%. Model z przeciekiem ma w raporcie AUC = .783. Współczynnik przy nowej kolumnie wynosi ok. 20, bo to zmienna idealnie rozdzielająca (separacja). W chwili decyzji kolumna jest pusta: AUC spada do .656, a model przewiduje średnio 8.3% nieprzyjść zamiast 11.7% (wyraz wolny 0.39).
Jak może zmylić. AUC .657 wygląda skromnie, ale część zmienności jest nieprzewidywalna z tych danych. Nawet prawdziwe prawdopodobieństwo, które zna ukrytą skłonność pacjenta, ma tu AUC .752. Przeciek nie zepsuł tu rankingu, ale zaniżył ryzyko – pokazuje to dopiero kalibracja. Inną drogę od kalibracji do decyzji, dla leadów sprzedażowych, opisuje wpis o ocenie leadów B2B.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: jeden blok – kto przyjdzie?
Decyzja dotyczy bloku. Weźmy blok z poniedziałku 24 marca 2025 r. w gabinecie nr 8 (8:00–12:00); jego suma ryzyk jest bliska 90. centyla wśród 881 pełnych bloków 2025 r. Mediana oczekiwanej liczby nieprzyjść w pełnym bloku wynosi 0.93, a 10. i 90. centyl – 0.69 i 1.26.
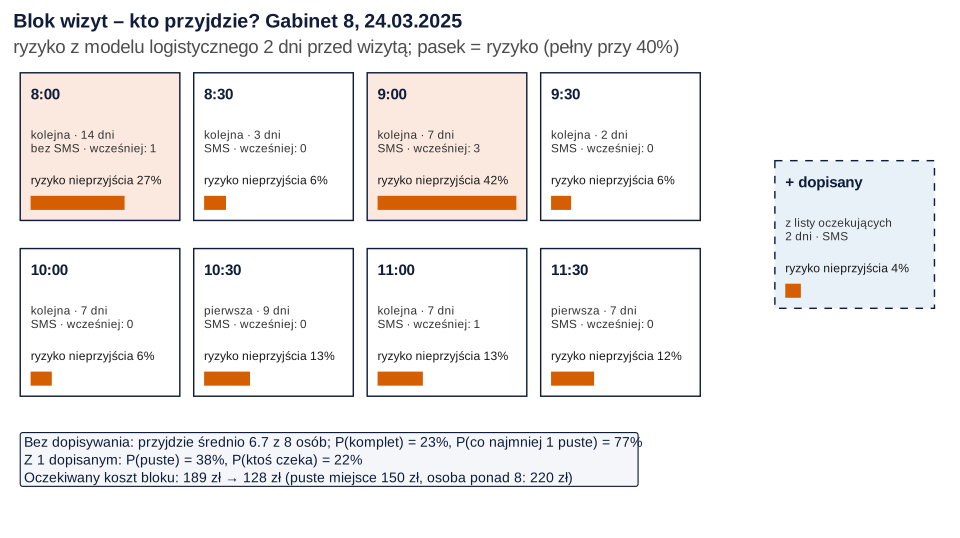
Co widać. Dwie wizyty mają wysokie ryzyko: 27.1% (bez SMS-a, jedno wcześniejsze nieprzyjście) i 42.0% (trzy wcześniejsze nieprzyjścia). Pozostałe mają 5.8–13.2%. Oczekiwana liczba przyjść to 6.74, komplet ośmiu osób zdarzy się z prawdopodobieństwem 23.2%, a co najmniej jedno puste miejsce – 76.8%. Pacjent dopisany z listy oczekujących (kolejna wizyta, termin za 2 dni, SMS) ma ryzyko tylko 4.5%.
Jak może zmylić. Ryzyko dotyczy bloku, nie osoby. Tego dnia nie przyszli pacjenci z ryzykiem 6.3% i 6.1%, a pacjent z ryzykiem 42.0% przyszedł. Karta nie mówi, kto zawiedzie, tylko ile osób zapewne przyjdzie.
Podpis do pracy:
Rysunek 5: suma Bernoullich z różnymi p
Każda osoba przychodzi albo nie – to próba Bernoulliego z własnym prawdopodobieństwem qi = 1 − ryzyko. Liczba przyjść w bloku to suma takich prób. Gdyby wszystkie q były równe, byłby to rozkład dwumianowy. Przy różnych q to rozkład Poissona-dwumianowy. Liczymy go dokładnie, dokładając osoby po kolei:
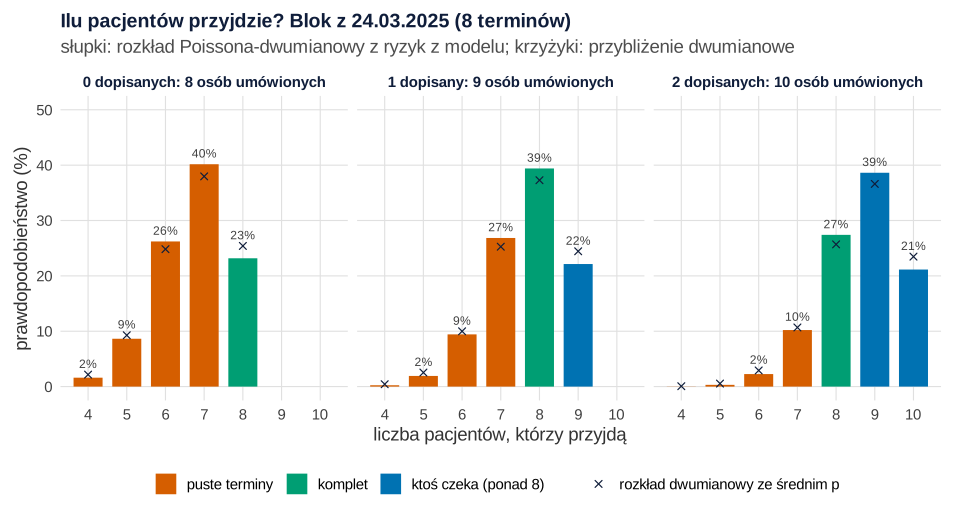
set.seed(7514)).Co widać. Bez dopisywania najbardziej prawdopodobne jest 7 osób (40.2%). Jeden dopisany zmniejsza szansę pustego miejsca z 76.8% do 38.5%, ale w 22.1% bloków ktoś będzie czekał ponad 8 terminów. Przy dwóch dopisanych czekanie grozi już w 59.8% przypadków. W 10 000 symulowanych powtórzeniach bloku komplet wypadł w 22.89% przypadków, a wzór daje 23.18%.
Jak może zmylić. Przybliżenie dwumianowe ze średnim q daje podobny obraz (P(komplet) = 25.4%), ale zawyża rozrzut: wariancja 1.061 zamiast 0.949. Model zakłada też niezależność: przy śnieżycy nie przychodzi wielu naraz – o takiej zależności pisze wpis o overbookingu w pensjonacie.
Podpis do pracy:
Rysunek 6: ile wizyt dopisać – oczekiwany koszt
Każde puste miejsce kosztuje sieć 150 zł utraconego przychodu. Każda osoba ponad 8 kosztuje 220 zł: pół godziny nadgodzin fizjoterapeuty i czekający, niezadowolony pacjent. Obie kwoty ustaliliśmy ręcznie. Dla każdego bloku wybieramy liczbę dopisanych (0–3) o najmniejszym oczekiwanym koszcie. Że nadrezerwacja poprawia dostęp i produktywność, ale wydłuża czekanie i nadgodziny, a jej opłacalność zależy od wag tych kosztów, pokazali w symulacjach LaGanga i Lawrence (2007).
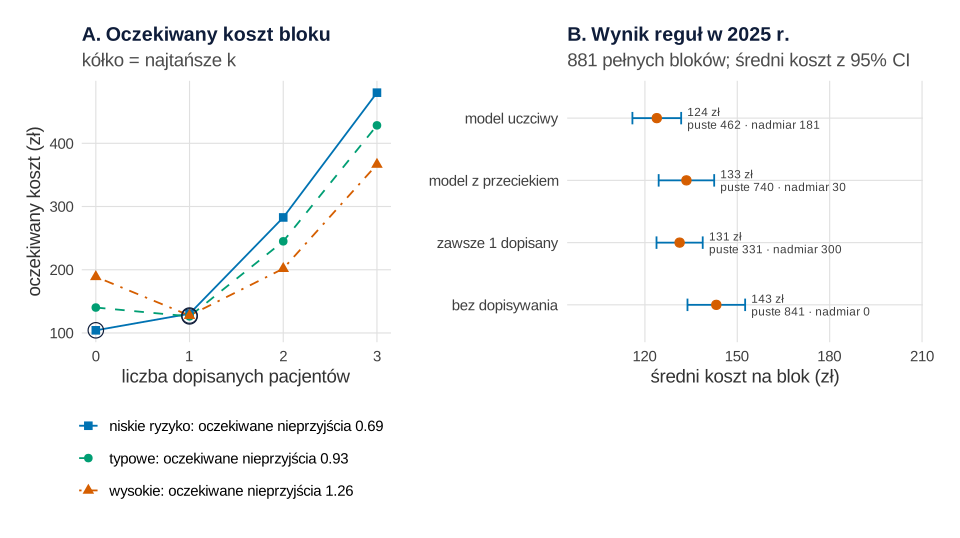
set.seed(7515)).Co widać. W bloku o niskim ryzyku (oczekiwane 0.69 nieprzyjścia) nie warto dopisywać: 104 zł wobec 130 zł. W bloku typowym i ryzykownym jeden dopisany obniża koszt, a dwóch – zawsze go podnosi. Reguła z modelu dopisała po jednej osobie w 611 z 881 pełnych bloków 2025 r. Przyjście dopisanych losowaliśmy z prawdziwego modelu; reguła kosztowała średnio 123.9 zł na blok, 95% CI [115.9, 131.8]. Bez dopisywania było to 143.2 zł [133.8, 152.6], przy dopisywaniu zawsze jednej osoby – 131.3 zł [123.8, 138.8]. Różnica wobec braku dopisywania wynosi −19.3 zł na blok [−28.5, −10.2], a wobec „zawsze 1” – −7.4 zł [−14.0, −0.9].
Jak może zmylić. Wynik zależy od kosztów. Przy koszcie nadmiaru 150 zł dopisywać trzeba by w 94.3% bloków, przy 400 zł – w 17.4%. Pokaż więc analizę wrażliwości. Model z przeciekiem, zaniżający ryzyko, dopisał tylko w 145 blokach i zostawił 740 pustych miejsc wobec 462 w regule uczciwej.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w firmie
- Decyduj o bloku, nie o pacjencie. Model służy do policzenia, ile osób zapewne przyjdzie, i do dopisania dodatkowego terminu z listy oczekujących. Nie służy do odmawiania wizyt pacjentom z wysokim ryzykiem ani do odsyłania ich na gorsze godziny.
- Nie wpychaj ryzykownych pacjentów w terminy nadrezerwowane. Algorytmy kierujące grupę o wyższym przewidywanym ryzyku na terminy z dłuższym czekaniem utrwalały nierówności (Shanklin i in., 2022). Dopisanego pacjenta uprzedź, że może poczekać.
- Ustal koszty z kierownictwem przed analizą i pokaż, jak zmienia się reguła przy innych kwotach.
- Zmniejszaj ryzyko u źródła. SMS dla wszystkich, krótsze wyprzedzenie kolejnych wizyt, telefon do pacjentów po dwóch nieprzyjściach. Skuteczność sprawdź eksperymentem – przykład w wpisie o SMS-ie i e-mailu w eksperymencie 2 × 2.
- Sprawdzaj kalibrację co kwartał i aktualizuj wyraz wolny, gdy średnie ryzyko odjedzie od odsetka nieprzyjść.
Więcej przykładów z usług: statystyka w pracy z zarządzania i ekonomii.
Jak opisać w pracy
Opisz definicję nieprzyjścia, chwilę prognozy, podział w czasie, dyskryminację, kalibrację i regułę decyzji z kosztami.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane d, przepis 2 – model m, przepis 3 – przewidywania dla 2025 r., przepis 4 – funkcję rozklad_pb() i pełne bloki bl używane w przepisie 5. Przepisy kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 751 w przepisie 1, 7514 w przepisie 4 (10 000 symulowanych bloków), 7515 w przepisie 5 (przyjście dopisanych pacjentów); przepisy 2, 3 i 6 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: 8 gabinetów, blok 8 terminów dziennie (rano albo po południu na zmianę co tydzień), 90% zajętych terminów, 82% szans, że wolny termin zajmie pacjent w trakcie serii, długość serii (1 + Poisson(4) wizyt), odstępy między wizytami (2–14 dni), wyprzedzenie pierwszych wizyt (rozkład gamma ze średnią 9 dni), zgodę na SMS (72% pacjentów), wszystkie współczynniki prawdziwego modelu nieprzyjścia i skłonność pacjenta (odchylenie standardowe 0.75), 30% przerwań serii po nieprzyjściu, 35% odwołań w ostatniej dobie wśród nieprzyjść (przepis 1), dwa dni przed wizytą jako chwilę decyzji, profil pacjenta dopisanego, koszty 150 i 220 zł oraz 0–3 dopisanych (przepisy 4–5). Po pierwszym uruchomieniu zmieniono (ziarna bez zmian): (1) średnią długość serii z 7 do 5 wizyt (1 + Poisson(6) → 1 + Poisson(4)), bo przy dłuższych seriach pacjentów było więcej, niż mieściły bloki, i mediana wyprzedzenia kolejnych wizyt wyniosła 16 dni zamiast typowego tygodnia; przy okazji przepisano zapis historii pacjenta, żeby przepis liczył się szybciej (inne liczby losowe niż w pierwszej wersji); (2) zakres osi na rysunkach 1 i 2, bo przedziały dla 3+ wcześniejszych nieprzyjść wychodziły poza wykres; (3) położenie etykiet na rysunkach 5 i 6, siatkę i ramkę podsumowania na rysunku 4 oraz krótszy tytuł rysunku 2. Przepis 1 liczy się ok. 25 sekund, pozostałe – po kilka sekund.
1. Dane i odsetki nieprzyjść: Rysunek 1
R
# Rysunek 1. Fikcyjna sieć 8 gabinetów fizjoterapii: 2 lata umówionych wizyt i odsetek nieprzyjść w grupach
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# ---- Parametry ustawione ręcznie ----
# 8 gabinetów, dni robocze 2024–2025, w każdym gabinecie dziennie jeden blok 8 terminów po 30 min:
# rano (8:00–12:00) albo po południu (15:00–19:00), na zmianę co tydzień
set.seed(751)
dni <- seq(as.Date("2024-01-01"), as.Date("2025-12-31"), by = "day")
dni <- dni[as.integer(format(dni, "%u")) <= 5]
G <- 8
efekt_gab <- rnorm(G, 0, 0.15)                     # różnice między gabinetami (nieobserwowane)
pory <- c("8–10", "10–12", "15–17", "17–19"); dni_tyg <- c("pn", "wt", "śr", "czw", "pt")
# Prawdziwy model nieprzyjścia (w prawdziwych danych go nie znamy); u – skłonność pacjenta, g – gabinet
logit_prawdy <- function(lead, pora, dzien, pierwsza, wczesniej, sms, u, g, miesiac)
  -3.15 + 0.42 * log1p(lead) + c(0.30, 0, 0.05, 0.25)[pora] + c(0.15, 0, 0, 0.05, 0.30)[dzien] +
  0.55 * pierwsza + 0.45 * pmin(wczesniej, 3) - 0.55 * sms + u + g +
  0.25 * (miesiac %in% 7:8) + 0.20 * (miesiac == 12)

N <- G * length(dni) * 8
kol_d <- c("gabinet", "t", "termin", "pora", "dzien", "miesiac", "pacjent", "lead", "pierwsza", "wczesniej",
           "sms", "p_prawdy", "nie_przyszedl")
d <- as.data.frame(matrix(NA_real_, N, length(kol_d), dimnames = list(NULL, kol_d)))
u_pac <- numeric(); zgoda_sms <- integer(); hist_t <- list(); hist_y <- list(); w <- 0
for (g in 1:G) {
  pid <- integer(); zostalo <- integer(); ostatnia <- numeric(); nast <- numeric()   # pacjenci w trakcie serii
  for (t in seq_along(dni)) {
    tydz <- as.integer(format(dni[t], "%V")); dz <- as.integer(format(dni[t], "%u"))
    mies <- as.integer(format(dni[t], "%m"))
    rano <- (tydz %% 2 == 0) == (g <= 4)
    dzis <- integer()
    for (s in 1:8) {
      if (runif(1) > 0.90) next                      # ok. 10% terminów nikt nie zarezerwował
      kand <- which(nast <= t & !(pid %in% dzis))
      if (length(kand) && runif(1) < 0.82) {         # kolejna wizyta z serii, umówiona na poprzedniej
        k <- kand[which.min(nast[kand])]; lead <- t - ostatnia[k]; pierwsza <- 0
      } else {                                       # nowy pacjent: pierwsza wizyta
        u_pac <- c(u_pac, rnorm(1, 0, 0.75)); zgoda_sms <- c(zgoda_sms, rbinom(1, 1, 0.72))
        hist_t[[length(u_pac)]] <- numeric(); hist_y[[length(u_pac)]] <- numeric()
        lead <- min(60, round(rgamma(1, shape = 1.3, rate = 1.3 / 9))); pierwsza <- 1
        pid <- c(pid, length(u_pac)); zostalo <- c(zostalo, 1 + rpois(1, 4))
        ostatnia <- c(ostatnia, t - lead); nast <- c(nast, t); k <- length(pid)
      }
      i <- pid[k]; dzis <- c(dzis, i)
      # nieprzyjścia tego pacjenta znane 2 dni przed wizytą (wtedy zapada decyzja o dopisaniu)
      wcz <- sum(hist_y[[i]][hist_t[[i]] < t - 2])
      sms <- zgoda_sms[i] * (lead >= 2)              # przypomnienie SMS dzień wcześniej (gdy jest zgoda)
      pora <- if (rano) 1 + (s > 4) else 3 + (s > 4)
      p <- plogis(logit_prawdy(lead, pora, dz, pierwsza, wcz, sms, u_pac[i], efekt_gab[g], mies))
      y <- rbinom(1, 1, p)
      w <- w + 1
      d[w, ] <- c(g, t, s, pora, dz, mies, i, lead, pierwsza, wcz, sms, p, y)
      hist_t[[i]] <- c(hist_t[[i]], t); hist_y[[i]] <- c(hist_y[[i]], y)
      zostalo[k] <- zostalo[k] - 1 - (y == 1) * rbinom(1, 1, 0.3) * 99   # po nieprzyjściu 30% przerywa serię
      ostatnia[k] <- t; nast[k] <- t + sample(c(2, 3, 4, 7, 7, 14), 1)
    }
    zost <- zostalo > 0
    pid <- pid[zost]; zostalo <- zostalo[zost]; ostatnia <- ostatnia[zost]; nast <- nast[zost]
  }
}
d <- d[seq_len(w), ]
d$data <- dni[d$t]; d$rok <- as.integer(format(d$data, "%Y"))
d$pora <- factor(pory[d$pora], pory); d$dzien <- factor(dni_tyg[d$dzien], dni_tyg)
d$wczesniej_kat <- factor(pmin(d$wczesniej, 3), 0:3, c("0", "1", "2", "3+"))
# Kolumna z systemu recepcji: „odwołał dzień wcześniej” – część nieprzyjść to odwołania w ostatniej dobie,
# gdy terminu nie dało się już obsadzić. Wpisywana dzień przed wizytą, czyli PO decyzji o grafiku.
d$odwolal_dzien_wczesniej <- d$nie_przyszedl * rbinom(nrow(d), 1, 0.35)

write.csv(transform(d[c("gabinet", "data", "termin", "pora", "dzien", "pacjent", "lead", "pierwsza", "wczesniej",
                        "sms", "odwolal_dzien_wczesniej", "nie_przyszedl")]),
          "no-show-fizjoterapia-wizyty.csv", row.names = FALSE)

cat("Wizyty:", nrow(d), "| pacjenci:", length(unique(d$pacjent)), "| terminy w blokach:", G * length(dni) * 8,
    "| zajęte:", round(100 * nrow(d) / (G * length(dni) * 8), 1), "%\n")
cat("Pierwsze wizyty:", round(100 * mean(d$pierwsza), 1), "% | SMS:", round(100 * mean(d$sms), 1),
    "% | mediana wyprzedzenia:", median(d$lead), "dni (pierwsze:", median(d$lead[d$pierwsza == 1]),
    "| kolejne:", median(d$lead[d$pierwsza == 0]), ")\n")
odsetek <- function(y) {                             # odsetek z 95% przedziałem Wilsona
  pt <- prop.test(sum(y), length(y), correct = FALSE)
  c(n = length(y), k = sum(y), proc = 100 * mean(y), dol = 100 * pt$conf.int[1], gora = 100 * pt$conf.int[2])
}
cat("Nieprzyjścia ogółem (%, 95% CI Wilsona):\n"); print(round(odsetek(d$nie_przyszedl), 2))
cat("Według roku:\n"); print(round(t(sapply(split(d$nie_przyszedl, d$rok), odsetek)), 2))
cat("Odwołane w ostatniej dobie wśród nieprzyjść:", round(100 * mean(d$odwolal_dzien_wczesniej[d$nie_przyszedl == 1]), 1), "%\n")
cat("Według gabinetu (%):", round(100 * tapply(d$nie_przyszedl, d$gabinet, mean), 1), "\n")

# ---- Odsetki nieprzyjść w grupach (rok 2024 – dane do uczenia modelu) ----
d$lead_kat <- cut(d$lead, c(-1, 1, 3, 7, 14, 28, 60), c("0–1", "2–3", "4–7", "8–14", "15–28", "29–60"))
d24 <- d[d$rok == 2024, ]
grupy <- list("wyprzedzenie (dni)" = d24$lead_kat, "pora wizyty" = d24$pora, "dzień tygodnia" = d24$dzien,
              "wizyta" = factor(ifelse(d24$pierwsza == 1, "pierwsza", "kolejna"), c("pierwsza", "kolejna")),
              "wcześniejsze nieprzyjścia" = d24$wczesniej_kat,
              "przypomnienie SMS" = factor(ifelse(d24$sms == 1, "tak", "nie"), c("nie", "tak")))
tab1 <- do.call(rbind, lapply(names(grupy), function(nm) {
  r <- t(sapply(split(d24$nie_przyszedl, grupy[[nm]]), odsetek))
  data.frame(cecha = nm, poziom = rownames(r), r, row.names = NULL) }))
tab1$cecha <- factor(tab1$cecha, names(grupy))
print(transform(tab1, proc = round(proc, 1), dol = round(dol, 1), gora = round(gora, 1)), row.names = FALSE)
sr24 <- 100 * mean(d24$nie_przyszedl)
p1 <- ggplot(tab1, aes(proc, factor(poziom, rev(unique(poziom))))) +
  geom_vline(xintercept = sr24, linetype = 2, colour = kol[["szary"]]) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.25, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 2.4, colour = kol[["pomaranczowy"]]) +
  geom_text(aes(x = gora, label = sprintf("%.1f%%", proc)), hjust = -0.2, size = 3.3, colour = "grey25") +
  facet_wrap(~cecha, ncol = 2, scales = "free_y") +
  scale_x_continuous(limits = c(0, 68), breaks = seq(0, 60, 10), labels = function(x) paste0(x, "%")) +
  labs(title = "Odsetek nieprzyjść w grupach wizyt (rok 2024)",
       subtitle = sprintf("punkt: odsetek; linia: 95%% CI Wilsona; przerywana: średnia %.1f%%", sr24),
       x = "odsetek wizyt, na które pacjent nie przyszedł", y = NULL) + motyw
p1                       # do pliku: ggsave("no-show-odsetki-grupy.svg", p1, width = 10, height = 7.6)
Wynik w R
Wizyty: 30064 | pacjenci: 6817 | terminy w blokach: 33472 | zajęte: 89.8 %
Pierwsze wizyty: 22.7 % | SMS: 72 % | mediana wyprzedzenia: 7 dni (pierwsze: 7 | kolejne: 7 )
Nieprzyjścia ogółem (%, 95% CI Wilsona):
       n        k     proc      dol     gora
30064.00  3543.00    11.78    11.43    12.15
Według roku:
         n    k  proc   dol  gora
2024 15070 1791 11.88 11.38 12.41
2025 14994 1752 11.68 11.18 12.21
Odwołane w ostatniej dobie wśród nieprzyjść: 35 %
Według gabinetu (%): 10.1 12.2 11.9 12.4 12.7 10.3 12 12.7
                     cecha   poziom     n    k proc  dol gora
        wyprzedzenie (dni)      0–1   366   58 15.8 12.5 19.9
        wyprzedzenie (dni)      2–3  2672  252  9.4  8.4 10.6
        wyprzedzenie (dni)      4–7  6104  677 11.1 10.3 11.9
        wyprzedzenie (dni)     8–14  4217  520 12.3 11.4 13.4
        wyprzedzenie (dni)    15–28  1612  261 16.2 14.5 18.1
        wyprzedzenie (dni)    29–60    99   23 23.2 16.0 32.5
               pora wizyty     8–10  3733  498 13.3 12.3 14.5
               pora wizyty    10–12  3777  411 10.9  9.9 11.9
               pora wizyty    15–17  3772  418 11.1 10.1 12.1
               pora wizyty    17–19  3788  464 12.2 11.2 13.3
            dzień tygodnia       pn  3001  329 11.0  9.9 12.1
            dzień tygodnia       wt  3048  322 10.6  9.5 11.7
            dzień tygodnia       śr  3002  343 11.4 10.3 12.6
            dzień tygodnia      czw  2997  360 12.0 10.9 13.2
            dzień tygodnia       pt  3022  437 14.5 13.3 15.8
                    wizyta pierwsza  3500  581 16.6 15.4 17.9
                    wizyta  kolejna 11570 1210 10.5  9.9 11.0
 wcześniejsze nieprzyjścia        0 12772 1330 10.4  9.9 11.0
 wcześniejsze nieprzyjścia        1  1901  329 17.3 15.7 19.1
 wcześniejsze nieprzyjścia        2   317   97 30.6 25.8 35.9
 wcześniejsze nieprzyjścia       3+    80   35 43.8 33.4 54.7
         przypomnienie SMS      nie  4217  666 15.8 14.7 16.9
         przypomnienie SMS      tak 10853 1125 10.4  9.8 11.0
2. Model logistyczny: Rysunek 2
R
# Rysunek 2. Model logistyczny ryzyka nieprzyjścia uczony na 2024 r.: ilorazy szans z 95% CI
# (korzysta z d, kol i motyw z przepisu 1; bez losowania)
library(ggplot2)

ucz <- d[d$rok == 2024, ]; test <- d[d$rok == 2025, ]
# tylko informacje znane 2 dni przed wizytą, gdy recepcja decyduje o dopisaniu pacjenta
wzor <- nie_przyszedl ~ log2(lead + 1) + pora + dzien + pierwsza + wczesniej_kat + sms
m <- glm(wzor, family = binomial, data = ucz)
print(round(summary(m)$coefficients, 3))
ci <- exp(confint.default(m))
or <- data.frame(zmienna = names(coef(m)), OR = exp(coef(m)), dol = ci[, 1], gora = ci[, 2])[-1, ]
or$etykieta <- c("wyprzedzenie: 2 razy dłuższe", "pora 10–12 (vs 8–10)", "pora 15–17 (vs 8–10)",
                 "pora 17–19 (vs 8–10)", "wtorek (vs pn)", "środa (vs pn)", "czwartek (vs pn)", "piątek (vs pn)",
                 "pierwsza wizyta (vs kolejna)", "1 wcześniejsze nieprzyjście (vs 0)", "2 wcześniejsze (vs 0)",
                 "3+ wcześniejsze (vs 0)", "przypomnienie SMS (vs brak)")
or$grupa <- ifelse(grepl("wcze|pierwsza|SMS", or$etykieta), "pacjent i rezerwacja", "termin")
or$grupa[1] <- "pacjent i rezerwacja"
print(transform(or[c("etykieta", "OR", "dol", "gora")], OR = round(OR, 2), dol = round(dol, 2), gora = round(gora, 2)),
      row.names = FALSE)
cat("Wizyty do uczenia (2024):", nrow(ucz), "| nieprzyjścia:", sum(ucz$nie_przyszedl),
    "| zdarzeń na parametr:", round(sum(ucz$nie_przyszedl) / (length(coef(m)) - 1), 1), "\n")
# Przykład: ta sama wizyta (kolejna, wt 10–12, bez wcześniejszych nieprzyjść) – SMS i wyprzedzenie
nowe <- data.frame(lead = c(7, 7, 28), pora = factor("10–12", levels(d$pora)), dzien = factor("wt", levels(d$dzien)),
                   pierwsza = 0, wczesniej_kat = factor("0", levels(d$wczesniej_kat)), sms = c(1, 0, 1))
cat("Przewidywane ryzyko (%): 7 dni + SMS:", round(100 * predict(m, nowe, type = "response")[1], 1),
    "| 7 dni bez SMS:", round(100 * predict(m, nowe, type = "response")[2], 1),
    "| 28 dni + SMS:", round(100 * predict(m, nowe, type = "response")[3], 1), "\n")
or$etykieta <- factor(or$etykieta, rev(or$etykieta))
p2 <- ggplot(or, aes(OR, etykieta, colour = grupa, shape = grupa)) +
  geom_vline(xintercept = 1, linetype = 2, colour = kol[["szary"]]) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.25, orientation = "y") +
  geom_point(size = 2.6) +
  geom_text(aes(x = gora, label = sprintf("%.2f", OR)), hjust = -0.25, size = 3.3, colour = "grey25", show.legend = FALSE) +
  scale_x_log10(breaks = c(0.5, 1, 2, 4, 8), labels = c("0.5", "1", "2", "4", "8"), limits = c(0.45, 18)) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(16, 15), name = NULL) +
  labs(title = "Co zwiększa ryzyko nieprzyjścia? Ilorazy szans",
       subtitle = "uczenie: 15 070 wizyt z 2024 r.; linie: 95% CI; oś w skali logarytmicznej",
       x = "iloraz szans nieprzyjścia (OR)", y = NULL) + motyw + theme(plot.title.position = "plot")
p2                       # do pliku: ggsave("no-show-ilorazy-szans.svg", p2, width = 10, height = 6.4)
Wynik w R
                Estimate Std. Error z value Pr(>|z|)
(Intercept)       -2.719      0.121 -22.484    0.000
log2(lead + 1)     0.228      0.030   7.608    0.000
pora10–12         -0.264      0.073  -3.632    0.000
pora15–17         -0.229      0.072  -3.165    0.002
pora17–19         -0.108      0.071  -1.520    0.129
dzienwt           -0.055      0.085  -0.646    0.518
dzienśr            0.034      0.083   0.413    0.679
dzienczw           0.100      0.083   1.211    0.226
dzienpt            0.312      0.080   3.910    0.000
pierwsza           0.780      0.060  12.963    0.000
wczesniej_kat1     0.838      0.072  11.616    0.000
wczesniej_kat2     1.577      0.129  12.217    0.000
wczesniej_kat3+    2.147      0.232   9.259    0.000
sms               -0.435      0.054  -8.005    0.000
                           etykieta   OR  dol  gora
       wyprzedzenie: 2 razy dłuższe 1.26 1.18  1.33
               pora 10–12 (vs 8–10) 0.77 0.67  0.89
               pora 15–17 (vs 8–10) 0.80 0.69  0.92
               pora 17–19 (vs 8–10) 0.90 0.78  1.03
                     wtorek (vs pn) 0.95 0.80  1.12
                      środa (vs pn) 1.04 0.88  1.22
                   czwartek (vs pn) 1.11 0.94  1.30
                     piątek (vs pn) 1.37 1.17  1.60
       pierwsza wizyta (vs kolejna) 2.18 1.94  2.45
 1 wcześniejsze nieprzyjście (vs 0) 2.31 2.01  2.66
              2 wcześniejsze (vs 0) 4.84 3.76  6.24
             3+ wcześniejsze (vs 0) 8.56 5.43 13.49
        przypomnienie SMS (vs brak) 0.65 0.58  0.72
Wizyty do uczenia (2024): 15070 | nieprzyjścia: 1791 | zdarzeń na parametr: 137.8
Przewidywane ryzyko (%): 7 dni + SMS: 5.8 | 7 dni bez SMS: 8.7 | 28 dni + SMS: 8.6
3. Walidacja w czasie, kalibracja i przeciek: Rysunek 3
R
# Rysunek 3. Walidacja w czasie (2025 r.): kalibracja i AUC modelu uczciwego i modelu z przeciekiem
# (korzysta z d, ucz, test, wzor, m, kol i motyw z przepisów 1–2; bez losowania)
library(ggplot2)
library(pROC)

test$p <- predict(m, test, type = "response")
roc_m <- roc(test$nie_przyszedl, test$p, quiet = TRUE)
cat("Model uczciwy, 2025: AUC =", round(auc(roc_m), 3), "95% CI", round(ci.auc(roc_m)[c(1, 3)], 3), "\n")
# kalibracja: wyraz wolny (przy nachyleniu 1, czyli z offsetem) i nachylenie
kalibracja <- function(y, p) {
  lp <- qlogis(p)
  c(sr_przewidywane = 100 * mean(p), sr_obserwowane = 100 * mean(y),
    wyraz_wolny = unname(coef(glm(y ~ offset(lp), family = binomial))[1]),
    nachylenie = unname(coef(glm(y ~ lp, family = binomial))[2]), Brier = mean((y - p)^2))
}
print(round(kalibracja(test$nie_przyszedl, test$p), 3))
cat("Dla porównania: AUC prawdziwego prawdopodobieństwa (zna ukrytą skłonność pacjenta):",
    round(auc(roc(test$nie_przyszedl, test$p_prawdy, quiet = TRUE)), 3), "\n")
# Model z przeciekiem: dodana kolumna „odwołał dzień wcześniej” (wpisywana PO decyzji o grafiku)
m_prz <- glm(update(wzor, . ~ . + odwolal_dzien_wczesniej), family = binomial, data = ucz)
test$p_raport <- predict(m_prz, test, type = "response")                      # ocena na eksporcie z systemu
test$p_decyzja <- predict(m_prz, transform(test, odwolal_dzien_wczesniej = 0), type = "response")  # 2 dni przed
roc_r <- roc(test$nie_przyszedl, test$p_raport, quiet = TRUE)
roc_d <- roc(test$nie_przyszedl, test$p_decyzja, quiet = TRUE)
cat("Model z przeciekiem – AUC w raporcie:", round(auc(roc_r), 3), "| AUC w chwili decyzji:", round(auc(roc_d), 3), "\n")
cat("Współczynnik przy 'odwołał dzień wcześniej':", round(coef(m_prz)["odwolal_dzien_wczesniej"], 2),
    "(w danych każda taka wizyta jest nieprzyjściem)\n")
print(round(kalibracja(test$nie_przyszedl, test$p_decyzja), 3))
# Krzywa kalibracji: 10 grup według przewidywanego ryzyka, odsetek obserwowany z 95% CI Wilsona
grupy_kal <- function(p, y, nazwa) {
  g <- cut(rank(p, ties.method = "first"), 10, labels = FALSE)
  do.call(rbind, lapply(1:10, function(k) {
    pt <- prop.test(sum(y[g == k]), sum(g == k), correct = FALSE)
    data.frame(model = nazwa, grupa = k, przew = 100 * mean(p[g == k]), obs = 100 * mean(y[g == k]),
               dol = 100 * pt$conf.int[1], gora = 100 * pt$conf.int[2]) }))
}
kal <- rbind(grupy_kal(test$p, test$nie_przyszedl, "A. Model uczciwy (dane znane 2 dni przed wizytą)"),
             grupy_kal(test$p_decyzja, test$nie_przyszedl, "B. Model z przeciekiem użyty 2 dni przed wizytą"))
print(transform(kal[c("model", "grupa", "przew", "obs")], przew = round(przew, 1), obs = round(obs, 1)), row.names = FALSE)
etyk <- data.frame(model = unique(kal$model), x = 1, y = 37,
                   tekst = c(sprintf("AUC = %s\nśrednio: przewidziane %.1f%%, obserwowane %.1f%%",
                                     sub("^0", "", sprintf("%.3f", auc(roc_m))), 100 * mean(test$p), 100 * mean(test$nie_przyszedl)),
                             sprintf("AUC w raporcie = %s, w chwili decyzji = %s\nśrednio: przewidziane %.1f%%, obserwowane %.1f%%",
                                     sub("^0", "", sprintf("%.3f", auc(roc_r))), sub("^0", "", sprintf("%.3f", auc(roc_d))),
                                     100 * mean(test$p_decyzja), 100 * mean(test$nie_przyszedl))))
p3 <- ggplot(kal, aes(przew, obs)) +
  geom_abline(slope = 1, intercept = 0, linetype = 2, colour = kol[["szary"]]) +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0, colour = kol[["niebieski"]]) +
  geom_line(colour = kol[["niebieski"]]) +
  geom_point(size = 2.4, colour = kol[["pomaranczowy"]]) +
  geom_text(data = etyk, aes(x, y, label = tekst), hjust = 0, vjust = 1, size = 3.4, lineheight = 0.95, colour = "grey20") +
  facet_wrap(~model, ncol = 2) + coord_equal(xlim = c(0, 40), ylim = c(0, 40)) +
  labs(title = "Kalibracja w 2025 r.: przewidziane ryzyko a odsetek nieprzyjść",
       subtitle = "10 grup po ok. 1500 wizyt; linia przerywana – idealna zgodność; pionowe linie – 95% CI",
       x = "przewidziane ryzyko nieprzyjścia (%)", y = "obserwowany odsetek nieprzyjść (%)") + motyw
p3                       # do pliku: ggsave("no-show-kalibracja.svg", p3, width = 10, height = 6)
Wynik w R
Model uczciwy, 2025: AUC = 0.657 95% CI 0.643 0.671
sr_przewidywane  sr_obserwowane     wyraz_wolny      nachylenie           Brier
         11.901          11.685          -0.022           0.981           0.099
Dla porównania: AUC prawdziwego prawdopodobieństwa (zna ukrytą skłonność pacjenta): 0.752
Model z przeciekiem – AUC w raporcie: 0.783 | AUC w chwili decyzji: 0.656
Współczynnik przy 'odwołał dzień wcześniej': 19.93 (w danych każda taka wizyta jest nieprzyjściem)
sr_przewidywane  sr_obserwowane     wyraz_wolny      nachylenie           Brier
          8.302          11.685           0.393           0.986           0.100
                                            model grupa przew  obs
 A. Model uczciwy (dane znane 2 dni przed wizytą)     1   5.4  5.2
 A. Model uczciwy (dane znane 2 dni przed wizytą)     2   6.3  6.1
 A. Model uczciwy (dane znane 2 dni przed wizytą)     3   7.1  6.6
 A. Model uczciwy (dane znane 2 dni przed wizytą)     4   8.0  7.9
 A. Model uczciwy (dane znane 2 dni przed wizytą)     5   9.1 10.1
 A. Model uczciwy (dane znane 2 dni przed wizytą)     6  10.6 10.6
 A. Model uczciwy (dane znane 2 dni przed wizytą)     7  12.6 13.1
 A. Model uczciwy (dane znane 2 dni przed wizytą)     8  15.0 13.7
 A. Model uczciwy (dane znane 2 dni przed wizytą)     9  18.1 17.2
 A. Model uczciwy (dane znane 2 dni przed wizytą)    10  26.7 26.3
  B. Model z przeciekiem użyty 2 dni przed wizytą     1   3.6  5.2
  B. Model z przeciekiem użyty 2 dni przed wizytą     2   4.3  6.5
  B. Model z przeciekiem użyty 2 dni przed wizytą     3   4.8  6.2
  B. Model z przeciekiem użyty 2 dni przed wizytą     4   5.5  8.7
  B. Model z przeciekiem użyty 2 dni przed wizytą     5   6.2  9.4
  B. Model z przeciekiem użyty 2 dni przed wizytą     6   7.3 10.2
  B. Model z przeciekiem użyty 2 dni przed wizytą     7   8.7 13.4
  B. Model z przeciekiem użyty 2 dni przed wizytą     8  10.5 13.8
  B. Model z przeciekiem użyty 2 dni przed wizytą     9  12.8 17.1
  B. Model z przeciekiem użyty 2 dni przed wizytą    10  19.3 26.2
4. Jeden blok i rozkład Poissona-dwumianowy: Rysunki 4 i 5
R
# Rysunki 4 i 5. Jeden blok 8 wizyt: kto przyjdzie? Rozkład liczby przyjść jako suma Bernoullich z różnymi p
# (korzysta z d, test, m, kol i motyw z przepisów 1–3)
library(ggplot2)

# rozkład Poissona-dwumianowy dokładnie: P(A = 0, 1, …, n), gdy osoba i przychodzi z prawdopodobieństwem q[i]
rozklad_pb <- function(q) { r <- 1; for (x in q) r <- c(r * (1 - x), 0) + c(0, r * x); r }
# pacjent dopisany z listy oczekujących: kolejna wizyta, termin za 2 dni, bez wcześniejszych nieprzyjść, z SMS
p_dopisany <- function(pora, dzien) predict(m, data.frame(lead = 2, pora = factor(pora, levels(d$pora)),
  dzien = factor(dzien, levels(d$dzien)), pierwsza = 0, wczesniej_kat = factor("0", levels(d$wczesniej_kat)), sms = 1),
  type = "response")

# Bloki 2025 r. z kompletem 8 zarezerwowanych wizyt
test$blok <- paste(test$gabinet, test$t)
pelne <- names(which(table(test$blok) == 8))
bl <- test[test$blok %in% pelne, ]
suma_ryzyka <- tapply(bl$p, bl$blok, sum)
cat("Pełne bloki w 2025 r.:", length(pelne), "z", length(unique(test$blok)),
    "| oczekiwana liczba nieprzyjść w bloku: mediana", round(median(suma_ryzyka), 2),
    "| 10. i 90. centyl:", round(quantile(suma_ryzyka, c(.1, .9)), 2), "\n")
# Przykładowy blok: ten, którego suma ryzyka jest najbliżej 90. centyla
przyklad <- names(which.min(abs(suma_ryzyka - quantile(suma_ryzyka, .9))))
b <- bl[bl$blok == przyklad, ]; b <- b[order(b$termin), ]
pd <- p_dopisany(as.character(b$pora[8]), as.character(b$dzien[1]))
cat("Przykładowy blok: gabinet", b$gabinet[1], "|", format(b$data[1], "%Y-%m-%d"), as.character(b$dzien[1]),
    "| ryzyko pacjenta dopisanego:", round(100 * pd, 1), "%\n")
print(data.frame(godzina = sprintf("%d:%02d", (8 + 7 * (b$pora[1] %in% c("15–17", "17–19"))) + (b$termin - 1) %/% 2,
                                   30 * ((b$termin - 1) %% 2)),
                 wizyta = ifelse(b$pierwsza == 1, "pierwsza", "kolejna"), lead = b$lead, wczesniej = b$wczesniej,
                 sms = b$sms, ryzyko_proc = round(100 * b$p, 1), przyszedl = 1 - b$nie_przyszedl), row.names = FALSE)
q <- 1 - b$p
koszt_pusty <- 150; koszt_nadmiar <- 220   # zł: utracony przychód z wizyty; nadgodzina + czekający pacjent
wyniki_k <- t(sapply(0:3, function(k) {
  r <- rozklad_pb(c(q, rep(1 - pd, k))); A <- seq_along(r) - 1
  c(dopisani = k, oczek_przyjscia = sum(A * r), P_komplet_8 = sum(r[A == 8]), P_puste = sum(r[A < 8]),
    P_nadmiar = sum(r[A > 8]), oczek_puste = sum(pmax(0, 8 - A) * r), oczek_nadmiar = sum(pmax(0, A - 8) * r),
    oczek_koszt = sum((koszt_pusty * pmax(0, 8 - A) + koszt_nadmiar * pmax(0, A - 8)) * r)) }))
print(round(wyniki_k, 3))
# Sprawdzenie symulacją: 10 000 powtórzeń tego bloku (bez dopisanych)
set.seed(7514)
sym <- colSums(matrix(rbinom(8 * 10000, 1, q), 8))
r0 <- rozklad_pb(q)
cat("Symulacja 10 000 bloków vs wzór – P(A = 8):", mean(sym == 8), "vs", round(r0[9], 4),
    "| P(A = 7):", mean(sym == 7), "vs", round(r0[8], 4), "| średnia:", mean(sym), "vs", round(sum(q), 3), "\n")
cat("Rozkład dwumianowy ze średnim p – P(A = 8):", round(dbinom(8, 8, mean(q)), 4),
    "| wariancja: Poisson-dwumianowy", round(sum(q * (1 - q)), 3), "vs dwumianowy", round(8 * mean(q) * (1 - mean(q)), 3), "\n")

# Rysunek 5: rozkład liczby przyjść przy 0, 1 i 2 dopisanych pacjentach
roz <- do.call(rbind, lapply(0:2, function(k) {
  r <- rozklad_pb(c(q, rep(1 - pd, k))); A <- seq_along(r) - 1
  data.frame(k = sprintf("%d dopisan%s: %d osób umówionych", k, c("ych", "y", "ych")[k + 1], 8 + k), A = A, P = r,
             dwum = dbinom(A, 8 + k, mean(c(q, rep(1 - pd, k)))),
             stan = factor(ifelse(A < 8, "puste terminy", ifelse(A == 8, "komplet", "ktoś czeka (ponad 8)")),
                           c("puste terminy", "komplet", "ktoś czeka (ponad 8)"))) }))
roz <- roz[roz$A >= 4, ]
p5 <- ggplot(roz, aes(A, 100 * P)) +
  geom_col(aes(fill = stan), width = 0.75) +
  geom_point(aes(y = 100 * dwum, shape = "rozkład dwumianowy ze średnim p"), size = 2, colour = kol[["granat"]]) +
  geom_text(data = roz[roz$P >= 0.005, ], aes(y = 100 * pmax(P, dwum) + 1.2, label = sprintf("%.0f%%", 100 * P)),
            vjust = 0, size = 3.2, colour = "grey25") +
  facet_wrap(~k, ncol = 3) +
  scale_fill_manual(values = c(kol[["pomaranczowy"]], kol[["zielony"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = 4, name = NULL) +
  scale_x_continuous(breaks = 4:10) + scale_y_continuous(limits = c(0, 50)) +
  labs(title = sprintf("Ilu pacjentów przyjdzie? Blok z %s (8 terminów)", format(b$data[1], "%d.%m.%Y")),
       subtitle = "słupki: rozkład Poissona-dwumianowy z ryzyk z modelu; krzyżyki: przybliżenie dwumianowe",
       x = "liczba pacjentów, którzy przyjdą", y = "prawdopodobieństwo (%)") +
  guides(fill = guide_legend(order = 1)) + motyw
p5                       # do pliku: ggsave("no-show-rozklad-przyjsc.svg", p5, width = 10, height = 5.4)

# Rysunek 4 (grafika): karta „blok wizyt – kto przyjdzie”
karty <- data.frame(x = c(rep(1:4, 2), 5.35), y = c(rep(2, 4), rep(1, 4), 1.5),
                    godz = c(sprintf("%d:%02d", 8 + 7 * (b$pora[1] %in% c("15–17", "17–19")) + (0:7) %/% 2, 30 * ((0:7) %% 2)), "+ dopisany"),
                    opis = c(paste0(ifelse(b$pierwsza == 1, "pierwsza", "kolejna"), " · ", b$lead, " dni\n",
                                    ifelse(b$sms == 1, "SMS", "bez SMS"), " · wcześniej: ", b$wczesniej),
                             "z listy oczekujących\n2 dni · SMS"),
                    ryzyko = c(b$p, pd))
karty$typ <- ifelse(karty$godz == "+ dopisany", "dopisany", ifelse(karty$ryzyko >= 0.2, "wysokie", "zwykłe"))
w0 <- wyniki_k[1, ]; w1 <- wyniki_k[2, ]
podsum <- sprintf(paste0("Bez dopisywania: przyjdzie średnio %.1f z 8 osób; P(komplet) = %.0f%%, P(co najmniej 1 puste) = %.0f%%\n",
                         "Z 1 dopisanym: P(puste) = %.0f%%, P(ktoś czeka) = %.0f%%\n",
                         "Oczekiwany koszt bloku: %.0f zł → %.0f zł (puste miejsce %d zł, osoba ponad 8: %d zł)"),
                  w0[["oczek_przyjscia"]], 100 * w0[["P_komplet_8"]], 100 * w0[["P_puste"]],
                  100 * w1[["P_puste"]], 100 * w1[["P_nadmiar"]], w0[["oczek_koszt"]], w1[["oczek_koszt"]],
                  koszt_pusty, koszt_nadmiar)
p4 <- ggplot(karty) +
  geom_rect(aes(xmin = x - 0.46, xmax = x + 0.46, ymin = y - 0.42, ymax = y + 0.42, fill = typ, linetype = typ),
            colour = kol[["granat"]], linewidth = 0.5) +
  geom_rect(aes(xmin = x - 0.4, xmax = x - 0.4 + 0.8 * pmin(ryzyko / 0.4, 1), ymin = y - 0.36, ymax = y - 0.28),
            fill = kol[["pomaranczowy"]]) +
  geom_text(aes(x - 0.4, y + 0.3, label = godz), hjust = 0, fontface = "bold", size = 4, colour = kol[["granat"]]) +
  geom_text(aes(x - 0.4, y + 0.03, label = opis), hjust = 0, size = 3.1, lineheight = 0.95, colour = "grey20") +
  geom_text(aes(x - 0.4, y - 0.19, label = sprintf("ryzyko nieprzyjścia %.0f%%", 100 * ryzyko)), hjust = 0, size = 3.2,
            colour = "grey10") +
  annotate("label", x = 0.54, y = 0.22, label = podsum, hjust = 0, vjust = 0.5, size = 3.7, lineheight = 1.05,
           linewidth = 0.4, fill = "#f4f6fa", colour = kol[["granat"]]) +
  scale_fill_manual(values = c(dopisany = "#e8f1f8", wysokie = "#fbe9df", "zwykłe" = "white"), guide = "none") +
  scale_linetype_manual(values = c(dopisany = 2, wysokie = 1, "zwykłe" = 1), guide = "none") +
  coord_cartesian(xlim = c(0.5, 5.85), ylim = c(-0.15, 2.45), expand = FALSE) +
  labs(title = sprintf("Blok wizyt – kto przyjdzie? Gabinet %d, %s", b$gabinet[1], format(b$data[1], "%d.%m.%Y")),
       subtitle = "ryzyko z modelu logistycznego 2 dni przed wizytą; pasek = ryzyko (pełny przy 40%)", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p4                       # do pliku: ggsave("no-show-blok-karta.svg", p4, width = 10, height = 5.6)
Wynik w R
Pełne bloki w 2025 r.: 881 z 2088 | oczekiwana liczba nieprzyjść w bloku: mediana 0.93 | 10. i 90. centyl: 0.69 1.26
Przykładowy blok: gabinet 8 | 2025-03-24 pn | ryzyko pacjenta dopisanego: 4.5 %
 godzina   wizyta lead wczesniej sms ryzyko_proc przyszedl
    8:00  kolejna   14         1   0        27.1         1
    8:30  kolejna    3         0   1         6.3         0
    9:00  kolejna    7         3   1        42.0         1
    9:30  kolejna    2         0   1         5.8         1
   10:00  kolejna    7         0   1         6.1         0
   10:30 pierwsza    9         0   1        13.2         1
   11:00  kolejna    7         1   1        13.0         1
   11:30 pierwsza    7         0   1        12.4         1
     dopisani oczek_przyjscia P_komplet_8 P_puste P_nadmiar oczek_puste
[1,]        0           6.741       0.232   0.768     0.000       1.259
[2,]        1           7.696       0.394   0.385     0.221       0.525
[3,]        2           8.651       0.274   0.128     0.598       0.158
[4,]        3           9.606       0.110   0.031     0.859       0.036
     oczek_nadmiar oczek_koszt
[1,]         0.000     188.879
[2,]         0.221     127.526
[3,]         0.809     201.726
[4,]         1.642     366.527
Symulacja 10 000 bloków vs wzór – P(A = 8): 0.2289 vs 0.2318 | P(A = 7): 0.4039 vs 0.4016 | średnia: 6.7341 vs 6.741
Rozkład dwumianowy ze średnim p – P(A = 8): 0.2541 | wariancja: Poisson-dwumianowy 0.949 vs dwumianowy 1.061
5. Reguła dopisywania i jej wynik w 2025 r.: Rysunek 6
R
# Rysunek 6. Ile wizyt dopisać? Oczekiwany koszt bloku i wynik reguł w 2025 r.
# (korzysta z d, bl, b, pd, rozklad_pb, p_dopisany, logit_prawdy, efekt_gab, koszt_pusty, koszt_nadmiar,
#  wyniki_k, kol i motyw z przepisów 1–4)
library(ggplot2)
library(patchwork)

koszt_oczek <- function(p, p_dop, k, kp = koszt_pusty, kn = koszt_nadmiar) {
  r <- rozklad_pb(c(1 - p, rep(1 - p_dop, k))); A <- seq_along(r) - 1
  sum((kp * pmax(0, 8 - A) + kn * pmax(0, A - 8)) * r)
}
bloki <- split(bl, bl$blok)
info <- data.frame(blok = names(bloki), suma = sapply(bloki, function(x) sum(x$p)),
                   suma_prz = sapply(bloki, function(x) sum(x$p_decyzja)),
                   pd = sapply(bloki, function(x) p_dopisany(as.character(x$pora[8]), as.character(x$dzien[1]))))
# reguła: dopisz k ∈ {0, 1, 2, 3}, które daje najmniejszy oczekiwany koszt
info$k_model <- sapply(seq_along(bloki), function(j)
  which.min(sapply(0:3, function(k) koszt_oczek(bloki[[j]]$p, info$pd[j], k))) - 1)
info$k_przeciek <- sapply(seq_along(bloki), function(j)
  which.min(sapply(0:3, function(k) koszt_oczek(bloki[[j]]$p_decyzja, info$pd[j], k))) - 1)
cat("Reguła z modelu – liczba dopisanych (bloki):"); print(table(info$k_model))
cat("Reguła z modelu z przeciekiem:"); print(table(info$k_przeciek))
# wrażliwość na koszt nadmiaru
for (kn in c(150, 220, 400)) cat("Koszt nadmiaru", kn, "zł – bloki z co najmniej 1 dopisanym:",
  round(100 * mean(sapply(seq_along(bloki), function(j)
    which.min(sapply(0:3, function(k) koszt_oczek(bloki[[j]]$p, info$pd[j], k, kn = kn))) > 1)), 1), "%\n")

# Rozliczenie na prawdziwych wynikach 2025 r.: umówieni – czy przyszli (dane); dopisani – losowani z prawdziwego modelu
set.seed(7515)
dop_przyjdzie <- t(sapply(seq_along(bloki), function(j) {
  x <- bloki[[j]][1, ]
  u <- rnorm(3, 0, 0.75); sms <- rbinom(3, 1, 0.72)
  p <- plogis(logit_prawdy(2, rep(as.integer(bloki[[j]]$pora[8]), 3), as.integer(x$dzien), 0, 0, sms, u,
                           efekt_gab[x$gabinet], x$miesiac))
  rbinom(3, 1, 1 - p) }))
rozlicz <- function(k) {
  A <- sapply(seq_along(bloki), function(j) sum(1 - bloki[[j]]$nie_przyszedl) + sum(dop_przyjdzie[j, seq_len(k[j])]))
  data.frame(puste = pmax(0, 8 - A), nadmiar = pmax(0, A - 8),
             koszt = koszt_pusty * pmax(0, 8 - A) + koszt_nadmiar * pmax(0, A - 8))
}
reguly <- list("bez dopisywania" = rep(0, length(bloki)), "zawsze 1 dopisany" = rep(1, length(bloki)),
               "model z przeciekiem" = info$k_przeciek, "model uczciwy" = info$k_model)
wyn <- do.call(rbind, lapply(names(reguly), function(nm) {
  r <- rozlicz(reguly[[nm]]); tt <- t.test(r$koszt)
  data.frame(regula = nm, dopisani = sum(reguly[[nm]]), puste = sum(r$puste), nadmiar = sum(r$nadmiar),
             bloki_z_nadmiarem = sum(r$nadmiar > 0), koszt_sr = mean(r$koszt),
             dol = tt$conf.int[1], gora = tt$conf.int[2], koszt_razem = sum(r$koszt)) }))
cat("Pełne bloki 2025:", length(bloki), "\n")
print(transform(wyn, koszt_sr = round(koszt_sr, 1), dol = round(dol, 1), gora = round(gora, 1)), row.names = FALSE)
# różnica kosztu: model uczciwy − zawsze 1 (te same bloki, para)
rm_ <- rozlicz(info$k_model)$koszt; r1 <- rozlicz(rep(1, length(bloki)))$koszt; r0 <- rozlicz(rep(0, length(bloki)))$koszt
tt <- t.test(rm_ - r0); cat("Model uczciwy − bez dopisywania: średnio", round(mean(rm_ - r0), 1), "zł na blok, 95% CI",
                           round(tt$conf.int, 1), "\n")
tt <- t.test(rm_ - r1); cat("Model uczciwy − zawsze 1: średnio", round(mean(rm_ - r1), 1), "zł na blok, 95% CI",
                           round(tt$conf.int, 1), "\n")

# Panel A: oczekiwany koszt w trzech blokach (10., 50. i 90. centyl sumy ryzyka)
cent <- sapply(c(.1, .5, .9), function(pr) info$blok[which.min(abs(info$suma - quantile(info$suma, pr)))])
krzywe <- do.call(rbind, lapply(seq_along(cent), function(j) {
  x <- bloki[[cent[j]]]; pdj <- info$pd[info$blok == cent[j]]
  data.frame(blok = sprintf("%s: oczekiwane nieprzyjścia %.2f", c("niskie ryzyko", "typowe", "wysokie"), info$suma[info$blok == cent[j]])[j],
             k = 0:3, koszt = sapply(0:3, function(k) koszt_oczek(x$p, pdj, k))) }))
krzywe$blok <- factor(krzywe$blok, unique(krzywe$blok))
print(transform(krzywe, koszt = round(koszt, 1)), row.names = FALSE)
pa <- ggplot(krzywe, aes(k, koszt, colour = blok, shape = blok, linetype = blok)) +
  geom_line() + geom_point(size = 2.6) +
  geom_point(data = do.call(rbind, lapply(split(krzywe, krzywe$blok), function(z) z[which.min(z$koszt), ])),
             shape = 1, size = 5, colour = kol[["granat"]], show.legend = FALSE) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["zielony"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(15, 16, 17), name = NULL) + scale_linetype_manual(values = c(1, 2, 4), name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "A. Oczekiwany koszt bloku", subtitle = "kółko = najtańsze k",
       x = "liczba dopisanych pacjentów", y = "oczekiwany koszt (zł)") + motyw
wyn$regula <- factor(wyn$regula, names(reguly))
pb <- ggplot(wyn, aes(koszt_sr, regula)) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.2, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 2.8, colour = kol[["pomaranczowy"]]) +
  geom_text(aes(x = gora + 2, label = sprintf("%.0f zł\npuste %d · nadmiar %d", koszt_sr, puste, nadmiar)),
            hjust = 0, size = 3.1, lineheight = 0.9, colour = "grey25") +
  scale_x_continuous(limits = c(100, 205)) +
  labs(title = "B. Wynik reguł w 2025 r.", subtitle = sprintf("%d pełnych bloków; średni koszt z 95%% CI", length(bloki)),
       x = "średni koszt na blok (zł)", y = NULL) + motyw
p6 <- pa + pb + plot_layout(widths = c(1, 1.15))
p6                       # do pliku: ggsave("no-show-koszt-dopisania.svg", p6, width = 10, height = 5.6)
Wynik w R
Reguła z modelu – liczba dopisanych (bloki):
  0   1
270 611
Reguła z modelu z przeciekiem:
  0   1
736 145
Koszt nadmiaru 150 zł – bloki z co najmniej 1 dopisanym: 94.3 %
Koszt nadmiaru 220 zł – bloki z co najmniej 1 dopisanym: 69.4 %
Koszt nadmiaru 400 zł – bloki z co najmniej 1 dopisanym: 17.4 %
Pełne bloki 2025: 881
              regula dopisani puste nadmiar bloki_z_nadmiarem koszt_sr   dol
     bez dopisywania        0   841       0                 0    143.2 133.8
   zawsze 1 dopisany      881   331     300               300    131.3 123.8
 model z przeciekiem      145   740      30                30    133.5 124.5
       model uczciwy      611   462     181               181    123.9 115.9
  gora koszt_razem
 152.6      126150
 138.8      115650
 142.5      117600
 131.8      109120
Model uczciwy − bez dopisywania: średnio -19.3 zł na blok, 95% CI -28.5 -10.2
Model uczciwy − zawsze 1: średnio -7.4 zł na blok, 95% CI -14 -0.9
                                        blok k koszt
 niskie ryzyko: oczekiwane nieprzyjścia 0.69 0 104.2
 niskie ryzyko: oczekiwane nieprzyjścia 0.69 1 130.4
 niskie ryzyko: oczekiwane nieprzyjścia 0.69 2 282.7
 niskie ryzyko: oczekiwane nieprzyjścia 0.69 3 480.1
        typowe: oczekiwane nieprzyjścia 0.93 0 140.2
        typowe: oczekiwane nieprzyjścia 0.93 1 126.2
        typowe: oczekiwane nieprzyjścia 0.93 2 244.9
        typowe: oczekiwane nieprzyjścia 0.93 3 428.3
       wysokie: oczekiwane nieprzyjścia 1.26 0 188.9
       wysokie: oczekiwane nieprzyjścia 1.26 1 127.5
       wysokie: oczekiwane nieprzyjścia 1.26 2 201.7
       wysokie: oczekiwane nieprzyjścia 1.26 3 366.5
6. Sprawdzenie palety pod kątem zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "niebieski – zielony" = c("#0072B2", "#009E73"),
             "pomarańczowy – zielony" = c("#D55E00", "#009E73"), "szary – pomarańczowy" = c("#999999", "#D55E00"),
             "szary – niebieski" = c("#999999", "#0072B2"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
szary – pomarańczowy                        77.2         62.9       56.0
szary – niebieski                           44.9         48.9       40.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, regresję logistyczną (glm), przedziały Wilsona (prop.test) i testy t obliczono funkcjami pakietu stats (z podstawowej instalacji R), pole pod krzywą ROC z przedziałem DeLonga – pakietem pROC. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Przeciek – kolumna wypełniana po chwili decyzji (tu „odwołał dzień wcześniej”) zawyża AUC i zaniża ryzyko przy wdrożeniu (rysunek 3).
- Ocena tylko AUC – do decyzji potrzebna jest kalibracja.
- Wiele wizyt tego samego pacjenta – zwykłe przedziały są za wąskie; użyj błędów odpornych na klastrowanie albo wielopoziomowej regresji logistycznej.
- Model ryzyka jako wyrok o pacjencie – w przykładzie nie przyszli pacjenci z ryzykiem 6% (rysunek 4).
- Założenie niezależności przyjść – pogoda i infekcje sezonowe dają zależne nieprzyjścia.
- Koszty „z sufitu” bez analizy wrażliwości (rysunek 6).
- Odsetek nieprzyjść z literatury – średnia rzędu 23% z przeglądu (Dantas i in., 2018) dotyczy wielu specjalności i krajów; licz go na własnych danych.
Najczęstsze pytania
Jak przewidzieć, czy pacjent przyjdzie na wizytę?
Zbuduj regresję logistyczną z cechami znanymi w chwili decyzji: wyprzedzeniem rezerwacji, porą i dniem, rodzajem wizyty, liczbą wcześniejszych nieprzyjść i przypomnieniem SMS. Ucz na starszych danych, sprawdzaj na nowszych. W przykładzie najsilniejszym czynnikiem była historia pacjenta (jedno wcześniejsze nieprzyjście: OR = 2.31), a AUC w kolejnym roku wyniosło .657.
Ile wizyt dopisać ponad grafik, żeby nie było pustych terminów?
Policz rozkład liczby przyjść w bloku jako sumę prób Bernoulliego z ryzykami z modelu (rozkład Poissona-dwumianowy) i wybierz liczbę dopisanych, która minimalizuje oczekiwany koszt pustego terminu i pacjenta ponad pojemność. W przykładzie (150 zł i 220 zł) opłacało się dopisać jedną osobę w 611 z 881 pełnych bloków, a nigdy dwie.
Dlaczego przy no-show ważna jest kalibracja, a nie tylko AUC?
Bo do decyzji o dopisaniu potrzebne są trafne prawdopodobieństwa, a nie tylko dobra kolejność. W przykładzie model z przeciekiem miał w chwili decyzji takie samo AUC jak model uczciwy (.656 wobec .657), ale przewidywał 8.3% nieprzyjść zamiast 11.7% i przez to dopisywał za mało.
Jaki jest średni odsetek nieprzyjść na wizyty?
Przegląd 105 badań podaje średnią rzędu 23%, z dużymi różnicami między krajami i specjalnościami (Dantas i in., 2018). Własny odsetek licz z przedziałem ufności; w fikcyjnej sieci gabinetów fizjoterapii było to 11.78%, 95% CI [11.43, 12.15].
Czy można nie umawiać pacjentów z wysokim ryzykiem nieprzyjścia?
Lepiej nie. Model służy do planowania bloku: ile osób zapewne przyjdzie i czy dopisać kogoś z listy oczekujących. Kierowanie pacjentów z wysokim ryzykiem na gorsze terminy utrwala nierówności w dostępie do opieki (Shanklin i in., 2022), a pojedynczy wynik i tak jest niepewny – w przykładzie nie przyszli pacjenci z ryzykiem 6%.
Powiązane hasła
Przeczytaj też
Przeciek danych i walidacja w czasie
Sieć siłowni i rezygnacje z karnetu: zmienne z przyszłości, losowy podział, wybór zmiennych na szumie i okno przesuwane – pięć rysunków z kodem R.
Czytaj →PoradnikOverbooking – ile rezerwacji ponad pojemność
Pensjonat z 24 pokojami: rozkład dwumianowy przyjazdów, koszt odmowy i pustego pokoju, optymalne N, bootstrap i grupy – z kodem R.
Czytaj →PoradnikObsada infolinii – Erlang C i symulacja
Infolinia dostawcy energii: test Poissona, czas rozmowy, Erlang C ręcznie, symulacja kolejki z rozłączeniami i grafik w kwadransach – sześć rysunków z kodem R.
Czytaj →Piszesz pracę o rezerwacjach albo planujesz grafik w placówce?
Pomożemy zbudować model ryzyka nieprzyjścia, sprawdzić jego kalibrację w czasie, policzyć regułę dopisywania z kosztami i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Dantas, L. F., Fleck, J. L., Cyrino Oliveira, F. L., & Hamacher, S. (2018). No-shows in appointment scheduling – a systematic literature review. Health Policy, 122(4), 412–421. https://doi.org/10.1016/j.healthpol.2018.02.002
- Gurol-Urganci, I., de Jongh, T., Vodopivec-Jamsek, V., Atun, R., & Car, J. (2013). Mobile phone messaging reminders for attendance at healthcare appointments. Cochrane Database of Systematic Reviews, 2013(12), Article CD007458. https://doi.org/10.1002/14651858.cd007458.pub3 ● Otwarty dostęp
- Kaufman, S., Rosset, S., Perlich, C., & Stitelman, O. (2012). Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 1–21. https://doi.org/10.1145/2382577.2382579
- LaGanga, L. R., & Lawrence, S. R. (2007). Clinic overbooking to improve patient access and increase provider productivity. Decision Sciences, 38(2), 251–276. https://doi.org/10.1111/j.1540-5915.2007.00158.x
- Shanklin, R., Samorani, M., Harris, S., & Santoro, M. A. (2022). Ethical redress of racial inequities in AI: Lessons from decoupling machine learning from optimization in medical appointment scheduling. Philosophy & Technology, 35(4), Article 96. https://doi.org/10.1007/s13347-022-00590-8 ● Otwarty dostęp
- Steyerberg, E. W., & Vergouwe, Y. (2014). Towards better clinical prediction models: Seven steps for development and an ABCD for validation. European Heart Journal, 35(29), 1925–1931. https://doi.org/10.1093/eurheartj/ehu207 ● Otwarty dostęp: pełny tekst
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{dantas2018noshows, author={Dantas, Leila F. and Fleck, Julia L. and Cyrino Oliveira, Fernando L. and Hamacher, Silvio}, title={{No-shows in appointment scheduling – a systematic literature review}}, journal={Health Policy}, year={2018}, volume={122}, number={4}, pages={412--421}, doi={10.1016/j.healthpol.2018.02.002}}@article{gurolurganci2013mobile, author={Gurol-Urganci, Ipek and de Jongh, Thyra and Vodopivec-Jamsek, Vlasta and Atun, Rifat and Car, Josip}, title={{Mobile phone messaging reminders for attendance at healthcare appointments}}, journal={Cochrane Database of Systematic Reviews}, year={2013}, volume={2013}, number={12}, eid={CD007458}, doi={10.1002/14651858.cd007458.pub3}}@article{kaufman2012leakage, author={Kaufman, Shachar and Rosset, Saharon and Perlich, Claudia and Stitelman, Ori}, title={{Leakage in data mining: Formulation, detection, and avoidance}}, journal={ACM Transactions on Knowledge Discovery from Data}, year={2012}, volume={6}, number={4}, pages={1--21}, doi={10.1145/2382577.2382579}}@article{laganga2007clinic, author={LaGanga, Linda R. and Lawrence, Stephen R.}, title={{Clinic overbooking to improve patient access and increase provider productivity}}, journal={Decision Sciences}, year={2007}, volume={38}, number={2}, pages={251--276}, doi={10.1111/j.1540-5915.2007.00158.x}}@article{shanklin2022ethical, author={Shanklin, Robert and Samorani, Michele and Harris, Shannon and Santoro, Michael A.}, title={{Ethical redress of racial inequities in AI: Lessons from decoupling machine learning from optimization in medical appointment scheduling}}, journal={Philosophy \& Technology}, year={2022}, volume={35}, number={4}, eid={96}, doi={10.1007/s13347-022-00590-8}}@article{steyerberg2014towards, author={Steyerberg, Ewout W. and Vergouwe, Yvonne}, title={{Towards better clinical prediction models: Seven steps for development and an ABCD for validation}}, journal={European Heart Journal}, year={2014}, volume={35}, number={29}, pages={1925--1931}, doi={10.1093/eurheartj/ehu207}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}