Co to jest model AFT?
Model AFT (ang. accelerated failure time, model przyspieszonego czasu do zdarzenia) to parametryczny model analizy przeżycia, w którym predyktory działają bezpośrednio na czas, a nie na hazard. Zapisuje się go jak regresję liniową logarytmu czasu: log T = β₀ + β₁x + σε, a rozkład składnika ε wyznacza rozkład czasu – Weibulla, log-normalny albo log-logistyczny. Obserwacje cenzurowane wchodzą do funkcji wiarygodności przez prawdopodobieństwo przeżycia do chwili cenzurowania. Wei (1992) zwraca uwagę, że model ten, choć ma intuicyjną interpretację, przez lata był używany znacznie rzadziej niż model Coxa, i przedstawia go jako użyteczną alternatywę.
Iloraz czasów zamiast ilorazu hazardów
Wartość exp(β) to iloraz czasów (ang. time ratio, TR). TR = 1.5 oznacza, że w grupie z x = 1 mediana i każdy inny kwantyl czasu do zdarzenia są 1.5 raza dłuższe – zdarzenie zostaje „odsunięte w czasie”. TR > 1 oznacza więc lepsze rokowanie, odwrotnie niż iloraz hazardów, w którym HR > 1 to wyższe ryzyko. Carroll (2003) przypomina, że tylko rozkład Weibulla spełnia jednocześnie założenia AFT i proporcjonalnych hazardów, więc tylko w nim można podać obie miary. Modele log-normalny i log-logistyczny nie zakładają proporcjonalnych hazardów, co bywa zaletą, gdy hazard najpierw rośnie, a potem maleje.
Przykład
W symulacji 400 osób (222 zdarzenia) z czasem log-normalnym i prawdziwym TR = 1.49 dopasowano trzy modele funkcją survreg(). Najmniejsze AIC miał model log-normalny (1307.95 wobec 1312.71 dla log-logistycznego i 1331.56 dla Weibulla). Dał on TR = 1.52, 95% CI [1.26, 1.84], a przewidywana mediana czasu wzrosła z 4.53 do 6.90 jednostki. Model Coxa na tych samych danych dał HR = 0.54.
Na rysunku
Rysunek korzysta z danych z przykładu (400 osób, set.seed(647)) i z dopasowanego modelu log-normalnego.
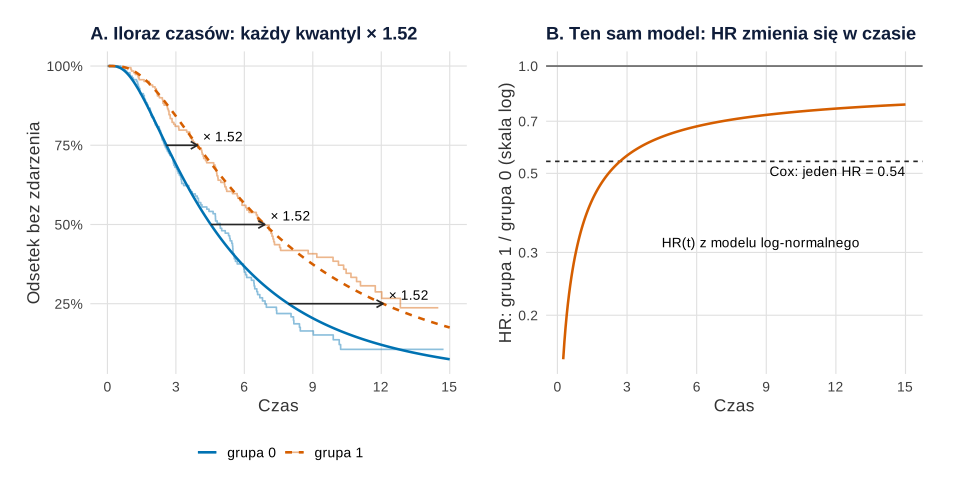
set.seed(647)).Co widać. W panelu A cienkie schodki to krzywe Kaplana–Meiera, a grube linie – krzywe z modelu. Strzałki łączą chwile, w których zdarzenie miało 25%, 50% i 75% osób: w grupie 0 to 2.59, 4.53 i 7.93 jednostki czasu, w grupie 1 – 3.94, 6.90 i 12.08. Każda strzałka wydłuża czas o ten sam czynnik 1.52, czyli o iloraz czasów, więc krzywa grupy 1 jest krzywą grupy 0 rozciągniętą wzdłuż osi czasu. Panel B opisuje ten sam model językiem hazardów: iloraz hazardów wynosi 0.34 w chwili 1, 0.56 w chwili 3 i 0.78 w chwili 15, a model Coxa streszcza go jedną liczbą, HR = 0.54.
Na co uważać. Stały iloraz czasów nie oznacza stałego ilorazu hazardów – wyjątkiem jest tylko model Weibulla. Test proporcjonalności hazardów w przykładzie (p = .834) tej zmienności nie wykrył, więc HR z modelu Coxa nie jest błędny, ale jest uśrednieniem po okresie obserwacji. Wykres nie dowodzi, że rozkład log-normalny jest właściwy: zgodność gładkich linii ze schodkami to tylko wstępna ocena, a prawe końce krzywych opierają się na nielicznych osobach, które pozostały w obserwacji.
Podpis do pracy:
Kod rysunku jest samowystarczalny. Rysunek na stronie powstał z tego samego kodu, w którym podmieniono tylko motyw (krój czcionki, siatka).
Kod R rysunku 1
# Rysunek 1. Model AFT: krzywa grupy 1 to krzywa grupy 0 rozciągnięta w czasie (A),
# a iloraz hazardów z tego samego modelu zmienia się w czasie (B)
library(survival)
library(ggplot2)
library(patchwork)

kol <- c("grupa 0" = "#0072B2", "grupa 1" = "#D55E00")   # Okabe–Ito, czytelne przy deuteranopii
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = rel(0.95)))

set.seed(647)                                   # dane z przykładu w haśle
n <- 400
grupa <- rbinom(n, 1, 0.5)
t_zd <- exp(1.5 + 0.4 * grupa + rnorm(n, sd = 0.8))   # prawdziwy TR = exp(0.4) = 1.49
t_cenz <- runif(n, 0, 15)
czas <- pmin(t_zd, t_cenz); zd <- as.integer(t_zd <= t_cenz)
aft <- survreg(Surv(czas, zd) ~ grupa, dist = "lognormal")
b <- coef(aft); s <- aft$scale

# Kwantyle czasu z modelu: każdy jest w grupie 1 dłuższy o ten sam czynnik TR
p <- c(0.25, 0.50, 0.75)                        # odsetek osób, które miały już zdarzenie
kw <- predict(aft, newdata = data.frame(grupa = 0:1), type = "quantile", p = p)
print(round(data.frame(odsetek_zdarzen = p, czas_grupa0 = kw[1, ], czas_grupa1 = kw[2, ],
                       iloraz_czasow = kw[2, ] / kw[1, ]), 2), row.names = FALSE)

# A: krzywe Kaplana–Meiera (cienkie) i krzywe z modelu log-normalnego (grube)
km <- survfit(Surv(czas, zd) ~ grupa)
km_df <- do.call(rbind, lapply(0:1, function(g) {
  f <- km[g + 1]; data.frame(grupa = paste("grupa", g), czas = c(0, f$time), S = c(1, f$surv))
}))
mod_df <- expand.grid(czas = seq(0.05, 15, by = 0.05), g = 0:1)
mod_df$S <- plnorm(mod_df$czas, b[[1]] + b[[2]] * mod_df$g, s, lower.tail = FALSE)
mod_df$grupa <- paste("grupa", mod_df$g)
strz <- data.frame(y = 1 - p, x0 = kw[1, ], x1 = kw[2, ])
pA <- ggplot() +
  geom_step(data = km_df, aes(czas, S, colour = grupa), alpha = 0.45) +
  geom_line(data = mod_df, aes(czas, S, colour = grupa, linetype = grupa), linewidth = 0.9) +
  geom_segment(data = strz, aes(x = x0, xend = x1, y = y, yend = y), colour = "grey15",
               arrow = arrow(length = unit(2, "mm"))) +
  geom_text(data = strz, aes(x = x1, y = y, label = sprintf("× %.2f", x1 / x0)),
            hjust = -0.15, vjust = -0.4, size = 3.6) +
  scale_colour_manual(NULL, values = kol) + scale_linetype_manual(NULL, values = c("solid", "22")) +
  scale_x_continuous("Czas", breaks = seq(0, 15, 3)) +
  scale_y_continuous("Odsetek bez zdarzenia", labels = function(x) paste0(100 * x, "%")) +
  labs(title = sprintf("A. Iloraz czasów: każdy kwantyl × %.2f", exp(b[[2]])))

# B: iloraz hazardów h1(t) / h0(t) z tego samego modelu log-normalnego
haz <- function(t, mu) dlnorm(t, mu, s) / plnorm(t, mu, s, lower.tail = FALSE)
hr_df <- data.frame(czas = seq(0.25, 15, by = 0.05))
hr_df$HR <- haz(hr_df$czas, b[[1]] + b[[2]]) / haz(hr_df$czas, b[[1]])
hr_cox <- unname(exp(coef(coxph(Surv(czas, zd) ~ grupa))))
t_wyb <- c(1, 3, 6, 10, 15)
hr_t <- haz(t_wyb, b[[1]] + b[[2]]) / haz(t_wyb, b[[1]]); names(hr_t) <- paste0("HR_t", t_wyb)
round(c(HR_cox = hr_cox, hr_t), 2)
pB <- ggplot(hr_df, aes(czas, HR)) +
  geom_hline(yintercept = 1, colour = "grey40") +
  geom_hline(yintercept = hr_cox, linetype = "22", colour = "grey15") +
  geom_line(colour = kol[["grupa 1"]], linewidth = 0.9) +
  annotate("text", x = 15, y = hr_cox, label = sprintf("Cox: jeden HR = %.2f", hr_cox),
           hjust = 1, vjust = 1.5, size = 3.6) +
  annotate("text", x = 4.5, y = 0.32, label = "HR(t) z modelu log-normalnego", hjust = 0, size = 3.6) +
  scale_x_continuous("Czas", breaks = seq(0, 15, 3)) +
  scale_y_log10("HR: grupa 1 / grupa 0 (skala log)", breaks = c(0.1, 0.2, 0.3, 0.5, 0.7, 1)) +
  labs(title = "B. Ten sam model: HR zmienia się w czasie")
p1 <- (pA | pB) & motyw
p1
Wynik w R
 odsetek_zdarzen czas_grupa0 czas_grupa1 iloraz_czasow
            0.25        2.59        3.94          1.52
            0.50        4.53        6.90          1.52
            0.75        7.93       12.08          1.52
HR_cox  HR_t1  HR_t3  HR_t6 HR_t10 HR_t15
  0.54   0.34   0.56   0.68   0.74   0.78
Na co uważać
- Wybór rozkładu. Porównaj kilka rozkładów, np. przez AIC, i oceń dopasowanie wykresem. Iloraz czasów bywa podobny, przewidywania w ogonach – już nie.
- Znak współczynnika. Dodatnie β w
survreg()oznacza dłuższy czas, czyli mniejsze ryzyko. - Ekstrapolacja. Przewidywania poza okresem obserwacji wynikają głównie z założonego rozkładu, a nie z danych.
Model Coxa i krzywe przeżycia na przykładzie pokazuje wpis Kaplan–Meier i model Coxa krok po kroku.
Model AFT w R
Kod symuluje czasy log-normalne z cenzurowaniem, dopasowuje modele AFT z trzema rozkładami, porównuje je przez AIC i zestawia iloraz czasów z ilorazem hazardów z modelu Coxa. Liczby w tekście pochodzą z tego kodu.
Iloraz czasów z survreg() dla trzech rozkładów
R
library(survival)
set.seed(647)
n <- 400
grupa <- rbinom(n, 1, 0.5)
t_zd <- exp(1.5 + 0.4 * grupa + rnorm(n, sd = 0.8))   # log T liniowo zależy od grupy: prawdziwy TR = exp(0.4) = 1.49
t_cenz <- runif(n, 0, 15)
czas <- pmin(t_zd, t_cenz); zd <- as.integer(t_zd <= t_cenz)
c(n = n, zdarzenia = sum(zd))
fity <- lapply(c(weibull = "weibull", lognormal = "lognormal", loglogistic = "loglogistic"),
               function(r) survreg(Surv(czas, zd) ~ grupa, dist = r))
tab <- t(sapply(fity, function(m) c(TR = exp(coef(m)[["grupa"]]),
                                    exp(confint(m)["grupa", ]), AIC = AIC(m))))
round(tab, 2)
cox <- coxph(Surv(czas, zd) ~ grupa)
round(c(HR_cox = unname(exp(coef(cox))), p_PH = cox.zph(cox)$table["grupa", "p"]), 3)
# mediana czasu w grupach z modelu log-normalnego
round(predict(fity$lognormal, newdata = data.frame(grupa = 0:1), type = "quantile", p = .5), 2)
Wynik w R
        n zdarzenia
      400       222
              TR 2.5 % 97.5 %     AIC
weibull     1.54  1.30   1.84 1331.56
lognormal   1.52  1.26   1.84 1307.95
loglogistic 1.53  1.27   1.84 1312.71
HR_cox   p_PH
 0.540  0.834
   1    2
4.53 6.90
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet survival: survreg(), coxph(), cox.zph(); rysunek 1 – także pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy wybrać model AFT zamiast modelu Coxa?
Gdy założenie proporcjonalnych hazardów jest wątpliwe, gdy wynik łatwiej przekazać jako wydłużenie czasu (np. „mediana dłuższa o 52%”) albo gdy potrzebne są przewidywane czasy i kwantyle. Ceną jest założenie konkretnego rozkładu, które trzeba sprawdzić.
Jak przeliczyć współczynnik z survreg() na iloraz czasów?
Podnieś go do potęgi: TR = exp(β), a przedział ufności to exp(confint(model)). Dodatnie β oznacza dłuższy czas do zdarzenia. W przykładzie β dla grupy w modelu log-normalnym dało TR = 1.52, 95% CI [1.26, 1.84].
Czy z modelu AFT można podać iloraz hazardów?
Tylko w modelu Weibulla, który jest jednocześnie modelem AFT i proporcjonalnych hazardów: HR = exp(−β/σ), gdzie σ to parametr scale z survreg(). W modelu log-normalnym i log-logistycznym hazardy nie są proporcjonalne, więc jeden HR nie istnieje.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Carroll, K. J. (2003). On the use and utility of the Weibull model in the analysis of survival data. Controlled Clinical Trials, 24(6), 682–701. https://doi.org/10.1016/s0197-2456(03)00072-2
- Wei, L. J. (1992). The accelerated failure time model: A useful alternative to the Cox regression model in survival analysis. Statistics in Medicine, 11(14–15), 1871–1879. https://doi.org/10.1002/sim.4780111409
Cytowania BibTeX
@article{carroll2003use, author={Carroll, Kevin J.}, title={{On the use and utility of the Weibull model in the analysis of survival data}}, journal={Controlled Clinical Trials}, year={2003}, volume={24}, number={6}, pages={682--701}, doi={10.1016/s0197-2456(03)00072-2}}@article{wei1992accelerated, author={Wei, L. J.}, title={{The accelerated failure time model: A useful alternative to the Cox regression model in survival analysis}}, journal={Statistics in Medicine}, year={1992}, volume={11}, number={14–15}, pages={1871--1879}, doi={10.1002/sim.4780111409}}