Kim byli Edward Kaplan i Paul Meier?
Edward L. Kaplan (1920–2006) i Paul Meier (1924–2011) opublikowali w czerwcu 1958 r. metodę szacowania krzywej przeżycia z niepełnych obserwacji, która stała się standardem raportowania przeżycia pacjentów (Stalpers i Kaplan, 2018). W chwili publikacji Kaplan podawał jako miejsce pracy University of California Radiation Laboratory, a Meier – University of Chicago (Kaplan i Meier, 1958). Obszerną biografię Kaplana opisali Stalpers i Kaplan (2018); my podajemy tylko to, co potwierdzają źródła, które mogliśmy przeczytać.
Meier urodził się w Nowym Jorku. Studiował fizykę i matematykę w Oberlin College (1945), a statystykę w Princeton, gdzie obronił doktorat w 1951 r. Od 1952 r. pracował w dziale biostatystyki Johns Hopkins University, w latach 1957–1992 na wydziale statystyki University of Chicago, a potem w Columbia University. Był członkiem założycielem Society for Clinical Trials i przez dwie dekady współtworzył badanie leczenia toksoplazmozy wrodzonej oparte na randomizacji. Zmarł w Nowym Jorku 7 sierpnia 2011 r. (Koppes, 2011).
Najważniejsze pomysły
- Estymator iloczynowy (1958). Kaplan i Meier (1958) rozważali obserwacje, w których moment zdarzenia („zgonu”) jest nieznany, bo wcześniej nastąpiła „utrata” – przypadkowa albo planowa, gdy badanie się kończy. Dziś mówimy o obserwacjach cenzurowanych. Ich estymator product-limit mnoży czynniki (N − r)/(N − r + 1) dla kolejnych zgonów i jest rozkładem, który maksymalizuje wiarygodność obserwacji bez założeń o kształcie krzywej. To właśnie krzywa Kaplana–Meiera.
- Porównanie z metodami aktuarialnymi. W tej samej pracy autorzy zestawili estymator z szacunkami aktuarialnymi (iloczyny po pogrupowaniu czasu) i szacunkami z „próby zredukowanej”, które wymagają znajomości planowanych końców obserwacji.
- Fundament analizy przeżycia. Na krzywej K–M opierają się test log-rank, mediana czasu przeżycia i wykresy przy modelu Coxa (zob. David Cox). Według Stalpersa i Kaplana (2018) metodę stosuje ponad 70% prac z onkologii klinicznej.
- Meier i badania kliniczne. Meier zasiadał w komitetach NIH, FDA i Narodowej Akademii Nauk oraz w komisjach monitorujących badania, a w latach 1986–1987 był prezesem Society for Clinical Trials (Koppes, 2011).
Ciekawostka
Zanim powstał estymator, Meier zajmował się szczepionką przeciw polio. W 1957 r., jako profesor nadzwyczajny biostatystyki w Johns Hopkins, opublikował w Science artykuł o testowaniu jej bezpieczeństwa (Meier, 1957). Wspomnienie University of Chicago przypomina, że wiele pisał o próbie terenowej szczepionki z 1954 r., w której wzięło udział ponad milion dzieci – nazywanej tam największym eksperymentem medycznym w historii (Koppes, 2011).
Wspólny artykuł z Kaplanem okazał się rekordzistą innego rodzaju. W 2011 r. miał około 34 000 cytowań (Koppes, 2011), a w listopadzie 2017 r. – 44 319 w Web of Science, co według Stalpersa i Kaplana (2018) czyni go najczęściej cytowaną publikacją statystyczną w literaturze naukowej.
Przykład na historycznych danych
Zbiór aml z pakietu survival opisuje – według pliku pomocy – przeżycie chorych na ostrą białaczkę szpikową; pytano, czy standardową chemioterapię przedłużyć o kolejne cykle (leczenie podtrzymujące). Źródłem jest podręcznik Millera (1997). Plik pomocy nie podaje jednostki czasu, więc piszemy po prostu „czas”.
W grupie z leczeniem podtrzymującym było 11 osób: 7 zdarzeń i 4 obserwacje ucięte (w czasie 13, 28, 45 i 161). Liczymy wprost wzorem z 1958 r.: układamy 11 czasów rosnąco (przy remisie zdarzenie przed ucięciem) i dla każdego zdarzenia o randze r mnożymy przez (11 − r)/(12 − r). Pierwsze zdarzenie (czas 9) daje 10/11 = 0.909, a ostatnie (czas 48, ranga 10) – czynnik 0.500. Kolejne wartości S(t) to .909, .818, .716, .614, .491, .368 i .184 – identyczne z wynikiem funkcji survfit().
Dwa naiwne skróty dają inne liczby. Przy czasie 40 estymator K–M wynosi .368; pominięcie obserwacji uciętych daje .143, a potraktowanie ich jak zdarzeń – .273. Przy czasie 20: .716 wobec .571 i .636. Tu oba skróty zaniżają przeżycie. W porównaniu grup mediana czasu wyniosła 31 z leczeniem podtrzymującym i 23 bez niego, test log-rank: χ²(1) = 3.40, p = .065 (n = 23).
Na rysunku
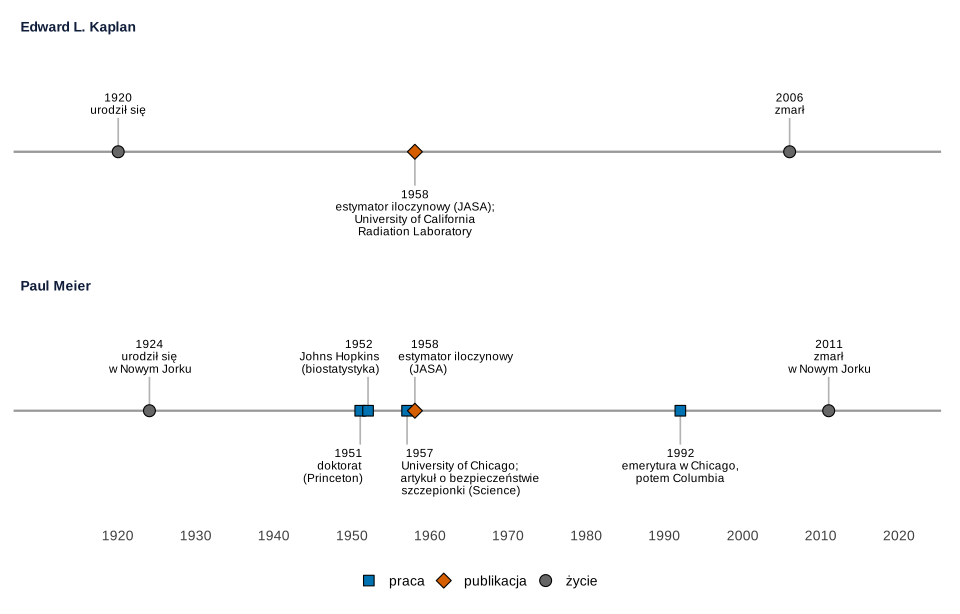
Co widać. Drogi obu autorów przecinają się w jednym punkcie – artykule z 1958 r. Rok wcześniej Meier przeniósł się z Johns Hopkins do Chicago, gdzie pracował przez 35 lat.
Na co uważać. Pas Kaplana ma tylko trzy zdarzenia, bo pełnego tekstu jego biografii (Stalpers i Kaplan, 2018) nie mogliśmy przeczytać; nie dopisujemy faktów znanych tylko z drugiej ręki.
Podpis do pracy:
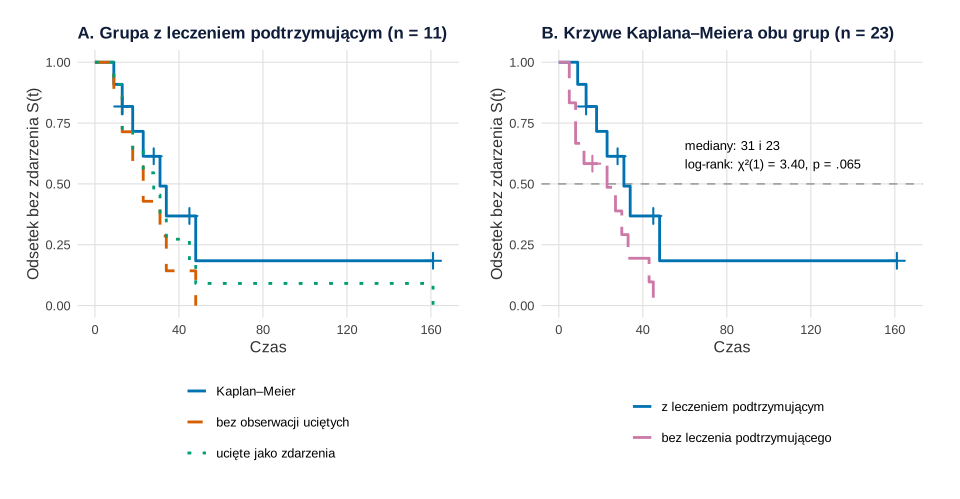
survival::aml): trzy sposoby szacowania przeżycia w grupie z leczeniem podtrzymującym (A) i krzywe Kaplana–Meiera obu grup (B). Obliczenia i rysunek: R, pakiety survival, ggplot2 i patchwork (dane historyczne, bez losowania).Co widać. W panelu A obie naiwne krzywe leżą pod krzywą K–M: pominięcie uciętych udaje, że wszyscy umarli wcześnie, a liczenie ich jako zdarzeń – że umarli w chwili ucięcia. Panel B pokazuje przewagę grupy z leczeniem podtrzymującym, której przy 23 osobach nie potwierdza test log-rank.
Na co uważać. Ostatni schodek (.184) opiera się na dwóch osobach w ryzyku, a płaski ogon do czasu 161 to jedna obserwacja ucięta – nie dowód trwałego wyleczenia. Pokazuj liczbę osób w ryzyku albo przedziały ufności.
Podpis do pracy:
Gdzie spotkasz Kaplana i Meiera w swojej pracy
Wszędzie, gdzie mierzysz czas do zdarzenia: nawrotu choroby, rezygnacji z terapii, odejścia z pracy czy powrotu do nałogu (zob. analiza przeżycia). Na co zwracać uwagę:
- opisuj medianę czasu i liczbę zdarzeń w grupach, a krzywe porównuj testem log-rank – całą ścieżkę pokazuje wpis Kaplan–Meier i model Coxa krok po kroku, a wersję w SPSS – Kaplan–Meier i regresja Coxa w SPSS;
- gdy krzywa nie spada do .50, mediany nie da się podać – wtedy pomaga RMST;
- zaznaczaj obserwacje ucięte na wykresie i nie usuwaj ich z analizy – przykład wyżej pokazuje, jak bardzo zmienia to wynik.
Spory, mity i trudne strony
- Niezależność ucięcia. Kaplan i Meier (1958) zakładali, że czas życia nie zależy od momentu utraty z obserwacji, i sami zaznaczali, że w praktyce to założenie wymaga starannego sprawdzenia. Jeśli z badania odpadają głównie osoby w gorszym stanie, krzywa K–M jest zbyt optymistyczna.
- Zdarzenia konkurujące. Gdy zgon z innej przyczyny uniemożliwia zdarzenie badane, 1 − K–M zawyża skumulowane ryzyko; potrzebne są metody ryzyk konkurencyjnych.
- Ogon krzywej. Daleki koniec krzywej opiera się na kilku osobach; odczytywanie z niego „przeżycia 5-letniego” bez liczby osób w ryzyku jest częstym błędem.
Estymator Kaplana–Meiera na danych aml w R
Kod wczytuje dane o białaczce z pakietu survival, liczy estymator iloczynowy wzorem z 1958 r. i sprawdza, że daje to samo co survfit(), porównuje go z dwoma naiwnymi szacunkami, podaje mediany i test log-rank, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Estymator iloczynowy na danych aml: rysunek 2
Kod R rysunku 2
# Kaplan i Meier: estymator iloczynowy (product-limit) na danych o białaczce (survival::aml)
suppressPackageStartupMessages({library(survival); library(ggplot2); library(patchwork)})
kol <- c(km = "#0072B2", bez = "#D55E00", jako = "#009E73", druga = "#CC79A7")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(cancer, package = "survival")
# time – czas przeżycia albo czas do ucięcia obserwacji; status – 1 zgon/nawrót (zdarzenie), 0 obserwacja ucięta;
# x – czy podano chemioterapię podtrzymującą (Maintained / Nonmaintained)
table(aml$x, aml$status, dnn = c("grupa", "status"))
m <- aml[aml$x == "Maintained", ]
m[order(m$time), c("time", "status")]

# 1. Wzór z 1958 r.: wszystkie N czasów w kolejności rosnącej (przy remisie zdarzenie przed ucięciem);
#    dla każdego zdarzenia o randze r czynnik (N − r) / (N − r + 1)
N <- nrow(m)
o <- m[order(m$time, -m$status), ]
o$r <- seq_len(N)
o$czynnik <- ifelse(o$status == 1, (N - o$r) / (N - o$r + 1), 1)
o$S <- cumprod(o$czynnik)
round(o[o$status == 1, c("time", "r", "czynnik", "S")], 3)
# To samo z funkcji survfit()
km <- survfit(Surv(time, status) ~ 1, data = m)
stopifnot(isTRUE(all.equal(unname(o$S[o$status == 1]), summary(km)$surv)))

# 2. Dwa naiwne sposoby, których dotyczyła praca: pominięcie obserwacji uciętych
#    i potraktowanie ich jak zdarzeń (odsetek „przeżywających” dłużej niż t)
siatka <- c(10, 20, 30, 40)
S_km <- summary(km, times = siatka)$surv
S_bez <- sapply(siatka, function(t) mean(m$time[m$status == 1] > t))
S_jako <- sapply(siatka, function(t) mean(m$time > t))
round(rbind(t = siatka, Kaplan_Meier = S_km, bez_uciętych = S_bez, ucięte_jako_zdarzenia = S_jako), 3)

# 3. Obie grupy: mediany i test log-rank
km2 <- survfit(Surv(time, status) ~ x, data = aml)
print(km2)
lr <- survdiff(Surv(time, status) ~ x, data = aml)
round(c(chi2 = lr$chisq, df = length(lr$n) - 1, p = pchisq(lr$chisq, length(lr$n) - 1, lower.tail = FALSE)), 3)

# Rysunek: schodki trzech oszacowań (A) i krzywe K–M dwóch grup (B)
schodki <- function(czasy, S, metoda) {
  data.frame(t = c(0, czasy), S = c(1, S), metoda = metoda)
}
zd <- sort(unique(m$time[m$status == 1]))
dA <- rbind(
  schodki(km$time, km$surv, "Kaplan–Meier"),
  schodki(zd, sapply(zd, function(t) mean(m$time[m$status == 1] > t)), "bez obserwacji uciętych"),
  schodki(sort(unique(m$time)), sapply(sort(unique(m$time)), function(t) mean(m$time > t)), "ucięte jako zdarzenia"))
dA$metoda <- factor(dA$metoda, levels = c("Kaplan–Meier", "bez obserwacji uciętych", "ucięte jako zdarzenia"))
uc <- data.frame(t = m$time[m$status == 0])
uc$S <- sapply(uc$t, function(t) summary(km, times = t)$surv)
pA <- ggplot(dA, aes(t, S, colour = metoda, linetype = metoda)) +
  geom_step(linewidth = 1) +
  geom_point(data = uc, aes(t, S), inherit.aes = FALSE, shape = 3, size = 3.2, stroke = 1.1, colour = kol[["km"]]) +
  scale_colour_manual(values = c(kol[["km"]], kol[["bez"]], kol[["jako"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "dotted"), name = NULL) +
  scale_x_continuous(limits = c(0, 165), breaks = seq(0, 160, by = 40)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, by = .25)) +
  labs(title = "A. Grupa z leczeniem podtrzymującym (n = 11)", x = "Czas", y = "Odsetek bez zdarzenia S(t)") +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  motyw
dB <- do.call(rbind, lapply(names(km2$strata), function(g) {
  i <- which(rep(names(km2$strata), km2$strata) == g)
  data.frame(t = c(0, km2$time[i]), S = c(1, km2$surv[i]), grupa = sub("x=", "", g),
             uciete = c(FALSE, km2$n.censor[i] > 0))
}))
dB$grupa <- factor(dB$grupa, levels = c("Maintained", "Nonmaintained"),
                   labels = c("z leczeniem podtrzymującym", "bez leczenia podtrzymującego"))
med <- summary(km2)$table[, "median"]
pB <- ggplot(dB, aes(t, S, colour = grupa, linetype = grupa)) +
  geom_hline(yintercept = .5, colour = "grey60", linetype = "dashed") +
  geom_step(linewidth = 1) +
  geom_point(data = dB[dB$uciete, ], shape = 3, size = 3.2, stroke = 1.1, show.legend = FALSE) +
  annotate("text", x = 60, y = .62, size = 3.4, hjust = 0,
           label = sprintf("mediany: %g i %g\nlog-rank: χ²(1) = %.2f, p = %s", med[1], med[2], lr$chisq,
                           sub("^0", "", sprintf("%.3f", pchisq(lr$chisq, 1, lower.tail = FALSE))))) +
  scale_colour_manual(values = c(kol[["km"]], kol[["druga"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  scale_x_continuous(limits = c(0, 165), breaks = seq(0, 160, by = 40)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, by = .25)) +
  labs(title = "B. Krzywe Kaplana–Meiera obu grup (n = 23)", x = "Czas", y = "Odsetek bez zdarzenia S(t)") +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  motyw
p2 <- pA + pB
p2
Wynik w R
               status
grupa            0  1
  Maintained     4  7
  Nonmaintained  1 11
   time status
1     9      1
2    13      1
3    13      0
4    18      1
5    23      1
6    28      0
7    31      1
8    34      1
9    45      0
10   48      1
11  161      0
   time  r czynnik     S
1     9  1   0.909 0.909
2    13  2   0.900 0.818
4    18  4   0.875 0.716
5    23  5   0.857 0.614
7    31  7   0.800 0.491
8    34  8   0.750 0.368
10   48 10   0.500 0.184
                        [,1]   [,2]   [,3]   [,4]
t                     10.000 20.000 30.000 40.000
Kaplan_Meier           0.909  0.716  0.614  0.368
bez_uciętych           0.857  0.571  0.429  0.143
ucięte_jako_zdarzenia  0.909  0.636  0.455  0.273
Call: survfit(formula = Surv(time, status) ~ x, data = aml)

                 n events median 0.95LCL 0.95UCL
x=Maintained    11      7     31      18      NA
x=Nonmaintained 12     11     23       8      NA
 chi2    df     p
3.396 1.000 0.065
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Edward L. Kaplan (1920–2006) i Paul Meier (1924–2011) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1920, 1958, 2006,
          1924, 1951, 1952, 1957, 1958, 1992, 2011),
  osoba = c(rep("Edward L. Kaplan", 3), rep("Paul Meier", 7)),
  opis = c("urodził się", "estymator iloczynowy (JASA);\nUniversity of California\nRadiation Laboratory", "zmarł",
           "urodził się\nw Nowym Jorku", "doktorat\n(Princeton)", "Johns Hopkins\n(biostatystyka)",
           "University of Chicago;\nartykuł o bezpieczeństwie\nszczepionki (Science)", "estymator iloczynowy\n(JASA)",
           "emerytura w Chicago,\npotem Columbia", "zmarł\nw Nowym Jorku"),
  rodzaj = c("życie", "publikacja", "życie",
             "życie", "praca", "praca", "praca", "publikacja", "praca", "życie"),
  strona = c(1, -1, 1,
             1, -1, 1, -1, 1, -1, 1),
  wyrownanie = c(0.5, 0.5, 0.5,
                 0.5, 0.95, 0.85, 0.05, 0.15, 0.5, 0.5))   # rozsunięcie bliskich etykiet
zdarzenia$osoba <- factor(zdarzenia$osoba, levels = c("Edward L. Kaplan", "Paul Meier"))
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = 0.5 * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = 0.56 * strona, label = paste0(rok, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  facet_wrap(~ osoba, ncol = 1) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1912, 2020), breaks = seq(1920, 2020, by = 10)) +
  scale_y_continuous(limits = c(-1.5, 1.5)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", hjust = 0), legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (Kaplan–Meier i log-rank – pakiet survival; rysunki – ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim byli Edward Kaplan i Paul Meier?
Statystykami, którzy w 1958 r. opublikowali estymator przeżycia z obserwacji niepełnych. Kaplan (1920–2006) pracował wtedy w University of California Radiation Laboratory. Meier (1924–2011) był biostatystykiem – w Johns Hopkins, przez 35 lat w University of Chicago, potem w Columbia University – i jednym z założycieli Society for Clinical Trials.
Dlaczego estymator Kaplana–Meiera nazywa się iloczynowym?
Bo szacunek przeżycia do czasu t jest iloczynem czynników dla kolejnych zdarzeń: w wersji z 1958 r. (N − r)/(N − r + 1), gdzie r to ranga zdarzenia wśród wszystkich czasów. Obserwacje ucięte nie dokładają czynnika, ale zmniejszają liczbę osób w ryzyku przy następnych zdarzeniach.
Jak często cytowana jest praca Kaplana i Meiera?
Według Stalpersa i Kaplana (2018) w listopadzie 2017 r. miała 44 319 cytowań w Web of Science i była najczęściej cytowaną publikacją statystyczną w literaturze naukowej. Metodę stosuje ponad 70% prac z onkologii klinicznej.
Czym zajmował się Paul Meier poza estymatorem?
Głównie badaniami klinicznymi: pisał o próbie terenowej szczepionki przeciw polio z 1954 r. i o testowaniu bezpieczeństwa szczepionki (Meier, 1957), współzakładał Society for Clinical Trials, zasiadał w komitetach NIH i FDA i przez dwie dekady współtworzył randomizowane badanie leczenia toksoplazmozy wrodzonej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikKaplan–Meier i regresja Coxa w SPSS
Od kodowania statusu po opis APA: krzywe i mediany, log-rank, Breslow i Tarone–Ware, ilorazy hazardów z Cox Regression i sprawdzenie proporcjonalności hazardów – z plikiem .sav.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Koppes, S. (2011). Paul Meier, statistician who helped change clinical research, 1924–2011. UChicago News. https://news.uchicago.edu/story/paul-meier-statistician-who-helped-change-clinical-research-1924-2011 ● Otwarty dostęp
- Meier, P. (1957). Safety testing of poliomyelitis vaccine. Science, 125(3257), 1067–1071. https://doi.org/10.1126/science.125.3257.1067
- Stalpers, L. J. A., & Kaplan, E. L. (2018). Edward L. Kaplan and the Kaplan–Meier survival curve. BSHM Bulletin: Journal of the British Society for the History of Mathematics, 33(2), 109–135. https://doi.org/10.1080/17498430.2018.1450055 ● Otwarty dostęp
Cytowania BibTeX
@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@misc{koppes2011paul, author={Koppes, Steve}, title={{Paul Meier, statistician who helped change clinical research, 1924–2011}}, howpublished={UChicago News}, year={2011}, publisher={University of Chicago}, url={https://news.uchicago.edu/story/paul-meier-statistician-who-helped-change-clinical-research-1924-2011}}@article{meier1957safety, author={Meier, Paul}, title={{Safety testing of poliomyelitis vaccine}}, journal={Science}, year={1957}, volume={125}, number={3257}, pages={1067--1071}, doi={10.1126/science.125.3257.1067}}@article{stalpers2018edward, author={Stalpers, Lukas J. A. and Kaplan, Edward L.}, title={{Edward L. Kaplan and the Kaplan–Meier survival curve}}, journal={BSHM Bulletin: Journal of the British Society for the History of Mathematics}, year={2018}, volume={33}, number={2}, pages={109--135}, doi={10.1080/17498430.2018.1450055}}