Kim był Ronald A. Fisher?
Sir Ronald Aylmer Fisher (1890–1962) był brytyjskim statystykiem i genetykiem, twórcą analizy wariancji i nowoczesnego planowania eksperymentów. Urodził się 17 lutego 1890 r., uczył się w Harrow, a matematykę studiował w Gonville and Caius College w Cambridge (Yates, 1962). Potem przez dwa lata był statystykiem w firmie inwestycyjnej i przez sześć lat uczył w szkołach.
W 1919 r. objął nowo utworzone stanowisko statystyka w rolniczej stacji doświadczalnej w Rothamsted. Pracował tam z badaczami, którzy na jedno doświadczenie mieli niewiele poletek, roślin czy zwierząt, i z tej współpracy wyrosły jego główne metody. W 1933 r. objął katedrę eugeniki im. Galtona na Uniwersytecie Londyńskim – po Karlu Pearsonie (Bodmer i in., 2021) – a w 1943 r. katedrę genetyki w Cambridge, którą zajmował do emerytury w 1957 r. Członkiem Royal Society został w 1929 r., tytuł szlachecki otrzymał w 1952 r. Od 1959 r. pracował w Adelaide w australijskiej agencji badawczej CSIRO i tam zmarł nagle 29 lipca 1962 r. (Yates, 1962).
Najważniejsze pomysły
- Analiza wariancji. Podział zmienności wyników na części przypisane różnym źródłom. W doświadczeniach rolniczych była wygodnym sposobem liczenia błędu i istotności (Yates, 1962); dziś to ANOVA i test oparty na rozkładzie F.
- Planowanie eksperymentu. Replikacja, blokowanie (porównania w obrębie jednorodnych bloków) i randomizacja, czyli losowy przydział warunków, który chroni przed nieobserwowanymi źródłami zmienności (Bodmer i in., 2021). Podejście to przedstawił w książce The Design of Experiments (1935).
- Estymacja. Rozróżnienie statystyki z próby i parametru populacji, pojęcie wiarygodności, metoda największej wiarygodności i zasada dostateczności (Bodmer i in., 2021; Yates, 1962).
- Małe próby. Dokładne testy istotności dla małych prób i szersze zastosowanie testu t Studenta (Bodmer i in., 2021) – o jego autorze zob. William Gosset („Student”).
- Wiele pomiarów naraz. Praca z 1936 r. o wykorzystaniu wielu pomiarów w problemach taksonomicznych (Fisher, 1936) to klasyczny punkt wyjścia analizy dyskryminacyjnej: kilka pomiarów łączy się w jedną funkcję, która rozdziela gatunki.
- Genetyka populacyjna. The Genetical Theory of Natural Selection (1930) pomogła pogodzić teorię Darwina z genetyką Mendla (Yates, 1962).
Pierwsza książka, Statistical Methods for Research Workers (1925), miała 14 wydań i uczyła statystyki badaczy z wielu dziedzin (Bodmer i in., 2021). Najbardziej znana historia o Fisherze to anegdota: według Senna (2012) zaczątkiem jego podejścia do eksperymentu była przerwa na herbatę, podczas której algolożka (badaczka glonów) nie chciała wypić podanej filiżanki; tytuł artykułu Senna nawiązuje do nalewania mleka przed herbatą. Wersja z kobietą, która twierdzi, że rozpozna po smaku, czy najpierw nalano mleko, i z ośmioma filiżankami (w czterech mleko najpierw) jest dziś przykładem w pomocy funkcji fisher.test() w R, czyli testu dokładnego Fishera.
Przykład na historycznych danych
Zbiór iris w R to pomiary działek i płatków 150 kwiatów, po 50 z trzech gatunków irysów. Według pliku pomocy dane zebrał Edgar Anderson, a Fisher (1936) wykorzystał je w pracy o wielu pomiarach w problemach taksonomicznych. Wzięliśmy dwa najbardziej podobne gatunki, versicolor i virginica (100 kwiatów), i cztery pomiary w centymetrach.
Funkcja dyskryminacyjna to ważona suma pomiarów z wagami −0.94 (długość działki), −1.48 (szerokość działki), 1.85 (długość płatka) i 3.28 (szerokość płatka). Wagi dobiera się tak, by stosunek zmienności między gatunkami do zmienności wewnątrz gatunków, czyli statystyka F z ANOVA, był jak największy. Dla najlepszego pojedynczego pomiaru, szerokości płatka, F = 213.9, a dla funkcji F = 355.5. Przy najlepszym progu na szerokości płatka do złego gatunku trafia 6 kwiatów na 100, na funkcji – 2. W sprawdzianie krzyżowym, w którym każdy kwiat klasyfikuje funkcja policzona bez niego, błędów jest 3. To nasze obliczenia na danych z pakietu datasets, a nie odtworzenie tabel z pracy Fishera.
Na rysunku
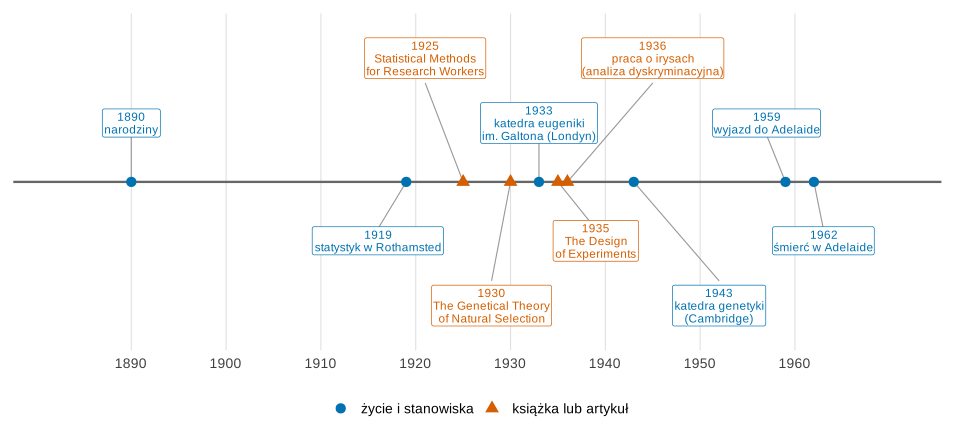
Co widać. Prawie cały dorobek statystyczny – od Statistical Methods for Research Workers po pracę o irysach – powstał w ciągu kilkunastu lat po przyjściu do Rothamsted. Późniejsze stanowiska były katedrami eugeniki i genetyki, a nie statystyki.
Na co uważać. Oś pokazuje wybrane daty; książki miały kolejne, poprawiane wydania, więc w pracy cytuj wydanie, z którego korzystasz.
Podpis do pracy:
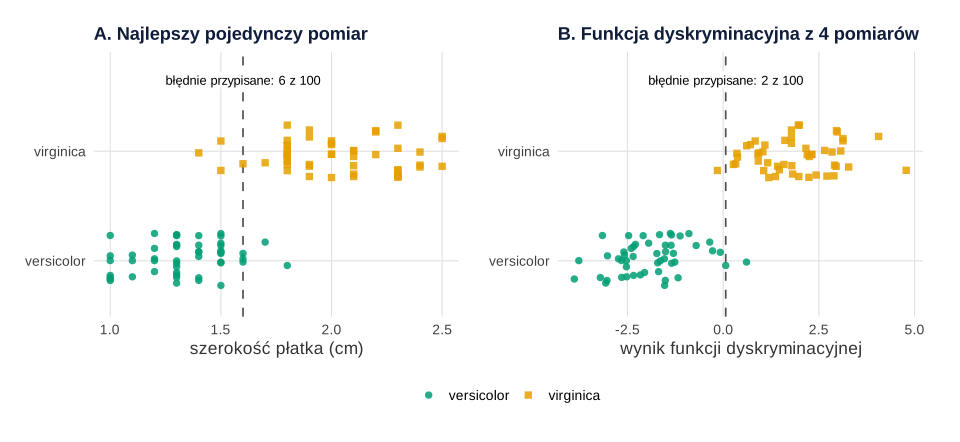
iris; pionowy rozrzut punktów losowy, set.seed(796)).Co widać. Na szerokości płatka gatunki zachodzą na siebie w przedziale około 1.4–1.8 cm. Funkcja z czterech pomiarów przesuwa je od siebie: chmury punktów prawie się nie stykają, a błędów jest trzy razy mniej. Na tym polegał pomysł Fishera – kilka słabych wskaźników razem rozróżnia lepiej niż najlepszy z nich osobno.
Na co uważać. Funkcję i próg policzono na tych samych 100 kwiatach, więc 2 błędy to wynik zbyt optymistyczny – sprawdzian krzyżowy daje 3.
Podpis do pracy:
Gdzie spotkasz Fishera w swojej pracy
- Porównujesz średnie trzech lub więcej grup – liczysz ANOVA i podajesz statystykę F.
- Masz tabelę 2 × 2 z małymi liczebnościami – zamiast chi-kwadrat stosujesz test dokładny Fishera.
- Liczysz przedział ufności dla korelacji albo porównujesz dwie korelacje – używasz transformacji Fishera z.
- Planujesz eksperyment – losujesz przydział do grup, łączysz osoby w bloki (randomizacja blokowa) albo układasz warunki w kwadrat łaciński.
- Raportujesz wartość p – element teorii testów istotności, którą rozwinął Fisher (Bodmer i in., 2021).
Spory, mity i trudne strony
Spór z Neymanem i Pearsonem. Fisher traktował wartość p jako stopniowalną miarę dowodów przeciw hipotezie zerowej, bez jawnej hipotezy alternatywnej i bez analizy mocy. Jerzy Neyman i Egon Pearson proponowali decyzję między dwiema hipotezami z ustalonymi z góry poziomem α i ryzykiem błędu II rodzaju. Popularne dziś podejście NHST jest niespójnym połączeniem obu szkół (Perezgonzalez, 2015).
Palenie i rak płuc. Po przejściu na emeryturę Fisher kwestionował tezę, że palenie papierosów powoduje raka płuc. Yates (1962) pisał w nekrologu, że krytyka ta pokazała słabości wnioskowania z danych sondażowych. Późniejsza ocena jest surowsza: według Stolleya (1991) Fisher nie przeanalizował wszystkich dostępnych danych i zbyt wcześnie wyciągnął wnioski, a na jego stanowisko mogły wpływać konflikty osobiste, praca konsultanta przemysłu tytoniowego i to, że sam palił.
Eugenika. Fisher od młodości popierał idee eugeniczne: jako student współzakładał towarzystwo eugeniczne w Cambridge, był członkiem rady Eugenics Society i popierał jej kampanię na rzecz dobrowolnej sterylizacji osób uznawanych wtedy za obciążone dziedzicznie; takiej ustawy w Wielkiej Brytanii nie uchwalono (Bodmer i in., 2021). Z tego powodu kilka instytucji – autorzy wymieniają m.in. Rothamsted Research i Gonville and Caius College, powołując się na dokumenty z 2020 r. – usunęło jego nazwisko z nazw nagród i dedykacji budynków. Bodmer i współautorzy, analizując jego pisma, nie znajdują w nich poparcia dla dyskryminacji rasowej.
Funkcja dyskryminacyjna Fishera w R
Pierwszy kod liczy funkcję dyskryminacyjną dla dwóch gatunków irysów, statystyki F i liczbę błędnych przypisań. Drugi rysuje oba rysunki. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Funkcja dyskryminacyjna na danych iris
R
# Fisher (1936): kilka pomiarów naraz – liniowa funkcja dyskryminacyjna na danych o irysach
suppressPackageStartupMessages(library(MASS))
data(iris, package = "datasets")   # po 50 kwiatów trzech gatunków; dane E. Andersona, użyte przez Fishera (1936)
d <- droplevels(subset(iris, Species != "setosa"))   # dwa najbardziej podobne gatunki: versicolor i virginica
pomiary <- c("Sepal.Length", "Sepal.Width", "Petal.Length", "Petal.Width")

# 1. Funkcja dyskryminacyjna: ważona suma czterech pomiarów
fit <- lda(Species ~ Sepal.Length + Sepal.Width + Petal.Length + Petal.Width, data = d)
round(coef(fit), 2)
d$LD <- predict(fit)$x[, 1]

# 2. Stosunek F (zmienność między gatunkami / wewnątrz gatunków): każdy pomiar osobno i funkcja
F_stat <- sapply(c(pomiary, "LD"), function(v) summary(aov(d[[v]] ~ d$Species))[[1]][1, "F value"])
round(F_stat, 1)

# 3. Błędne przypisania przy najlepszym progu na jednej osi (virginica powyżej progu)
bledy <- function(x, g) min(sapply(sort(unique(x)), function(t) sum((x > t) != (g == "virginica"))))
c(sapply(d[pomiary], bledy, g = d$Species), LD = bledy(d$LD, d$Species),
  LD_walidacja_krzyzowa = sum(lda(Species ~ Sepal.Length + Sepal.Width + Petal.Length + Petal.Width,
                                  data = d, CV = TRUE)$class != d$Species))
Wynik w R
               LD1
Sepal.Length -0.94
Sepal.Width  -1.48
Petal.Length  1.85
Petal.Width   3.28
Sepal.Length  Sepal.Width Petal.Length  Petal.Width           LD
        31.7         10.3        158.9        213.9        355.5
         Sepal.Length           Sepal.Width          Petal.Length
                   27                    37                     7
          Petal.Width                    LD LD_walidacja_krzyzowa
                    6                     2                     3
Rysunki 1 i 2: oś czasu i rozdzielenie gatunków
Kod R rysunków
# Rysunki 1–2: oś czasu R. A. Fishera i jeden pomiar a funkcja dyskryminacyjna (irysy)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(MASS)})
# Okabe–Ito (czytelne przy deuteranopii); kolor zawsze z kształtem punktu
kol <- c(stanowisko = "#0072B2", praca = "#D55E00", versicolor = "#009E73", virginica = "#E69F00")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: oś czasu (lata z nekrologu: Yates, 1962; praca o irysach: Fisher, 1936)
os <- data.frame(
  rok = c(1890, 1919, 1925, 1930, 1933, 1935, 1936, 1943, 1959, 1962),
  opis = c("narodziny", "statystyk w Rothamsted", "Statistical Methods\nfor Research Workers",
           "The Genetical Theory\nof Natural Selection", "katedra eugeniki\nim. Galtona (Londyn)",
           "The Design\nof Experiments", "praca o irysach\n(analiza dyskryminacyjna)",
           "katedra genetyki\n(Cambridge)", "wyjazd do Adelaide", "śmierć w Adelaide"),
  rodzaj = c("stanowisko", "stanowisko", "praca", "praca", "stanowisko", "praca", "praca",
             "stanowisko", "stanowisko", "stanowisko"),
  lx = c(1890, 1916, 1921, 1928, 1933, 1939, 1945, 1952, 1957, 1963),   # położenie etykiet
  y = c(1, -1, 2.1, -2.1, 1, -1, 2.1, -2.1, 1, -1))
os$rodzaj <- factor(os$rodzaj, levels = c("stanowisko", "praca"),
                    labels = c("życie i stanowiska", "książka lub artykuł"))
p1 <- ggplot(os, aes(rok)) +
  geom_hline(yintercept = 0, colour = "grey40", linewidth = 0.8) +
  geom_segment(aes(xend = lx, y = 0, yend = y * 0.8), colour = "grey60", linewidth = 0.4) +
  geom_point(aes(y = 0, colour = rodzaj, shape = rodzaj), size = 3.2) +
  geom_label(aes(x = lx, y = y, label = paste0(rok, "\n", opis), colour = rodzaj), size = 3.1,
             lineheight = 0.9, linewidth = 0.25, fill = "white", show.legend = FALSE) +
  scale_colour_manual(values = unname(kol[c("stanowisko", "praca")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = seq(1890, 1960, 10), limits = c(1882, 1971)) +
  scale_y_continuous(limits = c(-2.6, 2.6)) +
  labs(x = NULL, y = NULL) + motyw +
  theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# Rysunek 2: versicolor i virginica na najlepszym pojedynczym pomiarze i na funkcji dyskryminacyjnej
d <- droplevels(subset(iris, Species != "setosa"))
fit <- lda(Species ~ Sepal.Length + Sepal.Width + Petal.Length + Petal.Width, data = d)
d$LD <- predict(fit)$x[, 1]
prog <- function(x, g) {          # próg z najmniejszą liczbą błędów (virginica powyżej progu)
  t <- sort(unique(x)); b <- sapply(t, function(v) sum((x > v) != (g == "virginica")))
  c(prog = t[which.min(b)], bledy = min(b))
}
set.seed(796)                     # tylko pionowy rozrzut punktów na rysunku
d$drgania <- runif(nrow(d), -0.25, 0.25)
panel <- function(zm, tytul, os_x) {
  pr <- prog(d[[zm]], d$Species)
  ggplot(d, aes(.data[[zm]], as.numeric(Species) + drgania, colour = Species, shape = Species)) +
    geom_vline(xintercept = pr[["prog"]], linetype = "dashed", colour = "grey30") +
    geom_point(size = 2.2, alpha = 0.85) +
    annotate("label", x = pr[["prog"]], y = 2.65, label = paste("błędnie przypisane:", pr[["bledy"]], "z 100"),
             size = 3.4, fill = "white", linewidth = 0) +
    scale_colour_manual(values = unname(kol[c("versicolor", "virginica")]), name = NULL) +
    scale_shape_manual(values = c(16, 15), name = NULL) +
    scale_y_continuous(breaks = 1:2, labels = c("versicolor", "virginica"), limits = c(0.6, 2.8)) +
    labs(title = tytul, x = os_x, y = NULL) + motyw
}
p2 <- (panel("Petal.Width", "A. Najlepszy pojedynczy pomiar", "szerokość płatka (cm)") +
       panel("LD", "B. Funkcja dyskryminacyjna z 4 pomiarów", "wynik funkcji dyskryminacyjnej")) +
  plot_layout(guides = "collect") & theme(legend.position = "bottom")
round(rbind(platek_szerokosc = prog(d$Petal.Width, d$Species), funkcja = prog(d$LD, d$Species)), 2)

p1   # zapis: ggsave("ronald-fisher-os-czasu.svg", p1, width = 10, height = 4.6)
p2   # zapis: ggsave("ronald-fisher-iris-dyskryminacja.svg", p2, width = 10, height = 4.6)
Wynik w R
                 prog bledy
platek_szerokosc 1.60     6
funkcja          0.07     2
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja dyskryminacyjna – lda() z pakietu MASS; ANOVA – aov(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Ronald A. Fisher?
Brytyjskim statystykiem i genetykiem (1890–1962). Od 1919 r. pracował jako statystyk w rolniczej stacji doświadczalnej w Rothamsted, w 1933 r. objął katedrę eugeniki im. Galtona w Londynie, a w 1943 r. katedrę genetyki w Cambridge. Zmarł w 1962 r. w Adelaide w Australii.
Co wymyślił Ronald Fisher?
Analizę wariancji (ANOVA), zasady planowania eksperymentów (replikacja, bloki, randomizacja), metodę największej wiarygodności, dokładne testy dla małych prób, w tym test dokładny Fishera, oraz liniową funkcję dyskryminacyjną. Był też jednym z twórców genetyki populacyjnej.
Czy Ronald Fisher był eugenikiem?
Tak – od czasów studenckich popierał eugenikę, był członkiem rady Eugenics Society i popierał dobrowolną sterylizację. Z tego powodu kilka instytucji usunęło jego nazwisko z nagród i budynków. Analiza jego pism nie wykazała poparcia dla dyskryminacji rasowej (Bodmer i in., 2021).
Dlaczego Fisher kwestionował związek palenia z rakiem płuc?
Uważał wnioski z ówczesnych danych obserwacyjnych za słabo uzasadnione. Stolley (1991) ocenia, że Fisher nie przeanalizował wszystkich danych, wyciągał wnioski przedwcześnie, był konsultantem przemysłu tytoniowego i sam palił.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikChi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bodmer, W., Bailey, R. A., Charlesworth, B., Eyre-Walker, A., Farewell, V., Mead, A., & Senn, S. (2021). The outstanding scientist, R.A. Fisher: his views on eugenics and race. Heredity, 126(4), 565–576. https://doi.org/10.1038/s41437-020-00394-6 ● Otwarty dostęp
- Fisher, R. A. (1936). The use of multiple measurements in taxonomic problems. Annals of Eugenics, 7(2), 179–188. https://doi.org/10.1111/j.1469-1809.1936.tb02137.x ● Otwarty dostęp
- Perezgonzalez, J. D. (2015). Fisher, Neyman-Pearson or NHST? A tutorial for teaching data testing. Frontiers in Psychology, 6, Article 223. https://doi.org/10.3389/fpsyg.2015.00223 ● Otwarty dostęp
- Senn, S. (2012). Tea for three: Of infusions and inferences and milk in first. Significance, 9(6), 30–33. https://doi.org/10.1111/j.1740-9713.2012.00620.x
- Stolley, P. D. (1991). When genius errs: R. A. Fisher and the lung cancer controversy. American Journal of Epidemiology, 133(5), 416–425. https://doi.org/10.1093/oxfordjournals.aje.a115904
- Yates, F. (1962). Sir Ronald Fisher, F.R.S. Nature, 195(4847), 1151–1152. https://doi.org/10.1038/1951151a0 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bodmer2021outstanding, author={Bodmer, Walter and Bailey, R. A. and Charlesworth, Brian and Eyre-Walker, Adam and Farewell, Vernon and Mead, Andrew and Senn, Stephen}, title={{The outstanding scientist, R.A. Fisher: his views on eugenics and race}}, journal={Heredity}, year={2021}, volume={126}, number={4}, pages={565--576}, doi={10.1038/s41437-020-00394-6}}@article{fisher1936use, author={Fisher, Ronald A.}, title={{The use of multiple measurements in taxonomic problems}}, journal={Annals of Eugenics}, year={1936}, volume={7}, number={2}, pages={179--188}, doi={10.1111/j.1469-1809.1936.tb02137.x}}@article{perezgonzalez2015fisher, author={Perezgonzalez, Jose D.}, title={{Fisher, Neyman-Pearson or NHST? A tutorial for teaching data testing}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={223}, doi={10.3389/fpsyg.2015.00223}}@article{senn2012tea, author={Senn, Stephen}, title={{Tea for three: Of infusions and inferences and milk in first}}, journal={Significance}, year={2012}, volume={9}, number={6}, pages={30--33}, doi={10.1111/j.1740-9713.2012.00620.x}}@article{stolley1991when, author={Stolley, Paul D.}, title={{When genius errs: R. A. Fisher and the lung cancer controversy}}, journal={American Journal of Epidemiology}, year={1991}, volume={133}, number={5}, pages={416--425}, doi={10.1093/oxfordjournals.aje.a115904}}@article{yates1962sir, author={Yates, F.}, title={{Sir Ronald Fisher, F.R.S.}}, journal={Nature}, year={1962}, volume={195}, number={4847}, pages={1151--1152}, doi={10.1038/1951151a0}}