Kim był William Sealy Gosset?
William Sealy Gosset (1876–1937) był piwowarem i eksperymentatorem w browarze Guinnessa w Dublinie, a statystykiem – z konieczności. Pracował tam od 1899 do 1935 r., kiedy przeniósł się do Londynu (Breathnach, 1993). Według Ziliaka (2011) przeszedł drogę od praktykanta piwowarskiego przez kierownika browaru doświadczalnego do głównego piwowara Guinnessa. Swoje najważniejsze prace podpisywał pseudonimem „Student”, dlatego jego nazwisko zna mniej osób niż test t Studenta, z którym spotyka się każdy student nauk empirycznych.
Box (1987) pokazuje, że to warunki pracy w browarze zmusiły Gosseta do zmierzenia się ze statystyką małych prób, do czego używał technik przejętych od Karla Pearsona. Ziliak (2008) podkreśla też, że od 1904 r. Gosset patrzył na niepewność jak przedsiębiorca: liczyło się, czy różnica jest opłacalna, a nie samo przekroczenie progu istotności.
Najważniejsze pomysły
- Rozkład średniej z małej próby (1908). W artykule „The probable error of a mean” w czasopiśmie Biometrika (Student, 1908) Gosset opisał, jak zachowuje się średnia podzielona przez odchylenie standardowe oszacowane z tej samej, małej próby. Dziś mówimy o rozkładzie t-Studenta z liczbą stopni swobody n − 1: ma grubsze ogony niż rozkład normalny, więc przy małym n wymaga większej wartości krytycznej.
- Symulacja przed komputerami. Hanley, Julien i Moodie (2008) przypominają, że Gosset sprawdzał swój wynik doświadczeniem losowania i ułożył tablicę do odczytu prawdopodobieństw.
- Doświadczenia polowe i laboratoryjne. W latach 1904–1937 prowadził małe, powtarzane doświadczenia z jęczmieniem i słodem na potrzeby kontroli jakości (Ziliak, 2011).
- Ekonomiczne podejście do istotności. Sama istotność statystyczna była dla niego prawie bezwartościowa, jeśli nie mówiła, czy różnica ma praktyczne znaczenie (Ziliak, 2008) – to wątek bliski dzisiejszej krytyce mechanicznego używania wartości p.
Przykład na historycznych danych
Zbiór sleep z pakietu datasets to – według pliku pomocy – dane Cushny’ego i Peeblesa (1905) użyte przez Studenta (1908): przyrost snu w godzinach (względem kontroli) u 10 pacjentów po dwóch środkach nasennych. Plik pomocy zaznacza, że zmienna group nie oznacza dwóch grup – to te same 10 osób, więc właściwy jest test t dla prób zależnych.
Średni przyrost snu wyniósł 0.75 h po środku 1 i 2.33 h po środku 2. Różnica w parze (środek 2 − środek 1) miała średnią 1.58 h i SD = 1.23, a błąd standardowy 0.389. Różnica była dodatnia u 9 z 10 osób, u jednej wynosiła zero, a największa – 4.6 h. Test dał t(9) = 4.06, p = .003, 95% przedział ufności [0.70, 2.46] h. To nasze przeliczenie w R; nie przytaczamy liczb z artykułu z 1908 r.
Dwa porównania pokazują, o co chodziło Studentowi. Gdyby błąd standardowy z 10 osób potraktować jak znany i odczytać p z rozkładu normalnego, wyszłoby p < .001 (około 0.00005) zamiast .003, a wartość krytyczna 1.960 zamiast 2.262 – mała próba wyglądałaby na pewniejszą, niż jest. Gdyby zaś te same dane policzyć jak dwie niezależne grupy (test Welcha), wyszłoby t(17.78) = 1.86, p = .079: zmienność między pacjentami zagłuszyłaby efekt widoczny w parach.
Na rysunku
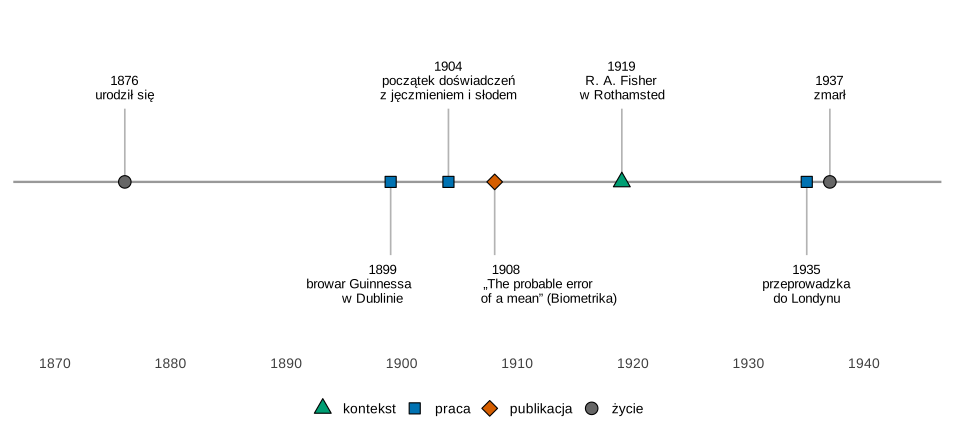
Co widać. Cała praca statystyczna Gosseta przypada na lata pracy dla Guinnessa (Ziliak, 2008): doświadczenia z jęczmieniem zaczynają się cztery lata przed artykułem o rozkładzie średniej, a od 1919 r. jego pomysły rozwija R. A. Fisher w stacji doświadczalnej Rothamsted (Box, 1987).
Na co uważać. Oś pokazuje tylko zdarzenia, których daty podają cytowane źródła. Nie ma na niej np. lat nauki u Karla Pearsona ani awansów w browarze, bo nie znaleźliśmy ich w źródłach, które mogliśmy przeczytać.
Podpis do pracy:
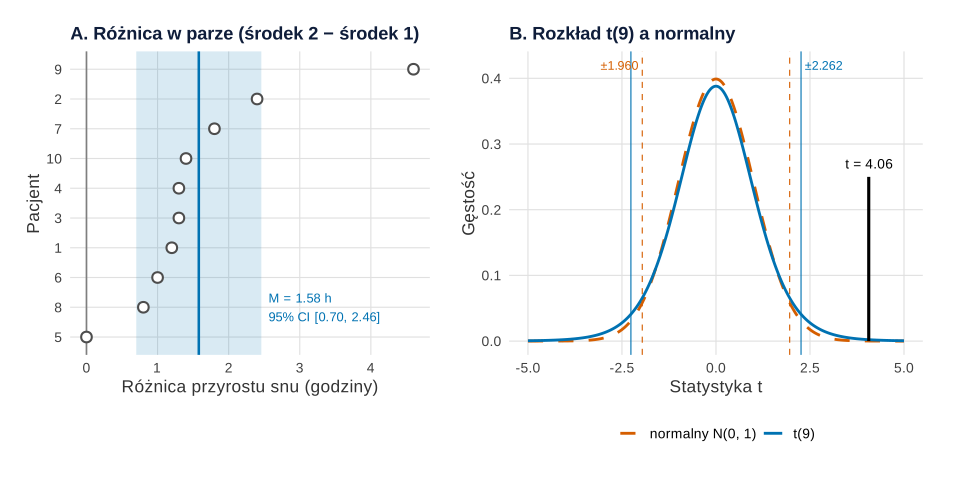
datasets::sleep): różnice w parach (A) i rozkład t(9) na tle normalnego (B). Obliczenia i rysunek: R, pakiety ggplot2 i patchwork (dane historyczne, bez losowania).Co widać. Na panelu A dziewięć punktów leży na prawo od zera, a przedział ufności średniej różnicy nie obejmuje zera. Panel B pokazuje różnicę, którą opisał Student: krzywa t(9) jest niższa w środku i ma grubsze ogony, więc wartość krytyczna przesuwa się z 1.960 do 2.262. Obserwowane t = 4.06 leży daleko w ogonie obu rozkładów.
Na co uważać. Przy 10 parach jedna skrajna osoba (różnica 4.6 h) mocno wpływa na średnią i SD. Test zakłada, że różnice pochodzą z rozkładu zbliżonego do normalnego; tego założenia 10 punktów praktycznie nie pozwala sprawdzić. Rysunek nie mówi też nic o tym, który środek został podany jako pierwszy.
Podpis do pracy:
Gdzie spotkasz Gosseta w swojej pracy
Za każdym razem, gdy porównujesz średnie testem t – jednej próby, dwóch grup czy dwóch pomiarów tych samych osób – korzystasz z wyniku Studenta. Rozkład t stoi też za przedziałem ufności dla średniej i za testami współczynników w regresji liniowej. W praktyce:
- w wynikach podajesz t, liczbę stopni swobody i p, np. t(9) = 4.06, p = .003 – kolejne kroki pokazuje wpis Test t Studenta krok po kroku;
- przy pomiarach przed i po analizujesz różnice w parach, a nie dwie grupy – dlaczego to tak dużo zmienia, pokazuje wpis Próby zależne w obrazkach;
- dwie niezależne grupy porównujesz domyślnie testem Welcha, który uogólnia problem Studenta na nierówne wariancje (zob. test t dla prób niezależnych).
Spory, mity i trudne strony
- Pseudonim. Zwykle opowiada się, że browar zakazywał pracownikom publikowania. Ziliak (2008) pisze ostrożniej: pracodawca wymagał, by tożsamość autora pozostała ukryta przed konkurencją. Nie wiemy z cytowanych źródeł, skąd wziął się akurat „Student”.
- Czy t wymyślił sam Gosset? Nie do końca. Hanley i in. (2008) przypominają, że Gosset wyprowadził rozkład innej statystyki (oznaczanej z), brakujący dowód dostarczył 22-letni R. A. Fisher, a przejście do dzisiejszego t nastąpiło później we współpracy obu. Box (1987) opisuje, jak Fisher od razu dostrzegł znaczenie pracy Studenta i rozszerzał jej zastosowania.
- Losowo czy zrównoważenie? Według Ziliaka (2011) Gosset uważał plany zrównoważone za wydajniejsze od losowych i odrzucał sztywne reguły co do wielkości próby i poziomu istotności. To stanowisko odmienne od dzisiejszego standardu, w którym podstawą eksperymentu jest randomizacja; spór dotyczy planowania doświadczeń, nie samego testu t.
Test Studenta na danych sleep w R
Kod wczytuje dane snu Cushny’ego i Peeblesa z pakietu datasets, liczy test t dla par, porównuje go z odczytem z rozkładu normalnego i z błędnym testem dla grup niezależnych, a na końcu rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Test t dla par na danych sleep: rysunek 2
Kod R rysunku 2
# William Sealy Gosset („Student”): przyrost snu u 10 pacjentów (datasets::sleep) – test t dla par
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(t = "#0072B2", norm = "#D55E00", dane = "grey30")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(sleep, package = "datasets")
# extra – przyrost snu w godzinach względem kontroli; group – podany środek (1 albo 2); ID – pacjent
s1 <- sleep$extra[sleep$group == "1"]
s2 <- sleep$extra[sleep$group == "2"]
stopifnot(identical(sleep$ID[sleep$group == "1"], sleep$ID[sleep$group == "2"]))   # te same osoby w tej samej kolejności
d <- s2 - s1                                                                         # różnica w parze: środek 2 − środek 1
n <- length(d)
round(c(n = n, M_srodek1 = mean(s1), M_srodek2 = mean(s2), M_roznicy = mean(d),
        SD_roznicy = sd(d), SE = sd(d) / sqrt(n), dodatnie = sum(d > 0), zerowe = sum(d == 0), max_roznica = max(d)), 3)
test <- t.test(s2, s1, paired = TRUE)
round(c(t = unname(test$statistic), df = unname(test$parameter), p = test$p.value,
        CI_dolna = test$conf.int[1], CI_gorna = test$conf.int[2]), 4)
# Wartości krytyczne i p, gdyby błąd standardowy z 10 osób uznać za znany (rozkład normalny zamiast t)
round(c(kryt_t9 = qt(.975, df = n - 1), kryt_normalny = qnorm(.975)), 4)
signif(c(p_t9 = test$p.value, p_normalny = 2 * pnorm(-abs(unname(test$statistic)))), 3)
# Ten sam zbiór policzony (błędnie) jak dwie niezależne grupy – test Welcha
welch <- t.test(s2, s1)
round(c(t_welch = unname(welch$statistic), df_welch = unname(welch$parameter), p_welch = welch$p.value), 4)

# Rysunek 2A: różnice w parach ze średnią i 95% CI
dd <- data.frame(pacjent = factor(1:n, levels = order(d)), d = d)
pA <- ggplot(dd, aes(d, pacjent)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  annotate("rect", xmin = test$conf.int[1], xmax = test$conf.int[2], ymin = -Inf, ymax = Inf, fill = kol[["t"]], alpha = 0.15) +
  geom_vline(xintercept = mean(d), colour = kol[["t"]], linewidth = 0.9) +
  geom_point(size = 3, shape = 21, fill = "white", colour = kol[["dane"]], stroke = 1.1) +
  annotate("text", x = test$conf.int[2] + 0.1, y = 2, label = sprintf("M = %.2f h\n95%% CI [%.2f, %.2f]", mean(d), test$conf.int[1], test$conf.int[2]),
           size = 3.4, hjust = 0, colour = kol[["t"]]) +
  labs(title = "A. Różnica w parze (środek 2 − środek 1)", x = "Różnica przyrostu snu (godziny)", y = "Pacjent") +
  motyw
# Rysunek 2B: rozkład t(9) i normalny standardowy; obserwowane t i wartości krytyczne
x <- seq(-5, 5, by = 0.02)
gest <- rbind(data.frame(x = x, y = dt(x, df = n - 1), rozklad = "t(9)"),
              data.frame(x = x, y = dnorm(x), rozklad = "normalny N(0, 1)"))
pB <- ggplot(gest, aes(x, y, colour = rozklad, linetype = rozklad)) +
  geom_line(linewidth = 1) +
  geom_vline(xintercept = c(-1, 1) * qt(.975, n - 1), colour = kol[["t"]], linetype = "solid", linewidth = 0.4) +
  geom_vline(xintercept = c(-1, 1) * qnorm(.975), colour = kol[["norm"]], linetype = "dashed", linewidth = 0.4) +
  annotate("segment", x = unname(test$statistic), xend = unname(test$statistic), y = 0, yend = 0.25, linewidth = 1.1, colour = "black") +
  annotate("text", x = unname(test$statistic), y = 0.27, label = sprintf("t = %.2f", unname(test$statistic)), size = 3.6) +
  annotate("text", x = qt(.975, n - 1), y = 0.42, label = sprintf("±%.3f", qt(.975, n - 1)), colour = kol[["t"]], size = 3.3, hjust = -0.1) +
  annotate("text", x = -qnorm(.975), y = 0.42, label = "±1.960", colour = kol[["norm"]], size = 3.3, hjust = 1.1) +
  scale_colour_manual(values = c("t(9)" = kol[["t"]], "normalny N(0, 1)" = kol[["norm"]]), name = NULL) +
  scale_linetype_manual(values = c("t(9)" = "solid", "normalny N(0, 1)" = "dashed"), name = NULL) +
  labs(title = "B. Rozkład t(9) a normalny", x = "Statystyka t", y = "Gęstość") +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1, 1.15))
p2
Wynik w R
          n   M_srodek1   M_srodek2   M_roznicy  SD_roznicy          SE
     10.000       0.750       2.330       1.580       1.230       0.389
   dodatnie      zerowe max_roznica
      9.000       1.000       4.600
       t       df        p CI_dolna CI_gorna
  4.0621   9.0000   0.0028   0.7001   2.4599
      kryt_t9 kryt_normalny
       2.2622        1.9600
      p_t9 p_normalny
  2.83e-03   4.86e-05
 t_welch df_welch  p_welch
  1.8608  17.7765   0.0794
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: William Sealy Gosset („Student”), 1876–1937 – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1876, 1899, 1904, 1908, 1919, 1935, 1937),
  opis = c("urodził się", "browar Guinnessa\nw Dublinie", "początek doświadczeń\nz jęczmieniem i słodem",
           "„The probable error\nof a mean” (Biometrika)", "R. A. Fisher\nw Rothamsted", "przeprowadzka\ndo Londynu", "zmarł"),
  rodzaj = c("życie", "praca", "praca", "publikacja", "kontekst", "praca", "życie"))
zdarzenia$strona <- rep(c(1, -1), length.out = nrow(zdarzenia))   # etykiety na przemian nad i pod osią
zdarzenia$wyrownanie <- c(0.5, 0.8, 0.5, 0.1, 0.5, 0.5, 0.5)         # rozsunięcie bliskich etykiet (1899 i 1908)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "kontekst" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "kontekst" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = 0.55 * strona), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 4, colour = "black") +
  geom_text(aes(y = 0.62 * strona, label = paste0(rok, "\n", opis), vjust = ifelse(strona > 0, 0, 1), hjust = wyrownanie), size = 3.5, lineheight = 0.9) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1870, 1943), breaks = seq(1870, 1940, by = 10)) +
  scale_y_continuous(limits = c(-1.15, 1.15)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test t – funkcja t.test() z pakietu stats; dane – pakiet datasets; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był William Sealy Gosset?
Piwowarem i eksperymentatorem w browarze Guinnessa w Dublinie (pracował tam od 1899 do 1935 r., potem w Londynie), który zajmował się statystyką małych prób. Pod pseudonimem „Student” opublikował w 1908 r. artykuł „The probable error of a mean”, od którego wywodzi się test t.
Dlaczego test t nazywa się testem Studenta?
Bo Gosset podpisał artykuł z 1908 r. pseudonimem „Student”. Według Ziliaka (2008) pracodawca wymagał, by tożsamość autora pozostała ukryta przed konkurencją. „Student” to więc nie student – to pracownik browaru Guinnessa.
Czy Gosset sam wymyślił rozkład t?
W dużej części tak, ale nie w dzisiejszej postaci. Gosset wyprowadził rozkład pokrewnej statystyki z i sprawdzał go doświadczeniem losowania; brakujący dowód dostarczył R. A. Fisher, a przejście od z do t nastąpiło we współpracy obu (Hanley i in., 2008).
Jakie dane historyczne Studenta można przeliczyć w R?
Zbiór sleep z pakietu datasets: przyrost snu u 10 pacjentów po dwóch środkach nasennych (Cushny i Peebles), wykorzystany przez Studenta w 1908 r. Test t dla par daje na nim t(9) = 4.06, p = .003.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikPróby zależne w obrazkach
Te same 30 par dwoma testami, rozkład różnic, korelacja pomiarów od −.5 do .8, moc z symulacji i regresja do średniej – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Box, J. F. (1987). Guinness, Gosset, Fisher, and small samples. Statistical Science, 2(1), 45–52. https://doi.org/10.1214/ss/1177013437 ● Otwarty dostęp
- Breathnach, C. S. (1993). Student. Irish Journal of Psychological Medicine, 10(3), 164–165. https://doi.org/10.1017/s0790966700012659
- Hanley, J. A., Julien, M., & Moodie, E. E. M. (2008). Student’s z, t, and s: What if Gosset had R? The American Statistician, 62(1), 64–69. https://doi.org/10.1198/000313008x269602
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Ziliak, S. T. (2008). Retrospectives: Guinnessometrics: The economic foundation of “Student’s” t. Journal of Economic Perspectives, 22(4), 199–216. https://doi.org/10.1257/jep.22.4.199
- Ziliak, S. T. (2011). W.S. Gosset and some neglected concepts in experimental statistics: Guinnessometrics II. Journal of Wine Economics, 6(2), 252–277. https://doi.org/10.1017/s1931436100001632
Cytowania BibTeX
@article{box1987guinness, author={Box, Joan Fisher}, title={{Guinness, Gosset, Fisher, and small samples}}, journal={Statistical Science}, year={1987}, volume={2}, number={1}, pages={45--52}, doi={10.1214/ss/1177013437}}@article{breathnach1993student, author={Breathnach, Caoimhghin S.}, title={{Student}}, journal={Irish Journal of Psychological Medicine}, year={1993}, volume={10}, number={3}, pages={164--165}, doi={10.1017/s0790966700012659}}@article{hanley2008student, author={Hanley, James A. and Julien, Marilyse and Moodie, Erica E. M.}, title={{Student’s z, t, and s: What if Gosset had R?}}, journal={The American Statistician}, year={2008}, volume={62}, number={1}, pages={64--69}, doi={10.1198/000313008x269602}}@article{student1908probable, author={{Student}}, title={{The probable error of a mean}}, journal={Biometrika}, year={1908}, volume={6}, number={1}, pages={1--25}, doi={10.1093/biomet/6.1.1}}@article{ziliak2008retrospectives, author={Ziliak, Stephen T.}, title={{Retrospectives: Guinnessometrics: The economic foundation of “Student’s” t}}, journal={Journal of Economic Perspectives}, year={2008}, volume={22}, number={4}, pages={199--216}, doi={10.1257/jep.22.4.199}}@article{ziliak2011gosset, author={Ziliak, Stephen T.}, title={{W.S. Gosset and some neglected concepts in experimental statistics: Guinnessometrics II}}, journal={Journal of Wine Economics}, year={2011}, volume={6}, number={2}, pages={252--277}, doi={10.1017/s1931436100001632}}