Kim był Egon S. Pearson?
Egon Sharpe Pearson (1895–1980) to statystyk z University College London (UCL), współtwórca teorii testowania hipotez razem z Jerzym Neymanem. Urodził się 11 sierpnia 1895 r., zmarł 12 czerwca 1980 r. (Bartlett, 1981). Był synem Karla Pearsona, twórcy współczynnika korelacji i czasopisma Biometrika. Bartlett (1981) zaczyna swoje wspomnienie od rodziny i uznaje ją za ważny czynnik jego kariery.
Według Moore’a (1981) Egon dołączył w 1921 r. jako wykładowca do kierowanego przez ojca Działu Statystyki Stosowanej UCL. Karl Pearson przeszedł na emeryturę w 1933 r., a Egon – w 1960 r., jako profesor statystyki. Napisał około 128 prac, z czego mniej więcej dwie trzecie w Biometrice, którą redagował do 1966 r. (Moore podaje lata 1933–1966). Nie napisał podręcznika.
Najważniejsze pomysły
- Teoria testowania z Neymanem. Neyman spędził rok akademicki 1924/1925 w Londynie i poznał tam obu Pearsonów. Gdy był już w Paryżu, Egon napisał do niego z propozycją wspólnych badań nad budową testów (Domański, 2021). Współpraca, prowadzona głównie listownie, trwała od 1926 do 1934 r. (Moore, 1981). W pracach z 1928 r. w Biometrice uogólnili kryterium ilorazu wiarygodności (dziś test ilorazu wiarygodności). Domański (2021) zwraca uwagę, że klasę hipotez alternatywnych wniósł do tych rozważań już w 1926 r. W. S. Gosset („Student”). Podział ról opisuje tak: Pearson wskazywał problemy, a Neyman nadawał im matematyczną postać.
- Lemat Neymana–Pearsona (1933). Test porównuje hipotezę zerową z konkretną alternatywą. Przy ustalonym prawdopodobieństwie odrzucenia prawdziwej H0 szuka się obszaru krytycznego, który najczęściej odrzuca H0, gdy prawdziwa jest alternatywa (Neyman i Pearson, 1933; Domański, 2021). Stąd pojęcia błędu I i II rodzaju oraz mocy testu.
- Przedział Cloppera–Pearsona (1934). W pracy z C. J. Clopperem w Biometrice Pearson pokazał, jak wyznaczyć granice ufności dla odsetka w rozkładzie dwumianowym (Clopper i Pearson, 1934). Tę procedurę stosuje funkcja
binom.test()w R. - Statystyka w przemyśle. W 1931 r. odwiedził w USA m.in. Bell Telephone Laboratories, gdzie rozwijano kontrolę jakości. Potem do Londynu zaproszono z wykładami Waltera Shewharta (1932), a British Standards Institution wydała pod nazwiskiem Pearsona normę BS 600 o metodach statystycznych w normalizacji i kontroli jakości (Moore, 1981). Zob. kartę kontrolną Shewharta.
Przykład: przedział Cloppera–Pearsona
Fikcyjne dane: w próbie 20 sprawdzonych elementów 2 są wadliwe (10%). Przedział Cloppera–Pearsona (95%) wynosi [0.012, 0.317], a podręcznikowy przedział Walda – [−0.031, 0.231], czyli zawiera niemożliwy ujemny odsetek. Jak często te przedziały obejmują prawdziwy odsetek, sprawdziliśmy symulacją: 10 000 prób po n = 20 dla pięciu prawdziwych odsetków (wartości n i p wybrano ręcznie, ziarno 798). Przy p = .05 przedział Walda objął prawdę tylko w 64.1% prób, a Cloppera–Pearsona w 98.5%. Przy p = .10: 88.0% i 98.9%. Przy p = .50 oba miały 95.8%. Przedział Cloppera–Pearsona w żadnym punkcie nie zszedł poniżej 95%. Płaci za to szerokością: jest zachowawczy.
Na rysunku
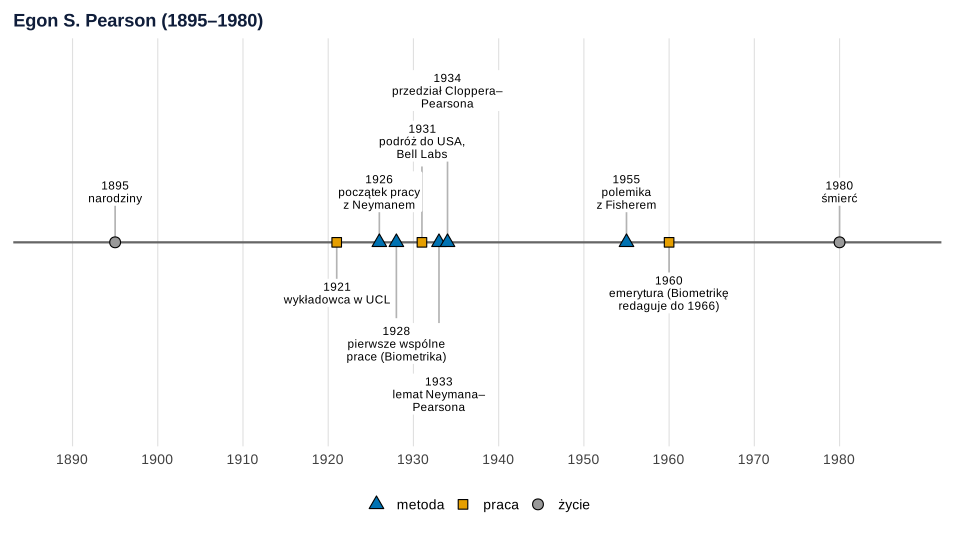
Co widać. Prawie wszystko, z czego Pearsona znają studenci, powstało w ciągu kilkunastu lat: od początku współpracy z Neymanem (1926) do przedziału Cloppera–Pearsona (1934). Kształt symbolu mówi, czy zdarzenie dotyczy metody, pracy zawodowej czy dat życia.
Na co uważać. Oś czasu upraszcza. Lata publikacji są pewne, ale np. początek współpracy z Neymanem źródła opisują jako proces (pobyt Neymana w Londynie, list do Paryża, korespondencja), a nie jedną datę.
Podpis do pracy:
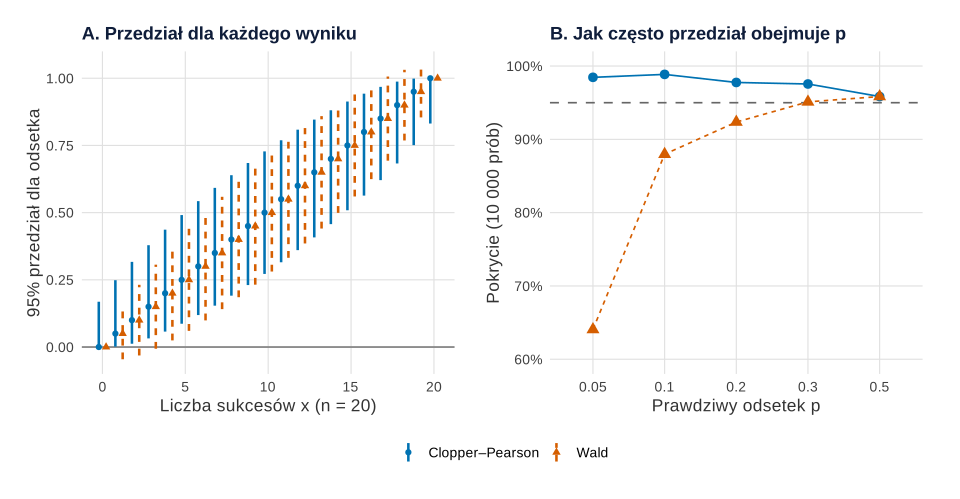
set.seed(798)).Co widać. Panel A to „pas ufności”: dla każdego możliwego wyniku od 0 do 20 sukcesów jeden przedział. Przy x = 0 przedział Walda ma zerową długość – twierdzi, że odsetek to dokładnie 0 – a Clopper–Pearson daje od 0 do 0.168. Panel B pokazuje skutek: przy odsetkach bliskich 0 przedział Walda często chybia, a Clopper–Pearson trzyma się powyżej 95%.
Na co uważać. Pokrycie powyżej 95% nie jest zaletą samo w sobie – to znak, że przedział jest szerszy, niż musi. Dlatego przy małych próbach częściej poleca się przedział Wilsona (zob. przedział ufności dla proporcji, gdzie porównujemy cztery metody na pełnej siatce odsetków). Wyniki symulacji mają błąd Monte Carlo rzędu kilku dziesiątych punktu procentowego.
Podpis do pracy:
Gdzie spotkasz Egona Pearsona w swojej pracy
- W rozdziale metodologicznym – gdy ustalasz α = .05 i planujesz liczebność próby tak, by moc wyniosła .80. To język Neymana i Pearsona: dwa rodzaje błędów i moc wobec konkretnej alternatywy.
- Przy odsetkach – gdy program podaje „dokładny” przedział dla proporcji. W pracy napisz, że to przedział Cloppera–Pearsona, i zastanów się, czy przy Twojej próbie nie lepszy jest przedział Wilsona.
- W porównaniu modeli – gdy używasz testu ilorazu wiarygodności, choćby przy porównaniu modeli zagnieżdżonych.
- W zastosowaniach przemysłowych – w kontroli jakości i kontroli odbiorczej (zob. wpis kontrola odbiorcza i krzywa OC).
Spory, mity i trudne strony
- Spór z Fisherem. R. A. Fisher w 1955 r. skrytykował podejście Neymana i Pearsona w artykule Statistical Methods and Scientific Induction. Pearson odpowiedział na tę krytykę w tym samym roku (Pearson, 1955). Czym różni się wartość p w ujęciu Fishera od decyzji w ujęciu Neymana–Pearsona, wyjaśniamy w haśle wartość p.
- Który Pearson? Korelacja Pearsona i test chi-kwadrat Pearsona to dzieło ojca, Karla. Lemat Neymana–Pearsona i przedział Cloppera–Pearsona – syna, Egona.
- „Dokładny” nie znaczy „najlepszy”. Przedział Cloppera–Pearsona jest dokładny w tym sensie, że korzysta wprost z rozkładu dwumianowego i gwarantuje pokrycie co najmniej nominalne. Nie jest najkrótszy.
Egon Pearson w R: przedział Cloppera–Pearsona
Kod tworzy oś czasu (rysunek 1), liczy przedział Cloppera–Pearsona i Walda dla 2 sukcesów na 20 prób, rysuje pas ufności dla wszystkich wyników i sprawdza pokrycie symulacją (rysunek 2). Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
Clopper–Pearson vs Wald przy n = 20
Kod R rysunków 1 i 2
# Egon S. Pearson: oś czasu i przedział Cloppera–Pearsona vs Walda przy n = 20
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(cp = "#0072B2", wald = "#D55E00", os = "grey40")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")

# 1. Oś czasu (lata z cytowanych źródeł)
zdarzenia <- data.frame(
  rok = c(1895, 1921, 1926, 1928, 1931, 1933, 1934, 1955, 1960, 1980),
  opis = c("narodziny", "wykładowca w UCL", "początek pracy\nz Neymanem", "pierwsze wspólne\nprace (Biometrika)",
           "podróż do USA,\nBell Labs", "lemat Neymana–\nPearsona", "przedział Cloppera–\nPearsona",
           "polemika\nz Fisherem", "emerytura (Biometrikę\nredaguje do 1966)", "śmierć"),
  rodzaj = c("życie", "praca", "metoda", "metoda", "praca", "metoda", "metoda", "metoda", "praca", "życie"),
  poziom = c(0.9, -0.9, 0.9, -1.8, 1.8, -2.7, 2.7, 0.9, -0.9, 0.9))
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = kol[["os"]], linewidth = 0.8) +
  geom_segment(aes(xend = rok, yend = poziom * 0.75), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.4) +
  geom_label(aes(y = poziom, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9,
             linewidth = 0, fill = "white") +
  scale_shape_manual(values = c(życie = 21, praca = 22, metoda = 24), name = NULL) +
  scale_fill_manual(values = c(życie = "grey60", praca = "#E69F00", metoda = "#0072B2"), name = NULL) +
  scale_x_continuous(breaks = seq(1890, 1980, 10), limits = c(1888, 1987)) +
  scale_y_continuous(limits = c(-3.3, 3.3)) +
  labs(x = NULL, y = NULL, title = "Egon S. Pearson (1895–1980)") + motyw +
  theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# 2. Przykład: 2 elementy wadliwe na 20 sprawdzonych (dane fikcyjne)
n <- 20; x <- 2; z <- qnorm(0.975)
wald <- function(x, n) { p <- x / n; se <- sqrt(p * (1 - p) / n); cbind(dol = p - z * se, gora = p + z * se) }
cp <- function(x, n) t(sapply(x, function(k) binom.test(k, n)$conf.int))   # binom.test = Clopper–Pearson
przyklad <- rbind(cp(x, n), wald(x, n))
dimnames(przyklad) <- list(c("Clopper_Pearson", "Wald"), c("dolna", "gorna"))
round(przyklad, 3)

# 3. Pas ufności: przedziały dla każdego możliwego wyniku x = 0, ..., 20
pas <- rbind(data.frame(x = 0:n, metoda = "Clopper–Pearson", setNames(as.data.frame(cp(0:n, n)), c("dol", "gora"))),
             data.frame(x = 0:n, metoda = "Wald", setNames(as.data.frame(wald(0:n, n)), c("dol", "gora"))))
pas$xs <- pas$x + ifelse(pas$metoda == "Wald", 0.22, -0.22)

# 4. Pokrycie z symulacji: 10 000 prób po n = 20 dla pięciu prawdziwych odsetków
set.seed(798)
p_prawdziwe <- c(0.05, 0.10, 0.20, 0.30, 0.50)
tab_cp <- cp(0:n, n); tab_w <- wald(0:n, n)          # przedziały dla x = 0..20; próba z wynikiem x bierze wiersz x + 1
pokrycie_tab <- do.call(rbind, lapply(p_prawdziwe, function(p) {
  xs <- rbinom(10000, n, p)
  data.frame(p = p, Clopper_Pearson = mean(tab_cp[xs + 1, 1] <= p & p <= tab_cp[xs + 1, 2]),
             Wald = mean(tab_w[xs + 1, 1] <= p & p <= tab_w[xs + 1, 2]))
}))
print(pokrycie_tab, row.names = FALSE)
pokrycie <- data.frame(p = rep(p_prawdziwe, 2), metoda = rep(c("Clopper–Pearson", "Wald"), each = 5),
                       pokrycie = c(pokrycie_tab$Clopper_Pearson, pokrycie_tab$Wald))

pA <- ggplot(pas, aes(xs, ymin = dol, ymax = gora, colour = metoda, linetype = metoda)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_linerange(linewidth = 0.9) +
  geom_point(aes(y = x / n, shape = metoda), size = 1.8) +
  scale_colour_manual(values = c("Clopper–Pearson" = kol[["cp"]], Wald = kol[["wald"]]), name = NULL) +
  scale_linetype_manual(values = c("Clopper–Pearson" = "solid", Wald = "22"), name = NULL) +
  scale_shape_manual(values = c("Clopper–Pearson" = 16, Wald = 17), name = NULL) +
  labs(x = "Liczba sukcesów x (n = 20)", y = "95% przedział dla odsetka",
       title = "A. Przedział dla każdego wyniku") + motyw
pB <- ggplot(pokrycie, aes(factor(p), pokrycie, colour = metoda, shape = metoda, group = metoda)) +
  geom_hline(yintercept = 0.95, linetype = "dashed", colour = "grey40") +
  geom_line(aes(linetype = metoda)) + geom_point(size = 3) +
  scale_colour_manual(values = c("Clopper–Pearson" = kol[["cp"]], Wald = kol[["wald"]]), name = NULL, guide = "none") +
  scale_linetype_manual(values = c("Clopper–Pearson" = "solid", Wald = "22"), name = NULL, guide = "none") +
  scale_shape_manual(values = c("Clopper–Pearson" = 16, Wald = 17), name = NULL, guide = "none") +
  scale_y_continuous(labels = function(v) paste0(round(100 * v), "%"), limits = c(0.6, 1), breaks = seq(0.6, 1, 0.1)) +
  labs(x = "Prawdziwy odsetek p", y = "Pokrycie (10 000 prób)", title = "B. Jak często przedział obejmuje p") + motyw
p_metoda <- (pA + pB) + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p_os
p_metoda
Wynik w R
                 dolna gorna
Clopper_Pearson  0.012 0.317
Wald            -0.031 0.231
    p Clopper_Pearson   Wald
 0.05          0.9846 0.6406
 0.10          0.9886 0.8797
 0.20          0.9776 0.9236
 0.30          0.9755 0.9511
 0.50          0.9584 0.9584
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przedział Cloppera–Pearsona – funkcja binom.test(), losowanie – rbinom(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Egon Pearson?
Statystykiem z University College London (1895–1980), synem Karla Pearsona. Z Jerzym Neymanem stworzył teorię testowania hipotez z błędami I i II rodzaju i mocą testu, z C. J. Clopperem – przedział ufności dla odsetka. Redagował Biometrikę i propagował statystykę w kontroli jakości.
Czym różni się Egon Pearson od Karla Pearsona?
Karl (ojciec) stworzył m.in. współczynnik korelacji i test chi-kwadrat oraz założył Biometrikę. Egon (syn) jest współautorem lematu Neymana–Pearsona, pojęcia mocy testu i przedziału Cloppera–Pearsona. Gdy czytasz „korelacja Pearsona”, chodzi o ojca; „Neyman i Pearson” – o syna.
Co mówi lemat Neymana–Pearsona?
Przy porównaniu dwóch prostych hipotez i ustalonym ryzyku błędu I rodzaju najmocniejszy test, czyli ten, który najczęściej wykrywa prawdziwą alternatywę, opiera się na ilorazie wiarygodności obu hipotez. Z tego podejścia wywodzą się pojęcia błędu II rodzaju i mocy.
Dlaczego przedział Cloppera–Pearsona nazywa się dokładnym?
Bo korzysta wprost z rozkładu dwumianowego, a nie z przybliżenia normalnego, i gwarantuje pokrycie co najmniej 95%. W symulacji z n = 20 miał pokrycie od 95.8% do 98.9%, czyli jest zachowawczy i szerszy, niż musi; przy małych próbach często poleca się przedział Wilsona.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kontrola odbiorcza i krzywa OC
Huta szkła i przetwórnia: plan (n, c) z ryzyka α i β, krzywa OC, AOQL, plan podwójny i sezon z dryfem jakości – z kodem R.
Czytaj →PoradnikWartość p – interpretacja
Błędne odczytania p na jednym przykładzie, symulacja p pod H0 i H1, replikacje, p a przedział ufności i wielkość efektu – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bartlett, M. S. (1981). Egon Sharpe Pearson, 11 August 1895 – 12 June 1980. Biographical Memoirs of Fellows of the Royal Society, 27(27), 425–443. https://doi.org/10.1098/rsbm.1981.0017
- Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404–413. https://doi.org/10.1093/biomet/26.4.404
- Domański, C. (2021). The beginnings of Jerzy Spława-Neyman’s scientific work. Wiadomości Statystyczne. The Polish Statistician, 66(12), 98–113. https://doi.org/10.5604/01.3001.0015.6657 ● Otwarty dostęp
- Moore, P. G. (1981). Egon Sharpe Pearson. Journal of the Institute of Actuaries, 108(1), 115–116. https://doi.org/10.1017/s0020268100040695 ● Otwarty dostęp
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694–706), 289–337. https://doi.org/10.1098/rsta.1933.0009 ● Otwarty dostęp
- Pearson, E. S. (1955). Statistical concepts in their relation to reality. Journal of the Royal Statistical Society: Series B (Methodological), 17(2), 204–207. https://doi.org/10.1111/j.2517-6161.1955.tb00194.x
Cytowania BibTeX
@article{bartlett1981egon, author={Bartlett, Maurice Stevenson}, title={{Egon Sharpe Pearson, 11 August 1895 – 12 June 1980}}, journal={Biographical Memoirs of Fellows of the Royal Society}, year={1981}, volume={27}, number={27}, pages={425--443}, doi={10.1098/rsbm.1981.0017}}@article{clopper1934use, author={Clopper, C. J. and Pearson, Egon S.}, title={{The use of confidence or fiducial limits illustrated in the case of the binomial}}, journal={Biometrika}, year={1934}, volume={26}, number={4}, pages={404--413}, doi={10.1093/biomet/26.4.404}}@article{domanski2021beginnings, author={Domański, Czesław}, title={{The beginnings of Jerzy Spława-Neyman’s scientific work}}, journal={Wiadomości Statystyczne. The Polish Statistician}, year={2021}, volume={66}, number={12}, pages={98--113}, doi={10.5604/01.3001.0015.6657}}@article{moore1981egon, author={Moore, P. G.}, title={{Egon Sharpe Pearson}}, journal={Journal of the Institute of Actuaries}, year={1981}, volume={108}, number={1}, pages={115--116}, doi={10.1017/s0020268100040695}}@article{neyman1933problem, author={Neyman, Jerzy and Pearson, Egon S.}, title={{On the problem of the most efficient tests of statistical hypotheses}}, journal={Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character}, year={1933}, volume={231}, number={694–706}, pages={289--337}, doi={10.1098/rsta.1933.0009}}@article{pearson1955statistical, author={Pearson, Egon S.}, title={{Statistical concepts in their relation to reality}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1955}, volume={17}, number={2}, pages={204--207}, doi={10.1111/j.2517-6161.1955.tb00194.x}}