Przykład: huta, przetwórnia i partie po 5000 słoików
Fikcyjna huta szkła dostarcza fikcyjnej przetwórni owoców słoiki 720 ml w partiach po 5000 sztuk. Słoik z wadą (odprysk na koronie, pęcherz w szkle, krzywy gwint) to nieszczelne zamknięcie i reklamacja dżemu. Przetwórnia nie sprawdza każdego słoika. Bierze z partii losową próbę, liczy wady i decyduje: przyjąć partię czy odesłać ją do sortowania. Pytanie: ile słoików sprawdzić i ile wad jeszcze tolerować.
W umowie strony zapisały dwa punkty. AQL = 0.5% wad: partia tak dobra ma przejść z prawdopodobieństwem co najmniej 95% – ryzyko dostawcy α ≤ 5%. LTPD = 3% wad: partia tak zła może przejść najwyżej z prawdopodobieństwem 10% – ryzyko odbiorcy β ≤ 10%. Te liczby ustaliliśmy ręcznie, po porównaniu czterech par. Sezon dostaw jest symulowany, więc znamy prawdziwą liczbę wad w każdej partii. Dane pobierzesz jako kontrola-odbiorcza-partie.csv.
Ten wpis dotyczy kontroli odbiorczej – decyzji o partii. Czy sam proces huty mieści się w tolerancji, mierzy wskaźnik zdolności – zob. zdolność procesu Cp i Cpk.
Rysunek 1: plan (n, c) i krzywa OC
Plan pojedynczy (n, c): wylosuj n słoików, policz wady d; gdy d ≤ c – przyjmij partię, w przeciwnym razie odrzuć. Liczba wad w próbie bez zwracania ma rozkład hipergeometryczny, więc prawdopodobieństwo przyjęcia partii z D wadliwymi słoikami to:
Wykres Pa względem odsetka wad w partii to krzywa OC (charakterystyka operacyjna). Dla naszych warunków pętla z sekcji 3 daje plan n = 219, c = 3.
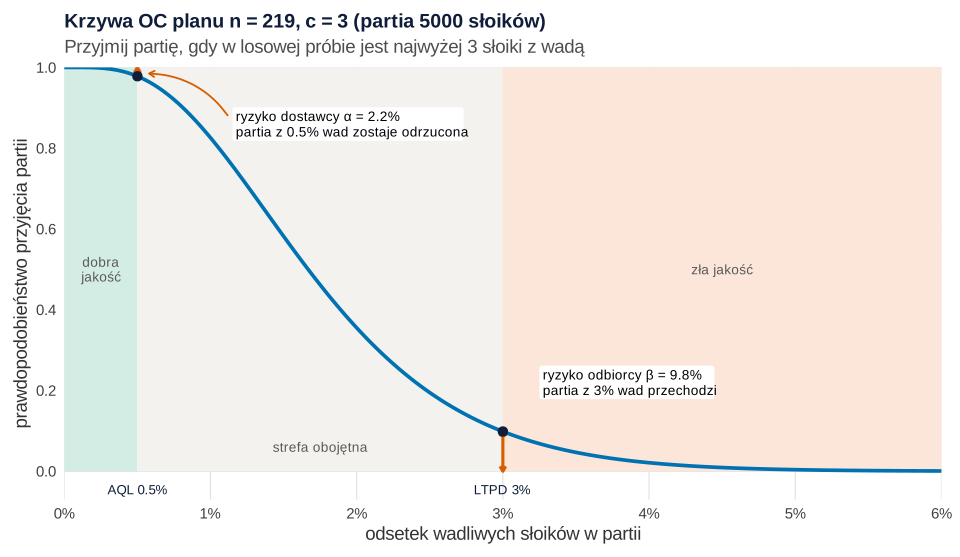
Co widać. Partia z 0.5% wad przechodzi z prawdopodobieństwem .978 (α = 2.2%), partia z 3% wad – z prawdopodobieństwem .098 (β = 9.8%). Pomiędzy leży strefa obojętna: przy 1% wad plan przyjmuje 82.6% partii, przy 1.5% – 58.2%, przy 2% – 35.5%. Poniżej 50% szansy na przyjęcie schodzi dopiero partia z 84 wadliwymi słoikami (1.68%). To obraz dwóch błędów z testowania hipotez: α to błąd I rodzaju dla dostawcy, a 1 − β – moc wykrycia złej partii.
Jak może zmylić. Kontrola każdego słoika dałaby schodek; każdy plan na próbie ma pochyłą krzywą. Nachylenie zależy prawie wyłącznie od n i c, nie od wielkości partii (sekcja 2).
Podpis do pracy:
Rysunek 2: ile daje c i kiedy liczy się wielkość partii
Panel A pokazuje trzy plany, które chronią odbiorcę tak samo (β ≈ 10% przy 3% wad), ale mają różne c. Panel B – jak plan n = 219, c = 3 działa w partiach od 300 do 10 000 słoików, gdy liczymy dokładnie (losowanie bez zwracania) i rozkładem dwumianowym, który wielkości partii nie zna.
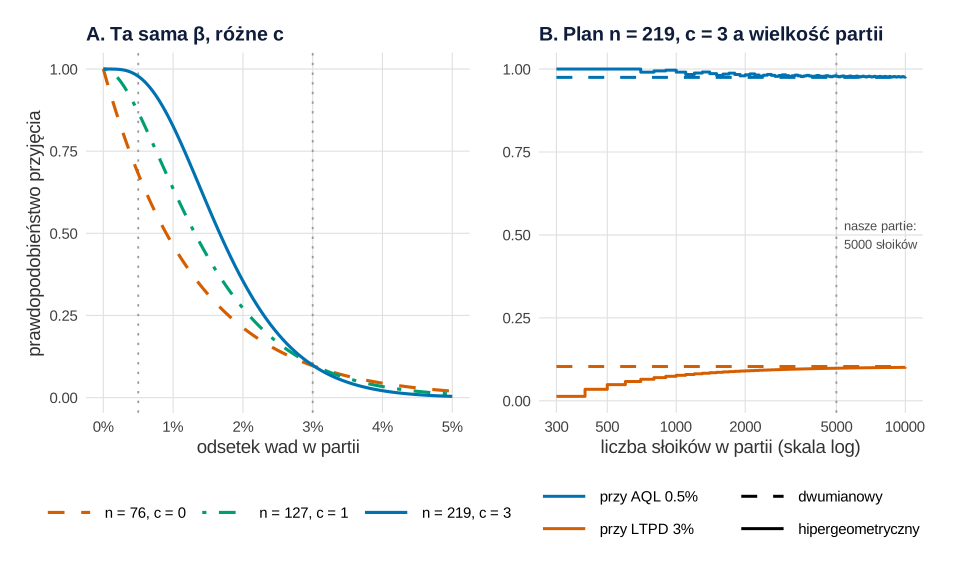
Co widać. Plan „zero wad” (n = 76, c = 0) odrzuca 31.9% partii o jakości AQL; plan z c = 1 – 13.2%, a z c = 3 – 2.2%. Większe c wymaga większej próby, ale krzywa robi się bardziej stroma i dobre partie przestają wracać do huty. W panelu B przy partii 5000 słoików różnica między rozkładami jest mała: β = 9.8% wobec 10.4%. Przy partii 500 słoików próba to 43.8% partii i β spada do 4.9%, przy 300 – do 1.4%.
Jak może zmylić. Ząbki w panelu B wynikają z zaokrąglenia liczby wadliwych słoików do całości. Przybliżenie dwumianowe jest ostrożne dla odbiorcy (zawyża β), więc przy dużych partiach można go używać. Przy małych partiach licz dokładnie, inaczej przepłacasz próbą (Hald, 1967, porównał rozwiązania dla trzech rozkładów; Guenther, 1969, dobór planów z ich tablic). Por. wielkość próby a wielkość populacji.
Podpis do pracy:
Rysunek 3: dobór n i c pętlą
Klasyczne zadanie: znaleźć najmniejsze c i najmniejsze n, przy których dobra partia przechodzi z prawdopodobieństwem co najmniej 1 − α, a zła – najwyżej z prawdopodobieństwem β (Grubbs, 1949; Hald, 1967). Nie potrzeba tablic. Dla każdego c od 0 do 8 szukamy najmniejszego n, przy którym β ≤ 10%, i największego n, przy którym α ≤ 5%.
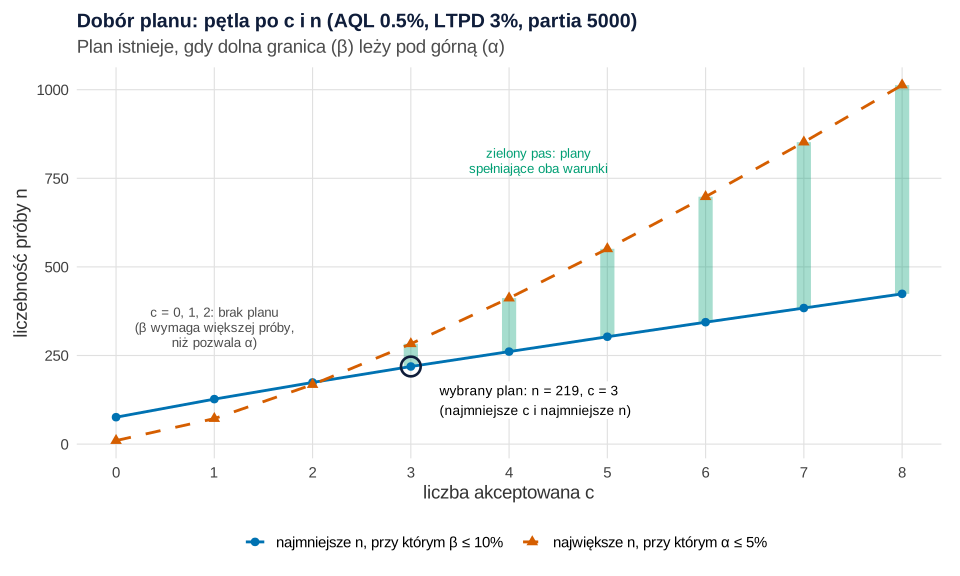
Co widać. Dla c = 0, 1 i 2 warunku β nie da się pogodzić z warunkiem α: przy c = 2 trzeba co najmniej 174 słoików, a α pozwala najwyżej na 168. Pierwszy wykonalny jest c = 3 (n od 219 do 283). Bierzemy najmniejsze n: 219. Pakiet AcceptanceSampling robi to gotową funkcją; pętla z phyper() pokazuje mechanikę.
Jak może zmylić. Plan zależy przede wszystkim od ilorazu LTPD/AQL. Gdy odbiorca zaostrza LTPD przy tym samym AQL, próba szybko rośnie: LTPD 4% – n = 131, c = 2; 3% – 219 i 3; 2% – 390 i 4; 1.5% – 679 i 6. Pokaż tę analizę wrażliwości obu stronom umowy, zanim podpiszą liczby.
Zdanie do Wyników:
Rysunek 4: jakość, która trafia na linię (AOQ i AOQL)
Załóżmy umowę „odrzucona partia wraca do huty na sortowanie 100%, wadliwe słoiki są wymieniane”. Wtedy na linię rozlewniczą trafia albo partia przyjęta (z wadami spoza próby), albo partia czysta. Średnia jakość wychodząca (AOQ) to oczekiwany odsetek wad na linii; jej maksimum po wszystkich poziomach jakości huty to AOQL. Średnia liczba sprawdzonych słoików na partię to ATI. Dodge i Romig (1929) zbudowali plany właśnie wokół takiej ochrony odbiorcy przy możliwie małym koszcie kontroli.
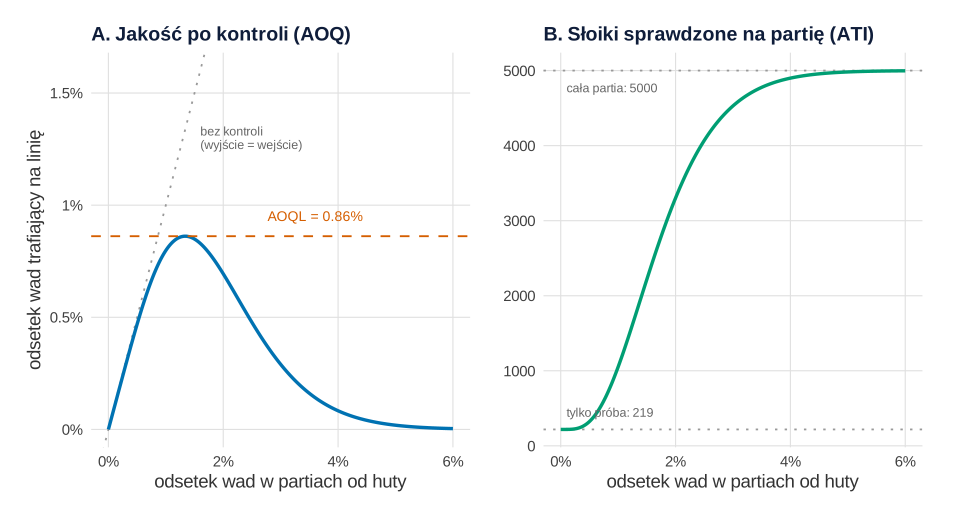
Co widać. AOQL wynosi 0.86% i pojawia się, gdy huta dostarcza 1.34% wad: plan przyjmuje wtedy 66.2% partii. Przy 1% wad na linię trafia średnio 0.80%, przy 2% – 0.69%, przy 3% – tylko 0.29%, bo prawie każda partia idzie do sortowania. Cena: średnio 324 sprawdzone słoiki na partię przy AQL, 3302 przy 2% i 4530 przy 3%.
Jak może zmylić. AOQL to gwarancja średnia w długim okresie, nie dla pojedynczej partii – jedna przyjęta partia może mieć 2% wad. Działa tylko wtedy, gdy odrzucone partie naprawdę są sortowane, a nie wysyłane ponownie bez zmian.
Podpis do pracy:
Rysunek 5: plan podwójny
W planie podwójnym bierzesz najpierw mniejszą próbę. Wynik wyraźnie dobry lub wyraźnie zły kończy kontrolę; tylko wynik pośredni wymaga drugiej próby. Ta sama pętla (n1 = n2 od 50 do 250, c1 < c2, kryterium – najmniejsza średnia próba przy AQL) dała plan: 134 słoiki; przy 0–1 wadzie przyjmij, przy 4 i więcej odrzuć, przy 2–3 weź kolejne 134 i przyjmij, gdy łącznie jest najwyżej 3 wady.
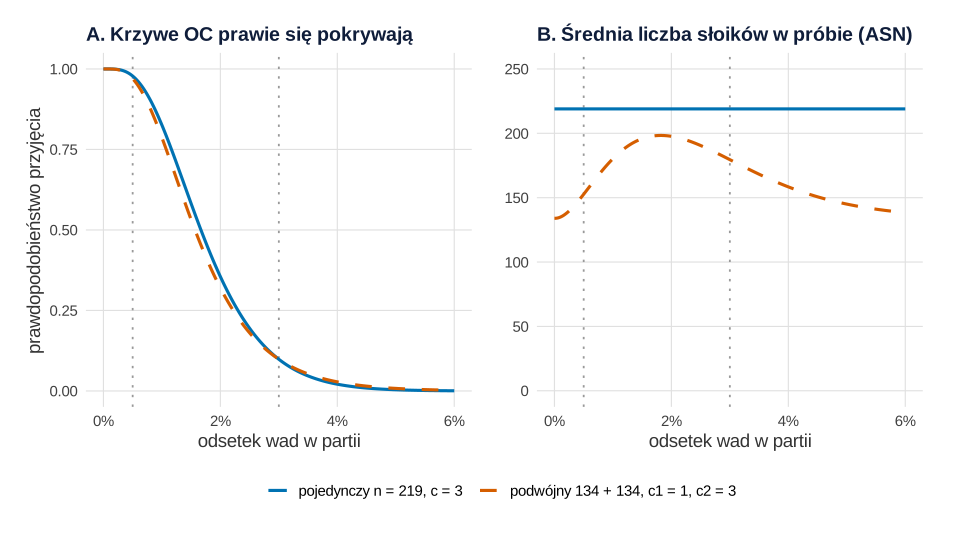
Co widać. Plan podwójny ma α = 3.0% i β = 9.8% – prawie tę samą krzywą OC. Przy dobrej hucie (0.5% wad) druga próba jest potrzebna w 14.0% partii, a średnio sprawdza się 153 słoiki zamiast 219. Nawet w najgorszym miejscu (1.82% wad) średnia próba to 198.
Jak może zmylić. Oszczędność jest średnia: czasem trzeba sprawdzić 268 słoików i poczekać na drugą próbę.
Rysunek 6: sezon, w którym zużywa się forma
Symulacja sezonu: 120 partii (ok. 6 dostaw tygodniowo przez 20 tygodni). Do partii 60 huta daje średnio 0.4% wad. Potem zużywa się forma i średnia rośnie liniowo do 2.8% w partii 120; odsetek wad różni się też losowo między partiami. Parametry ustawiliśmy ręcznie, ziarna 757 i 7576 – raz. Obok planu przetwórnia prowadzi kartę CUSUM na liczbie wad w kolejnych próbach – sumę skumulowaną, której pomysł pochodzi od Page’a (1954).
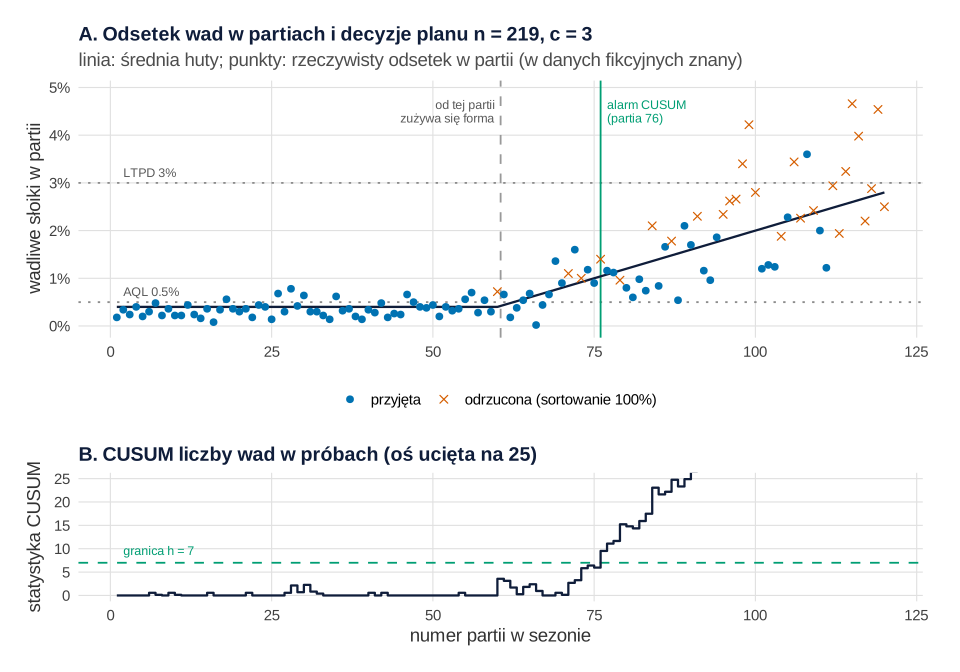
set.seed(757)).Co widać. W partiach 1–60 plan odrzucił 1 partię, w partiach 61–120 – 26. Pierwsze odrzucenie po zmianie przyszło w partii 71. Spośród 22 partii z ponad 2% wad przeszły 3, spośród 8 z ponad 3% – 1. Na linię trafiło w drugiej połowie sezonu 0.62% wad wobec 1.77% w dostawach, ale kosztem 137 446 sprawdzonych słoików (w pierwszej połowie: 17 921). CUSUM (odniesienie 0.4% wad, alarm przy przesunięciu do 1%, granica h = 7) dała sygnał w partii 76 i ani razu w partiach 1–60. W 2000 symulowanych sezonach bez dryfu fałszywy alarm pojawił się w 5.8% (błąd Monte Carlo 0.5 pp).
Jak może zmylić. Plan ocenia każdą partię osobno, więc dryf widzi jako serię pojedynczych odrzuceń. Trend pokazują dopiero połączone próby: w partiach 1–60 było 47 wad w 13 140 słoikach (0.36%, 95% CI [0.27, 0.48]%), w partiach 101–120 – 124 wady w 4380 słoikach (2.83%, 95% CI [2.38, 3.37]%). To przedziały Wilsona, zalecane zamiast przedziału Walda (Brown i in., 2001).
Zdanie do Wyników:
Co z tym zrobić w firmie
- Negocjuj krzywą, nie jedną liczbę. Zapisz w umowie AQL z α i LTPD z β, a obu stronom pokaż krzywą OC i tabelę wrażliwości (rysunki 1 i 3).
- Losuj słoiki z całej partii – z różnych warstw palet i różnych tacek, według numerów wylosowanych przed rozpakowaniem (zob. dobór losowy prosty).
- Ustal, co dzieje się z odrzuconą partią. AOQL = 0.86% obowiązuje tylko przy sortowaniu 100% (rysunek 4).
- Zbieraj wyniki prób w szereg czasowy. Karta kontrolna na liczbie wad wykryje dryf wcześniej niż pojedyncze odrzucenia (rysunek 6; zob. też anomalie w KPI).
- Wymagaj od huty dowodów stabilności procesu. Gdy proces dostawcy jest pod kontrolą kart, kontrola wejściowa staje się wyborem „wszystko albo nic”: albo 100%, albo żadnej – tak brzmi kryterium Deminga (Papadakis, 1985).
- Wady ukryte – te, które wyjdą dopiero w użytkowaniu – liczy się inaczej: zob. roszczenia gwarancyjne i rozkład Weibulla.
Więcej przykładów z magazynu i dostaw: statystyka w pracy z logistyki i wpis o popycie sporadycznym.
Jak opisać w pracy
Podaj wielkość partii, AQL i LTPD z α i β, rozkład, sposób losowania, regułę decyzji i los partii odrzuconej.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, warunki umowy i funkcje prawdopodobieństwa przyjęcia, z których korzystają kolejne. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 757 (sezon 120 partii) i 7576 (2000 sezonów bez dryfu) w przepisie 6, 7577 w przepisie 7 (10 000 partii z wadami w tackach na każdy z trzech poziomów wad); przepisy 1–5 i 8 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: wielkość partii (5000), AQL = 0.5% z α ≤ 5% i LTPD = 3% z β ≤ 10% (przepis 1); w symulacji – 120 partii, średnio 0.4% wad do partii 60 i liniowy wzrost do 2.8% w partii 120, zmienność między partiami (rozkład gamma o kształcie 6), odniesienie i przesunięcie karty CUSUM (0.4% i 1%) oraz granicę h (przepis 6); w pułapkach – układ palety (10 warstw po 500 słoików, 120 ze 150 wad w dwóch dolnych warstwach), 200 tacek po 25 słoików, ρ = 0.10 i 9 tacek w próbie (przepis 7). Po pierwszym uruchomieniu zmieniono (ziarna bez zmian): (1) parę AQL/LTPD wybrano po porównaniu czterech par (0.5/3%, 0.65/3%, 0.65/4%, 0.5/2.5%); (2) granicę CUSUM podniesiono z h = 4 do h = 7, bo przy 4 fałszywy alarm pojawiał się w ponad połowie symulowanych sezonów bez dryfu; (3) panel B rysunku 2 pokazywał najpierw krzywe OC dla trzech wielkości partii, które prawie się pokrywały – zastąpiono go wykresem prawdopodobieństwa przyjęcia przy AQL i LTPD w zależności od wielkości partii; (4) plan podwójny liczono najpierw rozkładem dwumianowym (wyszło n1 = 135), w wersji końcowej – hipergeometrycznym, jak pozostałe plany (134), i poprawiono funkcję dla partii z mniejszą liczbą wad niż w pierwszej próbie; (5) przesunięto podpisy na rysunkach 1, 3, 4 i 6 i ucięto oś CUSUM na 25. Każdy przepis liczy się w mniej niż 2 sekundy.
1. Warunki umowy, pętla po c i n i krzywa OC: Rysunek 1
R
# Rysunek 1. Krzywa OC planu pojedynczego (n, c) z ryzykiem dostawcy α i odbiorcy β
# Fikcyjna huta szkła dostarcza przetwórni owoców słoiki w partiach po 5000 sztuk
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Warunki z umowy (ustalone ręcznie): partia N = 5000 słoików,
# AQL = 0.5% wad – taka partia ma być przyjęta z prawdopodobieństwem co najmniej 95% (α ≤ 5%),
# LTPD = 3% wad – taka partia ma być przyjęta z prawdopodobieństwem najwyżej 10% (β ≤ 10%)
N <- 5000; AQL <- 0.005; LTPD <- 0.03; alfa_max <- 0.05; beta_max <- 0.10

# Prawdopodobieństwo przyjęcia partii: w próbie n słoików (bez zwracania) najwyżej c wad
pa_hiper <- function(p, n, c, N) { D <- round(p * N); phyper(c, D, N - D, n) }   # rozkład hipergeometryczny
pa_dwum  <- function(p, n, c) pbinom(c, n, p)                                       # przybliżenie dwumianowe

# Pętla po c i n: najmniejsze n, przy którym β ≤ 10%, i największe n, przy którym α ≤ 5%
siatka <- do.call(rbind, lapply(0:8, function(c) {
  n <- (c + 1):1500
  ok_beta <- pa_hiper(LTPD, n, c, N) <= beta_max
  ok_alfa <- pa_hiper(AQL, n, c, N) >= 1 - alfa_max
  data.frame(c = c, n_min_beta = min(n[ok_beta]), n_max_alfa = max(n[ok_alfa]))
}))
siatka$wykonalny <- siatka$n_min_beta <= siatka$n_max_alfa
print(siatka)
c_plan <- min(siatka$c[siatka$wykonalny]); n_plan <- siatka$n_min_beta[siatka$c == c_plan]
alfa <- 1 - pa_hiper(AQL, n_plan, c_plan, N); beta <- pa_hiper(LTPD, n_plan, c_plan, N)
cat(sprintf("Plan: n = %d, c = %d | α przy AQL = %.1f%% | β przy LTPD = %.1f%%\n", n_plan, c_plan, 100 * alfa, 100 * beta))
cat("Prawdopodobieństwo przyjęcia przy odsetku wad 0.5%, 1%, 1.5%, 2%, 3%, 4%:",
    round(pa_hiper(c(.005, .01, .015, .02, .03, .04), n_plan, c_plan, N), 3), "\n")
D50 <- min(which(pa_hiper((1:N) / N, n_plan, c_plan, N) <= 0.5))     # pierwsza liczba wad z Pa ≤ 0.5
cat(sprintf("Prawdopodobieństwo przyjęcia spada poniżej 50%% przy %d wadliwych słoikach w partii (%.2f%%)\n", D50, 100 * D50 / N))

# Rysunek: krzywa OC z zaznaczonymi strefami i ryzykami
oc <- data.frame(p = (0:300) / N)                          # 0–6% wad, co 1 słoik wadliwy w partii
oc$Pa <- pa_hiper(oc$p, n_plan, c_plan, N)
pa_aql <- 1 - alfa
strefy <- data.frame(x0 = c(0, AQL, LTPD), x1 = c(AQL, LTPD, 0.06), tlo = c("#d4ede4", "#f4f2ee", "#fbe6d9"),
                     etykieta = c("dobra\njakość", "strefa obojętna", "zła jakość"), y = c(0.5, 0.06, 0.5))
p1 <- ggplot() +
  geom_rect(data = strefy, aes(xmin = 100 * x0, xmax = 100 * x1, ymin = 0, ymax = 1), fill = strefy$tlo) +
  geom_text(data = strefy, aes(x = 100 * (x0 + x1) / 2, y = y, label = etykieta), colour = "grey35",
            size = 3.6, lineheight = 0.9) +
  geom_line(data = oc, aes(100 * p, Pa), colour = kol[["niebieski"]], linewidth = 1.3) +
  annotate("segment", x = 100 * AQL, xend = 100 * AQL, y = pa_aql, yend = 1, colour = kol[["pomaranczowy"]],
           linewidth = 1.1, arrow = arrow(ends = "both", length = unit(0.15, "cm"))) +
  annotate("segment", x = 100 * LTPD, xend = 100 * LTPD, y = 0, yend = beta, colour = kol[["pomaranczowy"]],
           linewidth = 1.1, arrow = arrow(ends = "both", length = unit(0.15, "cm"))) +
  annotate("point", x = 100 * c(AQL, LTPD), y = c(pa_aql, beta), colour = kol[["granat"]], size = 2.8) +
  annotate("curve", x = 1.12, y = 0.88, xend = 0.58, yend = 0.985, curvature = 0.25, colour = kol[["pomaranczowy"]],
           arrow = arrow(length = unit(0.18, "cm"))) +
  annotate("label", x = 1.15, y = 0.86, hjust = 0, size = 3.6, linewidth = 0, fill = "white", lineheight = 0.95,
           label = sprintf("ryzyko dostawcy α = %.1f%%\npartia z 0.5%% wad zostaje odrzucona", 100 * alfa)) +
  annotate("label", x = 3.25, y = 0.22, hjust = 0, size = 3.6, linewidth = 0, fill = "white", lineheight = 0.95,
           label = sprintf("ryzyko odbiorcy β = %.1f%%\npartia z 3%% wad przechodzi", 100 * beta)) +
  annotate("text", x = 100 * AQL, y = -0.045, label = "AQL 0.5%", size = 3.5, colour = kol[["granat"]]) +
  annotate("text", x = 100 * LTPD, y = -0.045, label = "LTPD 3%", size = 3.5, colour = kol[["granat"]]) +
  scale_x_continuous(breaks = 0:6, labels = function(x) paste0(x, "%")) +
  scale_y_continuous(breaks = seq(0, 1, 0.2), labels = function(y) sprintf("%.1f", y)) +
  coord_cartesian(xlim = c(0, 6), ylim = c(-0.07, 1), expand = FALSE) +
  labs(title = sprintf("Krzywa OC planu n = %d, c = %d (partia 5000 słoików)", n_plan, c_plan),
       subtitle = "Przyjmij partię, gdy w losowej próbie jest najwyżej 3 słoiki z wadą",
       x = "odsetek wadliwych słoików w partii", y = "prawdopodobieństwo przyjęcia partii") + motyw
p1                       # do pliku: ggsave("kontrola-odbiorcza-krzywa-oc.svg", p1, width = 10, height = 5.8)
Wynik w R
  c n_min_beta n_max_alfa wykonalny
1 0         76         10     FALSE
2 1        127         72     FALSE
3 2        174        168     FALSE
4 3        219        283      TRUE
5 4        261        412      TRUE
6 5        303        551      TRUE
7 6        344        698      TRUE
8 7        384        852      TRUE
9 8        424       1013      TRUE
Plan: n = 219, c = 3 | α przy AQL = 2.2% | β przy LTPD = 9.8%
Prawdopodobieństwo przyjęcia przy odsetku wad 0.5%, 1%, 1.5%, 2%, 3%, 4%: 0.978 0.826 0.582 0.355 0.098 0.021
Prawdopodobieństwo przyjęcia spada poniżej 50% przy 84 wadliwych słoikach w partii (1.68%)
2. Plany o różnym c i rola wielkości partii: Rysunek 2
R
# Rysunek 2. Ile daje c i kiedy rozkład hipergeometryczny różni się od dwumianowego
# (korzysta z kol, motyw, pa_hiper, pa_dwum, siatka, N, AQL, LTPD, n_plan i c_plan z przepisu 1; bez losowania)
library(ggplot2)
library(patchwork)

# A. Trzy plany o tej samej ochronie odbiorcy (β ≤ 10% przy 3% wad), ale różnym c
plany <- siatka[siatka$c %in% c(0, 1, 3), c("c", "n_min_beta")]
names(plany)[2] <- "n"
plany$alfa_proc <- round(100 * (1 - pa_hiper(AQL, plany$n, plany$c, N)), 1)
plany$beta_proc <- round(100 * pa_hiper(LTPD, plany$n, plany$c, N), 1)
print(plany)
pA <- do.call(rbind, lapply(seq_len(nrow(plany)), function(i) data.frame(
  p = (0:250) / N, Pa = pa_hiper((0:250) / N, plany$n[i], plany$c[i], N),
  plan = sprintf("n = %d, c = %d", plany$n[i], plany$c[i]))))
pA$plan <- factor(pA$plan, unique(pA$plan))
wA <- ggplot(pA, aes(100 * p, Pa, colour = plan, linetype = plan)) +
  geom_vline(xintercept = 100 * c(AQL, LTPD), colour = "grey60", linetype = 3) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = unname(kol[c("pomaranczowy", "zielony", "niebieski")]), name = NULL) +
  scale_linetype_manual(values = c(2, 4, 1), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%")) +
  labs(title = "A. Ta sama β, różne c", x = "odsetek wad w partii", y = "prawdopodobieństwo przyjęcia") +
  motyw + theme(legend.position = "bottom", legend.direction = "vertical")

# B. Plan n = 219, c = 3 w partiach różnej wielkości: losowanie bez zwracania (hipergeometryczny)
#    a przybliżenie dwumianowe, które wielkości partii nie zna
tabB <- do.call(rbind, lapply(c(300, 500, 1000, 2000, 5000, 10000), function(Nw) data.frame(
  partia = Nw, proc_partii_w_probie = round(100 * n_plan / Nw, 1),
  Pa_AQL_hiper = round(pa_hiper(AQL, n_plan, c_plan, Nw), 3), Pa_AQL_dwum = round(pa_dwum(AQL, n_plan, c_plan), 3),
  Pa_LTPD_hiper = round(pa_hiper(LTPD, n_plan, c_plan, Nw), 3), Pa_LTPD_dwum = round(pa_dwum(LTPD, n_plan, c_plan), 3))))
print(tabB)
Nsiatka <- seq(300, 10000, by = 100)
pB <- rbind(
  data.frame(N = Nsiatka, punkt = "przy AQL 0.5%", rozklad = "hipergeometryczny", Pa = sapply(Nsiatka, function(Nw) pa_hiper(AQL, n_plan, c_plan, Nw))),
  data.frame(N = Nsiatka, punkt = "przy LTPD 3%", rozklad = "hipergeometryczny", Pa = sapply(Nsiatka, function(Nw) pa_hiper(LTPD, n_plan, c_plan, Nw))),
  data.frame(N = Nsiatka, punkt = "przy AQL 0.5%", rozklad = "dwumianowy", Pa = pa_dwum(AQL, n_plan, c_plan)),
  data.frame(N = Nsiatka, punkt = "przy LTPD 3%", rozklad = "dwumianowy", Pa = pa_dwum(LTPD, n_plan, c_plan)))
wB <- ggplot(pB, aes(N, Pa, colour = punkt, linetype = rozklad)) +
  geom_vline(xintercept = N, colour = "grey60", linetype = 3) +
  geom_step(linewidth = 1.05) +
  annotate("text", x = N * 1.08, y = 0.5, label = "nasze partie:\n5000 słoików", hjust = 0, size = 3.4, colour = "grey30") +
  scale_x_log10(breaks = c(300, 500, 1000, 2000, 5000, 10000)) +
  scale_colour_manual(values = unname(kol[c("niebieski", "pomaranczowy")]), name = NULL) +
  scale_linetype_manual(values = c(dwumianowy = 2, hipergeometryczny = 1), name = NULL) +
  guides(colour = guide_legend(order = 1, ncol = 1), linetype = guide_legend(order = 2, ncol = 1)) +
  labs(title = sprintf("B. Plan n = %d, c = %d a wielkość partii", n_plan, c_plan),
       x = "liczba słoików w partii (skala log)", y = NULL) +
  motyw + theme(legend.position = "bottom", legend.key.width = unit(1.4, "cm"))

p2 <- wA + wB
p2                       # do pliku: ggsave("kontrola-odbiorcza-hipergeometryczny-dwumianowy.svg", p2, width = 10, height = 5.8)
Wynik w R
  c   n alfa_proc beta_proc
1 0  76      31.9       9.7
2 1 127      13.2      10.0
4 3 219       2.2       9.8
  partia proc_partii_w_probie Pa_AQL_hiper Pa_AQL_dwum Pa_LTPD_hiper
1    300                 73.0        1.000       0.975         0.014
2    500                 43.8        1.000       0.975         0.049
3   1000                 21.9        0.991       0.975         0.077
4   2000                 10.9        0.983       0.975         0.091
5   5000                  4.4        0.978       0.975         0.098
6  10000                  2.2        0.976       0.975         0.101
  Pa_LTPD_dwum
1        0.104
2        0.104
3        0.104
4        0.104
5        0.104
6        0.104
3. Dobór planu i wrażliwość na LTPD: Rysunek 3
R
# Rysunek 3. Dobór n i c pętlą: gdzie oba warunki (α ≤ 5% i β ≤ 10%) dają się spełnić naraz
# (korzysta z kol, motyw, pa_hiper, siatka, N, AQL, LTPD, n_plan i c_plan z przepisu 1; bez losowania)
library(ggplot2)

# Ta sama pętla przy innych granicach LTPD: jak bardzo rośnie próba, gdy odbiorca chce więcej ochrony
dobierz <- function(AQL, LTPD, N, alfa_max = 0.05, beta_max = 0.10) {
  for (c in 0:20) {
    n <- (c + 1):N
    n_min <- n[which(pa_hiper(LTPD, n, c, N) <= beta_max)[1]]
    if (pa_hiper(AQL, n_min, c, N) >= 1 - alfa_max)
      return(data.frame(AQL_proc = 100 * AQL, LTPD_proc = 100 * LTPD, n = n_min, c = c,
                        alfa_proc = round(100 * (1 - pa_hiper(AQL, n_min, c, N)), 1),
                        beta_proc = round(100 * pa_hiper(LTPD, n_min, c, N), 1)))
  }
}
wrazliwosc <- rbind(dobierz(AQL, 0.04, N), dobierz(AQL, LTPD, N), dobierz(AQL, 0.02, N), dobierz(AQL, 0.015, N))
print(wrazliwosc)

dl <- rbind(data.frame(c = siatka$c, n = siatka$n_min_beta, granica = "najmniejsze n, przy którym β ≤ 10%"),
            data.frame(c = siatka$c, n = siatka$n_max_alfa, granica = "największe n, przy którym α ≤ 5%"))
p3 <- ggplot() +
  geom_segment(data = siatka[siatka$wykonalny, ], aes(x = c, xend = c, y = n_min_beta, yend = n_max_alfa),
               colour = kol[["zielony"]], linewidth = 5, alpha = 0.35) +
  geom_line(data = dl, aes(c, n, colour = granica, linetype = granica), linewidth = 1) +
  geom_point(data = dl, aes(c, n, colour = granica, shape = granica), size = 2.6) +
  annotate("point", x = c_plan, y = n_plan, size = 6, shape = 21, stroke = 1.4, colour = kol[["granat"]]) +
  annotate("label", x = c_plan + 0.25, y = n_plan - 95, hjust = 0, size = 3.6, linewidth = 0, fill = "white",
           label = sprintf("wybrany plan: n = %d, c = %d\n(najmniejsze c i najmniejsze n)", n_plan, c_plan)) +
  annotate("text", x = 1, y = 330, label = "c = 0, 1, 2: brak planu\n(β wymaga większej próby,\nniż pozwala α)",
           size = 3.5, colour = "grey30", lineheight = 0.95) +
  annotate("text", x = 4.3, y = 800, label = "zielony pas: plany\nspełniające oba warunki", size = 3.5,
           colour = kol[["zielony"]], lineheight = 0.95) +
  scale_colour_manual(values = unname(kol[c("niebieski", "pomaranczowy")]), name = NULL) +
  scale_linetype_manual(values = c(1, 2), name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(breaks = 0:8) +
  labs(title = "Dobór planu: pętla po c i n (AQL 0.5%, LTPD 3%, partia 5000)",
       subtitle = "Plan istnieje, gdy dolna granica (β) leży pod górną (α)",
       x = "liczba akceptowana c", y = "liczebność próby n") +
  motyw + theme(legend.direction = "vertical")
p3                       # do pliku: ggsave("kontrola-odbiorcza-dobor-n-c.svg", p3, width = 10, height = 6)
Wynik w R
  AQL_proc LTPD_proc   n c alfa_proc beta_proc
1      0.5       4.0 131 2       2.7       9.8
2      0.5       3.0 219 3       2.2       9.8
3      0.5       2.0 390 4       4.1      10.0
4      0.5       1.5 679 6       4.4      10.0
4. AOQ, AOQL i ATI: Rysunek 4
R
# Rysunek 4. Średnia jakość wychodząca (AOQ) i średnia liczba sprawdzonych słoików (ATI),
# gdy odrzucone partie huta sortuje w 100%, a wadliwe słoiki wymienia na dobre
# (korzysta z kol, motyw, N, AQL, LTPD, n_plan i c_plan z przepisu 1; bez losowania)
library(ggplot2)
library(patchwork)

D <- 0:300                                          # liczba wadliwych słoików w partii (0–6%)
# Partia przyjęta: wady z próby wymienione, w pozostałych N − n słoikach zostaje D − d wad.
# Partia odrzucona: sortowanie 100% – na wyjściu 0 wad.
aoq <- sapply(D, function(Dk) { d <- 0:min(c_plan, Dk)
  sum(dhyper(d, Dk, N - Dk, n_plan) * (Dk - d)) / N })
pa <- phyper(c_plan, D, N - D, n_plan)
ati <- n_plan + (1 - pa) * (N - n_plan)             # słoiki sprawdzone na partię
w4 <- data.frame(p = D / N, aoq = aoq, ati = ati)
iA <- which.max(aoq)
cat(sprintf("AOQL = %.2f%% wad na wyjściu, osiągane przy %.2f%% wad w partiach (Pa = %.3f)\n",
            100 * aoq[iA], 100 * D[iA] / N, pa[iA]))
pkt <- round(c(AQL, 0.01, 0.02, LTPD, 0.05) * N)
print(data.frame(wady_w_partii_proc = 100 * pkt / N, Pa = round(pa[pkt + 1], 3),
                 AOQ_proc = round(100 * aoq[pkt + 1], 2), ATI = round(ati[pkt + 1])))

wA <- ggplot(w4, aes(100 * p, 100 * aoq)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60", linetype = 3) +
  geom_line(colour = kol[["niebieski"]], linewidth = 1.2) +
  geom_hline(yintercept = 100 * aoq[iA], colour = kol[["pomaranczowy"]], linetype = 2) +
  annotate("text", x = 3.6, y = 100 * aoq[iA] + 0.09, label = sprintf("AOQL = %.2f%%", 100 * aoq[iA]),
           colour = kol[["pomaranczowy"]], size = 3.7) +
  annotate("text", x = 1.6, y = 1.3, label = "bez kontroli\n(wyjście = wejście)", colour = "grey40", size = 3.3,
           hjust = 0, lineheight = 0.9) +
  scale_x_continuous(labels = function(x) paste0(x, "%")) + scale_y_continuous(labels = function(x) paste0(x, "%")) +
  coord_cartesian(ylim = c(0, 1.6)) +
  labs(title = "A. Jakość po kontroli (AOQ)", x = "odsetek wad w partiach od huty", y = "odsetek wad trafiający na linię") +
  motyw
wB <- ggplot(w4, aes(100 * p, ati)) +
  geom_hline(yintercept = c(n_plan, N), colour = "grey60", linetype = 3) +
  geom_line(colour = kol[["zielony"]], linewidth = 1.2) +
  annotate("text", x = 0.1, y = c(n_plan + 230, N - 230), hjust = 0, size = 3.3, colour = "grey40",
           label = c(sprintf("tylko próba: %d", n_plan), sprintf("cała partia: %d", N))) +
  scale_x_continuous(labels = function(x) paste0(x, "%")) +
  labs(title = "B. Słoiki sprawdzone na partię (ATI)", x = "odsetek wad w partiach od huty", y = NULL) +
  motyw
p4 <- wA + wB
p4                       # do pliku: ggsave("kontrola-odbiorcza-aoq-aoql.svg", p4, width = 10, height = 5.4)
Wynik w R
AOQL = 0.86% wad na wyjściu, osiągane przy 1.34% wad w partiach (Pa = 0.662)
  wady_w_partii_proc    Pa AOQ_proc  ATI
1                0.5 0.978     0.47  324
2                1.0 0.826     0.80 1052
3                2.0 0.355     0.69 3302
4                3.0 0.098     0.29 4530
5                5.0 0.004     0.02 4982
5. Plan podwójny i średnia liczebność próby: Rysunek 5
R
# Rysunek 5. Plan podwójny: krzywa OC i średnia liczebność próby (ASN) wobec planu pojedynczego
# (korzysta z kol, motyw, pa_hiper, N, AQL, LTPD, n_plan i c_plan z przepisu 1; bez losowania)
library(ggplot2)
library(patchwork)

# Plan podwójny (n1, c1, n2, c2): w 1. próbie d1 ≤ c1 → przyjmij; d1 > c2 → odrzuć;
# w przeciwnym razie 2. próba n2 z reszty partii i przyjmij, gdy d1 + d2 ≤ c2
pa_podw <- function(p, n1, n2, c1, c2, N) {
  D <- round(p * N); d1 <- (c1 + 1):c2; d1 <- d1[d1 <= D]   # więcej wad w próbie niż w partii – niemożliwe
  phyper(c1, D, N - D, n1) + sum(dhyper(d1, D, N - D, n1) * phyper(c2 - d1, D - d1, N - n1 - (D - d1), n2))
}
asn_podw <- function(p, n1, n2, c1, c2, N) { D <- round(p * N)
  n1 + n2 * (phyper(c2, D, N - D, n1) - phyper(c1, D, N - D, n1)) }   # 2. próba, gdy c1 < d1 ≤ c2

# Pętla: n1 = n2 od 50 do 250, c1 < c2; warunki α ≤ 5% i β ≤ 10%; kryterium – najmniejsza ASN przy AQL
kand <- expand.grid(n1 = 50:250, c1 = 0:3, c2 = 1:8)
kand <- kand[kand$c1 < kand$c2, ]
kand$alfa <- 1 - mapply(pa_podw, AQL, kand$n1, kand$n1, kand$c1, kand$c2, N)
kand$beta <- mapply(pa_podw, LTPD, kand$n1, kand$n1, kand$c1, kand$c2, N)
ok <- kand[kand$alfa <= 0.05 & kand$beta <= 0.10, ]
ok$asn_AQL <- mapply(asn_podw, AQL, ok$n1, ok$n1, ok$c1, ok$c2, N)
pl <- ok[which.min(ok$asn_AQL), ]
siatka_p <- (0:300) / N
asn_krzywa <- sapply(siatka_p, asn_podw, n1 = pl$n1, n2 = pl$n1, c1 = pl$c1, c2 = pl$c2, N = N)
cat(sprintf("Plan podwójny: n1 = n2 = %d, c1 = %d, c2 = %d | α = %.1f%% | β = %.1f%%\n",
            pl$n1, pl$c1, pl$c2, 100 * pl$alfa, 100 * pl$beta))
cat(sprintf("Średnia liczebność próby: przy AQL %.0f, przy LTPD %.0f, największa %.0f (przy %.2f%% wad); plan pojedynczy: %d\n",
            pl$asn_AQL, asn_podw(LTPD, pl$n1, pl$n1, pl$c1, pl$c2, N), max(asn_krzywa),
            100 * siatka_p[which.max(asn_krzywa)], n_plan))
cat(sprintf("Odsetek partii z 0.5%% wad, w których potrzebna jest 2. próba: %.1f%%\n", 100 * (pl$asn_AQL - pl$n1) / pl$n1))

w5 <- rbind(data.frame(p = siatka_p, plan = sprintf("pojedynczy n = %d, c = %d", n_plan, c_plan),
                       Pa = pa_hiper(siatka_p, n_plan, c_plan, N), ASN = n_plan),
            data.frame(p = siatka_p, plan = sprintf("podwójny %d + %d, c1 = %d, c2 = %d", pl$n1, pl$n1, pl$c1, pl$c2),
                       Pa = sapply(siatka_p, pa_podw, n1 = pl$n1, n2 = pl$n1, c1 = pl$c1, c2 = pl$c2, N = N),
                       ASN = asn_krzywa))
w5$plan <- factor(w5$plan, unique(w5$plan))          # kolejność: pojedynczy, podwójny
wA <- ggplot(w5, aes(100 * p, Pa, colour = plan, linetype = plan)) +
  geom_vline(xintercept = 100 * c(AQL, LTPD), colour = "grey60", linetype = 3) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = unname(kol[c("niebieski", "pomaranczowy")]), name = NULL) +
  scale_linetype_manual(values = c(1, 2), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%")) +
  labs(title = "A. Krzywe OC prawie się pokrywają", x = "odsetek wad w partii", y = "prawdopodobieństwo przyjęcia") +
  motyw + theme(legend.direction = "vertical")
wB <- ggplot(w5, aes(100 * p, ASN, colour = plan, linetype = plan)) +
  geom_vline(xintercept = 100 * c(AQL, LTPD), colour = "grey60", linetype = 3) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = unname(kol[c("niebieski", "pomaranczowy")]), name = NULL) +
  scale_linetype_manual(values = c(1, 2), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%")) + coord_cartesian(ylim = c(0, 250)) +
  labs(title = "B. Średnia liczba słoików w próbie (ASN)", x = "odsetek wad w partii", y = NULL) +
  motyw + theme(legend.direction = "vertical")
p5 <- wA + wB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p5                       # do pliku: ggsave("kontrola-odbiorcza-plan-podwojny.svg", p5, width = 10, height = 5.6)
Wynik w R
Plan podwójny: n1 = n2 = 134, c1 = 1, c2 = 3 | α = 3.0% | β = 9.8%
Średnia liczebność próby: przy AQL 153, przy LTPD 180, największa 198 (przy 1.82% wad); plan pojedynczy: 219
Odsetek partii z 0.5% wad, w których potrzebna jest 2. próba: 14.0%
6. Symulacja sezonu z dryfem jakości i karta CUSUM: Rysunek 6
R
# Rysunek 6. Symulacja sezonu: huta z dryfem jakości (zużywa się forma) a plan n = 219, c = 3 i karta CUSUM
# (korzysta z kol, motyw, N, AQL, LTPD, n_plan i c_plan z przepisu 1)
library(ggplot2)
library(patchwork)

# Parametry ustawione ręcznie: 120 partii w sezonie (ok. 6 dostaw tygodniowo przez 20 tygodni);
# partie 1–60: średnio 0.4% wad; od partii 61 średnia rośnie liniowo do 2.8% w partii 120;
# odsetek wad różni się też między partiami (rozkład gamma, kształt 6)
set.seed(757)
L <- 120
p_sr <- ifelse(1:L <= 60, 0.004, 0.004 + (0.028 - 0.004) * (1:L - 60) / 60)
p_partii <- rgamma(L, shape = 6, rate = 6 / p_sr)
D <- rbinom(L, N, pmin(p_partii, 1))                    # wadliwe słoiki w partii (w praktyce nieznane)
d <- rhyper(L, D, N - D, n_plan)                         # wady w losowej próbie 219 słoików
przyjeta <- d <= c_plan
na_linie <- ifelse(przyjeta, D - d, 0)                    # odrzucone: sortowanie 100% w hucie

# Karta CUSUM (Page) na liczbie wad w próbie: odniesienie 0.4% wad, alarm przy przesunięciu do 1%
mu0 <- n_plan * 0.004; mu1 <- n_plan * 0.010
k <- (mu1 - mu0) / log(mu1 / mu0); h <- 7                # h ustalone ręcznie (po 1. uruchomieniu: 4 → 7)
S <- numeric(L); for (i in 1:L) S[i] <- max(0, (if (i > 1) S[i - 1] else 0) + d[i] - k)
sygnal <- which(S > h)[1]

faza <- ifelse(1:L <= 60, "1–60", "61–120")
cat("Partie odrzucone: w partiach 1–60:", sum(!przyjeta[1:60]), "| w partiach 61–120:", sum(!przyjeta[61:L]), "\n")
cat("Pierwsza partia z odsetkiem wad > 2%:", which(D / N > 0.02)[1], "| > 3%:", which(D / N > 0.03)[1],
    "| pierwsze odrzucenie po partii 60:", which(!przyjeta & 1:L > 60)[1], "\n")
cat("Partie z > 2% wad:", sum(D / N > 0.02), "| w tym przyjęte:", sum(D / N > 0.02 & przyjeta),
    "| partie z > 3% wad:", sum(D / N > 0.03), "| w tym przyjęte:", sum(D / N > 0.03 & przyjeta), "\n")
cat(sprintf("CUSUM: k = %.3f, h = %d, pierwszy sygnał w partii %d (sygnałów w partiach 1–60: %d)\n",
            k, h, sygnal, sum(S[1:60] > h)))
for (f in c("1–60", "61–120")) { w <- faza == f
  cat(sprintf("Partie %s: wady od huty %.2f%% | trafiające na linię %.2f%% | sprawdzone słoiki %d\n", f,
              100 * sum(D[w]) / (N * sum(w)), 100 * sum(na_linie[w]) / (N * sum(w)),
              sum(ifelse(przyjeta[w], n_plan, N)))) }
ost <- 101:120
cat(sprintf("Ostatnie 20 partii: wady od huty %.2f%%, na linię %.2f%%\n",
            100 * sum(D[ost]) / (N * 20), 100 * sum(na_linie[ost]) / (N * 20)))
# Odsetek wad z połączonych prób: przedział Wilsona (prop.test bez poprawki na ciągłość)
for (zakres in list(1:60, ost)) { x <- sum(d[zakres]); m <- n_plan * length(zakres)
  ci <- prop.test(x, m, correct = FALSE)$conf.int
  cat(sprintf("Partie %d–%d: %d wad w %d słoikach z prób = %.2f%%, 95%% CI [%.2f, %.2f]%%\n",
              min(zakres), max(zakres), x, m, 100 * x / m, 100 * ci[1], 100 * ci[2])) }

# Czy CUSUM nie alarmuje za często przy stałych 0.4% wad? 2000 sezonów po 120 partii bez dryfu
set.seed(7576)
alarm <- replicate(2000, { dd <- rhyper(L, rbinom(L, N, rgamma(L, 6, 6 / 0.004)), N, n_plan)
  s <- 0; for (x in dd) { s <- max(0, s + x - k); if (s > h) return(TRUE) }; FALSE })
cat(sprintf("Bez dryfu: fałszywy alarm CUSUM w sezonie (120 partii) w %.1f%% symulowanych sezonów (błąd MC %.1f pp)\n",
            100 * mean(alarm), 100 * sqrt(mean(alarm) * (1 - mean(alarm)) / 2000)))

partie <- data.frame(partia = 1:L, tydzien = ceiling((1:L) / 6), wady_w_probce = d,
                     decyzja = ifelse(przyjeta, "przyjeta", "odrzucona"), cusum = round(S, 3),
                     wadliwe_w_partii = D, wadliwe_na_linie = na_linie)
write.csv(partie, "kontrola-odbiorcza-partie.csv", row.names = FALSE)

w6 <- data.frame(partia = 1:L, p = 100 * D / N, p_sr = 100 * p_sr, S = S,
                 decyzja = factor(ifelse(przyjeta, "przyjęta", "odrzucona (sortowanie 100%)"),
                                  c("przyjęta", "odrzucona (sortowanie 100%)")))
wA <- ggplot(w6, aes(partia, p)) +
  geom_hline(yintercept = c(0.5, 3), colour = "grey55", linetype = 3) +
  annotate("text", x = 2, y = c(0.5, 3) + 0.22, label = c("AQL 0.5%", "LTPD 3%"), hjust = 0, size = 3.3, colour = "grey35") +
  geom_vline(xintercept = c(60.5, sygnal), colour = kol[c("szary", "zielony")], linetype = c(2, 1)) +
  annotate("text", x = 59.5, y = 4.5, label = "od tej partii\nzużywa się forma", hjust = 1, size = 3.3,
           colour = "grey35", lineheight = 0.9) +
  annotate("text", x = sygnal + 1, y = 4.5, label = sprintf("alarm CUSUM\n(partia %d)", sygnal), hjust = 0,
           size = 3.3, colour = kol[["zielony"]], lineheight = 0.9) +
  geom_line(aes(y = p_sr), colour = kol[["granat"]], linewidth = 0.8) +
  geom_point(aes(colour = decyzja, shape = decyzja), size = 2.3) +
  scale_colour_manual(values = unname(kol[c("niebieski", "pomaranczowy")]), name = NULL) +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(x, "%")) + coord_cartesian(ylim = c(0, 4.9)) +
  labs(title = "A. Odsetek wad w partiach i decyzje planu n = 219, c = 3",
       subtitle = "linia: średnia huty; punkty: rzeczywisty odsetek w partii (w danych fikcyjnych znany)",
       x = NULL, y = "wadliwe słoiki w partii") + motyw
wB <- ggplot(w6, aes(partia, S)) +
  geom_hline(yintercept = h, colour = kol[["zielony"]], linetype = 2) +
  geom_step(colour = kol[["granat"]], linewidth = 0.8) +
  annotate("text", x = 2, y = h + 2.6, label = sprintf("granica h = %d", h), hjust = 0, size = 3.3, colour = kol[["zielony"]]) +
  coord_cartesian(ylim = c(0, 25)) +
  labs(title = "B. CUSUM liczby wad w próbach (oś ucięta na 25)", x = "numer partii w sezonie", y = "statystyka CUSUM") + motyw
p6 <- wA / wB + plot_layout(heights = c(2, 1))
p6                       # do pliku: ggsave("kontrola-odbiorcza-dryf-jakosci.svg", p6, width = 10, height = 7)
Wynik w R
Partie odrzucone: w partiach 1–60: 1 | w partiach 61–120: 26
Pierwsza partia z odsetkiem wad > 2%: 84 | > 3%: 98 | pierwsze odrzucenie po partii 60: 71
Partie z > 2% wad: 22 | w tym przyjęte: 3 | partie z > 3% wad: 8 | w tym przyjęte: 1
CUSUM: k = 1.434, h = 7, pierwszy sygnał w partii 76 (sygnałów w partiach 1–60: 0)
Partie 1–60: wady od huty 0.36% | trafiające na linię 0.33% | sprawdzone słoiki 17921
Partie 61–120: wady od huty 1.77% | trafiające na linię 0.62% | sprawdzone słoiki 137446
Ostatnie 20 partii: wady od huty 2.58%, na linię 0.62%
Partie 1–60: 47 wad w 13140 słoikach z prób = 0.36%, 95% CI [0.27, 0.48]%
Partie 101–120: 124 wad w 4380 słoikach z prób = 2.83%, 95% CI [2.38, 3.37]%
Bez dryfu: fałszywy alarm CUSUM w sezonie (120 partii) w 5.8% symulowanych sezonów (błąd MC 0.5 pp)
7. Pułapki: próbka z wierzchu palety, wady w tackach, próba bez wad
R
# Pułapki: próbka z wierzchu palety, wady skupione w tackach i co mówi próba bez wad
# (korzysta z N, AQL, LTPD, n_plan i c_plan z przepisu 1; bez rysunku)

# 1. Próbka z wierzchu palety. Partia z 3% wad (150 słoików); 120 z nich pochodzi z jednej złej godziny
#    produkcji i leży w dwóch dolnych warstwach palety (10 warstw po 500 słoików), 30 – równo we wszystkich
D <- 150; w_gornej <- 30 / 10                              # wady w górnej warstwie: 3
cat(sprintf("Pa przy losowej próbie z całej partii: %.3f | przy próbie z górnej warstwy (500 słoików, %d wady): %.3f\n",
            phyper(c_plan, D, N - D, n_plan), w_gornej, phyper(c_plan, w_gornej, 500 - w_gornej, n_plan)))

# 2. Wady skupione: partia to 200 tacek po 25 słoików; prawdopodobieństwo wady różni się między tackami
#    (rozkład beta, korelacja wewnątrz tacki ρ = 0.10 – ustalona ręcznie). Kontroler bierze 9 całych tacek
#    (225 słoików) zamiast 219 słoików losowanych pojedynczo z całej partii.
set.seed(7577)
rho <- 0.10; tacki <- 200; m <- 25; R <- 10000
symuluj <- function(p) {
  a <- p * (1 / rho - 1); b <- (1 - p) * (1 / rho - 1)
  wyn <- replicate(R, {
    wady_t <- rbinom(tacki, m, rbeta(tacki, a, b))          # wady w każdej tacce
    Dl <- sum(wady_t)
    c(tacki9 = sum(sample(wady_t, 9)) <= c_plan,             # 9 całych tacek
      losowo = rhyper(1, Dl, N - Dl, n_plan) <= c_plan)      # 219 słoików z całej partii
  })
  pa <- rowMeans(wyn)
  data.frame(odsetek_wad_proc = 100 * p, Pa_9_tacek = round(pa[1], 3), Pa_losowo = round(pa[2], 3),
             blad_MC_pp = round(100 * max(sqrt(pa * (1 - pa) / R)), 1))
}
print(rbind(symuluj(AQL), symuluj(0.015), symuluj(LTPD)), row.names = FALSE)
cat(sprintf("Efekt schematu 1 + (m − 1)ρ = %.1f → 225 słoików z 9 tacek niesie tyle informacji co ok. %.0f losowych\n",
            1 + (m - 1) * rho, 225 / (1 + (m - 1) * rho)))

# 3. Próba bez wad nie dowodzi partii bez wad: 95% przedział Wilsona dla odsetka wad w partii
for (x in c(0, 3)) { ci <- prop.test(x, n_plan, correct = FALSE)$conf.int
  cat(sprintf("Wady w próbie: %d z %d słoików → 95%% CI [%.2f, %.2f]%%\n", x, n_plan, 100 * ci[1], 100 * ci[2])) }
Wynik w R
Pa przy losowej próbie z całej partii: 0.098 | przy próbie z górnej warstwy (500 słoików, 3 wady): 1.000
 odsetek_wad_proc Pa_9_tacek Pa_losowo blad_MC_pp
              0.5      0.893     0.967        0.3
              1.5      0.630     0.585        0.5
              3.0      0.281     0.116        0.4
Efekt schematu 1 + (m − 1)ρ = 3.4 → 225 słoików z 9 tacek niesie tyle informacji co ok. 66 losowych
Wady w próbie: 0 z 219 słoików → 95% CI [0.00, 1.72]%
Wady w próbie: 3 z 219 słoików → 95% CI [0.47, 3.95]%
8. Sprawdzenie palety pod kątem zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace (bez losowania)
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "szary – niebieski" = c("#999999", "#0072B2"),
             "szary – pomarańczowy" = c("#999999", "#D55E00"), "niebieski – zielony" = c("#0072B2", "#009E73"),
             "pomarańczowy – zielony" = c("#D55E00", "#009E73"), "szary – zielony" = c("#999999", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
szary – niebieski                           44.9         48.9       40.6
szary – pomarańczowy                        77.2         62.9       56.0
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
szary – zielony                             47.8         11.8       19.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rozkłady hipergeometryczny i dwumianowy, losowanie i przedziały Wilsona (prop.test) obliczono funkcjami pakietu stats (z podstawowej instalacji R). Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Próbka z wierzchu palety. Partia ma 3% wad (150 słoików), ale 120 z nich pochodzi z jednej złej godziny i leży w dwóch dolnych warstwach. Losowa próba z całej partii przyjmuje ją z prawdopodobieństwem .098; próba 219 słoików z górnej warstwy (500 słoików, 3 wady) – zawsze (1.000). Krzywa OC obowiązuje tylko dla próby losowej.
- Wady skupione w partii. Gdy wady trzymają się tacek (korelacja wewnątrz tacki ρ = 0.10, tacki po 25 słoików) i kontroler bierze 9 całych tacek (225 słoików), krzywa OC się spłaszcza: przy 3% wad przyjmuje 28.1% partii zamiast 11.6% przy słoikach losowanych z całej partii, a przy 0.5% wad – 89.3% zamiast 96.7% (10 000 symulacji, ziarno 7577, błąd MC ≤ 0.5 pp). Efekt schematu 1 + (25 − 1) · 0.10 = 3.4 oznacza, że 225 słoików z tacek niesie tyle informacji co ok. 66 losowych (zob. ICC). (11.6% zamiast 9.8%, bo w symulacji liczba wad w partii się waha.)
- AQL to nie „dopuszczalny poziom wad”. AQL to punkt, w którym plan prawie zawsze przyjmuje partię. Plan przyjmuje też 82.6% partii z dwa razy gorszą jakością (1%). Jeśli przetwórnia nie zgadza się na 1% wad, umowa musi to powiedzieć wprost.
- Próba bez wad to nie partia bez wad. 0 wad w 219 słoikach daje 95% CI [0.00, 1.72]% odsetka wad w partii; 3 wady (jeszcze „przyjmij”) – [0.47, 3.95]%.
- Odrzucona partia wysłana ponownie bez sortowania – to druga szansa dla złej partii; AOQ przestaje obowiązywać.
- Jeden plan dla wszystkich wad. Wady krytyczne (odprysk szkła w słoiku) wymagają innego planu lub kontroli 100%, niezależnie od kosztu.
Najczęstsze pytania
Jak dobrać liczebność próby i liczbę akceptowaną w kontroli odbiorczej?
Ustal dwa punkty: AQL z ryzykiem dostawcy α i LTPD z ryzykiem odbiorcy β. Potem dla kolejnych c szukaj najmniejszego n, przy którym prawdopodobieństwo przyjęcia przy LTPD nie przekracza β, i sprawdź, czy przy AQL wynosi co najmniej 1 − α. W przykładzie (AQL 0.5%, α ≤ 5%, LTPD 3%, β ≤ 10%) pierwszy wykonalny jest plan n = 219, c = 3.
Co pokazuje krzywa OC planu próbkowania?
Prawdopodobieństwo przyjęcia partii w zależności od odsetka wad w partii. Dla planu n = 219, c = 3 wynosi ono .978 przy 0.5% wad, .826 przy 1%, .355 przy 2% i .098 przy 3%. Im krzywa bardziej stroma, tym lepiej plan odróżnia dobre partie od złych; stromość daje większa próba.
Czy AQL to dopuszczalny poziom wad w dostawie?
Nie. AQL to poziom jakości, przy którym plan prawie zawsze przyjmuje partię. Ten sam plan przyjmuje też wiele partii gorszych: w przykładzie przy AQL 0.5% plan przyjmuje 82.6% partii z 1% wad. Jeśli odbiorca nie akceptuje takiej jakości, musi to zapisać osobno, np. przez niższe LTPD.
Kiedy zamiast rozkładu dwumianowego użyć hipergeometrycznego w kontroli odbiorczej?
Gdy próba jest znaczną częścią partii. Przy partii 5000 słoików i próbie 219 różnica jest mała (β = 9.8% wobec 10.4%), ale przy partii 500 próba to 43.8% partii i dokładne β wynosi 4.9%. Rozkład dwumianowy zawyża wtedy ryzyko odbiorcy i każe brać niepotrzebnie dużą próbę.
Co to jest AOQL w kontroli odbiorczej?
To największa średnia jakość wychodząca – najwyższy oczekiwany odsetek wad, który trafia do odbiorcy, gdy odrzucone partie są sortowane w 100%. Dla planu n = 219, c = 3 i partii 5000 sztuk AOQL wynosi 0.86% i pojawia się przy 1.34% wad w dostawach. To gwarancja średnia w długim okresie, nie dla pojedynczej partii.
Powiązane hasła
Przeczytaj też
Zdolność procesu – Cp i Cpk
Toczenie wałków: karta X̄–R, Cp, Cpk, Pp, Ppk, ppm, przedziały ufności dla Cpk z symulacją i rozkład skośny – pięć rysunków z kodem R.
Czytaj →PoradnikRoszczenia gwarancyjne i rozkład Weibulla
Dane gwarancyjne jako czas do awarii: cenzurowanie, Kaplan–Meier, wykres Weibulla, hazard i prognoza zgłoszeń z kohort z bootstrapem – z kodem R.
Czytaj →PoradnikAnomalie w KPI – karta kontrolna
Sklep sportowy i dzienna konwersja: karta p, dzień tygodnia, poprawka Laneya, EWMA, CUSUM i symulacja fałszywych alarmów – pięć rysunków z kodem R.
Czytaj →Piszesz pracę o kontroli jakości albo projektujesz kontrolę dostaw?
Pomożemy dobrać plan próbkowania, policzyć krzywą OC, AOQL i ryzyko obu stron oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Dodge, H. F., & Romig, H. G. (1929). A method of sampling inspection. Bell System Technical Journal, 8(4), 613–631. https://doi.org/10.1002/j.1538-7305.1929.tb01240.x
- Grubbs, F. E. (1949). On designing single sampling inspection plans. The Annals of Mathematical Statistics, 20(2), 242–256. https://doi.org/10.1214/aoms/1177730033 ● Otwarty dostęp
- Guenther, W. C. (1969). Use of the binomial, hypergeometric and Poisson tables to obtain sampling plans. Journal of Quality Technology, 1(2), 105–109. https://doi.org/10.1080/00224065.1969.11980358
- Hald, A. (1967). The determination of single sampling attribute plans with given producer's and consumer's risk. Technometrics, 9(3), 401–415. https://doi.org/10.1080/00401706.1967.10490484
- Page, E. S. (1954). Continuous inspection schemes. Biometrika, 41(1–2), 100–115. https://doi.org/10.1093/biomet/41.1-2.100
- Papadakis, E. P. (1985). The Deming inspection criterion for choosing zero or 100 percent inspection. Journal of Quality Technology, 17(3), 121–127. https://doi.org/10.1080/00224065.1985.11978950
Cytowania BibTeX
@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{dodge1929method, author={Dodge, H. F. and Romig, H. G.}, title={{A method of sampling inspection}}, journal={Bell System Technical Journal}, year={1929}, volume={8}, number={4}, pages={613--631}, doi={10.1002/j.1538-7305.1929.tb01240.x}}@article{grubbs1949designing, author={Grubbs, Frank E.}, title={{On designing single sampling inspection plans}}, journal={The Annals of Mathematical Statistics}, year={1949}, volume={20}, number={2}, pages={242--256}, doi={10.1214/aoms/1177730033}}@article{guenther1969use, author={Guenther, William C.}, title={{Use of the binomial, hypergeometric and Poisson tables to obtain sampling plans}}, journal={Journal of Quality Technology}, year={1969}, volume={1}, number={2}, pages={105--109}, doi={10.1080/00224065.1969.11980358}}@article{hald1967determination, author={Hald, A.}, title={{The determination of single sampling attribute plans with given producer's and consumer's risk}}, journal={Technometrics}, year={1967}, volume={9}, number={3}, pages={401--415}, doi={10.1080/00401706.1967.10490484}}@article{page1954continuous, author={Page, E. S.}, title={{Continuous inspection schemes}}, journal={Biometrika}, year={1954}, volume={41}, number={1–2}, pages={100--115}, doi={10.1093/biomet/41.1-2.100}}@article{papadakis1985deming, author={Papadakis, Emmanuel P.}, title={{The Deming inspection criterion for choosing zero or 100 percent inspection}}, journal={Journal of Quality Technology}, year={1985}, volume={17}, number={3}, pages={121--127}, doi={10.1080/00224065.1985.11978950}}