Przykład: hurtownia części do maszyn rolniczych
Fikcyjna hurtownia zaopatruje gospodarstwa i serwisy w części do ciągników, siewników, opryskiwaczy, kombajnów i pras – 800 indeksów. Ma tygodniowy popyt z trzech lat (156 tygodni, 133 355 sztuk, 36.28 mln zł obrotu). W 73.1% par „indeks × tydzień” nikt nic nie kupił. Kierownik zakupów pyta: jak prognozować takie indeksy, jak sprawdzić, która prognoza jest lepsza, i ile sztuk trzymać na półce?
Zwykła średnia z tygodni z zerami i zwykłe wygładzanie wykładnicze źle pasują do takiego szeregu czasowego. Croston (1972) pokazał, że przy popycie sporadycznym wygładzanie daje niewłaściwe zapasy, i zaproponował prognozować osobno wielkość popytu i odstęp między popytami.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Szansę popytu w tygodniu i wielkość zamówienia każdego indeksu losowaliśmy z ręcznie ustalonych rozkładów (lista przy kodzie). Rzadko kupowane części do siewników i opryskiwaczy mają sezon wiosną, do kombajnów i pras – w żniwa. 49 indeksów (ok. 5%) to części do maszyn wycofywanych z użytku: od tygodnia 105–120 popyt prawie znika. Lata 1–2 to historia, rok 3 – okres testowy. Po pierwszym uruchomieniu zmieniliśmy trzy ustawienia: zasięg sezonu, regułę wyboru przykładowych indeksów i indeks na Rysunku 5 (szczegóły przy kodzie). Ziaren nie zmienialiśmy. Dane: popyt-sporadyczny-hurtownia-czesci-rolniczych.csv.
Rysunek 1: cztery typy popytu
Najpierw podział indeksów. Wpis o analizie ABC/XYZ pokazał, że współczynnik zmienności tygodniowej sprzedaży mierzy przy popycie z zerami głównie liczbę pustych tygodni. Dlatego używamy dwóch liczb: ADI – średni odstęp między tygodniami z popytem (104 tygodnie / liczba tygodni z popytem) – i CV² – kwadrat współczynnika zmienności wielkości w tygodniach, w których ktoś kupił. Progi 1.32 i 0.49 pochodzą z porównania błędów metod prognozy (Syntetos i in., 2005).
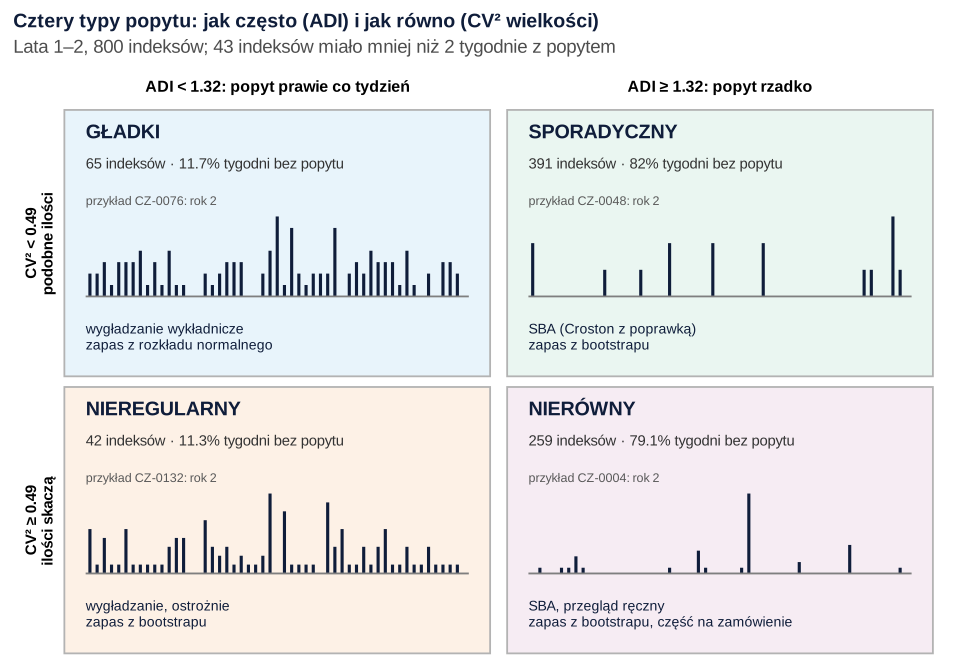
set.seed(758)).Co widać. 650 z 800 indeksów (81.2%) ma popyt rzadki: 391 sporadyczny i 259 nierówny, z ok. 80% pustych tygodni. Przynoszą 55.2% obrotu, więc nie da się ich zbyć regułą „i tak mało znaczą”. Tylko 107 indeksów kupuje się prawie co tydzień, a 43 miały w dwóch latach mniej niż dwa tygodnie z popytem.
Jak może zmylić. Progi są umowne, a indeks z ADI = 1.31 nie różni się od indeksu z ADI = 1.33. ADI liczone z dwóch lat nie widzi sezonu: część do siewnika z ADI = 5 może w kwietniu schodzić co tydzień.
Podpis do pracy:
Rysunek 2: metoda Crostona krok po kroku
Weźmy indeks CZ-0048: część do ciągnika, w dwóch latach kupowana w 20 tygodniach (ADI = 5.2). Metoda Crostona prowadzi dwie wygładzane wielkości, aktualizowane tylko w tygodniu z popytem:
- z – wielkość zamówienia: z ← z + α(popyt − z);
- x – odstęp od poprzedniego popytu: x ← x + α(odstęp − x).
W R liczy ją funkcja croston() z pakietu forecast (Hyndman i Khandakar, 2008); argument type = "sba" daje SBA. Po dwóch latach z = 1.471 sztuki i x = 6.074 tygodnia, więc prognoza Crostona to 0.242 sztuki na tydzień, a SBA – 0.230. Wygładzanie wykładnicze w tym samym tygodniu dawało 0.547, bo popyt pojawił się w ostatnich tygodniach. Prawdziwa średnia (znana, bo dane są fikcyjne) to 0.362.
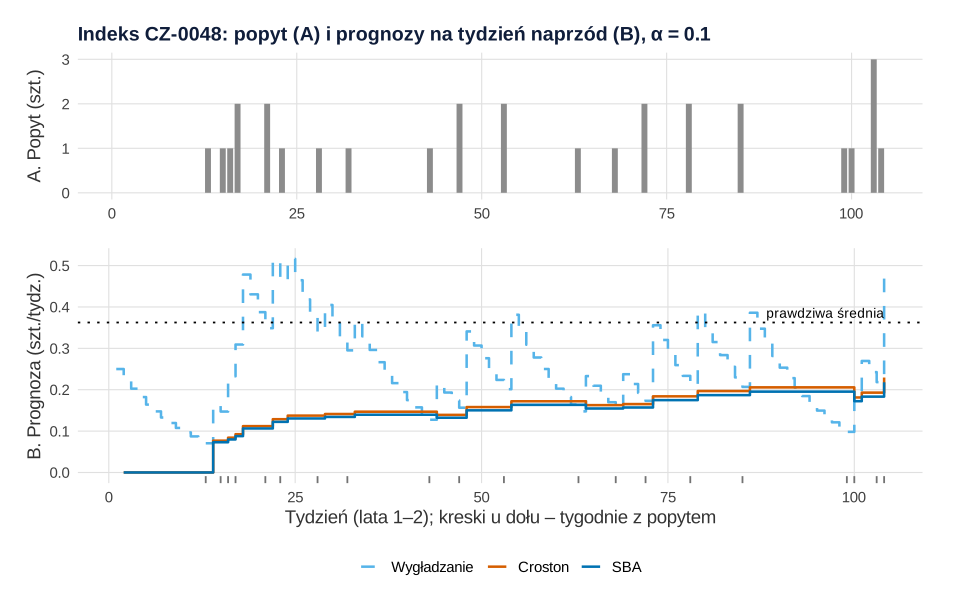
set.seed(758)).Co widać. Wygładzanie reaguje na każdy popyt skokiem, a potem przez kilka tygodni opada. Croston i SBA trzymają poziom w pustych tygodniach. Zamówienie składane zaraz po popycie dostaje od wygładzania zawyżoną prognozę – to problem, który opisał Croston (1972).
Jak może zmylić. Na jednym indeksie żadna metoda nie trafia w prawdziwą średnią: 20 popytów to mało, a start Crostona od pierwszego popytu jest przypadkowy. O obciążeniu decyduje dopiero symulacja na wielu szeregach.
Rysunek 3: obciążenie Crostona i poprawka SBA
Prognoza Crostona jest obciążona w górę (Teunter i in., 2011): średnia z ilorazu z/x to nie iloraz średnich. Syntetos i Boylan (2001) wskazali błąd w wyprowadzeniu Crostona i zaproponowali poprawkę dającą prognozy w przybliżeniu nieobciążone – to SBA. Sprawdzamy to symulacją: 1000 szeregów po 300 tygodni na każdą kombinację ADI (2, 3, 5, 10) i α (0.05, 0.1, 0.2, 0.3), wielkość popytu o średniej 3; liczymy średnią prognozę z tygodni 101–300 względem prawdziwej średniej.
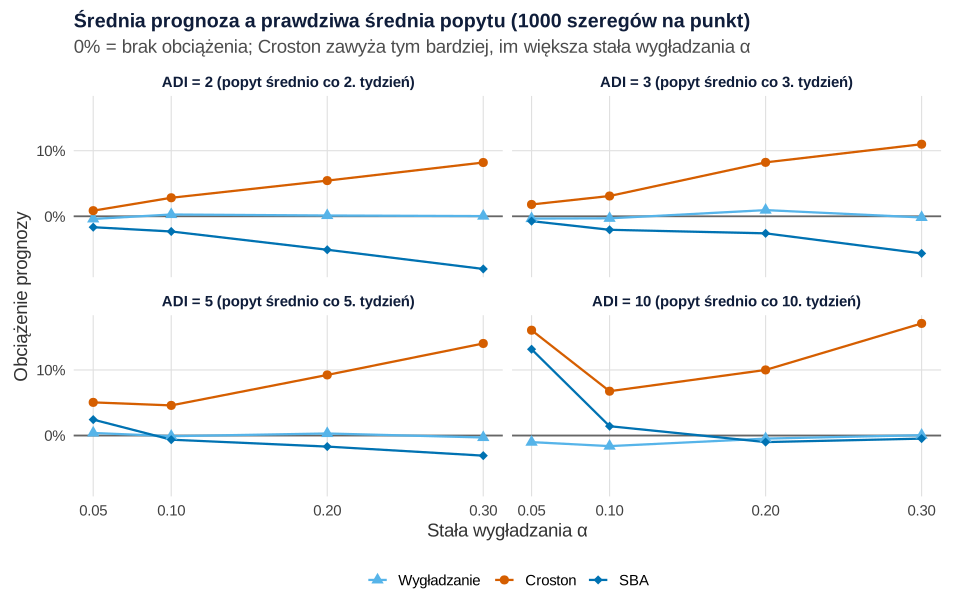
set.seed(7581)).Co widać. Croston zawyża zawsze, tym mocniej, im większe α i rzadszy popyt. SBA usuwa większość obciążenia. Przy częstym popycie (ADI = 2) i dużym α przesadza w dół (−8.0%), a nieobciążone w tym sensie jest też zwykłe wygładzanie. Odstające punkty przy ADI = 10 i α = 0.05 to efekt startu: przy 10 popytach w 100 tygodniach rozbiegu metoda nie zdążyła „zapomnieć” pierwszego odstępu.
Jak może zmylić. Brak obciążenia „średnio w czasie” nie znaczy, że prognoza jest dobra tuż po popycie. Rozkład popytu w symulacji jest stały – bez sezonu i wycofań.
Rysunek 4: jak oceniać prognozy, gdy większość tygodni to zera
Na roku 3 liczymy prognozy na tydzień naprzód pięcioma metodami: zero, średnia z całej historii, wygładzanie, Croston i SBA (wszystkie z α = 0.1). Typowe miary błędu prognozy zawodzą tu z trzech powodów:
- MAPE dzieli przez popyt. W roku 3 indeksy rzadkie miały 82.1% tygodni z zerem i żaden nie obszedł się bez zera.
- MAE nagradza medianę, a mediana popytu w takim tygodniu to 0. Prognoza „zero” miała najmniejszy MAE w 98.2% indeksów rzadkich.
- MASE (MAE podzielony przez MAE prognozy naiwnej w historii) pozwala uśredniać błędy indeksów o różnej skali (Hyndman i Koehler, 2006), ale jako przeskalowany MAE też woli zero.
Dlatego dodajemy błąd skumulowany: suma prognoz minus suma popytu, w procentach popytu. Pokazuje, czy metoda systematycznie zawyża (nadmiar zapasu) albo zaniża (braki).
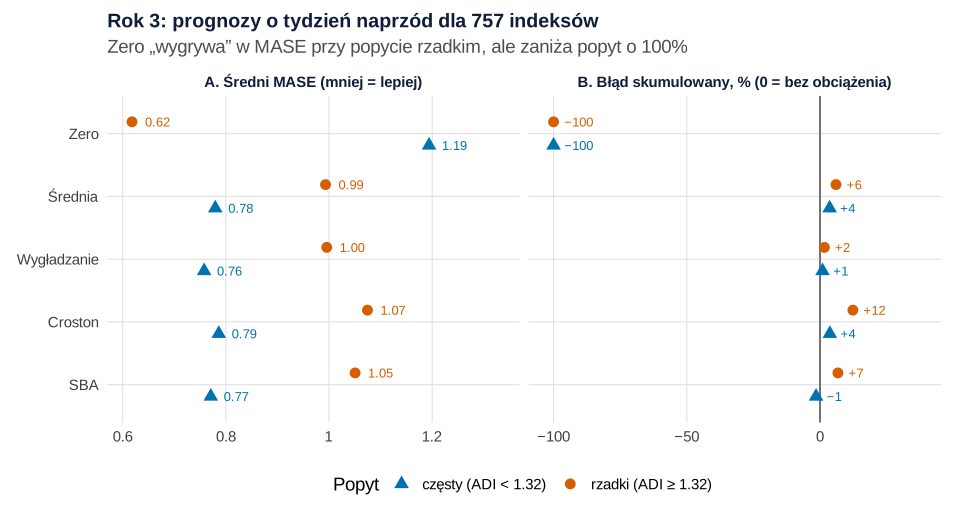
set.seed(758)).Co widać. Przy popycie rzadkim zero „wygrywa” w MASE (0.62 wobec 0.99–1.07), choć zaniża popyt o 100%. Błąd skumulowany Crostona to +12.3%, SBA +6.7%, wygładzania +1.6%. Bez 40 wycofywanych indeksów rzadkich spada do +6.4, +1.1 i +0.4% – większość nadwyżki Crostona to części, których nikt już nie kupuje. Przy popycie częstym metody wypadają podobnie (MASE 0.76–0.79).
Jak może zmylić. Żadna z tych miar nie mówi, ile zapasu trzeba i ilu braków unikniemy. To sprawdza dopiero symulacja zapasu (Rysunek 6).
Rysunek 5: zapas dla rzadkiej części – bootstrap
Hurtownia zamawia co tydzień, a dostawa przychodzi po 2 tygodniach. Zamówienie musi więc pokryć popyt z 3 tygodni. Zapas docelowy to percentyl rozkładu tego popytu, np. 95%. Mechanikę kwantyla krytycznego i zapasu bezpieczeństwa opisuje wpis o modelu gazeciarza i zapasie bezpieczeństwa. Tu chodzi o kształt rozkładu.
Dwa sposoby dla indeksu CZ-0004 (popyt nierówny: 31 tygodni z popytem w dwóch latach, największy 14 sztuk): rozkład normalny ze średnią 3 × SBA i odchyleniem z błędów prognozy oraz bootstrap – 10 000 razy losujemy ze zwracaniem 3 tygodnie z historii i sumujemy (mechanikę pokazuje wpis bootstrap na obrazkach).
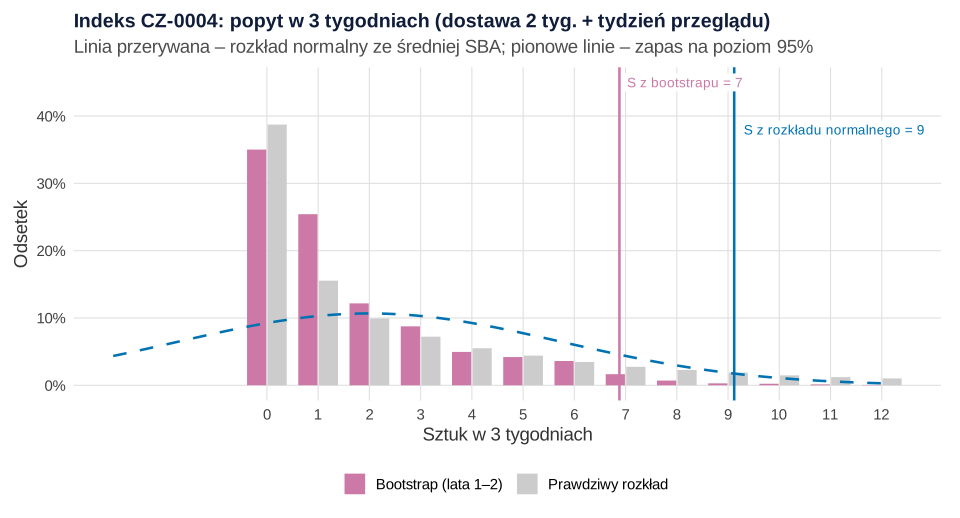
set.seed(7582) i set.seed(7583)).Co widać. Rozkład normalny przypisuje 29.6% szans popytowi ujemnemu i nie widzi, że najczęstszy wynik to zero. Bootstrap zachowuje zera i długi ogon. Na poziomie 95% bootstrap daje 7 sztuk (prawdziwy poziom obsługi 87.6%), rozkład normalny 9 (91.7%), a prawda wymagałaby 12. Na poziomie 98% bootstrap daje 14 sztuk (96.9%), normalny tylko 10 (93.2%).
Jak może zmylić. Bootstrap nie wymyśli zamówienia większego niż największe w historii. Przy 31 popytach dwa lata to mało, a ta część miała akurat mniejsze zamówienia niż jej prawdziwa średnia – obie metody zaniżają zapas.
Rysunek 6: ocena przez poziom obsługi
Teunter i Duncan (2009) pokazali, że tradycyjne miary błędu liczone tydzień po tygodniu nie nadają się do popytu sporadycznego, i porównywali metody przez osiągany poziom obsługi i zapas. Robimy to samo dla 650 indeksów rzadkich w roku 3: co tydzień zamawiamy do poziomu S z celu 80, 90, 95 lub 98%. Braki czekają w zaległościach, a mierzymy odsetek popytu wydany od ręki i średnią wartość zapasu. Bootstrap przeliczamy co 4 tygodnie z ostatnich 104 tygodni.
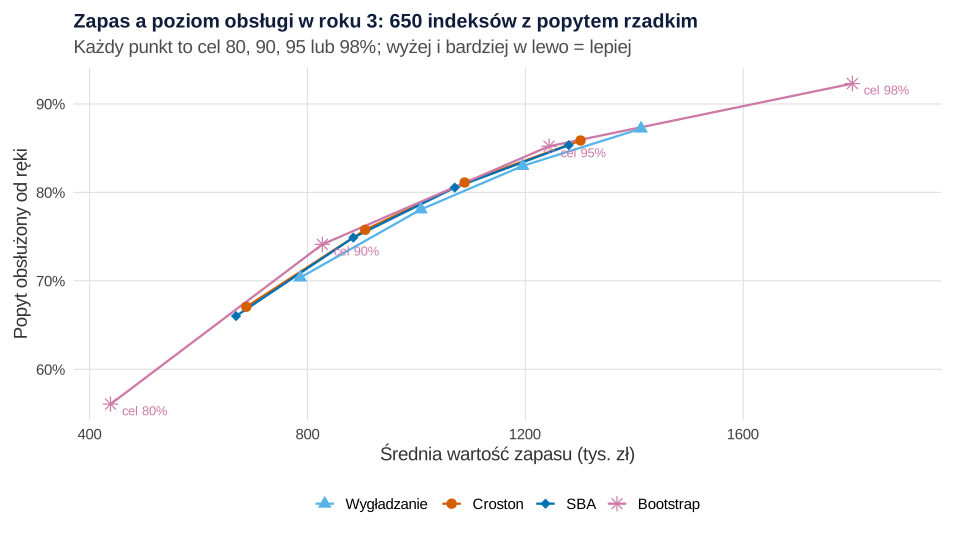
set.seed(758) i set.seed(7584)).Co widać. Żadna metoda nie osiąga celu: przy celu 95% wygładzanie obsługuje od ręki 83.0% popytu, Croston 81.1%, SBA 80.5%, a bootstrap 85.2%. Punkty metod opartych na rozkładzie normalnym leżą prawie na jednej krzywej. Różnią się głównie tym, ile zapasu wybiorą przy tym samym celu, a nie tym, jak dobrze go wykorzystają. Bootstrap mocniej reaguje na cel: przy 98% daje 92.3% obsługi za 1800.4 tys. zł. Prognoza „zero” dałaby zerowy zapas i zerową obsługę od ręki. W literaturze Croston i bootstrap wyprzedzały wygładzanie (Teunter i Duncan, 2009). W naszych danych różnice są małe.
Jak może zmylić. Wynik zależy od reguły zamawiania i czasu dostawy. Odsetek obsłużony od ręki to nie szansa, że zapas wystarczy na cały cykl – podaj, który poziom obsługi mierzysz.
Co z tym zrobić w firmie
- Sklasyfikuj indeksy co kwartał. Dla popytu gładkiego wystarczy wygładzanie, dla sporadycznego i nierównego – SBA, nie średnia z zerami. Indeksy z jednym popytem na rok zamawiaj pod klienta albo trzymaj z decyzji kierownika.
- Zamiast MAPE raportuj MASE, błąd skumulowany i obsługę od ręki. Ranking metod z samego MAE wybierze zero.
- Licz zapas z rozkładu popytu w czasie dostawy. Nie mnóż prognozy przez liczbę tygodni z doliczonym „normalnym” zapasem bezpieczeństwa. Czas dostawy też jest niepewny; jak porównać dostawców na wysokim percentylu, pokazuje wpis o czasie realizacji dostaw.
- Oddziel sezon. Przy celu 95% bootstrap obsłużył od ręki 78.2% popytu w sezonie i 88.8% poza nim, SBA – 71.7% i 85.8%. Przed sezonem licz zapas z tych samych tygodni lat poprzednich, jak w prognozie z sezonowością (zob. prognoza sprzedaży: sezonowość i promocje).
- Alarm dla części wycofywanych. Po 26 pustych tygodniach indeks idzie do przeglądu. W przykładzie 40 wycofywanych indeksów rzadkich zostawiło na koniec roku 3 zapas za 83.1 tys. zł przy SBA i 96.9 tys. zł przy bootstrapie.
Jak opisać w pracy
Ogólne wskazówki: statystyka w pracy z logistyki. Opisz podział na historię i okres testowy – prognoza z danych z przyszłości to przeciek danych.
| Metoda | MASE | Błąd skumulowany, % | Obsługa od ręki przy celu 95%, % | Średni zapas, tys. zł |
|---|---|---|---|---|
| Zero | 0.62 | −100.0 | 0 | 0 |
| Średnia | 0.99 | 6.0 | – | – |
| Wygładzanie wykładnicze | 1.00 | 1.6 | 83.0 | 1194.9 |
| Croston | 1.07 | 12.3 | 81.1 | 1088.7 |
| SBA | 1.05 | 6.7 | 80.5 | 1070.4 |
| Bootstrap | – | – | 85.2 | 1243.6 |
Kod R: klasy popytu, Croston i SBA, ocena prognoz i symulacja zapasu
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 3 – funkcje prognoz, z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Ziarna ustalono raz i nie zmieniano: dane – set.seed(758), symulacja obciążenia – set.seed(7581), bootstrap dla jednego indeksu – set.seed(7582), prawdziwy rozkład tego indeksu – set.seed(7583), bootstrap w symulacji zapasu – set.seed(7584). Ręcznie ustalono: 800 indeksów i 156 tygodni; grupy maszyn (ciągniki 40%, siewniki i opryskiwacze 30%, kombajny i prasy 30%); 15% indeksów częstych z szansą popytu w tygodniu od 0.75 do 1, pozostałe z rozkładu beta(1.2, 5); wielkość zamówienia 1 + rozkład ujemny dwumianowy ze średnią z rozkładu lognormalnego (log-średnia 0.7, SD 0.8) i parametrem kształtu 5 albo 0.6 (po połowie indeksów); cenę z rozkładu lognormalnego (mediana 180 zł, SD 0.9 w skali log); sezon rzadkich części do siewników i opryskiwaczy w tygodniach 10–20, do kombajnów i pras w tygodniach 27–37 (szansa popytu × 2 w sezonie i × 0.6 poza nim); 5% indeksów wycofywanych od tygodnia 105–120 (szansa popytu × 0.05); α = 0.1; dostawę po 2 tygodniach; w symulacji obciążenia ADI 2, 3, 5 i 10, α od 0.05 do 0.3, wielkość 1 + ujemny dwumianowy (średnia 2, kształt 2), 1000 szeregów po 300 tygodni z rozbiegiem 100 tygodni; bootstrap 10 000 prób dla jednego indeksu i 1000 prób przeliczanych co 4 tygodnie w symulacji zapasu. Po pierwszym uruchomieniu zmieniono trzy rzeczy: sezon w szansie popytu dotyczy tylko indeksów rzadkich (wcześniej popyt częsty miały tylko 44 indeksy), przykładowe indeksy wybiera reguła „typowe ADI” (≤ 1.2 dla popytu częstego, 3–6 dla rzadkiego; pierwszy wybór miał ADI = 26), a w przepisie 6 indeks CZ-0048 zastąpiono indeksem o popycie nierównym CZ-0004, bo dla CZ-0048 oba sposoby dawały ten sam zapas. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: popyt tygodniowy 800 indeksów przez 3 lata
R
# Przepis 1. Fikcyjna hurtownia części do maszyn rolniczych: popyt tygodniowy 800 indeksów przez 3 lata
library(ggplot2)
options(width = 110)                                   # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii), kształty punktów i prosty motyw rysunków
kol <- c("Zero" = "grey45", "Średnia" = "#009E73", "Wygładzanie" = "#56B4E9", "Croston" = "#D55E00",
         "SBA" = "#0072B2", "Bootstrap" = "#CC79A7")
ksz <- c("Zero" = 4, "Średnia" = 15, "Wygładzanie" = 17, "Croston" = 16, "SBA" = 18, "Bootstrap" = 8)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)                 # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie
n <- 800; tyg <- 156                                   # 800 indeksów, 156 tygodni (lata 2023–2025)
grupy <- c("Ciągniki", "Siewniki i opryskiwacze", "Kombajny i prasy")
sezon_tyg <- list("Siewniki i opryskiwacze" = 10:20,   # sezon prac polowych: wiosna
                  "Kombajny i prasy" = 27:37)          # i żniwa (tygodnie roku)
mnoznik_w_sezonie <- 2; mnoznik_poza <- 0.6            # szansa popytu w sezonie i poza nim (× bazowa;
                                                       # tylko indeksy rzadkie – częste kupuje się cały rok)
odsetek_czestych <- 0.15                               # indeksy kupowane prawie co tydzień
odsetek_wycofywanych <- 0.05                           # części do maszyn, których już się nie używa
spadek_po_wycofaniu <- 0.05                            # szansa popytu po wycofaniu (× bazowa)

set.seed(758)
grupa <- sample(grupy, n, replace = TRUE, prob = c(0.4, 0.3, 0.3))
czesty <- runif(n) < odsetek_czestych
p <- ifelse(czesty, runif(n, 0.75, 1), rbeta(n, 1.2, 5))      # bazowa szansa, że w tygodniu ktoś kupi
sr_nadwyzka <- exp(rnorm(n, 0.7, 0.8))                 # wielkość zamówienia = 1 + ujemny dwumianowy(średnia)
ksztalt <- ifelse(runif(n) < 0.5, 5, 0.6)              # 5 – podobne ilości, 0.6 – ilości skaczą
cena <- round(exp(rnorm(n, log(180), 0.9)))            # cena części (zł)
wycofywany <- runif(n) < odsetek_wycofywanych
tydz_wycof <- ifelse(wycofywany, sample(105:120, n, replace = TRUE), Inf)

tydz_roku <- rep(1:52, 3)
P <- t(sapply(1:n, function(i) {
  m <- rep(1, tyg)
  if (grupa[i] != "Ciągniki" && !czesty[i]) m <- ifelse(tydz_roku %in% sezon_tyg[[grupa[i]]], mnoznik_w_sezonie, mnoznik_poza)
  m[seq_len(tyg) >= tydz_wycof[i]] <- m[seq_len(tyg) >= tydz_wycof[i]] * spadek_po_wycofaniu
  pmin(1, p[i] * m)
}))
zdarzenie <- matrix(runif(n * tyg) < P, n)
wielkosc <- 1 + matrix(rnbinom(n * tyg, size = rep(ksztalt, tyg), mu = rep(sr_nadwyzka, tyg)), n)
Y <- zdarzenie * wielkosc                              # popyt: wiersz = indeks, kolumna = tydzień
indeks <- sprintf("CZ-%04d", 1:n)
rownames(Y) <- indeks

dane <- data.frame(indeks, grupa, cena, wycofywany_prawda = wycofywany, Y)
names(dane)[-(1:4)] <- sprintf("t%03d", 1:tyg)
write.csv(dane, "popyt-sporadyczny-hurtownia-czesci-rolniczych.csv", row.names = FALSE)

c(indeksy = n, tygodnie = tyg, sztuki = sum(Y), proc_tygodni_zero = round(100 * mean(Y == 0), 1),
  indeksy_wycofywane = sum(wycofywany), obrot_mln_zl = round(sum(Y * cena) / 1e6, 2))
table(grupa)
Wynik w R
           indeksy           tygodnie             sztuki  proc_tygodni_zero indeksy_wycofywane
            800.00             156.00          133355.00              73.10              49.00
      obrot_mln_zl
             36.28
grupa
               Ciągniki        Kombajny i prasy Siewniki i opryskiwacze
                    308                     248                     244
2. Klasy popytu z ADI i CV², karta typów: Rysunek 1
R
# Przepis 2. Klasy popytu z ADI i CV² (lata 1–2) i grafika: karta czterech typów popytu (Rysunek 1)
hist_tyg <- 1:104                                      # historia: lata 1–2; rok 3 to okres testowy
H <- Y[, hist_tyg]
ile_popytow <- rowSums(H > 0)
adi <- length(hist_tyg) / ile_popytow                  # średni odstęp między tygodniami z popytem
cv2 <- apply(H, 1, function(x) { z <- x[x > 0]; if (length(z) < 2) NA else (sd(z) / mean(z))^2 })
klasa <- ifelse(ile_popytow < 2, "za mało danych",
         ifelse(adi < 1.32, ifelse(cv2 < 0.49, "gładki", "nieregularny"),
                            ifelse(cv2 < 0.49, "sporadyczny", "nierówny")))
kolejnosc <- c("gładki", "nieregularny", "sporadyczny", "nierówny", "za mało danych")
klasa <- factor(klasa, kolejnosc)

podsum <- do.call(rbind, lapply(split(seq_len(n), klasa), function(i) data.frame(
  indeksy = length(i), proc_indeksow = round(100 * length(i) / n, 1),
  mediana_ADI = round(median(adi[i]), 2), mediana_CV2 = round(median(cv2[i], na.rm = TRUE), 2),
  proc_tygodni_zero = round(100 * mean(H[i, ] == 0), 1),
  proc_obrotu = round(100 * sum(H[i, ] * cena[i]) / sum(H * cena), 1))))
podsum
rzadki <- klasa %in% c("sporadyczny", "nierówny")
c(indeksy_rzadkie = sum(rzadki), proc_indeksow = round(100 * mean(rzadki), 1),
  proc_obrotu = round(100 * sum(H[rzadki, ] * cena[rzadki]) / sum(H * cena), 1))

# Przykładowy indeks każdej klasy: pierwszy z grupy „Ciągniki” (bez sezonu), niewycofywany,
# o typowym ADI (≤ 1.2 dla popytu częstego, 3–6 dla rzadkiego)
typowe_adi <- ifelse(klasa %in% c("gładki", "nieregularny"), adi <= 1.2, adi >= 3 & adi <= 6)
przyklad <- sapply(kolejnosc[1:4], function(k) which(klasa == k & grupa == "Ciągniki" & !wycofywany & typowe_adi)[1])
rbind(indeks = indeks[przyklad], ADI = round(adi[przyklad], 2), CV2 = round(cv2[przyklad], 2))

# Karta: 2 × 2 pola, w każdym liczba indeksów, mini-wykres 52 tygodni (rok 2) przykładu i metoda
pola <- data.frame(klasa = kolejnosc[1:4], x0 = c(0, 0, 1.04, 1.04), y0 = c(1.04, 0, 1.04, 0),
                   tlo = c("#E8F4FB", "#FDF1E6", "#EAF6F1", "#F6ECF3"),
                   metoda = c("wygładzanie wykładnicze\nzapas z rozkładu normalnego",
                              "wygładzanie, ostrożnie\nzapas z bootstrapu",
                              "SBA (Croston z poprawką)\nzapas z bootstrapu",
                              "SBA, przegląd ręczny\nzapas z bootstrapu, część na zamówienie"))
pola$liczba <- podsum[pola$klasa, "indeksy"]
pola$zera <- podsum[pola$klasa, "proc_tygodni_zero"]
slupki <- do.call(rbind, lapply(1:4, function(j) {
  y2 <- Y[przyklad[j], 53:104]
  data.frame(klasa = pola$klasa[j], x = pola$x0[j] + 0.06 + (0:51) * 0.88 / 52,
             y0 = pola$y0[j] + 0.30, y1 = pola$y0[j] + 0.30 + 0.30 * y2 / max(Y[przyklad[j], 53:104]))
}))
p1 <- ggplot() +
  geom_rect(data = pola, aes(xmin = x0, xmax = x0 + 1, ymin = y0, ymax = y0 + 1, fill = tlo), colour = "grey70") +
  scale_fill_identity() +
  geom_segment(data = slupki, aes(x = x, xend = x, y = y0, yend = y1), linewidth = 1.1, colour = "#0f1d3a") +
  geom_segment(data = pola, aes(x = x0 + 0.05, xend = x0 + 0.95, y = y0 + 0.30, yend = y0 + 0.30), colour = "grey50") +
  geom_text(data = pola, aes(x = x0 + 0.05, y = y0 + 0.92, label = toupper(klasa)), hjust = 0, fontface = "bold",
            size = 5.2, colour = "#0f1d3a") +
  geom_text(data = pola, aes(x = x0 + 0.05, y = y0 + 0.80,
                             label = paste0(liczba, " indeksów · ", zera, "% tygodni bez popytu")),
            hjust = 0, size = 3.9, colour = "grey20") +
  geom_text(data = pola, aes(x = x0 + 0.05, y = y0 + 0.66, label = paste0("przykład ", indeks[przyklad], ": rok 2")),
            hjust = 0, size = 3.3, colour = "grey35") +
  geom_text(data = pola, aes(x = x0 + 0.05, y = y0 + 0.15, label = metoda), hjust = 0, size = 3.7,
            lineheight = 0.95, colour = "#0f1d3a") +
  annotate("text", x = c(0.5, 1.54), y = 2.13, label = c("ADI < 1.32: popyt prawie co tydzień",
                                                         "ADI ≥ 1.32: popyt rzadko"), fontface = "bold", size = 4.2) +
  annotate("text", x = -0.06, y = c(1.54, 0.5), label = c("CV² < 0.49\npodobne ilości", "CV² ≥ 0.49\nilości skaczą"),
           angle = 90, fontface = "bold", size = 4, lineheight = 0.9) +
  coord_cartesian(xlim = c(-0.12, 2.06), ylim = c(-0.02, 2.2), expand = FALSE) +
  labs(title = "Cztery typy popytu: jak często (ADI) i jak równo (CV² wielkości)",
       subtitle = paste0("Lata 1–2, 800 indeksów; ", podsum["za mało danych", "indeksy"],
                         " indeksów miało mniej niż 2 tygodnie z popytem")) +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("popyt-sporadyczny-karta-typow.svg", p1, width = 10, height = 7)
Wynik w R
               indeksy proc_indeksow mediana_ADI mediana_CV2 proc_tygodni_zero proc_obrotu
gładki              65           8.1        1.13        0.29              11.7        30.0
nieregularny        42           5.2        1.12        1.02              11.3        14.8
sporadyczny        391          48.9        6.93        0.26              82.0        26.9
nierówny           259          32.4        5.47        0.87              79.1        28.3
za mało danych      43           5.4      104.00          NA              99.4         0.1
indeksy_rzadkie   proc_indeksow     proc_obrotu
          650.0            81.2            55.2
       CZ-0076   CZ-0132   CZ-0048   CZ-0004
indeks "CZ-0076" "CZ-0132" "CZ-0048" "CZ-0004"
ADI    "1.14"    "1.13"    "5.2"     "3.35"
CV2    "0.31"    "0.88"    "0.17"    "1.24"
3. Metoda Crostona krok po kroku: Rysunek 2
R
# Przepis 3. Metoda Crostona krok po kroku na jednym indeksie i porównanie z wygładzaniem (Rysunek 2)
library(forecast)
alfa <- 0.1                                            # stała wygładzania (ta sama we wszystkich metodach)

# Prognozy „na tydzień t z danych do t − 1” dla wielu szeregów naraz (wiersz = szereg).
# Croston: osobno wygładza wielkość niezerowego popytu (z) i odstęp między popytami (x); prognoza = z / x.
# SBA (Syntetos–Boylan): ta sama prognoza razy (1 − alfa / 2). Przed pierwszym popytem prognoza = 0.
croston_mac <- function(Y, alfa, typ = c("croston", "sba")) {
  typ <- match.arg(typ); wsp <- if (typ == "sba") 1 - alfa / 2 else 1
  Y <- rbind(Y); k <- nrow(Y); Tn <- ncol(Y)
  z <- x <- rep(NA_real_, k); od_ost <- rep(0, k); F <- matrix(0, k, Tn); F[, 1] <- NA
  for (t in 1:Tn) {
    if (t > 1) F[, t] <- ifelse(is.na(z), 0, wsp * z / x)
    od_ost <- od_ost + 1; d <- Y[, t] > 0
    pierwszy <- d & is.na(z); dalszy <- d & !is.na(z)
    z[pierwszy] <- Y[pierwszy, t]; x[pierwszy] <- od_ost[pierwszy]
    z[dalszy] <- z[dalszy] + alfa * (Y[dalszy, t] - z[dalszy])
    x[dalszy] <- x[dalszy] + alfa * (od_ost[dalszy] - x[dalszy])
    od_ost[d] <- 0
  }
  structure(F, z = z, x = x)                           # stan końcowy: wygładzona wielkość i odstęp
}
# Zwykłe wygładzanie wykładnicze z poziomem startowym = średnia z pierwszych 52 tygodni
ses_mac <- function(Y, alfa) {
  Y <- rbind(Y); l <- rowMeans(Y[, 1:52, drop = FALSE]); F <- matrix(NA_real_, nrow(Y), ncol(Y))
  for (t in 1:ncol(Y)) { F[, t] <- l; l <- l + alfa * (Y[, t] - l) }
  F
}
# Średnia z całej dotychczasowej historii
srednia_mac <- function(Y) { Y <- rbind(Y); S <- t(apply(Y, 1, cumsum)); cbind(NA, S[, -ncol(Y)] / rep(1:(ncol(Y) - 1), each = nrow(Y))) }

# Kontrola: nasza funkcja daje te same prognozy co forecast::croston (dopasowane = prognozy o krok naprzód)
i0 <- przyklad[["sporadyczny"]]
y0 <- ts(Y[i0, ])
c(croston = isTRUE(all.equal(c(croston_mac(Y[i0, ], alfa)[1, ]), as.numeric(croston(y0, alpha = alfa)$fitted))),
  sba = isTRUE(all.equal(c(croston_mac(Y[i0, ], alfa, "sba")[1, ]),
                         as.numeric(croston(y0, alpha = alfa, type = "sba")$fitted))))

# Przykładowy indeks: stan po roku 2 (tydzień 104) i prawdziwa średnia (znana, bo dane są fikcyjne)
prawda_srednia <- p[i0] * (1 + sr_nadwyzka[i0])
c(indeks = indeks[i0], ADI = round(adi[[i0]], 2), CV2 = round(cv2[[i0]], 2), tygodnie_z_popytem = ile_popytow[[i0]])
stan <- croston_mac(Y[i0, hist_tyg], alfa)
round(c(z_wygladzona_wielkosc = attr(stan, "z"), x_wygladzony_odstep = attr(stan, "x"),
        croston = attr(stan, "z") / attr(stan, "x"), sba = (1 - alfa / 2) * attr(stan, "z") / attr(stan, "x"),
        wygladzanie = ses_mac(Y[i0, ], alfa)[1, 105], srednia = mean(Y[i0, hist_tyg]),
        prawdziwa_srednia = prawda_srednia), 3)

# Rysunek 2: popyt w latach 1–2 i trzy prognozy o tydzień naprzód
tt <- 1:104
dl <- rbind(data.frame(t = tt, f = ses_mac(Y[i0, ], alfa)[1, tt], metoda = "Wygładzanie"),
            data.frame(t = tt, f = croston_mac(Y[i0, ], alfa)[1, tt], metoda = "Croston"),
            data.frame(t = tt, f = croston_mac(Y[i0, ], alfa, "sba")[1, tt], metoda = "SBA"))
dl$metoda <- factor(dl$metoda, c("Wygładzanie", "Croston", "SBA"))
p2a <- ggplot(data.frame(t = tt, y = Y[i0, tt]), aes(t, y)) +
  geom_col(fill = "grey55", width = 0.8) +
  labs(title = paste0("Indeks ", indeks[i0], ": popyt (A) i prognozy na tydzień naprzód (B), α = 0.1"),
       x = NULL, y = "A. Popyt (szt.)") + motyw
p2b <- ggplot(dl, aes(t, f, colour = metoda, linetype = metoda)) +
  geom_step(linewidth = 0.9, na.rm = TRUE) +
  geom_rug(data = data.frame(t = tt[Y[i0, tt] > 0]), aes(x = t), inherit.aes = FALSE, colour = "grey45") +
  geom_hline(yintercept = prawda_srednia, linetype = "dotted", colour = "black") +
  annotate("text", x = 104, y = prawda_srednia, label = "prawdziwa średnia", vjust = -0.5, hjust = 1, size = 3.6) +
  scale_colour_manual(values = kol) + scale_linetype_manual(values = c("dashed", "solid", "solid")) +
  labs(x = "Tydzień (lata 1–2); kreski u dołu – tygodnie z popytem", y = "B. Prognoza (szt./tydz.)",
       colour = NULL, linetype = NULL) + motyw
p2 <- patchwork::wrap_plots(p2a, p2b, ncol = 1, heights = c(1, 1.6))
p2   # zapis: ggsave("popyt-sporadyczny-croston-krok-po-kroku.svg", p2, width = 10, height = 6.4)
Wynik w R
croston     sba
   TRUE    TRUE
            indeks                ADI                CV2 tygodnie_z_popytem
         "CZ-0048"              "5.2"             "0.17"               "20"
z_wygladzona_wielkosc   x_wygladzony_odstep               croston                   sba           wygladzanie
                1.471                 6.074                 0.242                 0.230                 0.547
              srednia     prawdziwa_srednia
                0.279                 0.362
4. Obciążenie Crostona i SBA – symulacja: Rysunek 3
R
# Przepis 4. Obciążenie metody Crostona i poprawka SBA – symulacja przy znanej średniej (Rysunek 3)
set.seed(7581)
powt <- 1000; dl_szeregu <- 300; rozbieg <- 100        # 1000 szeregów po 300 tygodni; oceniamy tygodnie 101–300
srednia_wielk <- 3                                     # wielkość popytu: 1 + ujemny dwumianowy (średnia 2, kształt 2)
siatka <- expand.grid(adi = c(2, 3, 5, 10), alfa = c(0.05, 0.1, 0.2, 0.3))
wyniki <- do.call(rbind, lapply(seq_len(nrow(siatka)), function(j) {
  pr <- 1 / siatka$adi[j]; a <- siatka$alfa[j]; mu <- pr * srednia_wielk       # prawdziwa średnia na tydzień
  Ys <- matrix((runif(powt * dl_szeregu) < pr) * (1 + rnbinom(powt * dl_szeregu, size = 2, mu = 2)), powt)
  ocena <- (rozbieg + 1):dl_szeregu
  do.call(rbind, lapply(c("Wygładzanie", "Croston", "SBA"), function(m) {
    F <- switch(m, "Wygładzanie" = ses_mac(Ys, a), "Croston" = croston_mac(Ys, a), "SBA" = croston_mac(Ys, a, "sba"))
    sr <- rowMeans(F[, ocena])                         # średnia prognoza w każdym szeregu
    data.frame(ADI = siatka$adi[j], alfa = a, metoda = m, obciazenie_proc = 100 * (mean(sr) / mu - 1),
               blad_MC_pp = 100 * sd(sr) / sqrt(powt) / mu)
  }))
}))
wyniki$metoda <- factor(wyniki$metoda, c("Wygładzanie", "Croston", "SBA"))
print(transform(wyniki, obciazenie_proc = round(obciazenie_proc, 1), blad_MC_pp = round(blad_MC_pp, 2)), row.names = FALSE)

p3 <- ggplot(wyniki, aes(alfa, obciazenie_proc, colour = metoda, shape = metoda)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  facet_wrap(~ factor(paste0("ADI = ", ADI, " (popyt średnio co ", ADI, ". tydzień)"),
                      paste0("ADI = ", c(2, 3, 5, 10), " (popyt średnio co ", c(2, 3, 5, 10), ". tydzień)")), ncol = 2) +
  scale_colour_manual(values = kol) + scale_shape_manual(values = ksz) +
  scale_x_continuous(breaks = c(0.05, 0.1, 0.2, 0.3)) + scale_y_continuous(labels = function(x) minus(paste0(x, "%"))) +
  labs(title = "Średnia prognoza a prawdziwa średnia popytu (1000 szeregów na punkt)",
       subtitle = "0% = brak obciążenia; Croston zawyża tym bardziej, im większa stała wygładzania α",
       x = "Stała wygładzania α", y = "Obciążenie prognozy", colour = NULL, shape = NULL) +
  motyw
p3   # zapis: ggsave("popyt-sporadyczny-obciazenie-crostona.svg", p3, width = 10, height = 6.4)
Wynik w R
 ADI alfa      metoda obciazenie_proc blad_MC_pp
   2 0.05 Wygładzanie            -0.4       0.29
   2 0.05     Croston             0.9       0.27
   2 0.05         SBA            -1.7       0.27
   3 0.05 Wygładzanie            -0.3       0.39
   3 0.05     Croston             1.8       0.40
   3 0.05         SBA            -0.7       0.39
   5 0.05 Wygładzanie             0.4       0.54
   5 0.05     Croston             5.1       0.68
   5 0.05         SBA             2.4       0.67
  10 0.05 Wygładzanie            -1.0       0.77
  10 0.05     Croston            16.1       1.60
  10 0.05         SBA            13.2       1.56
   2 0.10 Wygładzanie             0.3       0.29
   2 0.10     Croston             2.8       0.29
   2 0.10         SBA            -2.3       0.28
   3 0.10 Wygładzanie            -0.3       0.40
   3 0.10     Croston             3.1       0.39
   3 0.10         SBA            -2.1       0.37
   5 0.10 Wygładzanie            -0.1       0.53
   5 0.10     Croston             4.6       0.51
   5 0.10         SBA            -0.6       0.49
  10 0.10 Wygładzanie            -1.6       0.79
  10 0.10     Croston             6.8       0.88
  10 0.10         SBA             1.4       0.83
   2 0.20 Wygładzanie             0.1       0.30
   2 0.20     Croston             5.4       0.31
   2 0.20         SBA            -5.1       0.28
   3 0.20 Wygładzanie             0.9       0.40
   3 0.20     Croston             8.2       0.42
   3 0.20         SBA            -2.6       0.38
   5 0.20 Wygładzanie             0.3       0.54
   5 0.20     Croston             9.2       0.57
   5 0.20         SBA            -1.7       0.52
  10 0.20 Wygładzanie            -0.5       0.83
  10 0.20     Croston            10.0       0.82
  10 0.20         SBA            -1.0       0.73
   2 0.30 Wygładzanie             0.0       0.30
   2 0.30     Croston             8.2       0.32
   2 0.30         SBA            -8.0       0.27
   3 0.30 Wygładzanie            -0.2       0.41
   3 0.30     Croston            11.0       0.45
   3 0.30         SBA            -5.7       0.38
   5 0.30 Wygładzanie            -0.3       0.54
   5 0.30     Croston            14.0       0.61
   5 0.30         SBA            -3.1       0.52
  10 0.30 Wygładzanie             0.1       0.83
  10 0.30     Croston            17.1       0.94
  10 0.30         SBA            -0.5       0.80
5. Ocena prognoz na roku 3: Rysunek 4
R
# Przepis 5. Ocena prognoz na roku 3 przy zerach: MAPE, MAE, MASE i błąd skumulowany (Rysunek 4)
test_tyg <- 105:156
prognozy <- list("Zero" = matrix(0, n, tyg), "Średnia" = srednia_mac(Y), "Wygładzanie" = ses_mac(Y, alfa),
                 "Croston" = croston_mac(Y, alfa), "SBA" = croston_mac(Y, alfa, "sba"))
Yt <- Y[, test_tyg]
skala <- rowMeans(abs(t(apply(H, 1, diff))))            # MAE prognozy naiwnej (ostatni tydzień) w latach 1–2
rodzaj <- ifelse(klasa %in% c("sporadyczny", "nierówny"), "rzadki (ADI ≥ 1.32)",
          ifelse(klasa %in% c("gładki", "nieregularny"), "częsty (ADI < 1.32)", NA))
oceniane <- !is.na(rodzaj) & skala > 0

# MAPE wymaga dzielenia przez popyt – w tygodniu z zerem nie da się go policzyć
sapply(split(seq_len(n)[oceniane], rodzaj[oceniane]), function(i) c(
  indeksy = length(i), proc_tygodni_zero = round(100 * mean(Yt[i, ] == 0), 1),
  indeksy_bez_zera_w_roku_3 = sum(rowSums(Yt[i, ] == 0) == 0)))

miary <- do.call(rbind, lapply(names(prognozy), function(m) {
  Ft <- prognozy[[m]][, test_tyg]
  mae <- rowMeans(abs(Yt - Ft))
  do.call(rbind, lapply(split(seq_len(n)[oceniane], rodzaj[oceniane]), function(i) data.frame(
    rodzaj = rodzaj[i[1]], metoda = m, MAE = mean(mae[i]), MASE = mean(mae[i] / skala[i]),
    blad_skum_proc = 100 * (sum(Ft[i, ]) - sum(Yt[i, ])) / sum(Yt[i, ]),
    blad_skum_bez_wycof = 100 * (sum(Ft[i[!wycofywany[i]], ]) - sum(Yt[i[!wycofywany[i]], ])) /
                          sum(Yt[i[!wycofywany[i]], ]))))
}))
miary$metoda <- factor(miary$metoda, names(prognozy))
print(transform(miary, MAE = round(MAE, 3), MASE = round(MASE, 3), blad_skum_proc = round(blad_skum_proc, 1),
                blad_skum_bez_wycof = round(blad_skum_bez_wycof, 1)), row.names = FALSE)

# W ilu indeksach rzadkich najmniejszy MAE daje prognoza zerowa?
mae_all <- sapply(prognozy, function(Fm) rowMeans(abs(Yt - Fm[, test_tyg])))
rz <- which(oceniane & rodzaj == "rzadki (ADI ≥ 1.32)")
round(100 * prop.table(table(factor(colnames(mae_all)[apply(mae_all[rz, ], 1, which.min)], names(prognozy)))), 1)

dl4 <- rbind(data.frame(miara = "A. Średni MASE (mniej = lepiej)", miary[, c("rodzaj", "metoda")], wartosc = miary$MASE),
             data.frame(miara = "B. Błąd skumulowany, % (0 = bez obciążenia)", miary[, c("rodzaj", "metoda")],
                        wartosc = miary$blad_skum_proc))
dl4$metoda <- factor(dl4$metoda, rev(names(prognozy)))
p4 <- ggplot(dl4, aes(wartosc, metoda, colour = rodzaj, shape = rodzaj)) +
  geom_vline(data = data.frame(miara = unique(dl4$miara)[2], x = 0), aes(xintercept = x), colour = "grey40") +
  geom_point(size = 3.4, position = position_dodge(width = 0.75)) +
  geom_text(aes(x = wartosc + ifelse(grepl("^A", miara), 0.025, 4),
                label = minus(ifelse(grepl("^A", miara), sprintf("%.2f", wartosc), sprintf("%+.0f", wartosc)))),
            position = position_dodge(width = 0.75), hjust = 0, size = 3.4, show.legend = FALSE) +
  facet_wrap(~ miara, scales = "free_x") +
  scale_colour_manual(values = c("#0072B2", "#D55E00")) + scale_shape_manual(values = c(17, 16)) +
  scale_x_continuous(labels = function(x) minus(x), expand = expansion(mult = c(0.08, 0.25))) +
  labs(title = paste0("Rok 3: prognozy o tydzień naprzód dla ", sum(oceniane), " indeksów"),
       subtitle = "Zero „wygrywa” w MASE przy popycie rzadkim, ale zaniża popyt o 100%",
       x = NULL, y = NULL, colour = "Popyt", shape = "Popyt") +
  motyw
p4   # zapis: ggsave("popyt-sporadyczny-ocena-prognoz.svg", p4, width = 10, height = 5.4)
Wynik w R
                          częsty (ADI < 1.32) rzadki (ADI ≥ 1.32)
indeksy                                 107.0               650.0
proc_tygodni_zero                        16.6                82.1
indeksy_bez_zera_w_roku_3                12.0                 0.0
              rodzaj      metoda   MAE  MASE blad_skum_proc blad_skum_bez_wycof
 częsty (ADI < 1.32)        Zero 3.349 1.194         -100.0              -100.0
 rzadki (ADI ≥ 1.32)        Zero 0.715 0.618         -100.0              -100.0
 częsty (ADI < 1.32)     Średnia 2.330 0.779            3.6                 0.0
 rzadki (ADI ≥ 1.32)     Średnia 1.081 0.993            6.0                 1.0
 częsty (ADI < 1.32) Wygładzanie 2.299 0.758            0.9                 0.0
 rzadki (ADI ≥ 1.32) Wygładzanie 1.050 0.996            1.6                 0.4
 częsty (ADI < 1.32)     Croston 2.360 0.786            3.7                 0.6
 rzadki (ADI ≥ 1.32)     Croston 1.117 1.075           12.3                 6.4
 częsty (ADI < 1.32)         SBA 2.319 0.771           -1.5                -4.4
 rzadki (ADI ≥ 1.32)         SBA 1.093 1.051            6.7                 1.1

       Zero     Średnia Wygładzanie     Croston         SBA
       98.2         0.9         0.5         0.0         0.5
6. Popyt w czasie dostawy: bootstrap i rozkład normalny: Rysunek 5
R
# Przepis 6. Popyt w czasie realizacji dla rzadkiej części: bootstrap vs rozkład normalny (Rysunek 5)
dostawa <- 2; okres_ochrony <- dostawa + 1              # dostawa po 2 tygodniach + tydzień do następnego zamówienia
i6 <- przyklad[["nierówny"]]                            # przykład popytu nierównego z przepisu 2 (CZ-0004)
y_hist <- Y[i6, hist_tyg]                               # lata 1–2
c(tygodnie_z_popytem = sum(y_hist > 0), najwiekszy_popyt = max(y_hist))

# Bootstrap: losujemy ze zwracaniem 3 tygodnie z historii i sumujemy (10 000 razy)
set.seed(7582)
boot_suma <- replicate(10000, sum(sample(y_hist, okres_ochrony, replace = TRUE)))
# Rozkład normalny: średnia z SBA × 3, odchylenie = RMSE prognoz SBA o tydzień naprzód (rok 2) × √3
f_sba <- croston_mac(Y[i6, ], alfa, "sba")[1, ]
rmse_sba <- sqrt(mean((y_hist[53:104] - f_sba[53:104])^2))
sr_norm <- okres_ochrony * f_sba[105]; sd_norm <- sqrt(okres_ochrony) * rmse_sba
# Prawda (znana, bo dane są fikcyjne): 3 tygodnie z prawdziwego procesu (100 000 razy)
set.seed(7583)
prawda_suma <- rowSums(matrix((runif(3e5) < p[i6]) *
                              (1 + rnbinom(3e5, size = ksztalt[i6], mu = sr_nadwyzka[i6])), ncol = 3))

poziomy <- c(0.80, 0.90, 0.95, 0.98)
S <- rbind(bootstrap = quantile(boot_suma, poziomy, type = 1),
           normalny = ceiling(qnorm(poziomy, sr_norm, sd_norm)),
           prawda = quantile(prawda_suma, poziomy, type = 1))
colnames(S) <- paste0("S_", 100 * poziomy)
S
# Jaki poziom obsługi (szansa, że zapas S wystarczy na 3 tygodnie) daje każde S naprawdę?
round(100 * apply(S, c(1, 2), function(s) mean(prawda_suma <= s)), 1)
round(c(P0_bootstrap = 100 * mean(boot_suma == 0), P0_prawda = 100 * mean(prawda_suma == 0),
        P_ujemne_normalny = 100 * pnorm(0, sr_norm, sd_norm), sr_norm = sr_norm, sd_norm = sd_norm), 2)

dl5 <- rbind(data.frame(k = 0:12, odsetek = sapply(0:12, function(k) mean(boot_suma == k)), zrodlo = "Bootstrap (lata 1–2)"),
             data.frame(k = 0:12, odsetek = sapply(0:12, function(k) mean(prawda_suma == k)), zrodlo = "Prawdziwy rozkład"))
krzywa <- data.frame(k = seq(-3, 12, 0.05)); krzywa$g <- dnorm(krzywa$k, sr_norm, sd_norm)
linie <- data.frame(x = c(S["bootstrap", "S_95"], S["normalny", "S_95"]) + c(-0.12, 0.12),
                    etykieta = paste0(c("S z bootstrapu = ", "S z rozkładu normalnego = "),
                                      c(S["bootstrap", "S_95"], S["normalny", "S_95"])),
                    kolor = c("Bootstrap", "SBA"))
p5 <- ggplot() +
  geom_col(data = dl5, aes(k, odsetek, fill = zrodlo), position = position_dodge(width = 0.8), width = 0.75) +
  geom_line(data = krzywa, aes(k, g), colour = kol[["SBA"]], linewidth = 0.9, linetype = "dashed") +
  geom_vline(data = linie, aes(xintercept = x, colour = kolor), linewidth = 0.9, show.legend = FALSE) +
  geom_label(data = linie, aes(x = x, y = c(0.45, 0.38), label = etykieta, colour = kolor), hjust = -0.03,
             size = 3.6, linewidth = 0, fill = "white", show.legend = FALSE) +
  scale_fill_manual(values = c("Bootstrap (lata 1–2)" = kol[["Bootstrap"]], "Prawdziwy rozkład" = "grey80")) +
  scale_colour_manual(values = kol) +
  scale_x_continuous(breaks = 0:12, labels = function(x) minus(x)) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%")) +
  labs(title = paste0("Indeks ", indeks[i6], ": popyt w 3 tygodniach (dostawa 2 tyg. + tydzień przeglądu)"),
       subtitle = "Linia przerywana – rozkład normalny ze średniej SBA; pionowe linie – zapas na poziom 95%",
       x = "Sztuk w 3 tygodniach", y = "Odsetek", fill = NULL) +
  motyw
p5   # zapis: ggsave("popyt-sporadyczny-bootstrap-czas-realizacji.svg", p5, width = 10, height = 5.4)
Wynik w R
tygodnie_z_popytem   najwiekszy_popyt
                31                 14
          S_80 S_90 S_95 S_98
bootstrap    3    5    7   14
normalny     6    7    9   10
prawda       5    9   12   17
          S_80 S_90 S_95 S_98
bootstrap 71.4 81.4 87.6 96.9
normalny  84.8 87.6 91.7 93.2
prawda    81.4 91.7 95.4 98.3
     P0_bootstrap         P0_prawda P_ujemne_normalny           sr_norm           sd_norm
            35.02             38.74             29.60              2.00              3.74
7. Symulacja zapasu w roku 3: Rysunek 6
R
# Przepis 7. Ocena przez poziom obsługi: symulacja zapasu w roku 3 dla indeksów rzadkich (Rysunek 6)
ir <- which(oceniane & rodzaj == "rzadki (ADI ≥ 1.32)")      # indeksy z popytem rzadkim (przepis 5)
k <- length(ir); Yr <- Y[ir, ]

# Zapas docelowy S na każdy tydzień roku 3 (zamówienie co tydzień do poziomu S, dostawa po 2 tygodniach)
S_normalny <- function(Fm, poziom) {                          # średnia × 3 + z × √3 × RMSE z roku 2
  rmse <- sqrt(rowMeans((Yr[, 53:104] - Fm[ir, 53:104])^2))
  ceiling(pmax(okres_ochrony * Fm[ir, test_tyg] + qnorm(poziom) * sqrt(okres_ochrony) * rmse, 0))
}
set.seed(7584)
B <- 1000; aktualizacje <- seq(105, 156, by = 4)              # bootstrap przeliczany co 4 tygodnie
boot_kw <- lapply(aktualizacje, function(t) {                 # 1000 sum 3 tygodni wylosowanych z 104 ostatnich
  okno <- Yr[, (t - 104):(t - 1)]
  los <- matrix(sample.int(104, B * okres_ochrony * k, replace = TRUE), k)
  sumy <- sapply(1:B, function(b) { kol_b <- los[, (b - 1) * okres_ochrony + 1:okres_ochrony]
    rowSums(matrix(okno[cbind(rep(1:k, okres_ochrony), c(kol_b))], k)) })
  t(apply(sumy, 1, quantile, probs = poziomy, type = 1))
})
S_bootstrap <- function(poziom) {
  j <- match(poziom, poziomy)
  sapply(test_tyg, function(t) boot_kw[[max(which(aktualizacje <= t))]][, j])
}

# Symulacja: na początku tygodnia dochodzi dostawa sprzed 2 tygodni, zamawiamy do poziomu S, potem popyt;
# czego brak, czeka w zaległościach. Start: stan = S z pierwszego tygodnia.
symuluj <- function(S) {
  stan <- S[, 1]; zam_1 <- zam_2 <- rep(0, k); obsluz <- popyt <- wart <- numeric(length(test_tyg))
  obsl_tyg <- matrix(0, k, length(test_tyg))
  for (j in seq_along(test_tyg)) {
    stan <- stan + zam_2                                      # dostawa zamówienia sprzed 2 tygodni
    q <- pmax(0, S[, j] - (stan + zam_1))                      # zamówienie do poziomu S
    d <- Yr[, test_tyg[j]]
    obsl_tyg[, j] <- pmin(d, pmax(stan, 0))                   # wydane od ręki
    stan <- stan - d
    wart[j] <- sum(pmax(stan, 0) * cena[ir])
    zam_2 <- zam_1; zam_1 <- q
  }
  list(obsluga = 100 * sum(obsl_tyg) / sum(Yr[, test_tyg]), zapas_tys_zl = mean(wart) / 1000,
       obsl_tyg = obsl_tyg, stan_koncowy = pmax(stan, 0))
}
metody7 <- c("Wygładzanie", "Croston", "SBA", "Bootstrap")
wyn7 <- do.call(rbind, lapply(metody7, function(m) do.call(rbind, lapply(poziomy, function(pz) {
  S <- if (m == "Bootstrap") S_bootstrap(pz) else S_normalny(prognozy[[m]], pz)
  s <- symuluj(S)
  data.frame(metoda = m, cel = 100 * pz, obsluga_proc = s$obsluga, zapas_tys_zl = s$zapas_tys_zl)
}))))
wyn7$metoda <- factor(wyn7$metoda, metody7)
print(transform(wyn7, obsluga_proc = round(obsluga_proc, 1), zapas_tys_zl = round(zapas_tys_zl, 1)), row.names = FALSE)

# Sezon i części wycofywane przy celu 95%: bootstrap i SBA
s_b <- symuluj(S_bootstrap(0.95)); s_s <- symuluj(S_normalny(prognozy[["SBA"]], 0.95))
w_sez <- sapply(ir, function(i) grupa[i] != "Ciągniki" & !czesty[i])         # indeksy z sezonem
tr <- tydz_roku[test_tyg]
sez_tyg <- outer(grupa[ir], tr, function(g, w) (g == "Siewniki i opryskiwacze" & w %in% 10:20) |
                                                (g == "Kombajny i prasy" & w %in% 27:37))
obs <- function(s, maska) round(100 * sum(s$obsl_tyg[maska]) / sum(Yr[, test_tyg][maska]), 1)
c(bootstrap_w_sezonie = obs(s_b, sez_tyg & w_sez), bootstrap_poza_sezonem = obs(s_b, !sez_tyg & w_sez),
  sba_w_sezonie = obs(s_s, sez_tyg & w_sez), sba_poza_sezonem = obs(s_s, !sez_tyg & w_sez))
wyc <- wycofywany[ir]
round(c(indeksy_wycofywane = sum(wyc), zapas_koncowy_tys_zl_bootstrap = sum(s_b$stan_koncowy[wyc] * cena[ir][wyc]) / 1000,
        zapas_koncowy_tys_zl_sba = sum(s_s$stan_koncowy[wyc] * cena[ir][wyc]) / 1000,
        sba_prognoza_wycof_vs_prawda = mean(prognozy[["SBA"]][ir[wyc], 156]) / mean(P[ir[wyc], 156] * (1 + sr_nadwyzka[ir[wyc]]))), 1)

p6 <- ggplot(wyn7, aes(zapas_tys_zl, obsluga_proc, colour = metoda, shape = metoda)) +
  geom_path(linewidth = 0.8) + geom_point(size = 3.2) +
  geom_text(data = subset(wyn7, metoda == "Bootstrap"), aes(label = paste0("cel ", cel, "%")),
            hjust = -0.25, vjust = 1.2, size = 3.4, show.legend = FALSE) +
  scale_colour_manual(values = kol) + scale_shape_manual(values = ksz) +
  scale_y_continuous(labels = function(x) paste0(x, "%")) +
  scale_x_continuous(expand = expansion(mult = c(0.05, 0.12))) +
  labs(title = paste0("Zapas a poziom obsługi w roku 3: ", k, " indeksów z popytem rzadkim"),
       subtitle = "Każdy punkt to cel 80, 90, 95 lub 98%; wyżej i bardziej w lewo = lepiej",
       x = "Średnia wartość zapasu (tys. zł)", y = "Popyt obsłużony od ręki", colour = NULL, shape = NULL) +
  motyw
p6   # zapis: ggsave("popyt-sporadyczny-zapas-a-obsluga.svg", p6, width = 10, height = 5.6)
Wynik w R
      metoda cel obsluga_proc zapas_tys_zl
 Wygładzanie  80         70.4        786.8
 Wygładzanie  90         78.1       1008.2
 Wygładzanie  95         83.0       1194.9
 Wygładzanie  98         87.2       1412.5
     Croston  80         67.1        687.7
     Croston  90         75.8        906.1
     Croston  95         81.1       1088.7
     Croston  98         85.9       1301.4
         SBA  80         66.0        668.9
         SBA  90         74.9        884.2
         SBA  95         80.5       1070.4
         SBA  98         85.3       1279.7
   Bootstrap  80         56.1        438.5
   Bootstrap  90         74.1        827.3
   Bootstrap  95         85.2       1243.6
   Bootstrap  98         92.3       1800.4
   bootstrap_w_sezonie bootstrap_poza_sezonem          sba_w_sezonie       sba_poza_sezonem
                  78.2                   88.8                   71.7                   85.8
            indeksy_wycofywane zapas_koncowy_tys_zl_bootstrap       zapas_koncowy_tys_zl_sba
                          40.0                           96.9                           83.1
  sba_prognoza_wycof_vs_prawda
                          20.6
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("Croston – SBA (też: popyt rzadki – częsty)" = c("#D55E00", "#0072B2"),
             "Wygładzanie – SBA" = c("#56B4E9", "#0072B2"),
             "Wygładzanie – Bootstrap" = c("#56B4E9", "#CC79A7"),
             "Bootstrap – prawdziwy rozkład" = c("#CC79A7", "grey80"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                           widzenie_typowe deuteranopia protanopia
Croston – SBA (też: popyt rzadki – częsty)           114.6        108.3       91.9
Wygładzanie – SBA                                     26.4         24.7       24.6
Wygładzanie – Bootstrap                               56.7         31.0       20.7
Bootstrap – prawdziwy rozkład                         45.1         20.5       29.7
czerwony – zielony (do unikania)                     121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, symulacje i bootstrap – pakiet stats. Metodę Crostona i SBA sprawdzono funkcją croston() pakietu forecast. Rysunki wykonano w pakiecie ggplot2, panele Rysunku 2 złożono pakietem patchwork, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- forecast (wersja 9.0.2): Hyndman, R., Athanasopoulos, G., Bergmeir, C., Caceres, G., Chhay, L., O’Hara-Wild, M., Petropoulos, F., Razbash, S., Wang, E., & Yasmeen, F. (2026). forecast: Forecasting functions for time series and linear models (R package version 9.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.forecast
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
Pułapki
- Części wycofywane. Croston i SBA nie zmieniają prognozy w pustych tygodniach. Na koniec roku 3 prognoza SBA dla wycofywanych indeksów była 20.6 razy wyższa od prawdziwej średniej. Metoda TSB aktualizuje co tydzień prawdopodobieństwo popytu i jest nieobciążona (Teunter i in., 2011).
- Sezon prac polowych. ADI i bootstrap z całego roku mieszają kwiecień z grudniem, więc w sezonie brakuje towaru (Rysunek 6 i lista wyżej).
- Sprzedaż to nie popyt. Gdy części nie było, klient poszedł gdzie indziej, a w danych jest zero. Takie tygodnie zaniżają prognozę – zob. popyt ukryty przez braki towaru.
- Stała wygładzania dobrana „na oko” albo pod MAE. Duże α zwiększa obciążenie Crostona (Rysunek 3). Dobór α minimalizujący MAE prowadzi do prognoz bliskich zera. W porównaniu na 3000 rzeczywistych szeregów najlepiej wypadła poprawiona metoda Syntetosa i Boylana (2005).
- Odbiór i reklamacje. Zwroty i wymiany gwarancyjne wliczone do popytu tworzą sztuczne skoki. Jakość dostaw z drugiej strony łańcucha opisuje wpis o kontroli odbiorczej, a o tym, jak zamówienia hurtowni rozchwiewają popyt u dostawcy – wpis o efekcie byczego bicza.
Najczęstsze pytania
Na czym polega metoda Crostona?
Metoda Crostona rozdziela popyt sporadyczny na dwie części: wielkość zamówienia w tygodniach, w których ktoś kupił, i odstęp między takimi tygodniami. Obie wygładza wykładniczo, ale tylko w tygodniu z popytem, a prognoza na tydzień to wygładzona wielkość podzielona przez wygładzony odstęp. W tygodniach bez popytu prognoza się nie zmienia. W R: forecast::croston().
Czym się różni SBA od metody Crostona?
SBA (poprawka Syntetosa–Boylana) mnoży prognozę Crostona przez 1 − α/2, gdzie α to stała wygładzania. Sam Croston daje prognozy obciążone w górę (Syntetos i Boylan, 2001). W symulacji z tego wpisu przy α = 0.1 Croston zawyżał średnią o 2.8–6.8%, a SBA mieścił się między −2.3 a 1.4%. W R: croston(y, type = "sba").
Jak ocenić trafność prognozy, gdy popyt często wynosi zero?
MAPE dzieli przez popyt, więc w tygodniu z zerem nie da się go policzyć. MAE i MASE nagradzają medianę, a przy rzadkim popycie mediana to zero – w przykładzie prognoza zerowa miała najlepszy MASE (0.62). Uzupełnij je błędem skumulowanym (czy prognoza systematycznie zawyża lub zaniża) i symulacją zapasu: jaki odsetek popytu obsłużysz od ręki przy jakiej wartości zapasu.
Ile zapasu trzymać dla części kupowanej kilka razy w roku?
Policz rozkład popytu w czasie realizacji (dostawa plus okres do następnego zamówienia) i weź jego kwantyl, np. 95%. Rozkład normalny źle pasuje do popytu z zerami – w przykładzie dawał 29.6% szans na popyt ujemny. Bootstrap (losowanie tygodni z historii) zachowuje zera i skoki, ale nie przewidzi zamówienia większego niż największe w danych.
Co zrobić z częściami, które przestają się sprzedawać?
Croston i SBA nie zmieniają prognozy po tygodniach bez popytu, więc dla części wycofywanych długo prognozują dawny popyt. W przykładzie prognoza SBA na koniec roku 3 była 20.6 razy wyższa od prawdziwej średniej tych części. Ustaw alarm po serii pustych tygodni albo użyj metody, która aktualizuje prawdopodobieństwo popytu co tydzień (Teunter i in., 2011).
Powiązane hasła
Przeczytaj też
Analiza ABC/XYZ asortymentu
Hurtownia części: krzywa Lorenza, umowne progi ABC, CV popytu i tygodnie bez sprzedaży, macierz ABC × XYZ i stabilność klas – pięć rysunków z kodem R.
Czytaj →PoradnikModel gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →PoradnikStatystyka w pracy z logistyki
Czasy dostaw i percentyle, błędy kompletacji na 1000 linii, przerwany szereg czasowy w magazynie, dostawcy jako skupienia i prognoza popytu: analizy, zdania APA i kod R.
Czytaj →Piszesz pracę o zapasach albo prognozujesz popyt na części?
Pomożemy sklasyfikować indeksy, dobrać metodę prognozy, policzyć zapas z rozkładu popytu w czasie dostawy i opisać ocenę prognoz tak, żebyś umiał(a) ją obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Croston, J. D. (1972). Forecasting and stock control for intermittent demands. Journal of the Operational Research Society, 23(3), 289–303. https://doi.org/10.1057/jors.1972.50
- Hyndman, R. J., & Khandakar, Y. (2008). Automatic time series forecasting: The forecast package for R. Journal of Statistical Software, 27(3), 1–22. https://doi.org/10.18637/jss.v027.i03 ● Otwarty dostęp
- Hyndman, R. J., & Koehler, A. B. (2006). Another look at measures of forecast accuracy. International Journal of Forecasting, 22(4), 679–688. https://doi.org/10.1016/j.ijforecast.2006.03.001 ● Otwarty dostęp: pełny tekst
- Syntetos, A. A., & Boylan, J. E. (2001). On the bias of intermittent demand estimates. International Journal of Production Economics, 71(1–3), 457–466. https://doi.org/10.1016/s0925-5273(00)00143-2 ● Otwarty dostęp: pełny tekst
- Syntetos, A. A., & Boylan, J. E. (2005). The accuracy of intermittent demand estimates. International Journal of Forecasting, 21(2), 303–314. https://doi.org/10.1016/j.ijforecast.2004.10.001 ● Otwarty dostęp: pełny tekst
- Syntetos, A. A., Boylan, J. E., & Croston, J. D. (2005). On the categorization of demand patterns. Journal of the Operational Research Society, 56(5), 495–503. https://doi.org/10.1057/palgrave.jors.2601841 ● Otwarty dostęp
- Teunter, R. H., Syntetos, A. A., & Babai, M. Z. (2011). Intermittent demand: Linking forecasting to inventory obsolescence. European Journal of Operational Research, 214(3), 606–615. https://doi.org/10.1016/j.ejor.2011.05.018 ● Otwarty dostęp: pełny tekst
- Teunter, R., & Duncan, L. (2009). Forecasting intermittent demand: A comparative study. Journal of the Operational Research Society, 60(3), 321–329. https://doi.org/10.1057/palgrave.jors.2602569
Cytowania BibTeX
@article{croston1972forecasting, author={Croston, J. D.}, title={{Forecasting and stock control for intermittent demands}}, journal={Journal of the Operational Research Society}, year={1972}, volume={23}, number={3}, pages={289--303}, doi={10.1057/jors.1972.50}}@article{hyndman2008automatic, author={Hyndman, Rob J. and Khandakar, Yeasmin}, title={{Automatic time series forecasting: The forecast package for R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={3}, pages={1--22}, doi={10.18637/jss.v027.i03}}@article{hyndman2006another, author={Hyndman, Rob J. and Koehler, Anne B.}, title={{Another look at measures of forecast accuracy}}, journal={International Journal of Forecasting}, year={2006}, volume={22}, number={4}, pages={679--688}, doi={10.1016/j.ijforecast.2006.03.001}}@article{syntetos2001bias, author={Syntetos, Aris A. and Boylan, John E.}, title={{On the bias of intermittent demand estimates}}, journal={International Journal of Production Economics}, year={2001}, volume={71}, number={1–3}, pages={457--466}, doi={10.1016/s0925-5273(00)00143-2}}@article{syntetos2005accuracy, author={Syntetos, Aris A. and Boylan, John E.}, title={{The accuracy of intermittent demand estimates}}, journal={International Journal of Forecasting}, year={2005}, volume={21}, number={2}, pages={303--314}, doi={10.1016/j.ijforecast.2004.10.001}}@article{syntetos2005categorization, author={Syntetos, A. A. and Boylan, J. E. and Croston, J. D.}, title={{On the categorization of demand patterns}}, journal={Journal of the Operational Research Society}, year={2005}, volume={56}, number={5}, pages={495--503}, doi={10.1057/palgrave.jors.2601841}}@article{teunter2011intermittent, author={Teunter, Ruud H. and Syntetos, Aris A. and Babai, M. Zied}, title={{Intermittent demand: Linking forecasting to inventory obsolescence}}, journal={European Journal of Operational Research}, year={2011}, volume={214}, number={3}, pages={606--615}, doi={10.1016/j.ejor.2011.05.018}}@article{teunter2009forecasting, author={Teunter, R. H. and Duncan, L.}, title={{Forecasting intermittent demand: A comparative study}}, journal={Journal of the Operational Research Society}, year={2009}, volume={60}, number={3}, pages={321--329}, doi={10.1057/palgrave.jors.2602569}}