Przykład: producent ręczników papierowych i chusteczek
Fikcyjny producent robi ręczniki papierowe i chusteczki higieniczne. Towar płynie w dół łańcucha: dostawca celulozy → producent → hurtownia → sklepy → klienci. Zamówienia płyną w górę. Sklepy sprzedają średnio 20 tys. kartonów tygodniowo, a mimo to dostawca celulozy dostaje od producenta zamówienia od 6 do 38 tys. kartonów (w przeliczeniu na kartony). Pytanie: skąd te wahania, jak je zmierzyć i co je zmniejsza.
To efekt byczego bicza (ang. bullwhip effect): wariancja zamówień rośnie z każdym szczeblem w górę łańcucha, choć popyt końcowy jest spokojny (Lee i in., 1997).
Dane są fikcyjne i wiemy, jak powstały. Popyt w sklepach w kolejnych tygodniach to średnia 20 tys. kartonów, sezon ±2.5 tys. (szczyt w listopadzie, w sezonie przeziębień) i wahania o autokorelacji 0.6 (model AR(1): dobry tydzień zwykle ciągnie za sobą następny). Każdy z czterech szczebli robi to samo:
- prognozuje swój popyt średnią ruchomą z 6 ostatnich tygodni – sklepy z popytu klientów, wyższe szczeble z zamówień szczebla niżej;
- zamawia „do poziomu”: tyle, by zapas w magazynie i w drodze pokrył prognozę na czas realizacji L tygodni (sklepy L = 1, hurtownia 2, producent 2, dostawca celulozy 3) plus stały zapas bezpieczeństwa;
- dostaje od swojego dostawcy zawsze całe zamówienie; zamówienie nie może być ujemne.
Analizujemy 104 tygodnie (po 30 tygodniach rozbiegu). Parametry ustawiliśmy ręcznie, ziarna (759, 7592, 7593) – raz. Dane jednej realizacji pobierzesz jako bicz-lancuch-104-tygodnie.csv (popyt, zamówienia i zapas netto czterech szczebli, bez zapasu bezpieczeństwa; ujemny zapas to zaległe zamówienia).
Rysunek 1: ten sam popyt, coraz większe fale
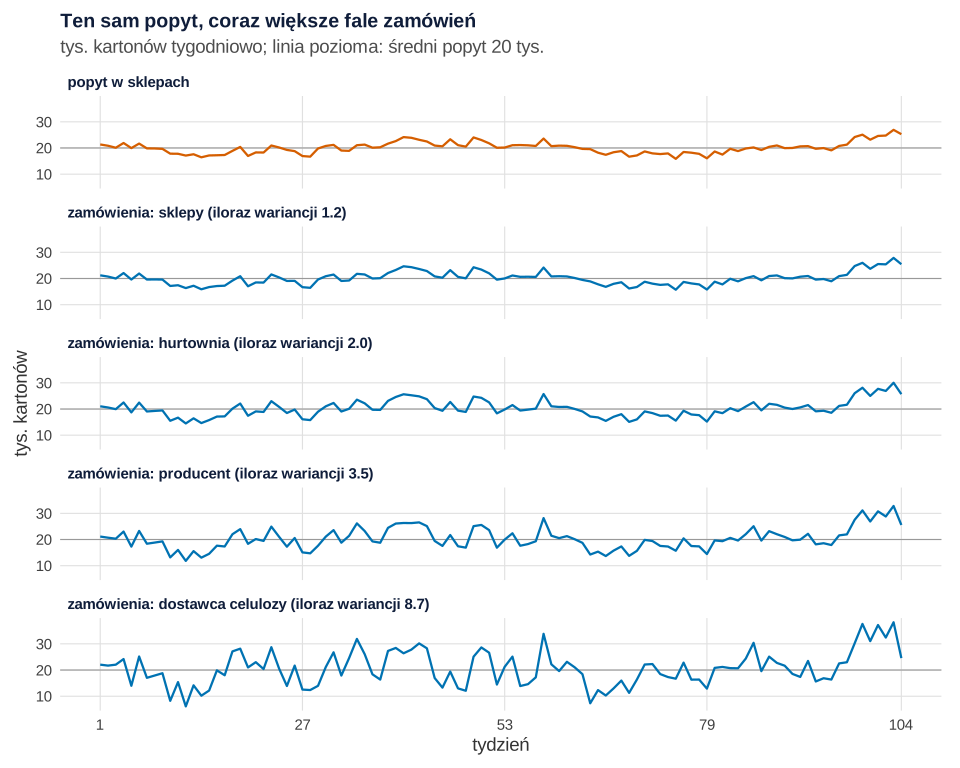
set.seed(759)).Co widać. Popyt w sklepach ma średnią 20 108 kartonów i odchylenie standardowe 2235 (od 15 855 do 26 923). Zamówienia mają prawie tę samą średnią, ale odchylenie rośnie: 2484 u sklepów, 3140 u hurtowni, 4152 u producenta i 6606 u dostawcy celulozy (od 6119 do 38 244 kartonów).
Jak może zmylić. To jedna realizacja – jedne „dwa lata” firmy. Przy innym ziarnie liczby będą inne (rysunek 2 pokazuje, jak bardzo). Wykres nie mówi też, dlaczego fale rosną; to pokazują rysunki 3 i 4.
Podpis do pracy:
Rysunek 2: iloraz wariancji na kolejnych szczeblach
Miarą efektu jest iloraz wariancji: Var(zamówienia szczebla) / Var(popyt końcowy). Wynik 1 oznacza brak wzmocnienia, 4 – wariancję cztery razy większą (odchylenie standardowe dwa razy większe). Żeby nie oceniać jednej realizacji, symulację powtarzamy 500 razy i podajemy średni iloraz z 95% przedziałem ufności (średnia ± 1.96 błędu standardowego z powtórzeń). Jak planować takie badania: badanie symulacyjne (ADEMP).
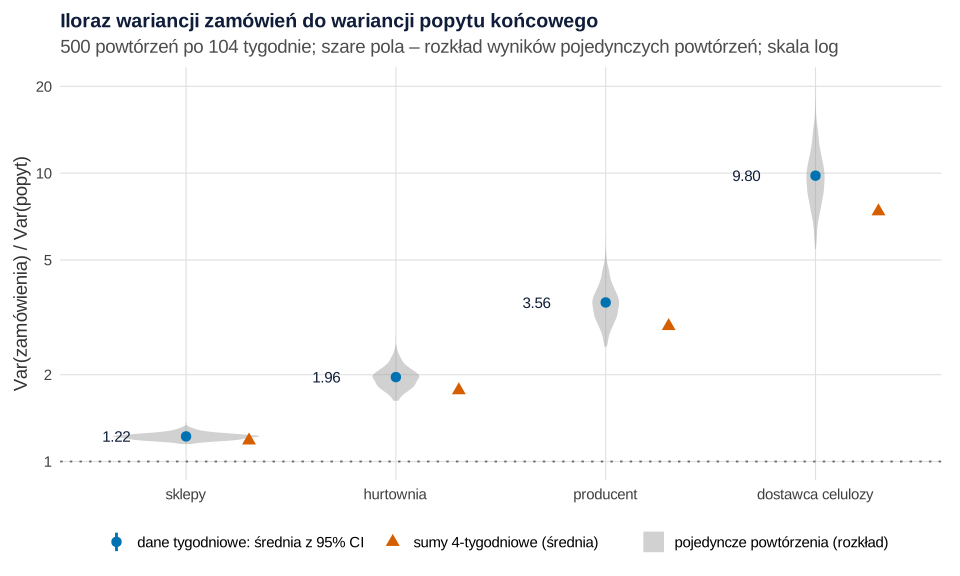
set.seed(7592)).Co widać. Średni iloraz rośnie: 1.22 u sklepów, 1.96 u hurtowni, 3.56 u producenta i 9.80, 95% CI [9.61, 9.99], u dostawcy celulozy. Każdy szczebel mnoży wariancję otrzymanych zamówień: hurtownia o 1.61, producent o 1.81, dostawca – z najdłuższym czasem realizacji – o 2.75. Iloraz powyżej 5 dostawca miał we wszystkich 500 powtórzeniach.
Jak może zmylić. Przedział dla średniej jest wąski, ale pojedyncze dwa lata rozrzucają się szeroko: u dostawcy 95% powtórzeń mieściło się w [6.09, 14.59]. Firma, która policzy iloraz z własnych 104 tygodni, ma jedną taką liczbę. Druga pułapka to jednostka czasu: na sumach 4-tygodniowych iloraz dostawcy spada do 7.37 (producenta do 2.95), bo sumowanie wycina część krótkich wahań. To agregacja, nie poprawa łańcucha.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: wzór Chena i in. – prognoza i czas realizacji
Dlaczego szczebel wzmacnia wahania, skoro zamawia „rozsądnie”? Gdy sprzedaż w tym tygodniu jest wyższa, rośnie prognoza. Wyższa prognoza podnosi poziom, do którego szczebel uzupełnia zapas – i to L razy, bo zapas ma pokryć L tygodni. Zamówienie zawiera więc sprzedaż i korektę poziomu. Chen i in. (2000) policzyli to dla jednego szczebla, popytu AR(1) z autokorelacją ρ i średniej ruchomej z p tygodni:
Var(zamówienia) / Var(popyt) = 1 + (2L/p + 2L²/p²) · (1 − ρp)
Słowami: efekt rośnie z czasem realizacji L (i jego kwadratem), maleje przy dłuższej średniej (większe p), a silna autokorelacja trochę go osłabia. Sprawdzamy wzór symulacją jednego szczebla: popyt bez sezonu, 20 000 tygodni na każdy punkt.
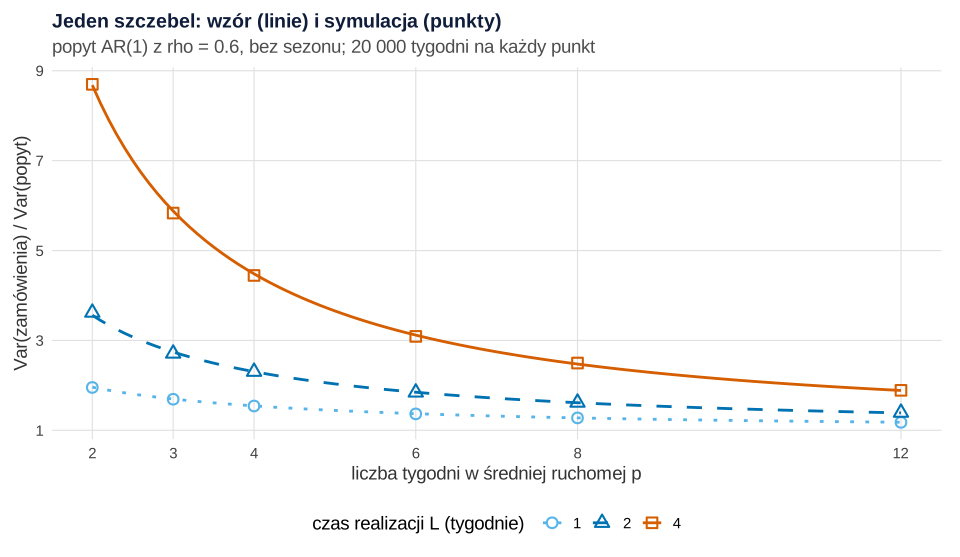
set.seed(7593)).Co widać. Symulacja i wzór zgadzają się w 18 punktach z dokładnością do 0.06. Przy L = 4 i średniej z 2 tygodni iloraz wynosi 8.68 (symulacja 8.70); ta sama średnia przy L = 1 daje 1.96. Wydłużenie średniej do 12 tygodni sprowadza iloraz przy L = 4 do 1.89.
Jak może zmylić. Wzór dotyczy jednego szczebla, popytu AR(1) i stałego zapasu bezpieczeństwa; przy zapasie liczonym z bieżącego odchylenia standardowego jest dolnym ograniczeniem. W naszym łańcuchu z sezonem sklepy mają iloraz 1.22, a wzór dla L = 1 i p = 6 daje 1.37 – płynny sezon prognoza śledzi dobrze. Zgadza się to z danymi branżowymi: branże o silnej sezonowości częściej wygładzają zmienność niż ją wzmacniają (Cachon i in., 2007).
Podpis do pracy:
Rysunek 4: źródła efektu i co pomaga
Lee i in. (1997) wymieniają cztery źródła efektu: prognozowanie, zamawianie partiami, wahania cen (promocje) i racjonowanie przy niedoborach. Trzy pierwsze, a obok nich trzy sposoby ograniczania efektu, porównujemy w scenariuszach. Każdy scenariusz liczymy na tych samych 500 przebiegach popytu (wspólne liczby losowe), więc różnice nie wynikają z losowania:
- wygładzanie wykładnicze zamiast średniej (alfa = 2/7, ten sam średni „wiek” danych co średnia z 6 tygodni; zob. wygładzanie wykładnicze);
- partie: hurtownia zamawia tylko pełne partie po 8000 kartonów (o progach przy zamówieniach – progi rabatu ilościowego);
- promocje: 6 akcji w sklepach – tydzień +35%, potem dwa tygodnie −15%, bo klienci mają zapas w domu (o modelowaniu takich wzorców – prognoza sprzedaży z promocjami);
- dane ze sklepów: każdy szczebel prognozuje z popytu końcowego, a nie z zamówień szczebla niżej;
- krótszy czas realizacji: L = 1, 1, 1, 2 zamiast 1, 2, 2, 3;
- wygładzanie zamówień: każdy zamawia prognozę i tylko 40% brakującej różnicy do poziomu (beta = 0.4).
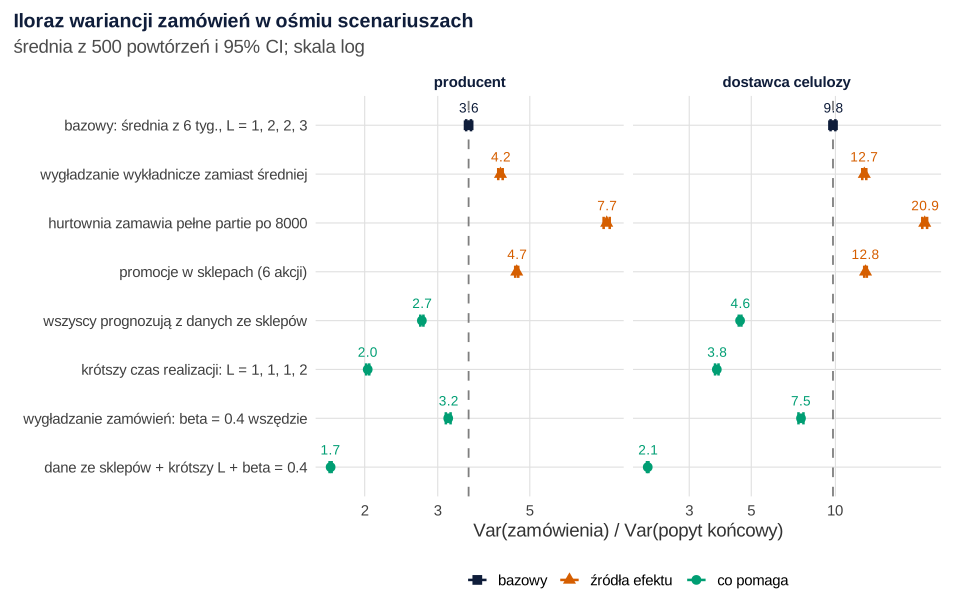
set.seed(7592)).Co widać. U dostawcy celulozy partie po 8000 podwajają iloraz (20.86, 95% CI [20.45, 21.27]; +113%), promocje podnoszą go o 31%, wygładzanie wykładnicze o 29%. Najwięcej daje krótszy czas realizacji: 3.76 [3.71, 3.82], czyli −62%. Dane ze sklepów dają −53% (4.56 [4.51, 4.61]), a wygładzanie zamówień −23%. Wszystkie trzy razem: 2.13 [2.12, 2.14], −78%.
Jak może zmylić. Dane ze sklepów zmniejszają efekt, ale go nie usuwają – każdy szczebel nadal koryguje swój poziom zapasu, co przewidzieli Chen i in. (2000). Wynik dla wygładzania wykładniczego zależy od alfy; Chen, Ryan i Simchi-Levi (2000) porównują obie metody dokładniej. Rachunek pomija racjonowanie (dostawca zawsze ma towar) i ludzkie decyzje: w eksperymencie z symulowanym systemem dystrybucji decyzje uczestników systematycznie odbiegały od optymalnych, a uczestnicy słabo uwzględniali skutki własnych wcześniejszych zamówień (Sterman, 1989).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: mniejsze wahania to nie zawsze mniejszy koszt
Iloraz wariancji mierzy wahania zamówień, nie pieniądze. Sprawdzamy to na jednej decyzji: producent wygładza zamówienia celulozy (beta od 1 do 0.2), reszta łańcucha działa bez zmian. Koszt tygodniowy każdego szczebla to 0.05 zł za karton w magazynie i 0.45 zł za karton brakujący (zaległy). Zapas bezpieczeństwa dobieramy w każdym wariancie tak, by koszt był najmniejszy (90. centyl zapotrzebowania – ta sama logika co w modelu gazeciarza). Stawki ustaliliśmy ręcznie.
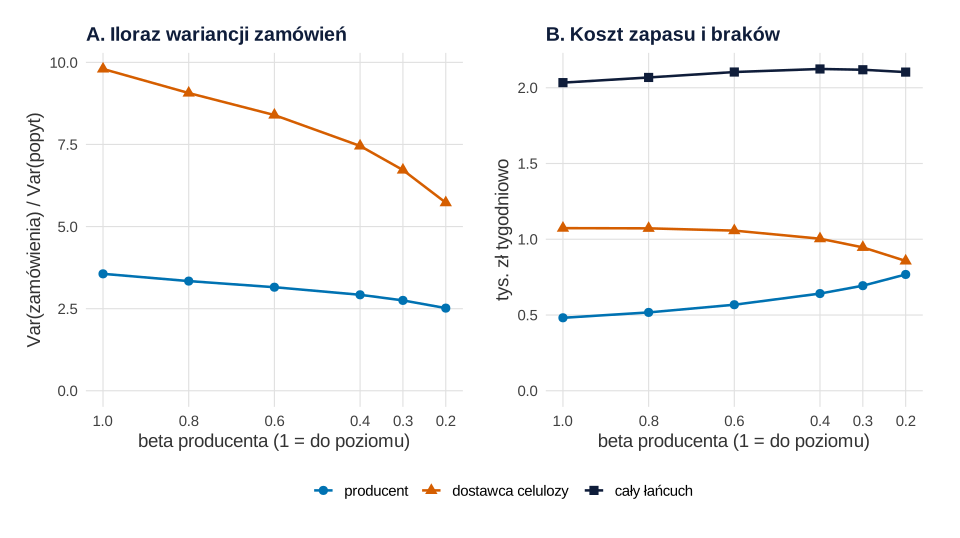
set.seed(7592)).Co widać. Przy beta = 0.2 iloraz dostawcy spada z 9.80 do 5.73, a jego koszt z 1073 do 857 zł tygodniowo. Ale producent, który wygładza, musi trzymać więcej zapasu: jego koszt rośnie z 482 do 768 zł. Koszt całego łańcucha prawie stoi w miejscu (2034 i 2103 zł; błąd standardowy kosztu szczebla to 3–8 zł).
Jak może zmylić. Wygładzanie przesuwa koszt z dostawcy na producenta. Dostawca zyskuje też na czymś, czego tu nie liczymy – spokojniejszej produkcji (mniej przezbrojeń i nadgodzin). Ta korzyść musi pokryć wyższy zapas producenta, inaczej producent nie ma powodu wygładzać. Wariancja zamówień ≠ koszt.
Podpis do pracy:
Rysunek 6: łańcuch i rosnące fale
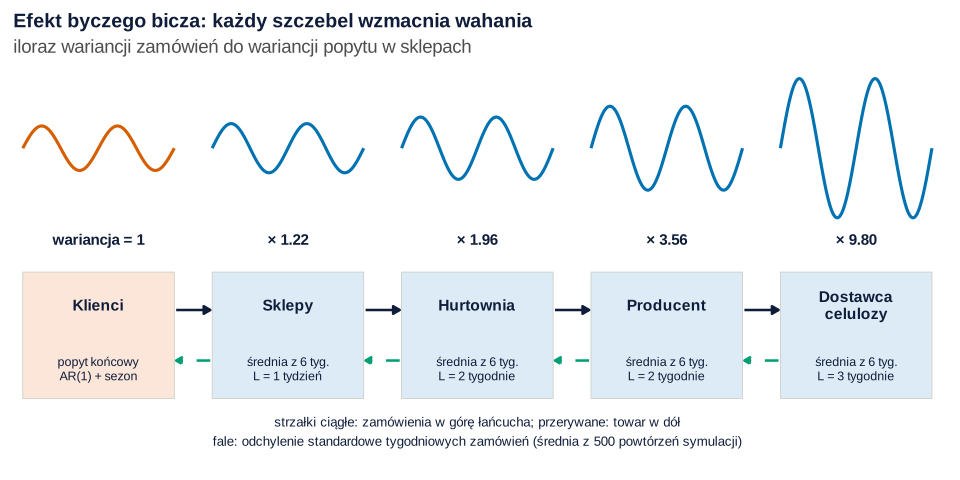
Co widać. Mały ruch na początku (popyt) i coraz większe fale dalej. Wysokość fali odpowiada odchyleniu standardowemu, czyli pierwiastkowi z ilorazu: u dostawcy celulozy ok. 3.1 raza więcej niż w sklepach.
Jak może zmylić. Fale nie są winą dostawcy – powstają na każdym szczeblu, najbardziej przy najdłuższym czasie realizacji.
Podpis do pracy:
Co z tym zrobić w firmie
- Zmierz efekt u siebie. Policz iloraz wariancji zamówień, które wysyłasz, do wariancji zamówień, które dostajesz (albo sprzedaży), na tych samych tygodniach – i podaj, jak bardzo zmieniłby się przy innej jednostce czasu.
- Dziel się danymi o sprzedaży w sklepach. W przykładzie prognoza z popytu końcowego obniżyła iloraz dostawcy o 53%. Gdy dostawca sam zarządza zapasem odbiorcy (VMI), może też zniknąć efekt partii i racjonowania (Disney i Towill, 2003).
- Skracaj czas realizacji. Wzór pokazuje, że L działa z kwadratem; w przykładzie −62%. Jak porównać dostawców na czasie realizacji, a nie tylko na jego średniej, pokazuje wpis o czasie realizacji dostaw.
- Zmniejsz partie i rozłóż promocje. Pełne partie podwoiły iloraz; pomagają mniejsze partie i dostawy mieszane.
- Wygładzaj zamówienia świadomie. Zysk ma szczebel wyżej, koszt – ten, kto wygładza. Umów się, kto płaci za dodatkowy zapas.
- Nie wydłużaj bez końca średniej w prognozie. Mniejszy efekt kupujesz wolniejszą reakcją na zmianę popytu i większymi błędami prognozy.
Gdy popyt jest rzadki i nieregularny (np. części zamienne), średnia ruchoma nie wystarczy – zob. popyt sporadyczny i metodę Crostona. Gdy sklepy miały braki, sprzedaż zaniża popyt, a prognoza z niej jest obciążona – zob. popyt ukryty przez braki towaru. Więcej tematów prac: statystyka w pracy z logistyki.
Jak opisać w pracy
Opisz model popytu, regułę prognozy i zamawiania na każdym szczeblu, czasy realizacji, liczbę powtórzeń i tygodni, miarę (iloraz wariancji i na jakich danych – tygodniowych czy zagregowanych) oraz uproszczenia (brak racjonowania, zamówienia nieujemne). Jeśli masz dane z firmy, opisz szereg czasowy sprzedaży jak we wpisie o szeregach czasowych w praktyce, a symulację potraktuj jako analizę „co by było, gdyby”. Zamiast samego ilorazu wariancji możesz podać ilorazy współczynników zmienności, gdy średnie zamówień różnią się między szczeblami.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i funkcje symulacji używane w kolejnych przepisach. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 759 w przepisie 1, 7592 w przepisach 2, 4 i 5 (te same przebiegi popytu we wszystkich scenariuszach – wspólne liczby losowe), 7593 w przepisie 3; przepisy 6 i 7 nie losują. Ręcznie ustalono: średni popyt (20 000 kartonów), amplitudę i szczyt sezonu (2500, tydzień 46), autokorelację (0.6) i odchylenie innowacji (1200), rozbieg (30 tygodni), czasy realizacji (1, 2, 2, 3), średnią z 6 tygodni i alfę 2/7, terminy i siłę promocji (+35%, potem 2 × −15%), partię 8000, krótsze czasy realizacji (1, 1, 1, 2), betę 0.4, stawki kosztu (0.05 i 0.45 zł) i liczbę powtórzeń (500). Po pierwszym uruchomieniu zmieniono (parametry popytu i reguł zamawiania zostały bez zmian): (1) w przepisach 4 i 5 ziarna 7594 i 7595 zastąpiono ziarnem 7592, żeby scenariusz bazowy dawał dokładnie te same liczby co przepis 2; (2) na rysunku 5 wygładzanie zamówień działało najpierw na wszystkich szczeblach naraz – zmieniono je na samego producenta, żeby było widać, kto zyskuje, a kto ponosi koszt (do funkcji lancuch() dodano betę osobną dla każdego szczebla), i zwiększono liczbę powtórzeń w przepisie 5 z 300 do 500; (3) na rysunku 2 punkty 2000 pojedynczych powtórzeń zastąpiono polami rozkładu, bo plik SVG miał 293 KB; (4) na rysunkach 4 i 5 poprawiono kolory i legendę (scenariusz bazowy osobnym kolorem, jedna wspólna legenda). Każdy przepis liczy się w kilka sekund.
1. Popyt, łańcuch i jedna realizacja: Rysunek 1
R
# Rysunek 1. Fikcyjny producent ręczników papierowych i chusteczek: popyt w sklepach i zamówienia
# czterech szczebli łańcucha (sklepy → hurtownia → producent → dostawca celulozy) przez 104 tygodnie
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Popyt końcowy (kartony tygodniowo, wszystkie sklepy razem): średnia + sezon (szczyt w listopadzie,
# sezon przeziębień) + wahania AR(1). Parametry ustawione ręcznie. Pierwsze 30 tygodni to rozbieg
# (prognozy i stany „rozgrzewają się”), do analizy bierzemy kolejne 104 tygodnie.
popyt <- function(tyg = 104, rozbieg = 30, srednia = 20000, sezon = 2500, rho = 0.6, sd_e = 1200,
                  promocje = FALSE) {
  n <- tyg + rozbieg; t <- seq_len(n) - rozbieg
  e <- as.numeric(arima.sim(list(ar = rho), n, sd = sd_e))
  D <- srednia + sezon * cos(2 * pi * (t - 46) / 52) + e
  if (promocje) {                     # 6 akcji: tydzień +35%, potem 2 tygodnie −15% (klienci mają zapas w domu)
    w <- c(10, 27, 44, 62, 79, 96) + rozbieg
    D[w] <- D[w] * 1.35; D[w + 1] <- D[w + 1] * 0.85; D[w + 2] <- D[w + 2] * 0.85
  }
  D
}

# Łańcuch: każdy szczebel widzi zamówienia szczebla niższego (sklepy – popyt końcowy), prognozuje je
# średnią ruchomą z p tygodni (albo wygładzaniem wykładniczym, alfa = 2/(p + 1)) i zamawia „do poziomu”
# y = L × prognoza (L – czas realizacji w tygodniach; stały zapas bezpieczeństwa nie zmienia zamówień).
# Opcje: wspolne = TRUE – każdy prognozuje z popytu końcowego (dane ze sklepów); beta < 1 – zamawia
# prognozę i tylko część brakującej różnicy (wygładzanie zamówień; jedna liczba albo osobno dla każdego
# szczebla); partia – zamówienie w pełnych partiach.
# Dostawca zawsze dostarcza całość; zamówienie nie może być ujemne (zwrotów nie ma).
lancuch <- function(D, L = c(1, 2, 2, 3), p = 6, metoda = "srednia", wspolne = FALSE, beta = 1,
                    partia = rep(0, length(L)), obetnij = TRUE) {
  n <- length(D); K <- length(L); zam <- zapas <- matrix(NA_real_, n, K); wej <- D
  beta <- rep_len(beta, K)
  for (k in 1:K) {
    syg <- if (wspolne) D else wej
    if (metoda == "srednia") {
      mu <- as.numeric(stats::filter(syg, rep(1 / p, p), sides = 1))
      mu[1:(p - 1)] <- cumsum(syg[1:(p - 1)]) / 1:(p - 1)
    } else {
      a <- 2 / (p + 1); mu <- numeric(n); mu[1] <- syg[1]
      for (t in 2:n) mu[t] <- mu[t - 1] + a * (syg[t] - mu[t - 1])
    }
    y <- L[k] * mu; q <- IP <- numeric(n); ip <- y[1]
    for (t in 1:n) {
      ipb <- ip - wej[t]                                   # pozycja zapasu po wydaniu towaru
      q[t] <- mu[t] + beta[k] * (y[t] - ipb - mu[t])       # beta = 1: zamów dokładnie do poziomu y
      if (partia[k] > 0) q[t] <- partia[k] * floor(max(q[t], 0) / partia[k])
      if (obetnij) q[t] <- max(q[t], 0)
      ip <- ipb + q[t]; IP[t] <- ip
    }
    # zapas netto (bez stałego zapasu bezpieczeństwa; ujemny = zaległe zamówienia klientów)
    for (t in (L[k] + 1):n) zapas[t, k] <- IP[t - L[k]] - sum(wej[(t - L[k] + 1):t])
    zam[, k] <- q; wej <- q
  }
  list(D = D, zam = zam, zapas = zapas)
}
# Miara efektu: wariancja zamówień szczebla / wariancja popytu końcowego (tygodnie po rozbiegu)
iloraz <- function(w, od = 31) apply(w$zam[od:nrow(w$zam), , drop = FALSE], 2, var) / var(w$D[od:length(w$D)])
szczeble <- c("sklepy", "hurtownia", "producent", "dostawca celulozy")

set.seed(759)
w1 <- lancuch(popyt())
dane <- data.frame(tydzien = 1:104, popyt = round(w1$D[31:134]), round(w1$zam[31:134, ]), round(w1$zapas[31:134, ]))
names(dane)[3:10] <- c(paste0("zam_", c("sklepy", "hurtownia", "producent", "dostawca")),
                       paste0("zapas_", c("sklepy", "hurtownia", "producent", "dostawca")))
write.csv(dane, "bicz-lancuch-104-tygodnie.csv", row.names = FALSE)

cat("Popyt końcowy: średnia", round(mean(dane$popyt)), "| odch. std.", round(sd(dane$popyt)),
    "| min", min(dane$popyt), "| max", max(dane$popyt), "\n")
sp <- sapply(dane[3:6], function(x) c(srednia = round(mean(x)), odch_std = round(sd(x)), min = min(x), max = max(x)))
print(sp)
cat("Iloraz wariancji zamówień do wariancji popytu (ta jedna realizacja):",
    paste(szczeble, round(iloraz(w1), 2), sep = " ", collapse = " | "), "\n")

dl <- data.frame(tydzien = rep(1:104, 5), ile = unlist(dane[2:6]) / 1000,
                 kto = factor(rep(c("popyt w sklepach", paste("zamówienia:", szczeble)), each = 104),
                              c("popyt w sklepach", paste("zamówienia:", szczeble))))
etyk <- paste0(levels(dl$kto), c("", sprintf("  (iloraz wariancji %.1f)", iloraz(w1))))
levels(dl$kto) <- etyk
dl$sklepowy <- dl$kto == etyk[1]
p1 <- ggplot(dl, aes(tydzien, ile)) +
  geom_hline(yintercept = 20, colour = "grey60", linewidth = 0.4) +
  geom_line(aes(colour = sklepowy), linewidth = 0.8, show.legend = FALSE) +
  facet_wrap(~kto, ncol = 1) +
  scale_colour_manual(values = c(`TRUE` = kol[["pomaranczowy"]], `FALSE` = kol[["niebieski"]])) +
  scale_x_continuous(breaks = c(1, 27, 53, 79, 104)) +
  labs(title = "Ten sam popyt, coraz większe fale zamówień",
       subtitle = "tys. kartonów tygodniowo; linia pozioma: średni popyt 20 tys.",
       x = "tydzień", y = "tys. kartonów") + motyw
p1                       # do pliku: ggsave("bicz-fale-zamowien.svg", p1, width = 10, height = 8)
Wynik w R
Popyt końcowy: średnia 20108 | odch. std. 2235 | min 15855 | max 26923
         zam_sklepy zam_hurtownia zam_producent zam_dostawca
srednia       20144         20232         20360        20634
odch_std       2484          3140          4152         6606
min           15718         14491         11840         6119
max           27863         30021         32818        38244
Iloraz wariancji zamówień do wariancji popytu (ta jedna realizacja): sklepy 1.24 | hurtownia 1.97 | producent 3.45 | dostawca celulozy 8.73
2. Narastanie efektu w 500 powtórzeniach: Rysunek 2
R
# Rysunek 2. Narastanie efektu: iloraz wariancji na każdym szczeblu w 500 powtórzeniach symulacji
# (korzysta z popyt, lancuch, iloraz, szczeble, kol i motyw z przepisu 1)
library(ggplot2)

set.seed(7592)
R <- 500
wyn <- t(replicate(R, {
  w <- lancuch(popyt())
  # to samo liczone na sumach 4-tygodniowych (26 „miesięcy” zamiast 104 tygodni)
  mies <- function(x) colSums(matrix(x[31:134], nrow = 4))
  c(iloraz(w), apply(w$zam, 2, function(z) var(mies(z)) / var(mies(w$D))))
}))
tyg <- wyn[, 1:4]; m4 <- wyn[, 5:8]
podsum <- function(x) c(srednia = mean(x), dolna = mean(x) - 1.96 * sd(x) / sqrt(length(x)),
                        gorna = mean(x) + 1.96 * sd(x) / sqrt(length(x)),
                        p2.5 = unname(quantile(x, .025)), p97.5 = unname(quantile(x, .975)))
tab <- data.frame(szczebel = szczeble, t(apply(tyg, 2, podsum)))
tab$krok <- tab$srednia / c(1, head(tab$srednia, -1))          # wzrost względem szczebla niżej
print(cbind(tab[1], round(tab[-1], 2)), row.names = FALSE)
cat("Średni iloraz na sumach 4-tygodniowych:", paste(szczeble, round(colMeans(m4), 2), collapse = " | "), "\n")
cat("Odsetek powtórzeń, w których dostawca ma iloraz > 5:", round(100 * mean(tyg[, 4] > 5), 1), "%\n")

pk <- data.frame(szczebel = factor(rep(szczeble, each = R), szczeble), iloraz = as.vector(tyg))
ps <- transform(tab, szczebel = factor(szczebel, szczeble))
pm <- data.frame(szczebel = factor(szczeble, szczeble), iloraz = colMeans(m4))
p2 <- ggplot(pk, aes(szczebel, iloraz)) +
  geom_hline(yintercept = 1, linetype = 3, colour = "grey40") +
  geom_violin(aes(fill = "pojedyncze powtórzenia (rozkład)"), colour = NA, alpha = 0.45, width = 0.7) +
  scale_fill_manual(values = kol[["szary"]], name = NULL) +
  geom_point(data = pm, aes(shape = "sumy 4-tygodniowe (średnia)"), colour = kol[["pomaranczowy"]], size = 3.2,
             position = position_nudge(x = 0.3)) +
  geom_pointrange(data = ps, aes(y = srednia, ymin = dolna, ymax = gorna, shape = "dane tygodniowe: średnia z 95% CI"),
                  colour = kol[["niebieski"]], size = 0.7, linewidth = 1) +
  geom_text(data = ps, aes(y = srednia, label = sprintf("%.2f", srednia)), nudge_x = -0.33, size = 4,
            colour = kol[["granat"]]) +
  scale_y_log10(breaks = c(0.5, 1, 2, 5, 10, 20)) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(title = "Iloraz wariancji zamówień do wariancji popytu końcowego",
       subtitle = "500 powtórzeń po 104 tygodnie; szare pola – rozkład wyników pojedynczych powtórzeń; skala log",
       x = NULL, y = "Var(zamówienia) / Var(popyt)") + motyw
p2                       # do pliku: ggsave("bicz-narastanie.svg", p2, width = 10, height = 6)
Wynik w R
          szczebel srednia dolna gorna p2.5 p97.5 krok
            sklepy    1.22  1.22  1.23 1.16  1.30 1.22
         hurtownia    1.96  1.95  1.98 1.67  2.34 1.61
         producent    3.56  3.51  3.61 2.62  4.71 1.81
 dostawca celulozy    9.80  9.61  9.99 6.09 14.59 2.75
Średni iloraz na sumach 4-tygodniowych: sklepy 1.18 | hurtownia 1.77 | producent 2.95 | dostawca celulozy 7.37
Odsetek powtórzeń, w których dostawca ma iloraz > 5: 100 %
3. Wzór Chena i in. a symulacja: Rysunek 3
R
# Rysunek 3. Wzór Chena i in. (2000) dla średniej ruchomej a symulacja jednego szczebla
# (korzysta z popyt, lancuch, kol i motyw z przepisu 1)
library(ggplot2)

# Wzór: Var(q) / Var(D) = 1 + (2L/p + 2L²/p²)(1 − rho^p) dla popytu AR(1) bez sezonu,
# zamawiania „do poziomu” y = L × średnia z p tygodni i stałego zapasu bezpieczeństwa
wzor <- function(L, p, rho) 1 + (2 * L / p + 2 * L^2 / p^2) * (1 - rho^p)
siatka <- expand.grid(p = c(2, 3, 4, 6, 8, 12), L = c(1, 2, 4))
set.seed(7593)
siatka$symulacja <- sapply(seq_len(nrow(siatka)), function(i) {
  D <- popyt(tyg = 20000, sezon = 0)                       # długi szereg, bez sezonu
  w <- lancuch(D, L = siatka$L[i], p = siatka$p[i], obetnij = FALSE)
  var(w$zam[31:20030, 1]) / var(D[31:20030])
})
siatka$wzor <- wzor(siatka$L, siatka$p, rho = 0.6)
print(transform(siatka, symulacja = round(symulacja, 2), wzor = round(wzor, 2)), row.names = FALSE)
cat("Największa różnica symulacja − wzór:", round(max(abs(siatka$symulacja - siatka$wzor)), 3), "\n")
cat("Ten sam wzór dla rho = 0 i rho = 0.9 przy L = 2, p = 6:", round(wzor(2, 6, 0), 2), "i", round(wzor(2, 6, 0.9), 2), "\n")

krzywe <- expand.grid(p = seq(2, 12, by = 0.1), L = c(1, 2, 4))
krzywe$wzor <- wzor(krzywe$L, krzywe$p, 0.6)
p3 <- ggplot(krzywe, aes(p, wzor, colour = factor(L), linetype = factor(L))) +
  geom_line(linewidth = 1) +
  geom_point(data = siatka, aes(y = symulacja, shape = factor(L)), size = 3, stroke = 1.1) +
  scale_colour_manual(values = c(kol[["blekit"]], kol[["niebieski"]], kol[["pomaranczowy"]]), name = "czas realizacji L (tygodnie)") +
  scale_linetype_manual(values = c(3, 2, 1), name = "czas realizacji L (tygodnie)") +
  scale_shape_manual(values = c(1, 2, 0), name = "czas realizacji L (tygodnie)") +
  scale_x_continuous(breaks = c(2, 3, 4, 6, 8, 12)) + scale_y_continuous(breaks = seq(1, 11, 2)) +
  labs(title = "Jeden szczebel: wzór (linie) i symulacja (punkty)",
       subtitle = "popyt AR(1) z rho = 0.6, bez sezonu; 20 000 tygodni na każdy punkt",
       x = "liczba tygodni w średniej ruchomej p", y = "Var(zamówienia) / Var(popyt)") + motyw
p3                       # do pliku: ggsave("bicz-wzor-chena.svg", p3, width = 10, height = 5.8)
Wynik w R
  p L symulacja wzor
  2 1      1.95 1.96
  3 1      1.69 1.70
  4 1      1.54 1.54
  6 1      1.37 1.37
  8 1      1.28 1.28
 12 1      1.18 1.18
  2 2      3.62 3.56
  3 2      2.71 2.74
  4 2      2.30 2.31
  6 2      1.84 1.85
  8 2      1.62 1.61
 12 2      1.39 1.39
  2 4      8.70 8.68
  3 4      5.83 5.88
  4 4      4.45 4.48
  6 4      3.09 3.12
  8 4      2.50 2.47
 12 4      1.89 1.89
Największa różnica symulacja − wzór: 0.059
Ten sam wzór dla rho = 0 i rho = 0.9 przy L = 2, p = 6: 1.89 i 1.42
4. Osiem scenariuszy: Rysunek 4
R
# Rysunek 4. Źródła efektu i co pomaga: osiem scenariuszy po 500 powtórzeń
# (korzysta z popyt, lancuch, iloraz, kol i motyw z przepisu 1)
library(ggplot2)

scen <- list(
  "bazowy: średnia z 6 tyg., L = 1, 2, 2, 3"   = list(),
  "wygładzanie wykładnicze zamiast średniej"    = list(metoda = "wygladzanie"),
  "hurtownia zamawia pełne partie po 8000"      = list(partia = c(0, 8000, 0, 0)),
  "promocje w sklepach (6 akcji)"               = list(promocje = TRUE),
  "wszyscy prognozują z danych ze sklepów"      = list(wspolne = TRUE),
  "krótszy czas realizacji: L = 1, 1, 1, 2"     = list(L = c(1, 1, 1, 2)),
  "wygładzanie zamówień: beta = 0.4 wszędzie"   = list(beta = 0.4),
  "dane ze sklepów + krótszy L + beta = 0.4"    = list(wspolne = TRUE, L = c(1, 1, 1, 2), beta = 0.4))
R <- 500
wyniki <- do.call(rbind, lapply(seq_along(scen), function(s) {
  a <- scen[[s]]
  set.seed(7592)                 # te same popyty co w przepisie 2 i w każdym scenariuszu (wspólne liczby losowe)
  il <- t(replicate(R, {
    D <- popyt(promocje = isTRUE(a$promocje))
    iloraz(do.call(lancuch, c(list(D = D), a[setdiff(names(a), "promocje")])))
  }))
  data.frame(scenariusz = names(scen)[s], szczebel = c("producent", "dostawca celulozy"),
             srednia = colMeans(il[, 3:4]), dolna = colMeans(il[, 3:4]) - 1.96 * apply(il[, 3:4], 2, sd) / sqrt(R),
             gorna = colMeans(il[, 3:4]) + 1.96 * apply(il[, 3:4], 2, sd) / sqrt(R),
             wzgl_bazowego = NA)
}))
baz <- wyniki$srednia[1:2]
wyniki$wzgl_bazowego <- round(100 * (wyniki$srednia / rep(baz, length(scen)) - 1))
print(cbind(wyniki[1:2], round(wyniki[3:5], 2), zmiana_proc = wyniki$wzgl_bazowego), row.names = FALSE)

wyniki$scenariusz <- factor(wyniki$scenariusz, rev(names(scen)))
wyniki$grupa <- factor(ifelse(as.integer(wyniki$scenariusz) <= 4, "co pomaga",
                              ifelse(as.integer(wyniki$scenariusz) == 8, "bazowy", "źródła efektu")),
                       c("bazowy", "źródła efektu", "co pomaga"))
wyniki$szczebel <- factor(wyniki$szczebel, c("producent", "dostawca celulozy"))
p4 <- ggplot(wyniki, aes(srednia, scenariusz, colour = grupa, shape = grupa)) +
  geom_vline(data = wyniki[wyniki$scenariusz == names(scen)[1], ], aes(xintercept = srednia),
             linetype = 2, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 0.9, orientation = "y") +
  geom_point(size = 3) +
  geom_text(aes(label = sprintf("%.1f", srednia)), nudge_y = 0.36, size = 3.6, show.legend = FALSE) +
  facet_wrap(~szczebel, scales = "free_x") +
  scale_x_log10() +
  scale_colour_manual(values = c("bazowy" = kol[["granat"]], "co pomaga" = kol[["zielony"]],
                                 "źródła efektu" = kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c("bazowy" = 15, "co pomaga" = 16, "źródła efektu" = 17), name = NULL) +
  labs(title = "Iloraz wariancji zamówień w ośmiu scenariuszach",
       subtitle = "średnia z 500 powtórzeń i 95% CI; skala log",
       x = "Var(zamówienia) / Var(popyt końcowy)", y = NULL) + motyw + theme(plot.title.position = "plot")
p4                       # do pliku: ggsave("bicz-scenariusze.svg", p4, width = 10, height = 6.4)
Wynik w R
                                scenariusz          szczebel srednia dolna
  bazowy: średnia z 6 tyg., L = 1, 2, 2, 3         producent    3.56  3.51
  bazowy: średnia z 6 tyg., L = 1, 2, 2, 3 dostawca celulozy    9.80  9.61
  wygładzanie wykładnicze zamiast średniej         producent    4.25  4.20
  wygładzanie wykładnicze zamiast średniej dostawca celulozy   12.68 12.47
    hurtownia zamawia pełne partie po 8000         producent    7.66  7.53
    hurtownia zamawia pełne partie po 8000 dostawca celulozy   20.86 20.45
             promocje w sklepach (6 akcji)         producent    4.65  4.61
             promocje w sklepach (6 akcji) dostawca celulozy   12.81 12.67
    wszyscy prognozują z danych ze sklepów         producent    2.75  2.72
    wszyscy prognozują z danych ze sklepów dostawca celulozy    4.56  4.51
   krótszy czas realizacji: L = 1, 1, 1, 2         producent    2.03  2.02
   krótszy czas realizacji: L = 1, 1, 1, 2 dostawca celulozy    3.76  3.71
 wygładzanie zamówień: beta = 0.4 wszędzie         producent    3.18  3.14
 wygładzanie zamówień: beta = 0.4 wszędzie dostawca celulozy    7.53  7.38
  dane ze sklepów + krótszy L + beta = 0.4         producent    1.66  1.65
  dane ze sklepów + krótszy L + beta = 0.4 dostawca celulozy    2.13  2.12
 gorna zmiana_proc
  3.61           0
  9.99           0
  4.30          19
 12.89          29
  7.79         115
 21.27         113
  4.69          31
 12.95          31
  2.77         -23
  4.61         -53
  2.05         -43
  3.82         -62
  3.22         -11
  7.68         -23
  1.66         -54
  2.14         -78
5. Wygładzanie zamówień a koszt: Rysunek 5
R
# Rysunek 5. Wariancja zamówień to nie koszt: producent wygładza zamówienia celulozy (beta)
# (korzysta z popyt, lancuch, iloraz, szczeble, kol i motyw z przepisu 1)
library(ggplot2)
library(patchwork)

# Koszt tygodniowy szczebla: h za karton w zapasie, b za karton brakujący (zaległy); h i b ustalone ręcznie.
# Stały zapas bezpieczeństwa dobieramy osobno w każdym powtórzeniu i scenariuszu tak, by koszt był
# najmniejszy (kwantyl b/(b + h) = 90% rozkładu zapasu netto bez zapasu bezpieczeństwa).
h <- 0.05; b <- 0.45                                            # zł za karton tygodniowo
koszt_tyg <- function(z) { s <- quantile(-z, b / (b + h)); mean(h * pmax(z + s, 0) + b * pmax(-(z + s), 0)) }
bety <- c(1, 0.8, 0.6, 0.4, 0.3, 0.2)
R <- 500
wyn <- do.call(rbind, lapply(bety, function(bt) {
  set.seed(7592)                                                # te same popyty co w przepisach 2 i 4
  r <- t(replicate(R, {
    w <- lancuch(popyt(), beta = c(1, 1, bt, 1))               # wygładza tylko producent
    c(iloraz(w), apply(w$zapas[31:134, ], 2, koszt_tyg))
  }))
  data.frame(beta = bt, szczebel = szczeble, iloraz = colMeans(r[, 1:4]), koszt = colMeans(r[, 5:8]),
             koszt_se = apply(r[, 5:8], 2, sd) / sqrt(R))
}))
print(transform(wyn[wyn$szczebel %in% szczeble[3:4], ], iloraz = round(iloraz, 2), koszt = round(koszt),
                koszt_se = round(koszt_se, 1)), row.names = FALSE)
suma <- aggregate(koszt ~ beta, wyn, sum)
cat("Koszt całego łańcucha (zł tygodniowo):", paste0("beta = ", suma$beta, ": ", round(suma$koszt), collapse = " | "), "\n")

wp <- wyn[wyn$szczebel %in% szczeble[3:4], ]
wp$szczebel <- factor(wp$szczebel, c(szczeble[3:4], "cały łańcuch"))
wk <- rbind(wp[c("beta", "szczebel", "koszt")], data.frame(beta = suma$beta, szczebel = "cały łańcuch", koszt = suma$koszt))
wk$szczebel <- factor(wk$szczebel, c(szczeble[3:4], "cały łańcuch"))
pa <- ggplot(wp, aes(beta, iloraz, colour = szczebel, shape = szczebel)) + geom_line(linewidth = 0.9) + geom_point(size = 2.8) +
  scale_x_reverse(breaks = bety) + scale_y_continuous(limits = c(0, NA)) +
  labs(title = "A. Iloraz wariancji zamówień", x = "beta producenta (1 = do poziomu)", y = "Var(zamówienia) / Var(popyt)") +
  guides(colour = "none", shape = "none")                      # wspólna legenda pod panelem B
pb <- ggplot(wk, aes(beta, koszt / 1000, colour = szczebel, shape = szczebel)) + geom_line(linewidth = 0.9) + geom_point(size = 2.8) +
  scale_x_reverse(breaks = bety) + scale_y_continuous(limits = c(0, NA)) +
  labs(title = "B. Koszt zapasu i braków", x = "beta producenta (1 = do poziomu)", y = "tys. zł tygodniowo")
p5 <- (pa + pb) + plot_layout(guides = "collect") &
  scale_colour_manual(values = c(producent = kol[["niebieski"]], "dostawca celulozy" = kol[["pomaranczowy"]],
                                 "cały łańcuch" = kol[["granat"]]), limits = levels(wk$szczebel), name = NULL) &
  scale_shape_manual(values = c(producent = 16, "dostawca celulozy" = 17, "cały łańcuch" = 15), limits = levels(wk$szczebel), name = NULL) & motyw
p5                       # do pliku: ggsave("bicz-koszt-wygladzania.svg", p5, width = 10, height = 5.6)
Wynik w R
 beta          szczebel iloraz koszt koszt_se
  1.0         producent   3.56   482      3.1
  1.0 dostawca celulozy   9.80  1073      8.1
  0.8         producent   3.34   517      3.5
  0.8 dostawca celulozy   9.07  1072      8.3
  0.6         producent   3.15   568      4.0
  0.6 dostawca celulozy   8.40  1057      8.3
  0.4         producent   2.92   642      4.6
  0.4 dostawca celulozy   7.46  1004      8.0
  0.3         producent   2.75   694      5.0
  0.3 dostawca celulozy   6.72   947      7.6
  0.2         producent   2.52   768      5.5
  0.2 dostawca celulozy   5.73   857      6.9
Koszt całego łańcucha (zł tygodniowo): beta = 0.2: 2103 | beta = 0.3: 2119 | beta = 0.4: 2124 | beta = 0.6: 2104 | beta = 0.8: 2068 | beta = 1: 2034
6. Schemat łańcucha: Rysunek 6
R
# Rysunek 6. Schemat łańcucha: popyt w sklepach i coraz większe fale zamówień na kolejnych szczeblach
# (korzysta z kol i motyw z przepisu 1; ilorazy z przepisu 2 wpisane ręcznie; bez losowania)
library(ggplot2)

il <- c(1, 1.22, 1.96, 3.56, 9.80)                       # popyt, sklepy, hurtownia, producent, dostawca
pola <- data.frame(x = c(1, 3, 5, 7, 9), y = 1.5,
                   tytul = c("Klienci", "Sklepy", "Hurtownia", "Producent", "Dostawca\ncelulozy"),
                   opis = c("popyt końcowy\nAR(1) + sezon", "średnia z 6 tyg.\nL = 1 tydzień", "średnia z 6 tyg.\nL = 2 tygodnie",
                            "średnia z 6 tyg.\nL = 2 tygodnie", "średnia z 6 tyg.\nL = 3 tygodnie"))
pola$tlo <- c("#fbe6d9", rep("#dcebf6", 4))
# fale nad polami: amplituda proporcjonalna do odchylenia standardowego (pierwiastek z ilorazu wariancji)
fale <- do.call(rbind, lapply(1:5, function(i) {
  s <- seq(-0.8, 0.8, length.out = 120)
  data.frame(x = pola$x[i] + s, y = 3.35 + 0.22 * sqrt(il[i]) * sin(2 * pi * 2 * s / 1.6), kto = i)
}))
podp <- data.frame(x = pola$x, y = 2.45, tekst = c("wariancja = 1", sprintf("× %.2f", il[-1])))
strz <- data.frame(x = pola$x[1:4] + 0.82, xend = pola$x[2:5] - 0.82)
p6 <- ggplot() +
  geom_path(data = fale, aes(x, y, group = kto), colour = ifelse(fale$kto == 1, kol[["pomaranczowy"]], kol[["niebieski"]]),
            linewidth = 1.1) +
  geom_text(data = podp, aes(x, y, label = tekst), size = 4, fontface = "bold", colour = kol[["granat"]]) +
  geom_tile(data = pola, aes(x, y), width = 1.6, height = 1.25, fill = pola$tlo, colour = "#c9c6bf") +
  geom_text(data = pola, aes(x, y + 0.3, label = tytul), fontface = "bold", size = 4.1, colour = "#0f1d3a", lineheight = 0.9) +
  geom_text(data = pola, aes(x, y - 0.33, label = opis), size = 3.3, colour = "#0f1d3a", lineheight = 0.95) +
  geom_segment(data = strz, aes(x = x, xend = xend, y = 1.75, yend = 1.75), colour = kol[["granat"]], linewidth = 0.9,
               arrow = arrow(length = unit(0.2, "cm"), type = "closed")) +
  geom_segment(data = strz, aes(x = xend, xend = x, y = 1.25, yend = 1.25), colour = kol[["zielony"]], linewidth = 0.9,
               linetype = 2, arrow = arrow(length = unit(0.2, "cm"), type = "closed")) +
  annotate("text", x = 5, y = 0.55, size = 3.5, colour = kol[["granat"]],
           label = "strzałki ciągłe: zamówienia w górę łańcucha; przerywane: towar w dół\nfale: odchylenie standardowe tygodniowych zamówień (średnia z 500 powtórzeń symulacji)") +
  coord_cartesian(xlim = c(0.1, 9.9), ylim = c(0.2, 4.15), expand = FALSE) +
  labs(title = "Efekt byczego bicza: każdy szczebel wzmacnia wahania",
       subtitle = "iloraz wariancji zamówień do wariancji popytu w sklepach", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p6                       # do pliku: ggsave("bicz-schemat-lancucha.svg", p6, width = 10, height = 5)
7. Sprawdzenie palety pod kątem zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "błękit – niebieski" = c("#56B4E9", "#0072B2"),
             "niebieski – zielony" = c("#0072B2", "#009E73"), "pomarańczowy – zielony" = c("#D55E00", "#009E73"),
             "niebieski – granat" = c("#0072B2", "#0f1d3a"), "pomarańczowy – granat" = c("#D55E00", "#0f1d3a"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
błękit – niebieski                          26.4         24.7       24.6
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
niebieski – granat                          41.3         40.8       41.3
pomarańczowy – granat                      101.6         96.6       81.5
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Symulację popytu AR(1), średnie ruchome i wariancje obliczono funkcjami pakietu stats (z podstawowej instalacji R). Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Wariancja zamówień to nie koszt – wygładzanie przesuwa koszt zapasu na tego, kto wygładza (rysunek 5).
- Jedna realizacja zamiast rozkładu – iloraz dostawcy z jednych dwóch lat wahał się od 6.09 do 14.59 (rysunek 2).
- Dane tygodniowe a miesięczne (lub dzienne) – iloraz zależy od jednostki czasu: sumy 4-tygodniowe dały 7.37 zamiast 9.80. Dane dzienne dodają wahania dnia tygodnia i rytmu zamawiania, które nie są efektem byczego bicza. Porównuj ilorazy tylko na tej samej jednostce.
- Sezon w mianowniku – przewidywalny sezon zwiększa wariancję popytu i może ukryć wzmocnienie wahań nieprzewidywalnych; licz iloraz także dla danych bez sezonu (Cachon i in., 2007).
- Zamówienia to nie popyt – szczebel, który prognozuje z zamówień odbiorcy, prognozuje już wzmocnione wahania (rysunek 4).
Najczęstsze pytania
Co to jest efekt byczego bicza?
To wzrost zmienności zamówień w górę łańcucha dostaw: sklepy zamawiają w hurtowni bardziej nierówno, niż klienci kupują, hurtownia u producenta jeszcze bardziej nierówno itd. W przykładzie wariancja zamówień dostawcy celulozy była 9.80 raza większa niż wariancja popytu w sklepach, choć średnie były prawie takie same. Źródła to m.in. prognozowanie, czas realizacji, zamawianie partiami i promocje.
Jak zmierzyć efekt byczego bicza?
Podziel wariancję zamówień, które szczebel wysyła, przez wariancję popytu końcowego (albo zamówień, które dostaje) z tych samych tygodni. Wynik powyżej 1 oznacza wzmocnienie. Podawaj jednostkę czasu – w przykładzie ten sam łańcuch dał 9.80 na danych tygodniowych i 7.37 na sumach 4-tygodniowych – a jeśli liczysz z symulacji, podaj średnią z wielu powtórzeń z przedziałem ufności.
Co mówi wzór Chena i in. o efekcie byczego bicza?
Dla jednego szczebla prognozującego średnią ruchomą z p okresów i czasu realizacji L iloraz wariancji wynosi 1 + (2L/p + 2L²/p²)(1 − ρ^p), gdzie ρ to autokorelacja popytu. Efekt rośnie z kwadratem czasu realizacji i maleje przy dłuższej średniej. Symulacja w przykładzie zgadzała się ze wzorem z dokładnością do 0.06.
Jak zmniejszyć efekt byczego bicza?
Najskuteczniejsze w przykładzie było skrócenie czasów realizacji (iloraz dostawcy z 9.80 do 3.76) i prognozowanie przez wszystkie szczeble z danych o sprzedaży w sklepach (do 4.56). Pomaga też zamawianie mniejszymi partiami, rzadsze promocje i wygładzanie zamówień. Udostępnienie danych o popycie zmniejsza efekt, ale go nie usuwa.
Czy mniejsze wahania zamówień zawsze obniżają koszty?
Nie. Gdy producent wygładzał zamówienia celulozy (beta = 0.2), iloraz dostawcy spadł z 9.80 do 5.73, a koszt zapasu dostawcy z 1073 do 857 zł tygodniowo, ale koszt producenta wzrósł z 482 do 768 zł. Koszt całego łańcucha prawie się nie zmienił – wygładzanie przesuwa koszt, więc trzeba ustalić, kto za nie płaci.
Powiązane hasła
Przeczytaj też
Model gazeciarza i zapas bezpieczeństwa
Sieć piekarni: kwantyl krytyczny, sprzedaż ≠ popyt w dniach wyprzedanych, zapas mąki z błędów prognozy, poziom obsługi α i β – rysunki i kod R.
Czytaj →PoradnikCzas realizacji dostaw na 90. centylu
Producent mebli tapicerowanych: regresja kwantylowa dostawców, terminowość z przedziałem Wilsona i zapas bezpieczeństwa przy długim ogonie – z kodem R.
Czytaj →PoradnikPopyt sporadyczny: Croston i SBA
Hurtownia części rolniczych: typy popytu ADI–CV², metoda Crostona i SBA, MASE i błąd skumulowany, zapas z bootstrapu i poziom obsługi – z kodem R.
Czytaj →Piszesz pracę o łańcuchu dostaw albo analizujesz zamówienia w firmie?
Pomożemy zbudować symulację łańcucha, policzyć iloraz wariancji z przedziałami, porównać scenariusze i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cachon, G. P., Randall, T., & Schmidt, G. M. (2007). In search of the bullwhip effect. Manufacturing & Service Operations Management, 9(4), 457–479. https://doi.org/10.1287/msom.1060.0149
- Chen, F., Drezner, Z., Ryan, J. K., & Simchi-Levi, D. (2000). Quantifying the bullwhip effect in a simple supply chain: The impact of forecasting, lead times, and information. Management Science, 46(3), 436–443. https://doi.org/10.1287/mnsc.46.3.436.12069
- Chen, F., Ryan, J. K., & Simchi-Levi, D. (2000). The impact of exponential smoothing forecasts on the bullwhip effect. Naval Research Logistics, 47(4), 269–286. https://doi.org/10.1002/(sici)1520-6750(200006)47:4<269::aid-nav1>3.0.co;2-q
- Disney, S. M., & Towill, D. R. (2003). Vendor-managed inventory and bullwhip reduction in a two-level supply chain. International Journal of Operations & Production Management, 23(6), 625–651. https://doi.org/10.1108/01443570310476654
- Lee, H. L., Padmanabhan, V., & Whang, S. (1997). Information distortion in a supply chain: The bullwhip effect. Management Science, 43(4), 546–558. https://doi.org/10.1287/mnsc.43.4.546
- Sterman, J. D. (1989). Modeling managerial behavior: Misperceptions of feedback in a dynamic decision making experiment. Management Science, 35(3), 321–339. https://doi.org/10.1287/mnsc.35.3.321
Cytowania BibTeX
@article{cachon2007search, author={Cachon, Gérard P. and Randall, Taylor and Schmidt, Glen M.}, title={{In search of the bullwhip effect}}, journal={Manufacturing \& Service Operations Management}, year={2007}, volume={9}, number={4}, pages={457--479}, doi={10.1287/msom.1060.0149}}@article{chen2000quantifying, author={Chen, Frank and Drezner, Zvi and Ryan, Jennifer K. and Simchi-Levi, David}, title={{Quantifying the bullwhip effect in a simple supply chain: The impact of forecasting, lead times, and information}}, journal={Management Science}, year={2000}, volume={46}, number={3}, pages={436--443}, doi={10.1287/mnsc.46.3.436.12069}}@article{chen2000impact, author={Chen, Frank and Ryan, Jennifer K. and Simchi-Levi, David}, title={{The impact of exponential smoothing forecasts on the bullwhip effect}}, journal={Naval Research Logistics}, year={2000}, volume={47}, number={4}, pages={269--286}, doi={10.1002/(sici)1520-6750(200006)47:4<269::aid-nav1>3.0.co;2-q}}@article{disney2003vendor, author={Disney, Stephen M. and Towill, Denis R.}, title={{Vendor-managed inventory and bullwhip reduction in a two-level supply chain}}, journal={International Journal of Operations \& Production Management}, year={2003}, volume={23}, number={6}, pages={625--651}, doi={10.1108/01443570310476654}}@article{lee1997information, author={Lee, Hau L. and Padmanabhan, V. and Whang, Seungjin}, title={{Information distortion in a supply chain: The bullwhip effect}}, journal={Management Science}, year={1997}, volume={43}, number={4}, pages={546--558}, doi={10.1287/mnsc.43.4.546}}@article{sterman1989modeling, author={Sterman, John D.}, title={{Modeling managerial behavior: Misperceptions of feedback in a dynamic decision making experiment}}, journal={Management Science}, year={1989}, volume={35}, number={3}, pages={321--339}, doi={10.1287/mnsc.35.3.321}}