Przykład: hurtownia opakowań i 25 000 zamówień
Fikcyjna hurtownia opakowań i materiałów do wysyłki sprzedaje kartony, folię stretch, taśmy i wypełniacze firmom: sklepom internetowym, producentom i drukarniom. Od 1 lipca pierwszego roku obowiązuje rabat ilościowy od wartości zamówienia netto: 3% od 2000 zł, 6% od 5000 zł i 9% od 10 000 zł. Rabat obejmuje całe zamówienie. Dział sprzedaży ma 25 049 zamówień od 700 klientów z dwóch lat: 6650 sprzed wprowadzenia rabatów i 18 399 z 18 miesięcy po nim. Mediana zamówienia to 942 zł, a średnia 2014 zł. Pytanie zarządu: ilu klientów naprawdę zwiększa zamówienie z powodu rabatu, ile rabat kosztuje marżę i czy inne progi byłyby tańsze?
Odpowiedź zaczyna się od histogramu wartości zamówień: jeśli klienci dokupują towar do progu, tuż nad nim rośnie słupek (skupienie), a tuż pod nim robi się dziura. Tę logikę dla jednego progu darmowej dostawy opisuje wpis próg darmowej dostawy i metoda bunching. Tu są trzy progi naraz, klienci firmowi zamawiają regularnie, a rabat liczony od całego zamówienia tworzy skok ceny, który w ekonomii nazywa się notch (Kleven i Waseem, 2013).
Dane są fikcyjne i znamy prawdę. Każdy klient ma dzienne zużycie opakowań (mediana 60 zł netto) i własny rytm zamówień (7–35 dni). Po wprowadzeniu rabatów 60% klientów reaguje na progi: gdy brakuje niewiele (średnio do 8% progu), dokupują, a gdy brakuje dużo, w połowie przypadków łączą dwa zamówienia w jedno. 33 duże firmy mają cennik indywidualny bez progów. Wiemy więc, że do progów dociągnięto 335 zamówień, a połączono 1584. Ziarna 770 nie zmienialiśmy, ale po pierwszych uruchomieniach zmieniliśmy cztery parametry danych, dodaliśmy łączenie zamówień i poprawiliśmy przedziały – szczegóły przy kodzie. Dane pobierzesz jako hurtownia-opakowan-zamowienia.csv.
Rysunek 1: trzy progi – trzy skupiska
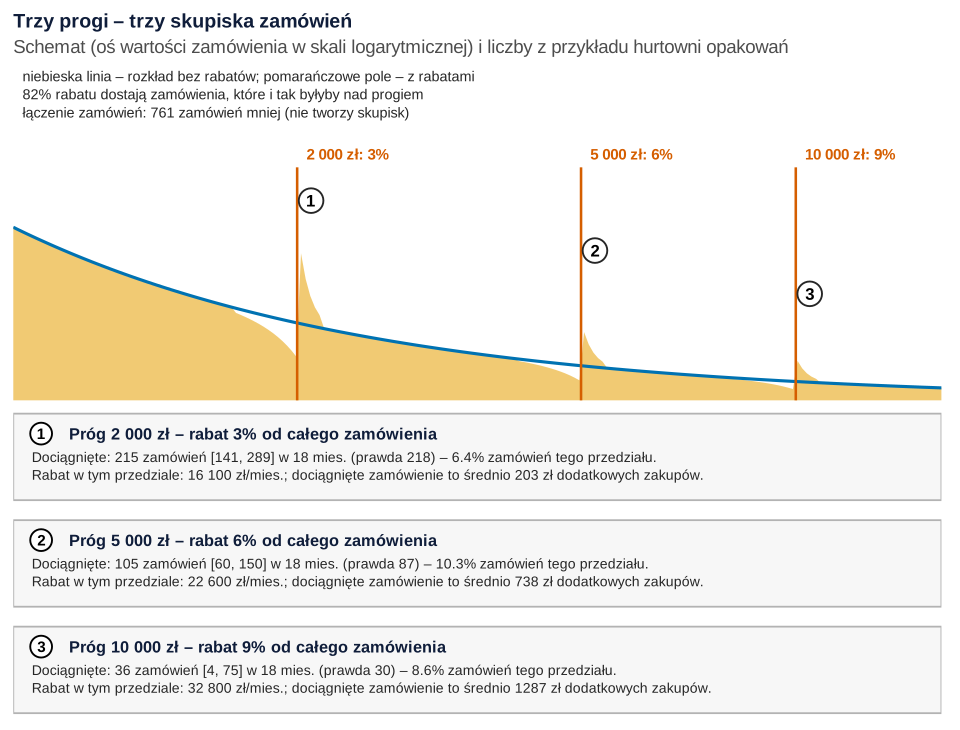
Co widać. Każdy próg ma skupisko, ale dociągniętych zamówień jest niewiele: 6.4% zamówień w przedziale 2000–5000 zł, 10.3% w przedziale 5000–10 000 zł i 8.6% powyżej 10 000 zł. Rabat płaci się zaś od wszystkich zamówień nad progiem.
Jak może zmylić. Skupienie pokazuje tylko jedną reakcję – dokupienie „do progu”. Łączenie dwóch zamówień w jedno nie zostawia skupiska – widać je dopiero w odstępach między zamówieniami (rysunek 4).
Rysunek 2: skupienia przy trzech progach
Dla każdego progu T robimy to samo, ale w skali dopasowanej do progu:
- Przedziały o szerokości 2% progu (40, 100 i 200 zł); próg jest granicą przedziału.
- Okno wokół progu: od 0.76T do 1.10T.
- Wielomian 4. stopnia dopasowany do przedziałów od 0.56T do 1.60T poza oknem i przedłużony do okna. To rozkład kontrfaktyczny, czyli „histogram bez rabatu” (Kleven, 2016).
- Nadwyżka i brak: suma (liczba zamówień − linia) nad progiem i (linia − liczba zamówień) pod progiem.
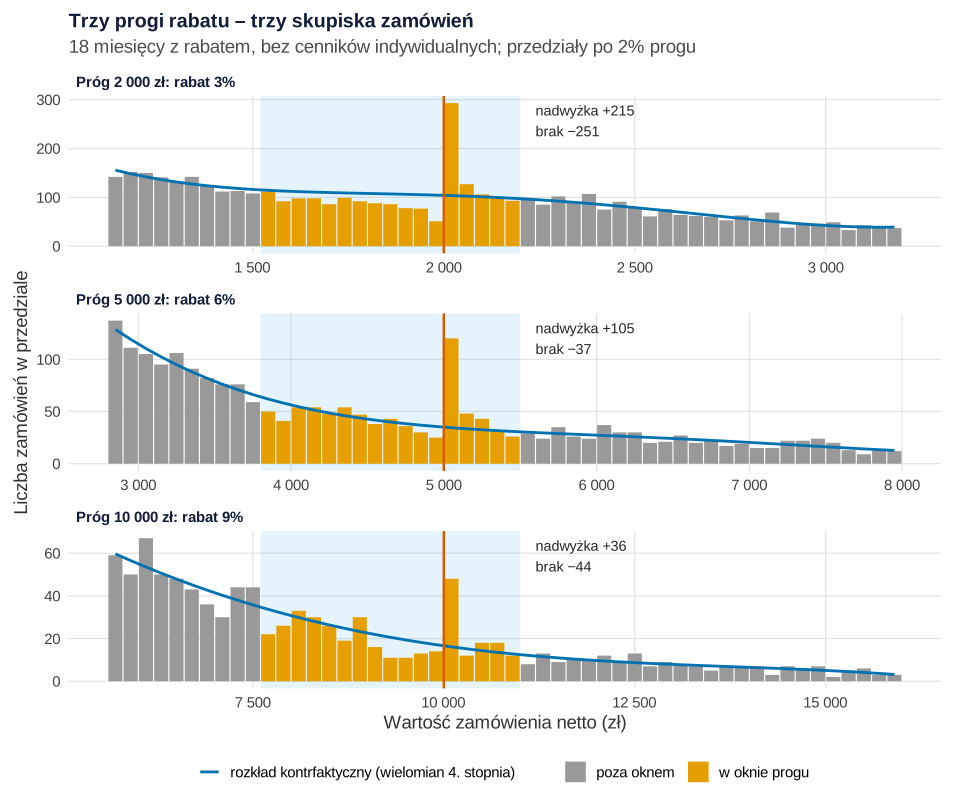
set.seed(770)).Co widać. W przedziale 2000–2040 zł jest 293 zamówienia, a linia kontrfaktyczna przewiduje 104. Tuż pod progiem, w przedziale 1960–2000 zł, jest 51 zamówień zamiast 105. Nadwyżka nad progiem 2000 zł wynosi 215 zamówień, brak pod nim – 251, a prawda to 218. Przy 5000 zł nadwyżka to 105 (prawda 87), przy 10 000 zł – 36 (prawda 30).
Jak może zmylić. Przy 5000 zł brak (37) jest dużo mniejszy od nadwyżki. Pod progiem część zamówień znika też z dalszych przedziałów, bo klienci je łączą, więc linia dopasowana poza oknem leży za nisko. Dlatego główną miarą jest nadwyżka. Dobry test placebo to okres przed rabatami: te same progi dają tam nadwyżki 5, −6 i 1 zamówienie.
Zdanie do Wyników:
Rysunek 3: przedział – losuj klientów, nie zamówienia
Niepewność oceniamy bootstrapem (Efron, 1979): całą procedurę powtarzamy 300 razy. W B2B zamówienia jednego klienta są do siebie podobne, więc losowanie pojedynczych zamówień zawęża przedział ufności. Losujemy więc całych klientów (667 klientów z ich zamówieniami). To bootstrap klastrowy, który daje poprawne przedziały dla danych pogrupowanych (Field i Welsh, 2007), podobnie jak błędy standardowe odporne na klastrowanie w regresji (Cameron i Miller, 2015). Tak samo losuje się słuchaczy przy ocenie rekomendacji offline.
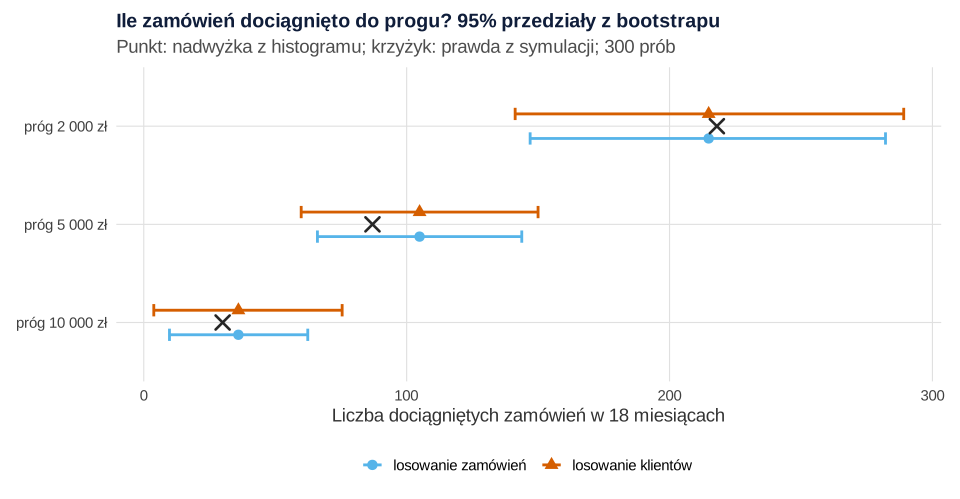
set.seed(7701)).Co widać. Przedziały z losowania klientów są szersze o 9% przy 2000 zł, o 16% przy 5000 zł i o 36% przy 10 000 zł. Przy 10 000 zł przedział [4, 75] zaczyna się niemal od zera, bo tak duże zamówienia składa niewielu klientów. Razem dociągnięto 356 zamówień, 95% CI [262, 445] (prawda 335), czyli 2.1% zamówień z 18 miesięcy.
Jak może zmylić. Bootstrap mierzy tylko losowość próby. Nie obejmuje niepewności z wyboru okna i stopnia wielomianu. Przy progu 5000 zł inne rozsądne warianty dają od 2 do 140 zamówień (pułapki na końcu wpisu), czyli rozrzut większy niż sam przedział.
Rysunek 4: czy klienci łączą zamówienia
Klientów dzielimy według mediany zamówienia sprzed rabatów: „tuż pod progiem” (76–100% któregoś progu, 104 klientów), „pół do progu” (50–76%, 217 klientów) i „pozostali” (346 klientów). Porównujemy zamówienia na 30 dni, średni odstęp między nimi i zakupy w złotych na 30 dni przed rabatami i po nich. Grupa „pozostali” jest porównawcza, więc wynik to różnica w różnicach.
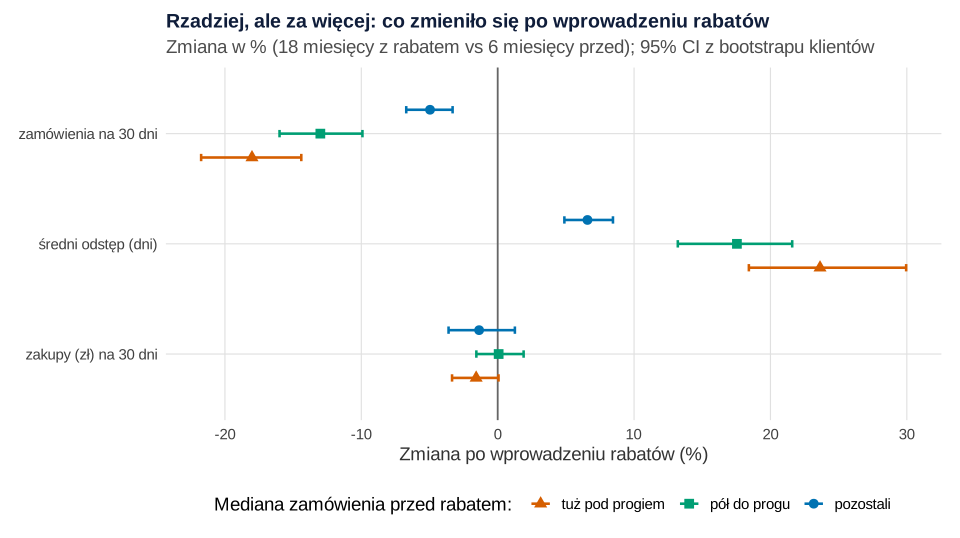
Co widać. Klienci tuż pod progiem składają o 18.0% mniej zamówień [−21.7, −14.4], a średni odstęp wzrósł u nich z 22.3 do 27.6 dnia. U klientów „pół do progu” zamówień jest mniej o 13.0%. Po odjęciu zmiany u pozostałych (−5.0%) różnica w różnicach wynosi −13.1 pp [−17.3, −9.2] i −8.0 pp [−11.3, −4.8]. Hurtownia obsłużyła o 761 zamówień mniej [554, 980] w 18 miesięcy. Zakupy w złotych prawie się nie zmieniły (od −1.6% do +0.1%): klienci kupują tyle samo, tylko rzadziej.
Jak może zmylić. Prawdziwy spadek w symulacji to około 1630 zamówień, czyli dwa razy więcej niż oszacowanie. Grupa porównawcza też reaguje, bo pojedyncze zamówienia „pozostałych” czasem wypadają w połowie drogi do progu. Taka „skażona” kontrola zaniża efekt. To schemat quasi-eksperymentalny, więc sezon może udawać efekt rabatu. Podobne zakupy na zapas opisano przy promocjach w handlu detalicznym (Hendel i Nevo, 2006).
Zdanie do Wyników:
Rysunek 5: koszt rabatu dla marży
Rabat oddany to 71 481 zł miesięcznie. Ile z tego „kupiło” zmianę zachowania? Gdy nałożymy obecny cennik na zamówienia sprzed zmiany, dostaniemy rabat dla zamówień, które i tak przekroczyłyby próg. Resztę wywołała zmiana zachowania. Po stronie zysku są tylko oszczędności na obsłudze: każde zamówienie mniej to 55 zł kosztu kompletacji i dostawy. Marża brutto przed rabatem wynosi 24% wartości.
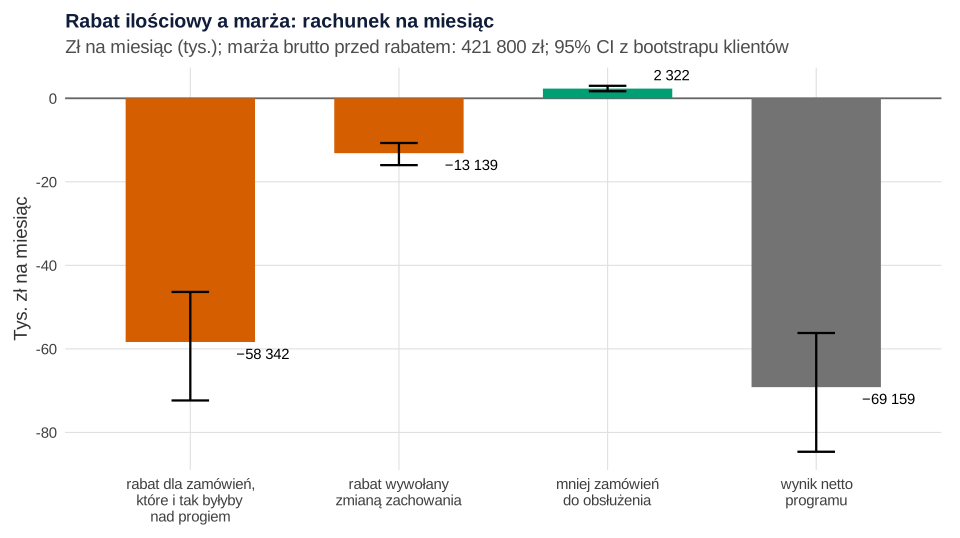
Co widać. 81.6% rabatu [77.4, 85.2] dostają zamówienia, które i tak byłyby nad progiem (prawda z symulacji: 81.3%). To 58 342 zł miesięcznie. Rabat wywołany zmianą zachowania to 13 139 zł, a oszczędność na obsłudze – tylko 2322 zł [1691, 2991]. Wynik netto programu to −69 159 zł miesięcznie [−84 634, −56 198], czyli 16.4% marży brutto.
Jak może zmylić. Kusi doliczenie marży z dokupionego towaru. Dociągnięte zamówienie to średnio +203 zł przy 2000 zł, +738 zł przy 5000 zł i +1287 zł przy 10 000 zł, co daje 2229 zł marży miesięcznie. Ale rysunek 4 pokazał, że zakupy w złotych się nie zmieniły. To ten sam towar kupiony wcześniej, a nie nowa sprzedaż. Rachunek pomija też klientów, którzy bez rabatu odeszliby do konkurencji – tego dane hurtowni nie pokażą.
Rysunek 6: inne progi i rabat od nadwyżki
Do porównania cenników potrzebny jest model reakcji. Z braku pod progami szacujemy odsetek klientów dokupujących przy luce g (część progu): p(g) = π · exp(−g / λ), wspólnie dla trzech progów. Wyszło π = 0.39 [0.24, 0.64] i λ = 0.11 [0.03, 0.39]. Szansę łączenia zamówień q = 0.18 [0.00, 0.24] dobieramy tak, by model odtwarzał 761 zamówień mniej z rysunku 4. Bazą są zamówienia sprzed rabatów. Sprawdzian: dla obecnego cennika model daje 67 152 zł rabatu, dane – 71 481 zł. Porównujemy obecny cennik, wyższe progi 2500/6000/12 000 zł i rabat od nadwyżki: 3% od części zamówienia między 2000 a 5000 zł, 6% od części do 10 000 zł i 9% od reszty. Wtedy dokupienie do progu nic nie daje, więc zakładamy brak skupisk i łączenia.
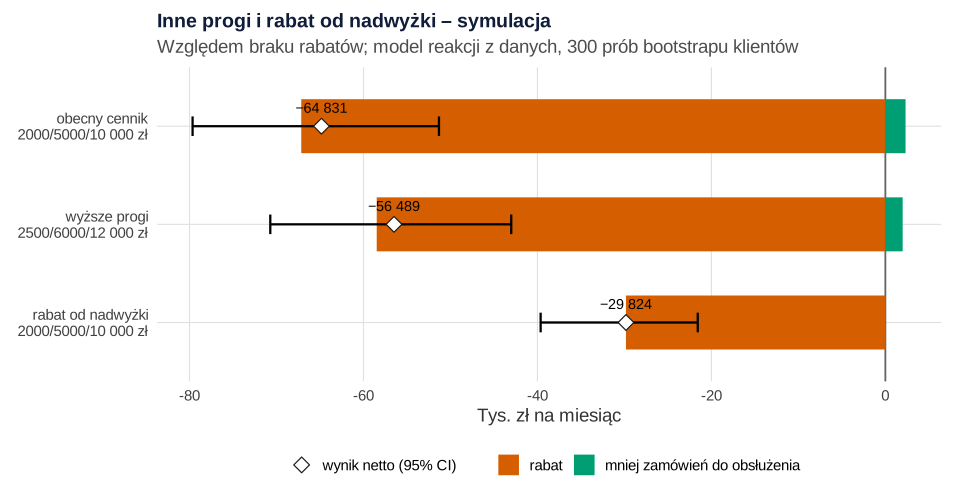
Co widać. Wyższe progi poprawiają wynik o 8342 zł miesięcznie [7153, 9811], bo mniej zamówień „i tak” łapie się na rabat. Rabat od nadwyżki poprawia wynik o 35 007 zł [28 806, 40 416]. Rabat spada o ponad połowę, a znika tylko oszczędność na obsłudze. Żaden cennik nie zwraca się z samej reakcji zamówień.
Jak może zmylić. Model zakłada taką samą reakcję na nowe progi (w części progu), a łączenie zamówień jest zaniżone przez różnicę w różnicach. Najważniejsze: przy rabacie od nadwyżki klient z zamówieniem na 10 000 zł dostaje 390 zł zamiast 900 zł. Część klientów może to odebrać jako podwyżkę cen i odejść. Tego histogram nie pokaże. Dolan (1987) przypomina, że rabaty ilościowe mają wiele celów, nie tylko zwiększanie zamówień.
Co z tym zrobić w firmie
- Licz rabat od wszystkich zamówień nad progiem, nie tylko od dociągniętych. 356 dociągniętych zamówień brzmi dobrze, ale rabat dostają tysiące zamówień, które i tak przekroczyłyby próg. Podobny rachunek „przyrost kontra koszt na całej bazie” robi wpis o głębokości rabatu a sprzedaży.
- Nie licz dokupionego towaru jako nowej sprzedaży. Klient zużywa tyle opakowań, ile wysyła paczek, więc rabat przesuwa zakupy w czasie. Sprawdzaj zakupy na klienta w złotych na miesiąc, nie średnią wartość zamówienia.
- Policz realną oszczędność z łączenia zamówień. Jeśli celem jest mniej małych zamówień, tańsze bywa minimum logistyczne albo opłata za małe zamówienie. Koszty dostaw w pracy z logistyki omawia wpis statystyka w pracy z logistyki.
- Rozważ rabat od nadwyżki albo wyższe progi – ale testuj. Zmień cennik najpierw dla nowych klientów albo w jednym regionie i porównaj odejścia klientów z grupą bez zmiany. Jak zaplanować losowy test ceny, opisuje wpis losowy test ceny i krzywa popytu. Reakcję cenową klientów przeliczysz też jak w elastyczności cenowej z danych sprzedażowych.
- Rozlicz rabat po zwrotach (pułapki niżej).
Wartość klienta, którego rabat ma zatrzymać, policzysz jak w CLV, a sprzedaż B2B opisuje też ocena leadów. Tematy prac o marży zbiera wpis statystyka w pracy z finansów i rachunkowości.
Jak opisać w pracy
W Dyskusji zaznacz, że analiza nie mierzy wpływu rabatu na odejścia klientów.
Kod R: skupienia przy progach, bootstrap klientów, łączenie zamówień i rachunek marży
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – funkcję bunching(), przepis 3 – próby klientów proby i funkcję ci(), przepis 5 – funkcję rabat_od(). Przepisy z rysunkami kończą się nazwą wykresu (p2–p8), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki) – dane, geometrie i skale są identyczne.
Losujące bloki mają własne ziarna: 770 (dane, przepis 1) i 7701 (300 prób bootstrapowych klientów i zamówień w przepisie 3; przepisy 4–6 używają tych samych prób i nic nie losują). Ziaren nie dobieraliśmy pod wynik. Ręcznie ustalono (przepis 1): progi i stawki, dzień zmiany (182), 700 klientów, rozkład zużycia (lognormalny, mediana 60 zł dziennie, odchylenie logarytmu 1.05), rytm zamówień (7–35 dni), szum zamówienia (odchylenie logarytmu 0.35), cenniki indywidualne (30% klientów z górnych 15% zużycia), odsetek reagujących (0.60), średnią tolerancję dokupienia (8% progu), przekroczenie progu (średnio 1.2%), szansę łączenia zamówień (0.50) i zwroty (15% dociągniętych zamówień zwraca 4–8% wartości, 4% pozostałych – 5–15%). W analizie ręcznie przyjęto przedziały 2% progu, okno 0.76T–1.10T, zakres 0.56T–1.60T, wielomian 4. stopnia, granice grup klientów (0.50T i 0.76T), marżę 24% i koszt obsługi 55 zł. Po pierwszych uruchomieniach zmieniliśmy dane i jeden błąd analizy: medianę zużycia z 55 na 60 zł i odchylenie logarytmu z 0.9 na 1.05, cenniki indywidualne z 40% klientów w górnych 20% na 30% w górnych 15% (za mało zamówień przy 10 000 zł), średnią tolerancję dokupienia z 12% na 8% progu (nadwyżka i brak się rozjeżdżały), dodaliśmy łączenie zamówień (bez niego odstępy prawie się nie zmieniały) i poprawiliśmy granice przedziałów (w pierwszej wersji próg 2000 zł nie był granicą przedziału, co zaniżało brak). Cały kod liczy się w kilkanaście sekund.
1. Dane: 25 000 zamówień i trzy progi rabatu
R
# Przepis 1. Fikcyjna hurtownia opakowań i materiałów do wysyłki: ok. 700 klientów firmowych, 24 miesiące,
# od 1 lipca pierwszego roku (dzień 182) rabat ilościowy 3% od 2000 zł, 6% od 5000 zł, 9% od 10 000 zł netto
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", blekit = "#56B4E9",
         zielony = "#009E73", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Ręcznie ustalone parametry (prawda znana tylko w symulacji)
progi    <- c(2000, 5000, 10000)   # progi rabatu (zł netto)
stawki   <- c(0.03, 0.06, 0.09)    # rabat od całego zamówienia po przekroczeniu progu
start    <- 182                    # dzień wprowadzenia rabatów (1 lipca pierwszego roku)
n_kl     <- 700                    # liczba klientów firmowych
p_reag   <- 0.60                   # odsetek klientów (bez cennika indywidualnego), którzy reagują na progi
tol_sr   <- 0.08                   # średnia tolerancja dokupienia u reagujących: ułamek progu (rozkład wykładniczy)
p_lacz   <- 0.50                   # szansa połączenia dwóch zamówień w jedno, gdy dwa razy plan przekracza próg

set.seed(770)
kl <- data.frame(klient = 1:n_kl,
                 zuzycie = rlnorm(n_kl, log(60), 1.05),      # zużycie opakowań klienta (zł netto dziennie)
                 rytm = runif(n_kl, 7, 35))                  # typowy odstęp między zamówieniami (dni)
# cennik indywidualny: częściej u dużych klientów; tacy klienci nie korzystają z progów
kl$indywidualny <- runif(n_kl) < ifelse(kl$zuzycie > quantile(kl$zuzycie, 0.85), 0.30, 0.00)
kl$reaguje <- !kl$indywidualny & runif(n_kl) < p_reag

zam <- list()
for (i in seq_len(n_kl)) {
  t <- runif(1, 0, kl$rytm[i]); w <- list()
  while (t < 730) {
    plan <- max(150, kl$zuzycie[i] * kl$rytm[i] * exp(rnorm(1, 0, 0.35)))   # zamówienie bez rabatów
    wart <- plan; doc <- FALSE; lacz <- FALSE
    if (t >= start && kl$reaguje[i] && plan < max(progi)) {
      pr <- progi[progi > plan][1]                                          # najbliższy próg powyżej planu
      if ((pr - plan) / pr <= rexp(1, 1 / tol_sr)) {                        # dokupi do progu?
        wart <- pr * (1 + rgamma(1, shape = 2, scale = 0.006)); doc <- TRUE  # przekroczenie progu średnio 1.2%
      } else if (2 * plan >= pr && runif(1) < p_lacz) {                     # czeka i łączy dwa zamówienia w jedno
        wart <- plan + max(150, kl$zuzycie[i] * kl$rytm[i] * exp(rnorm(1, 0, 0.35))); lacz <- TRUE
      }
    }
    w[[length(w) + 1]] <- c(dzien = floor(t), plan = plan, wartosc = wart, dociagniete = doc, polaczone = lacz)
    t <- t + wart / kl$zuzycie[i] * exp(rnorm(1, 0, 0.15))   # zapas starcza na tyle dni, ile kupiono
  }
  zam[[i]] <- data.frame(klient = i, do.call(rbind, w))
}
z <- do.call(rbind, zam)
z <- z[order(z$dzien, z$klient), ]
z$wartosc <- round(z$wartosc, 2); z$plan <- round(z$plan, 2); z$dociagniete <- z$dociagniete == 1; z$polaczone <- z$polaczone == 1
z$okres <- ifelse(z$dzien >= start, "z rabatem", "przed rabatem")
z$indywidualny <- kl$indywidualny[z$klient]
z$stawka <- ifelse(z$okres == "z rabatem" & !z$indywidualny,
                   c(0, stawki)[findInterval(z$wartosc, progi) + 1], NA)   # NA: przed rabatem lub cennik indywidualny
# zwroty: częściowy zwrot 4–8% wartości u 15% dociągniętych zamówień, 5–15% u 4% pozostałych
p_zw <- ifelse(z$dociagniete, 0.15, 0.04)
z$zwrot <- round(ifelse(runif(nrow(z)) < p_zw,
                        z$wartosc * ifelse(z$dociagniete, runif(nrow(z), 0.04, 0.08), runif(nrow(z), 0.05, 0.15)), 0), 2)

cat("Zamówień:", nrow(z), "| klientów:", n_kl, "| z cennikiem indywidualnym:", sum(kl$indywidualny),
    "| reagujących na progi (prawda):", sum(kl$reaguje), "\n")
cat("Przed rabatem (dni 0–181):", sum(z$okres == "przed rabatem"), "| z rabatem (dni 182–729):", sum(z$okres == "z rabatem"), "\n")
cat("Mediana zamówienia:", round(median(z$wartosc)), "zł | średnia:", round(mean(z$wartosc)), "zł\n")
s <- z[z$okres == "z rabatem" & !z$indywidualny, ]
cat("Okres z rabatem, bez cenników indywidualnych:", nrow(s), "zamówień\n")
for (k in 1:3) {
  gora <- c(progi, Inf)[k + 1]
  cat(sprintf("Próg %5d zł: zamówień w przedziale progu %4d | dociągniętych do tego progu (prawda) %3d\n",
              progi[k], sum(s$wartosc >= progi[k] & s$wartosc < gora),
              sum(s$dociagniete & s$wartosc >= progi[k] & s$wartosc < gora)))
}
cat("Połączonych zamówień (prawda):", sum(s$polaczone), "| dociągniętych razem (prawda):", sum(s$dociagniete), "\n")
write.csv(data.frame(id_zamowienia = seq_len(nrow(z)), klient = z$klient, dzien = z$dzien, okres = z$okres,
                     cennik_indywidualny = as.integer(z$indywidualny), wartosc_netto_zl = z$wartosc,
                     stawka_rabatu = z$stawka, zwrot_zl = z$zwrot,
                     dociagniete_prawda = as.integer(z$dociagniete),
                     polaczone_prawda = as.integer(z$polaczone), plan_prawda_zl = z$plan),
          "hurtownia-opakowan-zamowienia.csv", row.names = FALSE)
Wynik w R
Zamówień: 25049 | klientów: 700 | z cennikiem indywidualnym: 33 | reagujących na progi (prawda): 405
Przed rabatem (dni 0–181): 6650 | z rabatem (dni 182–729): 18399
Mediana zamówienia: 942 zł | średnia: 2014 zł
Okres z rabatem, bez cenników indywidualnych: 17319 zamówień
Próg  2000 zł: zamówień w przedziale progu 3344 | dociągniętych do tego progu (prawda) 218
Próg  5000 zł: zamówień w przedziale progu 1019 | dociągniętych do tego progu (prawda)  87
Próg 10000 zł: zamówień w przedziale progu  419 | dociągniętych do tego progu (prawda)  30
Połączonych zamówień (prawda): 1584 | dociągniętych razem (prawda): 335
2. Trzy histogramy i rozkład kontrfaktyczny: Rysunek 2
R
# Przepis 2. Trzy progi – trzy histogramy. Dla każdego progu T: przedziały o szerokości 2% progu (próg jest
# granicą przedziału), wielomian dopasowany poza oknem [0.76T, 1.10T) w zakresie [0.56T, 1.60T) i przedłużony do okna
bunching <- function(w, prog, stopien = 4, dol = -12, gora = 5, od = -22, do = 30) {
  # dol, gora, od, do: granice okna i zakresu w liczbie przedziałów 2% od progu
  brzegi <- prog * (1 + 0.02 * (od:do))
  h <- data.frame(k = od:(do - 1), lewy = head(brzegi, -1))
  h$srodek <- prog * (1 + 0.02 * (h$k + 0.5))
  h$n <- tabulate(findInterval(w[w >= min(brzegi) & w < max(brzegi)], brzegi), nbins = nrow(h))
  h$okno <- h$k >= dol & h$k < gora
  h$x <- h$srodek / prog - 1                                    # odległość od progu jako ułamek progu
  m <- lm(n ~ poly(x, stopien, raw = TRUE), data = h[!h$okno, ])
  h$kontr <- predict(m, newdata = h)
  nad <- h$okno & h$k >= 0; pod <- h$okno & h$k < 0
  list(h = h, prog = prog,
       nadwyzka = sum(h$n[nad] - h$kontr[nad]),       # zamówienia „za dużo” tuż nad progiem
       brak = sum(h$kontr[pod] - h$n[pod]))           # zamówienia „brakujące” tuż pod progiem
}

s <- z[z$okres == "z rabatem" & !z$indywidualny, ]   # 18 miesięcy z rabatem, bez cenników indywidualnych
b <- lapply(progi, function(p) bunching(s$wartosc, p))
for (k in 1:3) {
  gora <- c(progi, Inf)[k + 1]
  prawda <- sum(s$dociagniete & s$wartosc >= progi[k] & s$wartosc < gora)
  cat(sprintf("Próg %5d zł: nadwyżka %4.0f | brak %4.0f | prawda %3d | zamówień w przedziale [%d, %s) %4d | nadwyżka / te zamówienia %.1f%%\n",
              progi[k], b[[k]]$nadwyzka, b[[k]]$brak, prawda, progi[k], format(gora, big.mark = " "),
              sum(s$wartosc >= progi[k] & s$wartosc < gora),
              100 * b[[k]]$nadwyzka / sum(s$wartosc >= progi[k] & s$wartosc < gora)))
}
h1 <- b[[1]]$h
print(transform(h1[h1$lewy >= 1400 & h1$lewy < 2300, c("lewy", "n", "kontr")],
                kontr = round(kontr, 1), roznica = round(n - kontr, 1)), row.names = FALSE)

hh <- do.call(rbind, lapply(1:3, function(k) data.frame(b[[k]]$h, panel = sprintf("Próg %s zł: rabat %d%%",
                                                         format(progi[k], big.mark = " "), 100 * stawki[k]))))
hh$panel <- factor(hh$panel, levels = unique(hh$panel))
okna <- data.frame(panel = levels(hh$panel), xmin = 0.76 * progi, xmax = 1.10 * progi, prog = progi,
                   et = sprintf("nadwyżka +%.0f\nbrak −%.0f", sapply(b, `[[`, "nadwyzka"), sapply(b, `[[`, "brak")))
okna$panel <- factor(okna$panel, levels = levels(hh$panel))
p2 <- ggplot(hh, aes(srodek, n)) +
  geom_rect(data = okna, aes(xmin = xmin, xmax = xmax, ymin = -Inf, ymax = Inf), inherit.aes = FALSE,
            fill = kol[["blekit"]], alpha = 0.15) +
  geom_col(aes(fill = ifelse(okno, "w oknie progu", "poza oknem")), width = 0.0185 * rep(progi, sapply(b, function(x) nrow(x$h)))) +
  geom_line(aes(y = kontr, linetype = "rozkład kontrfaktyczny (wielomian 4. stopnia)"), colour = kol[["niebieski"]], linewidth = 1) +
  geom_vline(data = okna, aes(xintercept = prog), colour = kol[["cynober"]], linewidth = 0.9) +
  geom_text(data = okna, aes(x = prog * 1.12, y = Inf, label = et), hjust = 0, vjust = 1.3, size = 3.8, colour = "grey15") +
  facet_wrap(~ panel, ncol = 1, scales = "free") +
  scale_fill_manual(values = c("poza oknem" = kol[["szary"]], "w oknie progu" = kol[["pomaranczowy"]]), name = NULL) +
  scale_linetype_manual(values = c("rozkład kontrfaktyczny (wielomian 4. stopnia)" = "solid"), name = NULL) +
  scale_x_continuous(labels = function(x) format(x, big.mark = " ", scientific = FALSE)) +
  labs(title = "Trzy progi rabatu – trzy skupiska zamówień",
       subtitle = "18 miesięcy z rabatem, bez cenników indywidualnych; przedziały po 2% progu",
       x = "Wartość zamówienia netto (zł)", y = "Liczba zamówień w przedziale") + motyw +
  theme(strip.text = element_text(face = "bold", hjust = 0))
p2   # zapis: ggsave("progi-rabatu-histogram.svg", p2, width = 10, height = 8.4)
Wynik w R
Próg  2000 zł: nadwyżka  215 | brak  251 | prawda 218 | zamówień w przedziale [2000, 5 000) 3344 | nadwyżka / te zamówienia 6.4%
Próg  5000 zł: nadwyżka  105 | brak   37 | prawda  87 | zamówień w przedziale [5000, 10 000) 1019 | nadwyżka / te zamówienia 10.3%
Próg 10000 zł: nadwyżka   36 | brak   44 | prawda  30 | zamówień w przedziale [10000, Inf)  419 | nadwyżka / te zamówienia 8.6%
 lewy   n kontr roznica
 1400 112 120.8    -8.8
 1440 113 118.3    -5.3
 1480 108 116.2    -8.2
 1520 112 114.4    -2.4
 1560  92 112.9   -20.9
 1600  98 111.7   -13.7
 1640  98 110.7   -12.7
 1680  86 109.8   -23.8
 1720  99 109.1   -10.1
 1760  92 108.4   -16.4
 1800  88 107.7   -19.7
 1840  86 107.0   -21.0
 1880  78 106.3   -28.3
 1920  77 105.5   -28.5
 1960  51 104.6   -53.6
 2000 293 103.6   189.4
 2040 127 102.5    24.5
 2080 106 101.2     4.8
 2120 101  99.7     1.3
 2160  93  98.1    -5.1
 2200  99  96.4     2.6
 2240  85  94.4    -9.4
 2280 102  92.2     9.8
3. Bootstrap zamówień i klientów: Rysunek 3
R
# Przepis 3. Przedział dla liczby dociągniętych zamówień: bootstrap zamówień vs bootstrap klientów.
# Zamówienia tego samego klienta są do siebie podobne, więc losujemy całych klientów (z ich zamówieniami).
set.seed(7701)
B_rep <- 300
po_klientach <- split(s$wartosc, s$klient)
proby <- replicate(B_rep, sample(names(po_klientach), replace = TRUE), simplify = FALSE)   # użyjemy ich też w przepisach 4–6
nadw <- function(w) sapply(progi, function(p) bunching(w, p)$nadwyzka)
boot_zam <- t(replicate(B_rep, nadw(sample(s$wartosc, replace = TRUE))))
boot_kl  <- t(sapply(proby, function(id) nadw(unlist(po_klientach[id], use.names = FALSE))))
ci <- function(x) quantile(x, c(.025, .975))
prawda <- sapply(1:3, function(k) sum(s$dociagniete & s$wartosc >= progi[k] & s$wartosc < c(progi, Inf)[k + 1]))
wyn3 <- data.frame(prog = progi, nadwyzka = sapply(b, `[[`, "nadwyzka"), prawda = prawda,
                   zam_dol = apply(boot_zam, 2, ci)[1, ], zam_gora = apply(boot_zam, 2, ci)[2, ],
                   kl_dol = apply(boot_kl, 2, ci)[1, ], kl_gora = apply(boot_kl, 2, ci)[2, ])
wyn3$szer_kl_do_zam <- (wyn3$kl_gora - wyn3$kl_dol) / (wyn3$zam_gora - wyn3$zam_dol)
print(round(wyn3, 2), row.names = FALSE)
cat(sprintf("Klientów w próbie: %d | zamówień: %d | prób bootstrapowych: %d\n", length(po_klientach), nrow(s), B_rep))
cat(sprintf("Razem dociągniętych: %.0f, 95%% CI (klienci) [%.0f, %.0f]; prawda %d\n", sum(wyn3$nadwyzka),
            ci(rowSums(boot_kl))[1], ci(rowSums(boot_kl))[2], sum(prawda)))

d3 <- rbind(data.frame(prog = progi, metoda = "losowanie zamówień", est = wyn3$nadwyzka, dol = wyn3$zam_dol, gora = wyn3$zam_gora),
            data.frame(prog = progi, metoda = "losowanie klientów", est = wyn3$nadwyzka, dol = wyn3$kl_dol, gora = wyn3$kl_gora))
d3$prog_et <- factor(sprintf("próg %s zł", format(d3$prog, big.mark = " ")), levels = rev(sprintf("próg %s zł", format(progi, big.mark = " "))))
d3$metoda <- factor(d3$metoda, levels = c("losowanie zamówień", "losowanie klientów"))
pr3 <- data.frame(prog_et = levels(d3$prog_et), prawda = rev(prawda))
pr3$prog_et <- factor(pr3$prog_et, levels = levels(d3$prog_et))
p3 <- ggplot(d3, aes(est, prog_et, colour = metoda, shape = metoda)) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.25, orientation = "y", linewidth = 1, position = position_dodge(width = 0.5)) +
  geom_point(size = 3.2, position = position_dodge(width = 0.5)) +
  geom_point(data = pr3, aes(prawda, prog_et), inherit.aes = FALSE, shape = 4, size = 4, stroke = 1.4, colour = "grey15") +
  scale_colour_manual(values = c("losowanie zamówień" = kol[["blekit"]], "losowanie klientów" = kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c("losowanie zamówień" = 16, "losowanie klientów" = 17), name = NULL) +
  labs(title = "Ile zamówień dociągnięto do progu? 95% przedziały z bootstrapu",
       subtitle = "Punkt: nadwyżka z histogramu; krzyżyk: prawda z symulacji; 300 prób",
       x = "Liczba dociągniętych zamówień w 18 miesiącach", y = NULL) + motyw
p3   # zapis: ggsave("progi-rabatu-bootstrap.svg", p3, width = 10, height = 5.2)
Wynik w R
  prog nadwyzka prawda zam_dol zam_gora kl_dol kl_gora szer_kl_do_zam
  2000   214.88    218  146.98   282.15 141.28  289.08           1.09
  5000   104.92     87   66.06   143.79  59.88  149.98           1.16
 10000    36.00     30    9.78    62.39   3.82   75.47           1.36
Klientów w próbie: 667 | zamówień: 17319 | prób bootstrapowych: 300
Razem dociągniętych: 356, 95% CI (klienci) [262, 445]; prawda 335
4. Łączenie zamówień i różnica w różnicach: Rysunek 4
R
# Przepis 4. Czy klienci łączą zamówienia? Rzadziej, ale za więcej – przed i po wprowadzeniu rabatów.
# Grupy wg mediany zamówienia klienta PRZED rabatami: „tuż pod progiem” – w [0.76T, T) któregoś progu,
# „pół do progu” – w [0.50T, 0.76T), „pozostali” – reszta (grupa porównawcza).
zk <- z[!z$indywidualny, ]
zk <- zk[order(zk$klient, zk$dzien), ]
# dni od poprzedniego zamówienia tego klienta w tym samym okresie (odstęp przez datę zmiany pomijamy)
zk$odstep <- ave(zk$dzien, zk$klient, zk$okres, FUN = function(d) c(NA, diff(d)))
pre <- zk[zk$okres == "przed rabatem", ]
med_pre <- tapply(pre$wartosc, pre$klient, median)
gr <- sapply(med_pre, function(m) if (any(m >= 0.76 * progi & m < progi)) "tuż pod progiem"
             else if (any(m >= 0.50 * progi & m < 0.76 * progi)) "pół do progu" else "pozostali")
grupy <- c("tuż pod progiem", "pół do progu", "pozostali")
grupa <- data.frame(klient = as.integer(names(med_pre)), grupa = gr)
print(table(factor(grupa$grupa, levels = grupy)))

# podsumowanie każdego klienta osobno w obu okresach (182 dni przed, 548 dni z rabatem)
dni <- c("przed rabatem" = start, "z rabatem" = 730 - start)
pk <- lapply(split(zk, zk$klient), function(d) lapply(names(dni), function(o) {
  x <- d[d$okres == o, ]; list(n = nrow(x), zl = sum(x$wartosc), odst = x$odstep[!is.na(x$odstep)]) }))
# miary dla grupy klientów (wektor numerów; klient wylosowany dwa razy liczy się dwa razy)
miary <- function(kto) {
  m <- sapply(1:2, function(j) {
    q <- lapply(pk[as.character(kto)], `[[`, j)
    c(zamowien_30 = 30 * sum(sapply(q, `[[`, "n")) / dni[[j]] / length(kto),
      zakupy_30 = 30 * sum(sapply(q, `[[`, "zl")) / dni[[j]] / length(kto),
      sredni_odstep = mean(unlist(lapply(q, `[[`, "odst"))))
  })
  colnames(m) <- names(dni); m
}
zmiana <- function(kto) { m <- miary(kto); 100 * (m[, 2] / m[, 1] - 1) }   # zmiana z rabatem vs przed, w %
for (g in grupy) { cat("\n", g, "\n"); print(round(miary(grupa$klient[grupa$grupa == g]), 1)) }

# niepewność: te same próby klientów co w przepisie 3 (bootstrap klientów, bez nowego losowania)
zm_boot <- lapply(grupy, function(g) {
  kto <- grupa$klient[grupa$grupa == g]
  t(sapply(proby, function(id) { id <- as.integer(id); zmiana(id[id %in% kto]) }))
})
names(zm_boot) <- grupy
wyn4 <- do.call(rbind, lapply(grupy, function(g) {
  est <- zmiana(grupa$klient[grupa$grupa == g])
  data.frame(grupa = g, miara = names(est), zmiana_proc = est,
             dol = apply(zm_boot[[g]], 2, ci)[1, ], gora = apply(zm_boot[[g]], 2, ci)[2, ])
}))
print(transform(wyn4, zmiana_proc = round(zmiana_proc, 1), dol = round(dol, 1), gora = round(gora, 1)), row.names = FALSE)

# różnica w różnicach: zmiana liczby zamówień w grupie minus zmiana u „pozostałych” (punkty procentowe)
# i liczba zamówień, których hurtownia nie musiała obsłużyć w 18 miesiącach
mniej <- 0; mniej_b <- 0
for (g in grupy[1:2]) {
  did_b <- zm_boot[[g]][, "zamowien_30"] - zm_boot[["pozostali"]][, "zamowien_30"]
  did <- zmiana(grupa$klient[grupa$grupa == g])[["zamowien_30"]] - zmiana(grupa$klient[grupa$grupa == "pozostali"])[["zamowien_30"]]
  baza <- miary(grupa$klient[grupa$grupa == g])[["zamowien_30", 1]] * sum(grupa$grupa == g) * (730 - start) / 30
  mniej <- mniej - did / 100 * baza; mniej_b <- mniej_b - did_b / 100 * baza
  cat(sprintf("%s: różnica w różnicach %.1f pp, 95%% CI [%.1f, %.1f]\n", g, did, ci(did_b)[1], ci(did_b)[2]))
}
cat(sprintf("Zamówień mniej w 18 miesiącach: %.0f, 95%% CI [%.0f, %.0f]\n", mniej, ci(mniej_b)[1], ci(mniej_b)[2]))
s_doc <- s[s$dociagniete, ]
cat(sprintf("Prawda (z symulacji): połączonych %d + dokupiona wartość / plan %.0f = ok. %.0f zamówień mniej\n",
            sum(s$polaczone), sum((s_doc$wartosc - s_doc$plan) / s_doc$plan),
            sum(s$polaczone) + sum((s_doc$wartosc - s_doc$plan) / s_doc$plan)))

d4 <- wyn4
d4$miara <- factor(c(zamowien_30 = "zamówienia na 30 dni", zakupy_30 = "zakupy (zł) na 30 dni",
                     sredni_odstep = "średni odstęp (dni)")[d4$miara],
                   levels = rev(c("zamówienia na 30 dni", "średni odstęp (dni)", "zakupy (zł) na 30 dni")))
d4$grupa <- factor(d4$grupa, levels = grupy)
p4 <- ggplot(d4, aes(zmiana_proc, miara, colour = grupa, shape = grupa)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0.2, orientation = "y", linewidth = 0.9,
                position = position_dodge(width = 0.65)) +
  geom_point(size = 3, position = position_dodge(width = 0.65)) +
  scale_colour_manual(values = c("tuż pod progiem" = kol[["cynober"]], "pół do progu" = kol[["zielony"]],
                                 "pozostali" = kol[["niebieski"]]), name = "Mediana zamówienia przed rabatem:") +
  scale_shape_manual(values = c("tuż pod progiem" = 17, "pół do progu" = 15, "pozostali" = 16),
                     name = "Mediana zamówienia przed rabatem:") +
  labs(title = "Rzadziej, ale za więcej: co zmieniło się po wprowadzeniu rabatów",
       subtitle = "Zmiana w % (18 miesięcy z rabatem vs 6 miesięcy przed); 95% CI z bootstrapu klientów",
       x = "Zmiana po wprowadzeniu rabatów (%)", y = NULL) + motyw
p4   # zapis: ggsave("progi-rabatu-laczenie.svg", p4, width = 10, height = 5.6)
Wynik w R
tuż pod progiem    pół do progu       pozostali
            104             217             346

 tuż pod progiem
              przed rabatem z rabatem
zamowien_30             1.3       1.1
zakupy_30            3703.8    3645.3
sredni_odstep          22.3      27.6

 pół do progu
              przed rabatem z rabatem
zamowien_30             1.4       1.2
zakupy_30            3408.0    3410.4
sredni_odstep          21.1      24.8

 pozostali
              przed rabatem z rabatem
zamowien_30             1.8       1.7
zakupy_30            1799.8    1775.3
sredni_odstep          16.6      17.7
           grupa         miara zmiana_proc   dol  gora
 tuż pod progiem   zamowien_30       -18.0 -21.7 -14.4
 tuż pod progiem     zakupy_30        -1.6  -3.3   0.1
 tuż pod progiem sredni_odstep        23.6  18.4  30.0
    pół do progu   zamowien_30       -13.0 -16.0  -9.9
    pół do progu     zakupy_30         0.1  -1.6   1.9
    pół do progu sredni_odstep        17.5  13.2  21.6
       pozostali   zamowien_30        -5.0  -6.7  -3.3
       pozostali     zakupy_30        -1.4  -3.6   1.3
       pozostali sredni_odstep         6.6   4.9   8.5
tuż pod progiem: różnica w różnicach -13.1 pp, 95% CI [-17.3, -9.2]
pół do progu: różnica w różnicach -8.0 pp, 95% CI [-11.3, -4.8]
Zamówień mniej w 18 miesiącach: 761, 95% CI [554, 980]
Prawda (z symulacji): połączonych 1584 + dokupiona wartość / plan 46 = ok. 1630 zamówień mniej
5. Rachunek rabatu i marży: Rysunek 5
R
# Przepis 5. Koszt rabatu dla marży: ile rabatu dostały zamówienia, które i tak przekroczyłyby próg,
# a ile zmiana zachowania klientów – i co hurtownia zyskała na mniejszej liczbie zamówień
marza_proc <- 0.24        # marża brutto przed rabatem (ułamek wartości netto)
koszt_zam  <- 55          # koszt kompletacji i dostawy jednego zamówienia (zł)
rabat_od <- function(w, progi, stawki) c(0, stawki)[findInterval(w, progi) + 1] * w   # rabat od całego zamówienia
mies <- c(pre = start, post = 730 - start) / (365 / 12)                                    # 5.98 i 18.02 miesiąca

# rabat na klienta: po wprowadzeniu (rzeczywisty) i „gdyby” dostali go za zamówienia sprzed zmiany (bez zmiany zachowania)
rk <- t(sapply(split(zk, zk$klient), function(d) c(
  r1 = sum(rabat_od(d$wartosc[d$okres == "z rabatem"], progi, stawki)),
  r0 = sum(rabat_od(d$wartosc[d$okres == "przed rabatem"], progi, stawki)),
  obrot = sum(d$wartosc[d$okres == "z rabatem"]))))
rachunek <- function(id, mniej) {
  r <- rk[as.character(id), , drop = FALSE]
  R1 <- sum(r[, "r1"]) / mies[["post"]]; R0 <- sum(r[, "r0"]) / mies[["pre"]]
  c(rabat = R1, i_tak = R0, wywolany = R1 - R0, obsluga = mniej * koszt_zam / mies[["post"]],
    marza = marza_proc * sum(r[, "obrot"]) / mies[["post"]], netto = mniej * koszt_zam / mies[["post"]] - R1)
}
id_all <- rownames(rk)
wyn5 <- rachunek(id_all, mniej)
boot5 <- t(sapply(seq_along(proby), function(j) rachunek(proby[[j]], mniej_b[j])))
tab5 <- data.frame(skladnik = names(wyn5), zl_mies = round(wyn5), dol = round(apply(boot5, 2, ci)[1, ]),
                   gora = round(apply(boot5, 2, ci)[2, ]))
print(tab5, row.names = FALSE)
cat(sprintf("Rabat dla zamówień, które i tak byłyby nad progiem: %.1f%% rabatu [%.1f, %.1f]\n", 100 * wyn5[["i_tak"]] / wyn5[["rabat"]],
            100 * ci(boot5[, "i_tak"] / boot5[, "rabat"])[1], 100 * ci(boot5[, "i_tak"] / boot5[, "rabat"])[2]))
cat(sprintf("Rabat jako odsetek marży brutto: %.1f%% | wynik netto programu jako odsetek marży: %.1f%%\n",
            100 * wyn5[["rabat"]] / wyn5[["marza"]], 100 * wyn5[["netto"]] / wyn5[["marza"]]))
# prawda z symulacji: rabat, który klienci dostaliby bez zmiany zachowania (dociągnięte – za plan,
# połączone – osobno za dwa zamówienia, z których powstały)
sp <- zk[zk$okres == "z rabatem", ]
r_fakt <- rabat_od(sp$wartosc, progi, stawki)
r_bez <- ifelse(sp$dociagniete, rabat_od(sp$plan, progi, stawki),
                ifelse(sp$polaczone, rabat_od(sp$plan, progi, stawki) + rabat_od(sp$wartosc - sp$plan, progi, stawki), r_fakt))
cat(sprintf("Prawda: rabat, który i tak by przysługiwał, to %.1f%% rabatu (%.0f zł/mies.)\n",
            100 * sum(r_bez) / sum(r_fakt), sum(r_bez) / mies[["post"]]))
# „pozorny zysk”: marża z dokupionej wartości (środek ciężkości braku pod progiem → próg), gdyby była to nowa sprzedaż
dodatek <- sapply(b, function(x) { h <- x$h; pod <- h$okno & h$k < 0
  x$prog * 1.012 - weighted.mean(h$srodek[pod], pmax(h$kontr[pod] - h$n[pod], 0)) })
pozorny <- marza_proc * sum(sapply(b, `[[`, "nadwyzka") * dodatek) / mies[["post"]]
cat(sprintf("Średni dodatek przy progach: %s zł | pozorna marża z dokupień: %.0f zł/mies.\n",
            paste(round(dodatek), collapse = " / "), pozorny))

d5 <- data.frame(skladnik = c("rabat dla zamówień,\nktóre i tak byłyby\nnad progiem", "rabat wywołany\nzmianą zachowania",
                              "mniej zamówień\ndo obsłużenia", "wynik netto\nprogramu"),
                 est = c(-wyn5[["i_tak"]], -wyn5[["wywolany"]], wyn5[["obsluga"]], wyn5[["netto"]]),
                 dol = c(-apply(boot5, 2, ci)[2, "i_tak"], -apply(boot5, 2, ci)[2, "wywolany"],
                         apply(boot5, 2, ci)[1, "obsluga"], apply(boot5, 2, ci)[1, "netto"]),
                 gora = c(-apply(boot5, 2, ci)[1, "i_tak"], -apply(boot5, 2, ci)[1, "wywolany"],
                          apply(boot5, 2, ci)[2, "obsluga"], apply(boot5, 2, ci)[2, "netto"]),
                 typ = c("koszt", "koszt", "zysk", "netto"))
d5$skladnik <- factor(d5$skladnik, levels = d5$skladnik)
p5 <- ggplot(d5, aes(skladnik, est / 1000, fill = typ)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_col(width = 0.62) +
  geom_errorbar(aes(ymin = dol / 1000, ymax = gora / 1000), width = 0.18, linewidth = 0.8) +
  geom_text(aes(label = sub("-", "−", format(round(est), big.mark = " ")), vjust = ifelse(est < 0, 1.6, -0.8)),
            nudge_x = 0.22, hjust = 0, size = 3.9) +
  scale_fill_manual(values = c(koszt = kol[["cynober"]], zysk = kol[["zielony"]], netto = "grey45"), guide = "none") +
  labs(title = "Rabat ilościowy a marża: rachunek na miesiąc",
       subtitle = sprintf("Zł na miesiąc (tys.); marża brutto przed rabatem: %s zł; 95%% CI z bootstrapu klientów",
                          format(round(wyn5[["marza"]]), big.mark = " ")),
       x = NULL, y = "Tys. zł na miesiąc") + motyw
p5   # zapis: ggsave("progi-rabatu-marza.svg", p5, width = 10, height = 5.6)
Wynik w R
 skladnik zl_mies    dol   gora
    rabat   71481  58466  87039
    i_tak   58342  46363  72355
 wywolany   13139  10699  16002
  obsluga    2322   1691   2991
    marza  421800 385259 464890
    netto  -69159 -84634 -56198
Rabat dla zamówień, które i tak byłyby nad progiem: 81.6% rabatu [77.4, 85.2]
Rabat jako odsetek marży brutto: 16.9% | wynik netto programu jako odsetek marży: -16.4%
Prawda: rabat, który i tak by przysługiwał, to 81.3% rabatu (58127 zł/mies.)
Średni dodatek przy progach: 203 / 738 / 1287 zł | pozorna marża z dokupień: 2229 zł/mies.
6. Symulacja innych cenników: Rysunek 6
R
# Przepis 6. Symulacja innych progów (2500/6000/12 000 zł) i rabatu od nadwyżki (stawka tylko od części ponad próg).
# Model reakcji z danych: (a) dokupienie do progu – odsetek brakujących zamówień pod progiem maleje z luką
# do progu g (ułamek progu): p(g) = pi · exp(−g / lambda), wspólnie dla trzech progów; (b) łączenie dwóch zamówień
# w jedno, gdy dwa zamówienia przekraczają próg – szansę q dobieramy tak, by model odtwarzał liczbę
# „zaoszczędzonych” zamówień z przepisu 4. Bazą są zamówienia sprzed rabatów (bez zmiany zachowania).
reakcja <- function(bb) {
  h <- do.call(rbind, lapply(bb, function(x) transform(x$h[x$h$okno & x$h$k < 0, ], g = -x)))
  brak <- 1 - h$n / h$kontr
  f <- function(th) sum(h$kontr * (brak - plogis(th[1]) * exp(-h$g / exp(th[2])))^2)
  th <- optim(c(0, log(0.1)), f)$par
  ov <- weighted.mean(unlist(lapply(bb, function(x) { h <- x$h[x$h$okno & x$h$k >= 0, ]; h$x })),
                      unlist(lapply(bb, function(x) { h <- x$h[x$h$okno & x$h$k >= 0, ]; pmax(h$n - h$kontr, 0) })))
  c(pi = plogis(th[1]), lambda = exp(th[2]), ov = ov)
}
rabat_przyr <- function(w, progi, stawki) {        # rabat tylko od nadwyżki ponad każdy próg
  gor <- c(progi[-1], Inf)
  rowSums(sapply(seq_along(progi), function(k) stawki[k] * pmax(0, pmin(w, gor[k]) - progi[k])))
}
# oczekiwany wynik miesięczny danego cennika dla bazy zamówień v0 (zamówienia sprzed rabatów, n_mies miesięcy)
cennik <- function(v0, n_mies, pr, st, par, q, przyrostowy = FALSE) {
  if (przyrostowy) {
    return(c(rabat = sum(rabat_przyr(v0, pr, st)) / n_mies, i_tak = sum(rabat_przyr(v0, pr, st)) / n_mies, mniej = 0))
  }
  Tn <- sapply(v0, function(v) pr[pr > v][1])                       # najbliższy próg powyżej
  g <- (Tn - v0) / Tn
  pt <- ifelse(is.na(Tn), 0, par[["pi"]] * exp(-g / par[["lambda"]]))      # dokupi do progu
  pm <- ifelse(!is.na(Tn) & 2 * v0 >= Tn, (1 - pt) * q, 0)                 # trafi do połączonej pary
  vt <- ifelse(is.na(Tn), v0, Tn * (1 + par[["ov"]]))
  rab <- (1 - pt - pm) * rabat_od(v0, pr, st) + pt * rabat_od(vt, pr, st) + pm * rabat_od(2 * v0, pr, st) / 2
  c(rabat = sum(rab) / n_mies, i_tak = sum(rabat_od(v0, pr, st)) / n_mies,
    mniej = sum(pt * (vt - v0) / v0 + pm / 2) / n_mies)
}
warianty <- list("obecny cennik\n2000/5000/10 000 zł" = list(pr = progi, st = stawki, przyr = FALSE),
                 "wyższe progi\n2500/6000/12 000 zł" = list(pr = c(2500, 6000, 12000), st = stawki, przyr = FALSE),
                 "rabat od nadwyżki\n2000/5000/10 000 zł" = list(pr = progi, st = stawki, przyr = TRUE))
symuluj <- function(id, bb, mniej_obs) {
  par <- reakcja(bb)
  v0 <- unlist(lapply(split(pre$wartosc, pre$klient)[as.character(id)], identity), use.names = FALSE)
  # q: model dla obecnego cennika ma dać tyle „zaoszczędzonych” zamówień miesięcznie, ile przepis 4
  m0 <- cennik(v0, mies[["pre"]], progi, stawki, par, q = 0)[["mniej"]]
  m1 <- cennik(v0, mies[["pre"]], progi, stawki, par, q = 1)[["mniej"]]
  q <- min(1, max(0, (mniej_obs / mies[["post"]] - m0) / (m1 - m0)))
  out <- sapply(warianty, function(w) cennik(v0, mies[["pre"]], w$pr, w$st, par, q, w$przyr))
  out <- rbind(out, obsluga = out["mniej", ] * koszt_zam, netto = out["mniej", ] * koszt_zam - out["rabat", ])
  list(par = c(par, q = q), out = out)
}
sym <- symuluj(id_all, b, mniej)
print(round(sym$par, 3))
print(`colnames<-`(round(sym$out), sub("\n", " ", names(warianty))))
cat(sprintf("Sprawdzenie modelu: rabat obecnego cennika z modelu %.0f zł/mies. vs w danych %.0f zł/mies.\n",
            sym$out["rabat", 1], wyn5[["rabat"]]))
# niepewność: te same próby klientów co w przepisach 3–5 (bez nowego losowania)
boot6 <- lapply(seq_along(proby), function(j) {
  w <- unlist(po_klientach[proby[[j]]], use.names = FALSE)
  symuluj(proby[[j]], lapply(progi, function(p) bunching(w, p)), mniej_b[j])
})
par_b <- sapply(boot6, `[[`, "par")
print(round(apply(par_b, 1, ci), 3))
netto_b <- sapply(boot6, function(x) x$out["netto", ])
rabat_b <- sapply(boot6, function(x) x$out["rabat", ])
roznica_b <- netto_b - matrix(netto_b[1, ], nrow = 3, ncol = ncol(netto_b), byrow = TRUE)
wyn6 <- data.frame(wariant = names(warianty), rabat = sym$out["rabat", ], rabat_dol = apply(rabat_b, 1, ci)[1, ],
                   rabat_gora = apply(rabat_b, 1, ci)[2, ], obsluga = sym$out["obsluga", ], netto = sym$out["netto", ],
                   netto_dol = apply(netto_b, 1, ci)[1, ], netto_gora = apply(netto_b, 1, ci)[2, ],
                   vs_obecny = sym$out["netto", ] - sym$out["netto", 1],
                   vs_dol = apply(roznica_b, 1, ci)[1, ], vs_gora = apply(roznica_b, 1, ci)[2, ])
print(cbind(wariant = sub("\n", " ", wyn6$wariant), round(wyn6[, -1])), row.names = FALSE)

d6 <- rbind(data.frame(wariant = wyn6$wariant, skladnik = "rabat", est = -wyn6$rabat),
            data.frame(wariant = wyn6$wariant, skladnik = "mniej zamówień do obsłużenia", est = wyn6$obsluga))
d6$wariant <- factor(d6$wariant, levels = rev(names(warianty)))
d6$skladnik <- factor(d6$skladnik, levels = c("rabat", "mniej zamówień do obsłużenia"))
n6 <- transform(wyn6, wariant = factor(wariant, levels = rev(names(warianty))))
p6 <- ggplot(d6, aes(est / 1000, wariant)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_col(aes(fill = skladnik), width = 0.55) +
  geom_errorbar(data = n6, aes(xmin = netto_dol / 1000, xmax = netto_gora / 1000, y = wariant), inherit.aes = FALSE,
                width = 0.2, orientation = "y", linewidth = 0.8) +
  geom_point(data = n6, aes(netto / 1000, wariant, shape = "wynik netto (95% CI)"), inherit.aes = FALSE,
             size = 4, fill = "white", colour = "grey10") +
  geom_text(data = n6, aes(x = netto / 1000, y = wariant, label = sub("-", "−", format(round(netto), big.mark = " "))), inherit.aes = FALSE,
            vjust = -1.3, size = 3.8) +
  scale_fill_manual(values = c("rabat" = kol[["cynober"]], "mniej zamówień do obsłużenia" = kol[["zielony"]]), name = NULL) +
  scale_shape_manual(values = c("wynik netto (95% CI)" = 23), name = NULL) +
  labs(title = "Inne progi i rabat od nadwyżki – symulacja",
       subtitle = "Względem braku rabatów; model reakcji z danych, 300 prób bootstrapu klientów",
       x = "Tys. zł na miesiąc", y = NULL) + motyw + theme(plot.title.position = "plot")
p6   # zapis: ggsave("progi-rabatu-warianty.svg", p6, width = 10, height = 5.2)
Wynik w R
    pi lambda     ov      q
 0.387  0.106  0.015  0.183
        obecny cennik 2000/5000/10 000 zł wyższe progi 2500/6000/12 000 zł rabat od nadwyżki 2000/5000/10 000 zł
rabat                               67152                            58477                                 29824
i_tak                               58342                            50118                                 29824
mniej                                  42                               36                                     0
obsluga                              2322                             1988                                     0
netto                              -64831                           -56489                                -29824
Sprawdzenie modelu: rabat obecnego cennika z modelu 67152 zł/mies. vs w danych 71481 zł/mies.
         pi lambda    ov     q
2.5%  0.241  0.032 0.013 0.000
97.5% 0.637  0.390 0.021 0.245
                               wariant rabat rabat_dol rabat_gora obsluga  netto netto_dol netto_gora vs_obecny vs_dol
     obecny cennik 2000/5000/10 000 zł 67152     54282      82770    2322 -64831    -79646     -51320         0      0
      wyższe progi 2500/6000/12 000 zł 58477     46178      73528    1988 -56489    -70712     -43011      8342   7153
 rabat od nadwyżki 2000/5000/10 000 zł 29824     21570      39632       0 -29824    -39632     -21570     35007  28806
 vs_gora
       0
    9811
   40416
7. Pułapki: placebo, cenniki indywidualne, zwroty, wrażliwość
R
# Przepis 7. Pułapki: okres bez rabatów (placebo), cenniki indywidualne, zwroty po przekroczeniu progu,
# wybór okna i stopnia wielomianu
# (a) placebo: te same progi w 6 miesiącach przed rabatami – skupisk nie powinno być
pl <- sapply(progi, function(p) bunching(pre$wartosc, p)$nadwyzka)
cat("Placebo (przed rabatem, n =", nrow(pre), "):", sprintf("próg %d zł: %.0f", progi, pl), "\n")

# (b) klienci z cennikiem indywidualnym: czego nie widać, gdy ich nie wyłączymy
s_ind <- z[z$okres == "z rabatem", ]
for (k in 1:3) {
  b_all <- bunching(s_ind$wartosc, progi[k])
  gora <- c(progi, Inf)[k + 1]
  w_tier <- s_ind$wartosc >= progi[k] & s_ind$wartosc < gora
  w_bez <- s$wartosc >= progi[k] & s$wartosc < gora
  cat(sprintf("Próg %5d zł: nadwyżka z cennikami indywidualnymi %.0f (bez nich %.0f) = %.1f%% zamówień przedziału progu (bez nich %.1f%%) | udział cenników indywidualnych w przedziale %.1f%%\n",
              progi[k], b_all$nadwyzka, b[[k]]$nadwyzka, 100 * b_all$nadwyzka / sum(w_tier), 100 * b[[k]]$nadwyzka / sum(w_bez),
              100 * mean(s_ind$indywidualny[w_tier])))
}

# (c) zwroty: zamówienia tuż nad progiem częściej wracają, a po zwrocie spadają pod próg (rabat zostaje)
tuz_nad <- sapply(s$wartosc, function(v) any(v >= progi & v < 1.03 * progi))
netto_po <- s$wartosc - s$zwrot
spada <- findInterval(netto_po, progi) < findInterval(s$wartosc, progi)
st_po <- c(0, stawki)[findInterval(netto_po, progi) + 1]
nadplata <- ifelse(spada, s$stawka * s$wartosc - st_po * netto_po, 0)
print(data.frame(grupa = c("tuż nad progiem (do +3%)", "pozostałe"),
                 zamowien = c(sum(tuz_nad), sum(!tuz_nad)),
                 ze_zwrotem_proc = round(100 * c(mean(s$zwrot[tuz_nad] > 0), mean(s$zwrot[!tuz_nad] > 0)), 1),
                 spada_pod_prog_proc = round(100 * c(mean(spada[tuz_nad]), mean(spada[!tuz_nad])), 1)), row.names = FALSE)
cat(sprintf("Rabat za wysoki po zwrotach: %.0f zł/mies. (%d zamówień w 18 miesiącach)\n",
            sum(nadplata) / mies[["post"]], sum(spada)))

# (d) wrażliwość: stopień wielomianu 2–7, dolna granica okna 0.70/0.76/0.80T, górna 1.08/1.10/1.14T
wr <- expand.grid(stopien = 2:7, dol = c(-15, -12, -10), gora = c(4, 5, 7), k = 1:3)
wr$nadwyzka <- mapply(function(st, d, g, k) bunching(s$wartosc, progi[k], stopien = st, dol = d, gora = g)$nadwyzka,
                      wr$stopien, wr$dol, wr$gora, wr$k)
for (k in 1:3) {
  x <- wr[wr$k == k, ]
  cat(sprintf("Próg %5d zł: nadwyżka w 54 wariantach od %.0f do %.0f (stopnie 3–6: %.0f–%.0f); główny wariant %.0f; prawda %d\n",
              progi[k], min(x$nadwyzka), max(x$nadwyzka), min(x$nadwyzka[x$stopien %in% 3:6]),
              max(x$nadwyzka[x$stopien %in% 3:6]), b[[k]]$nadwyzka, prawda[k]))
}
Wynik w R
Placebo (przed rabatem, n = 6318 ): próg 2000 zł: 5 próg 5000 zł: -6 próg 10000 zł: 1
Próg  2000 zł: nadwyżka z cennikami indywidualnymi 207 (bez nich 215) = 5.3% zamówień przedziału progu (bez nich 6.4%) | udział cenników indywidualnych w przedziale 13.7%
Próg  5000 zł: nadwyżka z cennikami indywidualnymi 105 (bez nich 105) = 8.1% zamówień przedziału progu (bez nich 10.3%) | udział cenników indywidualnych w przedziale 21.0%
Próg 10000 zł: nadwyżka z cennikami indywidualnymi 44 (bez nich 36) = 7.9% zamówień przedziału progu (bez nich 8.6%) | udział cenników indywidualnych w przedziale 25.3%
                    grupa zamowien ze_zwrotem_proc spada_pod_prog_proc
 tuż nad progiem (do +3%)      576             9.9                 9.9
                pozostałe    16743             4.0                 0.1
Rabat za wysoki po zwrotach: 489 zł/mies. (82 zamówień w 18 miesiącach)
Próg  2000 zł: nadwyżka w 54 wariantach od 65 do 287 (stopnie 3–6: 114–287); główny wariant 215; prawda 218
Próg  5000 zł: nadwyżka w 54 wariantach od 2 do 175 (stopnie 3–6: 2–140); główny wariant 105; prawda 87
Próg 10000 zł: nadwyżka w 54 wariantach od 5 do 102 (stopnie 3–6: 21–102); główny wariant 36; prawda 30
8. Grafika: karta „trzy progi – trzy skupiska” (Rysunek 1)
R
# Przepis 8. Grafika: karta „trzy progi – trzy skupiska” (schemat u góry, liczby z przepisów 2–5 na kartach)
# Kształt schematu liczymy wzorem (bez losowania); oś schematu jest logarytmiczna, jak skala wartości zamówień.
x <- seq(0, 100, by = 0.5)
pozycje <- 100 * (log(progi) - log(800)) / (log(16000) - log(800))          # miejsca progów na osi schematu
gl <- 52 * exp(-x / 38)                                                       # gładki rozkład bez progów
efekt <- rowSums(sapply(pozycje, function(p) ifelse(x >= p - 7 & x < p, -0.45 * exp(-(p - x) / 3), 0) * gl +
                                             ifelse(x >= p & x < p + 2.5, 1.3 * exp(-(x - p) / 1.2), 0) * gl))
sch <- data.frame(x = x, y = gl + efekt)
# rabat na miesiąc w przedziale każdego progu (dane z okresu z rabatem)
sp <- zk[zk$okres == "z rabatem", ]
r_po <- sapply(1:3, function(k) sum(rabat_od(sp$wartosc, progi, stawki)[findInterval(sp$wartosc, progi) == k]) / mies[["post"]])
tys <- function(v) format(round(v / 100) * 100, big.mark = " ")
karty <- data.frame(ymin = c(-30, -62, -94), ymax = c(-4, -36, -68), nr = 1:3,
  tytul = sprintf("Próg %s zł – rabat %d%% od całego zamówienia", format(progi, big.mark = " "), 100 * stawki),
  tekst = sprintf("Dociągnięte: %.0f zamówień [%.0f, %.0f] w 18 mies. (prawda %d) – %.1f%% zamówień tego przedziału.\nRabat w tym przedziale: %s zł/mies.; dociągnięte zamówienie to średnio %.0f zł dodatkowych zakupów.",
                  wyn3$nadwyzka, wyn3$kl_dol, wyn3$kl_gora, prawda,
                  100 * wyn3$nadwyzka / sapply(1:3, function(k) sum(findInterval(s$wartosc, progi) == k)),
                  tys(r_po), dodatek))
p8 <- ggplot() +
  geom_area(data = sch, aes(x, y), fill = kol[["pomaranczowy"]], alpha = 0.55) +
  geom_line(data = sch, aes(x, gl), colour = kol[["niebieski"]], linewidth = 1.1) +
  annotate("segment", x = pozycje, xend = pozycje, y = 0, yend = 70, colour = kol[["cynober"]], linewidth = 0.9) +
  annotate("text", x = pozycje + 1, y = 74, hjust = 0, size = 4, fontface = "bold", colour = kol[["cynober"]],
           label = sprintf("%s zł: %d%%", format(progi, big.mark = " "), 100 * stawki)) +
  geom_point(aes(x = pozycje + 1.5, y = c(60, 45, 32)), shape = 21, size = 8, fill = "white", colour = "grey15", stroke = 1) +
  annotate("text", x = pozycje + 1.5, y = c(60, 45, 32), label = 1:3, size = 4.4, fontface = "bold") +
  annotate("text", x = 1, y = 99, hjust = 0, vjust = 1, size = 3.8, colour = "grey15", lineheight = 1.05,
           label = sprintf("niebieska linia – rozkład bez rabatów; pomarańczowe pole – z rabatami\n%.0f%% rabatu dostają zamówienia, które i tak byłyby nad progiem\nłączenie zamówień: %.0f zamówień mniej (nie tworzy skupisk)",
                           100 * wyn5[["i_tak"]] / wyn5[["rabat"]], mniej)) +
  geom_rect(data = karty, aes(xmin = 0, xmax = 100, ymin = ymin, ymax = ymax), fill = "grey97", colour = "grey70") +
  geom_point(data = karty, aes(x = 3, y = ymax - 6), shape = 21, size = 7, fill = "white", stroke = 1) +
  geom_text(data = karty, aes(x = 3, y = ymax - 6, label = nr), size = 4, fontface = "bold") +
  geom_text(data = karty, aes(x = 6, y = ymax - 6, label = tytul), hjust = 0, size = 4.3, fontface = "bold", colour = "#0f1d3a") +
  geom_text(data = karty, aes(x = 2, y = ymax - 11.5, label = tekst), hjust = 0, vjust = 1, size = 3.7,
            lineheight = 1.05, colour = "grey15") +
  coord_cartesian(xlim = c(0, 100), ylim = c(-95, 100), expand = FALSE) +
  labs(title = "Trzy progi – trzy skupiska zamówień",
       subtitle = "Schemat (oś wartości zamówienia w skali logarytmicznej) i liczby z przykładu hurtowni opakowań",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), panel.grid.minor = element_blank(), axis.text = element_blank())
p8   # zapis: ggsave("progi-rabatu-karta.svg", p8, width = 10, height = 7.6)
9. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 9. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("szary – pomarańczowy (rys. 2)" = c("grey60", "#E69F00"),
             "pomarańczowy – niebieski (rys. 1, 2)" = c("#E69F00", "#0072B2"),
             "błękitny – cynober (rys. 3)" = c("#56B4E9", "#D55E00"),
             "cynober – niebieski (rys. 4)" = c("#D55E00", "#0072B2"),
             "zielony – niebieski (rys. 4)" = c("#009E73", "#0072B2"),
             "cynober – zielony (rys. 4, 5, 6)" = c("#D55E00", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                     widzenie_typowe deuteranopia protanopia
szary – pomarańczowy (rys. 2)                   76.8         73.9       70.0
pomarańczowy – niebieski (rys. 1, 2)           120.2        121.5      109.3
błękitny – cynober (rys. 3)                    113.6        101.1       89.0
cynober – niebieski (rys. 4)                   114.6        108.3       91.9
zielony – niebieski (rys. 4)                    70.1         55.4       58.0
cynober – zielony (rys. 4, 5, 6)               102.4         53.5       37.3
czerwony – zielony (do unikania)               121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Wielomiany dopasowano funkcją lm(), krzywą reakcji funkcją optim(), a dane i próby bootstrapowe wylosowano funkcjami rlnorm(), runif(), rnorm(), rexp(), rgamma() i sample() z pakietów stats i base. Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Klienci z cennikiem indywidualnym w danych. Mają inne rabaty, a stanowią 13.7% zamówień w przedziale 2000–5000 zł i 25.3% powyżej 10 000 zł. Bez wyłączenia odsetek dociągniętych zamówień spada (przy 5000 zł z 10.3% do 8.1%).
- Zwroty po przekroczeniu progu. Zamówienia do 3% nad progiem miały zwrot w 9.9% przypadków, pozostałe – w 4.0%. Prawie każdy taki zwrot spycha zamówienie pod próg, a rabat zostaje: 82 zamówienia, 489 zł miesięcznie. Regulamin powinien przeliczać rabat po zwrocie. Model zwrotów opisuje wpis o odsetku zwrotów i jego koszcie w marży.
- Jeden wariant okna i wielomianu. W 54 wariantach (stopnie 2–7, trzy dolne i trzy górne granice okna) nadwyżka przy 2000 zł wahała się od 65 do 287, przy 5000 zł – od 2 do 175, a przy 10 000 zł – od 5 do 102. Za niski stopień nie nadąża za kształtem rozkładu, za wysoki zaczyna falować w oknie (przeuczenie). Pokaż tę analizę wrażliwości w aneksie.
- Skupienie jako cała reakcja. Łączenie zamówień nie tworzy skupiska, a odejścia klientów nie widać w żadnym histogramie. W regresji nieciągłej takie skupienie byłoby sygnałem manipulacji, a nie wynikiem.
- Tarcia. Na progi reagowało 60% klientów, a model oszacował π = 0.39. Część firm kupuje według stałego harmonogramu, więc małe skupienie nie znaczy, że rabat nikogo nie obchodzi (Kleven i Waseem, 2013).
Najczęstsze pytania
Jak sprawdzić, czy klienci dokupują towar, żeby przekroczyć próg rabatu?
Narysuj histogram wartości zamówień w wąskich przedziałach (np. 2% progu), tak by próg był granicą przedziału, i dopasuj wielomian do przedziałów poza oknem wokół progu. Nadwyżka zamówień tuż nad progiem względem tej linii to zamówienia dociągnięte. W przykładzie hurtowni przy progu 2000 zł w przedziale 2000–2040 zł było 293 zamówienia wobec 104 oczekiwanych. Dobrym testem jest okres bez rabatów – te same progi dają tam nadwyżkę bliską zera.
Ile kosztuje rabat ilościowy, jeśli większość klientów i tak przekracza próg?
Rabat płaci się od wszystkich zamówień nad progiem, a nie tylko od tych, które klient zwiększył. Część „i tak” oszacujesz, nakładając obecny cennik na zamówienia sprzed wprowadzenia rabatów. W przykładzie było to 81.6% rabatu (95% CI [77.4, 85.2]), czyli 58 342 zł z 71 481 zł miesięcznie, a wynik netto programu wyniósł −69 159 zł miesięcznie.
Dlaczego w danych B2B bootstrap powinien losować klientów, a nie zamówienia?
Zamówienia jednego klienta są zależne, bo wynikają z jego zużycia i nawyków. Losowanie pojedynczych zamówień daje za wąskie przedziały ufności. Bootstrap klastrowy losuje całych klientów z ich zamówieniami. W przykładzie przedział dla progu 10 000 zł był przy losowaniu klientów szerszy o 36%: [4, 75] zamiast [10, 62].
Jak sprawdzić, czy klienci łączą zamówienia z powodu rabatu?
Porównaj liczbę zamówień na klienta, odstępy między zamówieniami i zakupy w złotych przed i po wprowadzeniu rabatu, osobno dla klientów z typowym zamówieniem tuż pod progiem i dla grupy porównawczej. W przykładzie klienci tuż pod progiem zamawiali o 18.0% rzadziej, grupa porównawcza o 5.0%, a zakupy w złotych prawie się nie zmieniły. Łączenie zamówień nie tworzy skupiska nad progiem, więc histogram go nie pokaże.
Czy rabat od nadwyżki ponad próg jest tańszy niż rabat od całego zamówienia?
Zwykle tak, bo rabat obejmuje tylko część zamówienia ponad progiem, a dokupienie do progu przestaje się opłacać. W symulacji hurtowni rabat spadł z 67 152 do 29 824 zł miesięcznie, a wynik netto poprawił się o 35 007 zł [28 806, 40 416]. Klient z zamówieniem na 10 000 zł dostaje jednak 390 zł zamiast 900 zł, więc zmianę warto najpierw przetestować i sprawdzić odejścia klientów.
Powiązane hasła
Przeczytaj też
Próg darmowej dostawy – metoda bunching
Skupienie koszyków nad progiem, rozkład kontrfaktyczny, bootstrap i rachunek progu – na fikcyjnym sklepie z herbatami, z kodem R.
Czytaj →PoradnikGłębokość rabatu a sprzedaż
Sieć sklepów z elektroniką: krzywa odpowiedzi na rabat 10–40%, dołek po promocji, kanibalizacja, zysk zamiast przychodu i pułapka dobrych tygodni – z kodem R.
Czytaj →PoradnikOcena rekomendacji offline
Serwis z audiobookami: podział w czasie, precision@k, recall@k i NDCG, pokrycie katalogu, krzywa Lorenza i przeciek z przyszłości – z kodem R.
Czytaj →Analizujesz rabaty ilościowe albo piszesz o nich pracę?
Pomożemy policzyć skupienia przy progach z przedziałami, oszacować łączenie zamówień i koszt rabatu dla marży oraz opisać wszystko tak, żebyś umiał(a) to obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Dolan, R. J. (1987). Quantity discounts: Managerial issues and research opportunities. Marketing Science, 6(1), 1–22. https://doi.org/10.1287/mksc.6.1.1
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Field, C. A., & Welsh, A. H. (2007). Bootstrapping clustered data. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(3), 369–390. https://doi.org/10.1111/j.1467-9868.2007.00593.x
- Hendel, I., & Nevo, A. (2006). Measuring the implications of sales and consumer inventory behavior. Econometrica, 74(6), 1637–1673. https://doi.org/10.1111/j.1468-0262.2006.00721.x ● Otwarty dostęp: pełny tekst
- Kleven, H. J. (2016). Bunching. Annual Review of Economics, 8(1), 435–464. https://doi.org/10.1146/annurev-economics-080315-015234
- Kleven, H. J., & Waseem, M. (2013). Using notches to uncover optimization frictions and structural elasticities: Theory and evidence from Pakistan. The Quarterly Journal of Economics, 128(2), 669–723. https://doi.org/10.1093/qje/qjt004
Cytowania BibTeX
@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{dolan1987quantity, author={Dolan, Robert J.}, title={{Quantity discounts: Managerial issues and research opportunities}}, journal={Marketing Science}, year={1987}, volume={6}, number={1}, pages={1--22}, doi={10.1287/mksc.6.1.1}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{field2007bootstrapping, author={Field, Christopher A. and Welsh, Alan H.}, title={{Bootstrapping clustered data}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2007}, volume={69}, number={3}, pages={369--390}, doi={10.1111/j.1467-9868.2007.00593.x}}@article{hendel2006measuring, author={Hendel, Igal and Nevo, Aviv}, title={{Measuring the implications of sales and consumer inventory behavior}}, journal={Econometrica}, year={2006}, volume={74}, number={6}, pages={1637--1673}, doi={10.1111/j.1468-0262.2006.00721.x}}@article{kleven2016bunching, author={Kleven, Henrik Jacobsen}, title={{Bunching}}, journal={Annual Review of Economics}, year={2016}, volume={8}, number={1}, pages={435--464}, doi={10.1146/annurev-economics-080315-015234}}@article{kleven2013using, author={Kleven, Henrik J. and Waseem, Mazhar}, title={{Using notches to uncover optimization frictions and structural elasticities: Theory and evidence from Pakistan}}, journal={The Quarterly Journal of Economics}, year={2013}, volume={128}, number={2}, pages={669--723}, doi={10.1093/qje/qjt004}}