Przykład: serwis z audiobookami i pytanie „co polecić na start?”
Fikcyjny serwis z audiobookami w abonamencie ma 5000 tytułów (862 z nich to tomy cykli) i 30 000 słuchaczy. Mamy dziennik odsłuchów z 13 miesięcy: kto i w którym miesiącu pierwszy raz włączył tytuł – razem 295 213 odsłuchów 27 713 słuchaczy. Na ekranie startowym aplikacji jest rząd „Dla ciebie” z 10 tytułami. Pytanie zespołu: którą z trzech prostych metod tam wstawić – i jak to sprawdzić na danych historycznych, zanim ruszy eksperyment.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Tytuły należą do 8 gatunków po 5 nisz, a ich atrakcyjność ma rozkład z długim ogonem. Słuchacz ma gust skupiony na kilku niszach: 75% odsłuchów pochodzi z nich, 25% z tego, czego słuchają wszyscy. Nowość jest najsilniejsza tuż po premierze, a po tomie cyklu słuchacz z prawdopodobieństwem 0.55 włącza tom następny. Parametry ustawiliśmy ręcznie, ziarna (769 i kolejne) – raz. Dane pobierzesz jako ocena-rekomendacji-odsluchy.csv (dziennik: wiersz to słuchacz i miesiąc, kolumna tytuly – numery tytułów włączonych po raz pierwszy w tym miesiącu, rozdzielone spacją; jak rozwinąć je do jednego odsłuchu w wierszu, pokazuje komentarz w przepisie 1) i ocena-rekomendacji-tytuly.csv (katalog: numer, gatunek, nisza, miesiąc wydania – 0 i mniej to tytuły sprzed okresu danych, cykl i tom).
Podział w czasie: uczymy na miesiącach 1–12, a sprawdzamy na miesiącu 13 – tak jak działałby system wdrożony na koniec miesiąca 12. Oceniamy 14 137 słuchaczy, którzy słuchali w obu okresach; w miesiącu 13 włączyli 25 204 tytuły (średnio 1.78). Dlaczego nie losowo, pokażemy na rysunku 5; ogólnie o tym błędzie – wpis o przecieku danych i walidacji w czasie.
Rysunek 1: długi ogon i nowości, których nikt jeszcze nie słuchał
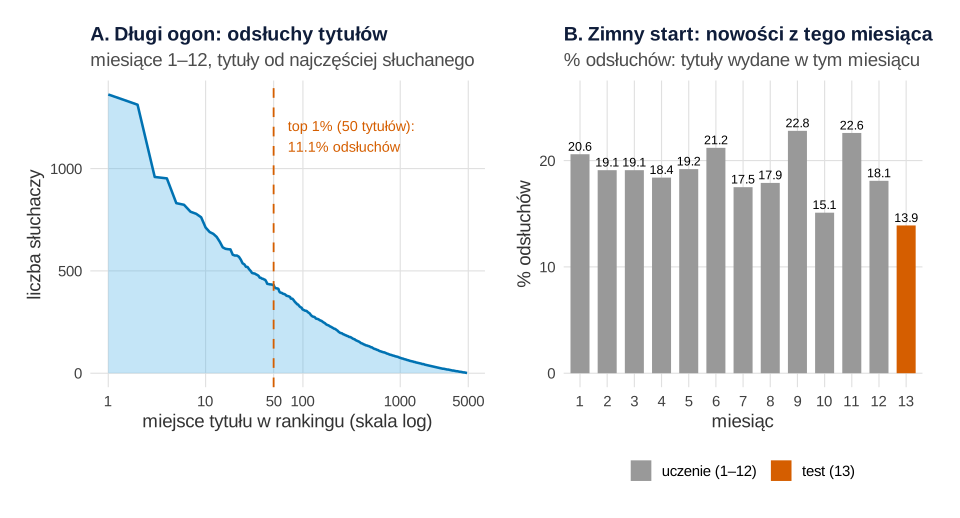
set.seed(769)).Co widać. Mediana to 26 słuchaczy na tytuł, maksimum – 1362; 50 najpopularniejszych tytułów (1%) zebrało 11.1% odsłuchów, a 142 tytuły nie miały żadnego. Co miesiąc 15–23% odsłuchów to tytuły wydane w tym samym miesiącu – w teście 13.9%.
Jak może zmylić. Te 13.9% to zimny start: tytuł wydany w miesiącu 13 nie istniał w danych uczących, więc żadna z trzech metod go nie poleci. Część trafności jest więc nieosiągalna z góry. Koncentrację opisuje krzywa Lorenza – wrócimy do niej przy rysunku 4.
Trzy proste metody
- Najpopularniejsze – 10 tytułów z największą liczbą słuchaczy w dwóch ostatnich miesiącach uczenia, z pominięciem już wysłuchanych. Wszyscy dostają prawie tę samą listę.
- „Słuchający X słuchali też Y” – podobieństwo kosinusowe dwóch tytułów: liczba wspólnych słuchaczy podzielona przez √(słuchacze X × słuchacze Y). Wynik tytułu dla słuchacza to suma jego podobieństw do tytułów z historii (Sarwar i in., 2001). Ten sam pomysł dla koszyków zakupów opisuje wpis o analizie koszykowej i rekomendacjach.
- Czynniki ukryte (SVD) – macierz słuchacz × tytuł (1 = słuchał) rozkładamy na 50 czynników, jak w PCA, i rzutujemy historię słuchacza na te czynniki. Rozkład macierzy pozwala łatwo dołożyć dane niejawne, takie jak odsłuchy, i efekty czasu (Koren i in., 2009). Tu robimy go ręcznie funkcją
svd()na macierzy zredukowanej do 1550 z 4892 tytułów, które miały co najmniej 50 słuchaczy – to one dały 62.5% odsłuchów w miesiącu 13.
Rysunek 2: k rekomendacji – co to są trafienia
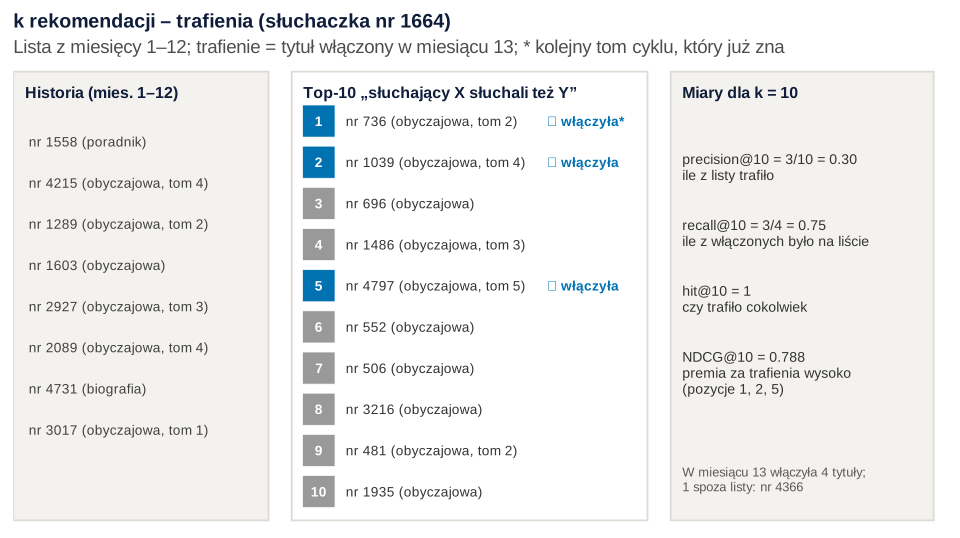
Co widać. Słuchaczka nr 1664 włączyła w miesiącu 13 cztery tytuły; trzy były na liście, na pozycjach 1, 2 i 5. Miary dla jednej listy długości k:
- precision@k – odsetek trafień na liście: 3/10 = 0.30;
- recall@k – odsetek włączonych tytułów, które były na liście: 3/4 = 0.75;
- hit@k – czy trafiło cokolwiek (0 albo 1); średnia po słuchaczach to hit rate;
- NDCG@k – trafienia wyżej na liście ważą więcej (dzielimy przez log2(pozycja + 1) i przez wynik idealnej kolejności): tu .788. Rachunek krok po kroku jest we wpisie o NDCG w wyszukiwarce sklepu.
Każdą miarę liczymy dla słuchacza i uśredniamy po słuchaczach. W zadaniu „pokaż kilka tytułów” liczy się trafność krótkiej listy, a nie błąd przewidywanej oceny (Cremonesi i in., 2010).
Jak może zmylić. Pozycja 1 to kolejny tom cyklu, którego tom 1 słuchaczka już zna – pewnie włączyłaby go i bez rekomendacji. Trafienie offline to zgodność z przyszłością, a nie zasługa listy (rysunek 5).
Podpis do pracy:
Rysunek 3: precision@k i recall@k trzech metod
Te same miary dla wszystkich 14 137 słuchaczy i list długości k = 1–20. Niepewność różnic liczymy bootstrapem słuchaczy (2000 prób): losujemy słuchaczy ze zwracaniem i porównujemy metody na tych samych osobach – to porównanie w parach.
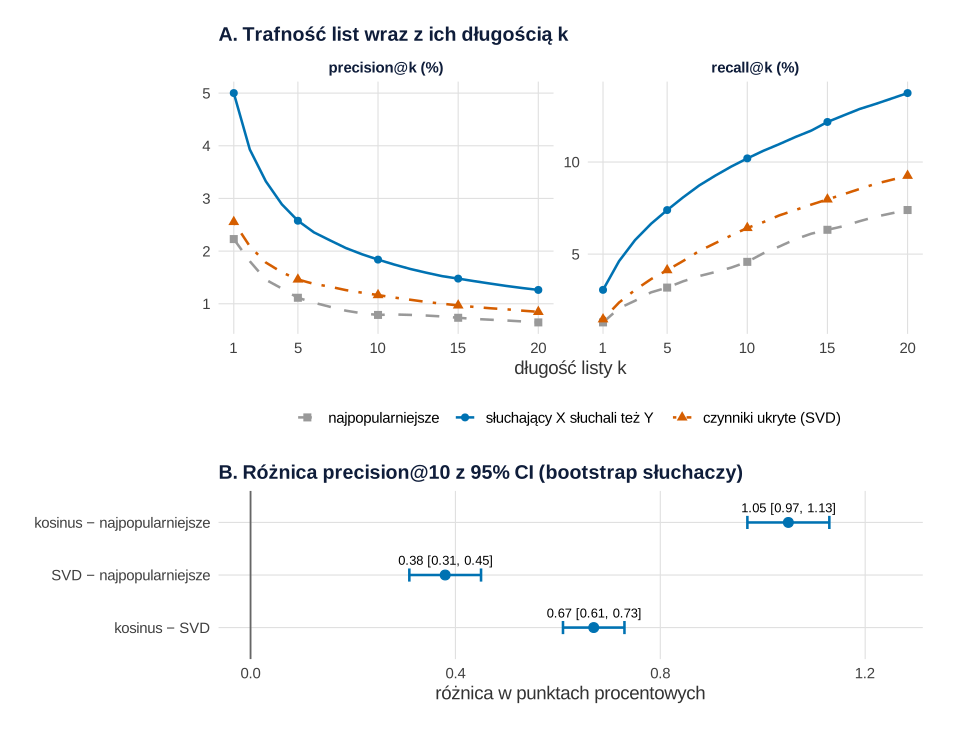
set.seed(7693)).Co widać. Przy k = 10 metoda kosinusowa ma precision@10 = 1.84%, recall@10 = 10.20%, hit rate 16.53% i NDCG@10 = .071. SVD: 1.16%, 6.42%, 10.77% i .041. Najpopularniejsze: 0.79%, 4.58%, 7.71% i .031. Losowe 10 tytułów dałoby 0.036%. Przewaga metody kosinusowej nad najpopularniejszymi to 1.05 punktu procentowego, 95% CI [0.97, 1.13], a nad SVD – 0.67 pp [0.61, 0.73].
Jak może zmylić. Precyzja na poziomie 2% wygląda słabo, ale słuchacz włącza w miesiącu średnio 1.78 tytułu – kto włączył dwa, nie może mieć precision@10 wyższej niż 20%. Porównuj metody między sobą i z losowym punktem odniesienia, przy tym samym k. Precision i recall zmieniają się z k w przeciwnych kierunkach, podobnie jak na krzywej precyzja–czułość. Wąski przedział ufności mówi tylko, że różnica nie jest przypadkiem tej próby słuchaczy – nie mówi, że lista zwiększy słuchanie.
Zdanie do Wyników:
Rysunek 4: pokrycie katalogu i skrzywienie w stronę popularnych
Trafność to nie wszystko. Herlocker i in. (2004) zalecają, by przed oceną ustalić zadanie użytkownika i oceniać także cechy rekomendacji inne niż trafność. Dwie z nich (Ge i in., 2010):
- pokrycie katalogu – odsetek dostępnych tytułów, które trafiły na co najmniej jedną listę top-10;
- skrzywienie w stronę popularnych – udział 50 najpopularniejszych tytułów (1%) w rekomendacjach, krzywa Lorenza liczby rekomendacji na tytuł i indeks Giniego.
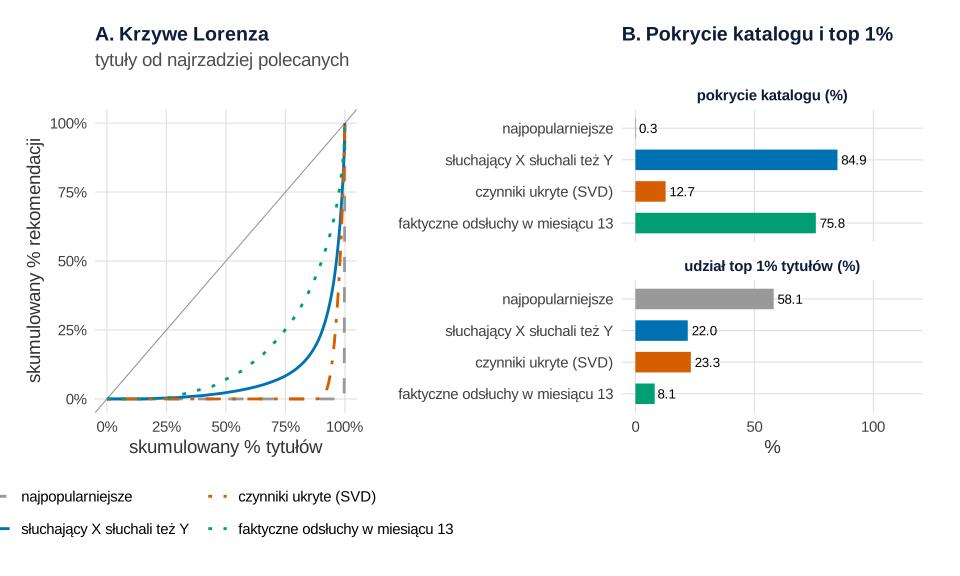
Co widać. Z 4892 dostępnych tytułów lista najpopularniejszych użyła 14 (pokrycie 0.3%), SVD – 621 (12.7%), metoda kosinusowa – 4152 (84.9%). Faktyczne odsłuchy w miesiącu 13 objęły 3707 tytułów. Popularna 1% tytułów to 8.1% faktycznych odsłuchów, ale 22.0% rekomendacji kosinusowych, 23.3% rekomendacji SVD i 58.1% list najpopularniejszych. Indeks Giniego: najpopularniejsze .998, SVD .947, kosinus .835, a faktyczne odsłuchy .671.
Jak może zmylić. Wysokie pokrycie nie oznacza trafnych propozycji: listy dla 14 137 osób to 141 370 miejsc, więc nawet przypadkowe tytuły „pokryłyby” katalog. Czytaj pokrycie razem z trafnością. Skrzywienie się wzmacnia: tytuł polecany dostaje odsłuchy, więc jutro jest jeszcze bardziej „popularny”. Symulacje Fledera i Hosanagara (2009) pokazały, że rekomendacje oparte na sprzedaży mogą zmniejszać łączną różnorodność, choć pojedynczym osobom podsuwają nowe produkty. Trafność zwykle spada w stronę długiego ogona, a użytkownicy w badaniu Stecka (2011) docenili tylko niewielkie przesunięcie ku mniej popularnym tytułom. Ta sama krzywa Lorenza opisuje koncentrację rynku.
Zdanie do Wyników:
Rysunek 5: przeciek z przyszłości i trafienia, które i tak by się zdarzyły
Zróbmy błąd celowo: do testu losujemy 26 465 odsłuchów (tyle, ile miał miesiąc 13) z wszystkich 13 miesięcy, a resztę dajemy do uczenia. Metody i miary są te same. Osobno sprawdzamy, ile trafień z podziału czasowego to kolejne tomy cykli, których poprzedni tom słuchacz już znał.
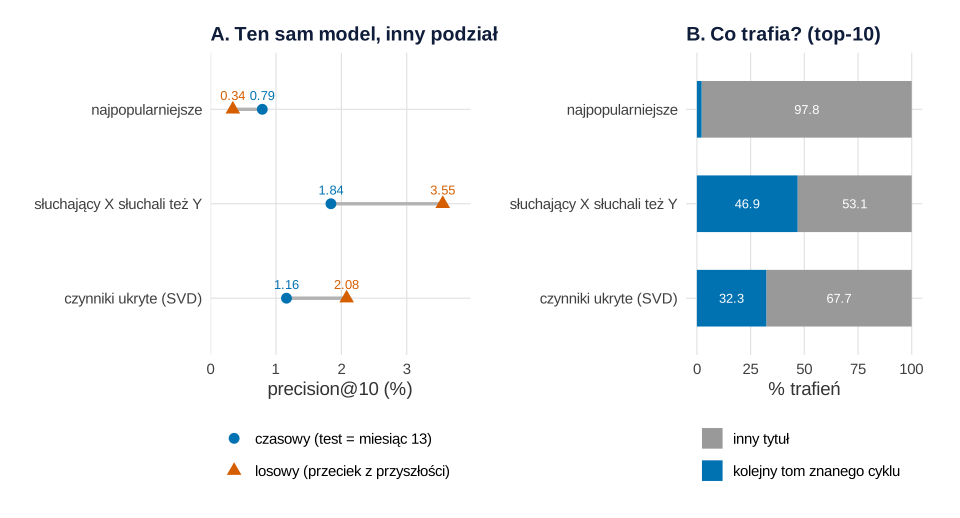
set.seed(7695)).Co widać. Losowy podział prawie podwaja wynik metod osobistych: kosinus 1.84% → 3.55% (1.93 raza), SVD 1.16% → 2.08%. Model widzi wtedy odsłuchy z tego samego i późniejszych miesięcy, więc „zna” nowości i sąsiednie tomy. Lista najpopularniejszych spada z 0.79% do 0.34%, bo popularność z dwóch ostatnich miesięcy nie pasuje do testu rozsianego po roku. Zmienia się więc nie tylko poziom, ale i przewaga metod.
Jak może zmylić. Kolejne tomy to tylko 6.4% odsłuchów miesiąca 13, ale 46.9% trafień metody kosinusowej. Bez nich jej precision@10 spada z 1.84% do 0.98%. Takie trafienia słuchacz zapewne zrobiłby sam – lista tylko je „przewidziała”.
Zdanie do Wyników:
Offline to nie online
Ocena offline odpowiada na pytanie „czy lista zgadza się z tym, co słuchacz i tak włączył?”. Firmę interesuje inne: czy lista zmienia słuchanie – czas odsłuchu, utrzymanie abonamentu. Zgodność z historią to nie przyczynowość (zob. korelacja a przyczynowość), a historia jest już skrzywiona przez wcześniejsze rekomendacje – to błąd selekcji. Jannach i Jugovac (2019) w przeglądzie testów w działających serwisach krytycznie oceniają wartość eksperymentów offline i wskazują, że realny efekt biznesowy rekomendacji trudno zmierzyć. Ostateczną oceną jest test A/B: losowa część słuchaczy widzi nową listę, reszta starą. Kogo w ogóle warto ruszać rekomendacją, pokazuje wpis o modelowaniu uplift.
Co z tym zrobić w marketingu
- Dziel dane w czasie. Uczenie do dnia wdrożenia, test po nim. Losowy podział zawyżył wynik prawie dwukrotnie.
- Raportuj kilka miar przy tym samym k. Precision@10, recall@10, hit rate, NDCG@10 – i losowy punkt odniesienia.
- Dodaj pokrycie i udział top 1%. Lista najpopularniejszych użyła 14 z 4892 tytułów – katalog, za który płacisz licencje, leży niewidoczny.
- Odfiltruj oczywistości. Kolejny tom pokaż w osobnym rzędzie „Kontynuuj cykl”, a w „Dla ciebie” oceniaj trafienia bez niego (0.98% zamiast 1.84%).
- Zaplanuj miejsce dla nowości. 13.9% odsłuchów to tytuły z bieżącego miesiąca; żadna z metod ich nie poleci – potrzebny jest osobny rząd albo cechy tytułu (gatunek, lektor).
- Wybór potwierdź testem A/B na czasie słuchania i rezygnacjach z abonamentu; przejścia między planami opisuje wpis o zmianie planu abonamentu.
Model szansy zakupu w sprzedaży B2B pokazuje wpis o sprzedaży krzyżowej modułów, a progi cenowe – wpis o progach rabatu ilościowego. Więcej z serii: statystyka w pracy z marketingu.
Jak opisać w pracy
Opisz: zadanie (lista top-k), podział w czasie, kogo oceniasz, jak traktujesz tytuły już znane, metody z parametrami, miary z k, niepewność (bootstrap użytkowników) i miary poza trafnością. Napisz wprost, że ocena offline nie mierzy wpływu rekomendacji.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, katalog tyt i dziennik ods, przepis 2 – funkcję rekomenduj() i listy rek, przepis 3 – macierze trafień H. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Pakiety recommenderlab i arules nie są potrzebne – wszystko liczy się macierzami z pakietu Matrix.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 769 w przepisie 1, 7693 w przepisie 3 (bootstrap, 2000 prób), 7695 w przepisie 5 (losowy podział); przepisy 2, 4 i 6 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: 8 gatunków × 5 nisz, 260 cykli po 2–5 tomów co 3 miesiące, 72% tytułów sprzed okresu danych, rozkład atrakcyjności (log-normalny, σ = 1.2), gust słuchaczy (Dirichlet, 0.08), tempo słuchania (średnio 0.85 tytułu miesięcznie), 70% słuchaczy od miesiąca 1, udział odsłuchów z gustu (75%), premię nowości (0.3 + 4 × e−wiek/1.5) i prawdopodobieństwo kolejnego tomu (0.55) w przepisie 1; popularność z dwóch ostatnich miesięcy, 50 czynników, próg 50 słuchaczy do SVD i listy 20 tytułów w przepisie 2; regułę wyboru słuchaczki na karcie (pierwsza z 3 trafieniami, 4 odsłuchami w teście i 5–8 tytułami w historii). Po pierwszym uruchomieniu zmieniono (parametry danych i ziarna zostały bez zmian): (1) próg do SVD z 25 na 50 słuchaczy, bo svd() macierzy 2606 × 2606 liczyła się 41 s; (2) szybszy wybór 10 najwyższych wyników w wierszu (sortowanie częściowe) zamiast pętli po słuchaczach; (3) na rysunku 1 linia z 400 punktów zamiast 4858 (pierwszy plik SVG miał 283 KB) i krótszy podtytuł; (4) na karcie oznaczono gwiazdką kolejny tom znanego cyklu – dopisane po zobaczeniu, że takie są trafienia – i skrócono nagłówek; (5) na rysunku 3 miary w procentach i różnice w punktach procentowych; (6) plik z dziennikiem zapisujemy jako jeden wiersz na słuchacza i miesiąc (zamiast jednego na odsłuch), żeby był mniejszy – wyniki się nie zmieniły; (7) analizę „kolejnych tomów” w przepisie 5 i wypisanie wielkości macierzy SVD w przepisie 2 dodano po pierwszym przeglądzie wyników; usunięto mylący wiersz o tomach z przepisu 1. Przepisy 2 i 5 liczą się po ok. 30 s, pozostałe w kilka sekund.
1. Dane: Rysunek 1
R
# Rysunek 1. Fikcyjny serwis z audiobookami w abonamencie: 5000 tytułów, 30 000 słuchaczy, 13 miesięcy odsłuchów
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie: 8 gatunków × 5 nisz, cykle (serie tomów), nowości, 30 000 słuchaczy, 13 miesięcy
set.seed(769)
gatunki <- c("kryminał", "fantastyka", "obyczajowa", "reportaż", "historia", "biografia", "poradnik", "romans")
M <- 13; U <- 30000; N_NISZ <- 40
# Cykle: 260 serii po 2–5 tomów, kolejny tom co 3 miesiące; tomy, które wyjdą po miesiącu 13, nie istnieją
cykle <- do.call(rbind, lapply(1:260, function(s) {
  L <- sample(2:5, 1); r1 <- sample(-30:10, 1)
  data.frame(cykl = s, tom = 1:L, wydanie = r1 + 3 * (0:(L - 1)), nisza = sample(N_NISZ, 1))
}))
cykle <- cykle[cykle$wydanie <= M, ]
n_poj <- 5000 - nrow(cykle)
poj <- data.frame(cykl = NA, tom = NA, nisza = sample(N_NISZ, n_poj, replace = TRUE),
                  wydanie = ifelse(runif(n_poj) < 0.72, sample(-60:0, n_poj, replace = TRUE),
                                   sample(1:M, n_poj, replace = TRUE)))
tyt <- rbind(cykle[, c("cykl", "tom", "nisza", "wydanie")], poj)
tyt <- tyt[sample(nrow(tyt)), ]; tyt$tytul <- seq_len(nrow(tyt)); rownames(tyt) <- NULL
tyt$gatunek <- gatunki[(tyt$nisza - 1) %/% 5 + 1]
tyt$atrakcyjnosc <- exp(rnorm(nrow(tyt), 0, 1.2))          # „jakość” tytułu – rozkład z długim ogonem
tyt$nastepny <- NA                                          # numer kolejnego tomu tego samego cyklu
ic <- which(!is.na(tyt$cykl))
klucz <- paste(tyt$cykl, tyt$tom)
tyt$nastepny[ic] <- match(paste(tyt$cykl[ic], tyt$tom[ic] + 1), klucz)

# Słuchacze: gust skupiony na kilku niszach (Dirichlet), tempo słuchania, miesiąc dołączenia
gust <- matrix(rgamma(U * N_NISZ, shape = 0.08), U); gust <- gust / rowSums(gust)
gust_cum <- t(apply(gust, 1, cumsum))
tempo <- rgamma(U, shape = 1.5, rate = 1.5 / 0.85)          # średnio 0.85 tytułu w miesiącu
dolacza <- ifelse(runif(U) < 0.7, 1, sample(2:M, U, replace = TRUE))

# Miesiąc po miesiącu: 75% odsłuchów z ulubionych nisz, 25% z „tego, co słuchają wszyscy”
# Waga tytułu w miesiącu m: atrakcyjność × (0.3 + 4 × e^(−wiek/1.5)) – nowości są najmocniejsze tuż po premierze
ods <- vector("list", M)
for (m in 1:M) {
  dost <- tyt$wydanie <= m
  w <- ifelse(dost, tyt$atrakcyjnosc * (0.3 + 4 * exp(-pmax(m - tyt$wydanie, 0) / 1.5)), 0)
  akt <- which(dolacza <= m); n <- rpois(length(akt), tempo[akt]); s <- rep(akt, n)
  z_gustu <- runif(length(s)) < 0.75
  nisza <- rowSums(runif(length(s)) > gust_cum[s, , drop = FALSE]) + 1
  t <- integer(length(s))
  for (k in 1:N_NISZ) { i <- which(z_gustu & nisza == k); kand <- which(tyt$nisza == k & dost)
    t[i] <- kand[sample.int(length(kand), length(i), replace = TRUE, prob = w[kand])] }
  i <- which(!z_gustu); t[i] <- sample.int(nrow(tyt), length(i), replace = TRUE, prob = w)
  ods[[m]] <- data.frame(sluchacz = s, tytul = t, miesiac = m)
}
ods <- do.call(rbind, ods)
# Cykle: po tomie k słuchacz z prawdopodobieństwem 0.55 włącza tom k + 1 (gdy wyjdzie, po 0–3 miesiącach)
nowe <- ods
for (krok in 1:4) {
  i <- which(!is.na(tyt$nastepny[nowe$tytul]) & runif(nrow(nowe)) < 0.55)
  nt <- tyt$nastepny[nowe$tytul[i]]
  mies <- pmax(nowe$miesiac[i], tyt$wydanie[nt]) + rgeom(length(i), 0.5)
  nowe <- data.frame(sluchacz = nowe$sluchacz[i], tytul = nt, miesiac = mies)[mies <= M, ]
  ods <- rbind(ods, nowe)
}
ods <- ods[order(ods$miesiac), ]
ods <- ods[!duplicated(ods[, c("sluchacz", "tytul")]), ]   # liczy się pierwszy odsłuch tytułu
ods$nowosc <- tyt$wydanie[ods$tytul] == ods$miesiac        # tytuł wydany w tym samym miesiącu
rownames(ods) <- NULL

cat("Tytuły:", nrow(tyt), "| w cyklach:", sum(!is.na(tyt$cykl)), "| wydane w miesiącach 1–13:", sum(tyt$wydanie >= 1), "\n")
cat("Słuchacze z co najmniej jednym odsłuchem:", length(unique(ods$sluchacz)), "| odsłuchy:", nrow(ods), "\n")
pop <- tabulate(ods$tytul[ods$miesiac <= 12], nrow(tyt))
cat("Udział 1% najczęściej słuchanych tytułów (50) w odsłuchach miesięcy 1–12:",
    round(100 * sum(sort(pop, decreasing = TRUE)[1:50]) / sum(pop), 1), "% | tytuły bez odsłuchu:", sum(pop == 0), "\n")
cat("Mediana odsłuchów tytułu:", median(pop), "| maksimum:", max(pop), "\n")
mies <- aggregate(cbind(odsluchy = 1, nowosc = nowosc) ~ miesiac, data = ods, FUN = sum)
mies$nowosc_proc <- round(100 * mies$nowosc / mies$odsluchy, 1)
print(mies, row.names = FALSE)

# Zapis danych (CSV w katalogu roboczym): dziennik odsłuchów (wiersz = słuchacz × miesiąc, numery tytułów
# rozdzielone spacją) i katalog tytułów
agg <- aggregate(tytul ~ sluchacz + miesiac, data = ods, FUN = function(x) paste(sort(x), collapse = " "))
names(agg)[3] <- "tytuly"
write.csv(agg[order(agg$sluchacz, agg$miesiac), ], "ocena-rekomendacji-odsluchy.csv", quote = FALSE, row.names = FALSE)
write.csv(tyt[, c("tytul", "gatunek", "nisza", "wydanie", "cykl", "tom")], "ocena-rekomendacji-tytuly.csv",
          quote = FALSE, row.names = FALSE, na = "")
# Odczyt z pliku z powrotem do postaci „jeden wiersz = jeden odsłuch”:
#   d <- read.csv("ocena-rekomendacji-odsluchy.csv"); t <- strsplit(d$tytuly, " ")
#   ods <- data.frame(sluchacz = rep(d$sluchacz, lengths(t)), tytul = as.integer(unlist(t)), miesiac = rep(d$miesiac, lengths(t)))

# Rysunek 1: (A) długi ogon popularności, (B) udział nowości w odsłuchach miesiąca
d1 <- data.frame(miejsce = seq_along(pop), odsluchy = sort(pop, decreasing = TRUE))
co <- unique(round(10^seq(0, log10(sum(pop > 0)), length.out = 400)))   # 400 punktów wystarczy do linii
pA <- ggplot(d1[co, ], aes(miejsce, odsluchy)) +
  geom_area(fill = kol[["blekit"]], alpha = 0.35) + geom_line(colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_vline(xintercept = 50, linetype = "dashed", colour = kol[["pomaranczowy"]]) +
  annotate("text", x = 70, y = max(pop) * 0.85, hjust = 0, size = 3.8, colour = kol[["pomaranczowy"]],
           label = paste0("top 1% (50 tytułów):\n", round(100 * sum(d1$odsluchy[1:50]) / sum(pop), 1), "% odsłuchów")) +
  scale_x_log10(breaks = c(1, 10, 50, 100, 1000, 5000), labels = c("1", "10", "50", "100", "1000", "5000")) +
  labs(title = "A. Długi ogon: odsłuchy tytułów", subtitle = "miesiące 1–12, tytuły od najczęściej słuchanego",
       x = "miejsce tytułu w rankingu (skala log)", y = "liczba słuchaczy") + motyw
pB <- ggplot(mies, aes(factor(miesiac), nowosc_proc)) +
  geom_col(aes(fill = miesiac == 13), width = 0.7) +
  geom_text(aes(label = sprintf("%.1f", nowosc_proc)), vjust = -0.4, size = 3.3) +
  scale_fill_manual(values = c(`FALSE` = kol[["szary"]], `TRUE` = kol[["pomaranczowy"]]),
                    labels = c("uczenie (1–12)", "test (13)"), name = NULL) +
  scale_y_continuous(limits = c(0, max(mies$nowosc_proc) * 1.15)) +
  labs(title = "B. Zimny start: nowości z tego miesiąca", subtitle = "% odsłuchów: tytuły wydane w tym miesiącu",
       x = "miesiąc", y = "% odsłuchów") + motyw
p1 <- pA + pB + plot_layout(widths = c(1.1, 1))
p1                       # do pliku: ggsave("ocena-rekomendacji-dlugi-ogon.svg", p1, width = 10, height = 5.4)
Wynik w R
Tytuły: 5000 | w cyklach: 862 | wydane w miesiącach 1–13: 1394
Słuchacze z co najmniej jednym odsłuchem: 27713 | odsłuchy: 295213
Udział 1% najczęściej słuchanych tytułów (50) w odsłuchach miesięcy 1–12: 11.1 % | tytuły bez odsłuchu: 142
Mediana odsłuchów tytułu: 26 | maksimum: 1362
 miesiac odsluchy nowosc nowosc_proc
       1    18187   3748        20.6
       2    19203   3659        19.1
       3    19839   3787        19.1
       4    20982   3863        18.4
       5    21392   4109        19.2
       6    22018   4661        21.2
       7    22751   3984        17.5
       8    23289   4168        17.9
       9    24490   5584        22.8
      10    24866   3747        15.1
      11    25289   5722        22.6
      12    26442   4784        18.1
      13    26465   3686        13.9
2. Trzy metody i karta: Rysunek 2
R
# Rysunek 2. Trzy metody rekomendacji uczone na miesiącach 1–12 i karta „k rekomendacji – trafienia” jednej słuchaczki
# (korzysta z ods, tyt, kol i motyw z przepisu 1)
library(ggplot2)
library(Matrix)

# Funkcja: z dziennika odsłuchów „uczenie” robi listy top-K dla wskazanych słuchaczy trzema metodami.
# Tytuły, które słuchacz już zna z uczenia, są pomijane.
rekomenduj <- function(uczenie, kto, K = 20, czynniki = 50, min_ods = 50) {
  nT <- nrow(tyt); nU <- max(ods$sluchacz)
  X <- sparseMatrix(i = uczenie$sluchacz, j = uczenie$tytul, x = 1, dims = c(nU, nT))
  X@x[] <- 1                                               # 1 = słuchał (bez powtórek)
  n_t <- colSums(X)
  # 1) Najpopularniejsze: liczba słuchaczy w dwóch ostatnich miesiącach uczenia (remisy: cała historia)
  ost <- max(uczenie$miesiac)
  pop <- tabulate(uczenie$tytul[uczenie$miesiac >= ost - 1], nT) + n_t / 1e6
  # 2) „Słuchający X słuchali też Y”: podobieństwo kosinusowe tytułów, wynik = suma podobieństw do historii
  C <- crossprod(X)                                        # liczba wspólnych słuchaczy par tytułów
  diag(C) <- 0
  norm <- 1 / sqrt(pmax(n_t, 1))
  S <- Diagonal(x = norm) %*% C %*% Diagonal(x = norm)
  # 3) Czynniki ukryte: SVD macierzy słuchacz × tytuł zredukowanej do tytułów z ≥ min_ods słuchaczami.
  #    Prawe wektory osobliwe X to wektory osobliwe X'X, więc svd() liczymy na małej macierzy X'X.
  zred <- which(n_t >= min_ods)
  G <- as.matrix(crossprod(X[, zred]))
  V <- svd(G, nu = 0, nv = czynniki)$v
  topK <- function(M) t(apply(M, 1, function(x) {            # K najwyższych wyników w wierszu
    prog <- -sort(-x, partial = K)[K]; i <- which(x >= prog); i[order(-x[i])][1:K] }))
  wyn <- list(popularne = NULL, kosinus = NULL, svd = NULL)
  for (b in split(seq_along(kto), ceiling(seq_along(kto) / 2000))) {
    Xb <- X[kto[b], , drop = FALSE]
    znane <- summary(Xb)[, c("i", "j")]; znane <- cbind(znane$i, znane$j)   # tytuły znane z uczenia
    P <- matrix(pop, length(b), nT, byrow = TRUE); P[znane] <- -Inf
    Sk <- as.matrix(Xb %*% S) + P / 1e9                    # bez wspólnych słuchaczy – remis rozstrzyga popularność
    Pr <- matrix(-1e9, length(b), nT); Pr[, zred] <- as.matrix(Xb[, zred] %*% V) %*% t(V); Pr[znane] <- -Inf
    wyn$popularne <- rbind(wyn$popularne, topK(P))
    wyn$kosinus <- rbind(wyn$kosinus, topK(Sk))
    wyn$svd <- rbind(wyn$svd, topK(Pr))
  }
  wyn
}

# Podział w czasie: miesiące 1–12 to uczenie, miesiąc 13 to test
ucz <- ods[ods$miesiac <= 12, ]; test <- ods[ods$miesiac == 13, ]
kto <- sort(intersect(unique(ucz$sluchacz), unique(test$sluchacz)))      # słuchacze oceniani
trafne <- split(test$tytul, factor(test$sluchacz, levels = kto))        # co naprawdę włączyli w miesiącu 13
cat("Oceniani słuchacze:", length(kto), "| ich odsłuchy w miesiącu 13:", sum(lengths(trafne)),
    "| średnio na słuchacza:", round(mean(lengths(trafne)), 2), "\n")
rek <- rekomenduj(ucz, kto)                              # ok. 20 s
n_t12 <- tabulate(ucz$tytul, nrow(tyt))
cat("Macierz do SVD: tytuły z ≥ 50 słuchaczami w miesiącach 1–12:", sum(n_t12 >= 50), "z", sum(tyt$wydanie <= 12),
    "| ich udział w odsłuchach miesiąca 13:", round(100 * mean(n_t12[test$tytul] >= 50), 1), "%\n")

# Karta: jedna słuchaczka, jej historia, lista top-10 metody kosinusowej i trafienia
opis <- function(t) paste0("nr ", t, " (", tyt$gatunek[t], ifelse(is.na(tyt$tom[t]), "", paste0(", tom ", tyt$tom[t])), ")")
traf10 <- sapply(seq_along(kto), function(j) sum(rek$kosinus[j, 1:10] %in% trafne[[j]]))
kandydatki <- which(traf10 == 3 & lengths(trafne) == 4 & sapply(kto, function(u) sum(ucz$sluchacz == u)) %in% 5:8)
j <- kandydatki[1]; u <- kto[j]
hist <- ucz$tytul[ucz$sluchacz == u]; lista <- rek$kosinus[j, 1:10]; traf <- lista %in% trafne[[j]]
dcg <- sum(traf / log2(1 + 1:10)); idcg <- sum(1 / log2(1 + 1:min(10, length(trafne[[j]]))))
cat("Słuchaczka nr", u, "| historia:", length(hist), "tytułów | w miesiącu 13 włączyła:", length(trafne[[j]]), "\n")
cat("Lista top-10 (kosinus):", paste(ifelse(traf, paste0("[", lista, "]"), lista), collapse = " "), "\n")
cat("precision@10 =", sum(traf) / 10, "| recall@10 =", round(sum(traf) / length(trafne[[j]]), 2),
    "| hit@10 =", as.integer(any(traf)), "| NDCG@10 =", round(dcg / idcg, 3), "\n")
kolejny <- lista %in% tyt$nastepny[hist]                  # kolejny tom cyklu, którego tom słuchaczka już zna
cat("Pozycje trafień:", which(traf), "| w tym kolejne tomy znanych cykli:", which(traf & kolejny),
    "| poza listą:", paste(setdiff(trafne[[j]], lista), collapse = ", "), "\n")

karta <- data.frame(poz = 1:10, y = 10:1, tekst = sapply(lista, opis), traf = traf,
                    znak = ifelse(kolejny, "✓ włączyła*", "✓ włączyła"))
hist_t <- data.frame(y = seq(9.5, by = -1, length.out = length(hist)), tekst = sapply(hist, opis))
p2 <- ggplot() +
  annotate("rect", xmin = 0, xmax = 3.3, ymin = 0.3, ymax = 11.2, fill = "#f4f2ee", colour = "#dedbd4") +
  annotate("text", x = 0.15, y = 10.7, hjust = 0, fontface = "bold", size = 4.2, colour = kol[["granat"]],
           label = "Historia (mies. 1–12)") +
  geom_text(data = hist_t, aes(0.2, y, label = tekst), hjust = 0, size = 3.6, colour = "grey25") +
  annotate("rect", xmin = 3.6, xmax = 8.2, ymin = 0.3, ymax = 11.2, fill = "white", colour = "#dedbd4") +
  annotate("text", x = 3.75, y = 10.7, hjust = 0, fontface = "bold", size = 4.2, colour = kol[["granat"]],
           label = "Top-10 „słuchający X słuchali też Y”") +
  geom_tile(data = karta, aes(3.95, y, fill = traf), width = 0.42, height = 0.78, colour = "white") +
  geom_text(data = karta, aes(3.95, y, label = poz), size = 3.6, colour = "white", fontface = "bold") +
  geom_text(data = karta, aes(4.3, y, label = tekst), hjust = 0, size = 3.6, colour = "grey20") +
  geom_text(data = karta[karta$traf, ], aes(6.9, y, label = znak), hjust = 0, size = 3.6,
            colour = kol[["niebieski"]], fontface = "bold") +
  scale_fill_manual(values = c(`FALSE` = kol[["szary"]], `TRUE` = kol[["niebieski"]]), guide = "none") +
  annotate("rect", xmin = 8.5, xmax = 11.9, ymin = 0.3, ymax = 11.2, fill = "#f4f2ee", colour = "#dedbd4") +
  annotate("text", x = 8.65, y = 10.7, hjust = 0, fontface = "bold", size = 4.2, colour = kol[["granat"]], label = "Miary dla k = 10") +
  annotate("text", x = 8.65, y = c(9.2, 7.6, 6.0, 4.4), hjust = 0, vjust = 1, size = 3.7, lineheight = 0.95, colour = "grey20",
           label = c(sprintf("precision@10 = %d/10 = %.2f\nile z listy trafiło", sum(traf), sum(traf) / 10),
                     sprintf("recall@10 = %d/%d = %.2f\nile z włączonych było na liście", sum(traf), length(trafne[[j]]), sum(traf) / length(trafne[[j]])),
                     sprintf("hit@10 = %d\nczy trafiło cokolwiek", as.integer(any(traf))),
                     sprintf("NDCG@10 = %.3f\npremia za trafienia wysoko\n(pozycje %s)", dcg / idcg, paste(which(traf), collapse = ", ")))) +
  annotate("text", x = 8.65, y = 1.3, hjust = 0, size = 3.4, colour = "grey35", lineheight = 0.95,
           label = sprintf("W miesiącu 13 włączyła %d tytuły;\n%d spoza listy: %s", length(trafne[[j]]),
                           length(setdiff(trafne[[j]], lista)), paste0("nr ", setdiff(trafne[[j]], lista), collapse = ", "))) +
  coord_cartesian(xlim = c(0, 12), ylim = c(0.2, 11.3), expand = FALSE) +
  labs(title = paste0("k rekomendacji – trafienia (słuchaczka nr ", u, ")"),
       subtitle = "Lista z miesięcy 1–12; trafienie = tytuł włączony w miesiącu 13; * kolejny tom cyklu, który już zna",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p2                       # do pliku: ggsave("ocena-rekomendacji-karta-k.svg", p2, width = 10, height = 5.6)
Wynik w R
Oceniani słuchacze: 14137 | ich odsłuchy w miesiącu 13: 25204 | średnio na słuchacza: 1.78
Macierz do SVD: tytuły z ≥ 50 słuchaczami w miesiącach 1–12: 1550 z 4892 | ich udział w odsłuchach miesiąca 13: 62.5 %
Słuchaczka nr 1664 | historia: 8 tytułów | w miesiącu 13 włączyła: 4
Lista top-10 (kosinus): [736] [1039] 696 1486 [4797] 552 506 3216 481 1935
precision@10 = 0.3 | recall@10 = 0.75 | hit@10 = 1 | NDCG@10 = 0.788
Pozycje trafień: 1 2 5 | w tym kolejne tomy znanych cykli: 1 | poza listą: 4366
3. Miary trafności i bootstrap: Rysunek 3
R
# Rysunek 3. Precision@k, recall@k, hit rate i NDCG@k trzech metod oraz bootstrap słuchaczy dla różnicy precision@10
# (korzysta z rek, trafne, kto, kol i motyw z przepisów 1–2)
library(ggplot2)
library(patchwork)

metody <- c(popularne = "najpopularniejsze", kosinus = "słuchający X słuchali też Y", svd = "czynniki ukryte (SVD)")
# Macierz trafień: wiersz = słuchacz, kolumna = pozycja na liście (1 = tytuł włączony w miesiącu 13)
trafienia <- function(lista, trafne) t(sapply(seq_len(nrow(lista)), function(j) lista[j, ] %in% trafne[[j]]))
H <- lapply(rek, trafienia, trafne = trafne)
n_traf <- lengths(trafne)
miary_k <- function(h, k) {                                 # miary dla każdego słuchacza przy liście długości k
  hk <- h[, 1:k, drop = FALSE]; tr <- rowSums(hk)
  idcg <- sapply(pmin(n_traf, k), function(n) sum(1 / log2(1 + seq_len(n))))
  data.frame(precision = tr / k, recall = tr / n_traf, hit = as.numeric(tr > 0),
             ndcg = as.vector(hk %*% (1 / log2(1 + 1:k))) / idcg)
}
wyniki <- do.call(rbind, lapply(names(metody), function(m) do.call(rbind, lapply(1:20, function(k)
  data.frame(metoda = metody[[m]], k = k, t(colMeans(miary_k(H[[m]], k))))))))
w10 <- wyniki[wyniki$k == 10, ]; w10[, 3:6] <- round(w10[, 3:6], 4)
cat("Miary przy k = 10 (średnie po", length(kto), "słuchaczach):\n"); print(w10, row.names = FALSE)
cat("Losowa lista 10 tytułów – oczekiwana precision@10:", round(mean(n_traf) / (nrow(tyt) - 1), 5), "\n")

# Niepewność: bootstrap słuchaczy (2000 prób), różnice w parach – ci sami słuchacze w obu metodach
p10 <- sapply(names(metody), function(m) miary_k(H[[m]], 10)$precision)
pary <- list(c("kosinus", "popularne"), c("svd", "popularne"), c("kosinus", "svd"))
krotko <- c(popularne = "najpopularniejsze", kosinus = "kosinus", svd = "SVD")
set.seed(7693)
B <- 2000; los <- replicate(B, sample.int(nrow(p10), replace = TRUE))
boot <- do.call(rbind, lapply(pary, function(pr) { r <- p10[, pr[1]] - p10[, pr[2]]
  bs <- apply(los, 2, function(i) mean(r[i]))
  data.frame(para = paste(krotko[[pr[1]]], "−", krotko[[pr[2]]]), roznica = mean(r),
             dolna = quantile(bs, 0.025), gorna = quantile(bs, 0.975)) }))
boot[, 2:4] <- round(boot[, 2:4], 4); rownames(boot) <- NULL
cat("Różnice precision@10 (95% przedział percentylowy, bootstrap", B, "prób słuchaczy):\n"); print(boot, row.names = FALSE)

# Rysunek 3: (A) precision@k i recall@k, (B) różnice precision@10 z 95% przedziałem
dl <- rbind(data.frame(wyniki[, c("metoda", "k")], miara = "precision@k (%)", wartosc = 100 * wyniki$precision),
            data.frame(wyniki[, c("metoda", "k")], miara = "recall@k (%)", wartosc = 100 * wyniki$recall))
dl$metoda <- factor(dl$metoda, levels = metody)
kol_m <- setNames(kol[c("szary", "niebieski", "pomaranczowy")], metody)
pA <- ggplot(dl, aes(k, wartosc, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_line(linewidth = 0.9) + geom_point(data = dl[dl$k %in% c(1, 5, 10, 15, 20), ], size = 2.4) +
  facet_wrap(~ miara, scales = "free_y") +
  scale_colour_manual(values = kol_m, name = NULL) + scale_shape_manual(values = c(15, 16, 17), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid", "dotdash"), name = NULL) +
  scale_x_continuous(breaks = c(1, 5, 10, 15, 20)) +
  labs(title = "A. Trafność list wraz z ich długością k", x = "długość listy k", y = NULL) +
  motyw + theme(legend.position = "bottom")
boot$para <- factor(boot$para, levels = rev(boot$para))
pB <- ggplot(boot, aes(100 * roznica, para)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = 100 * dolna, xmax = 100 * gorna), width = 0.25, orientation = "y", colour = kol[["niebieski"]], linewidth = 0.9) +
  geom_point(size = 3, colour = kol[["niebieski"]]) +
  geom_text(aes(label = sprintf("%.2f [%.2f, %.2f]", 100 * roznica, 100 * dolna, 100 * gorna)), vjust = -1.1, size = 3.4) +
  scale_x_continuous(limits = c(0, 1.25)) +
  labs(title = "B. Różnica precision@10 z 95% CI (bootstrap słuchaczy)", x = "różnica w punktach procentowych", y = NULL) + motyw
p3 <- pA / pB + plot_layout(heights = c(1.5, 1))
p3                       # do pliku: ggsave("ocena-rekomendacji-precision-recall.svg", p3, width = 10, height = 7.6)
Wynik w R
Miary przy k = 10 (średnie po 14137 słuchaczach):
                      metoda  k precision recall    hit   ndcg
           najpopularniejsze 10    0.0079 0.0458 0.0771 0.0313
 słuchający X słuchali też Y 10    0.0184 0.1020 0.1653 0.0713
       czynniki ukryte (SVD) 10    0.0116 0.0642 0.1077 0.0412
Losowa lista 10 tytułów – oczekiwana precision@10: 0.00036
Różnice precision@10 (95% przedział percentylowy, bootstrap 2000 prób słuchaczy):
                        para roznica  dolna  gorna
 kosinus − najpopularniejsze  0.0105 0.0097 0.0113
     SVD − najpopularniejsze  0.0038 0.0031 0.0045
               kosinus − SVD  0.0067 0.0061 0.0073
4. Pokrycie i krzywe Lorenza: Rysunek 4
R
# Rysunek 4. Pokrycie katalogu i skrzywienie w stronę popularnych: krzywe Lorenza rekomendacji
# (korzysta z rek, ucz, test, kto, tyt, metody, kol i motyw z przepisów 1–3)
library(ggplot2)
library(patchwork)
library(ineq)

dostepne <- which(tyt$wydanie <= 12)                       # tytuły, które można było polecić po miesiącu 12
pop12 <- tabulate(ucz$tytul, nrow(tyt))
top1 <- order(-pop12)[1:50]                                 # 1% najczęściej słuchanych tytułów w uczeniu
liczniki <- c(lapply(rek, function(l) tabulate(l[, 1:10], nrow(tyt))),
              list(odsluchy = tabulate(test$tytul[test$sluchacz %in% kto], nrow(tyt))))
nazwy <- c(metody, odsluchy = "faktyczne odsłuchy w miesiącu 13")
pk <- do.call(rbind, lapply(names(liczniki), function(m) { x <- liczniki[[m]][dostepne]
  data.frame(metoda = nazwy[[m]], pokrycie_proc = round(100 * mean(x > 0), 1),
             udzial_top1_proc = round(100 * sum(liczniki[[m]][top1]) / sum(liczniki[[m]]), 1),
             gini = round(ineq(x, type = "Gini"), 3), roznych_tytulow = sum(x > 0)) }))
cat("Tytuły dostępne po miesiącu 12:", length(dostepne), "| listy top-10:", length(kto), "\n")
print(pk, row.names = FALSE)
cat("Odsłuchy z miesiąca 13 w tytułach wydanych w miesiącu 13 (nie do polecenia):",
    round(100 * mean(tyt$wydanie[test$tytul[test$sluchacz %in% kto]] == 13), 1), "%\n")

# Rysunek 4: (A) krzywe Lorenza: jaki odsetek rekomendacji przypada na najmniej polecane tytuły, (B) pokrycie i top 1%
lor <- do.call(rbind, lapply(names(liczniki), function(m) { L <- Lc(liczniki[[m]][dostepne])
  i <- unique(round(seq(1, length(L$p), length.out = 300)))
  data.frame(metoda = nazwy[[m]], p = L$p[i], L = L$L[i]) }))
lor$metoda <- factor(lor$metoda, levels = nazwy)
kol_n <- setNames(c(kol[c("szary", "niebieski", "pomaranczowy")], kol[["zielony"]]), nazwy)
pA <- ggplot(lor, aes(p, L, colour = metoda, linetype = metoda)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60", linewidth = 0.4) +
  geom_line(linewidth = 1) +
  scale_colour_manual(values = kol_n, name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid", "dotdash", "dotted"), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(100 * x, "%")) + scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  labs(title = "A. Krzywe Lorenza", subtitle = "tytuły od najrzadziej polecanych",
       x = "skumulowany % tytułów", y = "skumulowany % rekomendacji") +
  guides(colour = guide_legend(ncol = 2), linetype = guide_legend(ncol = 2)) + motyw
pd <- rbind(data.frame(metoda = pk$metoda, miara = "pokrycie katalogu (%)", wartosc = pk$pokrycie_proc),
            data.frame(metoda = pk$metoda, miara = "udział top 1% tytułów (%)", wartosc = pk$udzial_top1_proc))
pd$metoda <- factor(pd$metoda, levels = rev(nazwy))
pB <- ggplot(pd, aes(wartosc, metoda, fill = metoda)) + geom_col(width = 0.65) +
  geom_text(aes(label = sprintf("%.1f", wartosc)), hjust = -0.15, size = 3.5) +
  facet_wrap(~ miara, ncol = 1) + scale_fill_manual(values = kol_n, guide = "none") +
  scale_x_continuous(limits = c(0, 115), breaks = c(0, 50, 100)) +
  labs(title = "B. Pokrycie katalogu i top 1%", x = "%", y = NULL) + motyw
p4 <- pA + pB + plot_layout(widths = c(1, 1.15)) & theme(legend.position = "bottom")
p4                       # do pliku: ggsave("ocena-rekomendacji-lorenz-pokrycie.svg", p4, width = 10, height = 6)
Wynik w R
Tytuły dostępne po miesiącu 12: 4892 | listy top-10: 14137
                           metoda pokrycie_proc udzial_top1_proc  gini
                najpopularniejsze           0.3             58.1 0.998
      słuchający X słuchali też Y          84.9             22.0 0.835
            czynniki ukryte (SVD)          12.7             23.3 0.947
 faktyczne odsłuchy w miesiącu 13          75.8              8.1 0.671
 roznych_tytulow
              14
            4152
             621
            3707
Odsłuchy z miesiąca 13 w tytułach wydanych w miesiącu 13 (nie do polecenia): 14 %
5. Losowy podział i kolejne tomy: Rysunek 5
R
# Rysunek 5. Losowy podział zamiast czasowego (przeciek z przyszłości) i trafienia, które „i tak by się zdarzyły”
# (korzysta z rekomenduj, ods, tyt, H, metody, miary_k, rek, kto, trafne, ucz, test, kol i motyw z przepisów 1–4)
library(ggplot2)
library(patchwork)

# Losowy podział: tyle samo odsłuchów co w miesiącu 13 trafia do testu, ale losowo z całych 13 miesięcy
set.seed(7695)
i_test <- sample.int(nrow(ods), nrow(test))
ucz_l <- ods[-i_test, ]; test_l <- ods[i_test, ]
kto_l <- sort(intersect(unique(ucz_l$sluchacz), unique(test_l$sluchacz)))
trafne_l <- split(test_l$tytul, factor(test_l$sluchacz, levels = kto_l))
rek_l <- rekomenduj(ucz_l, kto_l)                          # ok. 20 s
n_traf_l <- lengths(trafne_l)
p10_l <- sapply(rek_l, function(l) mean(rowSums(t(sapply(seq_len(nrow(l)), function(j) l[j, 1:10] %in% trafne_l[[j]]))) / 10))
p10_c <- sapply(H, function(h) mean(rowSums(h[, 1:10]) / 10))
porown <- data.frame(metoda = metody[names(rek)], czasowy = round(p10_c, 4), losowy = round(p10_l, 4),
                     zawyzenie_razy = round(p10_l / p10_c, 2))
cat("Oceniani słuchacze – podział losowy:", length(kto_l), "| czasowy:", length(kto), "\n")
cat("precision@10: podział czasowy (miesiąc 13) vs losowy (te same 13 miesięcy):\n"); print(porown, row.names = FALSE)

# Trafienia metody kosinusowej: ile to kolejne tomy cykli, których poprzedni tom słuchacz już znał z uczenia
znane_tomy <- unique(paste(ucz$sluchacz, tyt$nastepny[ucz$tytul]))
rodzaj <- function(lista, h) {                              # trafienia z list top-10: kolejny tom vs reszta
  j <- row(h[, 1:10])[h[, 1:10]]; t <- lista[, 1:10][h[, 1:10]]
  ifelse(paste(kto[j], t) %in% znane_tomy, "kolejny tom znanego cyklu", "inny tytuł") }
tr <- do.call(rbind, lapply(names(rek), function(m) { r <- rodzaj(rek[[m]], H[[m]])
  data.frame(metoda = metody[[m]], rodzaj = r) }))
tab <- as.data.frame(table(metoda = tr$metoda, rodzaj = tr$rodzaj))
tab$proc <- round(100 * tab$Freq / ave(tab$Freq, tab$metoda, FUN = sum), 1)
cat("Trafienia list top-10 według rodzaju:\n"); print(tab[order(tab$metoda), ], row.names = FALSE)
cat("Odsłuchy miesiąca 13 (oceniani słuchacze), które są kolejnym tomem znanego cyklu:",
    round(100 * mean(paste(test$sluchacz, test$tytul)[test$sluchacz %in% kto] %in% znane_tomy), 1), "%\n")
# Precision@10 kosinusa bez kolejnych tomów znanych cykli (gdyby ich nie liczyć jako zasługi rekomendacji)
bez <- sapply(seq_along(kto), function(j) { l <- rek$kosinus[j, 1:10]
  sum(l %in% trafne[[j]] & !(paste(kto[j], l) %in% znane_tomy)) / 10 })
cat("precision@10 kosinusa bez kolejnych tomów:", round(mean(bez), 4), "\n")

# Rysunek 5: (A) czasowy vs losowy, (B) skład trafień
dA <- rbind(data.frame(metoda = porown$metoda, podzial = "czasowy (test = miesiąc 13)", p = porown$czasowy),
            data.frame(metoda = porown$metoda, podzial = "losowy (przeciek z przyszłości)", p = porown$losowy))
dA$metoda <- factor(dA$metoda, levels = rev(metody))
pA <- ggplot(dA, aes(100 * p, metoda)) +
  geom_line(aes(group = metoda), colour = "grey70", linewidth = 1.2) +
  geom_point(aes(colour = podzial, shape = podzial), size = 3.4) +
  geom_text(aes(label = sprintf("%.2f", 100 * p), colour = podzial), vjust = -1, size = 3.4, show.legend = FALSE) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_continuous(limits = c(0, NA), expand = expansion(mult = c(0, 0.12))) +
  labs(title = "A. Ten sam model, inny podział", x = "precision@10 (%)", y = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) + motyw
tab$metoda <- factor(tab$metoda, levels = rev(metody))
pB <- ggplot(tab, aes(proc, metoda, fill = rodzaj)) + geom_col(width = 0.6) +
  geom_text(aes(label = ifelse(proc >= 8, sprintf("%.1f", proc), "")), position = position_stack(vjust = 0.5),
            size = 3.4, colour = "white") +
  scale_fill_manual(values = c(`inny tytuł` = kol[["szary"]], `kolejny tom znanego cyklu` = kol[["niebieski"]]), name = NULL) +
  labs(title = "B. Co trafia? (top-10)", x = "% trafień", y = NULL) +
  guides(fill = guide_legend(ncol = 1)) + motyw
p5 <- pA + pB + plot_layout(widths = c(1.1, 1))
p5                       # do pliku: ggsave("ocena-rekomendacji-przeciek.svg", p5, width = 10, height = 5.4)
Wynik w R
Oceniani słuchacze – podział losowy: 14234 | czasowy: 14137
precision@10: podział czasowy (miesiąc 13) vs losowy (te same 13 miesięcy):
                      metoda czasowy losowy zawyzenie_razy
           najpopularniejsze  0.0079 0.0034           0.43
 słuchający X słuchali też Y  0.0184 0.0355           1.93
       czynniki ukryte (SVD)  0.0116 0.0208           1.79
Trafienia list top-10 według rodzaju:
                      metoda                    rodzaj Freq proc
       czynniki ukryte (SVD)                inny tytuł 1114 67.7
       czynniki ukryte (SVD) kolejny tom znanego cyklu  532 32.3
           najpopularniejsze                inny tytuł 1089 97.8
           najpopularniejsze kolejny tom znanego cyklu   24  2.2
 słuchający X słuchali też Y                inny tytuł 1379 53.1
 słuchający X słuchali też Y kolejny tom znanego cyklu 1219 46.9
Odsłuchy miesiąca 13 (oceniani słuchacze), które są kolejnym tomem znanego cyklu: 6.4 %
precision@10 kosinusa bez kolejnych tomów: 0.0098
6. Sprawdzenie palety pod kątem zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("szary – niebieski" = c("#999999", "#0072B2"), "szary – pomarańczowy" = c("#999999", "#D55E00"),
             "niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "niebieski – zielony" = c("#0072B2", "#009E73"),
             "pomarańczowy – zielony" = c("#D55E00", "#009E73"), "szary – zielony" = c("#999999", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
szary – niebieski                           44.9         48.9       40.6
szary – pomarańczowy                        77.2         62.9       56.0
niebieski – pomarańczowy                   114.6        108.3       91.9
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
szary – zielony                             47.8         11.8       19.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, rozkład SVD (svd()) i bootstrap obliczono funkcjami pakietów base i stats (z podstawowej instalacji R), macierze rzadkie – pakietem Matrix, krzywe Lorenza i indeks Giniego – pakietem ineq. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- Matrix (wersja 1.7.4): Bates, D., Maechler, M., & Jagan, M. (2025). Matrix: Sparse and dense matrix classes and methods [R package]. https://doi.org/10.32614/CRAN.package.Matrix
- ineq (wersja 0.2.13): Zeileis, A. (2014). ineq: Measuring inequality, concentration, and poverty [R package]. https://doi.org/10.32614/CRAN.package.ineq
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Losowy podział zamiast czasowego – przeciek z przyszłości zawyża metody osobiste i zmienia ranking metod (rysunek 5).
- Precision@k bez punktu odniesienia – 1.84% to ok. 50 razy więcej niż lista losowa (rysunek 3).
- Różne k w porównaniu – precision maleje, recall rośnie z długością listy.
- Sama trafność – najtrafniejsza z prostych list może polecać ciągle te same tytuły (rysunek 4).
- Trafienia oczywiste – kolejne tomy cykli to prawie połowa trafień metody kosinusowej.
- Zimny start – nowości z miesiąca testu są poza zasięgiem metod uczonych na historii (rysunek 1).
- Dobór parametrów na zbiorze testowym – liczbę czynników czy próg SVD wybieraj na osobnym miesiącu walidacyjnym, inaczej grozi przeuczenie.
Najczęstsze pytania
Co to jest precision@k w systemach rekomendacyjnych?
To odsetek trafień na liście k rekomendacji: ile z k pokazanych tytułów użytkownik naprawdę wybrał w okresie testowym. Liczysz go dla każdego użytkownika i uśredniasz. Gdy lista ma 10 pozycji, a słuchacz włączył 3 z nich, precision@10 = 0.30. Obok podawaj recall@k, czyli jaki odsetek wybranych tytułów był na liście.
Dlaczego dane do oceny rekomendacji dzieli się w czasie, a nie losowo?
Bo system po wdrożeniu zna tylko przeszłość. Losowy podział wpuszcza do uczenia odsłuchy z tego samego i późniejszych okresów, więc model „zna” nowości i kolejne tomy. W przykładzie losowy podział podniósł precision@10 metody kosinusowej z 1.84% do 3.55%, a listę najpopularniejszych obniżył z 0.79% do 0.34% – zmienił więc i poziom, i ranking metod.
Co to jest pokrycie katalogu w rekomendacjach?
To odsetek dostępnych produktów, które trafiły na co najmniej jedną listę rekomendacji. Lista najpopularniejszych może mieć dobrą trafność i pokrycie bliskie zera – w przykładzie 14 z 4892 tytułów (0.3%). Pokrycie czytaj razem z trafnością i udziałem najpopularniejszych tytułów w rekomendacjach.
Jak zmierzyć skrzywienie rekomendacji w stronę popularnych produktów?
Policz udział np. 1% najpopularniejszych produktów w rekomendacjach i porównaj z ich udziałem w faktycznych wyborach, a rozkład liczby rekomendacji na produkt pokaż krzywą Lorenza z indeksem Giniego. W przykładzie 1% tytułów to 8.1% odsłuchów, ale 22.0% rekomendacji metody kosinusowej; indeks Giniego wynosił .835 wobec .671 w odsłuchach.
Czy dobra ocena offline wystarczy, żeby wdrożyć nowy algorytm rekomendacji?
Nie. Ocena offline mierzy zgodność listy z tym, co użytkownik i tak wybrał, a nie wpływ listy na jego zachowanie. W przykładzie 46.9% trafień metody kosinusowej to kolejne tomy cykli znanych słuchaczowi. O wdrożeniu rozstrzyga test A/B na mierze biznesowej, np. czasie słuchania lub utrzymaniu abonamentu.
Powiązane hasła
Przeczytaj też
Analiza koszykowa i rekomendacje
Wsparcie, ufność i lift na przykładzie sklepu z kawą, sieć reguł, test na nowych paragonach i rekomendacje „klienci kupili też” z kodem R.
Czytaj →PoradnikWyszukiwarka w sklepie – NDCG i przeplatanie
Sklep z narzędziami: precyzja@5, MRR i NDCG krok po kroku, obciążenie pozycji, test A/B vs przeplatanie team-draft i zapytania rzadkie – kod R.
Czytaj →PoradnikPrzeciek danych i walidacja w czasie
Sieć siłowni i rezygnacje z karnetu: zmienne z przyszłości, losowy podział, wybór zmiennych na szumie i okno przesuwane – pięć rysunków z kodem R.
Czytaj →Piszesz pracę o systemach rekomendacyjnych albo oceniasz algorytm w firmie?
Pomożemy zaplanować podział danych w czasie, dobrać miary trafności i pokrycia, policzyć niepewność i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cremonesi, P., Koren, Y., & Turrin, R. (2010). Performance of recommender algorithms on top-N recommendation tasks. In Proceedings of the Fourth ACM Conference on Recommender Systems (pp. 39–46). ACM. https://doi.org/10.1145/1864708.1864721
- Fleder, D., & Hosanagar, K. (2009). Blockbuster culture's next rise or fall: The impact of recommender systems on sales diversity. Management Science, 55(5), 697–712. https://doi.org/10.1287/mnsc.1080.0974 ● Otwarty dostęp: pełny tekst
- Ge, M., Delgado-Battenfeld, C., & Jannach, D. (2010). Beyond accuracy: Evaluating recommender systems by coverage and serendipity. In Proceedings of the Fourth ACM Conference on Recommender Systems (pp. 257–260). ACM. https://doi.org/10.1145/1864708.1864761
- Herlocker, J. L., Konstan, J. A., Terveen, L. G., & Riedl, J. T. (2004). Evaluating collaborative filtering recommender systems. ACM Transactions on Information Systems, 22(1), 5–53. https://doi.org/10.1145/963770.963772
- Jannach, D., & Jugovac, M. (2019). Measuring the business value of recommender systems. ACM Transactions on Management Information Systems, 10(4), 1–23. https://doi.org/10.1145/3370082 ● Otwarty dostęp: pełny tekst
- Koren, Y., Bell, R., & Volinsky, C. (2009). Matrix factorization techniques for recommender systems. Computer, 42(8), 30–37. https://doi.org/10.1109/mc.2009.263
- Sarwar, B., Karypis, G., Konstan, J., & Riedl, J. (2001). Item-based collaborative filtering recommendation algorithms. In Proceedings of the 10th International Conference on World Wide Web (pp. 285–295). ACM. https://doi.org/10.1145/371920.372071
- Steck, H. (2011). Item popularity and recommendation accuracy. In Proceedings of the Fifth ACM Conference on Recommender Systems (pp. 125–132). ACM. https://doi.org/10.1145/2043932.2043957
Cytowania BibTeX
@inproceedings{cremonesi2010performance, author={Cremonesi, Paolo and Koren, Yehuda and Turrin, Roberto}, title={{Performance of recommender algorithms on top-N recommendation tasks}}, booktitle={Proceedings of the Fourth ACM Conference on Recommender Systems}, year={2010}, pages={39--46}, publisher={ACM}, doi={10.1145/1864708.1864721}}@article{fleder2009blockbuster, author={Fleder, Daniel and Hosanagar, Kartik}, title={{Blockbuster culture's next rise or fall: The impact of recommender systems on sales diversity}}, journal={Management Science}, year={2009}, volume={55}, number={5}, pages={697--712}, doi={10.1287/mnsc.1080.0974}}@inproceedings{ge2010beyond, author={Ge, Mouzhi and Delgado-Battenfeld, Carla and Jannach, Dietmar}, title={{Beyond accuracy: Evaluating recommender systems by coverage and serendipity}}, booktitle={Proceedings of the Fourth ACM Conference on Recommender Systems}, year={2010}, pages={257--260}, publisher={ACM}, doi={10.1145/1864708.1864761}}@article{herlocker2004evaluating, author={Herlocker, Jonathan L. and Konstan, Joseph A. and Terveen, Loren G. and Riedl, John T.}, title={{Evaluating collaborative filtering recommender systems}}, journal={ACM Transactions on Information Systems}, year={2004}, volume={22}, number={1}, pages={5--53}, doi={10.1145/963770.963772}}@article{jannach2019measuring, author={Jannach, Dietmar and Jugovac, Michael}, title={{Measuring the business value of recommender systems}}, journal={ACM Transactions on Management Information Systems}, year={2019}, volume={10}, number={4}, pages={1--23}, doi={10.1145/3370082}}@article{koren2009matrix, author={Koren, Yehuda and Bell, Robert and Volinsky, Chris}, title={{Matrix factorization techniques for recommender systems}}, journal={Computer}, year={2009}, volume={42}, number={8}, pages={30--37}, doi={10.1109/mc.2009.263}}@inproceedings{sarwar2001item, author={Sarwar, Badrul and Karypis, George and Konstan, Joseph and Riedl, John}, title={{Item-based collaborative filtering recommendation algorithms}}, booktitle={Proceedings of the 10th International Conference on World Wide Web}, year={2001}, pages={285--295}, publisher={ACM}, doi={10.1145/371920.372071}}@inproceedings{steck2011item, author={Steck, Harald}, title={{Item popularity and recommendation accuracy}}, booktitle={Proceedings of the Fifth ACM Conference on Recommender Systems}, year={2011}, pages={125--132}, publisher={ACM}, doi={10.1145/2043932.2043957}}