Przykład: program księgowy z czterema modułami dodatkowymi
Fikcyjny producent sprzedaje małym firmom program księgowy w abonamencie. Każdy klient ma moduł bazowy (faktury, księga, deklaracje), a może dokupić cztery moduły dodatkowe: kadry i płace, magazyn, sklep internetowy (pobieranie zamówień ze sklepu) i raporty. Dział marketingu ma dane 6000 klientów z trzech lat (36 miesięcy) i pyta: w jakiej kolejności klienci dokupują moduły, komu i który moduł zaproponować w tym miesiącu.
Klienci to małe firmy (mediana 3 pracowników; 39.9% usługi, 34.7% handel, 13.3% budownictwo, 12.1% produkcja). Wiemy, jak używają modułu bazowego: ile wystawiają faktur i jaka ich część ma pozycje magazynowe albo dotyczy zamówień internetowych.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Miesięczną szansę zakupu ustawiliśmy ręcznie: kadry kupują częściej większe firmy oraz produkcja i budownictwo, magazyn – firmy z wieloma fakturami z pozycjami magazynowymi, sklep – firmy sprzedające przez internet, a zwłaszcza te, które mają już magazyn, raporty – klienci z wieloma modułami i fakturami. Do tego nieobserwowane „zaangażowanie” klienta. 7.3% klientów (437) kupiło pakiet od razu – co najmniej dwa moduły w pierwszym miesiącu. 75.2% kupujących wypróbowało moduł przed zakupem w 30-dniowej wersji próbnej. Ziarno 767 ustaliliśmy raz. Dane pobierzesz jako sprzedaz-krzyzowa-moduly-ksiegowosc.csv.
Nie chodzi o to, co trafia razem do koszyka (analiza koszykowa), tylko o kolejność w czasie.
Rysunek 1: ścieżki dokupowania modułów
Najpierw opis. Zakupy 2033 klientów ze startem w miesiącach 1–12 (bez pakietu od razu; każdy ma 24 miesiące obserwacji) układamy w ścieżki: pierwszy moduł dodatkowy, drugi, kolejne. Rysunek to diagram przepływów (Sankeya).
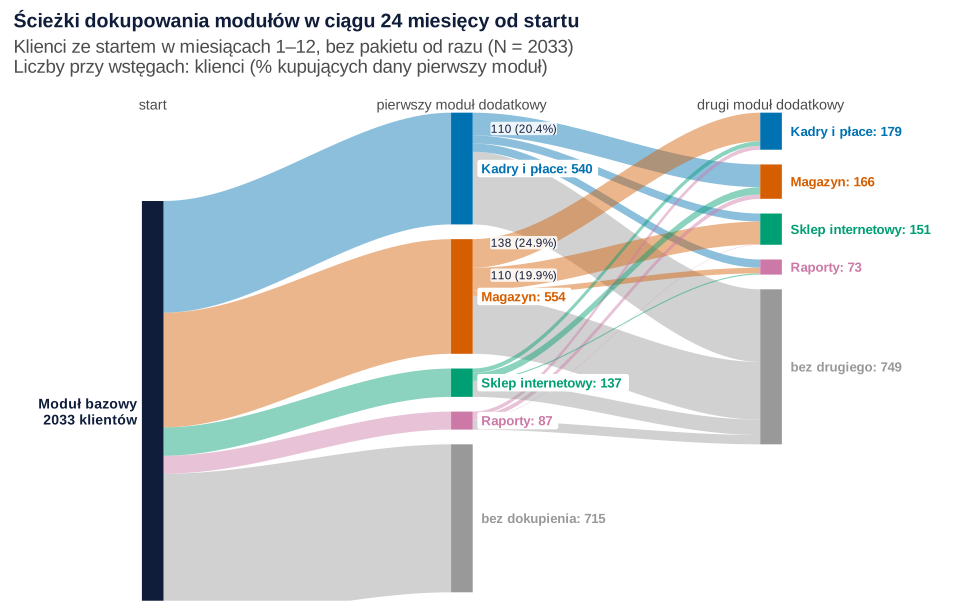
set.seed(767)).Co widać. 35.2% klientów nie dokupiło w dwa lata niczego. Pierwszym modułem są prawie zawsze kadry (540) albo magazyn (554); sklep (137) i raporty (87) rzadko otwierają ścieżkę. Najczęstsze ścieżki to „tylko kadry” (17.3% kohorty), „tylko magazyn” (13.7%), „magazyn → kadry” (5.1%) i „magazyn → sklep” (4.0%). Po magazynie co piąty klient (19.9%) dokupił sklep, po kadrach – tylko 7.2%.
Jak może zmylić. Szerokość wstęgi to liczba klientów, a nie siła związku: kadry kupuje się często niezależnie od kolejności. 34 klientów kupiło dwa moduły w jednym miesiącu – o kolejności decyduje wtedy kolejność kolumn.
Podpis do pracy:
Rysunek 2: macierz „po module X kupił Y”
Macierz: wśród klientów, którzy kupili moduł X najpóźniej w miesiącu 24 i nie mieli wcześniej Y, liczymy odsetek, który kupił Y w ciągu 12 miesięcy po X, z 95% przedziałem ufności Wilsona. Dolny wiersz to punkt odniesienia: odsetek kupujących Y w pierwszym roku od startu wśród wszystkich klientów.
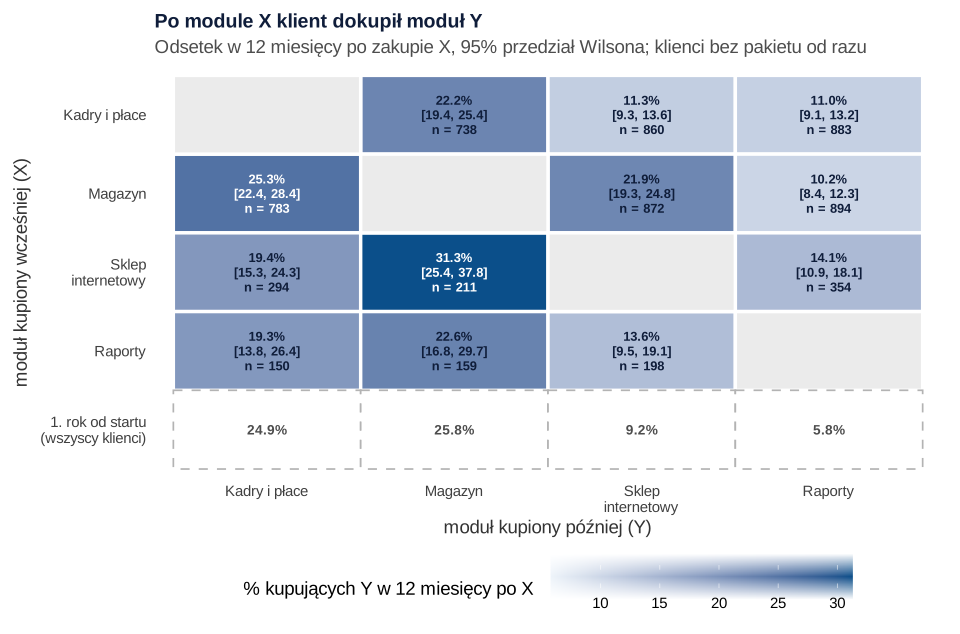
Co widać. Po magazynie sklep kupiło 21.9% [19.3, 24.8] klientów – 2.4 razy więcej niż w pierwszym roku u wszystkich (9.2%). Po sklepie magazyn dokupiło 31.3% [25.4, 37.8]. Raporty po sklepie (14.1%) i po kadrach (11.0%) to dwa razy i więcej niż średnio (5.8%), bo raporty kupują klienci z wieloma modułami.
Jak może zmylić. Po kadrach magazyn kupiło 22.2% – mniej niż w pierwszym roku u wszystkich (25.8%). Kadry nie „zniechęcają” do magazynu: klienci z kadrami, a bez magazynu, to częściej usługi z małą liczbą towarów – macierz miesza kolejność z tym, kim są klienci. Wiersze mają też różne liczebności (od 150 do 894), stąd przedziały od ok. ±2 do ±7 punktów procentowych. Macierz przejść między planami: zmiana planu abonamentu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: czas do pierwszego dokupienia
Klienci zaczynali w różnych miesiącach, więc 2501 z 5563 (bez pakietu) do końca danych nic nie dokupiło – ich czas jest cenzurowany. Odsetek „kiedykolwiek dokupił” (55.0%) zaniża wynik, bo nowi klienci nie zdążyli. Właściwa jest krzywa Kaplana–Meiera (Kaplan i Meier, 1958); rysujemy 1 − S(t), czyli odsetek, który już dokupił.
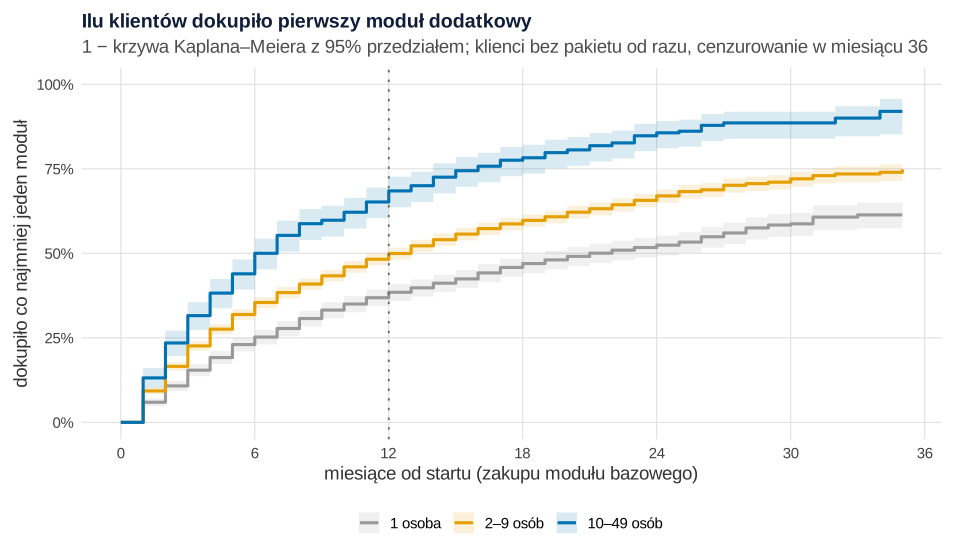
Co widać. Po 6 miesiącach dokupiło 33.7% klientów, po 12 – 48.2% [46.8, 49.6], po 24 – 64.4% [62.8, 65.9]; mediana czasu to 13 miesięcy. Po roku dokupiło 38.5% firm jednoosobowych, 49.9% firm 2–9 osób i 68.5% firm 10–49 osób (mediany 21, 13 i 6 miesięcy; test log-rank χ²(2) = 192, p < .001).
Jak może zmylić. Krzywa zakłada, że klienci z krótką obserwacją zachowują się jak dawni. Nie uwzględnia odejść (tu ich nie symulowaliśmy) – klient, który zrezygnował, już nic nie dokupi. Po analizę przeżycia z ludźmi, którzy nigdy nie kupią, zajrzyj do wpisu o okresie próbnym i freemium.
Podpis do pracy:
Rysunek 4: model szansy dokupienia w 6 miesięcy
Dla każdego modułu budujemy osobną regresję logistyczną. Wiersz to klient w dniu stanu (koniec miesiąca), który jeszcze nie ma modułu; wynik – czy kupi go w kolejnych 6 miesiącach. Predyktory: liczba pracowników (logarytm), branża, udział faktur z pozycjami magazynowymi i z zamówień internetowych, liczba faktur, staż, posiadane moduły i to, czy klient przed dniem stanu uruchomił wersję próbną. Uczymy na stanach z miesięcy 12, 18 i 24, a sprawdzamy na stanie z miesiąca 30 – to walidacja w czasie.
Ilorazy szans pokrywają się z tym, co ukryliśmy: dwukrotnie więcej pracowników to szansa kadr większa o ok. 1.7 raza (OR = 2.20 na jednostkę logarytmu), a posiadanie magazynu zwiększa szansę sklepu 3.31 raza. Najbardziej, jak w badaniu modeli „następnego produktu” Knotta i in. (2002), pomaga wiedza o modułach już posiadanych.
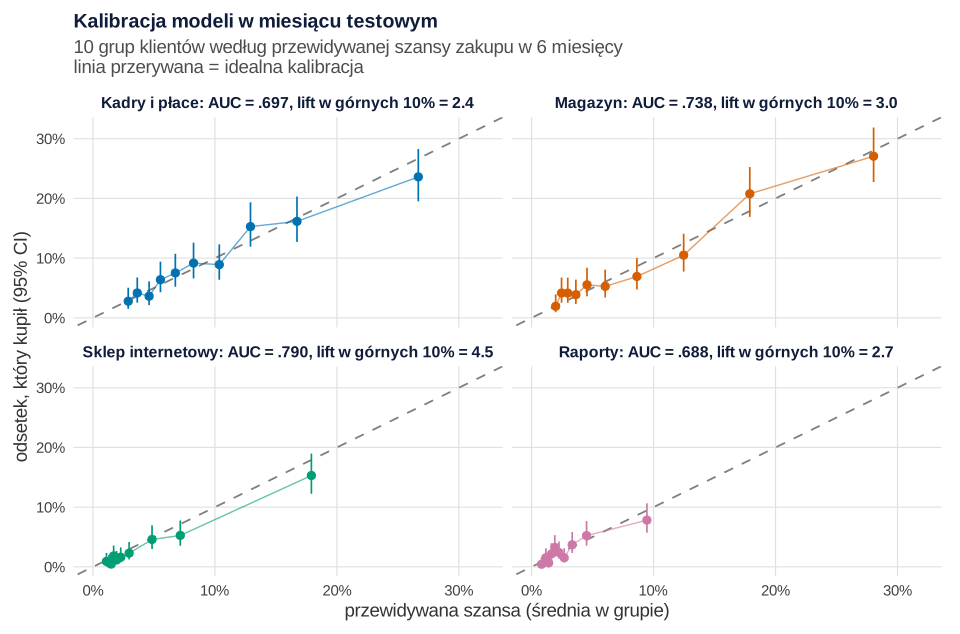
set.seed(7675)).Co widać. Pole pod krzywą ROC wynosi .697 [.668, .726] dla kadr, .738 [.708, .768] dla magazynu, .790 [.749, .830] dla sklepu i .688 [.643, .734] dla raportów. Kalibracja jest dobra: dla kadr przewidziano średnio 9.8% kupujących i tyle kupiło (wyraz wolny kalibracji −0.01, nachylenie 0.95). Lift w górnych 10% to 2.42 [2.01, 2.82] dla kadr (23.6% kupujących zamiast 9.8%), 3.00 dla magazynu i 4.49 [3.77, 5.35] dla sklepu (15.3% zamiast 3.4%). Przedziały liftu pochodzą z bootstrapu (1000 prób).
Jak może zmylić. Model sklepu przeszacowuje: przewiduje 4.3% kupujących, a kupiło 3.4% (wyraz wolny −0.26) – w miesiącu testowym sklep kupowano rzadziej niż w danych do uczenia (4.5%). Trzeba raportować razem dyskryminację i kalibrację (Steyerberg i in., 2010), a ROC, lift i kalibrację opisuje się we wspólnych ramach (Vuk i Curk, 2006). Inny przykład kalibracji w sprzedaży B2B opisuje wpis o ocenie leadów.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: następny najlepszy moduł – p czy p × marża?
Klient dostaje jedną propozycję. Odruchowo wybiera się moduł o najwyższej szansie p, ale moduły dają różną marżę (ustaliliśmy roczną: kadry 1200 zł, magazyn 700 zł, sklep 500 zł, raporty 300 zł). Lepiej wybrać najwyższą wartość oczekiwaną p × marża.
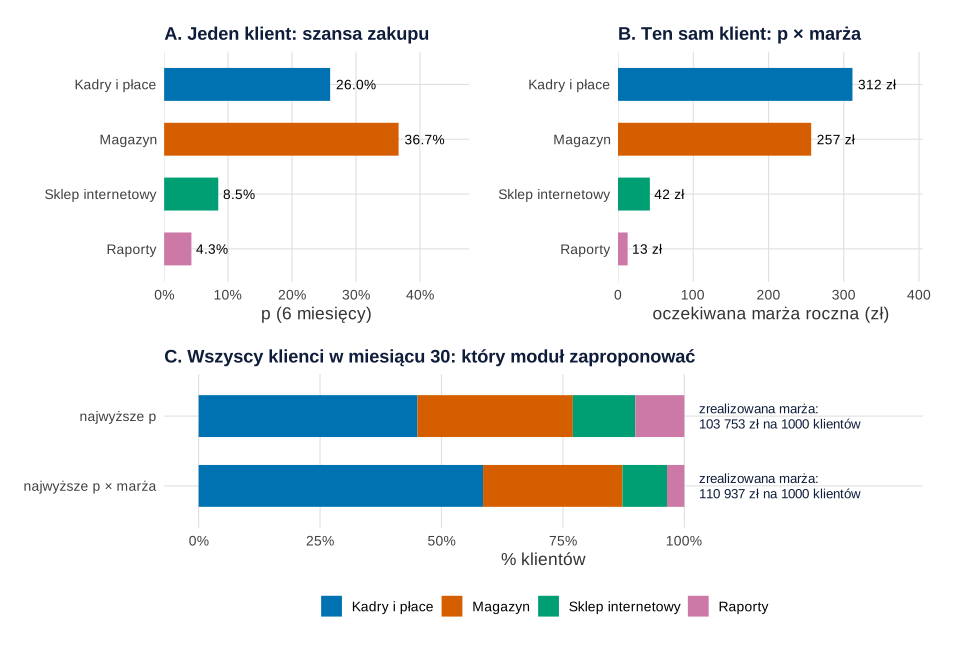
set.seed(7676)).Co widać. Klient nr 91 (handel, 10 pracowników) najchętniej kupi magazyn: p = 36.7% wobec 26.0% dla kadr. Ale 0.367 × 700 zł = 257 zł, a 0.260 × 1200 zł = 312 zł – oczekiwanie wygrywają kadry. Wśród 4983 klientów reguły wskazują inny moduł u 959 (19.2%). Trafność jest prawie taka sama (11.9% i 11.8%), ale marża z trafień rośnie ze 103 753 do 110 937 zł na 1000 klientów: o 7184 zł, 95% CI [3311, 10918] (bootstrap klientów).
Jak może zmylić. Te zakupy nastąpiły bez żadnej kampanii. Rysunek mówi, ile kupują wskazani klienci, a nie ile kupią dzięki propozycji – o tym niżej. W dłuższym horyzoncie zamiast marży rocznej użyj wartości klienta (CLV).
Podpis do pracy:
Model to nie przyczyna: kampania z grupą kontrolną
Model mówi, kto kupi, a nie, kto kupi z powodu propozycji. Klient z p = 37% często kupi i bez maila. Badanie terenowe działań retencyjnych pokazało, że klienci o najwyższym przewidywanym ryzyku nie byli najlepszymi adresatami działań (Ascarza, 2018). Model „następnego produktu” Knotta i in. (2002) dał w teście terenowym wyższy zysk niż heurystyka – a autorzy sprawdzali, czy zysk jest przyrostowy wobec sprzedaży, która i tak nastąpiłaby innymi kanałami.
Praktycznie: z listy wybranej modelem odłóż losowo np. 15% klientów, którym nic nie wysyłasz (grupa kontrolna), i porównaj odsetki zakupów. Gdy wyniki kilku kampanii się zbiorą, można modelować sam przyrost – patrz modelowanie uplift.
Rysunek 6: przeciek z wersji próbnej i pakiety od razu
Najsilniejszy sygnał zakupu to wersja próbna, zwykle uruchamiana w miesiącu zakupu. Co się stanie, gdy analityk weźmie cechę „używał funkcji modułu” z bazy na dziś (miesiąc 36), a nie ze stanu w dniu prognozy? Wersje próbne uruchomione w oknie wyniku wejdą do predyktorów – to przeciek (Kaufman i in., 2012).
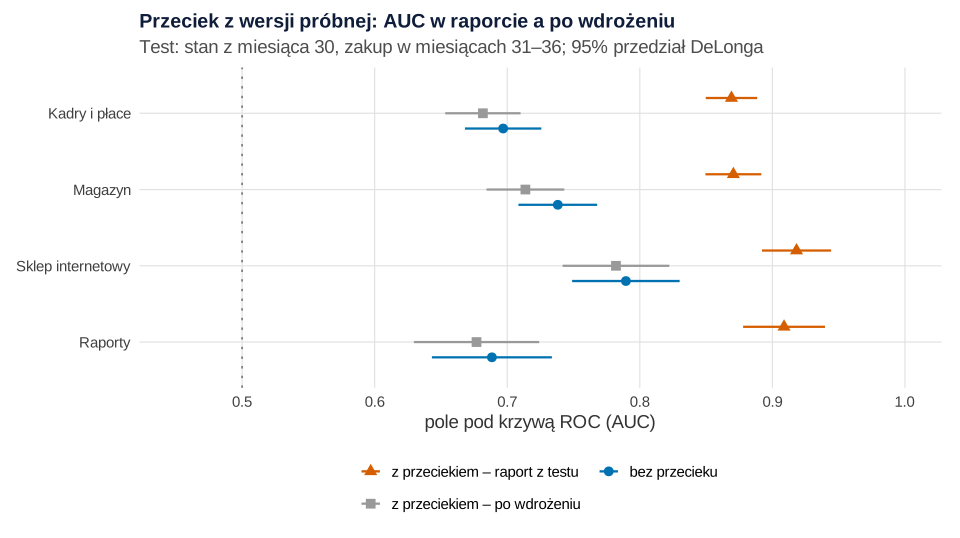
Co widać. W raporcie modele z przeciekiem mają AUC .869–.918, a iloraz szans dla wersji próbnej rośnie z 1.85 do 8.5 (kadry). Po wdrożeniu, gdy w dniu prognozy przyszłych wersji próbnych jeszcze nie ma, AUC spada do .677–.782 – poniżej modelu uczciwego. Model kadr z przeciekiem przewiduje też 5.6% kupujących, a kupiło 9.8%.
Druga pułapka – pakiety od razu. 437 klientów kupiło w pierwszym miesiącu 2–4 moduły (263 – wszystkie cztery). Nie mają kolejności, więc wyłączyliśmy ich ze ścieżek, macierzy i krzywej. Gdyby liczyć ich jako „dokupienie w miesiącu 0”, odsetek po roku wzrósłby z 48.2% do 52.0%, a do ścieżek trafiłyby sztuczne remisy.
Podpis do pracy:
Co z tym zrobić w marketingu
- Opowiadaj ścieżkami, decyduj modelem – ścieżki pokazują typowe kolejności, model – komu zaproponować moduł teraz.
- Proponuj sklep klientom z magazynem i zamówieniami internetowymi, kadry – firmom z pracownikami, raporty – klientom z kilkoma modułami.
- Wybieraj moduł po p × marża, nie po samym p – w przykładzie o 7184 zł więcej na 1000 klientów.
- Licz cechy na dzień prognozy i oceniaj model na późniejszym okresie.
- Odkładaj losową grupę kontrolną przy każdej kampanii.
- Pakiety od razu analizuj osobno i pytaj, czy oferta pakietu nie jest lepsza dla dużych firm (68.5% z nich dokupiło moduł w rok).
Że produkty kupuje się w przewidywalnej kolejności, a klienci różnią się tempem przechodzenia do kolejnych, pokazali Li i in. (2005) na usługach bankowych. Więcej przykładów: statystyka w pracy z marketingu; o czasie do powtórnego zakupu – wpis o czasie do drugiego zakupu.
Jak opisać w pracy
Opisz kohortę, traktowanie pakietów, definicję wiersza (klient × dzień stanu), okno wyniku, podział w czasie, miary z przedziałami i regułę wyboru modułu. Napisz wprost, że model przewiduje zakup, a nie efekt kampanii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane k (wiersz = klient), przepis 5 – modele i zbiory testowe używane w przepisach 6 i 7. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 767 w przepisie 1, 7675 w przepisie 5 (bootstrap liftu, 1000 prób), 7676 w przepisie 6 (bootstrap różnicy marży, 1000 prób); przepisy 2, 3, 4, 7 i 8 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: liczbę klientów (6000), miesiące startu (1–33) i długość danych (36 miesięcy), rozkłady wielkości firmy, branż, udziału faktur z towarami i z zamówień internetowych oraz liczby faktur, odsetek pakietów od razu (7%) i liczbę modułów w pakiecie, współczynniki miesięcznej szansy zakupu każdego modułu, nieobserwowane zaangażowanie (odchylenie standardowe 0.5), wzrost zakupów w pierwszych miesiącach, częstość i termin wersji próbnych (przepis 1), marże modułów (1200, 700, 500 i 300 zł), kohortę ścieżek (start w miesiącach 1–12, 24 miesiące), okno macierzy (12 miesięcy), dni stanu (12, 18, 24 i 30) i okno wyniku (6 miesięcy). Po pierwszym uruchomieniu zmieniono (współczynniki szansy zakupu i ziarna zostały bez zmian): (1) poprawiono błąd w kodzie przypisującym wersje próbne kupującym – pierwsza wersja przepisu 1 przerwała się błędem, zanim powstały jakiekolwiek wyniki; (2) udziały faktur z towarami i z zamówień internetowych zaokrąglono do trzech miejsc, żeby plik CSV dawał te same wyniki co kod – zmieniło to pojedyncze liczby (np. w macierzy n dla pary kadry → sklep z 859 na 860); (3) schemat ścieżek narysowano wstęgami zamiast strzałek, bo podpisy strzałek nachodziły na siebie; (4) do macierzy dodano wiersz odniesienia i liczebności w polach; (5) na rysunku 3 poprawiono błąd w pasmach przedziałów; (6) wykres kalibracji ułożono w dwóch wierszach bez wspólnej skali osi; (7) przykładowego klienta na rysunku 5 wybiera się według największej przewagi magazynu w p (pierwsza reguła – największa przewaga kadr w p × marża – dała klienta z prawie równymi p: 24.6% i 26.0%); (8) do porównania przecieku dodano średnią przewidywaną szansę. Każdy przepis liczy się w kilka sekund.
1. Dane: klienci, zakupy modułów i wersje próbne
R
# Dane. Fikcyjny producent programu księgowego dla małych firm: moduł bazowy + 4 moduły dodatkowe, 36 miesięcy
library(ggplot2)
options(width = 120)                                       # szersze wydruki tabel w konsoli

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(kadry = "#0072B2", magazyn = "#D55E00", sklep = "#009E73", raporty = "#CC79A7",
         szary = "#999999", zolty = "#E69F00", blekit = "#56B4E9", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
moduly <- c("kadry", "magazyn", "sklep", "raporty")
marza <- c(kadry = 1200, magazyn = 700, sklep = 500, raporty = 300)   # roczna marża z modułu, zł (ręcznie)

# Parametry ustawione ręcznie: 6000 klientów, start w miesiącach 1–33, obserwacja do końca miesiąca 36
set.seed(767)
N <- 6000; M <- 36
k <- data.frame(id = 1:N, start = sample(1:33, N, replace = TRUE))
k$pracownicy <- pmin(49, 1 + rnbinom(N, size = 0.8, mu = 3))
k$branza <- sample(c("handel", "usługi", "produkcja", "budownictwo"), N, TRUE, c(.35, .40, .12, .13))
# używane funkcje modułu bazowego (średnia z ostatnich miesięcy):
# towary – udział faktur z pozycjami magazynowymi, internet – udział faktur do zamówień internetowych
k$towary <- with(k, ifelse(branza == "handel", rbeta(N, 5, 3), ifelse(branza == "produkcja", rbeta(N, 4, 3),
                 ifelse(branza == "budownictwo", rbeta(N, 2, 5), rbeta(N, 1, 8)))))
sklep_www <- k$branza == "handel" & runif(N) < .4
k$internet <- ifelse(sklep_www, rbeta(N, 3, 4), rbeta(N, 0.5, 25))
k$towary <- round(k$towary, 3); k$internet <- round(k$internet, 3)          # zapis jak w systemie: 3 miejsca
k$faktury <- round(exp(log(15) + 0.5 * log(k$pracownicy) + rnorm(N, 0, 0.6)))   # faktur miesięcznie
zaang <- rnorm(N, 0, 0.5)                                    # zaangażowanie klienta (nieobserwowane)

# Pakiet od razu: 7% klientów kupuje w pierwszym miesiącu co najmniej 2 moduły
kup <- matrix(NA_integer_, N, 4, dimnames = list(NULL, moduly))     # miesiąc zakupu modułu
prob <- matrix(NA_integer_, N, 4, dimnames = list(NULL, moduly))    # pierwszy miesiąc wersji próbnej
k$pakiet_start <- as.integer(runif(N) < .07)
for (i in which(k$pakiet_start == 1)) {
  ile <- sample(2:4, 1, prob = c(.3, .2, .5)); kup[i, sample(moduly, ile)] <- k$start[i]
}
# Miesięczna szansa zakupu modułu (logit), gdy klient go jeszcze nie ma
for (t in 2:M) {
  akt <- which(k$start < t)
  staz <- t - k$start[akt]
  ma <- !is.na(kup[akt, , drop = FALSE]) & kup[akt, , drop = FALSE] < t
  wczesnie <- 0.7 * exp(-(staz - 1) / 6)                    # więcej zakupów w pierwszych miesiącach
  logit <- cbind(
    kadry   = -5.2 + 0.8 * log(k$pracownicy[akt]) + 0.4 * (k$branza[akt] %in% c("produkcja", "budownictwo")),
    magazyn = -5.6 + 3.0 * k$towary[akt] + 0.3 * (k$branza[akt] == "handel"),
    sklep   = -6.2 + 4.0 * k$internet[akt] + 1.3 * ma[, "magazyn"],
    raporty = -6.0 + 0.5 * rowSums(ma) + 0.35 * log(k$faktury[akt] / 20)) + zaang[akt] + wczesnie
  p <- plogis(logit)
  nowe <- matrix(runif(length(p)) < p, ncol = 4) & is.na(kup[akt, , drop = FALSE])
  # wersja próbna: u 75% kupujących przed zakupem (50% w tym samym miesiącu, 25% w poprzednim),
  # a próby bez zakupu – z szansą równą połowie szansy zakupu
  u <- matrix(runif(length(p)), ncol = 4)
  kiedy <- ifelse(u < .50, t, ifelse(u < .75 & staz > 1, t - 1, NA))
  pr <- ifelse(nowe, kiedy, ifelse(is.na(kup[akt, , drop = FALSE]) & u > 1 - 0.5 * p, t, NA))
  prob[akt, ] <- pmin(prob[akt, , drop = FALSE], pr, na.rm = TRUE)
  kup[akt, ][nowe] <- t
}
k <- cbind(k, setNames(as.data.frame(kup), paste0("kup_", moduly)), setNames(as.data.frame(prob), paste0("proba_", moduly)))
write.csv(k, "sprzedaz-krzyzowa-moduly-ksiegowosc.csv", row.names = FALSE, na = "")

cat("Klienci:", N, "| pakiet od razu:", sum(k$pakiet_start), "=", round(100 * mean(k$pakiet_start), 1), "%\n")
cat("Branże (%):"); print(round(100 * prop.table(table(k$branza)), 1))
cat("Pracownicy: mediana", median(k$pracownicy), "| odsetek firm 1-osobowych", round(100 * mean(k$pracownicy == 1), 1), "%\n")
bez <- k$pakiet_start == 0
cat("Klienci bez pakietu: z co najmniej jednym modułem dodatkowym do miesiąca 36:",
    round(100 * mean(rowSums(!is.na(kup[bez, ])) > 0), 1), "% | moduły kupione (liczba klientów):\n")
print(colSums(!is.na(kup[bez, ])))
cat("Kupujący z wersją próbną przed zakupem (%):",
    round(100 * mean((!is.na(prob) & !is.na(kup) & prob <= kup)[!is.na(kup) & bez]), 1), "\n")
Wynik w R
Klienci: 6000 | pakiet od razu: 437 = 7.3 %
Branże (%):
budownictwo      handel   produkcja      usługi
       13.3        34.7        12.1        39.9
Pracownicy: mediana 3 | odsetek firm 1-osobowych 29.2 %
Klienci bez pakietu: z co najmniej jednym modułem dodatkowym do miesiąca 36: 55 % | moduły kupione (liczba klientów):
  kadry magazyn   sklep raporty
   1754    1701     713     489
Kupujący z wersją próbną przed zakupem (%): 75.2
2. Ścieżki dokupowania: Rysunek 1
R
# Rysunek 1. Schemat ścieżek dokupowania: pierwszy i drugi moduł dodatkowy w ciągu 24 miesięcy od startu
# (korzysta z k, moduly, kol i motyw z przepisu 1; bez losowania)
library(ggplot2)

# Kohorta: klienci bez pakietu od razu, którzy zaczęli w miesiącach 1–12 (każdy ma co najmniej 24 miesiące obserwacji)
ko <- k[k$pakiet_start == 0 & k$start <= 12, ]
mies <- as.matrix(ko[paste0("kup_", moduly)]) - ko$start       # miesiąc stażu, w którym kupił moduł
mies[mies > 24] <- NA
colnames(mies) <- moduly
# ścieżka = moduły w kolejności zakupu; zakupy w tym samym miesiącu łączymy znakiem „+”
sciezka <- apply(mies, 1, function(m) {
  m <- m[!is.na(m)]; if (!length(m)) return("brak dokupienia")
  paste(sapply(split(names(m), m), paste, collapse = "+"), collapse = " → ") })
cat("Kohorta:", nrow(ko), "klientów | bez dokupienia w 24 mies.:", sum(sciezka == "brak dokupienia"),
    "=", round(100 * mean(sciezka == "brak dokupienia"), 1), "%\n")
cat("Klienci z zakupem dwóch modułów w tym samym miesiącu:", sum(grepl("\\+", sciezka)), "\n")
cat("Najczęstsze ścieżki (liczba klientów i % kohorty):\n")
top <- sort(table(sciezka), decreasing = TRUE)[1:10]
print(data.frame(sciezka = names(top), n = as.integer(top), proc = round(100 * as.integer(top) / nrow(ko), 1)), row.names = FALSE)

# Kroki do schematu: pierwszy i drugi moduł (przy remisie w jednym miesiącu – kolejność kolumn)
pierwszy <- apply(mies, 1, function(m) if (all(is.na(m))) "brak" else names(m)[order(m)][1])
drugi <- apply(mies, 1, function(m) if (sum(!is.na(m)) < 2) "koniec" else names(m)[order(m)][2])
p1t <- table(factor(pierwszy, c(moduly, "brak")))
p12 <- as.data.frame(table(pierwszy = factor(pierwszy, moduly), drugi = factor(drugi, c(moduly, "koniec"))))
p12 <- p12[p12$Freq > 0, ]
p12$proc <- round(100 * p12$Freq / as.numeric(p1t[as.character(p12$pierwszy)]), 1)
cat("Pierwszy moduł dodatkowy (liczba klientów):\n"); print(p1t)
cat("Drugi moduł po pierwszym (liczba i % kupujących dany pierwszy moduł):\n")
print(p12[order(p12$pierwszy, -p12$Freq), ], row.names = FALSE)

# Schemat (diagram przepływów): słupek = węzeł, wysokość ~ liczba klientów, wstęga = przejście
nazwy <- c(baza = "Moduł bazowy", kadry = "Kadry i płace", magazyn = "Magazyn", sklep = "Sklep internetowy",
           raporty = "Raporty", brak = "bez dokupienia", koniec = "bez drugiego")
skala <- 10 / nrow(ko); przerwa <- 0.35
ustaw <- function(id, n, x) {                               # węzły jednej kolumny ułożone od góry
  h <- n * skala; gora <- 10 + przerwa * (length(n) - 1) - c(0, cumsum(h + przerwa)[-length(n)])
  data.frame(id = id, n = n, x = x, gora = gora, dol = gora - h) }
w0 <- ustaw("baza", nrow(ko), 0)
w0$gora <- w0$gora - przerwa * 2; w0$dol <- w0$dol - przerwa * 2   # wyśrodkowanie startu
w1 <- ustaw(c(moduly, "brak"), as.integer(p1t), 1)
n2 <- as.integer(table(factor(drugi[pierwszy != "brak"], c(moduly, "koniec"))))
w2 <- ustaw(c(moduly, "koniec"), n2, 2)
wstega <- function(x0, x1, a0, b0, a1, b1, grupa) {         # wstęga z krzywą „S” między dwoma odcinkami
  s <- seq(0, 1, length.out = 40); g <- 3 * s^2 - 2 * s^3
  data.frame(x = c(x0 + (x1 - x0) * s, rev(x0 + (x1 - x0) * s)),
             y = c(a0 + (a1 - a0) * g, rev(b0 + (b1 - b0) * g)), grupa = grupa) }
sz <- 0.035                                                  # połowa szerokości słupka
f1 <- do.call(rbind, lapply(seq_len(nrow(w1)), function(i)  # start → pierwszy moduł
  wstega(sz, 1 - sz, w0$gora - (sum(w1$n[seq_len(i - 1)])) * skala, w0$gora - sum(w1$n[1:i]) * skala,
         w1$gora[i], w1$dol[i], w1$id[i])))
p12$pierwszy <- as.character(p12$pierwszy); p12$drugi <- as.character(p12$drugi)
p12 <- p12[order(match(p12$pierwszy, moduly), match(p12$drugi, c(moduly, "koniec"))), ]
od <- do.call(rbind, lapply(seq_len(nrow(p12)), function(i) {  # przejścia pierwszy → drugi moduł
  z <- p12[i, ]; prz_z <- p12[p12$pierwszy == z$pierwszy, ]; prz_do <- p12[p12$drugi == z$drugi, ]
  y0 <- w1$gora[w1$id == z$pierwszy] - sum(prz_z$Freq[seq_len(which(prz_z$drugi == z$drugi) - 1)]) * skala
  y1 <- w2$gora[w2$id == z$drugi] - sum(prz_do$Freq[seq_len(which(prz_do$pierwszy == z$pierwszy) - 1)]) * skala
  cbind(wstega(1 + sz, 2 - sz, y0, y0 - z$Freq * skala, y1, y1 - z$Freq * skala, paste(z$pierwszy, z$drugi)),
        modul = ifelse(z$drugi == "koniec", "brak", z$pierwszy)) }))
wezly <- rbind(w0, w1, w2)
wezly$kolor <- ifelse(wezly$id %in% moduly, kol[wezly$id], ifelse(wezly$id == "baza", kol[["granat"]], kol[["szary"]]))
wezly$etykieta <- paste0(nazwy[wezly$id], ": ", wezly$n)
f1$modul <- f1$grupa
opisy <- p12[p12$Freq >= 100 & p12$drugi != "koniec", ]       # podpisy największych przejść – przy ich początku
opisy$x <- 1.2
opisy$y <- sapply(seq_len(nrow(opisy)), function(i) { g <- od[od$grupa == paste(opisy$pierwszy[i], opisy$drugi[i]), ]
  mean(g$y[abs(g$x - 1.2) < 0.02]) })
p1 <- ggplot() +
  geom_polygon(data = f1, aes(x, y, group = grupa, fill = modul), alpha = 0.45) +
  geom_polygon(data = od, aes(x, y, group = grupa, fill = modul), alpha = 0.45) +
  geom_rect(data = wezly, aes(xmin = x - sz, xmax = x + sz, ymin = dol, ymax = gora), fill = wezly$kolor) +
  geom_label(data = wezly[wezly$x > 0, ], aes(x = x + 0.05, y = (gora + dol) / 2, label = etykieta),
             hjust = 0, size = 3.5, fill = "white", linewidth = 0, colour = wezly$kolor[wezly$x > 0], fontface = "bold") +
  annotate("text", x = -0.05, y = (w0$gora + w0$dol) / 2, label = paste0("Moduł bazowy\n", nrow(ko), " klientów"),
           hjust = 1, size = 3.7, fontface = "bold", colour = kol[["granat"]], lineheight = 0.95) +
  geom_label(data = opisy, aes(x, y, label = paste0(Freq, " (", proc, "%)")), size = 3.1, colour = "#0f1d3a",
             fill = "white", alpha = 0.85, linewidth = 0, label.padding = unit(0.12, "lines")) +
  annotate("text", x = c(0, 1, 2), y = 11.6, label = c("start", "pierwszy moduł dodatkowy", "drugi moduł dodatkowy"),
           size = 3.8, colour = "grey30") +
  scale_fill_manual(values = c(kol[moduly], brak = kol[["szary"]]), guide = "none") +
  coord_cartesian(xlim = c(-0.45, 2.55), ylim = c(-0.2, 12), expand = FALSE) +
  labs(title = "Ścieżki dokupowania modułów w ciągu 24 miesięcy od startu",
       subtitle = paste0("Klienci ze startem w miesiącach 1–12, bez pakietu od razu (N = ", nrow(ko), ")\n",
                         "Liczby przy wstęgach: klienci (% kupujących dany pierwszy moduł)"), x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p1                       # do pliku: ggsave("sprzedaz-krzyzowa-sciezki.svg", p1, width = 10, height = 6.2)
Wynik w R
Kohorta: 2033 klientów | bez dokupienia w 24 mies.: 715 = 35.2 %
Klienci z zakupem dwóch modułów w tym samym miesiącu: 34
Najczęstsze ścieżki (liczba klientów i % kohorty):
         sciezka   n proc
 brak dokupienia 715 35.2
           kadry 351 17.3
         magazyn 279 13.7
 magazyn → kadry 104  5.1
 magazyn → sklep  81  4.0
           sklep  74  3.6
 kadry → magazyn  64  3.1
         raporty  45  2.2
 kadry → raporty  30  1.5
 sklep → magazyn  24  1.2
Pierwszy moduł dodatkowy (liczba klientów):

  kadry magazyn   sklep raporty    brak
    540     554     137      87     715
Drugi moduł po pierwszym (liczba i % kupujących dany pierwszy moduł):
 pierwszy   drugi Freq proc
    kadry  koniec  351 65.0
    kadry magazyn  110 20.4
    kadry raporty   40  7.4
    kadry   sklep   39  7.2
  magazyn  koniec  279 50.4
  magazyn   kadry  138 24.9
  magazyn   sklep  110 19.9
  magazyn raporty   27  4.9
    sklep  koniec   74 54.0
    sklep magazyn   35 25.5
    sklep   kadry   22 16.1
    sklep raporty    6  4.4
  raporty  koniec   45 51.7
  raporty magazyn   21 24.1
  raporty   kadry   19 21.8
  raporty   sklep    2  2.3
3. Macierz „po X kupił Y” z przedziałami Wilsona: Rysunek 2
R
# Rysunek 2. Macierz „po module X kupił Y w ciągu 12 miesięcy” z 95% przedziałami Wilsona
# (korzysta z k, moduly, kol i motyw z przepisu 1; bez losowania)
library(ggplot2)

wilson <- function(x, n, z = 1.96) {                       # 95% przedział Wilsona dla odsetka
  p <- x / n; srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  c(srodek - pol, srodek + pol) }
b <- k[k$pakiet_start == 0, ]
kup <- as.matrix(b[paste0("kup_", moduly)]); colnames(kup) <- moduly
mac <- do.call(rbind, lapply(moduly, function(x) do.call(rbind, lapply(setdiff(moduly, x), function(y) {
  # klienci, którzy kupili X najpóźniej w miesiącu 24 (12 miesięcy obserwacji po zakupie) i nie mieli wcześniej Y
  i <- which(!is.na(kup[, x]) & kup[, x] <= 24 & (is.na(kup[, y]) | kup[, y] > kup[, x]))
  tak <- sum(!is.na(kup[i, y]) & kup[i, y] - kup[i, x] <= 12)
  ci <- wilson(tak, length(i))
  data.frame(po = x, kupil = y, n = length(i), tak = tak, proc = 100 * tak / length(i),
             dolna = 100 * ci[1], gorna = 100 * ci[2]) }))))
# punkt odniesienia: odsetek kupujących Y w pierwszych 12 miesiącach od startu (klienci ze startem w miesiącach 1–24)
s24 <- b$start <= 24
baza <- sapply(moduly, function(y) 100 * mean(!is.na(kup[s24, y]) & kup[s24, y] - b$start[s24] <= 12))
mac$baza <- baza[mac$kupil]
mac$wskaznik <- mac$proc / mac$baza                        # ile razy częściej niż w pierwszym roku u wszystkich
print(transform(mac, proc = round(proc, 1), dolna = round(dolna, 1), gorna = round(gorna, 1),
                baza = round(baza, 1), wskaznik = round(wskaznik, 2)), row.names = FALSE)

nazwy <- c(kadry = "Kadry i płace", magazyn = "Magazyn", sklep = "Sklep\ninternetowy", raporty = "Raporty")
mac$po_f <- factor(nazwy[mac$po], rev(nazwy)); mac$kupil_f <- factor(nazwy[mac$kupil], nazwy)
odn <- data.frame(kupil_f = factor(nazwy, nazwy), po_f = "1. rok od startu\n(wszyscy klienci)", proc = baza)
p2 <- ggplot(mac, aes(kupil_f, po_f, fill = proc)) +
  geom_tile(colour = "white", linewidth = 1.2) +
  geom_tile(data = data.frame(kupil_f = factor(nazwy, nazwy), po_f = factor(nazwy, rev(nazwy))),
            aes(kupil_f, po_f), fill = "grey92", inherit.aes = FALSE, colour = "white", linewidth = 1.2) +
  geom_tile(data = odn, fill = "white", colour = "grey70", linewidth = 0.6, linetype = 2) +
  geom_text(aes(label = sprintf("%.1f%%\n[%.1f, %.1f]\nn = %d", proc, dolna, gorna, n),
                colour = proc > 24), size = 3.4, lineheight = 0.95, fontface = "bold") +
  geom_text(data = odn, aes(label = sprintf("%.1f%%", proc)), size = 3.6, colour = "grey30", fontface = "bold") +
  scale_fill_gradient(low = "#eef4fa", high = "#0b4f8a", name = "% kupujących Y w 12 miesięcy po X") +
  scale_colour_manual(values = c(`FALSE` = "#0f1d3a", `TRUE` = "white"), guide = "none") +
  scale_y_discrete(limits = unname(c("1. rok od startu\n(wszyscy klienci)", rev(nazwy)))) +
  labs(title = "Po module X klient dokupił moduł Y",
       subtitle = "Odsetek w 12 miesięcy po zakupie X, 95% przedział Wilsona; klienci bez pakietu od razu",
       x = "moduł kupiony później (Y)", y = "moduł kupiony wcześniej (X)") +
  motyw + theme(panel.grid.major = element_blank(), legend.key.width = unit(1.6, "cm"))
p2                       # do pliku: ggsave("sprzedaz-krzyzowa-macierz.svg", p2, width = 10, height = 6.6)
Wynik w R
      po   kupil   n tak proc dolna gorna baza wskaznik
   kadry magazyn 738 164 22.2  19.4  25.4 25.8     0.86
   kadry   sklep 860  97 11.3   9.3  13.6  9.2     1.22
   kadry raporty 883  97 11.0   9.1  13.2  5.8     1.90
 magazyn   kadry 783 198 25.3  22.4  28.4 24.9     1.02
 magazyn   sklep 872 191 21.9  19.3  24.8  9.2     2.37
 magazyn raporty 894  91 10.2   8.4  12.3  5.8     1.76
   sklep   kadry 294  57 19.4  15.3  24.3 24.9     0.78
   sklep magazyn 211  66 31.3  25.4  37.8 25.8     1.21
   sklep raporty 354  50 14.1  10.9  18.1  5.8     2.44
 raporty   kadry 150  29 19.3  13.8  26.4 24.9     0.78
 raporty magazyn 159  36 22.6  16.8  29.7 25.8     0.88
 raporty   sklep 198  27 13.6   9.5  19.1  9.2     1.48
4. Czas do pierwszego dokupienia (Kaplan–Meier): Rysunek 3
R
# Rysunek 3. Czas od startu do pierwszego modułu dodatkowego – Kaplan–Meier według wielkości firmy
# (korzysta z k, moduly, kol i motyw z przepisu 1; bez losowania)
library(ggplot2)
library(survival)

b <- k[k$pakiet_start == 0, ]
pierwszy <- apply(b[paste0("kup_", moduly)], 1, function(m) if (all(is.na(m))) NA else min(m, na.rm = TRUE))
b$czas <- ifelse(is.na(pierwszy), 36 - b$start, pierwszy - b$start)   # miesiące od startu
b$zdarzenie <- as.integer(!is.na(pierwszy))                            # 0 = cenzurowanie: koniec danych (miesiąc 36)
b$wielkosc <- cut(b$pracownicy, c(0, 1, 9, 49), labels = c("1 osoba", "2–9 osób", "10–49 osób"))
cat("Klienci bez pakietu:", nrow(b), "| zdarzenia:", sum(b$zdarzenie), "| cenzurowani:", sum(1 - b$zdarzenie),
    "| mediana obserwacji cenzurowanych:", median(b$czas[b$zdarzenie == 0]), "mies.\n")
cat("Naiwnie – odsetek, który kiedykolwiek dokupił (bez uwzględnienia cenzurowania):",
    round(100 * mean(b$zdarzenie), 1), "%\n")
km <- survfit(Surv(czas, zdarzenie) ~ 1, data = b)
s <- summary(km, times = c(6, 12, 24))
print(data.frame(miesiac = s$time, dokupilo_proc = round(100 * (1 - s$surv), 1),
                 dolna = round(100 * (1 - s$upper), 1), gorna = round(100 * (1 - s$lower), 1)), row.names = FALSE)
cat("Mediana czasu do pierwszego dokupienia:", summary(km)$table["median"], "mies.\n")
kmw <- survfit(Surv(czas, zdarzenie) ~ wielkosc, data = b)
sw <- summary(kmw, times = 12)
print(data.frame(grupa = sw$strata, n = kmw$n, dokupilo_12m_proc = round(100 * (1 - sw$surv), 1),
                 dolna = round(100 * (1 - sw$upper), 1), gorna = round(100 * (1 - sw$lower), 1)), row.names = FALSE)
print(summary(kmw)$table[, "median"])
print(survdiff(Surv(czas, zdarzenie) ~ wielkosc, data = b))

kr <- data.frame(czas = kmw$time, dokupilo = 1 - kmw$surv, dolna = 1 - kmw$upper, gorna = 1 - kmw$lower,
                 grupa = rep(levels(b$wielkosc), kmw$strata))
kr <- rbind(data.frame(czas = 0, dokupilo = 0, dolna = 0, gorna = 0, grupa = levels(b$wielkosc)), kr)
kr$grupa <- factor(kr$grupa, levels(b$wielkosc))
p3 <- ggplot(kr, aes(czas, dokupilo, colour = grupa, fill = grupa)) +
  geom_rect(aes(xmin = czas, xmax = xmax, ymin = dolna, ymax = gorna), colour = NA, alpha = 0.15,
            data = do.call(rbind, lapply(split(kr, kr$grupa), function(x) { x$xmax <- c(x$czas[-1], 35); x }))) +
  geom_step(linewidth = 1.1) +
  geom_vline(xintercept = 12, linetype = 3, colour = "grey40") +
  scale_colour_manual(values = unname(kol[c("szary", "zolty", "kadry")]), name = NULL) +
  scale_fill_manual(values = unname(kol[c("szary", "zolty", "kadry")]), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%"), limits = c(0, 1)) +
  scale_x_continuous(breaks = seq(0, 36, 6)) +
  labs(title = "Ilu klientów dokupiło pierwszy moduł dodatkowy",
       subtitle = "1 − krzywa Kaplana–Meiera z 95% przedziałem; klienci bez pakietu od razu, cenzurowanie w miesiącu 36",
       x = "miesiące od startu (zakupu modułu bazowego)", y = "dokupiło co najmniej jeden moduł") +
  motyw
p3                       # do pliku: ggsave("sprzedaz-krzyzowa-czas.svg", p3, width = 10, height = 5.8)
Wynik w R
Klienci bez pakietu: 5563 | zdarzenia: 3062 | cenzurowani: 2501 | mediana obserwacji cenzurowanych: 14 mies.
Naiwnie – odsetek, który kiedykolwiek dokupił (bez uwzględnienia cenzurowania): 55 %
 miesiac dokupilo_proc dolna gorna
       6          33.7  32.4  35.0
      12          48.2  46.8  49.6
      24          64.4  62.8  65.9
Mediana czasu do pierwszego dokupienia: 13 mies.
               grupa    n dokupilo_12m_proc dolna gorna
    wielkosc=1 osoba 1632              38.5  35.9  40.9
   wielkosc=2–9 osób 3437              49.9  48.1  51.7
 wielkosc=10–49 osób  494              68.5  63.6  72.7
   wielkosc=1 osoba   wielkosc=2–9 osób wielkosc=10–49 osób
                 21                  13                   6
Call:
survdiff(formula = Surv(czas, zdarzenie) ~ wielkosc, data = b)

                       N Observed Expected (O-E)^2/E (O-E)^2/V
wielkosc=1 osoba    1632      736      998     68.97     108.7
wielkosc=2–9 osób   3437     1962     1849      6.88      18.4
wielkosc=10–49 osób  494      364      214    104.41     119.8

 Chisq= 192  on 2 degrees of freedom, p= <2e-16
5. Regresja logistyczna dla każdego modułu i walidacja w czasie: Rysunek 4
R
# Rysunek 4. Model szansy dokupienia modułu w 6 miesięcy: regresja logistyczna dla każdego modułu,
# walidacja w czasie – uczenie na stanach z miesięcy 12, 18 i 24, test na stanie z miesiąca 30
# (korzysta z k, moduly, kol i motyw z przepisu 1)
library(ggplot2)
library(pROC)

# Wiersz = klient × moduł × dzień stanu s: wszystko, co wiadomo na koniec miesiąca s;
# wynik = kupił moduł w miesiącach s+1 … s+6. Klient musi być już klientem i nie mieć jeszcze modułu.
stan <- function(s, j, przeciek = FALSE) {
  x <- k[k$start < s & (is.na(k[[paste0("kup_", j)]]) | k[[paste0("kup_", j)]] > s), ]
  kupil <- x[[paste0("kup_", j)]]
  for (m in setdiff(moduly, j)) x[[paste0("ma_", m)]] <- as.integer(!is.na(x[[paste0("kup_", m)]]) & x[[paste0("kup_", m)]] <= s)
  pr <- x[[paste0("proba_", j)]]
  # uczciwie: wersja próbna przed dniem stanu; z przeciekiem: „używał funkcji modułu” – z całej bazy na dziś (miesiąc 36)
  x$proba <- as.integer(!is.na(pr) & (przeciek | pr <= s))
  x$staz <- s - x$start; x$s <- s
  x$y <- as.integer(!is.na(kupil) & kupil > s & kupil <= s + 6)
  x[c("id", "s", "staz", "pracownicy", "branza", "towary", "internet", "faktury", "pakiet_start",
      paste0("ma_", setdiff(moduly, j)), "proba", "y")]
}
wzor <- function(j) as.formula(paste("y ~ log(pracownicy) + branza + towary + internet + log(faktury) + log(staz) + proba +",
                                     paste0("ma_", setdiff(moduly, j), collapse = " + ")))
ucz <- lapply(setNames(moduly, moduly), function(j) do.call(rbind, lapply(c(12, 18, 24), stan, j = j)))
test <- lapply(setNames(moduly, moduly), function(j) stan(30, j))
modele <- lapply(setNames(moduly, moduly), function(j) glm(wzor(j), family = binomial, data = ucz[[j]]))
for (j in moduly) test[[j]]$p <- predict(modele[[j]], test[[j]], type = "response")
cat("Współczynniki (iloraz szans) – Kadry i płace:\n"); print(round(exp(coef(modele$kadry)), 2))
cat("Współczynniki (iloraz szans) – Sklep internetowy:\n"); print(round(exp(coef(modele$sklep)), 2))

set.seed(7675)
ocena <- do.call(rbind, lapply(moduly, function(j) {
  t <- test[[j]]; a <- ci.auc(roc(t$y, t$p, quiet = TRUE))
  lp <- qlogis(t$p)
  nach <- coef(glm(y ~ lp, family = binomial, data = t))[2]                         # nachylenie kalibracji
  wyr <- coef(glm(y ~ offset(lp), family = binomial, data = t))[1]                  # wyraz wolny kalibracji
  gora <- t$p >= quantile(t$p, 0.9)
  lift <- mean(t$y[gora]) / mean(t$y)
  bl <- replicate(1000, { i <- sample.int(nrow(t), replace = TRUE); g <- t$p[i] >= quantile(t$p[i], 0.9)
                          mean(t$y[i][g]) / mean(t$y[i]) })
  data.frame(modul = j, n_ucz = nrow(ucz[[j]]), kupili_ucz_proc = round(100 * mean(ucz[[j]]$y), 1),
             n_test = nrow(t), kupili_test = sum(t$y), kupili_test_proc = round(100 * mean(t$y), 1),
             przewid_proc = round(100 * mean(t$p), 1), AUC = round(a[2], 3), AUC_dolna = round(a[1], 3), AUC_gorna = round(a[3], 3),
             kal_wyraz = round(wyr, 2), kal_nachylenie = round(nach, 2),
             gorne10_proc = round(100 * mean(t$y[gora]), 1), lift10 = round(lift, 2),
             lift_dolna = round(quantile(bl, .025), 2), lift_gorna = round(quantile(bl, .975), 2)) }))
print(ocena, row.names = FALSE)

# Kalibracja: dziesięć grup według przewidywanej szansy – średnia przewidywana vs odsetek kupujących
kal <- do.call(rbind, lapply(moduly, function(j) {
  t <- test[[j]]; g <- cut(rank(t$p, ties.method = "first"), 10, labels = FALSE)
  do.call(rbind, lapply(split(t, g), function(x) { n <- nrow(x); o <- mean(x$y)
    pol <- 1.96 * sqrt(o * (1 - o) / n + 1.96^2 / (4 * n^2)) / (1 + 1.96^2 / n); sr <- (o + 1.96^2 / (2 * n)) / (1 + 1.96^2 / n)
    data.frame(modul = j, przewid = mean(x$p), obserw = o, dolna = sr - pol, gorna = sr + pol) })) }))
nazwy <- c(kadry = "Kadry i płace", magazyn = "Magazyn", sklep = "Sklep internetowy", raporty = "Raporty")
etyk <- setNames(sprintf("%s: AUC = %s, lift w górnych 10%% = %.1f", nazwy[ocena$modul],
                         sub("^0", "", sprintf("%.3f", ocena$AUC)), ocena$lift10), ocena$modul)
kal$modul_f <- factor(etyk[kal$modul], etyk)
p4 <- ggplot(kal, aes(przewid, obserw, colour = modul)) +
  geom_abline(slope = 1, intercept = 0, linetype = 2, colour = "grey50") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0, linewidth = 0.6) +
  geom_point(size = 2.4) + geom_line(linewidth = 0.5, alpha = 0.6) +
  facet_wrap(~ modul_f, nrow = 2) +
  scale_colour_manual(values = kol[moduly], guide = "none") +
  scale_x_continuous(labels = function(x) paste0(round(100 * x), "%"), limits = c(0, 0.32)) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%"), limits = c(0, 0.32)) +
  labs(title = "Kalibracja modeli w miesiącu testowym",
       subtitle = "10 grup klientów według przewidywanej szansy zakupu w 6 miesięcy\nlinia przerywana = idealna kalibracja",
       x = "przewidywana szansa (średnia w grupie)", y = "odsetek, który kupił (95% CI)") +
  motyw + theme(strip.text = element_text(size = rel(0.85)))
p4                       # do pliku: ggsave("sprzedaz-krzyzowa-kalibracja.svg", p4, width = 10, height = 6.6)
Wynik w R
Współczynniki (iloraz szans) – Kadry i płace:
    (Intercept) log(pracownicy)    branzahandel branzaprodukcja    branzausługi          towary        internet
           0.08            2.20            0.60            1.06            0.68            1.37            0.71
   log(faktury)       log(staz)           proba      ma_magazyn        ma_sklep      ma_raporty
           1.00            0.80            1.85            1.26            1.07            1.07
Współczynniki (iloraz szans) – Sklep internetowy:
    (Intercept) log(pracownicy)    branzahandel branzaprodukcja    branzausługi          towary        internet
           0.02            0.85            1.38            1.39            1.10            1.21           41.93
   log(faktury)       log(staz)           proba        ma_kadry      ma_magazyn      ma_raporty
           1.06            0.81            2.00            1.67            3.31            1.32
   modul n_ucz kupili_ucz_proc n_test kupili_test kupili_test_proc przewid_proc   AUC AUC_dolna AUC_gorna kal_wyraz
   kadry  6952            10.8   3596         351              9.8          9.8 0.697     0.668     0.726     -0.01
 magazyn  6840            10.2   3615         326              9.0          8.9 0.738     0.708     0.768      0.02
   sklep  7958             4.5   4372         149              3.4          4.3 0.790     0.749     0.830     -0.26
 raporty  8269             2.7   4595         132              2.9          2.9 0.688     0.643     0.734     -0.02
 kal_nachylenie gorne10_proc lift10 lift_dolna lift_gorna
           0.95         23.6   2.42       2.01       2.82
           0.94         27.1   3.00       2.59       3.46
           1.07         15.3   4.49       3.77       5.35
           0.88          7.8   2.72       2.05       3.42
6. Następny najlepszy moduł: Rysunek 5
R
# Rysunek 5. „Następny najlepszy moduł”: najwyższa szansa p czy najwyższa oczekiwana wartość p × marża?
# (korzysta z k, moduly, marza, test, kol i motyw z przepisów 1 i 5)
library(ggplot2)
library(patchwork)

# Macierz szans w miesiącu testowym (30): wiersz = klient, kolumna = moduł; NA = klient już ma moduł
ids <- sort(unique(unlist(lapply(test, `[[`, "id"))))
P <- Y <- matrix(NA, length(ids), 4, dimnames = list(ids, moduly))
for (j in moduly) { P[as.character(test[[j]]$id), j] <- test[[j]]$p; Y[as.character(test[[j]]$id), j] <- test[[j]]$y }
EV <- sweep(P, 2, marza[moduly], "*")                       # oczekiwana marża roczna z oferty = p × marża
wybor <- function(S) moduly[apply(S, 1, function(r) which.max(replace(r, is.na(r), -Inf)))]
wyb_p <- wybor(P); wyb_ev <- wybor(EV)
cat("Klienci w miesiącu 30 z co najmniej jednym modułem do kupienia:", length(ids), "\n")
cat("Wybrany moduł – reguła najwyższego p:\n"); print(table(factor(wyb_p, moduly)))
cat("Wybrany moduł – reguła najwyższego p × marża:\n"); print(table(factor(wyb_ev, moduly)))
cat("Inna oferta niż przy najwyższym p:", sum(wyb_p != wyb_ev), "klientów =", round(100 * mean(wyb_p != wyb_ev), 1), "%\n")
r <- seq_along(ids)
wart <- function(w, M) M[cbind(r, match(w, moduly))]
cat("Oczekiwana marża na 1000 klientów (z modelu): najwyższe p", round(1000 * mean(wart(wyb_p, EV))),
    "zł | najwyższe p × marża", round(1000 * mean(wart(wyb_ev, EV))), "zł\n")
# zrealizowane zakupy wskazanego modułu w miesiącach 31–36 (bez żadnej kampanii!)
zre_p <- wart(wyb_p, Y) * marza[wyb_p]; zre_ev <- wart(wyb_ev, Y) * marza[wyb_ev]
cat("Trafność wskazania (kupił wskazany moduł w 6 mies.): najwyższe p", round(100 * mean(wart(wyb_p, Y)), 1),
    "% | p × marża", round(100 * mean(wart(wyb_ev, Y)), 1), "%\n")
set.seed(7676)
roz <- replicate(1000, { i <- sample.int(length(r), replace = TRUE); 1000 * (mean(zre_ev[i]) - mean(zre_p[i])) })
cat("Zrealizowana marża na 1000 klientów: najwyższe p", round(1000 * mean(zre_p)), "zł | p × marża",
    round(1000 * mean(zre_ev)), "zł | różnica", round(1000 * (mean(zre_ev) - mean(zre_p))),
    "zł, 95% CI (bootstrap 1000) [", round(quantile(roz, .025)), ",", round(quantile(roz, .975)), "]\n")

# Przykładowy klient: reguły wskazują różne moduły, wszystkie cztery moduły do kupienia
kand <- which(wyb_p == "magazyn" & wyb_ev == "kadry" & rowSums(is.na(P)) == 0)
ten <- kand[which.max(P[kand, "magazyn"] - P[kand, "kadry"])]   # największa przewaga Magazynu w p
cat("Przykładowy klient nr", ids[ten], "\n")
print(k[k$id == ids[ten], c("pracownicy", "branza", "towary", "internet", "faktury", "start")])
print(round(rbind(p_proc = 100 * P[ten, ], marza_zl = marza[moduly], p_x_marza_zl = EV[ten, ]), 1))

nazwy <- c(kadry = "Kadry i płace", magazyn = "Magazyn", sklep = "Sklep internetowy", raporty = "Raporty")
kl <- data.frame(modul = factor(nazwy, rev(nazwy)), p = P[ten, ], ev = EV[ten, ], kod = moduly)
pa <- ggplot(kl, aes(p, modul, fill = kod)) + geom_col(width = 0.6) +
  geom_text(aes(label = sprintf("%.1f%%", 100 * p)), hjust = -0.15, size = 3.6) +
  scale_fill_manual(values = kol[moduly], guide = "none") +
  scale_x_continuous(labels = function(x) paste0(round(100 * x), "%"), expand = expansion(mult = c(0, 0.3))) +
  labs(title = "A. Jeden klient: szansa zakupu", x = "p (6 miesięcy)", y = NULL) + motyw
pb <- ggplot(kl, aes(ev, modul, fill = kod)) + geom_col(width = 0.6) +
  geom_text(aes(label = sprintf("%.0f zł", ev)), hjust = -0.15, size = 3.6) +
  scale_fill_manual(values = kol[moduly], guide = "none") +
  scale_x_continuous(expand = expansion(mult = c(0, 0.3))) +
  labs(title = "B. Ten sam klient: p × marża", x = "oczekiwana marża roczna (zł)", y = NULL) + motyw +
  theme(axis.text.y = element_blank())
ile <- rbind(data.frame(regula = "najwyższe p", modul = wyb_p), data.frame(regula = "najwyższe p × marża", modul = wyb_ev))
ile$modul <- factor(ile$modul, moduly)
ile$regula <- factor(ile$regula, c("najwyższe p × marża", "najwyższe p"))
pc <- ggplot(ile, aes(y = regula, fill = modul)) + geom_bar(position = position_fill(reverse = TRUE), width = 0.6) +
  scale_fill_manual(values = kol[moduly], labels = nazwy, name = NULL) +
  scale_x_continuous(labels = function(x) paste0(round(100 * x), "%"), breaks = seq(0, 1, 0.25)) +
  annotate("text", x = 1.03, y = 2:1, hjust = 0, size = 3.5, colour = "#0f1d3a", lineheight = 0.95,
           label = sprintf("zrealizowana marża:\n%s zł na 1000 klientów",
                           format(round(1000 * c(mean(zre_p), mean(zre_ev))), big.mark = " "))) +
  coord_cartesian(xlim = c(0, 1.42)) +
  labs(title = "C. Wszyscy klienci w miesiącu 30: który moduł zaproponować", x = "% klientów", y = NULL) +
  motyw
p5 <- (pa | pb) / pc + plot_layout(heights = c(1.5, 1))
p5                       # do pliku: ggsave("sprzedaz-krzyzowa-nastepny-modul.svg", p5, width = 10, height = 6.8)
Wynik w R
Klienci w miesiącu 30 z co najmniej jednym modułem do kupienia: 4983
Wybrany moduł – reguła najwyższego p:

  kadry magazyn   sklep raporty
   2245    1594     641     503
Wybrany moduł – reguła najwyższego p × marża:

  kadry magazyn   sklep raporty
   2918    1431     456     178
Inna oferta niż przy najwyższym p: 959 klientów = 19.2 %
Oczekiwana marża na 1000 klientów (z modelu): najwyższe p 106497 zł | najwyższe p × marża 110506 zł
Trafność wskazania (kupił wskazany moduł w 6 mies.): najwyższe p 11.9 % | p × marża 11.8 %
Zrealizowana marża na 1000 klientów: najwyższe p 103753 zł | p × marża 110937 zł | różnica 7184 zł, 95% CI (bootstrap 1000) [ 3311 , 10918 ]
Przykładowy klient nr 91
   pracownicy branza towary internet faktury start
91         10 handel   0.79     0.33     124    29
              kadry magazyn sklep raporty
p_proc         26.0    36.7   8.5     4.3
marza_zl     1200.0   700.0 500.0   300.0
p_x_marza_zl  311.5   256.7  42.3    12.8
7. Przeciek z wersji próbnej i pakiety od razu: Rysunek 6
R
# Rysunek 6. Przeciek: „używał funkcji modułu” wzięte z bazy na dziś zamiast ze stanu na dzień prognozy
# (korzysta z k, moduly, kol, motyw, stan(), wzor(), modele i test z przepisów 1 i 5; bez losowania)
library(ggplot2)
library(pROC)
library(survival)

auc_ci <- function(y, p) as.numeric(ci.auc(roc(y, p, quiet = TRUE)))
wyn <- do.call(rbind, lapply(moduly, function(j) {
  ucz_p <- do.call(rbind, lapply(c(12, 18, 24), stan, j = j, przeciek = TRUE))
  m_p <- glm(wzor(j), family = binomial, data = ucz_p)
  t_p <- stan(30, j, przeciek = TRUE)                       # test z tą samą (błędną) cechą – „raport”
  p1 <- predict(m_p, t_p, type = "response"); a1 <- auc_ci(t_p$y, p1)
  p2 <- predict(m_p, test[[j]], type = "response"); a2 <- auc_ci(test[[j]]$y, p2)  # ten sam model na danych z dnia prognozy
  a3 <- auc_ci(test[[j]]$y, test[[j]]$p)                                   # model uczciwy z przepisu 5
  cat(j, ": iloraz szans dla „używał funkcji” – z przeciekiem", round(exp(coef(m_p)["proba"]), 1),
      "| uczciwie", round(exp(coef(modele[[j]])["proba"]), 2), "\n")
  data.frame(modul = j, wariant = c("z przeciekiem – raport z testu", "z przeciekiem – po wdrożeniu", "bez przecieku"),
             AUC = c(a1[2], a2[2], a3[2]), dolna = c(a1[1], a2[1], a3[1]), gorna = c(a1[3], a2[3], a3[3]),
             przewid_proc = 100 * c(mean(p1), mean(p2), mean(test[[j]]$p)), kupilo_proc = 100 * mean(test[[j]]$y)) }))
print(transform(wyn, AUC = round(AUC, 3), dolna = round(dolna, 3), gorna = round(gorna, 3),
                przewid_proc = round(przewid_proc, 1), kupilo_proc = round(kupilo_proc, 1)), row.names = FALSE)

# Druga pułapka: klienci z pakietem od razu policzeni jako „dokupienie w miesiącu 0”
wsz <- k
pierwszy <- apply(wsz[paste0("kup_", moduly)], 1, function(m) if (all(is.na(m))) NA else min(m, na.rm = TRUE))
wsz$czas <- ifelse(is.na(pierwszy), 36 - wsz$start, pierwszy - wsz$start); wsz$zd <- as.integer(!is.na(pierwszy))
s_wsz <- summary(survfit(Surv(czas, zd) ~ 1, data = wsz), times = c(1, 12))
cat("Z pakietami jako dokupieniem w miesiącu 0: dokupiło do miesiąca 1:", round(100 * (1 - s_wsz$surv[1]), 1),
    "% | do miesiąca 12:", round(100 * (1 - s_wsz$surv[2]), 1), "%\n")
cat("Pakiety od razu – liczba modułów:"); print(table(rowSums(!is.na(k[k$pakiet_start == 1, paste0("kup_", moduly)]))))

nazwy <- c(kadry = "Kadry i płace", magazyn = "Magazyn", sklep = "Sklep internetowy", raporty = "Raporty")
wyn$modul_f <- factor(nazwy[wyn$modul], rev(nazwy))
wyn$wariant <- factor(wyn$wariant, c("z przeciekiem – raport z testu", "z przeciekiem – po wdrożeniu", "bez przecieku"))
p6 <- ggplot(wyn, aes(AUC, modul_f, colour = wariant, shape = wariant)) +
  geom_vline(xintercept = 0.5, linetype = 3, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, linewidth = 0.8, orientation = "y",
                position = position_dodge(width = 0.6, reverse = TRUE)) +
  geom_point(size = 3, position = position_dodge(width = 0.6, reverse = TRUE)) +
  scale_colour_manual(values = unname(kol[c("magazyn", "szary", "kadry")]), name = NULL) +
  scale_shape_manual(values = c(17, 15, 16), name = NULL) +
  scale_x_continuous(limits = c(0.45, 1), breaks = seq(0.5, 1, 0.1)) +
  labs(title = "Przeciek z wersji próbnej: AUC w raporcie a po wdrożeniu",
       subtitle = "Test: stan z miesiąca 30, zakup w miesiącach 31–36; 95% przedział DeLonga",
       x = "pole pod krzywą ROC (AUC)", y = NULL) +
  motyw + guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
p6                       # do pliku: ggsave("sprzedaz-krzyzowa-przeciek.svg", p6, width = 10, height = 5.6)
Wynik w R
kadry : iloraz szans dla „używał funkcji” – z przeciekiem 8.5 | uczciwie 1.85
magazyn : iloraz szans dla „używał funkcji” – z przeciekiem 8.1 | uczciwie 1.69
sklep : iloraz szans dla „używał funkcji” – z przeciekiem 15.6 | uczciwie 2
raporty : iloraz szans dla „używał funkcji” – z przeciekiem 26.4 | uczciwie 3.32
   modul                        wariant   AUC dolna gorna przewid_proc kupilo_proc
   kadry z przeciekiem – raport z testu 0.869 0.850 0.889          7.5         9.8
   kadry   z przeciekiem – po wdrożeniu 0.682 0.653 0.710          5.6         9.8
   kadry                  bez przecieku 0.697 0.668 0.726          9.8         9.8
 magazyn z przeciekiem – raport z testu 0.871 0.849 0.892          7.2         9.0
 magazyn   z przeciekiem – po wdrożeniu 0.714 0.684 0.743          5.1         9.0
 magazyn                  bez przecieku 0.738 0.708 0.768          8.9         9.0
   sklep z przeciekiem – raport z testu 0.918 0.892 0.944          3.0         3.4
   sklep   z przeciekiem – po wdrożeniu 0.782 0.742 0.822          2.2         3.4
   sklep                  bez przecieku 0.790 0.749 0.830          4.3         3.4
 raporty z przeciekiem – raport z testu 0.909 0.878 0.940          2.0         2.9
 raporty   z przeciekiem – po wdrożeniu 0.677 0.630 0.724          1.5         2.9
 raporty                  bez przecieku 0.688 0.643 0.734          2.9         2.9
Z pakietami jako dokupieniem w miesiącu 0: dokupiło do miesiąca 1: 15.3 % | do miesiąca 12: 52 %
Pakiety od razu – liczba modułów:
  2   3   4
 67 107 263
8. Sprawdzenie palety pod kątem zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "niebieski – zielony" = c("#0072B2", "#009E73"),
             "pomarańczowy – zielony" = c("#D55E00", "#009E73"), "różowy – niebieski" = c("#CC79A7", "#0072B2"),
             "różowy – pomarańczowy" = c("#CC79A7", "#D55E00"), "różowy – zielony" = c("#CC79A7", "#009E73"),
             "szary – żółty" = c("#999999", "#E69F00"), "szary – niebieski" = c("#999999", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
niebieski – zielony                         70.1         55.4       58.0
pomarańczowy – zielony                     102.4         53.5       37.3
różowy – niebieski                          53.6         42.0       22.5
różowy – pomarańczowy                       74.3         70.2       71.9
różowy – zielony                            87.5         18.1       36.2
szary – żółty                               76.8         73.9       70.0
szary – niebieski                           44.9         48.9       40.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, regresję logistyczną, przedziały Wilsona i bootstrap obliczono funkcjami pakietu stats (z podstawowej instalacji R), krzywe Kaplana–Meiera i test log-rank – pakietem survival, AUC z przedziałem DeLonga – pakietem pROC. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Odsetek „kiedykolwiek dokupił” bez cenzurowania – 55.0% wobec 64.4% po dwóch latach według Kaplana–Meiera (rysunek 3).
- Macierz jako związek przyczynowy – po kadrach magazyn rzadziej, bo inni klienci (rysunek 2).
- Cechy z bazy na dziś – wersja próbna z okna wyniku zawyża AUC do .87–.92 (rysunek 6).
- Pakiety od razu w ścieżkach – sztuczne remisy i skok krzywej w miesiącu 0.
- Najwyższe p zamiast wartości – tańsze moduły wypierają droższe (rysunek 5).
- Kampania bez grupy kontrolnej – zakupy „i tak” wyglądają jak sukces.
Najczęstsze pytania
Jak zbadać, w jakiej kolejności klienci kupują produkty?
Ułóż zakupy każdego klienta w ścieżkę (pierwszy, drugi, kolejny produkt) i policz macierz: jaki odsetek kupujących X kupił Y w ustalonym czasie po X, z 95% przedziałem Wilsona. Porównaj go z odsetkiem kupujących Y u wszystkich. W przykładzie po module magazynowym sklep internetowy dokupiło 21.9% klientów [19.3, 24.8], wobec 9.2% w pierwszym roku u wszystkich.
Dlaczego do czasu do pierwszego zakupu używać krzywej Kaplana–Meiera?
Bo część klientów zaczęła niedawno i jeszcze nie zdążyła kupić – ich czas jest cenzurowany. Prosty odsetek „kiedykolwiek kupił” to zaniża: w przykładzie 55.0%, podczas gdy krzywa Kaplana–Meiera daje 64.4% po dwóch latach i medianę 13 miesięcy.
Jak ocenić model skłonności do zakupu?
Ucz go na wcześniejszych okresach, a sprawdzaj na późniejszym. Podaj AUC z przedziałem, kalibrację (wyraz wolny i nachylenie, wykres w decylach) i lift w grupie, do której naprawdę trafi kampania, np. w górnych 10%. W przykładzie model dla modułu kadrowego miał AUC .697, nachylenie kalibracji 0.95 i lift 2.42.
Czy proponować klientowi produkt, który najchętniej kupi?
Niekoniecznie. Porównaj oczekiwaną wartość: szansa zakupu × marża. Klient z p = 36.7% dla modułu za 700 zł marży i 26.0% dla modułu za 1200 zł przyniesie średnio więcej przy droższym (312 zł wobec 257 zł). W przykładzie ta reguła zmieniła ofertę u 19.2% klientów i podniosła marżę o 7184 zł na 1000 klientów.
Czy wysoka szansa zakupu z modelu oznacza, że kampania zadziała?
Nie. Model przewiduje zakup, a nie efekt propozycji – klient z wysoką szansą często kupi i bez maila. Żeby zmierzyć przyrost, odłóż losowo część wybranych klientów jako grupę kontrolną i porównaj odsetki zakupów; z kilku takich kampanii można budować model uplift.
Powiązane hasła
Przeczytaj też
Modelowanie uplift: komu wysłać kupon
Przekonywalni, pewniacy i „nie przeszkadzać”: T-learner, las przyczynowy, krzywa Qini i zysk kampanii na przykładzie sklepu z grami, z kodem R.
Czytaj →PoradnikAnaliza koszykowa i rekomendacje
Wsparcie, ufność i lift na przykładzie sklepu z kawą, sieć reguł, test na nowych paragonach i rekomendacje „klienci kupili też” z kodem R.
Czytaj →PoradnikPrzeciek danych i walidacja w czasie
Sieć siłowni i rezygnacje z karnetu: zmienne z przyszłości, losowy podział, wybór zmiennych na szumie i okno przesuwane – pięć rysunków z kodem R.
Czytaj →Piszesz pracę o sprzedaży krzyżowej albo budujesz model skłonności do zakupu?
Pomożemy zaplanować dane klient × miesiąc, walidację w czasie i kalibrację, policzyć lift i wartość oferty oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Ascarza, E. (2018). Retention futility: Targeting high-risk customers might be ineffective. Journal of Marketing Research, 55(1), 80–98. https://doi.org/10.1509/jmr.16.0163 ● Otwarty dostęp: pełny tekst
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Kaufman, S., Rosset, S., Perlich, C., & Stitelman, O. (2012). Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 1–21. https://doi.org/10.1145/2382577.2382579
- Knott, A., Hayes, A., & Neslin, S. A. (2002). Next-product-to-buy models for cross-selling applications. Journal of Interactive Marketing, 16(3), 59–75. https://doi.org/10.1002/dir.10038
- Li, S., Sun, B., & Wilcox, R. T. (2005). Cross-selling sequentially ordered products: An application to consumer banking services. Journal of Marketing Research, 42(2), 233–239. https://doi.org/10.1509/jmkr.42.2.233.62288
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
- Vuk, M., & Curk, T. (2006). ROC curve, lift chart and calibration plot. Advances in Methodology and Statistics, 3(1). https://doi.org/10.51936/noqf3710 ● Otwarty dostęp
Cytowania BibTeX
@article{ascarza2018retention, author={Ascarza, Eva}, title={{Retention futility: Targeting high-risk customers might be ineffective}}, journal={Journal of Marketing Research}, year={2018}, volume={55}, number={1}, pages={80--98}, doi={10.1509/jmr.16.0163}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{kaufman2012leakage, author={Kaufman, Shachar and Rosset, Saharon and Perlich, Claudia and Stitelman, Ori}, title={{Leakage in data mining: Formulation, detection, and avoidance}}, journal={ACM Transactions on Knowledge Discovery from Data}, year={2012}, volume={6}, number={4}, pages={1--21}, doi={10.1145/2382577.2382579}}@article{knott2002next, author={Knott, Aaron and Hayes, Andrew and Neslin, Scott A.}, title={{Next-product-to-buy models for cross-selling applications}}, journal={Journal of Interactive Marketing}, year={2002}, volume={16}, number={3}, pages={59--75}, doi={10.1002/dir.10038}}@article{li2005cross, author={Li, Shibo and Sun, Baohong and Wilcox, Ronald T.}, title={{Cross-selling sequentially ordered products: An application to consumer banking services}}, journal={Journal of Marketing Research}, year={2005}, volume={42}, number={2}, pages={233--239}, doi={10.1509/jmkr.42.2.233.62288}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}@article{vuk2006roc, author={Vuk, Miha and Curk, Tomaž}, title={{ROC curve, lift chart and calibration plot}}, journal={Advances in Methodology and Statistics}, year={2006}, volume={3}, number={1}, doi={10.51936/noqf3710}}