Przykład: sklep z nasionami, cebulkami i roślinami
Fikcyjny sklep internetowy sprzedaje nasiona warzyw i kwiatów, cebulki oraz rośliny w doniczkach. Zarabia na klientach, którzy wracają, więc dział marketingu pyta: ilu nowych klientów robi drugi zakup, kiedy to się dzieje i co przy pierwszym zamówieniu zapowiada powrót?
Mamy 20 000 klientów z pierwszym zakupem od 1 grudnia 2023 do 15 listopada 2026. Stan sprawdzamy 30 listopada 2026. Drugi zakup zrobiło dotąd 7989 osób (39.9%), a 12 011 jeszcze nie wróciło. Prawie połowa (48.7%) przyszła wiosną. O pierwszym zamówieniu wiemy: wartość (mediana 108.56 zł), kategorię (nasiona, cebulki, rośliny), kanał pozyskania (wyszukiwarka internetowa, serwis społecznościowy, polecenie), czy klient użył kodu −15% na pierwszy zakup (34.2%) i czy zaznaczył „zapakuj na prezent” (8.8%).
Wynik to czas od pierwszego do drugiego zakupu, którego większość klientów jeszcze „nie ma” – zadanie dla analizy przeżycia. Procedurę ogólną opisuje wpis Kaplan–Meier i model Coxa krok po kroku. Tu dochodzą dwie rzeczy typowe dla handlu bez umowy: sezon (klienci wracają w kalendarzowym sezonie ogrodniczym, a nie po stałej liczbie dni) i klienci, którzy nie wrócą nigdy. Liczbę przyszłych zakupów aktywnych klientów prognozuje model BG/NBD, a rezygnację z abonamentu opisuje wpis churn jako analiza przeżycia.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Część klientów nie wróci nigdy; tę szansę podnoszą zakup na prezent, rabat i pozyskanie z serwisu społecznościowego, a obniżają polecenie i wyższe zamówienie (prawdziwy udział „nigdy” w całej bazie: 49.4%). Pozostali wracają z dziennym ryzykiem 0.0035 (mnożniki cech – przy kodzie), a mnożnik miesiąca kalendarza waha się od 0.20 w styczniu i 0.25 w lipcu do 2.8 w kwietniu i 2.3 we wrześniu. W pierwszych 21 dniach po zakupie ryzyko stanowi 30% tej wartości. Po pierwszym uruchomieniu wzmocniliśmy mnożniki miesięcy (np. kwiecień 2.5 → 2.8; lista przy kodzie), bo schody były słabo widoczne. Ziarna 766 nie zmienialiśmy. Dane: drugi-zakup-sklep-ogrodniczy.csv.
Rysunek 1: oś klienta – pierwszy zakup, okno, drugi zakup albo cenzurowanie
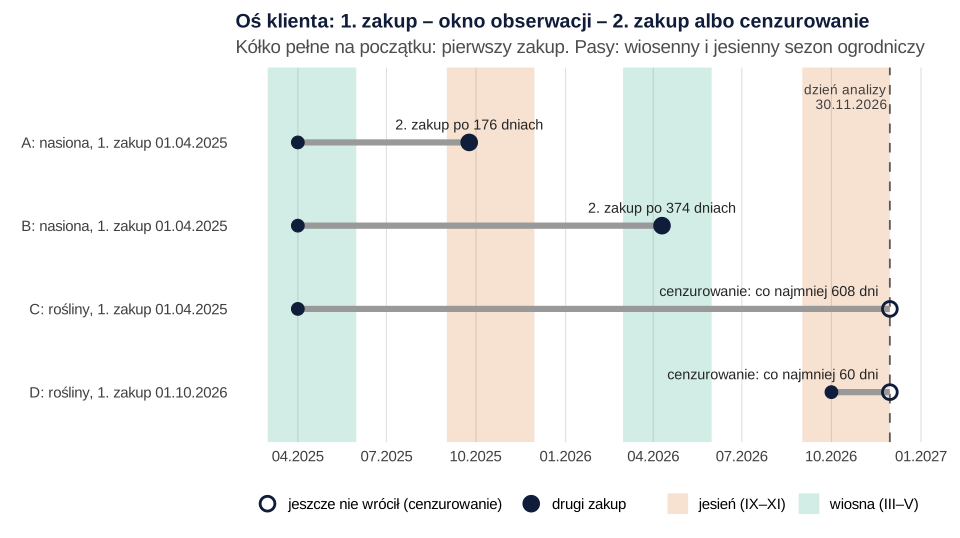
set.seed(766)).Co widać. Klientów wybrano regułą (pierwszy w numeracji spełniający warunek). Zegar rusza w dniu pierwszego zakupu. Klient A wrócił po 176 dniach, B – po 374, choć kupili tego samego dnia: obaj wrócili w sezonie. O kliencie C wiemy tylko, że czeka co najmniej 608 dni, a o D – co najmniej 60. To obserwacje cenzurowane.
Jak może zmylić. C prawdopodobnie nie wróci nigdy, a D nie miał jeszcze szansy – o tym, ile wiemy, decyduje okno obserwacji, nie klient.
Podpis do pracy:
Rysunek 2: odsetek powrotów kohort o różnym czasie obserwacji
Najprostszy raport: odsetek klientów każdej kohorty (kwartału pierwszego zakupu), którzy już wrócili. Analiza kohortowa retencji porównuje za to kohorty w tym samym miesiącu od startu.
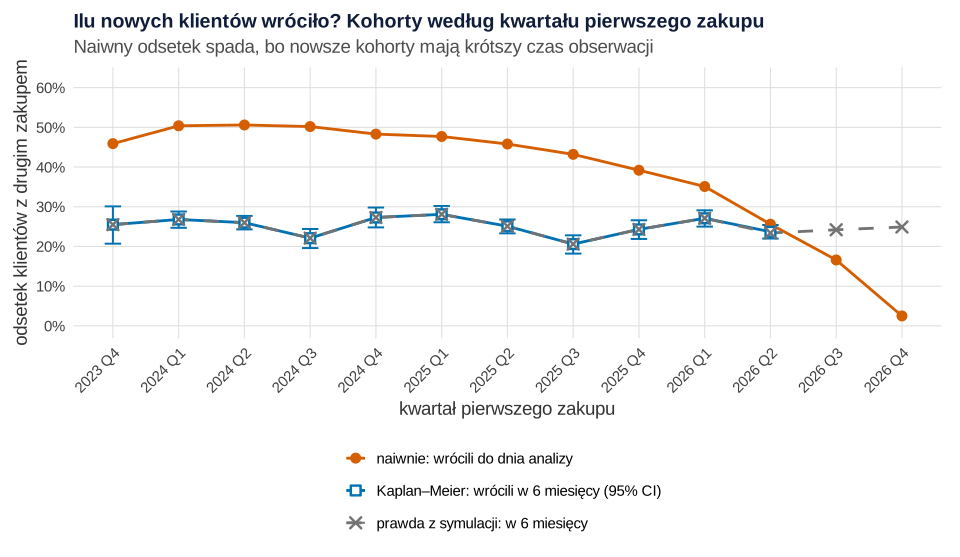
set.seed(766)).Co widać. Naiwny odsetek dla kohort z 2024 roku to około 50%, a dla kohorty z II kwartału 2026 – 25.6%, z III kwartału – 16.6%. To krótszy czas obserwacji, nie gorsze pozyskanie. Porównanie w tym samym horyzoncie, 6 miesięcy od pierwszego zakupu (Kaplan–Meier), daje 20.6–28.1% we wszystkich kohortach; dla II kwartału 2026 to 23.7%, 95% CI [22.0, 25.4], przy prawdzie 23.4%.
Jak może zmylić. Nawet w tym samym horyzoncie kohorty letnie wracają rzadziej (22.1% i 20.6% wobec 26.8% i 28.1% dla kohort z I kwartału), bo ich 6 miesięcy obejmuje zimę. Porównuj kohorty z tej samej pory roku – rok do roku.
Podpis do pracy:
Rysunek 3: krzywe Kaplana–Meiera rosną schodami
Dopełnienie krzywej Kaplana–Meiera (1 − KM) pokazuje odsetek klientów z drugim zakupem po t miesiącach. Porównujemy cztery pojedyncze miesiące pierwszego zakupu – trzymiesięczne pory roku rozmyłyby schody (Kaplan i Meier, 1958).
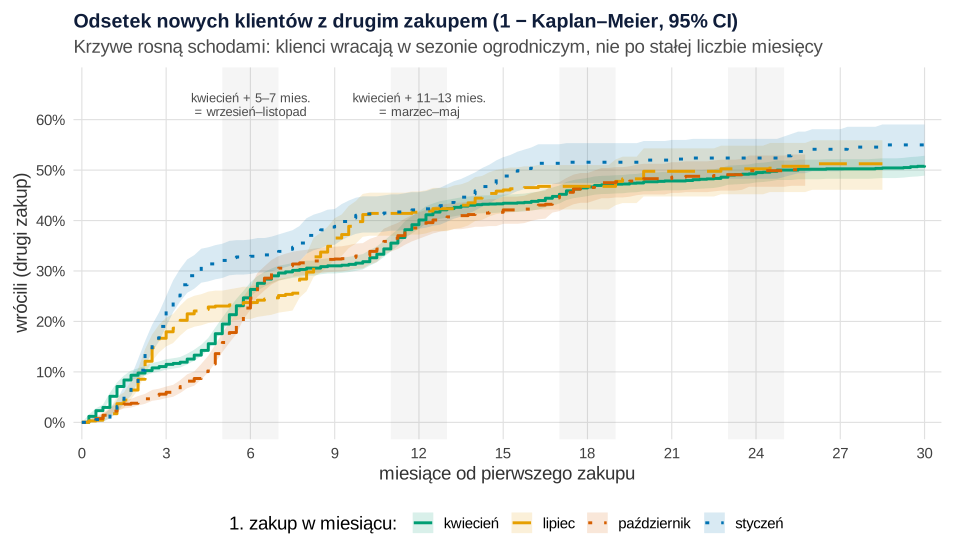
set.seed(766)).Co widać. Klienci z kwietnia po 5 miesiącach mają 19.5% powrotów, po 7 – już 29.6%: wrzesień i październik to sezon cebulek. Potem krzywa stoi przez zimę (31.0% po 9 miesiącach) i znów skacze wiosną, do 40.1%, 95% CI [38.4, 41.8], po roku. Klienci ze stycznia wracają od razu (32.1% po 5 miesiącach), z października – najpierw prawie wcale (6.0% po 3 miesiącach). W całej bazie 68% drugich zakupów przypadło na marzec–kwiecień albo wrzesień–październik.
Jak może zmylić. Po dwóch latach krzywe zbiegają się przy 50%, więc test log-rank dla czterech pór roku pierwszego zakupu daje tylko χ²(3) = 8.2, p = .04 – krzywe się przecinają. Mediany często nie ma (połowa nie wróci) – podawaj odsetki po 6, 12 i 24 miesiącach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: kiedy klienci wracają – szczyt hazardu
Hazard to szansa powrotu w danym miesiącu wśród klientów, którzy jeszcze czekają: powroty podzielone przez miesiące oczekiwania z danych „klient × miesiąc kalendarzowy” (262 268 wierszy).
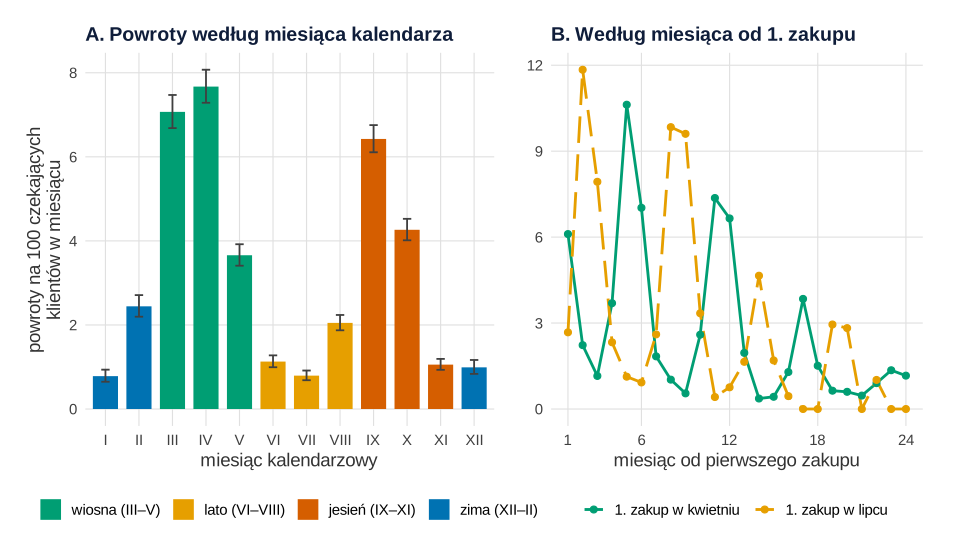
set.seed(766)).Co widać. W kwietniu wraca 7.7 na 100 czekających klientów, 95% CI [7.3, 8.1], we wrześniu 6.4 [6.1, 6.8], a w styczniu i lipcu – 0.8. W czasie od pierwszego zakupu (panel B) klienci z kwietnia mają szczyt w 5. miesiącu (10.6 na 100), klienci z lipca – w 2. (11.8). Reguła „przypomnienie 60 dni po zakupie” trafi jednych w szczyt, a innych w zimę.
Jak może zmylić. Kolejne szczyty są coraz niższe, choć sezon jest co roku taki sam. W grupie czekających coraz większą część stanowią klienci, którzy nie wrócą nigdy (rysunek 6). Spadający hazard nie znaczy, że klient „stygnie”.
Podpis do pracy:
Rysunek 5: model Coxa – pora roku przy zakupie czy pora roku teraz
Model Coxa (Cox, 1972) opisuje, jak cechy pierwszego zamówienia zmieniają tempo powrotu: iloraz hazardów HR > 1 to szybszy (lub częstszy) powrót. Model A ma porę roku pierwszego zakupu jako zwykłą zmienną, model B – porę roku w każdym miesiącu oczekiwania, czyli zmienną zależną od czasu (Fisher i Lin, 1999) na danych „klient × miesiąc”.
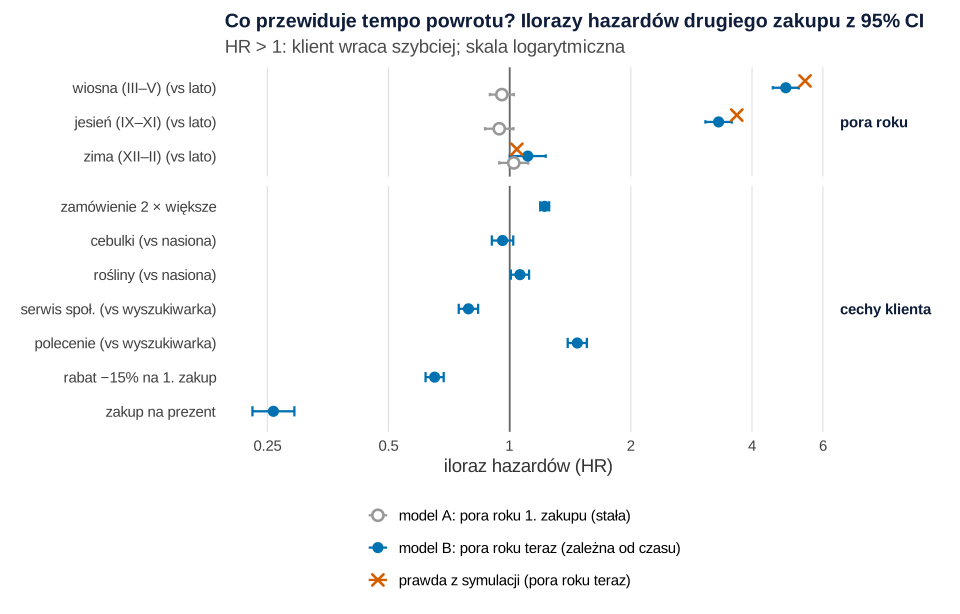
set.seed(766)).Co widać. Według modelu A pora roku nie ma znaczenia (HR 0.94–1.02). Reszty Schoenfelda mówią jednak, że jej efekt zmienia się w czasie: χ²(3) = 55.3, p < .001 (Grambsch i Therneau, 1994) – to schody z rysunku 3. Model B pokazuje sezon wprost: wiosną klienci wracają 4.85 raza szybciej niż latem, 95% CI [4.51, 5.23], jesienią 3.30 raza [3.06, 3.56] (prawda: 5.42 i 3.67). Cechy klienta są w obu modelach takie same: polecenie HR = 1.47 [1.39, 1.55], dwa razy większe zamówienie 1.22 [1.19, 1.25], rabat 0.65 [0.62, 0.69], zakup na prezent 0.26 [0.23, 0.29].
Jak może zmylić. HR sezonu jest trochę za niski, a test nadal coś wykrywa (globalnie χ²(10) = 70.0, p < .001; przy 20 000 klientów wychwytuje małe odchylenia), bo wśród czekających przybywa klientów, którzy nie wrócą nigdy. HR = 0.26 dla prezentu łączy „czy wróci” i „jak szybko”. Model z warstwami według miesiąca pierwszego zakupu (strata()) też usunie problem, ale nie poda efektu sezonu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: klienci, którzy nie wrócą nigdy
Krzywa „jeszcze nie wrócili” nie spada do zera, tylko się wypłaszcza, a zwykłe modele zakładają, że wróci każdy. Model frakcji wyleczonych (cure model) dzieli klientów na tych, którzy kiedyś wrócą, i „nigdy”; przegląd takich modeli podają Amico i Van Keilegom (2018). Dopasowujemy najprostszą wersję: frakcja „nigdy” zależy od prezentu i rabatu, a czas powrotu pozostałych ma rozkład Weibulla.
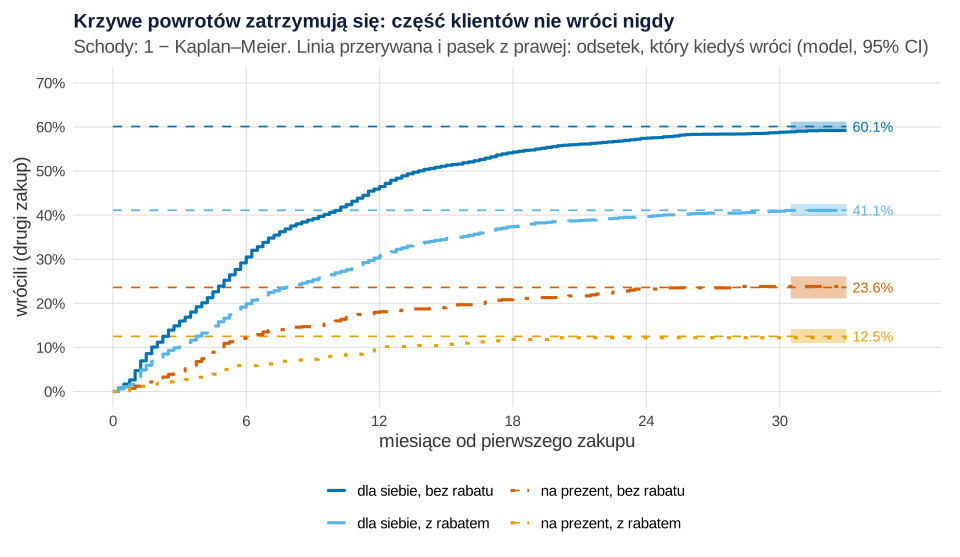
set.seed(766)).Co widać. Nigdy nie wróci według modelu 39.9%, 95% CI [38.8, 41.0], klientów kupujących dla siebie bez rabatu, 58.9% [57.5, 60.2] z rabatem, 76.4% [73.9, 78.9] kupujących na prezent i 87.5% [85.8, 89.0] kupujących na prezent z rabatem. Prawda w symulacji: 40.2%, 58.2%, 76.8% i 88.5%. Prezent zwiększa szansę „nigdy” 4.87 raza (iloraz szans, 95% CI [4.24, 5.60]).
Jak może zmylić. Frakcję widać dopiero, gdy krzywa stoi – tu po około 2 latach; ze świeżych kohort jej nie oszacujesz. Rabat ma w tym prostym modelu iloraz szans 2.16 [2.01, 2.32], ale część tego efektu to kanał pozyskania – rabatu częściej używają klienci z serwisu społecznościowego. Pełniejszy przykład z regresją dla obu części modelu opisuje wpis okres próbny i freemium.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Przypomnienie przed sezonem, nie po liczbie dni. Szczyty hazardu to marzec–kwiecień i wrzesień. Wyślij wiadomość pod koniec lutego i sierpnia wszystkim, którzy jeszcze nie wrócili. Czy działa, sprawdź na losowej grupie bez wysyłki – jak w teście wyłączenia reklamy.
- Raportuj odsetek powrotów w 6 i 12 miesięcy z Kaplana–Meiera, porównując kohorty z tej samej pory roku, a nie odsetek „wróconych do dziś” (rysunek 2).
- Klientów z prezentem licz osobno. Ponad trzy czwarte z nich nie wróci; wliczeni do średniej zaniżą powroty.
- Rabat powitalny oceń na wartości klienta, nie na liczbie pierwszych zamówień. Klienci z rabatem częściej nie wracają; podobny wzór opisał Lewis (2006) na danych sklepu spożywczego i wydawnictwa. Rachunek wartości opisuje wpis wartość klienta w czasie (CLV), a skutki rabatu w abonamencie – rabat na pierwszy miesiąc a rezygnacje.
Model opisuje związek, nie przyczynę: rabat może przyciągać innych klientów, a nie ich zmieniać. Polecenie i wyższe pierwsze zamówienie zapowiadają szybszy powrót. Powracający klient nie musi też być zyskowny (Reinartz i Kumar, 2000) – dołóż marżę. Eksperyment w tym samym typie sklepu opisuje wpis czas ładowania strony a konwersja, a inne tematy prac – statystyka w pracy z marketingu.
Jak opisać w pracy
Tabela do Wyników:
| Pierwszy zakup | n | Nie wróci nigdy – model (%) | 95% CI | Bez powrotu po 30 mies. – KM (%) |
|---|---|---|---|---|
| Dla siebie, bez rabatu | 11 986 | 39.9 | [38.8, 41.0] | 41.2 |
| Dla siebie, z rabatem | 6245 | 58.9 | [57.5, 60.2] | 59.1 |
| Na prezent, bez rabatu | 1170 | 76.4 | [73.9, 78.9] | 76.2 |
| Na prezent, z rabatem | 599 | 87.5 | [85.8, 89.0] | 87.8 |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy 1–6 po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, a kolejne korzystają z obiektów poprzednich. Przepis 7 jest samodzielny. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 i 6 – każdy zaczyna się od własnego set.seed(766) (w przepisie 6 losowanie służy tylko przedziałom ufności frakcji, 1000 losowań parametrów). Ziarno 766 ustalono raz i nie zmieniano go. Pozostałe przepisy nie losują. Ręcznie ustalono (przepis 1): okres i liczbę klientów (20 000), sezonowość pozyskania, udziały kategorii w miesiącach, kanałów, rabatu i prezentu, rozkład wartości zamówienia, parametry szansy „nigdy”, dzienne ryzyko powrotu 0.0035 z mnożnikami cech, niższe ryzyko w pierwszych 21 dniach i mnożniki miesięcy kalendarza. Po pierwszym uruchomieniu zmieniono tylko te ostatnie: z (0.30, 0.90, 2.20, 2.50, 1.40, 0.50, 0.35, 0.80, 2.00, 1.60, 0.50, 0.45) na (0.20, 0.70, 2.40, 2.80, 1.30, 0.35, 0.25, 0.60, 2.30, 1.70, 0.40, 0.35) dla stycznia–grudnia, żeby schody były wyraźniejsze; rysunek 3 pierwotnie łączył miesiące w pory roku. Kolumny p_nigdy, wroci, lam i t_prawdziwy to ukryty mechanizm, którego sklep nie zna – używają go tylko porównania z prawdą; w pliku CSV ich nie ma. Cały kod liczy się w kilkanaście sekund.
1. Dane i oś klienta: Rysunek 1
R
# Rysunek 1. Fikcyjny sklep internetowy z nasionami, cebulkami i roślinami: nowi klienci i oś czasu klienta
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii; sprawdzenie w przepisie 7) i prosty motyw
kol_sezon <- c("wiosna (III–V)" = "#009E73", "lato (VI–VIII)" = "#E69F00",
               "jesień (IX–XI)" = "#D55E00", "zima (XII–II)" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Nowi klienci z pierwszym zakupem od 1 grudnia 2023 do 15 listopada 2026; dzień analizy 30 listopada 2026.
# Wszystkie parametry ustalono ręcznie.
set.seed(766)                                     # ziarno ustalone raz, bez dobierania pod wynik
start <- as.Date("2023-12-01"); koniec_zakupow <- as.Date("2026-11-15"); analiza <- as.Date("2026-11-30")
dni <- seq(start, koniec_zakupow, by = "day")
# pozyskanie nowych klientów: dużo wiosną, mniej jesienią, mało latem i zimą (względna liczba na dzień)
pozysk_mies <- c(0.45, 0.9, 2.1, 2.4, 1.7, 0.7, 0.45, 0.55, 1.3, 1.25, 0.55, 0.6)
k <- 20000
klienci <- data.frame(klient = sprintf("N%05d", 1:k),
                      pierwszy = sort(sample(dni, k, replace = TRUE,
                                             prob = pozysk_mies[as.integer(format(dni, "%m"))])))
m1 <- as.integer(format(klienci$pierwszy, "%m"))
klienci$sezon1 <- factor(names(kol_sezon)[c(4, 4, 1, 1, 1, 2, 2, 2, 3, 3, 3, 4)[m1]], names(kol_sezon))
# kategoria 1. zamówienia zależy od pory roku: wiosną nasiona i rośliny, jesienią cebulki
p_kat <- rbind(nasiona = c(.55, .60, .50, .35, .25, .20, .20, .25, .15, .15, .30, .45),
               cebulki = c(.10, .10, .15, .15, .10, .10, .15, .30, .60, .60, .35, .15))
p_kat <- rbind(p_kat, rosliny = 1 - colSums(p_kat))
u <- runif(k)
klienci$kategoria <- factor(ifelse(u < p_kat["nasiona", m1], "nasiona",
                                   ifelse(u < p_kat["nasiona", m1] + p_kat["cebulki", m1], "cebulki", "rośliny")),
                            c("nasiona", "cebulki", "rośliny"))
klienci$kanal <- factor(sample(c("wyszukiwarka", "serwis społecznościowy", "polecenie"), k, TRUE, c(.50, .32, .18)),
                        c("wyszukiwarka", "serwis społecznościowy", "polecenie"))
klienci$rabat <- as.integer(runif(k) < ifelse(klienci$kanal == "serwis społecznościowy", 0.55, 0.25))  # kod −15%
klienci$prezent <- as.integer(runif(k) < ifelse(m1 %in% c(5, 12), 0.22, 0.06))     # opcja „zapakuj na prezent”
klienci$wartosc <- round(exp(rnorm(k, log(85) + c(0, 0.25, 0.35)[klienci$kategoria] + 0.4 * klienci$prezent, 0.6)), 2)
klienci$wartosc2 <- log2(klienci$wartosc / 100)   # +1 = zamówienie dwa razy większe

# Ukryty mechanizm (prawda znana, bo dane są fikcyjne)
# a) część klientów nie wróci nigdy (frakcja „nigdy”)
klienci$p_nigdy <- plogis(-0.35 + 1.8 * klienci$prezent + 0.55 * klienci$rabat +
                          0.35 * (klienci$kanal == "serwis społecznościowy") - 0.45 * (klienci$kanal == "polecenie") -
                          0.25 * klienci$wartosc2)
klienci$wroci <- runif(k) > klienci$p_nigdy
# b) u tych, którzy wrócą: dzienne ryzyko powrotu = poziom klienta × pora roku w dniu kalendarza
sezon_kal <- c(0.20, 0.70, 2.40, 2.80, 1.30, 0.35, 0.25, 0.60, 2.30, 1.70, 0.40, 0.35)   # styczeń … grudzień
klienci$lam <- 0.0035 * exp(log(1.25) * (klienci$kategoria == "rośliny") + log(1.10) * klienci$wartosc2 +
                            log(1.20) * (klienci$kanal == "polecenie") - log(1.15) * klienci$rabat)
# dzień po dniu do końca 2028 r. (dalej niż dzień analizy – tylko po to, by znać prawdę)
klienci$t_prawdziwy <- NA_real_
for (d in as.list(seq(start + 1, as.Date("2028-12-31"), by = "day"))) {
  ryzyko <- which(klienci$wroci & is.na(klienci$t_prawdziwy) & klienci$pierwszy < d)
  if (!length(ryzyko)) next
  t <- as.numeric(d - klienci$pierwszy[ryzyko])
  h <- klienci$lam[ryzyko] * sezon_kal[as.integer(format(d, "%m"))] * ifelse(t <= 21, 0.3, 1)
  zdarz <- runif(length(ryzyko)) < h
  klienci$t_prawdziwy[ryzyko[zdarz]] <- t[zdarz]
}

# To, co widzi sklep 30 listopada 2026: czas od 1. zakupu do 2. zakupu albo do dnia analizy (cenzurowanie)
obs <- as.numeric(analiza - klienci$pierwszy)
klienci$status <- as.integer(!is.na(klienci$t_prawdziwy) & klienci$t_prawdziwy <= obs)
klienci$dni <- ifelse(klienci$status == 1, klienci$t_prawdziwy, obs)
klienci$drugi <- as.Date(ifelse(klienci$status == 1, klienci$pierwszy + klienci$dni, NA))
c(klienci = k, wrocilo = sum(klienci$status), cenzurowani = sum(1 - klienci$status))
round(100 * prop.table(table(klienci$sezon1)), 1)
round(100 * prop.table(table(klienci$kategoria)), 1)
round(100 * c(rabat = mean(klienci$rabat), prezent = mean(klienci$prezent), nigdy_prawda = mean(!klienci$wroci)), 1)
quantile(klienci$wartosc, c(.25, .5, .75))
summary(klienci$dni / 30.44)

# Rysunek 1: czterech klientów wybranych regułą (pierwszy w numeracji spełniający warunek)
kw25 <- with(klienci, pierwszy >= as.Date("2025-04-01") & pierwszy <= as.Date("2025-04-30"))
wyb <- c(A = which(kw25 & klienci$status == 1 & klienci$drugi >= as.Date("2025-09-01") &
                     klienci$drugi <= as.Date("2025-11-30"))[1],
         B = which(kw25 & klienci$status == 1 & klienci$drugi >= as.Date("2026-03-01") &
                     klienci$drugi <= as.Date("2026-05-31"))[1],
         C = which(kw25 & klienci$status == 0)[1],
         D = which(klienci$pierwszy >= as.Date("2026-10-01") & klienci$status == 0)[1])
d1 <- klienci[wyb, c("klient", "pierwszy", "drugi", "dni", "status", "kategoria")]
d1$kto <- factor(paste0(names(wyb), ": ", d1$kategoria, ", 1. zakup ", format(d1$pierwszy, "%d.%m.%Y")),
                 rev(paste0(names(wyb), ": ", d1$kategoria, ", 1. zakup ", format(d1$pierwszy, "%d.%m.%Y"))))
d1$koniec <- d1$pierwszy + d1$dni
d1$opis <- ifelse(d1$status == 1, paste0("2. zakup po ", d1$dni, " dniach"),
                  paste0("cenzurowanie: co najmniej ", d1$dni, " dni"))
d1
pasy <- data.frame(od = as.Date(c("2025-03-01", "2025-09-01", "2026-03-01", "2026-09-01")),
                   do = as.Date(c("2025-05-31", "2025-11-30", "2026-05-31", "2026-11-30")),
                   pora = rep(c("wiosna (III–V)", "jesień (IX–XI)"), 2))
p1 <- ggplot(d1) +
  geom_rect(data = pasy, aes(xmin = od, xmax = do, ymin = -Inf, ymax = Inf, fill = pora), alpha = 0.18,
            inherit.aes = FALSE) +
  geom_vline(xintercept = analiza, linetype = "dashed", colour = "grey35") +
  annotate("text", x = analiza, y = 4.55, label = "dzień analizy\n30.11.2026", hjust = 1.05, size = 3.6,
           colour = "grey25", lineheight = 0.9) +
  geom_segment(aes(x = pierwszy, xend = koniec, y = kto, yend = kto), linewidth = 2.2, colour = "grey60") +
  geom_point(aes(pierwszy, kto), size = 4, colour = "#0f1d3a") +
  geom_point(aes(koniec, kto, shape = factor(status)), size = 4.2, stroke = 1.5, colour = "#0f1d3a",
             fill = "#0f1d3a") +
  geom_text(aes(koniec - 12 * (status == 0), kto, label = opis), vjust = -1.25, hjust = ifelse(d1$status == 1, 0.5, 1),
            size = 3.8, colour = "grey15") +
  scale_shape_manual(values = c("0" = 1, "1" = 21), labels = c("0" = "jeszcze nie wrócił (cenzurowanie)",
                                                               "1" = "drugi zakup"), name = NULL) +
  scale_fill_manual(values = c("wiosna (III–V)" = "#009E73", "jesień (IX–XI)" = "#D55E00"), name = NULL) +
  scale_x_date(limits = as.Date(c("2025-03-01", "2026-12-20")), date_breaks = "3 months", date_labels = "%m.%Y") +
  scale_y_discrete(expand = expansion(add = c(0.6, 0.9))) +
  labs(title = "Oś klienta: 1. zakup – okno obserwacji – 2. zakup albo cenzurowanie",
       subtitle = "Kółko pełne na początku: pierwszy zakup. Pasy: wiosenny i jesienny sezon ogrodniczy",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank())
p1
# ggsave("rysunek1-os-klienta.svg", p1, width = 10, height = 5.6)
Wynik w R
    klienci     wrocilo cenzurowani
      20000        7989       12011

wiosna (III–V) lato (VI–VIII) jesień (IX–XI)  zima (XII–II)
          48.7           13.1           23.3           14.8

nasiona cebulki rośliny
   33.0    24.1    42.9
       rabat      prezent nigdy_prawda
        34.2          8.8         49.4
     25%      50%      75%
 71.0475 108.5600 165.6025
    Min.  1st Qu.   Median     Mean  3rd Qu.     Max.
 0.03285  4.23785  8.73850 12.42439 19.57950 35.97241
      klient   pierwszy      drugi dni status kategoria
8896  N08896 2025-04-01 2025-09-24 176      1   nasiona
8922  N08922 2025-04-01 2026-04-10 374      1   nasiona
8898  N08898 2025-04-01       <NA> 608      0   rośliny
19210 N19210 2026-10-01       <NA>  60      0   rośliny
                                  kto     koniec
8896  A: nasiona, 1. zakup 01.04.2025 2025-09-24
8922  B: nasiona, 1. zakup 01.04.2025 2026-04-10
8898  C: rośliny, 1. zakup 01.04.2025 2026-11-30
19210 D: rośliny, 1. zakup 01.10.2026 2026-11-30
                                   opis
8896             2. zakup po 176 dniach
8922             2. zakup po 374 dniach
8898  cenzurowanie: co najmniej 608 dni
19210  cenzurowanie: co najmniej 60 dni
2. Kohorty: naiwny odsetek, Kaplan–Meier i prawda: Rysunek 2
R
# Rysunek 2. Odsetek powrotów kohort o różnym czasie obserwacji: naiwny odsetek, Kaplan–Meier i prawda
# (wymaga obiektów z przepisu 1: klienci, motyw)
library(survival)
klienci$kwartal <- paste0(format(klienci$pierwszy, "%Y"), " Q", (as.integer(format(klienci$pierwszy, "%m")) - 1) %/% 3 + 1)
klienci$mies <- klienci$dni / 30.44                     # czas w miesiącach (30.44 dnia)
kw <- sort(unique(klienci$kwartal))
km6 <- t(sapply(kw, function(q) {
  s <- survfit(Surv(mies, status) ~ 1, subset(klienci, kwartal == q))
  if (max(s$time) < 6) return(c(NA, NA, NA))
  z <- summary(s, times = 6)
  100 * (1 - c(z$surv, z$upper, z$lower))
}))
tab2 <- data.frame(kwartal = kw, n = as.vector(table(klienci$kwartal)[kw]),
                   naiwny = round(100 * tapply(klienci$status, klienci$kwartal, mean)[kw], 1),
                   km_6_mies = round(km6[, 1], 1), dolna = round(km6[, 2], 1), gorna = round(km6[, 3], 1),
                   prawda_6_mies = round(100 * tapply(!is.na(klienci$t_prawdziwy) & klienci$t_prawdziwy <= 6 * 30.44,
                                                      klienci$kwartal, mean)[kw], 1), row.names = NULL)
tab2

d2 <- rbind(data.frame(kwartal = kw, proc = tab2$naiwny, lo = NA, hi = NA, linia = "naiwnie: wrócili do dnia analizy"),
            data.frame(kwartal = kw, proc = tab2$km_6_mies, lo = tab2$dolna, hi = tab2$gorna,
                       linia = "Kaplan–Meier: wrócili w 6 miesięcy (95% CI)"),
            data.frame(kwartal = kw, proc = tab2$prawda_6_mies, lo = NA, hi = NA,
                       linia = "prawda z symulacji: w 6 miesięcy"))
d2$linia <- factor(d2$linia, unique(d2$linia))
p2 <- ggplot(d2, aes(kwartal, proc, colour = linia, shape = linia, group = linia)) +
  geom_line(aes(linetype = linia), linewidth = 1, na.rm = TRUE) +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = 0.25, linewidth = 0.7, na.rm = TRUE) +
  geom_point(size = 3, fill = "white", stroke = 1.3, na.rm = TRUE) +
  scale_colour_manual(values = c("#D55E00", "#0072B2", "grey45"), name = NULL) +
  scale_shape_manual(values = c(16, 22, 4), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "dashed"), name = NULL) +
  scale_y_continuous(limits = c(0, 62), breaks = seq(0, 60, 10), labels = function(x) paste0(x, "%")) +
  guides(colour = guide_legend(nrow = 3), shape = guide_legend(nrow = 3), linetype = guide_legend(nrow = 3)) +
  labs(title = "Ilu nowych klientów wróciło? Kohorty według kwartału pierwszego zakupu",
       subtitle = "Naiwny odsetek spada, bo nowsze kohorty mają krótszy czas obserwacji",
       x = "kwartał pierwszego zakupu", y = "odsetek klientów z drugim zakupem") +
  motyw + theme(axis.text.x = element_text(angle = 45, hjust = 1))
p2
# ggsave("rysunek2-kohorty.svg", p2, width = 10, height = 5.8)
Wynik w R
   kwartal    n naiwny km_6_mies dolna gorna prawda_6_mies
1  2023 Q4  329   45.9      25.5  20.7  30.1          25.5
2  2024 Q1 1841   50.4      26.8  24.7  28.8          26.8
3  2024 Q2 2487   50.6      26.0  24.3  27.7          26.0
4  2024 Q3 1156   50.2      22.1  19.6  24.4          22.1
5  2024 Q4 1241   48.3      27.3  24.8  29.8          27.3
6  2025 Q1 1841   47.7      28.1  26.1  30.2          28.1
7  2025 Q2 2429   45.8      25.1  23.3  26.8          25.1
8  2025 Q3 1187   43.2      20.6  18.2  22.8          20.6
9  2025 Q4 1239   39.2      24.3  21.9  26.6          24.3
10 2026 Q1 1797   35.1      27.1  25.0  29.1          27.1
11 2026 Q2 2482   25.6      23.7  22.0  25.4          23.4
12 2026 Q3 1180   16.6        NA    NA    NA          24.2
13 2026 Q4  791    2.5        NA    NA    NA          24.9
3. Krzywe Kaplana–Meiera według miesiąca pierwszego zakupu: Rysunek 3
R
# Rysunek 3. Krzywe Kaplana–Meiera: odsetek klientów z drugim zakupem według miesiąca pierwszego zakupu
# (wymaga obiektów z przepisów 1–2: klienci z kolumną mies, kol_sezon, motyw)
# Cztery miesiące – po jednym z każdej pory roku, żeby schody nie rozmyły się w trzymiesięcznych grupach
mies_nazwy <- c("1" = "styczeń", "4" = "kwiecień", "7" = "lipiec", "10" = "październik")
klienci$m1 <- as.integer(format(klienci$pierwszy, "%m"))
k3 <- subset(klienci, m1 %in% c(1, 4, 7, 10))
k3$miesiac1 <- factor(mies_nazwy[as.character(k3$m1)], c("kwiecień", "lipiec", "październik", "styczeń"))
km <- survfit(Surv(mies, status) ~ miesiac1, data = k3)
z <- summary(km, times = c(3, 5, 7, 9, 12, 24))
data.frame(miesiac1 = sub("miesiac1=", "", z$strata), miesiac = z$time, w_ryzyku = z$n.risk,
           wrocilo_proc = round(100 * (1 - z$surv), 1), dolna = round(100 * (1 - z$upper), 1),
           gorna = round(100 * (1 - z$lower), 1))
lr <- function(f, d) {                                             # test log-rank: χ², df i p
  t <- survdiff(f, data = d); df <- length(t$n) - 1
  c(chi2 = round(t$chisq, 1), df = df, p = signif(pchisq(t$chisq, df, lower.tail = FALSE), 2))
}
lr(Surv(mies, status) ~ miesiac1, k3)                              # cztery miesiące pierwszego zakupu
lr(Surv(mies, status) ~ sezon1, klienci)                           # cztery pory roku, wszyscy klienci
# Odsetek wszystkich drugich zakupów, które przypadły w marcu–kwietniu albo we wrześniu–październiku
m2 <- as.integer(format(klienci$drugi[klienci$status == 1], "%m"))
round(100 * mean(m2 %in% c(3, 4, 9, 10)), 1)

# krzywe na siatce co tydzień (0.25 miesiąca) – mniejszy plik, schody bez zmian
siatka <- seq(0, 30, by = 0.25)
zs <- summary(km, times = siatka, extend = TRUE)
d3 <- data.frame(mies = zs$time, wrocilo = 100 * (1 - zs$surv), lo = 100 * (1 - zs$upper),
                 hi = 100 * (1 - zs$lower), miesiac1 = factor(sub("miesiac1=", "", zs$strata), levels(k3$miesiac1)))
d3 <- subset(d3, zs$n.risk >= 30)                                  # bez ogona z mniej niż 30 klientami w ryzyku
kol_m <- setNames(kol_sezon, levels(k3$miesiac1))
p3 <- ggplot(d3, aes(mies, wrocilo, colour = miesiac1, fill = miesiac1)) +
  geom_rect(data = data.frame(od = c(5, 11, 17, 23), do = c(7, 13, 19, 25)), inherit.aes = FALSE,
            aes(xmin = od, xmax = do, ymin = -Inf, ymax = Inf), fill = "grey50", alpha = 0.08) +
  geom_ribbon(aes(ymin = lo, ymax = hi), alpha = 0.15, colour = NA) +
  geom_step(aes(linetype = miesiac1), linewidth = 1.05) +
  annotate("text", x = 6, y = 63, label = "kwiecień + 5–7 mies.\n= wrzesień–listopad", size = 3.4,
           colour = "grey30", lineheight = 0.9) +
  annotate("text", x = 12, y = 63, label = "kwiecień + 11–13 mies.\n= marzec–maj", size = 3.4,
           colour = "grey30", lineheight = 0.9) +
  scale_colour_manual(values = kol_m, name = "1. zakup w miesiącu:") +
  scale_fill_manual(values = kol_m, name = "1. zakup w miesiącu:") +
  scale_linetype_manual(values = c("solid", "longdash", "dotdash", "dotted"), name = "1. zakup w miesiącu:") +
  scale_x_continuous(breaks = seq(0, 30, 3), expand = expansion(mult = c(0.01, 0.02))) +
  scale_y_continuous(limits = c(0, 67), breaks = seq(0, 60, 10), labels = function(x) paste0(x, "%")) +
  labs(title = "Odsetek nowych klientów z drugim zakupem (1 − Kaplan–Meier, 95% CI)",
       subtitle = "Krzywe rosną schodami: klienci wracają w sezonie ogrodniczym, nie po stałej liczbie miesięcy",
       x = "miesiące od pierwszego zakupu", y = "wrócili (drugi zakup)") +
  motyw
p3
# ggsave("rysunek3-kaplan-meier.svg", p3, width = 10, height = 5.8)
Wynik w R
      miesiac1 miesiac w_ryzyku wrocilo_proc dolna gorna
1     kwiecień       3     3289         11.5  10.5  12.5
2     kwiecień       5     2992         19.5  18.2  20.7
3     kwiecień       7     2616         29.6  28.1  31.1
4     kwiecień       9     1684         31.0  29.5  32.5
5     kwiecień      12     1462         40.1  38.4  41.8
6     kwiecień      24      609         49.5  47.6  51.4
7       lipiec       3      576         17.9  15.1  20.7
8       lipiec       5      331         23.0  19.9  26.1
9       lipiec       7      322         25.1  21.7  28.4
10      lipiec       9      273         36.5  32.3  40.5
11      lipiec      12      251         41.6  37.2  45.8
12      lipiec      24      100         50.3  45.2  54.8
13 październik       3     1239          6.0   4.8   7.1
14 październik       5     1109         15.8  13.9  17.7
15 październik       7      915         30.6  28.1  33.0
16 październik       9      891         32.4  29.8  34.8
17 październik      12      803         39.1  36.4  41.6
18 październik      24      316         49.9  46.7  52.9
19     styczeń       3      566         22.0  19.0  25.0
20     styczeń       5      493         32.1  28.6  35.4
21     styczeń       7      480         33.9  30.4  37.2
22     styczeń       9      444         38.8  35.2  42.3
23     styczeń      12      276         42.1  38.4  45.6
24     styczeń      24      110         52.4  48.3  56.2
    chi2       df        p
17.90000  3.00000  0.00047
 chi2    df     p
8.200 3.000 0.042
[1] 68
4. Dane „klient × miesiąc” i hazard: Rysunek 4
R
# Rysunek 4. Kiedy klienci wracają: miesięczny hazard powrotu w kalendarzu i w czasie od pierwszego zakupu
# (wymaga obiektów z przepisów 1–3: klienci z kolumnami mies i m1, kol_sezon, motyw)
library(patchwork)
# Dane „klient × miesiąc kalendarzowy”: każdy wiersz to część miesiąca, w której klient czekał na drugi zakup
nr_mies <- function(d) as.integer(format(d, "%Y")) * 12 + as.integer(format(d, "%m")) - 1   # numer miesiąca
data_mies <- function(nr) as.Date(sprintf("%d-%02d-01", nr %/% 12, nr %% 12 + 1))             # jego 1. dzień
n_mies <- nr_mies(klienci$pierwszy + klienci$dni) - nr_mies(klienci$pierwszy) + 1
dl <- klienci[rep(seq_len(nrow(klienci)), n_mies), c("klient", "pierwszy", "dni", "status", "m1", "wartosc2",
                                                     "kategoria", "kanal", "rabat", "prezent", "sezon1")]
nr <- nr_mies(dl$pierwszy) + sequence(n_mies) - 1                 # kolejne miesiące kalendarzowe klienta
dl$od_mies <- data_mies(nr); dl$do_mies <- data_mies(nr + 1)
dl$tstart <- pmax(0, as.numeric(dl$od_mies - dl$pierwszy))
dl$tstop <- pmin(dl$dni, as.numeric(dl$do_mies - dl$pierwszy))
dl$zdarzenie <- as.integer(dl$status == 1 & dl$tstop == dl$dni)
dl <- subset(dl, tstop > tstart)
dl$mies_kal <- as.integer(format(dl$od_mies, "%m"))
c(wiersze = nrow(dl), zdarzenia = sum(dl$zdarzenie))

# A: hazard według miesiąca kalendarzowego (powroty na 100 klientów czekających przez cały miesiąc)
hz <- aggregate(cbind(zdarzenie, narazenie = (tstop - tstart) / 30.44) ~ mies_kal, data = dl, FUN = sum)
ci <- t(mapply(function(x, n) poisson.test(x, n)$conf.int, hz$zdarzenie, hz$narazenie))
hz$na_100 <- 100 * hz$zdarzenie / hz$narazenie; hz$lo <- 100 * ci[, 1]; hz$hi <- 100 * ci[, 2]
cbind(miesiac = month.abb[hz$mies_kal], round(hz[, c("zdarzenie", "narazenie", "na_100", "lo", "hi")], 1))

# B: hazard według miesiąca od pierwszego zakupu dla klientów z kwietnia i z lipca
dl$m_od <- floor(dl$tstart / 30.44) + 1                           # 1 = pierwsze 30 dni po zakupie
hb <- aggregate(cbind(zdarzenie, narazenie = (tstop - tstart) / 30.44) ~ m_od + m1,
                data = subset(dl, m1 %in% c(4, 7) & tstart < 24 * 30.44), FUN = sum)
hb$na_100 <- 100 * hb$zdarzenie / hb$narazenie
hb$miesiac1 <- factor(c("4" = "1. zakup w kwietniu", "7" = "1. zakup w lipcu")[as.character(hb$m1)])
hb[order(hb$m1, -hb$na_100), ][c(1:3, 25:27), c("miesiac1", "m_od", "na_100")]

pora <- c("zima (XII–II)", "zima (XII–II)", rep("wiosna (III–V)", 3), rep("lato (VI–VIII)", 3),
          rep("jesień (IX–XI)", 3), "zima (XII–II)")
hz$pora <- factor(pora[hz$mies_kal], names(kol_sezon))
p4a <- ggplot(hz, aes(factor(mies_kal), na_100, fill = pora)) +
  geom_col(width = 0.75) +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = 0.25, colour = "grey25") +
  scale_x_discrete(labels = c("I", "II", "III", "IV", "V", "VI", "VII", "VIII", "IX", "X", "XI", "XII")) +
  scale_fill_manual(values = kol_sezon, name = NULL) +
  labs(title = "A. Powroty według miesiąca kalendarza", x = "miesiąc kalendarzowy",
       y = "powroty na 100 czekających\nklientów w miesiącu") +
  motyw + theme(legend.position = "none")
p4b <- ggplot(hb, aes(m_od, na_100, colour = miesiac1, linetype = miesiac1)) +
  geom_line(linewidth = 1) + geom_point(size = 2) +
  scale_colour_manual(values = c("#009E73", "#E69F00"), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  scale_x_continuous(breaks = c(1, 6, 12, 18, 24)) +
  labs(title = "B. Według miesiąca od 1. zakupu", x = "miesiąc od pierwszego zakupu", y = NULL) +
  motyw + theme(legend.position = "bottom")
p4 <- p4a + p4b + plot_layout(widths = c(1.1, 1))
p4
# ggsave("rysunek4-hazard.svg", p4, width = 10, height = 5.8)
Wynik w R
  wiersze zdarzenia
   262268      7989
   miesiac zdarzenie narazenie na_100  lo  hi
1      Jan       119   15219.0    0.8 0.6 0.9
2      Feb       355   14532.3    2.4 2.2 2.7
3      Mar      1252   17711.4    7.1 6.7 7.5
4      Apr      1482   19320.7    7.7 7.3 8.1
5      May       804   21979.9    3.7 3.4 3.9
6      Jun       254   22511.8    1.1 1.0 1.3
7      Jul       190   23936.3    0.8 0.7 0.9
8      Aug       500   24403.7    2.0 1.9 2.2
9      Sep      1541   23984.7    6.4 6.1 6.8
10     Oct      1085   25449.0    4.3 4.0 4.5
11     Nov       263   24909.3    1.1 0.9 1.2
12     Dec       144   14529.8    1.0 0.8 1.2
              miesiac1 m_od    na_100
5  1. zakup w kwietniu    5 10.621240
11 1. zakup w kwietniu   11  7.364940
6  1. zakup w kwietniu    6  7.023403
26    1. zakup w lipcu    2 11.841798
32    1. zakup w lipcu    8  9.838807
33    1. zakup w lipcu    9  9.604948
5. Model Coxa: pora roku stała i zależna od czasu: Rysunek 5
R
# Rysunek 5. Model Coxa: pora roku 1. zakupu (stała) czy pora roku „teraz” (zmienna zależna od czasu)
# (wymaga obiektów z przepisów 1–4: klienci, dl, pora, kol_sezon, motyw)
# Model A: wszystkie zmienne mierzone przy pierwszym zakupie, w tym pora roku 1. zakupu (odniesienie: lato)
klienci$pora1 <- relevel(klienci$sezon1, ref = "lato (VI–VIII)")
mA <- coxph(Surv(dni, status) ~ wartosc2 + kategoria + kanal + rabat + prezent + pora1, data = klienci)
round(summary(mA)$conf.int[, c(1, 3, 4)], 2)
cox.zph(mA)                                                        # test proporcjonalności (reszty Schoenfelda)

# Model B: te same zmienne, ale pora roku w danym miesiącu kalendarza jako zmienna zależna od czasu
dl$pora_teraz <- relevel(factor(pora[dl$mies_kal], names(kol_sezon)), ref = "lato (VI–VIII)")
mB <- coxph(Surv(tstart, tstop, zdarzenie) ~ wartosc2 + kategoria + kanal + rabat + prezent + pora_teraz,
            data = dl)
round(summary(mB)$conf.int[, c(1, 3, 4)], 2)
cox.zph(mB)
# Prawda dla pory roku „teraz”: średni mnożnik sezonu z przepisu 1 względem lata
s4 <- tapply(sezon_kal, pora, mean)
round(s4[c("wiosna (III–V)", "jesień (IX–XI)", "zima (XII–II)")] / s4["lato (VI–VIII)"], 2)

nazwy <- c(wartosc2 = "zamówienie 2 × większe", kategoriacebulki = "cebulki (vs nasiona)",
           "kategoriarośliny" = "rośliny (vs nasiona)", "kanalserwis społecznościowy" = "serwis społ. (vs wyszukiwarka)",
           kanalpolecenie = "polecenie (vs wyszukiwarka)", rabat = "rabat −15% na 1. zakup",
           prezent = "zakup na prezent")
ciA <- summary(mA)$conf.int; ciB <- summary(mB)$conf.int
pory <- c("wiosna (III–V)", "jesień (IX–XI)", "zima (XII–II)")
d5 <- rbind(
  data.frame(zmienna = nazwy, hr = ciB[names(nazwy), 1], lo = ciB[names(nazwy), 3], hi = ciB[names(nazwy), 4],
             model = "model B", grupa = "cechy klienta"),
  data.frame(zmienna = paste(pory, "(vs lato)"), hr = ciA[paste0("pora1", pory), 1], lo = ciA[paste0("pora1", pory), 3],
             hi = ciA[paste0("pora1", pory), 4], model = "model A: pora roku 1. zakupu (stała)", grupa = "pora roku"),
  data.frame(zmienna = paste(pory, "(vs lato)"), hr = ciB[paste0("pora_teraz", pory), 1],
             lo = ciB[paste0("pora_teraz", pory), 3], hi = ciB[paste0("pora_teraz", pory), 4],
             model = "model B: pora roku teraz (zależna od czasu)", grupa = "pora roku"),
  data.frame(zmienna = paste(pory, "(vs lato)"), hr = as.numeric(s4[pory] / s4["lato (VI–VIII)"]), lo = NA, hi = NA,
             model = "prawda z symulacji (pora roku teraz)", grupa = "pora roku"))
d5$model[d5$model == "model B"] <- "model B: pora roku teraz (zależna od czasu)"
d5$model <- factor(d5$model, c("model A: pora roku 1. zakupu (stała)", "model B: pora roku teraz (zależna od czasu)",
                               "prawda z symulacji (pora roku teraz)"))
d5$zmienna <- factor(d5$zmienna, rev(unique(d5$zmienna)))
d5$grupa <- factor(d5$grupa, c("pora roku", "cechy klienta"))
p5 <- ggplot(d5, aes(hr, zmienna, colour = model, shape = model)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_errorbar(aes(xmin = lo, xmax = hi), width = 0.3, linewidth = 0.8, orientation = "y", na.rm = TRUE,
                position = position_dodge(width = 0.6)) +
  geom_point(size = 3, fill = "white", stroke = 1.4, position = position_dodge(width = 0.6)) +
  facet_grid(grupa ~ ., scales = "free_y", space = "free_y") +
  scale_x_log10(breaks = c(0.25, 0.5, 1, 2, 4, 6), labels = c("0.25", "0.5", "1", "2", "4", "6")) +
  scale_colour_manual(values = c("#999999", "#0072B2", "#D55E00"), name = NULL) +
  scale_shape_manual(values = c(21, 16, 4), name = NULL) +
  guides(colour = guide_legend(nrow = 3), shape = guide_legend(nrow = 3)) +
  labs(title = "Co przewiduje tempo powrotu? Ilorazy hazardów drugiego zakupu z 95% CI",
       subtitle = "HR > 1: klient wraca szybciej; skala logarytmiczna",
       x = "iloraz hazardów (HR)", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank(), strip.text.y = element_text(angle = 0, hjust = 0))
p5
# ggsave("rysunek5-cox.svg", p5, width = 10, height = 6.4)
Wynik w R
                            exp(coef) lower .95 upper .95
wartosc2                         1.22      1.19      1.25
kategoriacebulki                 0.97      0.90      1.03
kategoriarośliny                 1.04      0.98      1.09
kanalserwis społecznościowy      0.79      0.75      0.84
kanalpolecenie                   1.47      1.39      1.55
rabat                            0.65      0.62      0.69
prezent                          0.26      0.23      0.29
pora1wiosna (III–V)              0.96      0.89      1.02
pora1jesień (IX–XI)              0.94      0.87      1.02
pora1zima (XII–II)               1.02      0.94      1.11
          chisq df       p
wartosc2  10.59  1 0.00114
kategoria 16.52  2 0.00026
kanal      9.13  2 0.01039
rabat      2.21  1 0.13675
prezent    1.70  1 0.19225
pora1     55.29  3 6.0e-12
GLOBAL    82.41 10 1.7e-13
                            exp(coef) lower .95 upper .95
wartosc2                         1.22      1.19      1.25
kategoriacebulki                 0.96      0.90      1.02
kategoriarośliny                 1.06      1.01      1.12
kanalserwis społecznościowy      0.79      0.75      0.83
kanalpolecenie                   1.47      1.39      1.55
rabat                            0.65      0.62      0.69
prezent                          0.26      0.23      0.29
pora_terazwiosna (III–V)         4.85      4.51      5.23
pora_terazjesień (IX–XI)         3.30      3.06      3.56
pora_terazzima (XII–II)          1.11      1.00      1.23
           chisq df       p
wartosc2   16.88  1 4.0e-05
kategoria  36.53  2 1.2e-08
kanal       9.76  2  0.0076
rabat       2.20  1  0.1383
prezent     4.22  1  0.0400
pora_teraz 10.97  3  0.0119
GLOBAL     70.03 10 4.4e-11
wiosna (III–V) jesień (IX–XI)  zima (XII–II)
          5.42           3.67           1.04
6. Frakcja klientów, którzy nie wrócą: Rysunek 6
R
# Rysunek 6. Klienci, którzy nie wrócą nigdy: plateau krzywej i model frakcji „nigdy” (frakcji wyleczonych)
# (wymaga obiektów z przepisów 1–2: klienci z kolumną mies, motyw)
library(flexsurvcure)
klienci$grupa <- factor(paste0(ifelse(klienci$prezent == 1, "na prezent", "dla siebie"),
                               ifelse(klienci$rabat == 1, ", z rabatem", ", bez rabatu")),
                        c("dla siebie, bez rabatu", "dla siebie, z rabatem", "na prezent, bez rabatu",
                          "na prezent, z rabatem"))
table(klienci$grupa)
# Model mieszaninowy: frakcja „nigdy” (logit) zależy od prezentu i rabatu, czas powrotu pozostałych – Weibull
mc <- flexsurvcure(Surv(mies, status) ~ prezent + rabat, data = klienci, dist = "weibull", mixture = TRUE)
mc
round(exp(mc$res[c("prezent", "rabat"), c("est", "L95%", "U95%")]), 2)   # ilorazy szans „nigdy” (OR)
nd <- data.frame(prezent = c(0, 0, 1, 1), rabat = c(0, 1, 0, 1))
set.seed(766)                                     # przedziały z losowania parametrów (B = 1000)
pi_hat <- summary(mc, newdata = nd, type = "survival", t = 1000, B = 1000)   # S(t → ∞) = frakcja „nigdy”
tab6 <- data.frame(grupa = levels(klienci$grupa), n = as.vector(table(klienci$grupa)),
                   nigdy_model = round(100 * sapply(pi_hat, function(x) x$est), 1),
                   dolna = round(100 * sapply(pi_hat, function(x) x$lcl), 1),
                   gorna = round(100 * sapply(pi_hat, function(x) x$ucl), 1),
                   nigdy_km_30_mies = round(100 * summary(survfit(Surv(mies, status) ~ grupa, klienci), times = 30,
                                                          extend = TRUE)$surv, 1),
                   nigdy_prawda = round(100 * tapply(!klienci$wroci, klienci$grupa, mean), 1), row.names = NULL)
tab6

km6 <- survfit(Surv(mies, status) ~ grupa, data = klienci)
z6 <- summary(km6, times = seq(0, 33, by = 0.25), extend = TRUE)
d6 <- data.frame(mies = z6$time, wrocilo = 100 * (1 - z6$surv), n_ryzyko = z6$n.risk,
                 grupa = factor(sub("grupa=", "", z6$strata), levels(klienci$grupa)))
d6 <- subset(d6, n_ryzyko >= 30)
pl6 <- data.frame(grupa = factor(levels(klienci$grupa), levels(klienci$grupa)), wroci = 100 - tab6$nigdy_model,
                  lo = 100 - tab6$gorna, hi = 100 - tab6$dolna)
kol_g <- c("#0072B2", "#56B4E9", "#D55E00", "#E69F00")
p6 <- ggplot(d6, aes(mies, wrocilo, colour = grupa)) +
  geom_rect(data = pl6, aes(xmin = 30.5, xmax = 33, ymin = lo, ymax = hi, fill = grupa), inherit.aes = FALSE,
            alpha = 0.35) +
  geom_segment(data = pl6, aes(x = 0, xend = 33, y = wroci, yend = wroci, colour = grupa), linetype = "dashed",
               linewidth = 0.6) +
  geom_step(aes(linetype = grupa), linewidth = 1.1) +
  geom_text(data = pl6, aes(x = 33, y = wroci, label = sprintf("%.1f%%", wroci), colour = grupa), hjust = -0.15,
            size = 3.8, show.legend = FALSE) +
  scale_colour_manual(values = kol_g, name = NULL) + scale_fill_manual(values = kol_g, guide = "none") +
  scale_linetype_manual(values = c("solid", "longdash", "dotdash", "dotted"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 30, 6), limits = c(0, 35.5)) +
  scale_y_continuous(limits = c(0, 70), breaks = seq(0, 70, 10), labels = function(x) paste0(x, "%")) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "Krzywe powrotów zatrzymują się: część klientów nie wróci nigdy",
       subtitle = "Schody: 1 − Kaplan–Meier. Linia przerywana i pasek z prawej: odsetek, który kiedyś wróci (model, 95% CI)",
       x = "miesiące od pierwszego zakupu", y = "wrócili (drugi zakup)") +
  motyw
p6
# ggsave("rysunek6-nigdy.svg", p6, width = 10, height = 5.8)
Wynik w R
dla siebie, bez rabatu  dla siebie, z rabatem na prezent, bez rabatu
                 11986                   6245                   1170
 na prezent, z rabatem
                   599
Call:
flexsurvcure(formula = Surv(mies, status) ~ prezent + rabat,
    data = klienci, dist = "weibull", mixture = TRUE)

Estimates:
         data mean  est     L95%    U95%    se      exp(est)  L95%    U95%
theta        NA     0.3990  0.3877  0.4104      NA      NA        NA      NA
shape        NA     1.1540  1.1311  1.1774  0.0118      NA        NA      NA
scale        NA     8.5269  8.3048  8.7549  0.1148      NA        NA      NA
prezent  0.0885     1.5839  1.4452  1.7226  0.0707  4.8740    4.2429  5.5989
rabat    0.3422     0.7694  0.6976  0.8413  0.0366  2.1585    2.0089  2.3193

N = 20000,  Events: 7989,  Censored: 12011
Total time at risk: 248487.8
Log-likelihood = -33709.69, df = 5
AIC = 67429.37

         est L95% U95%
prezent 4.87 4.24 5.60
rabat   2.16 2.01 2.32
                   grupa     n nigdy_model dolna gorna nigdy_km_30_mies
1 dla siebie, bez rabatu 11986        39.9  38.8  41.0             41.2
2  dla siebie, z rabatem  6245        58.9  57.5  60.2             59.1
3 na prezent, bez rabatu  1170        76.4  73.9  78.9             76.2
4  na prezent, z rabatem   599        87.5  85.8  89.0             87.8
  nigdy_prawda
1         40.2
2         58.2
3         76.8
4         88.5
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("wiosna – jesień" = c("#009E73", "#D55E00"),
             "lato – zima" = c("#E69F00", "#0072B2"),
             "wiosna – lato" = c("#009E73", "#E69F00"),
             "model A – model B" = c("#999999", "#0072B2"),
             "dla siebie: bez – z rabatem" = c("#0072B2", "#56B4E9"),
             "prezent: bez – z rabatem" = c("#D55E00", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
wiosna – jesień                            102.4         53.5       37.3
lato – zima                                120.2        121.5      109.3
wiosna – lato                               88.7         66.3       51.5
model A – model B                           44.9         48.9       40.6
dla siebie: bez – z rabatem                 26.4         24.7       24.6
prezent: bez – z rabatem                    33.4         18.4       24.9
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, odsetki, hazard miesięczny i przedziały Poissona (poisson.test()) – bazowy R (pakiety stats i base); estymator Kaplana–Meiera (survfit()), test log-rank (survdiff()), model Coxa ze zmienną zależną od czasu (coxph()) i test proporcjonalności (cox.zph()) – pakiet survival; model frakcji wyleczonych (flexsurvcure()) – pakiety flexsurvcure i flexsurv. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- flexsurv (wersja 2.3.2): Jackson, C. (2016). flexsurv: A platform for parametric survival modeling in R. Journal of Statistical Software, 70(8), 1–33. https://doi.org/10.18637/jss.v070.i08
- flexsurvcure (wersja 1.3.3): Amdahl, J. (2025). flexsurvcure: Flexible parametric cure models (R package version 1.3.3) [Computer software]. https://doi.org/10.32614/CRAN.package.flexsurvcure
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Odsetek „wróconych do dziś” w kohortach o różnym czasie obserwacji – fałszywy spadek w nowych kohortach (rysunek 2).
- Pora roku pierwszego zakupu jako zwykła zmienna – model mówi „bez znaczenia”, bo sezon działa w kalendarzu, nie w czasie od zakupu (rysunek 5).
- Zakup na prezent w jednym worku z pozostałymi – zaniża powroty i łamie proporcjonalność hazardów (rysunek 6).
- Definicja drugiego zakupu. Zamówienie uzupełniające po dwóch dniach to nie powrót – ustal próg (np. 14 dni) i opisz go w Metodzie.
- Jeden klient – kilka kont. Zakup bez logowania z innym adresem e-mail robi z powracającego klienta nowego – najpierw połącz konta.
Najczęstsze pytania
Jak policzyć odsetek nowych klientów, którzy wracają, gdy część jest dopiero co pozyskana?
Nie dziel liczby powrotów przez wszystkich klientów kohorty – nowi nie mieli jeszcze czasu wrócić. W przykładzie naiwny odsetek spadał z około 50% do 16.6% w najnowszych kohortach. Potraktuj klientów bez drugiego zakupu jako obserwacje cenzurowane i podaj odsetek powrotów po 6 i 12 miesiącach z krzywej Kaplana–Meiera, porównując kohorty z tej samej pory roku.
Jak uwzględnić sezonowość w modelu Coxa dla ponownych zakupów?
Sezon działa w kalendarzu, a nie w czasie od pierwszego zakupu. Pora roku pierwszego zakupu jako zwykła zmienna dała w przykładzie HR bliskie 1 i silne naruszenie proporcjonalności (χ²(3) = 55.3). Podziel czas klienta na miesiące kalendarzowe (format licznikowy) i wprowadź porę roku jako zmienną zależną od czasu: wiosną HR = 4.85, jesienią 3.30 względem lata.
Kiedy wysłać przypomnienie klientowi, który kupił pierwszy raz?
Tam, gdzie hazard powrotu ma szczyt. W sklepie ogrodniczym to marzec–kwiecień i wrzesień, więc przypomnienie wysyła się pod koniec lutego i sierpnia. Reguła „60 dni po zakupie” trafia klientów z lipca w szczyt, a klientów z kwietnia w czerwcowy dołek. Skuteczność przypomnienia sprawdź na losowej grupie bez wysyłki.
Dlaczego krzywa powrotów klientów nie dochodzi do 100%?
Bo część klientów nie wróci nigdy, choćby obserwować ich latami. Krzywa wypłaszcza się na poziomie odsetka tych, którzy kiedyś wrócą. Model frakcji wyleczonych (cure model) szacuje ten odsetek osobno od tempa powrotu: w przykładzie nie wróci 39.9% kupujących dla siebie bez rabatu i 76.4% kupujących na prezent.
Czy klientów kupujących na prezent analizować razem z pozostałymi?
Lepiej osobno albo z wyraźną zmienną. Prezent kupuje często ktoś, kto nie jest odbiorcą oferty, więc rzadko wraca: w przykładzie iloraz szans „nigdy” wyniósł 4.87. Wliczeni do średniej zaniżają odsetek powrotów i łamią założenie proporcjonalnych hazardów.
Powiązane hasła
Przeczytaj też
Churn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →PoradnikOkres próbny i freemium – analiza przeżycia
Ilu użytkowników kiedyś kupi i jak szybko? Kaplan–Meier, model frakcji wyleczonych i test 7 vs 14 dni okresu próbnego – z kodem R.
Czytaj →PoradnikAnaliza kohortowa retencji klientów
Sklep z karmą, 30 kohort i 18 tys. transakcji: tabela kohortowa, mapa ciepła, krzywe z przedziałami i pułapki oceny programu lojalnościowego – pięć rysunków z kodem R.
Czytaj →Analizujesz powroty klientów do pracy z marketingu?
Pomożemy zakodować pierwszy i drugi zakup, cenzurowanie i sezon, dobrać krzywe, model Coxa ze zmienną zależną od czasu i model frakcji „nigdy” oraz opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Amico, M., & Van Keilegom, I. (2018). Cure models in survival analysis. Annual Review of Statistics and Its Application, 5(1), 311–342. https://doi.org/10.1146/annurev-statistics-031017-100101 ● Otwarty dostęp: pełny tekst
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Fisher, L. D., & Lin, D. Y. (1999). Time-dependent covariates in the Cox proportional-hazards regression model. Annual Review of Public Health, 20(1), 145–157. https://doi.org/10.1146/annurev.publhealth.20.1.145 ● Otwarty dostęp: pełny tekst
- Grambsch, P. M., & Therneau, T. M. (1994). Proportional hazards tests and diagnostics based on weighted residuals. Biometrika, 81(3), 515–526. https://doi.org/10.1093/biomet/81.3.515
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Lewis, M. (2006). Customer acquisition promotions and customer asset value. Journal of Marketing Research, 43(2), 195–203. https://doi.org/10.1509/jmkr.43.2.195
- Reinartz, W. J., & Kumar, V. (2000). On the profitability of long-life customers in a noncontractual setting: An empirical investigation and implications for marketing. Journal of Marketing, 64(4), 17–35. https://doi.org/10.1509/jmkg.64.4.17.18077
Cytowania BibTeX
@article{amico2018cure, author={Amico, Maïlis and Van Keilegom, Ingrid}, title={{Cure models in survival analysis}}, journal={Annual Review of Statistics and Its Application}, year={2018}, volume={5}, number={1}, pages={311--342}, doi={10.1146/annurev-statistics-031017-100101}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{fisher1999time, author={Fisher, Lloyd D. and Lin, D. Y.}, title={{Time-dependent covariates in the Cox proportional-hazards regression model}}, journal={Annual Review of Public Health}, year={1999}, volume={20}, number={1}, pages={145--157}, doi={10.1146/annurev.publhealth.20.1.145}}@article{grambsch1994proportional, author={Grambsch, Patricia M. and Therneau, Terry M.}, title={{Proportional hazards tests and diagnostics based on weighted residuals}}, journal={Biometrika}, year={1994}, volume={81}, number={3}, pages={515--526}, doi={10.1093/biomet/81.3.515}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{lewis2006customer, author={Lewis, Michael}, title={{Customer acquisition promotions and customer asset value}}, journal={Journal of Marketing Research}, year={2006}, volume={43}, number={2}, pages={195--203}, doi={10.1509/jmkr.43.2.195}}@article{reinartz2000profitability, author={Reinartz, Werner J. and Kumar, V.}, title={{On the profitability of long-life customers in a noncontractual setting: An empirical investigation and implications for marketing}}, journal={Journal of Marketing}, year={2000}, volume={64}, number={4}, pages={17--35}, doi={10.1509/jmkg.64.4.17.18077}}