Przykład: sklep z filamentami i spowolniona strona produktu
Fikcyjny sklep internetowy sprzedaje filamenty, dysze, stoły i inne części do drukarek 3D. Strona produktu ładuje się wolno: duże zdjęcia, galeria i podgląd modelu. Zespół marketingu pyta: ile sprzedaży kosztuje nas każde 100 ms czekania i czy opłaca się wydać pieniądze na przyspieszenie?
Najprostsza odpowiedź – porównać w danych z analityki szybkie i wolne sesje – myli, bo czas ładowania nie jest przydzielony losowo. Dlatego sklep zrobił test A/B z dawkami: przez 3 tygodnie 100 000 użytkowników losowo dostawało sztuczne opóźnienie strony produktu o 0, 250, 500 albo 1000 ms.
Dane są fikcyjne i znamy w nich prawdę. Ręcznie ustaliliśmy (lista przy kodzie): 60% telefonów, wolne łącza (10% komputerów, 25% telefonów), naturalny czas ładowania (mediana 1.3 s na komputerze, 2.1 s na telefonie), wyższą skłonność do zakupu na komputerze i porzucanie strony z każdą sekundą czekania – na telefonie dwa razy częstsze niż na komputerze. Prawdziwy skutek +100 ms to −0.050 pp konwersji na sesję. Jedna zmiana po pierwszym uruchomieniu: dodaliśmy niemierzony „słabszy sprzęt”, który spowalnia ładowanie i idzie w parze z mniejszą chęcią zakupu (w pierwszej wersji korekta o urządzenie i łącze usuwała prawie cały błąd analizy obserwacyjnej, a w praktyce rzadko się to udaje). Ziarna nie zmienialiśmy. Dane (145 445 sesji): czas-ladowania-filamenty-sesje.csv (wiersz = sesja; urządzenie T/K – telefon/komputer, łącze W/S – wolne/szybkie, czas w ms; zakup = przychód > 0).
Rysunek 1: schemat eksperymentu ze spowolnieniem
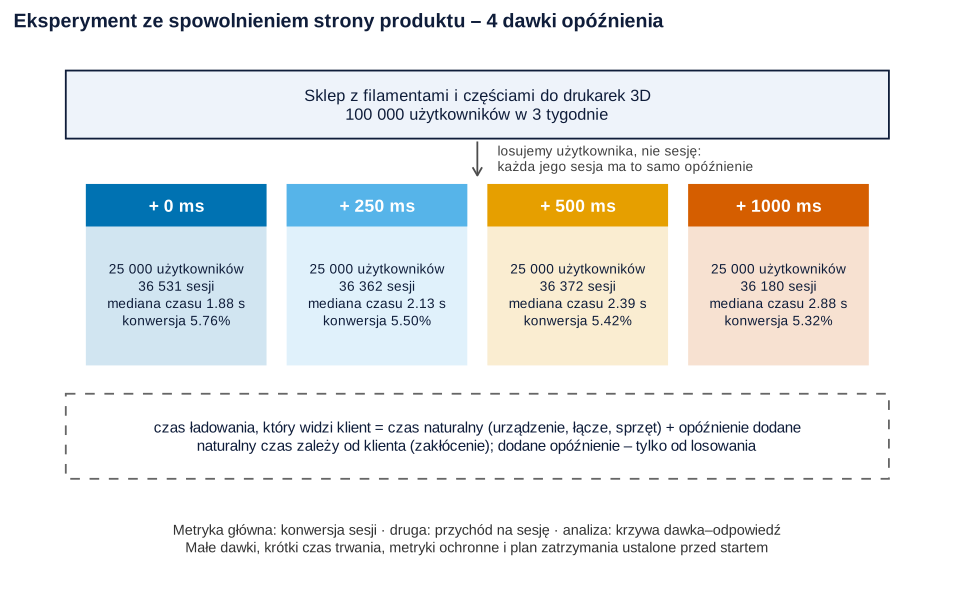
set.seed(765)).Co widać. Każda grupa ma 25 000 użytkowników i ok. 36 tys. sesji. Konwersja sesji spada z 5.76% przy 0 ms do 5.32% przy 1000 ms. Losujemy użytkownika, nie sesję: kto wrócił do sklepu, dostał to samo opóźnienie (inaczej porównywalibyśmy jego własne sesje i mieszali grupy). Eksperymenty online to najlepszy sposób ustalania przyczyn, choć randomizacja bywa w praktyce trudniejsza, niż się zakłada (Kohavi i in., 2009).
Jak może zmylić. Dawka to tylko dodatek. Klient widzi czas całkowity, a ten mocno się nakłada między grupami – o tym w pułapkach.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: dlaczego dane obserwacyjne mylą
Najpierw to, co robi większość raportów: w grupie bez opóźnienia porównujemy konwersję sesji o różnym naturalnym czasie ładowania.
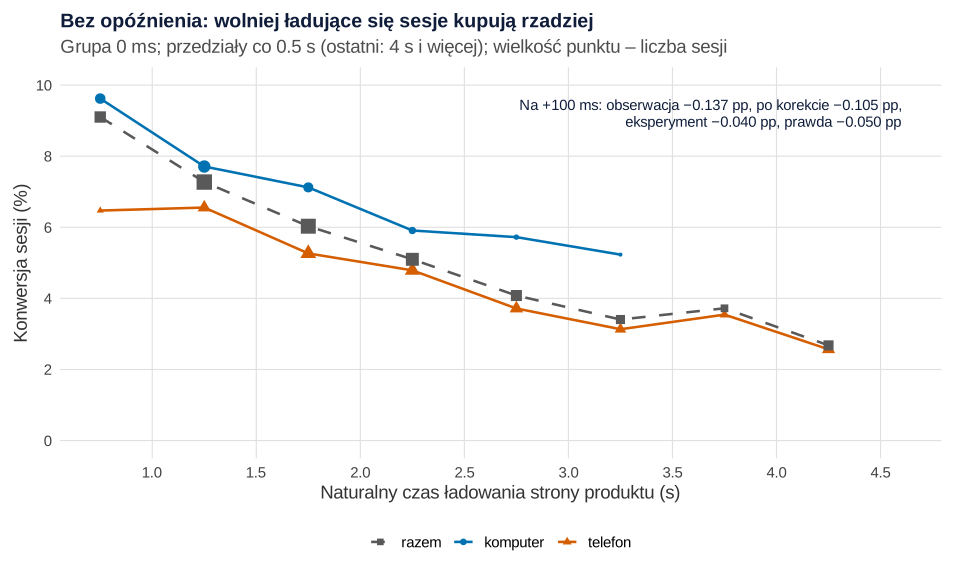
set.seed(765)).Co widać. Sesje ładujące się poniżej sekundy kupują w 9.10%, a te powyżej 4 s – w 2.68%. Regresja daje −0.137 pp na każde 100 ms, 95% CI [−0.153, −0.121]: niemal trzy razy więcej niż prawda (−0.050 pp). Powód to zmienna zakłócająca: wolno ładują się telefony, wolne łącza i słabszy sprzęt, a ich właściciele kupują rzadziej z innych powodów. Wśród sesji poniżej 1.5 s telefony to 30.3%, wśród sesji od 3 s – 90.9%.
Jak może zmylić. Korekta o urządzenie i łącze – zgodnie z zasadą, by kontrolować zmienne, które są przyczyną ekspozycji lub wyniku (VanderWeele, 2019) – zmniejsza błąd tylko do −0.105 pp [−0.125, −0.086]. Słabszego sprzętu nie mierzymy. Eksperyment daje −0.040 pp [−0.072, −0.008] i jego przedział obejmuje prawdę. Szerzej: korelacja a przyczynowość.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: błąd w obie strony – 300 analiz w dwóch światach
Czy dane obserwacyjne zawsze zawyżają szkodę? Nie. Symulujemy po 300 analiz (każda 15 000 sesji) w dwóch światach o tym samym mechanizmie porzucania strony. Świat A: słabszy sprzęt ładuje wolniej i należy do osób, które kupują rzadziej. Świat B: zalogowani stali klienci dostają cięższą, spersonalizowaną stronę i kupują częściej.
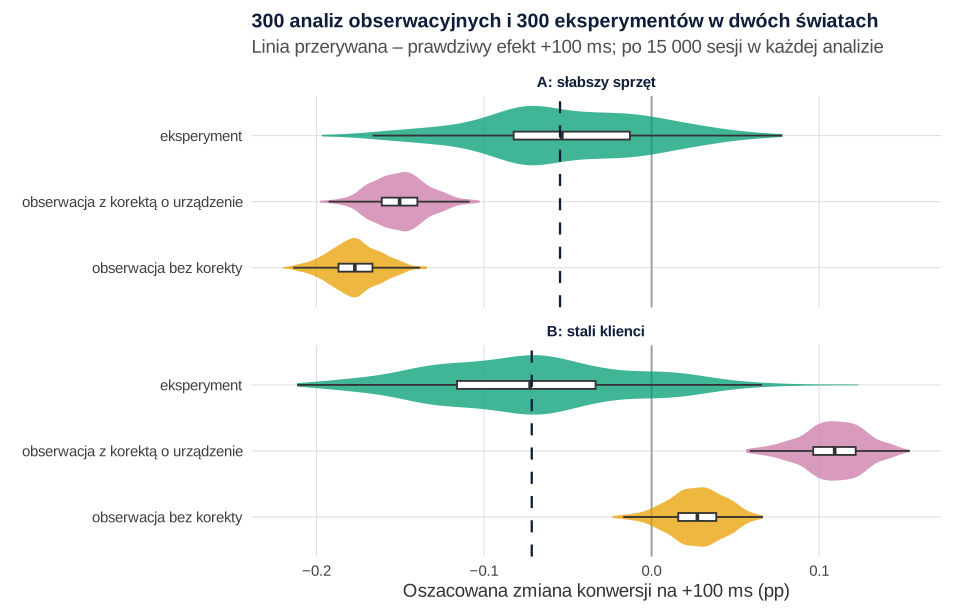
set.seed(7651)).Co widać. W świecie A obserwacja daje średnio −0.177 pp na 100 ms przy prawdzie −0.055 pp – szkoda wygląda na trzy razy większą. W świecie B znak się odwraca: obserwacja daje +0.027 pp i w 94% analiz „wolniej znaczy lepiej”, a korekta o urządzenie pogarsza sprawę (+0.108 pp; w 100% analiz wynik dodatni). Eksperyment trafia średnio w prawdę w obu światach (−0.052 i −0.072 pp).
Jak może zmylić. Eksperyment jest nieobciążony, ale nieprecyzyjny: odchylenie standardowe oszacowań to 0.052–0.060 pp, więc w świecie B 14.7% eksperymentów pokazało wynik dodatni. Jedno badanie z 15 000 sesji to za mało.
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: krzywa dawka–odpowiedź
Cztery dawki leżą na jednej osi, więc pytamy o zależność dawka–odpowiedź, a nie o zwycięzcę (porównania wariantów bez takiej osi opisuje wpis test A/B z wieloma wariantami). Przedziały liczymy bootstrapem (Efron, 1979) użytkowników: losujemy całych użytkowników z ich sesjami, bo sesje tej samej osoby nie są niezależne.
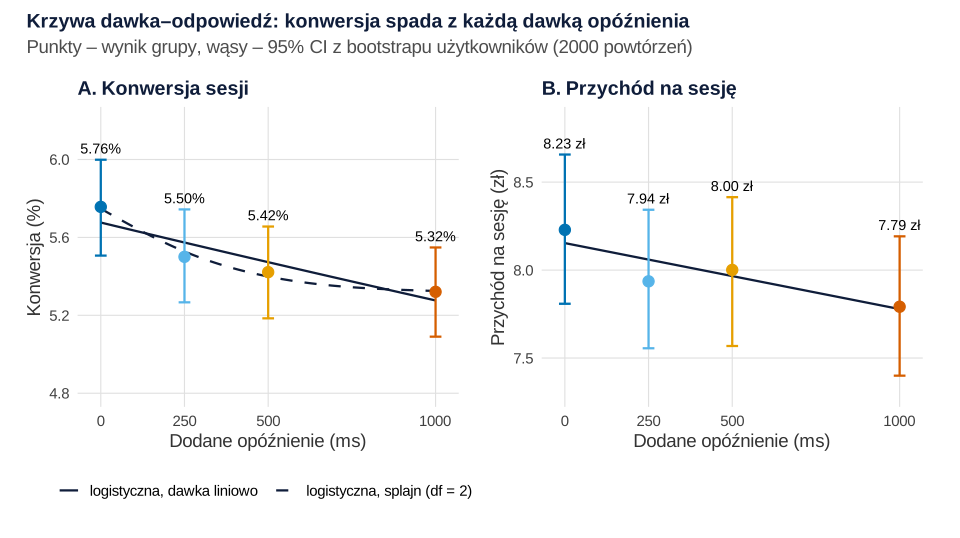
set.seed(7652)).Co widać. Konwersja spada z 5.76% [5.51, 6.00] do 5.32% [5.09, 5.55], czyli o 0.44 pp, 95% CI [0.10, 0.78], względnie o 7.6%. W regresji logistycznej z dawką liniowo trend jest istotny: test ilorazu wiarygodności χ²(1) = 6.12, p = .013, a OR na +100 ms wynosi 0.992 [0.986, 0.999]. Klasyczny test trendu Cochrana–Armitage’a daje to samo (χ²(1) = 6.10, p = .014) – test ukierunkowany na porządek grup może wykazać efekt, którego zwykły test chi-kwadrat nie wykaże (Armitage, 1955). Splajn naturalny nie poprawia dopasowania (χ²(1) = 1.04, p = .307), tak jak model z osobną konwersją każdej dawki (χ²(2) = 1.14, p = .566).
Jak może zmylić. Brak dowodu nieliniowości przy czterech dawkach to nie dowód prostej: splajny pozwalają sprawdzić liniowość (Desquilbet i Mariotti, 2010), ale tu mają tylko cztery punkty (więcej w artykule splajny i GAM). Przychód na sesję spada z 8.23 do 7.79 zł, ale przedziały się nakładają: koszyk 145 zł na zakup bardzo zwiększa rozrzut.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: ile warte jest 100 ms
Przeliczamy krzywą na pieniądze w każdym z 2000 powtórzeń bootstrapu: nachylenie prostej przez cztery punkty daje zmianę na +100 ms. Ręcznie przyjęliśmy marżę 30% przychodu oraz koszt przyspieszenia (lżejsze zdjęcia i galeria) 60 000 zł za skrócenie ładowania o 300 ms. Ruch w sklepie: 207 779 sesji ze stroną produktu miesięcznie (3 tygodnie testu przeliczone na 30 dni).
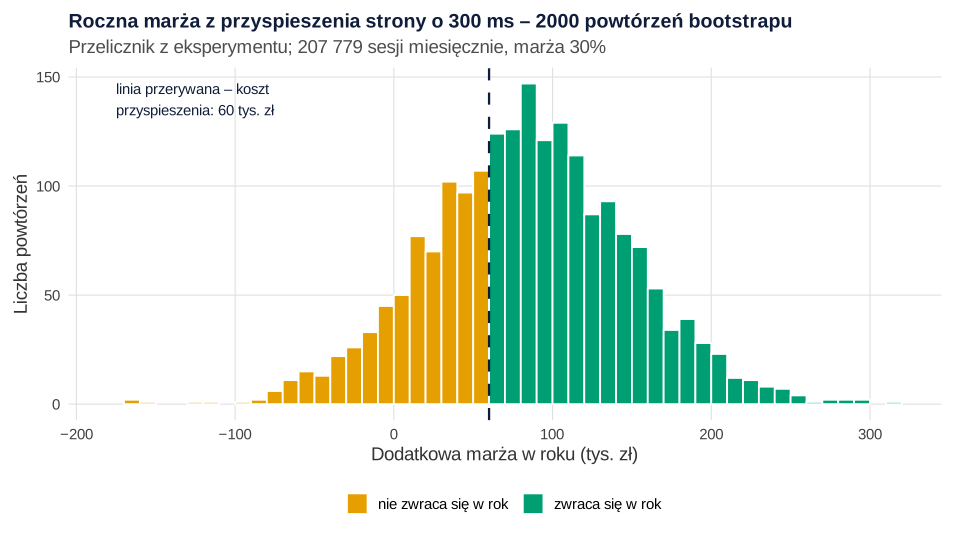
Co widać. Każde 100 ms to −0.040 pp konwersji [−0.072, −0.008] i −0.0375 zł przychodu na sesję [−0.094, 0.019], czyli zmianę przychodu o −7 793 zł miesięcznie [−19 426, 3 958]. Przyspieszenie o 300 ms daje w punkcie 84 164 zł marży rocznie i zwraca się w 8.6 miesiąca. Ale przedział jest bardzo szeroki: [−42 744, 209 799] zł. W 65.9% powtórzeń roczna marża przekracza koszt, a w 8.9% jest ujemna.
Jak może zmylić. Eksperyment mierzył dodanie opóźnienia do strony ładującej się średnio ok. 2 s. Przyspieszenie odejmuje czas – zakładamy, że krzywa jest w tym zakresie symetryczna, a tego test nie sprawdza. Nah (2004) wskazuje, że tolerowany czas oczekiwania to ok. 2 s, a informacja zwrotna podczas ładowania go wydłuża, więc skutki przy krótszych czasach mogą być inne.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: telefon a komputer
W danych ukryliśmy dwa razy silniejsze porzucanie strony na telefonie. Czy eksperyment to widzi? Sprawdzamy interakcję dawka × urządzenie w regresji logistycznej (urządzenie jako modyfikator efektu).
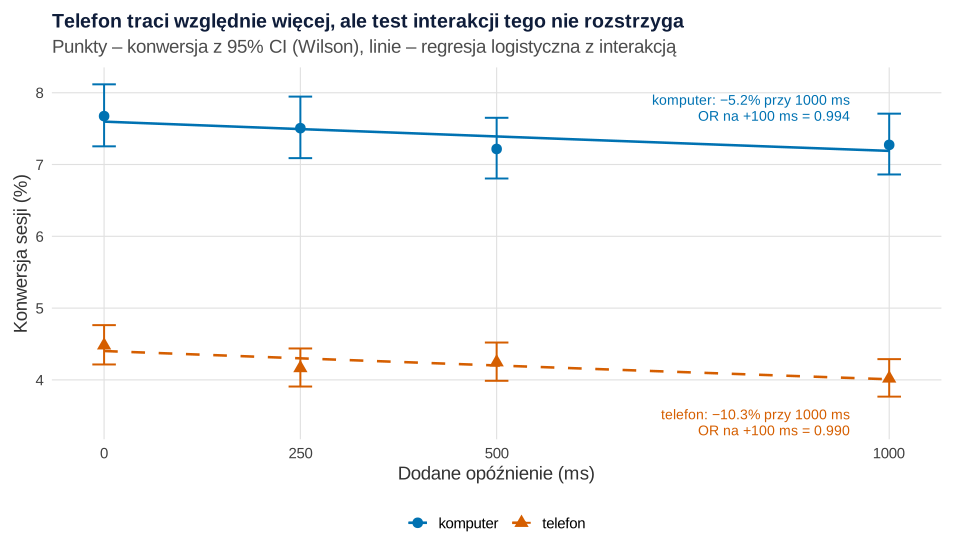
Co widać. Na komputerze konwersja spada z 7.67% do 7.27% (−5.2%, OR na +100 ms = 0.994 [0.986, 1.003]), na telefonie z 4.48% do 4.02% (−10.3%, OR = 0.990 [0.981, 0.999]). Kierunek różnicy zgadza się z prawdą, ale test interakcji jej nie potwierdza: χ²(1) = 0.37, p = .543.
Jak może zmylić. Nieistotna interakcja nie znaczy „efekt taki sam”. Test interakcji ma znacznie mniejszą moc niż test efektu głównego.
Podpis do pracy:
Zdanie do Wyników:
Etyka i koszt eksperymentu
Spowalniając stronę, świadomie pogarszasz obsługę części klientów i tracisz część sprzedaży. Dlatego: krótko (tyle, ile wymaga moc), małe dawki (nie kilka sekund), część ruchu zamiast całego i metryki ochronne z progiem zatrzymania ustalonym przed startem. Kohavi i in. (2020) omawiają definiowanie kluczowych metryk i ogólnego kryterium oceny eksperymentu – ustal je przed startem. Podobną logikę „za dużo szkodzi” ma eksperyment o częstotliwości powiadomień push.
Co z tym zrobić w marketingu
- Nie licz wartości szybkości z danych z analityki. W przykładzie zawyżały szkodę prawie trzy razy, a w innym świecie odwracały znak.
- Wycen 100 ms z przedziałem, nie liczbą. Przyspieszenie o 300 ms za 60 000 zł ma 65.9% szans zwrotu w rok – to argument za inwestycją, ale z ryzykiem; pokaż zarządowi cały rozkład.
- Zacznij od telefonów. Mają wolniejsze strony i prawdopodobnie większą stratę na 100 ms, choć ten test jej nie rozstrzygnął.
- Zaplanuj kolejny test jako przyspieszenie. Wersja szybsza vs obecna sprawdzi, czy odejmowanie czasu działa jak dodawanie.
- Więcej przykładów w artykule statystyka w pracy z marketingu; o tym, co dzieje się z klientem po pierwszym zakupie, pisze wpis o czasie do drugiego zakupu.
Jak opisać w pracy
Podaj jednostkę losowania, dawki, czas trwania, metryki, model i sposób liczenia przedziałów.
| Opóźnienie | Sesje | Konwersja, % [95% CI] | Przychód na sesję, zł [95% CI] | Mediana czasu, s |
|---|---|---|---|---|
| 0 ms | 36 531 | 5.76 [5.51, 6.00] | 8.23 [7.81, 8.66] | 1.88 |
| 250 ms | 36 362 | 5.50 [5.27, 5.74] | 7.94 [7.56, 8.34] | 2.13 |
| 500 ms | 36 372 | 5.42 [5.19, 5.66] | 8.00 [7.57, 8.41] | 2.39 |
| 1000 ms | 36 180 | 5.32 [5.09, 5.55] | 7.79 [7.40, 8.19] | 2.88 |
Kod R: dane, obserwacja, symulacja, krzywa dawka–odpowiedź i wartość 100 ms
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, palety, motyw i funkcję minus(), z których korzystają następne, a przepis 6 korzysta z bootstrapu z przepisu 5. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(765)), 4 (set.seed(7651)) i 5 (set.seed(7652)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 100 000 użytkowników, dawki 0, 250, 500 i 1000 ms, 60% telefonów, wolne łącza u 10% komputerów i 25% telefonów, medianę naturalnego czasu ładowania 1.3 s i 2.1 s (×1.6 przy wolnym łączu, sdlog = 0.35), ukrytą skłonność do zakupu (+0.4 na komputerze, −0.3 przy wolnym łączu), słabszy sprzęt (sd = 0.25 w skali log czasu, −1.2 skłonności na jednostkę), natężenie porzucenia 0.06 i 0.12 na sekundę (komputer, telefon), logit zakupu −3.0 + 0.8 × skłonność, średni koszyk 145 zł (sdlog = 0.6), 0.45 dodatkowej sesji na użytkownika, a w przepisie 6 marżę 30%, koszt 60 000 zł i zysk 300 ms. Po pierwszym uruchomieniu dodano jeden element danych – słabszy sprzęt (dwa parametry wyżej), bo bez niego korekta o urządzenie i łącze usuwała prawie cały błąd analizy obserwacyjnej. Poprawiono też błąd w kodzie przepisu 4: zapis 0.4 * !telefon + … działał inaczej, niż zamierzano, bo w R operator ! ma niski priorytet i neguje całe wyrażenie po prawej stronie, a nie tylko telefon. Poprawna wersja to 0.4 * (!telefon) i wszystkie liczby na tej stronie pochodzą z kodu już po poprawce. Pozostałe zmiany dotyczyły tylko wyglądu rysunków. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się ok. 20 sekund.
1. Dane: 100 000 użytkowników, 4 dawki, 145 tys. sesji
R
# Przepis 1. Fikcyjny sklep z filamentami i częściami do drukarek 3D: eksperyment ze sztucznym opóźnieniem
# 100 000 użytkowników przez 3 tygodnie; każdy użytkownik losowo dostaje 0, 250, 500 albo 1000 ms opóźnienia
library(ggplot2)
options(width = 120)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol_dawka <- c("0 ms" = "#0072B2", "250 ms" = "#56B4E9", "500 ms" = "#E69F00", "1000 ms" = "#D55E00")
kol_urz <- c("komputer" = "#0072B2", "telefon" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach

# Parametry ustalone ręcznie (w prawdziwych danych nieznane)
n_uzytk   <- 100000                     # użytkowników w 3 tygodnie (losowanie 1 : 1 : 1 : 1)
dawki     <- c(0, 250, 500, 1000)       # dodane opóźnienie strony produktu (ms)
p_telefon <- 0.60                       # udział telefonów
p_wolne   <- c(komputer = 0.10, telefon = 0.25)   # udział wolnych łączy
zamiar_sr <- c(komputer = 0.40, telefon = 0.00)   # skłonność do zakupu (ukryta): wyższa na komputerze
zamiar_wolne <- -0.30                   # ... i niższa przy wolnym łączu
mediana_czasu <- c(komputer = 1.3, telefon = 2.1) # naturalny czas ładowania (s), mediana
mnoznik_wolne <- 1.6                    # wolne łącze wydłuża ładowanie 1.6 raza
sdlog_czasu   <- 0.35                   # rozrzut czasu ładowania między sesjami
sd_sprzet     <- 0.25                   # starszy/słabszy sprzęt: stałe dla użytkownika spowolnienie (log czasu) ...
zamiar_sprzet <- -1.2                   # ... które idzie w parze z mniejszą skłonnością do zakupu (nie mierzymy go)
lambda    <- c(komputer = 0.06, telefon = 0.12)   # natężenie porzucenia strony na sekundę czekania
a_zakup   <- -3.0; b_zamiar <- 0.8      # logit zakupu u osoby, która doczekała strony
sr_koszyk <- 145; sdlog_koszyk <- 0.6   # średnia wartość zamówienia (zł), rozkład log-normalny

p_zakupu <- function(czas_s, urz, zamiar)          # prawdziwy mechanizm (znany, bo dane są fikcyjne)
  exp(-lambda[urz] * czas_s) * plogis(a_zakup + b_zamiar * zamiar)

set.seed(765)
uz <- data.frame(uzytkownik = 1:n_uzytk, dawka_ms = sample(rep(dawki, each = n_uzytk / 4)))
uz$urzadzenie <- ifelse(runif(n_uzytk) < p_telefon, "telefon", "komputer")
uz$lacze <- ifelse(runif(n_uzytk) < p_wolne[uz$urzadzenie], "wolne", "szybkie")
uz$sprzet <- rnorm(n_uzytk, 0, sd_sprzet)
uz$zamiar <- rnorm(n_uzytk, zamiar_sr[uz$urzadzenie] + zamiar_wolne * (uz$lacze == "wolne") + zamiar_sprzet * uz$sprzet, 1)
uz$sesje <- 1 + rpois(n_uzytk, 0.45)

ses <- uz[rep(seq_len(n_uzytk), uz$sesje), ]
ses$czas_naturalny_s <- round(exp(log(mediana_czasu[ses$urzadzenie] * ifelse(ses$lacze == "wolne", mnoznik_wolne, 1)) +
                                  ses$sprzet + rnorm(nrow(ses), 0, sdlog_czasu)), 2)
ses$czas_calkowity_s <- ses$czas_naturalny_s + ses$dawka_ms / 1000
ses$p_prawdziwe <- p_zakupu(ses$czas_calkowity_s, ses$urzadzenie, ses$zamiar)
ses$zakup <- rbinom(nrow(ses), 1, ses$p_prawdziwe)
ses$przychod_zl <- ifelse(ses$zakup == 1,
                          round(rlnorm(nrow(ses), log(sr_koszyk) - sdlog_koszyk^2 / 2, sdlog_koszyk), 2), 0)
rownames(ses) <- NULL

# Prawdziwy efekt +100 ms (średnio na sesję, przy dawce 0) – punkt odniesienia dla analiz
kontrola <- ses[ses$dawka_ms == 0, ]
prawda_100ms_pp <- 100 * mean(p_zakupu(kontrola$czas_naturalny_s + 0.1, kontrola$urzadzenie, kontrola$zamiar) -
                              p_zakupu(kontrola$czas_naturalny_s, kontrola$urzadzenie, kontrola$zamiar))

# CSV: tylko zmienne obserwowane (wiersz = sesja); urzadzenie T = telefon, K = komputer; lacze W = wolne, S = szybkie;
# czas w ms; zakup = przychod_zl > 0
write.csv(data.frame(uzytkownik = ses$uzytkownik, dawka_ms = ses$dawka_ms,
                     urzadzenie = ifelse(ses$urzadzenie == "telefon", "T", "K"), lacze = ifelse(ses$lacze == "wolne", "W", "S"),
                     czas_naturalny_ms = round(1000 * ses$czas_naturalny_s), przychod_zl = ses$przychod_zl),
          "czas-ladowania-filamenty-sesje.csv", row.names = FALSE, quote = FALSE)

cat("Użytkownicy:", format(n_uzytk, big.mark = " ", scientific = FALSE), " sesje:", format(nrow(ses), big.mark = " "), " telefon (% sesji):", round(100 * mean(ses$urzadzenie == "telefon"), 1),
    " wolne łącze (% sesji):", round(100 * mean(ses$lacze == "wolne"), 1), "\n")
cat("Prawdziwy efekt +100 ms (pp na sesję):", round(prawda_100ms_pp, 4), "\n\n")
podsum <- do.call(rbind, lapply(split(ses, ses$dawka_ms), function(d) data.frame(
  dawka_ms = d$dawka_ms[1], uzytkownicy = length(unique(d$uzytkownik)), sesje = nrow(d), zakupy = sum(d$zakup),
  konwersja_proc = 100 * mean(d$zakup), przychod_na_sesje = mean(d$przychod_zl),
  czas_mediana = median(d$czas_calkowity_s), czas_p90 = quantile(d$czas_calkowity_s, 0.9, names = FALSE))))
rownames(podsum) <- NULL
print(round(podsum, 3))
cat("\nCzas całkowity (s) – kwantyle wg dawki i urządzenia:\n")
kw <- aggregate(czas_calkowity_s ~ dawka_ms + urzadzenie, data = ses,
                FUN = function(x) round(quantile(x, c(0.1, 0.5, 0.9)), 2))
print(kw)
cat("\nOdsetek sesji z dawką 0 ms wolniejszych niż mediana sesji z dawką 1000 ms (%):",
    round(100 * mean(kontrola$czas_calkowity_s > median(ses$czas_calkowity_s[ses$dawka_ms == 1000])), 1), "\n")
Wynik w R
Użytkownicy: 100 000  sesje: 145 445  telefon (% sesji): 60.1  wolne łącze (% sesji): 19
Prawdziwy efekt +100 ms (pp na sesję): -0.0498

  dawka_ms uzytkownicy sesje zakupy konwersja_proc przychod_na_sesje czas_mediana czas_p90
1        0       25000 36531   2103          5.757             8.229         1.88     3.81
2      250       25000 36362   2000          5.500             7.936         2.13     4.07
3      500       25000 36372   1972          5.422             8.001         2.39     4.31
4     1000       25000 36180   1925          5.321             7.792         2.88     4.82

Czas całkowity (s) – kwantyle wg dawki i urządzenia:
  dawka_ms urzadzenie czas_calkowity_s.10% czas_calkowity_s.50% czas_calkowity_s.90%
1        0   komputer                 0.76                 1.35                 2.45
2      250   komputer                 1.02                 1.60                 2.71
3      500   komputer                 1.26                 1.85                 2.93
4     1000   komputer                 1.76                 2.35                 3.41
5        0    telefon                 1.29                 2.34                 4.37
6      250    telefon                 1.54                 2.59                 4.65
7      500    telefon                 1.80                 2.86                 4.87
8     1000    telefon                 2.29                 3.34                 5.37

Odsetek sesji z dawką 0 ms wolniejszych niż mediana sesji z dawką 1000 ms (%): 22
2. Grafika: schemat eksperymentu: Rysunek 1
R
# Przepis 2. Grafika: schemat eksperymentu ze spowolnieniem (karta): Rysunek 1
# Korzysta z podsum, kol_dawka, motyw z przepisu 1.
karty <- data.frame(x = c(1, 2, 3, 4), dawka = names(kol_dawka),
  tekst = sprintf("%s użytkowników\n%s sesji\nmediana czasu %.2f s\nkonwersja %.2f%%",
                  format(podsum$uzytkownicy, big.mark = " "), format(podsum$sesje, big.mark = " "),
                  podsum$czas_mediana, podsum$konwersja_proc))
p1 <- ggplot() +
  annotate("rect", xmin = 0.45, xmax = 4.55, ymin = 8.6, ymax = 9.8, fill = "#eef3fa", colour = "#0f1d3a") +
  annotate("text", x = 2.5, y = 9.2, size = 4.3, colour = "#0f1d3a", lineheight = 0.95,
           label = "Sklep z filamentami i częściami do drukarek 3D\n100 000 użytkowników w 3 tygodnie") +
  annotate("segment", x = 2.5, xend = 2.5, y = 8.55, yend = 7.95, arrow = arrow(length = unit(0.25, "cm")), colour = "grey30") +
  annotate("text", x = 2.6, y = 8.25, hjust = 0, size = 3.6, colour = "grey25", lineheight = 0.95,
           label = "losujemy użytkownika, nie sesję:\nkażda jego sesja ma to samo opóźnienie") +
  geom_rect(data = karty, aes(xmin = x - 0.45, xmax = x + 0.45, ymin = 4.6, ymax = 7.8, fill = dawka), alpha = 0.18, colour = NA) +
  geom_rect(data = karty, aes(xmin = x - 0.45, xmax = x + 0.45, ymin = 7.05, ymax = 7.8, fill = dawka), colour = NA) +
  geom_text(data = karty, aes(x, 7.42, label = paste("+", dawka)), colour = "white", fontface = "bold", size = 4.6) +
  geom_text(data = karty, aes(x, 5.85, label = tekst), size = 3.6, lineheight = 1.05, colour = "#0f1d3a") +
  annotate("rect", xmin = 0.45, xmax = 4.55, ymin = 2.6, ymax = 4.1, fill = "white", colour = "grey40", linetype = "dashed") +
  annotate("text", x = 2.5, y = 3.35, size = 4.0, colour = "#0f1d3a", lineheight = 1.0,
           label = "czas ładowania, który widzi klient = czas naturalny (urządzenie, łącze, sprzęt) + opóźnienie dodane\nnaturalny czas zależy od klienta (zakłócenie); dodane opóźnienie – tylko od losowania") +
  annotate("text", x = 2.5, y = 1.55, size = 3.8, colour = "grey20", lineheight = 1.0,
           label = "Metryka główna: konwersja sesji · druga: przychód na sesję · analiza: krzywa dawka–odpowiedź\nMałe dawki, krótki czas trwania, metryki ochronne i plan zatrzymania ustalone przed startem") +
  scale_fill_manual(values = kol_dawka, guide = "none") +
  scale_x_continuous(limits = c(0.4, 4.6)) + scale_y_continuous(limits = c(0.9, 9.9)) +
  labs(title = "Eksperyment ze spowolnieniem strony produktu – 4 dawki opóźnienia") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
p1   # zapis: ggsave("czas-ladowania-schemat-eksperymentu.svg", p1, width = 10, height = 6.4)
Przepis nie wypisuje liczb – tworzy tylko wykres p1.
3. Dane obserwacyjne a eksperyment: Rysunek 2
R
# Przepis 3. Dane obserwacyjne mylą: konwersja a NATURALNY czas ładowania w grupie bez opóźnienia: Rysunek 2
library(sandwich)                                   # błędy standardowe odporne na skupienie sesji w użytkownikach
kontrola <- ses[ses$dawka_ms == 0, ]

# Konwersja w przedziałach naturalnego czasu ładowania (co 0.5 s, ostatni: 4 s i więcej), osobno dla urządzeń
kontrola$przedzial <- pmin(floor(kontrola$czas_naturalny_s / 0.5) * 0.5, 4) + 0.25
tab <- aggregate(zakup ~ przedzial + urzadzenie, data = kontrola, FUN = function(x) c(n = length(x), k = sum(x)))
tab <- data.frame(przedzial = tab$przedzial, urzadzenie = tab$urzadzenie, n = tab$zakup[, "n"], k = tab$zakup[, "k"])
razem <- aggregate(zakup ~ przedzial, data = kontrola, FUN = function(x) c(n = length(x), k = sum(x)))
tab <- rbind(tab, data.frame(przedzial = razem$przedzial, urzadzenie = "razem", n = razem$zakup[, "n"], k = razem$zakup[, "k"]))
tab$konw <- 100 * tab$k / tab$n
tab <- tab[tab$n >= 200, ]                          # pomijamy przedziały z mniej niż 200 sesjami
print(tab[tab$urzadzenie == "razem", ], row.names = FALSE)
cat("\nUdział telefonów wśród sesji z naturalnym czasem < 1.5 s i >= 3 s (%):",
    round(100 * mean(kontrola$urzadzenie[kontrola$czas_naturalny_s < 1.5] == "telefon"), 1),
    round(100 * mean(kontrola$urzadzenie[kontrola$czas_naturalny_s >= 3] == "telefon"), 1), "\n\n")

# Nachylenie w punktach procentowych na +100 ms (model liniowy prawdopodobieństwa, SE odporne na skupienie)
nachylenie <- function(m, zm, klaster) {
  b <- coef(m)[zm] * 0.1 * 100; se <- sqrt(vcovCL(m, cluster = klaster)[zm, zm]) * 0.1 * 100
  c(pp_na_100ms = unname(b), ci_dol = unname(b - 1.96 * se), ci_gora = unname(b + 1.96 * se))
}
m_naiwny <- lm(zakup ~ czas_naturalny_s, data = kontrola)
m_korekta <- lm(zakup ~ czas_naturalny_s + urzadzenie + lacze, data = kontrola)
ses$dawka_s <- ses$dawka_ms / 1000
m_eksp <- lm(zakup ~ dawka_s, data = ses)
porownanie <- rbind(
  "obserwacja, bez korekty"            = nachylenie(m_naiwny, "czas_naturalny_s", ~ uzytkownik),
  "obserwacja, korekta: urządzenie i łącze" = nachylenie(m_korekta, "czas_naturalny_s", ~ uzytkownik),
  "eksperyment (dodane opóźnienie)"   = nachylenie(m_eksp, "dawka_s", ~ uzytkownik),
  "prawda (znana z symulacji)"         = c(prawda_100ms_pp, NA, NA))
round(porownanie, 4)

tab$urzadzenie <- factor(tab$urzadzenie, levels = c("razem", "komputer", "telefon"))
etyk <- minus(sprintf("Na +100 ms: obserwacja %.3f pp, po korekcie %.3f pp,\neksperyment %.3f pp, prawda %.3f pp",
                      porownanie[1, 1], porownanie[2, 1], porownanie[3, 1], porownanie[4, 1]))
p2 <- ggplot(tab, aes(przedzial, konw, colour = urzadzenie, shape = urzadzenie, linetype = urzadzenie)) +
  geom_line(linewidth = 0.9) + geom_point(aes(size = n)) +
  annotate("text", x = 4.6, y = 9.6, label = etyk, hjust = 1, vjust = 1, size = 3.9, colour = "#0f1d3a", lineheight = 0.95) +
  scale_colour_manual(values = c(razem = "grey35", kol_urz), name = NULL) +
  scale_shape_manual(values = c(razem = 15, komputer = 16, telefon = 17), name = NULL) +
  scale_linetype_manual(values = c(razem = "dashed", komputer = "solid", telefon = "solid"), name = NULL) +
  scale_size_area(max_size = 5, guide = "none") +
  scale_x_continuous(breaks = seq(0.5, 4.5, 0.5)) +
  scale_y_continuous(limits = c(0, 10), breaks = seq(0, 10, 2)) +
  labs(title = "Bez opóźnienia: wolniej ładujące się sesje kupują rzadziej",
       subtitle = "Grupa 0 ms; przedziały co 0.5 s (ostatni: 4 s i więcej); wielkość punktu – liczba sesji",
       x = "Naturalny czas ładowania strony produktu (s)", y = "Konwersja sesji (%)") +
  motyw
p2   # zapis: ggsave("czas-ladowania-obserwacja.svg", p2, width = 10, height = 6)
Wynik w R
 przedzial urzadzenie    n   k     konw
      0.75      razem 4131 376 9.101912
      1.25      razem 8058 586 7.272276
      1.75      razem 7529 454 6.030017
      2.25      razem 5491 280 5.099253
      2.75      razem 3848 157 4.080042
      3.25      razem 2496  85 3.405449
      3.75      razem 1693  63 3.721205
      4.25      razem 3136  84 2.678571

Udział telefonów wśród sesji z naturalnym czasem < 1.5 s i >= 3 s (%): 30.3 90.9

                                        pp_na_100ms  ci_dol ci_gora
obserwacja, bez korekty                     -0.1371 -0.1534 -0.1209
obserwacja, korekta: urządzenie i łącze     -0.1053 -0.1245 -0.0862
eksperyment (dodane opóźnienie)             -0.0399 -0.0724 -0.0075
prawda (znana z symulacji)                  -0.0498      NA      NA
4. Symulacja: 300 analiz w dwóch światach zakłócenia: Rysunek 3
R
# Przepis 4. Symulacja: 300 analiz obserwacyjnych i 300 eksperymentów w dwóch światach zakłócenia: Rysunek 3
# Świat A: słabszy sprzęt ładuje wolniej i należy do osób, które rzadziej kupują (błąd zawyża szkodę).
# Świat B: zalogowani stali klienci dostają cięższą, spersonalizowaną stronę i kupują częściej (błąd zaniża szkodę).
# W obu światach prawdziwy wpływ czasu ładowania jest ten sam (mechanizm porzucenia z przepisu 1).
set.seed(7651)
n_ses <- 15000; powt <- 300
lam <- c(komputer = 0.06, telefon = 0.12)
swiat <- function(n, rodzaj, dawka_s = 0) {
  telefon <- runif(n) < 0.6; urz <- ifelse(telefon, "telefon", "komputer")
  if (rodzaj == "A") {
    sprzet <- rnorm(n, 0, 0.30); staly <- rep(FALSE, n)
    zamiar <- rnorm(n, 0.4 * (!telefon) - 1.5 * sprzet, 1)
  } else {
    sprzet <- rnorm(n, 0, 0.10); staly <- runif(n) < 0.30
    zamiar <- rnorm(n, 0.4 * (!telefon) + 1.5 * staly, 1)
  }
  czas <- exp(log(ifelse(telefon, 2.1, 1.3)) + sprzet + 0.6 * staly + rnorm(n, 0, 0.35))
  p <- function(t) exp(-lam[urz] * t) * plogis(-3.0 + 0.8 * zamiar)
  list(czas = czas, telefon = telefon, dawka = dawka_s, zakup = rbinom(n, 1, p(czas + dawka_s)),
       prawda = 100 * mean(p(czas + 0.1) - p(czas)))
}
pp100 <- function(X, y) .lm.fit(X, y)$coefficients[2] * 0.1 * 100    # nachylenie w pp na +100 ms
wyniki <- do.call(rbind, lapply(c("A", "B"), function(r) {
  t(replicate(powt, {
    o <- swiat(n_ses, r)                                              # dane obserwacyjne: bez opóźnienia
    e <- swiat(n_ses, r, dawka_s = sample(c(0, 0.25, 0.5, 1), n_ses, replace = TRUE))  # eksperyment
    c(swiat = match(r, c("A", "B")),
      obs_naiwna = pp100(cbind(1, o$czas), o$zakup),
      obs_korekta = pp100(cbind(1, o$czas, o$telefon), o$zakup),      # korekta o urządzenie (mierzone)
      eksperyment = pp100(cbind(1, e$dawka), e$zakup), prawda = o$prawda)
  }))
}))
wyniki <- as.data.frame(wyniki)
podsum <- aggregate(cbind(obs_naiwna, obs_korekta, eksperyment, prawda) ~ swiat, data = wyniki, FUN = mean)
podsum$swiat <- c("A: słabszy sprzęt", "B: stali klienci")
cat("Średnie oszacowania (pp na +100 ms) z", powt, "powtórzeń po", n_ses, "sesji:\n"); print(podsum, digits = 3)
cat("\nOdchylenie standardowe oszacowań eksperymentu (pp):", round(tapply(wyniki$eksperyment, wyniki$swiat, sd), 4), "\n")
cat("Odsetek analiz z oszacowaniem > 0 (wolniej = lepiej) w świecie B: naiwna", round(100 * mean(wyniki$obs_naiwna[wyniki$swiat == 2] > 0), 1),
    "%, z korektą", round(100 * mean(wyniki$obs_korekta[wyniki$swiat == 2] > 0), 1), "%, eksperyment",
    round(100 * mean(wyniki$eksperyment[wyniki$swiat == 2] > 0), 1), "%\n")

dl <- data.frame(swiat = rep(podsum$swiat[wyniki$swiat], 3),
                 analiza = factor(rep(c("obserwacja bez korekty", "obserwacja z korektą o urządzenie", "eksperyment"), each = nrow(wyniki)),
                                  levels = c("obserwacja bez korekty", "obserwacja z korektą o urządzenie", "eksperyment")),
                 oszac = c(wyniki$obs_naiwna, wyniki$obs_korekta, wyniki$eksperyment))
prawdy <- data.frame(swiat = podsum$swiat, prawda = podsum$prawda)
kol_analiza <- c("obserwacja bez korekty" = "#E69F00", "obserwacja z korektą o urządzenie" = "#CC79A7", "eksperyment" = "#009E73")
p3 <- ggplot(dl, aes(oszac, analiza, fill = analiza)) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_violin(colour = NA, alpha = 0.75, scale = "width") +
  geom_boxplot(width = 0.12, outlier.shape = NA, fill = "white", colour = "grey20") +
  geom_vline(data = prawdy, aes(xintercept = prawda), linetype = "dashed", colour = "#0f1d3a", linewidth = 0.8) +
  facet_wrap(~ swiat, ncol = 1) +
  scale_fill_manual(values = kol_analiza, guide = "none") +
  scale_x_continuous(labels = function(x) minus(format(x))) +
  labs(title = "300 analiz obserwacyjnych i 300 eksperymentów w dwóch światach",
       subtitle = "Linia przerywana – prawdziwy efekt +100 ms; po 15 000 sesji w każdej analizie",
       x = "Oszacowana zmiana konwersji na +100 ms (pp)", y = NULL) +
  motyw
p3   # zapis: ggsave("czas-ladowania-symulacja.svg", p3, width = 10, height = 6.4)
Wynik w R
Średnie oszacowania (pp na +100 ms) z 300 powtórzeń po 15000 sesji:
              swiat obs_naiwna obs_korekta eksperyment  prawda
1 A: słabszy sprzęt    -0.1772      -0.150     -0.0515 -0.0546
2  B: stali klienci     0.0266       0.108     -0.0720 -0.0715

Odchylenie standardowe oszacowań eksperymentu (pp): 0.052 0.0597
Odsetek analiz z oszacowaniem > 0 (wolniej = lepiej) w świecie B: naiwna 94 %, z korektą 100 %, eksperyment 14.7 %
5. Krzywa dawka–odpowiedź, test trendu i bootstrap użytkowników: Rysunek 4
R
# Przepis 5. Krzywa dawka–odpowiedź: konwersja i przychód na sesję wg opóźnienia, test trendu i splajn: Rysunek 4
library(splines); library(sandwich); library(patchwork)
ses$dawka_s <- ses$dawka_ms / 1000

# Regresja logistyczna na poziomie sesji: bez dawki, dawka liniowo, splajn naturalny (df = 2), osobna konwersja dla każdej dawki
m0   <- glm(zakup ~ 1, family = binomial, data = ses)
mlin <- glm(zakup ~ dawka_s, family = binomial, data = ses)
mns  <- glm(zakup ~ ns(dawka_s, df = 2), family = binomial, data = ses)
msat <- glm(zakup ~ factor(dawka_ms), family = binomial, data = ses)
lrt <- function(a, b) { x <- anova(a, b, test = "LRT"); c(chi2 = x$Deviance[2], df = x$Df[2], p = x$`Pr(>Chi)`[2]) }
testy <- rbind("trend liniowy (dawka vs brak)" = lrt(m0, mlin), "splajn vs liniowo" = lrt(mlin, mns),
               "osobne dawki vs liniowo (nieliniowość)" = lrt(mlin, msat))
round(testy, 4)
se_model <- sqrt(vcov(mlin)[2, 2]); se_klaster <- sqrt(vcovCL(mlin, cluster = ~ uzytkownik)[2, 2])
b <- coef(mlin)[2]
cat("\nlog-OR na 1 s:", round(b, 4), " OR na +100 ms:", round(exp(0.1 * b), 4),
    "[", round(exp(0.1 * (b - 1.96 * se_klaster)), 4), ",", round(exp(0.1 * (b + 1.96 * se_klaster)), 4), "]",
    " SE odporne / SE modelu:", round(se_klaster / se_model, 3), "\n")
tab_tr <- aggregate(zakup ~ dawka_ms, data = ses, FUN = function(x) c(k = sum(x), n = length(x)))
print(prop.trend.test(tab_tr$zakup[, "k"], tab_tr$zakup[, "n"], score = tab_tr$dawka_ms))   # Cochran–Armitage

# Bootstrap użytkowników (losujemy całych użytkowników z ich sesjami, osobno w każdej dawce)
uzs <- aggregate(cbind(sesje = 1, zakup, przychod_zl) ~ uzytkownik + dawka_ms, data = ses, FUN = sum)
set.seed(7652); B <- 2000
boot_dawki <- sapply(split(uzs, uzs$dawka_ms), function(d) {
  replicate(B, { i <- sample.int(nrow(d), replace = TRUE); s <- sum(d$sesje[i])
                 c(konw = 100 * sum(d$zakup[i]) / s, przych = sum(d$przychod_zl[i]) / s) })
}, simplify = "array")                       # wymiary: 2 miary × B × 4 dawki
krzywa <- data.frame(dawka_ms = c(0, 250, 500, 1000),
  konw = sapply(split(ses, ses$dawka_ms), function(d) 100 * mean(d$zakup)),
  konw_dol = apply(boot_dawki["konw", , ], 2, quantile, 0.025), konw_gora = apply(boot_dawki["konw", , ], 2, quantile, 0.975),
  przych = sapply(split(ses, ses$dawka_ms), function(d) mean(d$przychod_zl)),
  przych_dol = apply(boot_dawki["przych", , ], 2, quantile, 0.025), przych_gora = apply(boot_dawki["przych", , ], 2, quantile, 0.975))
krzywa$zmiana_wzgl_proc <- 100 * (krzywa$konw / krzywa$konw[1] - 1)
round(krzywa, 3)
roznica_1000 <- boot_dawki["konw", , 4] - boot_dawki["konw", , 1]
cat("\n1000 ms vs 0 ms, konwersja (pp):", round(krzywa$konw[4] - krzywa$konw[1], 3),
    "95% CI [", round(quantile(roznica_1000, 0.025), 3), ",", round(quantile(roznica_1000, 0.975), 3), "]\n")

siatka <- data.frame(dawka_s = seq(0, 1, 0.01)); siatka$dawka_ms <- 1000 * siatka$dawka_s
siatka$liniowo <- 100 * predict(mlin, siatka, type = "response")
siatka$splajn  <- 100 * predict(mns, siatka, type = "response")
dl <- rbind(data.frame(siatka[, c("dawka_ms")], model = "logistyczna, dawka liniowo", y = siatka$liniowo),
            data.frame(siatka[, c("dawka_ms")], model = "logistyczna, splajn (df = 2)", y = siatka$splajn))
names(dl)[1] <- "dawka_ms"
pa <- ggplot(krzywa, aes(dawka_ms, konw)) +
  geom_line(data = dl, aes(y = y, linetype = model), colour = "#0f1d3a", linewidth = 0.8) +
  geom_errorbar(aes(ymin = konw_dol, ymax = konw_gora, colour = factor(dawka_ms)), width = 35, linewidth = 0.8) +
  geom_point(aes(colour = factor(dawka_ms)), size = 3.5) +
  geom_text(aes(y = konw_gora, label = sprintf("%.2f%%", konw)), vjust = -0.6, size = 3.8) +
  scale_colour_manual(values = unname(kol_dawka), guide = "none") +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(0, 250, 500, 1000)) + scale_y_continuous(limits = c(4.8, 6.2)) +
  labs(title = "A. Konwersja sesji", x = "Dodane opóźnienie (ms)", y = "Konwersja (%)") + motyw
pb <- ggplot(krzywa, aes(dawka_ms, przych)) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "#0f1d3a", linewidth = 0.8) +
  geom_errorbar(aes(ymin = przych_dol, ymax = przych_gora, colour = factor(dawka_ms)), width = 35, linewidth = 0.8) +
  geom_point(aes(colour = factor(dawka_ms)), size = 3.5) +
  geom_text(aes(y = przych_gora, label = sprintf("%.2f zł", przych)), vjust = -0.6, size = 3.8) +
  scale_colour_manual(values = unname(kol_dawka), guide = "none") +
  scale_x_continuous(breaks = c(0, 250, 500, 1000)) + scale_y_continuous(limits = c(7.3, 8.85)) +
  labs(title = "B. Przychód na sesję", x = "Dodane opóźnienie (ms)", y = "Przychód na sesję (zł)") + motyw
p4 <- (pa | pb) + plot_annotation(title = "Krzywa dawka–odpowiedź: konwersja spada z każdą dawką opóźnienia",
  subtitle = "Punkty – wynik grupy, wąsy – 95% CI z bootstrapu użytkowników (2000 powtórzeń)", theme = motyw) &
  theme(legend.position = "bottom")
p4   # zapis: ggsave("czas-ladowania-krzywa-dawka.svg", p4, width = 10, height = 5.6)
Wynik w R
                                         chi2 df      p
trend liniowy (dawka vs brak)          6.1206  1 0.0134
splajn vs liniowo                      1.0439  1 0.3069
osobne dawki vs liniowo (nieliniowość) 1.1400  2 0.5655

log-OR na 1 s: -0.0773  OR na +100 ms: 0.9923 [ 0.9861 , 0.9986 ]  SE odporne / SE modelu: 1.028

	Chi-squared Test for Trend in Proportions

data:  tab_tr$zakup[, "k"] out of tab_tr$zakup[, "n"] ,
 using scores: 0 250 500 1000
X-squared = 6.0974, df = 1, p-value = 0.01354

     dawka_ms  konw konw_dol konw_gora przych przych_dol przych_gora zmiana_wzgl_proc
0           0 5.757    5.507     5.999  8.229      7.809       8.657            0.000
250       250 5.500    5.267     5.744  7.936      7.556       8.343           -4.456
500       500 5.422    5.185     5.656  8.001      7.568       8.414           -5.819
1000     1000 5.321    5.090     5.548  7.792      7.400       8.192           -7.576

1000 ms vs 0 ms, konwersja (pp): -0.436 95% CI [ -0.776 , -0.102 ]
6. Wartość 100 ms i opłacalność przyspieszenia: Rysunek 5
R
# Przepis 6. Ile warte jest 100 ms i czy opłaca się przyspieszenie strony: Rysunek 5
# Korzysta z boot_dawki i krzywa z przepisu 5 (te same 2000 powtórzeń bootstrapu użytkowników).
sesje_miesiac <- nrow(ses) / 21 * 30         # sesje ze stroną produktu w miesiącu (z 3 tygodni testu)
marza    <- 0.30                             # marża brutto od przychodu (ustalona ręcznie)
koszt    <- 60000                            # jednorazowy koszt przyspieszenia (zł, ustalony ręcznie)
zysk_ms  <- 300                              # o tyle ms skróci się czas ładowania po zmianie

x <- c(0, 250, 500, 1000) / 100              # dawka w setkach ms
nachyl <- function(y) unname(coef(lm(y ~ x))[2])                  # zmiana na +100 ms (prosta przez 4 punkty)
boot_konw   <- apply(boot_dawki["konw", , ], 1, nachyl)            # pp na 100 ms
boot_przych <- apply(boot_dawki["przych", , ], 1, nachyl)          # zł na sesję na 100 ms
ocena <- function(punkt, boot) c(oszacowanie = punkt, ci_dol = unname(quantile(boot, 0.025)), ci_gora = unname(quantile(boot, 0.975)))
wartosc <- rbind(
  "konwersja: pp na +100 ms"              = ocena(nachyl(krzywa$konw), boot_konw),
  "przychód: zł na sesję na +100 ms"      = ocena(nachyl(krzywa$przych), boot_przych),
  "przychód: zł na miesiąc na +100 ms"    = ocena(nachyl(krzywa$przych) * sesje_miesiac, boot_przych * sesje_miesiac),
  "marża: zł na rok przy −300 ms"         = ocena(-nachyl(krzywa$przych) * zysk_ms / 100 * sesje_miesiac * 12 * marza,
                                                 -boot_przych * zysk_ms / 100 * sesje_miesiac * 12 * marza))
round(wartosc, 4)
roczna_marza <- -boot_przych * zysk_ms / 100 * sesje_miesiac * 12 * marza
cat("\nSesje na miesiąc:", round(sesje_miesiac), "\n")
cat("Odsetek powtórzeń bootstrapu, w których roczna marża > koszt", koszt, "zł:", round(100 * mean(roczna_marza > koszt), 1), "%\n")
cat("Odsetek powtórzeń, w których marża <= 0 (spowolnienie nie szkodzi):", round(100 * mean(roczna_marza <= 0), 1), "%\n")
cat("Zwrot w miesiącach (oszacowanie punktowe):", round(koszt / (wartosc[4, 1] / 12), 1), "\n")

dh <- data.frame(marza_tys = roczna_marza / 1000)
p5 <- ggplot(dh, aes(marza_tys, fill = marza_tys > koszt / 1000)) +
  geom_histogram(binwidth = 10, boundary = 0, colour = "white") +
  geom_vline(xintercept = koszt / 1000, linetype = "dashed", colour = "#0f1d3a", linewidth = 0.8) +
  annotate("text", x = -175, y = Inf, vjust = 1.5, hjust = 0, size = 3.9, colour = "#0f1d3a",
           label = sprintf("linia przerywana – koszt\nprzyspieszenia: %s tys. zł", koszt / 1000)) +
  scale_fill_manual(values = c("FALSE" = "#E69F00", "TRUE" = "#009E73"),
                    labels = c("FALSE" = "nie zwraca się w rok", "TRUE" = "zwraca się w rok"), name = NULL) +
  scale_x_continuous(labels = function(x) minus(format(x))) +
  labs(title = "Roczna marża z przyspieszenia strony o 300 ms – 2000 powtórzeń bootstrapu",
       subtitle = sprintf("Przelicznik z eksperymentu; %s sesji miesięcznie, marża %d%%",
                          format(round(sesje_miesiac), big.mark = " "), round(100 * marza)),
       x = "Dodatkowa marża w roku (tys. zł)", y = "Liczba powtórzeń") +
  motyw
p5   # zapis: ggsave("czas-ladowania-wartosc-100-ms.svg", p5, width = 10, height = 5.6)
Wynik w R
                                   oszacowanie      ci_dol     ci_gora
konwersja: pp na +100 ms               -0.0399     -0.0720     -0.0082
przychód: zł na sesję na +100 ms       -0.0375     -0.0935      0.0190
przychód: zł na miesiąc na +100 ms  -7792.9990 -19425.7942   3957.7339
marża: zł na rok przy −300 ms       84164.3896 -42743.5266 209798.5775

Sesje na miesiąc: 207779
Odsetek powtórzeń bootstrapu, w których roczna marża > koszt 60000 zł: 65.9 %
Odsetek powtórzeń, w których marża <= 0 (spowolnienie nie szkodzi): 8.9 %
Zwrot w miesiącach (oszacowanie punktowe): 8.6
7. Telefon a komputer: interakcja: Rysunek 6
R
# Przepis 7. Niejednorodność: telefon a komputer (interakcja dawka × urządzenie): Rysunek 6
library(sandwich)
ses$dawka_s <- ses$dawka_ms / 1000
m_bez <- glm(zakup ~ dawka_s + urzadzenie, family = binomial, data = ses)
m_int <- glm(zakup ~ dawka_s * urzadzenie, family = binomial, data = ses)
test_int <- anova(m_bez, m_int, test = "LRT")
cat("Interakcja dawka × urządzenie: chi2 =", round(test_int$Deviance[2], 3), " df =", test_int$Df[2],
    " p =", sub("^0", "", sprintf("%.3f", test_int$`Pr(>Chi)`[2])), "\n")
V <- vcovCL(m_int, cluster = ~ uzytkownik); b <- coef(m_int)
L <- rbind(komputer = c(0, 1, 0, 0), telefon = c(0, 1, 0, 1))        # nachylenie dawki w każdej grupie
or100 <- t(apply(L, 1, function(l) { e <- sum(l * b); s <- sqrt(drop(t(l) %*% V %*% l))
  exp(0.1 * c(OR_100ms = e, ci_dol = e - 1.96 * s, ci_gora = e + 1.96 * s)) }))
round(or100, 4)

grupy <- aggregate(zakup ~ dawka_ms + urzadzenie, data = ses, FUN = function(x) c(k = sum(x), n = length(x)))
grupy <- data.frame(grupy[, 1:2], k = grupy$zakup[, "k"], n = grupy$zakup[, "n"])
ci <- t(mapply(function(k, n) prop.test(k, n, correct = FALSE)$conf.int, grupy$k, grupy$n))   # przedział Wilsona
grupy$konw <- 100 * grupy$k / grupy$n; grupy$dol <- 100 * ci[, 1]; grupy$gora <- 100 * ci[, 2]
grupy$zmiana_wzgl_proc <- ave(grupy$konw, grupy$urzadzenie, FUN = function(v) 100 * (v / v[1] - 1))
print(grupy, digits = 4, row.names = FALSE)

siatka <- expand.grid(dawka_s = seq(0, 1, 0.01), urzadzenie = c("komputer", "telefon"))
siatka$konw <- 100 * predict(m_int, siatka, type = "response"); siatka$dawka_ms <- 1000 * siatka$dawka_s
etyk <- data.frame(urzadzenie = c("komputer", "telefon"), dawka_ms = 950,
                   konw = siatka$konw[siatka$dawka_s == 1] + c(0.6, -0.6),
                   tekst = minus(sprintf("%s: %+.1f%% przy 1000 ms\nOR na +100 ms = %.3f", c("komputer", "telefon"),
                                         grupy$zmiana_wzgl_proc[grupy$dawka_ms == 1000], or100[, 1])))
p6 <- ggplot(grupy, aes(dawka_ms, konw, colour = urzadzenie, shape = urzadzenie)) +
  geom_line(data = siatka, aes(linetype = urzadzenie), linewidth = 0.9) +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 30, linewidth = 0.7) + geom_point(size = 3.3) +
  geom_text(data = etyk, aes(label = tekst), hjust = 1, size = 3.7, lineheight = 0.95, show.legend = FALSE) +
  scale_colour_manual(values = kol_urz, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(0, 250, 500, 1000)) +
  labs(title = "Telefon traci względnie więcej, ale test interakcji tego nie rozstrzyga",
       subtitle = "Punkty – konwersja z 95% CI (Wilson), linie – regresja logistyczna z interakcją",
       x = "Dodane opóźnienie (ms)", y = "Konwersja sesji (%)") +
  motyw
p6   # zapis: ggsave("czas-ladowania-telefon-komputer.svg", p6, width = 10, height = 5.8)
Wynik w R
Interakcja dawka × urządzenie: chi2 = 0.37  df = 1  p = .543
         OR_100ms ci_dol ci_gora
komputer   0.9941 0.9855  1.0027
telefon    0.9903 0.9812  0.9994
 dawka_ms urzadzenie    k     n  konw   dol  gora zmiana_wzgl_proc
        0   komputer 1120 14594 7.674 7.254 8.117            0.000
      250   komputer 1091 14534 7.507 7.089 7.946           -2.187
      500   komputer 1039 14397 7.217 6.805 7.651           -5.963
     1000   komputer 1052 14463 7.274 6.862 7.708           -5.221
        0    telefon  983 21937 4.481 4.215 4.763            0.000
      250    telefon  909 21828 4.164 3.907 4.438           -7.066
      500    telefon  933 21975 4.246 3.987 4.520           -5.251
     1000    telefon  873 21717 4.020 3.767 4.289          -10.291
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw (pakiet colorspace)
library(colorspace)
pary <- list("0 ms – 250 ms" = c("#0072B2", "#56B4E9"), "250 ms – 500 ms" = c("#56B4E9", "#E69F00"),
             "500 ms – 1000 ms" = c("#E69F00", "#D55E00"), "komputer – telefon" = c("#0072B2", "#D55E00"),
             "obserwacja – po korekcie" = c("#E69F00", "#CC79A7"), "po korekcie – eksperyment" = c("#CC79A7", "#009E73"),
             "nie zwraca się – zwraca się" = c("#E69F00", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
0 ms – 250 ms                               26.4         24.7       24.6
250 ms – 500 ms                            113.1        111.4      101.5
500 ms – 1000 ms                            33.4         18.4       24.9
komputer – telefon                         114.6        108.3       91.9
obserwacja – po korekcie                    88.6         81.3       87.6
po korekcie – eksperyment                   87.5         18.1       36.2
nie zwraca się – zwraca się                 88.7         66.3       51.5
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja logistyczna i liniowa (glm, lm), testy ilorazu wiarygodności, test trendu (prop.trend.test), przedziały Wilsona (prop.test) i splajn naturalny (splines::ns) – pakiety stats i splines z podstawowej instalacji R. Błędy standardowe odporne na skupienie – pakiet sandwich. Rysunki wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Opóźnienie dodane ≠ czas, który widzi klient. Mediana czasu całkowitego rośnie z 1.88 s do 2.88 s, ale 90. centyl to 3.81 s już przy 0 ms, a na telefonie 4.37 s. 22% sesji bez opóźnienia ładowało się dłużej niż mediana sesji z 1000 ms. Raportuj rozkład czasu całkowitego, nie tylko dawkę.
- Kilka stron w sesji, kilka sesji u osoby. Analiza „na sesję” przy losowaniu użytkowników wymaga przedziałów odpornych na skupienie lub bootstrapu użytkowników. Tu różnica jest mała (SE odporne większe o 2.8%), bo użytkownik ma średnio 1.45 sesji; przy stałych klientach rośnie (zob. pseudoreplikacja).
- Losowanie strony zamiast użytkownika. Jeśli opóźnienie losuje się przy każdym wyświetleniu, klient dostaje mieszankę dawek, a jego decyzja zależy od całej wizyty.
- Przychód jest dużo bardziej zaszumiony niż konwersja. Test zaplanowany na konwersję rzadko rozstrzyga przychód (zob. skośne metryki).
Najczęstsze pytania
Jak sprawdzić, czy czas ładowania strony wpływa na sprzedaż?
Zrób eksperyment: losowo dodaj części użytkowników niewielkie opóźnienie (np. 250, 500 i 1000 ms) i porównaj konwersję między grupami. Porównanie szybkich i wolnych sesji w danych z analityki myli, bo wolno ładują się strony u osób z telefonami, słabymi łączami i starszym sprzętem, które kupują rzadziej z innych powodów. W przykładzie dane obserwacyjne zawyżyły skutek prawie trzy razy.
Ile konwersji traci sklep na każde 100 ms ładowania?
To zależy od sklepu, urządzeń i wyjściowego czasu ładowania, dlatego warto to zmierzyć u siebie. W fikcyjnym sklepie z filamentami każde 100 ms dodanego opóźnienia obniżało konwersję sesji o 0.040 pp, 95% CI [0.008, 0.072], czyli OR = 0.992 na 100 ms. Przeliczenie na pieniądze ma bardzo szeroki przedział, bo przychód jest dużo bardziej zaszumiony niż konwersja.
Czy spowalnianie strony w eksperymencie jest etyczne?
Pogarszasz obsługę części klientów, więc ogranicz koszt: małe dawki, krótki czas, część ruchu i metryki ochronne z progiem zatrzymania ustalonym przed startem. Gdy to możliwe, testuj przyspieszenie zamiast spowolnienia – wtedy grupa eksperymentalna zyskuje.
Dlaczego w teście A/B czasu ładowania losuje się użytkowników, a nie sesje?
Bo decyzja o zakupie zależy od całej wizyty, a często od kilku wizyt. Jeśli ta sama osoba raz dostaje szybką, a raz wolną stronę, grupy się mieszają. Przy losowaniu użytkowników analizę na sesjach trzeba prowadzić z błędami odpornymi na skupienie albo bootstrapem całych użytkowników.
Czy efekt spowolnienia jest taki sam na telefonie i komputerze?
Niekoniecznie. W przykładzie konwersja przy 1000 ms spadła względnie o 10.3% na telefonach i o 5.2% na komputerach, ale test interakcji nie był istotny (p = .543). Test interakcji ma małą moc, więc brak istotności nie dowodzi jednakowego efektu.
Powiązane hasła
Przeczytaj też
Metryki ochronne w teście A/B
Test nie-gorszości z marginesem, symulacja, moc dla rzadkich metryk i reguła decyzji – na fikcyjnym teście serwisu biletowego, z kodem R.
Czytaj →PoradnikIle powiadomień push wysyłać
Aplikacja do nauki języków i 4 dawki powiadomień: krzywe dawka–odpowiedź, kliknięcia, wypisy, zmęczenie i optimum z bootstrapu – z kodem R.
Czytaj →PoradnikTest A/B z wieloma wariantami
Pięć tematów maila i kontrola: Dunnett, Holm i Tukey, klątwa zwycięzcy w 1000 symulacji, test potwierdzający i moc – pięć rysunków z kodem R.
Czytaj →Piszesz pracę o eksperymentach online albo planujesz test szybkości strony?
Pomożemy zaplanować dawki i jednostkę losowania, policzyć krzywą dawka–odpowiedź z przedziałami i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Armitage, P. (1955). Tests for linear trends in proportions and frequencies. Biometrics, 11(3), 375–386. https://doi.org/10.2307/3001775
- Desquilbet, L., & Mariotti, F. (2010). Dose-response analyses using restricted cubic spline functions in public health research. Statistics in Medicine, 29(9), 1037–1057. https://doi.org/10.1002/sim.3841
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Nah, F. F.-H. (2004). A study on tolerable waiting time: How long are Web users willing to wait? Behaviour & Information Technology, 23(3), 153–163. https://doi.org/10.1080/01449290410001669914 ● Otwarty dostęp: pełny tekst
- VanderWeele, T. J. (2019). Principles of confounder selection. European Journal of Epidemiology, 34(3), 211–219. https://doi.org/10.1007/s10654-019-00494-6 ● Otwarty dostęp
Cytowania BibTeX
@article{armitage1955tests, author={Armitage, P.}, title={{Tests for linear trends in proportions and frequencies}}, journal={Biometrics}, year={1955}, volume={11}, number={3}, pages={375--386}, doi={10.2307/3001775}}@article{desquilbet2010dose, author={Desquilbet, Loïc and Mariotti, François}, title={{Dose-response analyses using restricted cubic spline functions in public health research}}, journal={Statistics in Medicine}, year={2010}, volume={29}, number={9}, pages={1037--1057}, doi={10.1002/sim.3841}}@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{nah2004study, author={Nah, Fiona Fui-Hoon}, title={{A study on tolerable waiting time: How long are Web users willing to wait?}}, journal={Behaviour \& Information Technology}, year={2004}, volume={23}, number={3}, pages={153--163}, doi={10.1080/01449290410001669914}}@article{vanderweele2019principles, author={VanderWeele, Tyler J.}, title={{Principles of confounder selection}}, journal={European Journal of Epidemiology}, year={2019}, volume={34}, number={3}, pages={211--219}, doi={10.1007/s10654-019-00494-6}}