Przykład: serwis ze zdjęciami w chmurze
Fikcyjny serwis przechowuje zdjęcia w chmurze w czterech planach: darmowym (10 GB), 100 GB za 9.99 zł miesięcznie, 1 TB za 29.99 zł i rodzinnym (2 TB dla 5 osób) za 44.99 zł. Część klientów płaci za rok z góry. Dział marketingu ma plan każdego konta na koniec każdego miesiąca przez dwa lata i pyta: jak klienci przechodzą między planami, ile przyniesie nowe konto w pierwszym roku i co się stanie, gdy podrożeje plan 1 TB?
Dane obejmują 40 000 kont: 30 000 założonych przed okresem obserwacji i 10 000 nowych kont darmowych z miesięcy 1–12. Daje to 779 644 przejścia z miesiąca do miesiąca. Rezygnacja (zamknięcie konta) jest stanem pochłaniającym: kto do niej trafi, już nie wychodzi. Do 24. miesiąca konto zamknęło 9704 klientów.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Parametry ustaliliśmy ręcznie (lista przy kodzie): rezygnacje są częstsze w pierwszych dwóch miesiącach w planie, konta roczne schodzą niżej lub rezygnują tylko w miesiącu odnowienia, a przejścia na wyższy plan rosną gwałtownie przy ponad 90% zajętego miejsca. Po pierwszym uruchomieniu zmniejszyliśmy tempo dokładania zdjęć i skok przejść z planu darmowego przy pełnym miejscu, bo na planie darmowym zostawało po dwóch latach tylko 15.9% kont. Ziaren nie zmienialiśmy. Dane pobierzesz jako zmiana-planu-abonamentu-konta.csv (opis kolumn w przepisie 1, odtworzenie danych – w przepisie 9).
Wpis rozwija tekst o przechodzeniu między markami (tam: kolejne zakupy i rozkład stacjonarny; tu: miesiące, stan pochłaniający, staż w planie i przychód). Inne tematy prac zebraliśmy we wpisie statystyka w pracy z marketingu.
Rysunek 1: dokąd płyną konta w ciągu miesiąca
Zaczynamy od obrazu całości: pola to plany, strzałki – przejścia, a grubość strzałki – średnia liczba kont na miesiąc.
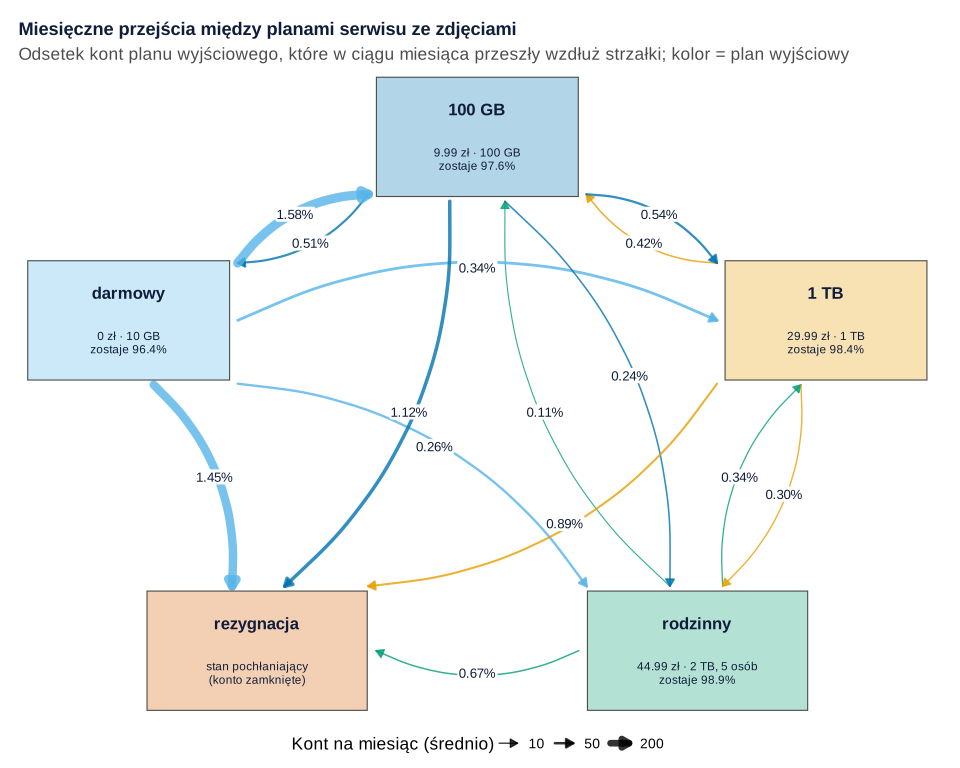
Co widać. Co miesiąc w planie zostaje od 96.4% kont darmowych do 98.9% rodzinnych. Najczęstsze ruchy to przejście z planu darmowego na 100 GB (średnio 288 kont miesięcznie) i rezygnacja z planu darmowego (265 kont). Rezygnacje z planów płatnych maleją wraz z ceną: 1.12% w 100 GB, 0.89% w 1 TB, 0.67% w rodzinnym.
Jak może zmylić. Diagram uśrednia 24 miesiące i wszystkie konta, więc nie pokazuje, kiedy konto się rusza – a to okaże się kluczowe. Można go zastąpić diagramem Sankeya, ale przy przepływach w obie strony strzałki są czytelniejsze.
Rysunek 2: macierz przejść z przedziałami ufności
Liczby z diagramu pochodzą z macierzy przejść. To tabela krzyżowa „plan na koniec miesiąca × plan na koniec następnego miesiąca”, w której każdy wiersz dzielimy przez jego sumę. Anderson i Goodman (1957) pokazali, że tak liczone odsetki są estymatorami największej wiarygodności prawdopodobieństw przejść w łańcuchu Markowa. Wiersz rezygnacji ma 100% na przekątnej.
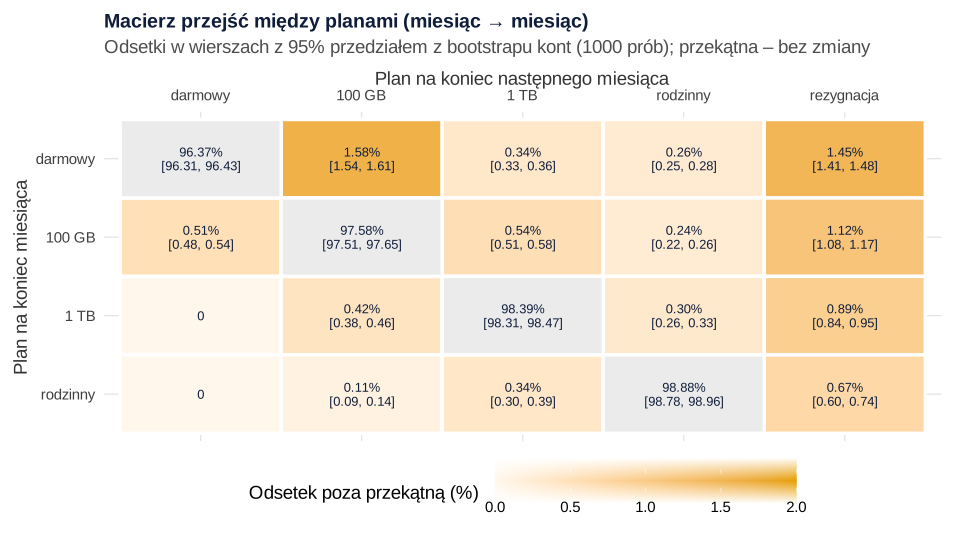
Co widać. Z planu darmowego co miesiąc 1.58% kont przechodzi na 100 GB (95% CI [1.54, 1.61]), a 1.45% rezygnuje [1.41, 1.48]. Z planu 100 GB rezygnuje 1.12% [1.08, 1.17], na 1 TB przechodzi 0.54%, a do planu darmowego wraca 0.51%.
Skąd przedziały. Jedno konto daje do 24 przejść, więc losujemy ze zwracaniem całe konta (1000 razy) i za każdym razem liczymy macierz od nowa. Field i Welsh (2007) wykazali, że bootstrap całych skupień daje zgodne oszacowania wariancji także przy powiązanych obserwacjach. Dla pojedynczej komórki różnica jest mała (przedział Wilsona dla rezygnacji z 100 GB: [1.078, 1.173], bootstrap: [1.076, 1.174]), ale bootstrap kont przyda się przy prognozie i przychodzie.
Jak może zmylić. Macierz łączy stare i nowe konta oraz rozliczenie miesięczne i roczne. Wąski przedział mówi, że średnia jest precyzyjna, a nie że konta są jednakowe.
Rysunek 3: łańcuch Markowa – prognoza dla nowych kont i przychód
Jeśli przejścia zależą tylko od obecnego planu, rozkład planów po t miesiącach to πt = π0Pt, gdzie nowe konto startuje z π0 = (1, 0, 0, 0, 0) (plan darmowy). Potęgę liczy funkcja %^% z pakietu expm, a przychód w 12 miesiącach to suma iloczynów πt i cen. Prognozę sprawdzamy na 10 000 nowych kont z pełnym rokiem obserwacji. Trzeci wariant to łańcuch na rozszerzonych stanach: każdy plan dzielimy na „1.–2. miesiąc w planie” i „dłużej”.
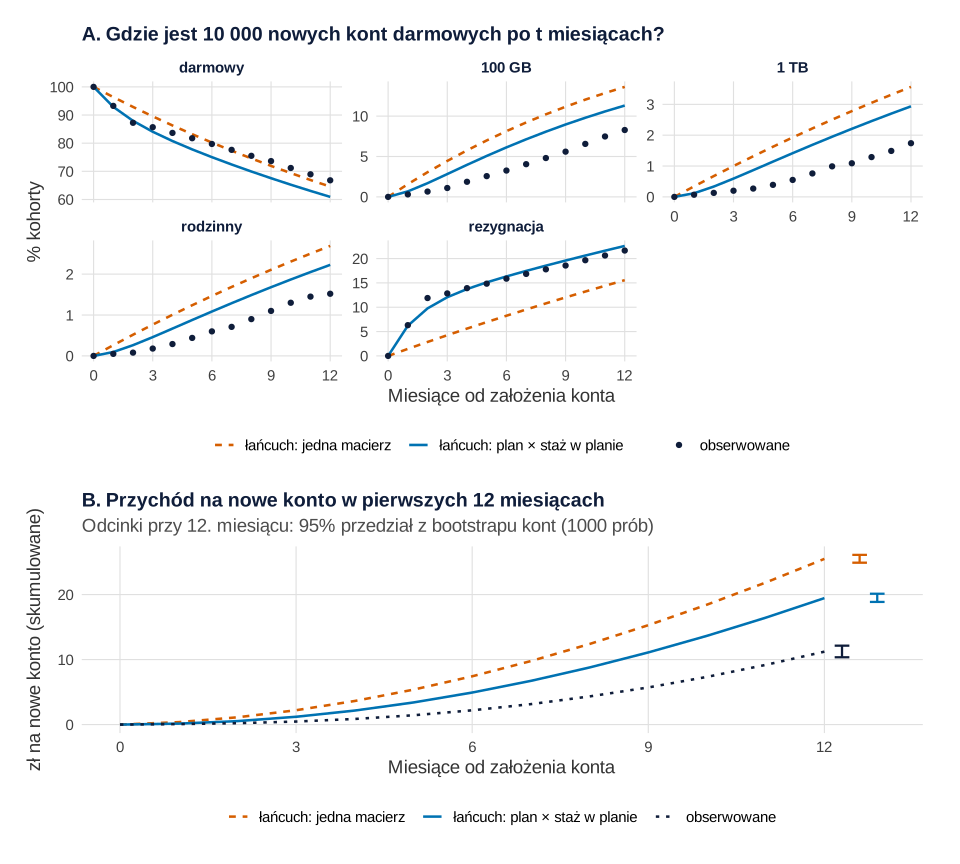
Co widać – panel A. Łańcuch z jedną macierzą zaniża wczesne rezygnacje (po 3 miesiącach 4.3% zamkniętych kont, w danych 12.8%) i zawyża przejścia na płatne plany (po 12 miesiącach 13.6% kont w planie 100 GB, w danych 8.3%). Łańcuch ze stażem trafia w rezygnacje (12.1%), ale nadal zawyża przejścia w górę (11.3%).
Co widać – panel B. Nowe konto przyniosło w pierwszym roku średnio 11.22 zł (95% CI [10.36, 12.14]). Łańcuch z jedną macierzą przewiduje 25.50 zł [24.90, 26.11], czyli o 14.28 zł więcej [13.41, 15.14]. Rozszerzony łańcuch przewiduje 19.46 zł [18.87, 20.13]. Przedziały pochodzą z bootstrapu kont.
Jak może zmylić. Wąski przedział nie oznacza trafnej prognozy: bootstrap mierzy niepewność macierzy, a nie błąd modelu. Ta sama macierz daje przez macierz fundamentalną (I − Q)−1 „wartość do rezygnacji” nowego konta: 90.8 miesiąca i 1570.84 zł – z modelu, który już po roku myli się ponad dwukrotnie. Wartość klienta (CLV) bezpieczniej liczyć z krótkim horyzontem i danymi kohort.
Rysunek 4: sprawdzenie założenia Markowa – staż w planie
Założenie Markowa mówi, że przyszłość zależy tylko od obecnego planu, a nie od czasu spędzonego w nim. Sprawdzamy to, rysując odsetek przejść według miesiąca w planie.
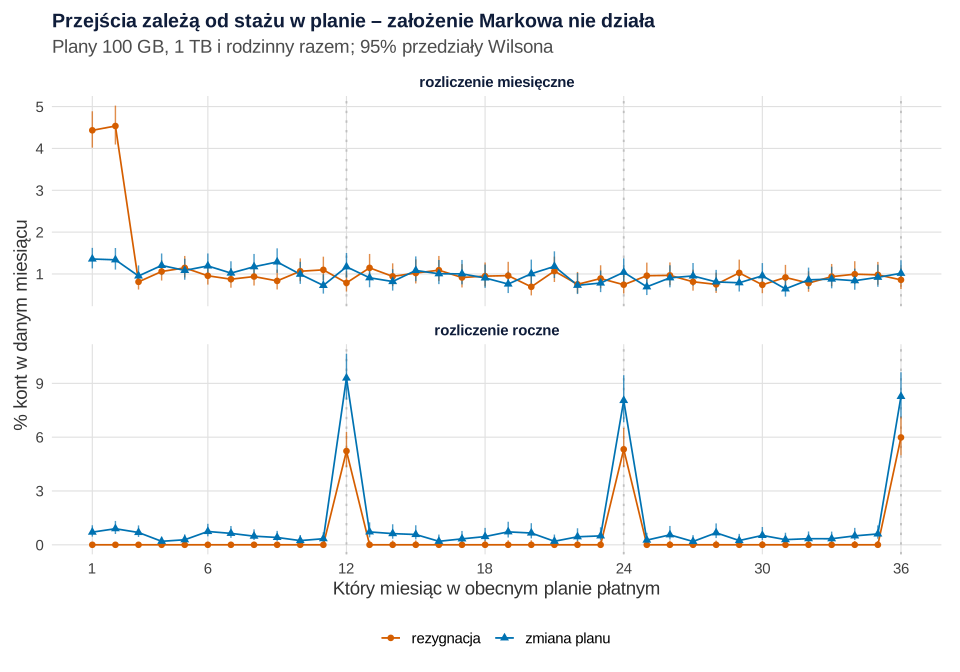
Co widać. Przy rozliczeniu miesięcznym w 1. miesiącu planu rezygnuje 4.43% kont [4.02, 4.89], w 2. – 4.54%, a od 3. miesiąca około 1%. W pierwszych dwóch miesiącach rezygnuje łącznie 4.48% konto-miesięcy, później 0.93% (χ²(1) = 1555.7, p < .001). Przy rozliczeniu rocznym rezygnacji w trakcie roku nie ma wcale. W 12. miesiącu rezygnuje 5.23% kont [4.33, 6.29], a plan zmienia 9.30% [8.10, 10.65].
Model wielostanowy. Model wielostanowy opisuje proces przez intensywności przejść (Andersen i Keiding, 2002). Kalbfleisch i Lawless (1985) podali jego estymację dla danych panelowych, w których stan widać tylko w wybranych chwilach – u nas na koniec miesiąca. W pakiecie msm (Jackson, 2011) na podpróbie 3000 kont z rozliczeniem miesięcznym dodaliśmy zmienną „1.–2. miesiąc w planie” do intensywności rezygnacji. Test ilorazu wiarygodności: χ²(4) = 261.4, p < .001. Ilorazy hazardów rezygnacji na początku planu wynoszą od 3.14 [1.65, 5.98] dla planu 1 TB do 7.56 [3.55, 16.09] dla rodzinnego.
Jak może zmylić. Wykres łączy trzy plany płatne, a staż może częściowo zastępować inną zmienną. Rozszerzenie stanów naprawiło rezygnacje, ale nie przejścia w górę – te zależą od zajętego miejsca.
Rysunek 5: model wielomianowy – kiedy kończy się miejsce
Z planu 100 GB w następnym miesiącu są cztery wyjścia: bez zmian, wyżej (1 TB lub rodzinny), niżej (darmowy) albo rezygnacja. Stosujemy wielomianową regresję logistyczną (multinom() z pakietu nnet, kategoria odniesienia „bez zmian”) z zapełnieniem miejsca i 1.–2. miesiącem w planie jako predyktorami: 139 508 konto-miesięcy 10 194 kont z rozliczeniem miesięcznym (konta roczne w trakcie roku nie mogą zejść niżej). Zapełnienie wchodzi liniowo, z progiem 90% albo jako splajn naturalny.
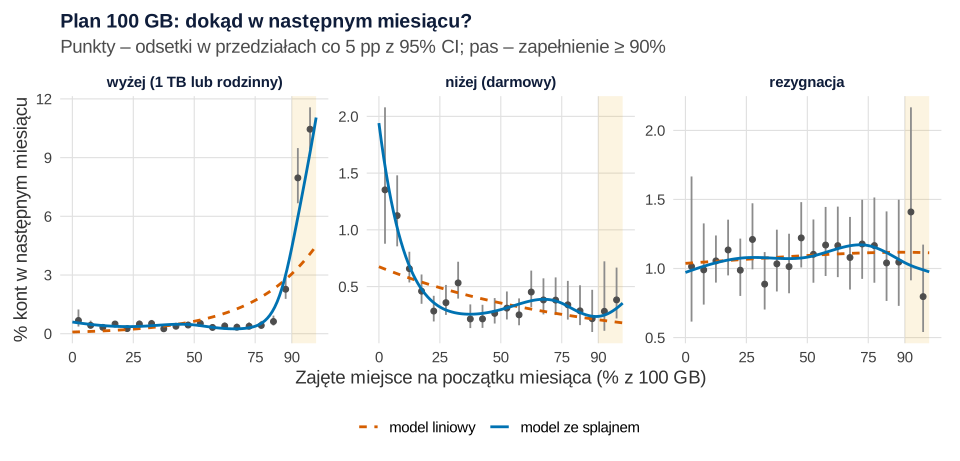
Co widać. Według modelu ze splajnem na wyższy plan przechodzi miesięcznie 0.45% kont przy połowie zajętego miejsca, 1.95% przy 85%, 4.39% przy 90% i 11.05% przy pełnym dysku. Model liniowy wygładza ten skok: przy 90% daje 3.06%, a przy pełnym dysku tylko 4.49%. Według kryterium AIC najlepszy jest splajn (38 009.3), potem model z progiem (38 130.4), a najsłabszy model liniowy (38 772.8). W modelu z progiem iloraz ryzyk względnych (RRR) przejścia wyżej przy zapełnieniu ≥ 90% wynosi 14.47 [11.57, 18.09]. Zejście do planu darmowego jest częstsze przy prawie pustym miejscu (1.26% przy 5% wobec 0.30% przy 50%), a rezygnacja – w 1.–2. miesiącu planu (RRR = 4.90 [4.34, 5.54]).
Jak może zmylić. Próg 90% może wynikać z komunikatu „kończy się miejsce”, a nie z natury klientów – ale widać go tylko w modelu z nieliniowością. Klienci nie zawsze wybierają też plan najtańszy dla siebie: Lambrecht i Skiera (2006) pokazali, że wielu woli płacić ryczałt mimo wyższego rachunku i nie odchodzi przez to częściej.
Rysunek 6: symulacja – podwyżka planu 1 TB
Zarząd chce podnieść cenę planu 1 TB z 29.99 do 34.99 zł. Skutki liczymy macierzą przejść dla 1000 aktywnych kont ze stanu z 24. miesiąca. Trzeba jednak przyjąć, jak podwyżka zmieni przejścia – tych liczb nie ma w danych. Założyliśmy, że odpływ z 1 TB (rezygnacje i zejścia do 100 GB) wzrośnie m = 1.5 raza, a przejścia do 1 TB spadną o 20%, i pokazujemy analizę wrażliwości dla m od 1 do 4.
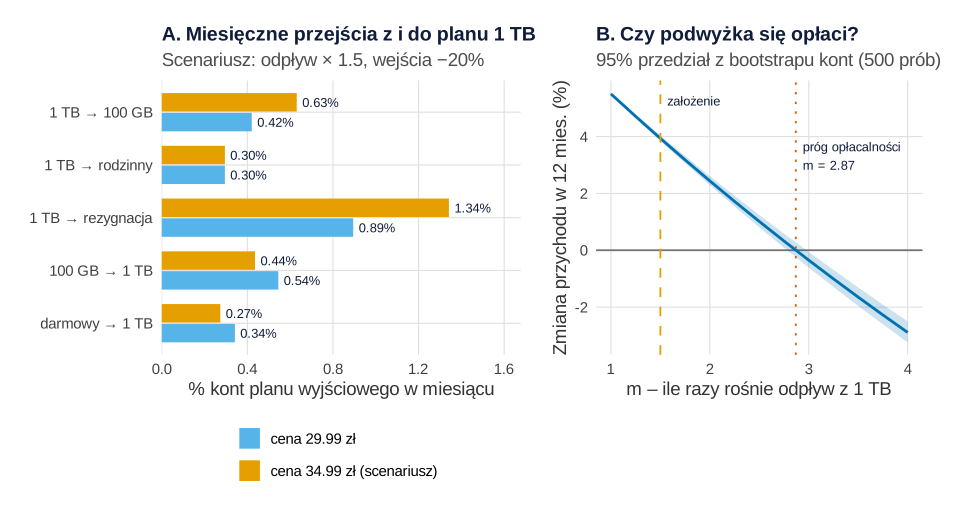
Co widać. Przy założeniach scenariusza po 12 miesiącach w planie 1 TB jest 148.3 konta na 1000 zamiast 165.6, a zamkniętych kont jest 138.2 zamiast 130.2. Przychód z 1000 kont w roku rośnie jednak ze 153 933.9 do 159 990.9 zł, czyli o 3.9% (95% CI [3.84, 4.04]). Podwyżka przestaje się opłacać dopiero wtedy, gdy odpływ z 1 TB wzrośnie 2.87 raza.
Jak może zmylić. Przedział obejmuje tylko niepewność macierzy, a o wyniku decyduje m, którego dane nie znają – zmierzy je losowy test ceny. Symulacja dziedziczy też wady jednej macierzy: ignoruje staż w planie i plany roczne.
Co z tym zrobić w marketingu
- Pilnuj pierwszych dwóch miesięcy w nowym planie. Wtedy rezygnuje ok. 4.5% kont miesięcznie, później ok. 1%. Tu najbardziej przyda się pomoc w przeniesieniu zdjęć czy przypomnienie o funkcjach – a jej skutek sprawdź w teście.
- Proponuj wyższy plan przy 85–90% zajętego miejsca. Wcześniej szansa zmiany planu jest niska, potem rośnie kilkunastokrotnie. Konta z prawie pustym miejscem częściej schodzą do planu darmowego. Podobny problem „co zaproponować dalej” opisuje wpis o sprzedaży krzyżowej modułów.
- Nie planuj przychodu z jednej macierzy. Tu przeszacowała przychód z nowego konta ponad dwukrotnie (25.50 zł wobec 11.22 zł). Prognozuj kohortami z podziałem na staż i rozliczenie i sprawdzaj prognozę na kohortach z pełnymi danymi.
- Licz konta roczne osobno. Ich rezygnacje i zmiany planu skupiają się w miesiącu odnowienia – tam kieruj działania utrzymaniowe.
- Decyzję o cenie opieraj na teście, nie na założeniu. Symulacja wskazuje próg (m = 2.87), ale nie mówi, jaki odpływ nastąpi. Rezygnacje po podwyżce przeanalizujesz jak we wpisie o churnie jako analizie przeżycia. Gdy podwyżka wiąże się z ofertą promocyjną, zob. rabat na pierwszy miesiąc a rezygnacje.
Jak opisać w pracy
W Metodzie opisz stany, jednostkę czasu, przedziały i sprawdzenie założenia Markowa; w Wynikach – macierz, trafność prognozy i model wielomianowy. Ocenę modelu na późniejszym okresie pokazuje też wpis o ocenie rekomendacji offline.
Kod R: macierz przejść, łańcuch Markowa, msm, model wielomianowy i symulacja ceny
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane i plik CSV, z których korzystają kolejne, a przepis 2 – funkcję macierz(). Potęgi macierzy liczy pakiet expm, model wielostanowy – msm, wielomianową regresję logistyczną – multinom() z pakietu nnet, a splajny naturalne – ns() z pakietu splines. Bootstrap jest napisany ręcznie: losujemy konta ze zwracaniem, a wagi kont mnożymy przez ich liczby przejść. Każdy przepis z rysunkiem kończy się nazwą wykresu (p2–p7), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(768)), 2 (set.seed(7681)), 3 (set.seed(7682)), 4 (set.seed(7684)) i 6 (set.seed(7686)); ziaren nie zmieniano. Ręcznie ustalono: ceny i limity planów, 30 000 starych i 10 000 nowych kont, rozkład planów w miesiącu 0 (60/22/12/6%), 25% rozliczeń rocznych w planach płatnych, tempo dokładania zdjęć (rozkład logarytmiczno-normalny, mediana 0.3 GB miesięcznie), wszystkie miesięczne prawdopodobieństwa przejść w funkcji przejscia() (m.in. rezygnacja 6% / 5% / 4% / 3% w 1.–2. miesiącu planu darmowego / 100 GB / 1 TB / rodzinnego wobec 1.2% / 1.1% / 0.9% / 0.6% później; skok przejść wyżej przy zapełnieniu ok. 90%; konta roczne schodzą niżej i rezygnują tylko w miesiącu odnowienia) oraz założenia scenariusza podwyżki (odpływ z 1 TB × m, wejścia do 1 TB −20%). Po pierwszym uruchomieniu zmieniono dwa parametry: medianę dokładanych zdjęć z 1 do 0.3 GB miesięcznie (rozrzut 1.2 → 1.3) i skok przejść z planu darmowego na 100 GB przy pełnym miejscu z 9% do 5% miesięcznie – wcześniej po 24 miesiącach na planie darmowym zostawało tylko 15.9% kont. Poprawiono też dwa błędy w kodzie (brak nazw wierszy macierzy, porównanie czynników o różnych poziomach), skrócono zapis CSV (pierwsza wersja miała 7 MB), w przepisie 5 RRR dla zapełnienia przeliczono na 10 punktów procentowych i dodano wiersz z modelem liniowym, w przepisie 7 zmieniono układ pól diagramu, a na koniec – by zmniejszyć plik CSV z 3.6 do 1.8 MB – zapisano w nim zapełnienie tylko dla planu 100 GB i staż w planie w miesiącu 0. Zapełnienie w analizie zaokrąglono przy tym do 1%, tak jak w pliku; zmieniło to tylko wyniki przepisu 5 (np. RRR dla progu 90% z 14.30 na 14.47). Przepis 9 odtwarza z CSV przejścia, rozliczenie, staż i zapełnienie i sprawdza, że są identyczne z danymi z przepisu 1. Całość liczy się w mniej niż minutę.
1. Paleta, motyw i dane
R
# Przepis 1. Fikcyjny serwis do przechowywania zdjęć w chmurze: plan każdego konta na koniec
# miesięcy 0–24 (darmowy, 100 GB, 1 TB, rodzinny; rezygnacja = konto zamknięte), dane symulowane
library(ggplot2)
library(patchwork)

# Paleta oparta na Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
plany <- c("darmowy", "100 GB", "1 TB", "rodzinny", "rezygnacja")
kol_plan <- c("darmowy" = "#56B4E9", "100 GB" = "#0072B2", "1 TB" = "#E69F00", "rodzinny" = "#009E73",
              "rezygnacja" = "#D55E00")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie ------------------------------------------------------------------
cena  <- c(0, 9.99, 29.99, 44.99, 0)        # zł miesięcznie: darmowy, 100 GB, 1 TB, rodzinny, rezygnacja
limit <- c(10, 100, 1000, 2000, Inf)        # GB miejsca w planie
n_stare <- 30000                            # konta założone przed oknem obserwacji (miesiąc 0)
n_nowe  <- 10000                            # nowe konta darmowe założone w miesiącach 1–12
start_plan <- c(0.60, 0.22, 0.12, 0.06)     # rozkład planów starych kont w miesiącu 0
p_roczny <- 0.25                            # część kont płatnych z rozliczeniem rocznym
prog <- function(z) plogis((z - 0.90) / 0.02)   # „próg 90%”: gwałtowny wzrost chęci zmiany planu
# Miesięczne prawdopodobieństwa przejść (prawda symulacji). k = który to miesiąc w obecnym planie,
# z = zapełnienie miejsca na początku miesiąca (0–1). Konta roczne nie schodzą niżej i nie rezygnują
# w trakcie roku – tylko w 12., 24., ... miesiącu planu (wyżej przejść mogą zawsze).
przejscia <- function(s, k, z, roczny) {
  n <- length(s); P <- matrix(0, n, 5)
  nowy <- k <= 2; rocznica <- k %% 12 == 0; blok <- roczny & !rocznica; ann <- roczny & rocznica
  d <- s == 1   # darmowy
  P[d, 2] <- 0.003 + 0.050 * prog(z[d]); P[d, 3] <- 0.0006 + 0.012 * prog(z[d])
  P[d, 4] <- 0.0006 + 0.008 * prog(z[d]); P[d, 5] <- ifelse(nowy[d], 0.06, 0.012)
  m <- s == 2   # 100 GB
  wyzej <- 0.004 + 0.110 * prog(z[m])
  P[m, 3] <- 0.7 * wyzej; P[m, 4] <- 0.3 * wyzej
  P[m, 1] <- ifelse(blok[m], 0, ifelse(ann[m], 0.10, 0.003 + 0.015 * exp(-z[m] / 0.08)))
  P[m, 5] <- ifelse(blok[m], 0, ifelse(ann[m], 0.06, ifelse(nowy[m], 0.05, 0.011)))
  t1 <- s == 3  # 1 TB
  P[t1, 4] <- 0.003
  P[t1, 2] <- ifelse(blok[t1], 0, ifelse(ann[t1], 0.06, 0.004))
  P[t1, 5] <- ifelse(blok[t1], 0, ifelse(ann[t1], 0.05, ifelse(nowy[t1], 0.04, 0.009)))
  r <- s == 4   # rodzinny
  P[r, 3] <- ifelse(blok[r], 0, ifelse(ann[r], 0.04, 0.003)); P[r, 2] <- ifelse(blok[r], 0, 0.0015)
  P[r, 5] <- ifelse(blok[r], 0, ifelse(ann[r], 0.04, ifelse(nowy[r], 0.03, 0.006)))
  P[cbind(seq_len(n), s)] <- 1 - rowSums(P)   # bez zmiany
  P
}

set.seed(768)
n <- n_stare + n_nowe
rejestracja <- c(rep(0L, n_stare), sample(1:12, n_nowe, replace = TRUE))   # miesiąc założenia konta
s <- c(sample(1:4, n_stare, replace = TRUE, prob = start_plan), rep(1L, n_nowe))
d <- c(sample(2:36, n_stare, replace = TRUE), rep(0L, n_nowe))   # pełne miesiące w obecnym planie
roczny <- s %in% 2:4 & runif(n) < p_roczny
u <- c(rbeta(n_stare, 2, 2.5) * limit[s[1:n_stare]], pmin(rlnorm(n_nowe, log(1.5), 0.8), 10))   # zajęte GB
g <- rlnorm(n, log(0.3), 1.3)               # ile GB zdjęć konto dokłada miesięcznie (mediana 0.3 GB)
STAN <- ZAJ <- ROCZ <- STAZ <- matrix(NA, n, 25)
aktywne <- rejestracja == 0
STAN[aktywne, 1] <- s[aktywne]; ZAJ[aktywne, 1] <- u[aktywne]; ROCZ[aktywne, 1] <- roczny[aktywne]
STAZ[aktywne, 1] <- d[aktywne]
for (m in 1:24) {                           # miesiąc m: przejście ze stanu na koniec m − 1 do stanu na koniec m
  i <- which(aktywne & s <= 4)
  if (length(i)) {
    P <- przejscia(s[i], d[i] + 1, pmin(u[i] / limit[s[i]], 1), roczny[i])
    nowe_s <- 1L + rowSums(runif(length(i)) > t(apply(P, 1, cumsum)))
    zmiana <- nowe_s != s[i]
    na_platny <- zmiana & s[i] == 1 & nowe_s %in% 2:4
    roczny[i[na_platny]] <- runif(sum(na_platny)) < p_roczny
    roczny[i[zmiana & nowe_s %in% c(1, 5)]] <- FALSE
    d[i] <- ifelse(zmiana, 0L, d[i] + 1L); s[i] <- nowe_s
    rosnie <- i[s[i] <= 4 & u[i] < limit[s[i]]]
    u[rosnie] <- pmin(u[rosnie] + g[rosnie], limit[s[rosnie]])   # pełne miejsce = nie da się dodać zdjęć
  }
  nowe <- rejestracja == m; aktywne <- aktywne | nowe
  j <- which(aktywne)
  STAN[j, m + 1] <- s[j]; ZAJ[j, m + 1] <- u[j]; ROCZ[j, m + 1] <- roczny[j]; STAZ[j, m + 1] <- d[j]
}

# Przejścia miesiąc do miesiąca w formacie długim (tylko z planów aktywnych)
idx <- which(!is.na(STAN[, -25]) & STAN[, -25] <= 4, arr.ind = TRUE)
prz <- data.frame(konto = idx[, 1], miesiac = idx[, 2],                          # przejście z m − 1 do m
                  z = factor(plany[STAN[idx]], plany), do = factor(plany[STAN[cbind(idx[, 1], idx[, 2] + 1)]], plany),
                  roczny = ROCZ[idx], k = STAZ[idx] + 1,                         # k – który miesiąc w planie
                  zapelnienie = round(100 * pmin(ZAJ[idx] / limit[STAN[idx]], 1)) / 100,   # z dokładnością do 1%
                  nowe_konto = rejestracja[idx[, 1]] > 0)
c(kont = n, stare = n_stare, nowe = n_nowe, przejsc = nrow(prz),
  zamkniete_do_24 = sum(STAN[, 25] == 5), konta_roczne_kiedykolwiek = sum(rowSums(ROCZ, na.rm = TRUE) > 0))
round(100 * table(factor(plany[STAN[, 1]], plany)) / n_stare, 1)            # plany starych kont w miesiącu 0
round(100 * table(factor(plany[STAN[, 25]], plany)) / n, 1)                 # wszystkie konta w miesiącu 24

# Plik CSV (bez cudzysłowów): jeden wiersz na konto, numer konta = numer wiersza.
# miesiac_zalozenia – 0 dla kont sprzed okresu obserwacji; staz_m0 – pełne miesiące w planie na koniec miesiąca 0
# (puste dla nowych kont); plan_m0_m24 – 25 znaków (koniec miesięcy 0–24): D darmowy, S 100 GB, T 1 TB,
# R rodzinny, X rezygnacja, małe litery s/t/r – rozliczenie roczne, kropka – konta jeszcze nie było;
# zap_100gb – zajęte miejsce w % (liczby całkowite) w miesiącach w planie 100 GB, oddzielone „;”
znak <- matrix(c("D", "S", "T", "R", "X")[STAN], n)
znak[!is.na(ROCZ) & ROCZ] <- tolower(znak[!is.na(ROCZ) & ROCZ]); znak[is.na(znak)] <- "."
zap <- round(100 * pmin(ZAJ / 100, 1)); zap[is.na(STAN) | STAN != 2] <- NA
write.csv(data.frame(miesiac_zalozenia = rejestracja, staz_m0 = ifelse(rejestracja == 0, STAZ[, 1], NA),
                     plan_m0_m24 = apply(znak, 1, paste, collapse = ""),
                     zap_100gb = apply(zap, 1, function(x) paste(x[!is.na(x)], collapse = ";"))),
          "zmiana-planu-abonamentu-konta.csv", row.names = FALSE, quote = FALSE, na = "")
Wynik w R
                     kont                     stare                      nowe
                    40000                     30000                     10000
                  przejsc           zamkniete_do_24 konta_roczne_kiedykolwiek
                   779644                      9704                      5329

   darmowy     100 GB       1 TB   rodzinny rezygnacja
      59.7       22.1       12.1        6.1        0.0

   darmowy     100 GB       1 TB   rodzinny rezygnacja
      32.4       23.7       11.9        7.7       24.3
2. Macierz przejść i bootstrap kont: Rysunek 2
R
# Przepis 2. Macierz przejść miesiąc do miesiąca z rezygnacją jako stanem pochłaniającym: Rysunek 2
# Korzysta z prz, plany, n, motyw (przepis 1). Przedziały: bootstrap kont (set.seed(7681)).

# Liczby przejść każdego konta jako wiersz 20 komórek (4 plany wyjściowe × 5 stanów docelowych)
komorka <- (as.integer(prz$z) - 1) * 5 + as.integer(prz$do)
C <- unclass(table(factor(prz$konto, 1:n), factor(komorka, 1:20)))
macierz <- function(w) {                     # w – wagi kont (ile razy konto wylosowano)
  N <- matrix(crossprod(w, C), 4, byrow = TRUE)
  M <- rbind(N / rowSums(N), c(0, 0, 0, 0, 1))   # wiersz rezygnacji: stan pochłaniający
  dimnames(M) <- list(z = plany, do = plany); M
}
P <- macierz(rep(1, n))
N <- matrix(colSums(C), 4, byrow = TRUE, dimnames = list(plany[1:4], plany))
N                                             # liczby przejść (konto-miesiące)
round(100 * P, 2)                             # odsetki w wierszach (%)

B <- 1000
set.seed(7681)
boot_P <- replicate(B, macierz(tabulate(sample(n, replace = TRUE), n)))   # tablica 5 × 5 × B
ci_dol <- apply(boot_P, 1:2, quantile, 0.025); ci_gor <- apply(boot_P, 1:2, quantile, 0.975)
tab <- expand.grid(z = plany[1:4], do = plany, stringsAsFactors = FALSE)
tab$proc <- 100 * P[cbind(match(tab$z, plany), match(tab$do, plany))]
tab$dol  <- 100 * ci_dol[cbind(match(tab$z, plany), match(tab$do, plany))]
tab$gora <- 100 * ci_gor[cbind(match(tab$z, plany), match(tab$do, plany))]
print(data.frame(tab[1:2], round(tab[3:5], 2)), row.names = FALSE)

# Dla porównania: przedział Wilsona traktuje każdy konto-miesiąc jak niezależną obserwację (za wąski)
w <- prop.test(N["100 GB", "rezygnacja"], sum(N["100 GB", ]), correct = FALSE)$conf.int
b <- c(ci_dol["100 GB", "rezygnacja"], ci_gor["100 GB", "rezygnacja"])
round(c(wilson_dol = 100 * w[1], wilson_gora = 100 * w[2], bootstrap_dol = 100 * b[1], bootstrap_gora = 100 * b[2],
        iloraz_szerokosci = diff(b) / diff(w)), 3)

tab$jasny <- tab$z == tab$do
tab$z <- factor(tab$z, rev(plany[1:4])); tab$do <- factor(tab$do, plany)
tab$etykieta <- ifelse(tab$proc < 0.005, "0",
                       sprintf("%.2f%%\n[%.2f, %.2f]", tab$proc, tab$dol, tab$gora))
p2 <- ggplot(tab, aes(do, z)) +
  geom_tile(aes(fill = ifelse(jasny, NA, proc)), colour = "white", linewidth = 1.2) +
  geom_tile(data = subset(tab, jasny), fill = "grey92", colour = "white", linewidth = 1.2) +
  geom_text(aes(label = etykieta), size = 3.4, lineheight = 0.9, colour = "#0f1d3a") +
  scale_fill_gradient("Odsetek poza przekątną (%)", low = "#FFF7EC", high = "#E69F00", na.value = "grey92",
                      limits = c(0, 2), oob = scales::squish) +
  scale_x_discrete("Plan na koniec następnego miesiąca", position = "top") +
  labs(y = "Plan na koniec miesiąca", title = "Macierz przejść między planami (miesiąc → miesiąc)",
       subtitle = "Odsetki w wierszach z 95% przedziałem z bootstrapu kont (1000 prób); przekątna – bez zmiany") +
  motyw + theme(panel.grid = element_blank(), legend.key.width = unit(1.6, "cm"))
p2
# ggsave("zmiana-planu-macierz-przejsc.svg", p2, width = 10, height = 5.6)
Wynik w R
         darmowy 100 GB  1 TB rodzinny rezygnacja
darmowy   422528   6911  1499     1153       6349
100 GB       957 182870  1021      453       2107
1 TB           0    409 95681      287        870
rodzinny       0     63   195    55913        378
            do
z            darmowy 100 GB  1 TB rodzinny rezygnacja
  darmowy      96.37   1.58  0.34     0.26       1.45
  100 GB        0.51  97.58  0.54     0.24       1.12
  1 TB          0.00   0.42 98.39     0.30       0.89
  rodzinny      0.00   0.11  0.34    98.88       0.67
  rezygnacja    0.00   0.00  0.00     0.00     100.00
        z         do  proc   dol  gora
  darmowy    darmowy 96.37 96.31 96.43
   100 GB    darmowy  0.51  0.48  0.54
     1 TB    darmowy  0.00  0.00  0.00
 rodzinny    darmowy  0.00  0.00  0.00
  darmowy     100 GB  1.58  1.54  1.61
   100 GB     100 GB 97.58 97.51 97.65
     1 TB     100 GB  0.42  0.38  0.46
 rodzinny     100 GB  0.11  0.09  0.14
  darmowy       1 TB  0.34  0.33  0.36
   100 GB       1 TB  0.54  0.51  0.58
     1 TB       1 TB 98.39 98.31 98.47
 rodzinny       1 TB  0.34  0.30  0.39
  darmowy   rodzinny  0.26  0.25  0.28
   100 GB   rodzinny  0.24  0.22  0.26
     1 TB   rodzinny  0.30  0.26  0.33
 rodzinny   rodzinny 98.88 98.78 98.96
  darmowy rezygnacja  1.45  1.41  1.48
   100 GB rezygnacja  1.12  1.08  1.17
     1 TB rezygnacja  0.89  0.84  0.95
 rodzinny rezygnacja  0.67  0.60  0.74
       wilson_dol       wilson_gora     bootstrap_dol    bootstrap_gora
            1.078             1.173             1.076             1.174
iloraz_szerokosci
            1.025
3. Łańcuch Markowa dla nowych kont i przychód: Rysunek 3
R
# Przepis 3. Łańcuch Markowa: rozkład planów nowych kont po 1–12 miesiącach (potęga macierzy) a obserwowany,
# przychód na konto w 12 miesiącach z przedziałem z bootstrapu kont: Rysunek 3
# Korzysta z prz, STAN, rejestracja, plany, cena, n, kol_plan, motyw (przepis 1) i P (przepis 2).
library(expm)                                  # operator %^% – potęga macierzy

kohorta <- which(rejestracja > 0)              # 10 000 nowych kont darmowych z miesięcy 1–12
obs <- sapply(0:12, function(t) STAN[cbind(kohorta, rejestracja[kohorta] + 1 + t)])   # stan t miesięcy po założeniu
przychod_obs <- rowSums(matrix(cena[obs[, -1]], ncol = 12))                            # zł w miesiącach 1–12

# (a) Zwykły łańcuch: jedna macierz P dla wszystkich kont i miesięcy
pi0 <- c(1, 0, 0, 0, 0)
rozklad <- function(P, start, kroki = 0:12) t(sapply(kroki, function(t) as.vector(start %*% (P %^% t))))
markow <- rozklad(P, pi0)

# (b) Łańcuch na rozszerzonych stanach: plan × „pierwsze 2 miesiące w planie” (n) albo „dłużej” (s)
st9 <- c(paste(rep(plany[1:4], each = 2), c("n", "s")), "rezygnacja")
z9 <- paste(prz$z, ifelse(prz$k <= 2, "n", "s"))
do9 <- ifelse(prz$do == "rezygnacja", "rezygnacja",
              ifelse(prz$do == prz$z, paste(prz$do, ifelse(prz$k == 1, "n", "s")), paste(prz$do, "n")))
kom9 <- (match(z9, st9) - 1) * 9 + match(do9, st9)
C9 <- unclass(table(factor(prz$konto, 1:n), factor(kom9, 1:81)))
macierz9 <- function(w) {
  N9 <- matrix(crossprod(w, C9), 9, byrow = TRUE); N9[9, 9] <- 1
  N9 / rowSums(N9)
}
zwin <- function(R9) cbind(R9[, 1] + R9[, 2], R9[, 3] + R9[, 4], R9[, 5] + R9[, 6], R9[, 7] + R9[, 8], R9[, 9])
rozszerzony <- zwin(rozklad(macierz9(rep(1, n)), c(1, rep(0, 8))))

obserwowany <- t(sapply(1:13, function(j) table(factor(obs[, j], 1:5)) / length(kohorta)))
por <- function(M) round(100 * M[c(4, 7, 13), ], 1)
wynik <- rbind(obserwowany = por(obserwowany), markow = por(markow), rozszerzony = por(rozszerzony))
dimnames(wynik) <- list(paste(rep(c("obserwowany", "markow", "rozszerzony"), each = 3), "po", c(3, 6, 12), "mies."),
                        plany)
wynik

# (c) Przychód na nowe konto w miesiącach 1–12 i oczekiwana liczba miesięcy do rezygnacji (macierz fundamentalna)
przychod <- function(R) sum(R[-1, ] %*% cena)
fundamentalna <- function(P) solve(diag(4) - P[1:4, 1:4])[1, ]   # oczekiwane miesiące w planach, start: darmowy
miary <- function(w_wszystkie, w_kohorta) {
  P1 <- macierz(w_wszystkie)                       # funkcja z przepisu 2
  c(obserwowany = sum(przychod_obs * w_kohorta) / sum(w_kohorta),
    markow = przychod(rozklad(P1, pi0)),
    rozszerzony = przychod(zwin(rozklad(macierz9(w_wszystkie), c(1, rep(0, 8))))),
    miesiace_do_rezygnacji = sum(fundamentalna(P1)), przychod_do_rezygnacji = sum(fundamentalna(P1) * cena[1:4]))
}
ocena <- miary(rep(1, n), rep(1, length(kohorta)))
B <- 1000
set.seed(7682)
boot <- replicate(B, {
  w <- tabulate(sample(n, replace = TRUE), n)          # losujemy konta; kohorta to podzbiór wylosowanych
  miary(w, w[kohorta])
})
round(cbind(ocena, t(apply(boot, 1, quantile, c(.025, .975)))), 2)
# Różnica: łańcuch Markowa − obserwowany przychód (zł na konto) z 95% CI
d <- boot["markow", ] - boot["obserwowany", ]
round(c(roznica = unname(ocena["markow"] - ocena["obserwowany"]), quantile(d, c(.025, .975))), 2)

# Rysunek: odsetek kohorty w planach (A) i skumulowany przychód na konto (B)
lin <- rbind(data.frame(t = 0:12, plan = rep(plany, each = 13), proc = 100 * as.vector(markow), co = "łańcuch: jedna macierz"),
             data.frame(t = 0:12, plan = rep(plany, each = 13), proc = 100 * as.vector(rozszerzony),
                        co = "łańcuch: plan × staż w planie"))
pkt <- data.frame(t = 0:12, plan = rep(plany, each = 13), proc = 100 * as.vector(obserwowany), co = "obserwowane")
lin$plan <- factor(lin$plan, plany); pkt$plan <- factor(pkt$plan, plany)
pA <- ggplot(lin, aes(t, proc)) +
  geom_line(aes(linetype = co, colour = co), linewidth = 0.9) +
  geom_point(data = pkt, aes(shape = co), colour = "#0f1d3a", size = 1.8) +
  facet_wrap(~plan, ncol = 3, scales = "free_y") +
  scale_colour_manual(NULL, values = c("łańcuch: jedna macierz" = "#D55E00", "łańcuch: plan × staż w planie" = "#0072B2")) +
  scale_linetype_manual(NULL, values = c("łańcuch: jedna macierz" = "22", "łańcuch: plan × staż w planie" = "solid")) +
  scale_shape_manual(NULL, values = c(obserwowane = 16)) +
  scale_x_continuous("Miesiące od założenia konta", breaks = c(0, 3, 6, 9, 12)) +
  labs(y = "% kohorty", title = "A. Gdzie jest 10 000 nowych kont darmowych po t miesiącach?") +
  motyw
skum <- function(R) cumsum(c(0, R[-1, ] %*% cena))
krzywe <- data.frame(t = 0:12, zl = c(skum(markow), skum(rozszerzony),
                                      c(0, cumsum(colMeans(matrix(cena[obs[, -1]], ncol = 12))))),
                     co = rep(c("łańcuch: jedna macierz", "łańcuch: plan × staż w planie", "obserwowane"), each = 13))
ci12 <- data.frame(co = c("obserwowane", "łańcuch: jedna macierz", "łańcuch: plan × staż w planie"),
                   zl = ocena[1:3], dol = apply(boot[1:3, ], 1, quantile, .025), gora = apply(boot[1:3, ], 1, quantile, .975))
pB <- ggplot(krzywe, aes(t, zl, colour = co, linetype = co)) +
  geom_line(linewidth = 0.9) +
  geom_errorbar(data = ci12, aes(x = 12 + c(0.3, 0.6, 0.9), ymin = dol, ymax = gora), width = 0.25, linetype = "solid",
                inherit.aes = FALSE, colour = c("#0f1d3a", "#D55E00", "#0072B2"), linewidth = 0.8) +
  scale_colour_manual(NULL, values = c("łańcuch: jedna macierz" = "#D55E00", "łańcuch: plan × staż w planie" = "#0072B2",
                                       obserwowane = "#0f1d3a")) +
  scale_linetype_manual(NULL, values = c("łańcuch: jedna macierz" = "22", "łańcuch: plan × staż w planie" = "solid",
                                         obserwowane = "12")) +
  scale_x_continuous("Miesiące od założenia konta", breaks = c(0, 3, 6, 9, 12)) +
  labs(y = "zł na nowe konto (skumulowane)", title = "B. Przychód na nowe konto w pierwszych 12 miesiącach",
       subtitle = "Odcinki przy 12. miesiącu: 95% przedział z bootstrapu kont (1000 prób)") +
  motyw
p3 <- pA / pB + plot_layout(heights = c(1.5, 1))
p3
# ggsave("zmiana-planu-lancuch-kohorta.svg", p3, width = 10, height = 9)
Wynik w R
                        darmowy 100 GB 1 TB rodzinny rezygnacja
obserwowany po 3 mies.     85.7    1.1  0.2      0.2       12.8
obserwowany po 6 mies.     79.7    3.3  0.5      0.6       15.9
obserwowany po 12 mies.    66.8    8.3  1.7      1.5       21.6
markow po 3 mies.          89.5    4.5  1.0      0.8        4.3
markow po 6 mies.          80.2    8.1  1.9      1.5        8.3
markow po 12 mies.         64.6   13.6  3.6      2.7       15.6
rozszerzony po 3 mies.     84.1    2.8  0.6      0.5       12.1
rozszerzony po 6 mies.     75.0    6.1  1.4      1.1       16.3
rozszerzony po 12 mies.    60.9   11.3  2.9      2.2       22.6
                         ocena    2.5%   97.5%
obserwowany              11.22   10.36   12.14
markow                   25.50   24.90   26.11
rozszerzony              19.46   18.87   20.13
miesiace_do_rezygnacji   90.80   88.23   93.49
przychod_do_rezygnacji 1570.84 1482.01 1667.66
roznica    2.5%   97.5%
  14.28   13.41   15.14
4. Staż w planie i model wielostanowy msm: Rysunek 4
R
# Przepis 4. Czy przejścia zależą od tego, jak długo konto jest w planie? (założenie Markowa): Rysunek 4
# oraz model wielostanowy msm ze stażem w planie jako zmienną. Korzysta z prz, STAN, ROCZ, STAZ, plany,
# motyw (przepis 1). Losuje podpróbę kont do msm (set.seed(7684)).
library(msm)

# (a) Odsetek kont płatnych, które w danym miesiącu planu zrezygnowały albo zmieniły plan
pl <- subset(prz, z %in% c("100 GB", "1 TB", "rodzinny") & k <= 36)
pl$wynik <- ifelse(pl$do == "rezygnacja", "rezygnacja", ifelse(pl$do == pl$z, "bez zmiany", "zmiana planu"))
pl$rozliczenie <- factor(ifelse(pl$roczny, "rozliczenie roczne", "rozliczenie miesięczne"),
                         c("rozliczenie miesięczne", "rozliczenie roczne"))
staz <- do.call(rbind, lapply(split(pl, list(pl$rozliczenie, pl$k), drop = TRUE), function(d)
  do.call(rbind, lapply(c("rezygnacja", "zmiana planu"), function(w) {
    x <- sum(d$wynik == w); ci <- prop.test(x, nrow(d), correct = FALSE)$conf.int
    data.frame(rozliczenie = d$rozliczenie[1], k = d$k[1], wynik = w, n = nrow(d), proc = 100 * x / nrow(d),
               dol = 100 * ci[1], gora = 100 * ci[2])
  }))))
pokaz <- subset(staz, k %in% c(1, 2, 3, 6, 11, 12, 13, 24))
print(data.frame(pokaz[1:4], round(pokaz[5:7], 2))[order(pokaz$rozliczenie, pokaz$wynik, pokaz$k), ], row.names = FALSE)

# Test: czy w rozliczeniu miesięcznym rezygnacja zależy od stażu w planie (1–2 miesiąc vs później)?
mies <- subset(pl, !roczny)
tab <- table(pierwsze_2_mies = mies$k <= 2, rezygnacja = mies$wynik == "rezygnacja")
tab; round(100 * prop.table(tab, 1)[, "TRUE"], 2)
chisq.test(tab, correct = FALSE)

# (b) Model wielostanowy w czasie ciągłym (msm) dla kont z rozliczeniem miesięcznym, podpróba 3000 kont.
# Zmienna „nowy” = konto jest w 1. lub 2. miesiącu obecnego planu; działa na intensywności rezygnacji.
bez_rocznych <- which(rowSums(ROCZ, na.rm = TRUE) == 0)
set.seed(7684)
wyb <- sort(sample(bez_rocznych, 3000))
dl <- do.call(rbind, lapply(wyb, function(i) {
  m <- which(!is.na(STAN[i, ]))
  ost <- m[STAN[i, m] == 5][1]; if (!is.na(ost)) m <- m[m <= ost]    # po rezygnacji nie obserwujemy dalej
  data.frame(konto = i, miesiac = m - 1, stan = STAN[i, m], nowy = as.integer(STAZ[i, m] + 1 <= 2))
}))
Q <- rbind(c(0, 1, 1, 1, 1), c(1, 0, 1, 1, 1), c(0, 1, 0, 1, 1), c(0, 1, 1, 0, 1), c(0, 0, 0, 0, 0))
Q0 <- crudeinits.msm(stan ~ miesiac, konto, data = dl, qmatrix = Q)
m0 <- msm(stan ~ miesiac, konto, data = dl, qmatrix = Q0)
m1 <- msm(stan ~ miesiac, konto, data = dl, qmatrix = Q0,
          covariates = list("1-5" = ~nowy, "2-5" = ~nowy, "3-5" = ~nowy, "4-5" = ~nowy))
lrtest.msm(m0, m1)
hr <- hazard.msm(m1)$nowy
round(hr[c("State 1 - State 5", "State 2 - State 5", "State 3 - State 5", "State 4 - State 5"), ], 2)
round(100 * pmatrix.msm(m0, t = 12)[1, ], 1)     # model bez stażu: rozkład po 12 miesiącach od planu darmowego

staz$wynik <- factor(staz$wynik, c("rezygnacja", "zmiana planu"))
p4 <- ggplot(staz, aes(k, proc, colour = wynik, shape = wynik)) +
  geom_vline(xintercept = c(12, 24, 36), colour = "grey75", linetype = "dotted") +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0, linewidth = 0.5, alpha = 0.7) +
  geom_line(linewidth = 0.6) + geom_point(size = 1.9) +
  facet_wrap(~rozliczenie, ncol = 1, scales = "free_y") +
  scale_colour_manual(NULL, values = c(rezygnacja = "#D55E00", "zmiana planu" = "#0072B2")) +
  scale_shape_manual(NULL, values = c(rezygnacja = 16, "zmiana planu" = 17)) +
  scale_x_continuous("Który miesiąc w obecnym planie płatnym", breaks = c(1, 6, 12, 18, 24, 30, 36)) +
  labs(y = "% kont w danym miesiącu", title = "Przejścia zależą od stażu w planie – założenie Markowa nie działa",
       subtitle = "Plany 100 GB, 1 TB i rodzinny razem; 95% przedziały Wilsona") +
  motyw
p4
# ggsave("zmiana-planu-staz-w-planie.svg", p4, width = 10, height = 7)
Wynik w R
            rozliczenie  k        wynik    n proc  dol  gora
 rozliczenie miesięczne  1   rezygnacja 8617 4.43 4.02  4.89
 rozliczenie miesięczne  2   rezygnacja 7694 4.54 4.09  5.02
 rozliczenie miesięczne  3   rezygnacja 7142 0.81 0.63  1.05
 rozliczenie miesięczne  6   rezygnacja 6373 0.96 0.75  1.23
 rozliczenie miesięczne 11   rezygnacja 5370 1.10 0.85  1.41
 rozliczenie miesięczne 12   rezygnacja 5208 0.79 0.58  1.07
 rozliczenie miesięczne 13   rezygnacja 5058 1.15 0.89  1.48
 rozliczenie miesięczne 24   rezygnacja 4707 0.74 0.54  1.03
 rozliczenie miesięczne  1 zmiana planu 8617 1.36 1.13  1.62
 rozliczenie miesięczne  2 zmiana planu 7694 1.34 1.11  1.62
 rozliczenie miesięczne  3 zmiana planu 7142 0.95 0.75  1.21
 rozliczenie miesięczne  6 zmiana planu 6373 1.19 0.95  1.49
 rozliczenie miesięczne 11 zmiana planu 5370 0.73 0.53  0.99
 rozliczenie miesięczne 12 zmiana planu 5208 1.17 0.91  1.50
 rozliczenie miesięczne 13 zmiana planu 5058 0.91 0.68  1.21
 rozliczenie miesięczne 24 zmiana planu 4707 1.04 0.79  1.37
     rozliczenie roczne  1   rezygnacja 2832 0.00 0.00  0.14
     rozliczenie roczne  2   rezygnacja 2677 0.00 0.00  0.14
     rozliczenie roczne  3   rezygnacja 2624 0.00 0.00  0.15
     rozliczenie roczne  6   rezygnacja 2424 0.00 0.00  0.16
     rozliczenie roczne 11   rezygnacja 2068 0.00 0.00  0.19
     rozliczenie roczne 12   rezygnacja 1990 5.23 4.33  6.29
     rozliczenie roczne 13   rezygnacja 1669 0.00 0.00  0.23
     rozliczenie roczne 24   rezygnacja 1653 5.32 4.34  6.51
     rozliczenie roczne  1 zmiana planu 2832 0.71 0.46  1.09
     rozliczenie roczne  2 zmiana planu 2677 0.90 0.60  1.33
     rozliczenie roczne  3 zmiana planu 2624 0.69 0.43  1.08
     rozliczenie roczne  6 zmiana planu 2424 0.74 0.47  1.17
     rozliczenie roczne 11 zmiana planu 2068 0.34 0.16  0.70
     rozliczenie roczne 12 zmiana planu 1990 9.30 8.10 10.65
     rozliczenie roczne 13 zmiana planu 1669 0.72 0.41  1.25
     rozliczenie roczne 24 zmiana planu 1653 8.05 6.83  9.46
               rezygnacja
pierwsze_2_mies  FALSE   TRUE
          FALSE 176120   1651
          TRUE   15580    731
FALSE  TRUE
 0.93  4.48

	Pearson's Chi-squared test

data:  tab
X-squared = 1555.7, df = 1, p-value < 2.2e-16

   -2 log LR df p
m1  261.4428  4 0
                    HR    L     U
State 1 - State 5 5.64 4.59  6.93
State 2 - State 5 4.24 2.88  6.24
State 3 - State 5 3.14 1.65  5.98
State 4 - State 5 7.56 3.55 16.09
State 1 State 2 State 3 State 4 State 5
   67.3    10.8     2.9     2.4    16.8
5. Model wielomianowy dla planu 100 GB: Rysunek 5
R
# Przepis 5. Model wielomianowy: co konto w planie 100 GB robi w następnym miesiącu (bez zmian / wyżej /
# niżej / rezygnacja) w zależności od zapełnienia miejsca: Rysunek 5. Korzysta z prz i motyw (przepis 1). Nie losuje.
library(nnet)
library(splines)

st <- subset(prz, z == "100 GB" & !roczny)     # konta roczne nie mogą zejść niżej ani zrezygnować w trakcie roku
st$wynik <- factor(ifelse(st$do == "100 GB", "bez zmian",
                   ifelse(st$do %in% c("1 TB", "rodzinny"), "wyżej",
                   ifelse(st$do == "darmowy", "niżej", "rezygnacja"))), c("bez zmian", "wyżej", "niżej", "rezygnacja"))
st$zap <- 100 * st$zapelnienie                  # zapełnienie w % limitu 100 GB
st$nowy <- as.integer(st$k <= 2)
c(konto_miesiecy = nrow(st), kont = length(unique(st$konto)))
round(100 * prop.table(table(st$wynik)), 2)

m_lin   <- multinom(wynik ~ zap + nowy, data = st, trace = FALSE, maxit = 500)
m_prog  <- multinom(wynik ~ zap + I(zap >= 90) + nowy, data = st, trace = FALSE, maxit = 500)
m_splaj <- multinom(wynik ~ ns(zap, knots = c(25, 50, 75, 90)) + nowy, data = st, trace = FALSE, maxit = 500)
round(c(AIC_liniowy = AIC(m_lin), AIC_prog_90 = AIC(m_prog), AIC_splajn = AIC(m_splaj)), 1)

# Ilorazy ryzyk względnych (RRR) z modelu z progiem, z 95% CI (kategoria odniesienia: bez zmian)
b <- coef(m_prog); se <- summary(m_prog)$standard.errors
rrr <- function(v, k = 1) round(cbind(RRR = exp(k * b[, v]), dol = exp(k * (b[, v] - 1.96 * se[, v])),
                                      gora = exp(k * (b[, v] + 1.96 * se[, v]))), 2)
rrr("I(zap >= 90)TRUE"); rrr("nowy")
rrr("zap", k = 10)                              # na 10 punktów procentowych zapełnienia

# Przewidywane prawdopodobieństwa (konto po 2. miesiącu w planie) dla wybranych zapełnień
siatka <- data.frame(zap = 0:100, nowy = 0)
pr <- rbind(data.frame(siatka, model = "splajn", predict(m_splaj, siatka, type = "probs"), check.names = FALSE),
            data.frame(siatka, model = "liniowy", predict(m_lin, siatka, type = "probs"), check.names = FALSE))
print(cbind(pr[pr$model == "splajn" & pr$zap %in% c(5, 50, 85, 90, 95, 100), "zap", drop = FALSE],
            round(100 * pr[pr$model == "splajn" & pr$zap %in% c(5, 50, 85, 90, 95, 100), 4:7], 2)), row.names = FALSE)
round(100 * pr[pr$model == "liniowy" & pr$zap %in% c(50, 90, 100), "wyżej"], 2)   # model liniowy: wyżej przy 50, 90, 100%

# Obserwowane odsetki w przedziałach zapełnienia (co 5 punktów) z przedziałem Wilsona
st$przedz <- pmin(floor(st$zap / 5) * 5, 95) + 2.5
obs <- do.call(rbind, lapply(split(subset(st, nowy == 0), subset(st, nowy == 0)$przedz), function(d)
  do.call(rbind, lapply(c("wyżej", "niżej", "rezygnacja"), function(w) {
    x <- sum(d$wynik == w); ci <- prop.test(x, nrow(d), correct = FALSE)$conf.int
    data.frame(zap = d$przedz[1], wynik = w, proc = 100 * x / nrow(d), dol = 100 * ci[1], gora = 100 * ci[2])
  }))))
dl <- do.call(rbind, lapply(c("wyżej", "niżej", "rezygnacja"), function(w)
  data.frame(zap = pr$zap, model = pr$model, wynik = w, proc = 100 * pr[[w]])))
dl$wynik <- factor(dl$wynik, c("wyżej", "niżej", "rezygnacja")); obs$wynik <- factor(obs$wynik, levels(dl$wynik))
p5 <- ggplot(dl, aes(zap, proc)) +
  annotate("rect", xmin = 90, xmax = 100, ymin = -Inf, ymax = Inf, fill = "#E69F00", alpha = 0.12) +
  geom_errorbar(data = obs, aes(ymin = dol, ymax = gora), width = 0, colour = "grey55") +
  geom_point(data = obs, colour = "grey30", size = 1.6) +
  geom_line(aes(colour = model, linetype = model), linewidth = 1) +
  facet_wrap(~wynik, ncol = 3, scales = "free_y",
             labeller = as_labeller(c("wyżej" = "wyżej (1 TB lub rodzinny)", "niżej" = "niżej (darmowy)",
                                      rezygnacja = "rezygnacja"))) +
  scale_colour_manual(NULL, values = c(splajn = "#0072B2", liniowy = "#D55E00"),
                      labels = c(splajn = "model ze splajnem", liniowy = "model liniowy")) +
  scale_linetype_manual(NULL, values = c(splajn = "solid", liniowy = "22"),
                        labels = c(splajn = "model ze splajnem", liniowy = "model liniowy")) +
  scale_x_continuous("Zajęte miejsce na początku miesiąca (% z 100 GB)", breaks = c(0, 25, 50, 75, 90)) +
  labs(y = "% kont w następnym miesiącu", title = "Plan 100 GB: dokąd w następnym miesiącu?",
       subtitle = "Punkty – odsetki w przedziałach co 5 pp z 95% CI; pas – zapełnienie ≥ 90%") +
  motyw
p5
# ggsave("zmiana-planu-wielomianowy-zapelnienie.svg", p5, width = 10, height = 4.8)
Wynik w R
konto_miesiecy           kont
        139508          10194

 bez zmian      wyżej      niżej rezygnacja
     97.41       0.79       0.43       1.36
AIC_liniowy AIC_prog_90  AIC_splajn
    38772.8     38130.4     38009.3
             RRR   dol  gora
wyżej      14.47 11.57 18.09
niżej       2.01  1.14  3.54
rezygnacja  0.97  0.73  1.29
            RRR  dol gora
wyżej      1.41 1.14 1.75
niżej      1.30 1.00 1.68
rezygnacja 4.90 4.34 5.54
            RRR  dol gora
wyżej      1.09 1.05 1.13
niżej      0.86 0.83 0.90
rezygnacja 1.01 0.99 1.04
 zap bez zmian wyżej niżej rezygnacja
   5     97.23  0.51  1.26       1.00
  50     98.17  0.45  0.30       1.08
  85     96.71  1.95  0.25       1.09
  90     94.33  4.39  0.24       1.04
  95     91.14  7.58  0.27       1.00
 100     87.62 11.05  0.35       0.98
[1] 0.64 3.06 4.49
6. Symulacja podwyżki planu 1 TB: Rysunek 6
R
# Przepis 6. Symulacja: podwyżka planu 1 TB z 29.99 do 34.99 zł – przepływy i przychód w 12 miesiącach: Rysunek 6
# Korzysta z STAN, plany, cena, n, motyw (przepis 1) i funkcji macierz() (przepis 2). Bootstrap kont: set.seed(7686).
library(expm)

cena_nowa <- cena; cena_nowa[3] <- 34.99
# Założenia scenariusza (ustalone ręcznie – nie wynikają z danych): odpływ z 1 TB (rezygnacja i zejście
# do 100 GB) rośnie m razy, a przejścia do 1 TB z planów 100 GB i darmowego spadają o 20%; brakująca masa zostaje w planie
scenariusz <- function(P, m, spadek_wejsc = 0.2) {
  P["1 TB", c("100 GB", "rezygnacja")] <- m * P["1 TB", c("100 GB", "rezygnacja")]
  P[c("darmowy", "100 GB"), "1 TB"] <- (1 - spadek_wejsc) * P[c("darmowy", "100 GB"), "1 TB"]
  diag(P)[1:4] <- 0; diag(P)[1:4] <- 1 - rowSums(P[1:4, ])
  P
}
start <- c(as.vector(table(factor(STAN[, 25], 1:4))), 0)      # konta aktywne na koniec miesiąca 24
start <- 1000 * start / sum(start)                           # na 1000 aktywnych kont
projekcja <- function(P, ceny, s0 = start) {
  R <- t(sapply(1:12, function(t) as.vector(s0 %*% (P %^% t))))
  list(stany = R[12, ], przychod = sum(R %*% ceny))
}
P0 <- macierz(rep(1, n))
m_zal <- 1.5
baza <- projekcja(P0, cena); scen <- projekcja(scenariusz(P0, m_zal), cena_nowa)
tab <- rbind(start = start, po_12_baza = baza$stany, po_12_podwyzka = scen$stany)
colnames(tab) <- plany; round(tab, 1)                         # konta na 1000 aktywnych
round(c(przychod_baza = baza$przychod, przychod_podwyzka = scen$przychod,
        zmiana_proc = 100 * (scen$przychod / baza$przychod - 1)), 1)

# Wrażliwość: zmiana przychodu (%) dla m od 1 do 4, z 95% CI z bootstrapu kont (500 prób, P szacowane od nowa)
ms <- seq(1, 4, by = 0.25)
zmiana <- function(P) sapply(ms, function(m) 100 * (projekcja(scenariusz(P, m), cena_nowa)$przychod /
                                                    projekcja(P, cena)$przychod - 1))
ocena <- zmiana(P0)
set.seed(7686)
boot <- replicate(500, zmiana(macierz(tabulate(sample(n, replace = TRUE), n))))
wr <- data.frame(m = ms, zmiana = ocena, dol = apply(boot, 1, quantile, .025), gora = apply(boot, 1, quantile, .975))
round(wr, 2)
prog_m <- uniroot(function(m) 100 * (projekcja(scenariusz(P0, m), cena_nowa)$przychod / baza$przychod - 1),
                  c(1, 10))$root
round(c(m_przy_ktorym_podwyzka_przestaje_sie_oplacac = prog_m), 2)

# Rysunek: miesięczne przepływy z 1 TB (A) i wrażliwość przychodu na odpływ (B)
P1 <- scenariusz(P0, m_zal)
prz_tb <- data.frame(kierunek = rep(c("1 TB → 100 GB", "1 TB → rodzinny", "1 TB → rezygnacja", "100 GB → 1 TB",
                                      "darmowy → 1 TB"), 2),
                     wariant = rep(c("cena 29.99 zł", "cena 34.99 zł (scenariusz)"), each = 5),
                     proc = 100 * c(P0["1 TB", c(2, 4, 5)], P0[2, 3], P0[1, 3], P1["1 TB", c(2, 4, 5)], P1[2, 3], P1[1, 3]))
prz_tb$kierunek <- factor(prz_tb$kierunek, rev(unique(prz_tb$kierunek)))
pA <- ggplot(prz_tb, aes(proc, kierunek, fill = wariant)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = sprintf("%.2f%%", proc)), position = position_dodge(width = 0.75), hjust = -0.15, size = 3.4,
            colour = "#0f1d3a") +
  scale_fill_manual(NULL, values = c("cena 29.99 zł" = "#56B4E9", "cena 34.99 zł (scenariusz)" = "#E69F00")) +
  scale_x_continuous("% kont planu wyjściowego w miesiącu", expand = expansion(mult = c(0, 0.25))) +
  labs(y = NULL, title = "A. Miesięczne przejścia z i do planu 1 TB", subtitle = sprintf("Scenariusz: odpływ × %.1f, wejścia −20%%", m_zal)) +
  guides(fill = guide_legend(nrow = 2)) + motyw
pB <- ggplot(wr, aes(m, zmiana)) +
  geom_hline(yintercept = 0, colour = "grey45") +
  geom_ribbon(aes(ymin = dol, ymax = gora), fill = "#0072B2", alpha = 0.2) +
  geom_line(colour = "#0072B2", linewidth = 1) +
  geom_vline(xintercept = c(m_zal, prog_m), linetype = c("dashed", "dotted"), colour = c("#E69F00", "#D55E00")) +
  annotate("text", x = c(m_zal, prog_m) + 0.07, y = max(wr$gora) * c(0.95, 0.6), hjust = 0, size = 3.4,
           label = c("założenie", sprintf("próg opłacalności\nm = %.2f", prog_m)), colour = "#0f1d3a") +
  scale_x_continuous("m – ile razy rośnie odpływ z 1 TB", breaks = 1:4) +
  labs(y = "Zmiana przychodu w 12 mies. (%)", title = "B. Czy podwyżka się opłaci?",
       subtitle = "95% przedział z bootstrapu kont (500 prób)") +
  motyw
p6 <- pA + pB + plot_layout(widths = c(1.1, 1))
p6
# ggsave("zmiana-planu-podwyzka-1tb.svg", p6, width = 10, height = 5.4)
Wynik w R
               darmowy 100 GB  1 TB rodzinny rezygnacja
start            427.8  313.2 157.4    101.6        0.0
po_12_baza       290.1  300.9 165.6    113.2      130.2
po_12_podwyzka   292.7  307.8 148.3    113.0      138.2
    przychod_baza przychod_podwyzka       zmiana_proc
         153933.9          159990.9               3.9
      m zmiana   dol  gora
1  1.00   5.50  5.47  5.53
2  1.25   4.71  4.65  4.77
3  1.50   3.93  3.84  4.04
4  1.75   3.18  3.06  3.32
5  2.00   2.44  2.29  2.61
6  2.25   1.72  1.54  1.92
7  2.50   1.01  0.80  1.24
8  2.75   0.32  0.09  0.58
9  3.00  -0.35 -0.61 -0.06
10 3.25  -1.01 -1.29 -0.69
11 3.50  -1.65 -1.96 -1.31
12 3.75  -2.28 -2.61 -1.91
13 4.00  -2.89 -3.24 -2.50
m_przy_ktorym_podwyzka_przestaje_sie_oplacac
                                        2.87
7. Grafika: diagram przepływów (Rysunek 1)
R
# Przepis 7. Grafika: diagram przepływów między planami (Rysunek 1). Korzysta z P, N (przepis 2), plany, cena,
# kol_plan (przepis 1). Nie losuje.
pola <- data.frame(plan = plany, x = c(12, 50, 88, 74, 26), y = c(44, 64, 44, 8, 8),
                   szer = c(22, 22, 22, 24, 24), wys = 13)
pola$opis <- c(sprintf("%s · %s\nzostaje %.1f%%", c("0 zł", "9.99 zł", "29.99 zł", "44.99 zł"),
                       c("10 GB", "100 GB", "1 TB", "2 TB, 5 osób"), 100 * diag(P)[1:4]),
               "stan pochłaniający\n(konto zamknięte)")
# Strzałki: każde przejście poza przekątną; grubość ~ średnia liczba kont na miesiąc
str <- as.data.frame(as.table(N), stringsAsFactors = FALSE)
names(str) <- c("z", "do", "liczba")
str <- subset(str, z != do & liczba > 0)
str$proc <- 100 * P[cbind(as.character(str$z), as.character(str$do))]
str$na_miesiac <- str$liczba / 24
krawedz <- function(x0, y0, x1, y1, sz, wy) {          # punkt na brzegu prostokąta w stronę (x1, y1)
  dx <- x1 - x0; dy <- y1 - y0; t <- min(sz / 2 / abs(dx), wy / 2 / abs(dy), na.rm = TRUE)
  c(x0 + 1.08 * t * dx, y0 + 1.08 * t * dy)
}
wsp <- t(sapply(seq_len(nrow(str)), function(i) {
  a <- pola[pola$plan == str$z[i], ]; b <- pola[pola$plan == str$do[i], ]
  c(krawedz(a$x, a$y, b$x, b$y, a$szer, a$wys), krawedz(b$x, b$y, a$x, a$y, b$szer, b$wys))
}))
str[c("x", "y", "xend", "yend")] <- wsp
dl <- sqrt((str$xend - str$x)^2 + (str$yend - str$y)^2)
str$lx <- (str$x + str$xend) / 2 - 0.11 * (str$yend - str$y)   # etykieta na środku łuku
str$ly <- (str$y + str$yend) / 2 + 0.11 * (str$xend - str$x)
print(data.frame(str[c("z", "do")], proc = round(str$proc, 2), kont_na_miesiac = round(str$na_miesiac)), row.names = FALSE)

p7 <- ggplot() +
  geom_curve(data = str, aes(x = x, y = y, xend = xend, yend = yend, linewidth = na_miesiac, colour = z),
             curvature = -0.25, arrow = arrow(length = unit(2.2, "mm"), type = "closed"), alpha = 0.8,
             lineend = "round") +
  geom_label(data = str, aes(lx, ly, label = sprintf("%.2f%%", proc)), size = 3.5, linewidth = 0,
             fill = "white", colour = "#0f1d3a", label.padding = unit(0.08, "lines")) +
  geom_rect(data = pola, aes(xmin = x - szer / 2, xmax = x + szer / 2, ymin = y - wys / 2, ymax = y + wys / 2,
                             fill = plan), colour = "grey30", linewidth = 0.4, alpha = 0.3) +
  geom_text(data = pola, aes(x, y + 3, label = plan), fontface = "bold", size = 4.4, colour = "#0f1d3a") +
  geom_text(data = pola, aes(x, y - 2.4, label = opis), size = 3.1, colour = "#0f1d3a", lineheight = 0.95) +
  scale_fill_manual(values = kol_plan, guide = "none") +
  scale_colour_manual(values = kol_plan, guide = "none") +
  scale_linewidth(range = c(0.4, 3.2), breaks = c(10, 50, 200), name = "Kont na miesiąc (średnio)") +
  coord_fixed(xlim = c(0, 100), ylim = c(0, 72), expand = FALSE, clip = "off") +
  labs(title = "Miesięczne przejścia między planami serwisu ze zdjęciami",
       subtitle = "Odsetek kont planu wyjściowego, które w ciągu miesiąca przeszły wzdłuż strzałki; kolor = plan wyjściowy") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
p7
# ggsave("zmiana-planu-diagram-przeplywow.svg", p7, width = 10, height = 8)
Wynik w R
        z         do proc kont_na_miesiac
   100 GB    darmowy 0.51              40
  darmowy     100 GB 1.58             288
     1 TB     100 GB 0.42              17
 rodzinny     100 GB 0.11               3
  darmowy       1 TB 0.34              62
   100 GB       1 TB 0.54              43
 rodzinny       1 TB 0.34               8
  darmowy   rodzinny 0.26              48
   100 GB   rodzinny 0.24              19
     1 TB   rodzinny 0.30              12
  darmowy rezygnacja 1.45             265
   100 GB rezygnacja 1.12              88
     1 TB rezygnacja 0.89              36
 rodzinny rezygnacja 0.67              16
8. Sprawdzenie palety (deuteranopia)
R
# Przepis 8. Czy paleta jest czytelna przy zaburzeniach widzenia barw? (colorspace::deutan, protan)
# Nie korzysta z innych przepisów. Nie losuje.
library(colorspace)
pary <- list("darmowy – 100 GB" = c("#56B4E9", "#0072B2"), "100 GB – 1 TB" = c("#0072B2", "#E69F00"),
             "1 TB – rodzinny" = c("#E69F00", "#009E73"), "rodzinny – rezygnacja" = c("#009E73", "#D55E00"),
             "1 TB – rezygnacja" = c("#E69F00", "#D55E00"), "rezygnacja – zmiana planu" = c("#D55E00", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
darmowy – 100 GB                            26.4         24.7       24.6
100 GB – 1 TB                              120.2        121.5      109.3
1 TB – rodzinny                             88.7         66.3       51.5
rodzinny – rezygnacja                      102.4         53.5       37.3
1 TB – rezygnacja                           33.4         18.4       24.9
rezygnacja – zmiana planu                  114.6        108.3       91.9
czerwony – zielony (do unikania)           121.7         21.1       31.6
9. Odtworzenie danych z pliku CSV
R
# Przepis 9. Odtworzenie danych z pliku CSV: z pliku powstają te same przejścia (prz), co w przepisie 1,
# więc przepisy 2–7 dają z CSV te same liczby. Korzysta z prz i plany (przepis 1) tylko do porównania. Nie losuje.
k <- read.csv("zmiana-planu-abonamentu-konta.csv", colClasses = c("integer", "integer", "character", "character"))
n_csv <- nrow(k)
lit <- do.call(rbind, strsplit(k$plan_m0_m24, ""))                       # 40 000 × 25 znaków
S2 <- matrix(match(toupper(lit), c("D", "S", "T", "R", "X")), n_csv)    # kropka → NA
R2 <- lit %in% c("s", "t", "r"); dim(R2) <- dim(lit); R2[is.na(S2)] <- NA
D2 <- matrix(NA_integer_, n_csv, 25); D2[, 1] <- ifelse(k$miesiac_zalozenia == 0, k$staz_m0, NA)
for (m in 2:25) {                                                         # staż: +1 bez zmiany planu, 0 po zmianie
  zal <- !is.na(S2[, m]) & is.na(S2[, m - 1])                             # konto założone w tym miesiącu
  D2[, m] <- ifelse(zal, 0L, ifelse(S2[, m] == S2[, m - 1], D2[, m - 1] + 1L, 0L))
}
Z2 <- matrix(NA_real_, n_csv, 25); w <- strsplit(k$zap_100gb, ";")
for (i in which(lengths(w) > 0)) Z2[i, which(S2[i, ] == 2)] <- as.numeric(w[[i]]) / 100
idx2 <- which(!is.na(S2[, -25]) & S2[, -25] <= 4, arr.ind = TRUE)
idx2 <- idx2[order(idx2[, 2], idx2[, 1]), ]
prz_csv <- data.frame(konto = idx2[, 1], miesiac = idx2[, 2],
                      z = factor(plany[S2[idx2]], plany), do = factor(plany[S2[cbind(idx2[, 1], idx2[, 2] + 1)]], plany),
                      roczny = R2[idx2], k = D2[idx2] + 1)
p1 <- prz[order(prz$miesiac, prz$konto), ]
c(wiersze_rowne = nrow(prz_csv) == nrow(p1),
  plany_i_rozliczenie_rowne = all(p1$konto == prz_csv$konto & p1$z == prz_csv$z & p1$do == prz_csv$do &
                                  p1$roczny == prz_csv$roczny),
  staz_rowny = all(p1$k == prz_csv$k),
  zapelnienie_100gb_rowne = all(abs(p1$zapelnienie[p1$z == "100 GB"] - Z2[idx2][prz_csv$z == "100 GB"]) < 1e-9))
Wynik w R
            wiersze_rowne plany_i_rozliczenie_rowne                staz_rowny
                     TRUE                      TRUE                      TRUE
  zapelnienie_100gb_rowne
                     TRUE
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, bootstrap, przedziały Wilsona i test χ² – pakiety base i stats; splajny naturalne – pakiet splines; potęgi macierzy – pakiet expm; model wielostanowy – pakiet msm; wielomianowa regresja logistyczna – pakiet nnet). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R (w tym pakiety stats i splines): R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- expm (wersja 1.0.0): Maechler, M., Dutang, C., & Goulet, V. (2024). expm: Matrix exponential, log, 'etc' [R package]. https://doi.org/10.32614/CRAN.package.expm
- msm (wersja 1.9): Jackson, C. H. (2011). Multi-state models for panel data: The msm package for R. Journal of Statistical Software, 38(8). https://doi.org/10.18637/jss.v038.i08
- nnet (wersja 7.3.20): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Plany roczne w jednej macierzy z miesięcznymi. Konto roczne przez 11 miesięcy „stoi”, a w 12. robi skok (9.30% zmian planu, 5.23% rezygnacji). Licz je osobno albo z krokiem rocznym.
- Konta rodzinne. Licz plan po płatniku, nie po kontach członków, bo zawyżysz liczbę kont i zaniżysz przychód na konto. Członkowie zmieniają plan razem, więc w bootstrapie losuj całe rodziny.
- Powroty po rezygnacji. Jeśli zamknięte konto może „wrócić”, zdecyduj, czy to nowe konto – inaczej rezygnacja przestaje być stanem pochłaniającym.
- Wąski przedział jako dowód trafności. Prognoza z przedziałem [24.90, 26.11] zł minęła się z prawdą (11.22 zł) o ponad połowę.
- Zapełnienie liniowo. Model liniowy daje przy pełnym miejscu 4.49% przejść wyżej, splajn – 11.05%.
- Scenariusz ceny bez testu. Wynik +3.9% zależy od założonego m; pokazuj całą krzywą wrażliwości.
Najczęstsze pytania
Co to jest macierz przejść między planami abonamentu?
To tabela krzyżowa, w której wiersz oznacza plan konta na koniec miesiąca, a kolumna – plan na koniec następnego miesiąca. Odsetki w wierszu to szacowane prawdopodobieństwa przejść: na przekątnej konta, które zostały w planie, poza nią przejścia na wyższy lub niższy plan i rezygnacje. W przykładzie z planu darmowego co miesiąc 1.58% kont przechodziło na plan 100 GB.
Dlaczego rezygnacja to stan pochłaniający?
Bo z rezygnacji nie ma przejść do innych stanów: wiersz rezygnacji ma 100% na przekątnej. Dzięki temu potęgi macierzy pokazują skumulowany odsetek zamkniętych kont, a macierz fundamentalna – oczekiwany czas do rezygnacji. Jeśli w danych klienci wracają, trzeba zdecydować, czy powrót to nowe konto.
Jak policzyć przedział ufności dla macierzy przejść?
Jedno konto daje wiele przejść, więc warto losować ze zwracaniem całe konta (bootstrap kont) i za każdym razem liczyć macierz od nowa. Ten sam bootstrap daje przedziały dla wielkości liczonych z całej macierzy, np. przychodu na konto. Pamiętaj, że przedział nie obejmuje błędu założeń modelu.
Jak sprawdzić założenie Markowa w danych o abonamentach?
Porównaj prognozę łańcucha z obserwowaną kohortą i narysuj odsetek przejść według miesiąca w planie. W przykładzie rezygnacja w 1.–2. miesiącu planu wynosiła 4.48%, później 0.93%. Formalnie można dodać staż w planie jako zmienną w modelu wielostanowym (np. pakiet msm) albo rozszerzyć stany o staż.
Jak oszacować skutki podwyżki ceny planu łańcuchem Markowa?
Zmień w macierzy przejścia, na które wpłynie cena (np. odpływ z droższego planu), i porównaj przychód z projekcji z nową i starą ceną. Ponieważ reakcji klientów nie ma w danych, pokaż wynik dla różnych założeń i próg, przy którym podwyżka przestaje się opłacać, a reakcję zmierz losowym testem ceny.
Powiązane hasła
Przeczytaj też
Przechodzenie klientów między markami
Macierz przejść z panelu 2500 gospodarstw: lojalność, odchylenia od niezależności, łańcuch Markowa, bootstrap i promocja – z kodem R.
Czytaj →PoradnikWielomianowa regresja logistyczna
Kategoria odniesienia, RRR, test predyktorów, prawdopodobieństwa przewidywane, założenie IIA i tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikWartość klienta w czasie (CLV)
Sklep z abonamentem na karmę: koncentracja marży, prosty wzór CLV, wrażliwość na retencję, model rezygnacji i bootstrap – pięć rysunków z kodem R.
Czytaj →Analizujesz w pracy zmiany planów lub rezygnacje klientów?
Pomożemy zbudować macierz przejść, sprawdzić założenie Markowa, policzyć przychód z przedziałami i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Andersen, P. K., & Keiding, N. (2002). Multi-state models for event history analysis. Statistical Methods in Medical Research, 11(2), 91–115. https://doi.org/10.1191/0962280202sm276ra
- Anderson, T. W., & Goodman, L. A. (1957). Statistical inference about Markov chains. The Annals of Mathematical Statistics, 28(1), 89–110. https://doi.org/10.1214/aoms/1177707039 ● Otwarty dostęp
- Field, C. A., & Welsh, A. H. (2007). Bootstrapping clustered data. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(3), 369–390. https://doi.org/10.1111/j.1467-9868.2007.00593.x
- Jackson, C. H. (2011). Multi-state models for panel data: The msm package for R. Journal of Statistical Software, 38(8). https://doi.org/10.18637/jss.v038.i08 ● Otwarty dostęp
- Kalbfleisch, J. D., & Lawless, J. F. (1985). The analysis of panel data under a Markov assumption. Journal of the American Statistical Association, 80(392), 863–871. https://doi.org/10.1080/01621459.1985.10478195
- Lambrecht, A., & Skiera, B. (2006). Paying too much and being happy about it: Existence, causes, and consequences of tariff-choice biases. Journal of Marketing Research, 43(2), 212–223. https://doi.org/10.1509/jmkr.43.2.212 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{andersen2002multistate, author={Andersen, Per Kragh and Keiding, Niels}, title={{Multi-state models for event history analysis}}, journal={Statistical Methods in Medical Research}, year={2002}, volume={11}, number={2}, pages={91--115}, doi={10.1191/0962280202sm276ra}}@article{anderson1957statistical, author={Anderson, T. W. and Goodman, Leo A.}, title={{Statistical inference about Markov chains}}, journal={The Annals of Mathematical Statistics}, year={1957}, volume={28}, number={1}, pages={89--110}, doi={10.1214/aoms/1177707039}}@article{field2007bootstrapping, author={Field, Christopher A. and Welsh, Alan H.}, title={{Bootstrapping clustered data}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2007}, volume={69}, number={3}, pages={369--390}, doi={10.1111/j.1467-9868.2007.00593.x}}@article{jackson2011multi, author={Jackson, Christopher H.}, title={{Multi-state models for panel data: The msm package for R}}, journal={Journal of Statistical Software}, year={2011}, volume={38}, number={8}, doi={10.18637/jss.v038.i08}}@article{kalbfleisch1985analysis, author={Kalbfleisch, J. D. and Lawless, J. F.}, title={{The analysis of panel data under a Markov assumption}}, journal={Journal of the American Statistical Association}, year={1985}, volume={80}, number={392}, pages={863--871}, doi={10.1080/01621459.1985.10478195}}@article{lambrecht2006paying, author={Lambrecht, Anja and Skiera, Bernd}, title={{Paying too much and being happy about it: Existence, causes, and consequences of tariff-choice biases}}, journal={Journal of Marketing Research}, year={2006}, volume={43}, number={2}, pages={212--223}, doi={10.1509/jmkr.43.2.212}}